2026年本地AI部署全攻略:从Ollama到RAG知识库,从单模型到多模态,手把手打造你的本地AI工作台
2025-2026年,大模型技术迎来了真正的"落地之年"。当云端AI的隐私忧虑、数据成本、网络依赖等问题逐一暴露,越来越多的开发者、技术爱好者和企业开始将目光转向本地部署。
本地部署意味着什么?数据不出本地、零API费用、离线可用、完全可控。 在这个大模型日新月异的时代,部署自己的本地AI,已经不再是极客的专属技能,而是每一个AI使用者都应该掌握的基础能力。
本文将为你呈现一份完整的本地AI部署实战指南,涵盖以下核心内容:
- Ollama:本地大模型运行的核心引擎,安装配置与API调用
- 向量数据库与RAG:本地知识库的技术架构与实战搭建
- Dify/RAGFlow/AnythingLLM:三大主流知识库平台的全方位对比与实操
- 多模态模型:本地部署视觉-语言模型,实现图片理解与生成
- 性能优化:GPU配置、量化技术、批量推理的实战经验
无论你是想要本地跑一个DeepSeek来写代码,还是想给团队搭建一个私有知识库,这篇文章都将提供可以直接上手的实战指南。
一、为什么要在本地部署AI?
1.1 本地部署的核心价值
在开始实战之前,我们先厘清一个问题:为什么要本地部署,而不是直接使用OpenAI API或国内云服务?
数据隐私与安全是最主要的驱动力。当企业需要处理敏感数据(医疗记录、法律文档、财务报表、内部代码)时,将这些数据发送给第三方API存在合规风险。本地部署意味着数据从始至终保留在本地环境,没有任何传输和存储的风险。
成本控制是第二大驱动力。以GPT-4o的API定价为例,每百万token的输入成本约为2.5-5美元(根据模型版本),而本地部署大模型只需一次性硬件投入。以日均调用量10000次计算,一年的API费用可能高达数万元,而同等计算量的本地部署(以RTX 4090为例)硬件成本约在2-3万元,能源成本另计。
离线可用性在特定场景下至关重要。没有网络连接时(飞机、偏远工地、网络受限环境),本地部署是唯一选择。
可定制性则是技术团队的刚需。本地部署允许接入开源模型、修改系统提示词、进行模型微调,构建完全贴合业务需求的应用。
1.2 2026年本地AI的技术生态全景
2026年,本地AI的技术生态已经非常成熟:
| 层级 | 核心组件 | 主流选项 |
|---|---|---|
| 模型运行框架 | Ollama / vLLM / LM Studio | Ollama(最易用)、vLLM(最高效) |
| 大语言模型 | DeepSeek / Qwen / Llama / Mistral | DeepSeek-R1(性价比最高)、Qwen2.5(中文最强) |
| 向量数据库 | Milvus / Qdrant / Chroma / LanceDB | Qdrant(轻量首选)、Milvus(企业级) |
| RAG框架 | LangChain / LlamaIndex / Dify / RAGFlow | Dify(生态最全)、RAGFlow(文档解析最强) |
| 多模态模型 | LLaVA / Qwen-VL / InternVL / CogVLM | LLaVA(最流行)、Qwen2-VL(中文优化) |
| Embedding | Sentence Transformers / BGE / M3E | BGE(中文优化,开源可商用) |
二、Ollama:本地大模型的"一键启动"引擎
2.1 Ollama是什么
Ollama(官网:ollama.com/)是当前最流行的本地大…**
Ollama的特点:
- 安装极简:macOS/Linux一行命令,Windows有官方安装包
- 模型管理便捷:一个命令拉取模型(
ollama pull),一个命令运行(ollama run) - API友好:自动提供REST API,可以被LangChain/LlamaIndex等框架直接调用
- 多平台支持:macOS、Linux、Windows、Docker,甚至可以在树莓派上运行
2.2 安装与配置
macOS/Linux安装:
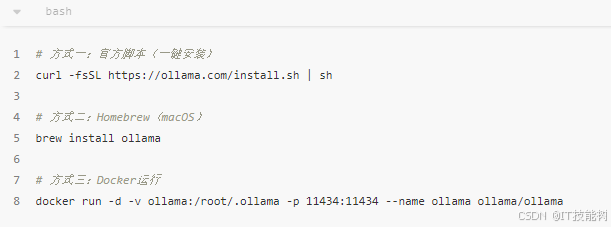
Windows安装: 直接访问 ollama.com/download 下载Windows安装包,双击运行即可。
验证安装:
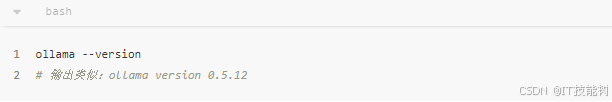
2.3 模型拉取与运行
Ollama的模型管理通过模型库(Ollama Library)进行,支持数百个开源模型。以下是常用模型的拉取命令:
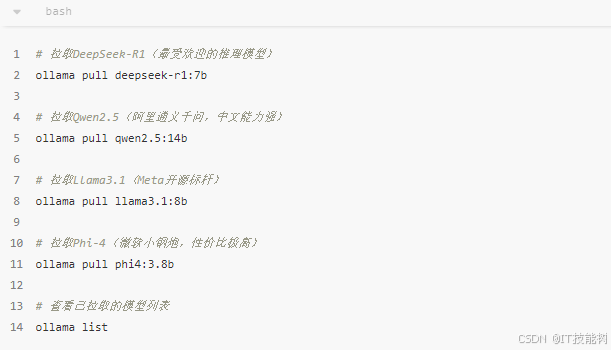
硬件需求参考:
| 模型 | 参数量 | 最低内存 | 推荐显存/内存 | 适用场景 |
|---|---|---|---|---|
| Phi-4 | 3.8B | 8GB | 16GB | 轻量推理、快速响应 |
| Qwen2.5:3B | 3B | 8GB | 12GB | 本地助手、聊天 |
| Llama3.1:8B | 8B | 16GB | 24GB | 通用对话、代码 |
| Qwen2.5:14B | 14B | 32GB | 48GB | 高质量问答 |
| DeepSeek-R1:7B | 7B | 16GB | 32GB | 推理分析 |
| DeepSeek-R1:70B | 70B | 128GB | 多卡并行 | 企业级应用 |
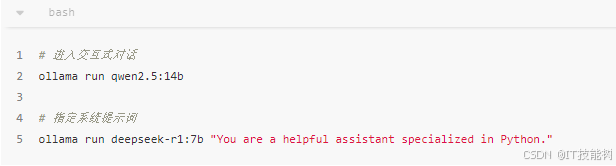
运行模型:
2.4 API调用:让AI接入你的应用
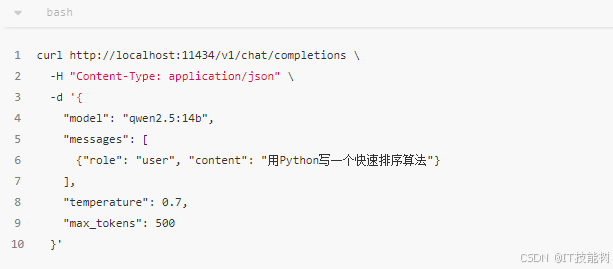
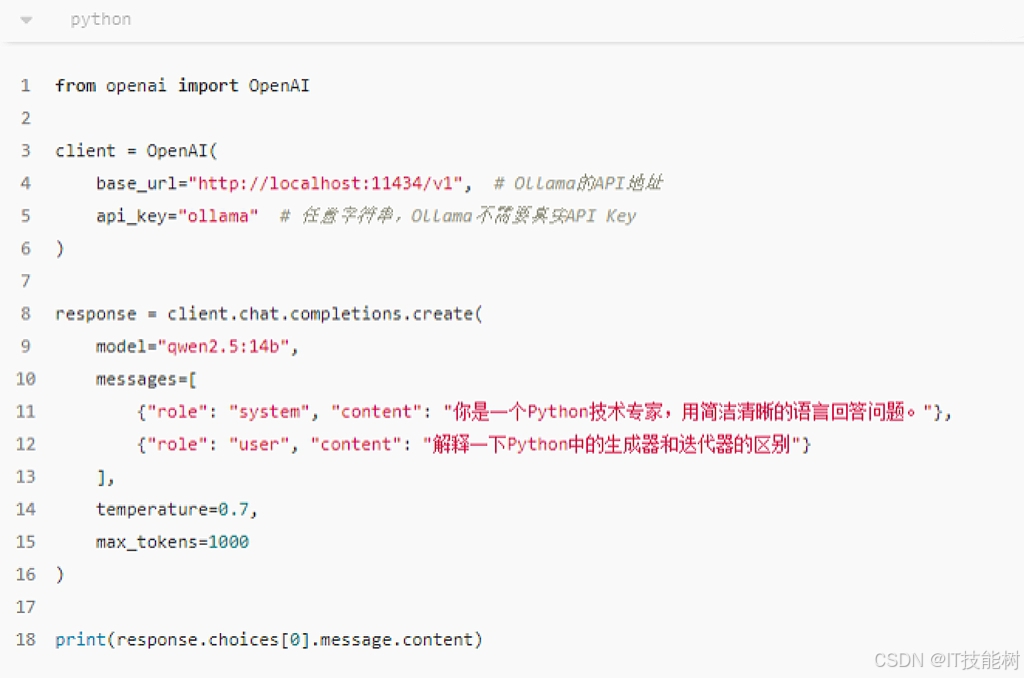
Ollama启动后自动提供REST API,地址为 http://localhost:11434。这意味着你可以用任何支持HTTP请求的编程语言调用本地模型。
Chat Completions API(与OpenAI兼容):
Python调用示例(使用OpenAI SDK):
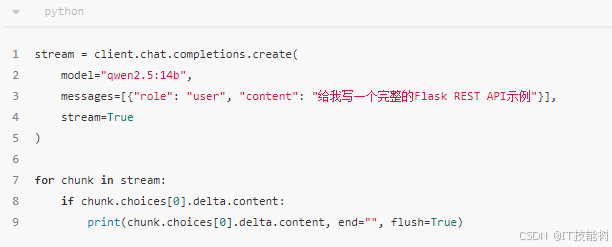
流式输出:
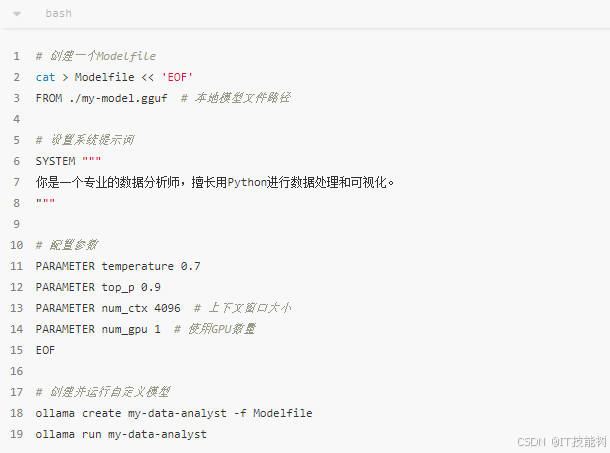
2.5 Ollama进阶:自定义模型与Modelfile
如果Ollama Library中没有你需要的模型,或者你想用自己的模型文件(GGUF格式),可以通过Modelfile自定义模型配置:
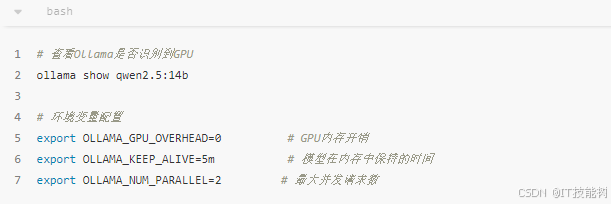
2.6 Ollama的GPU配置
Ollama会自动检测并使用GPU。在NVIDIA显卡环境下,确保已安装CUDA驱动:
【图1:Ollama运行状态截图,请自行截图。截取Ollama Web界面或终端中模型正在推理的截图,展示GPU利用率和内存占用情况。可访问 ollama.com/ 查看Web UI介绍】
三、向量数据库:RAG的存储底座
3.1 为什么需要向量数据库
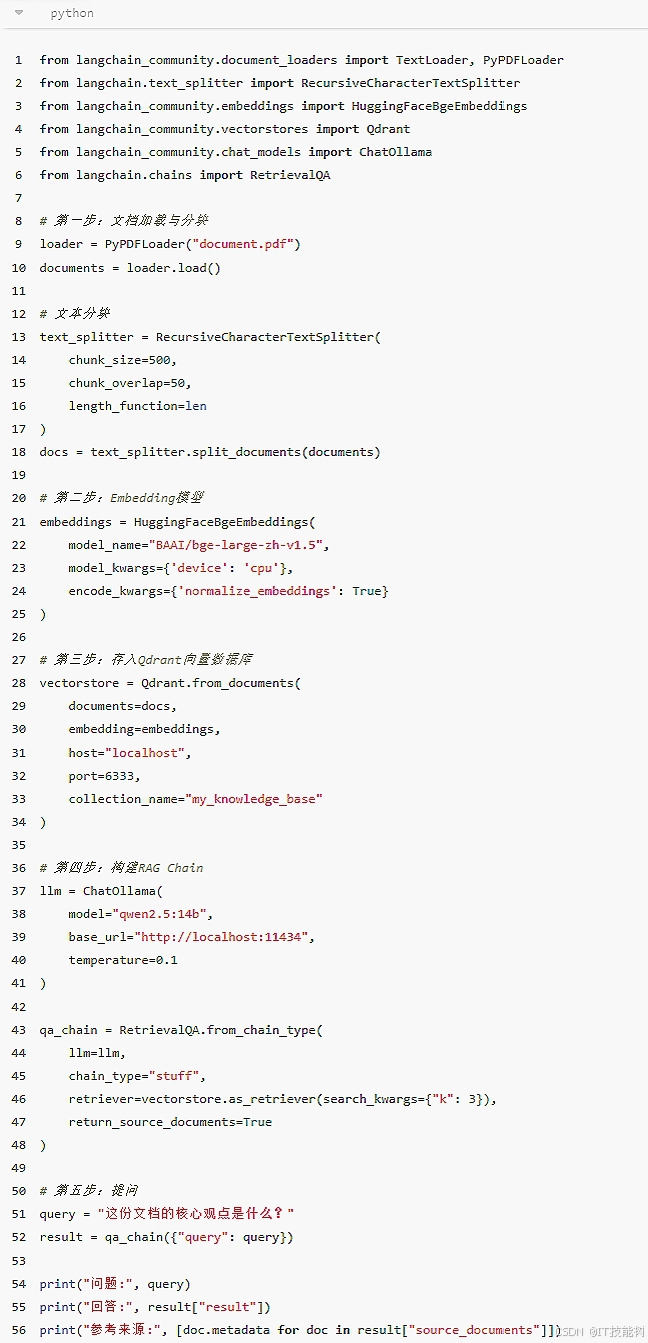
RAG(Retrieval-Augmented Generation,检索增强生成)的核心工作流程是:先将文档切分成小块(Chunk),通过Embedding模型将每块文本转换为向量(Vector),存储在向量数据库中;用户提问时,将问题也转换为向量,在数据库中进行相似度搜索(Similarity Search),找到最相关的文档块,最后将检索结果与原始问题一起发送给大模型生成回答。
在这个流程中,向量数据库是存储和检索的底座。选择一个合适的向量数据库,是构建高效RAG系统的关键。
3.2 主流向量数据库对比
| 数据库 | 特点 | 优势 | 劣势 | 适用场景 |
|---|---|---|---|---|
| Qdrant | Rust编写,高性能 | 内存效率高,API设计优秀 | 生态相对年轻 | 个人/中小团队首选 |
| Milvus | 企业级,开源标杆 | 功能最全面,扩展性强 | 部署较复杂 | 大规模企业应用 |
| Chroma | 轻量,Python原生 | 最易上手,开发友好 | 生产环境性能有限 | 快速原型验证 |
| LanceDB | 基于Lance格式 | 查询速度快,支持多模态 | 相对新兴 | 多模态RAG场景 |
| Weaviate | 混合搜索强 | 支持向量+标量混合检索 | 资源消耗较高 | 复杂检索需求 |
3.3 Qdrant:轻量级向量数据库实战
Qdrant是我最推荐的本地向量数据库——它部署简单、API友好、性能优秀,同时提供了成熟的云服务版本,方便未来扩展到云端。
Docker部署Qdrant(最简方式):
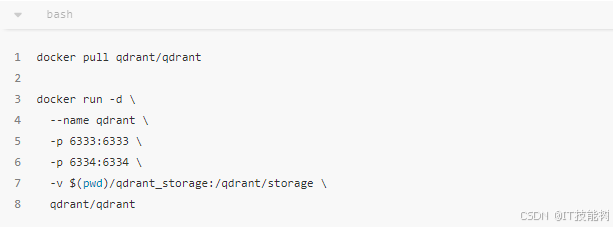
6333端口:REST API6334端口:gRPC API(性能更高)
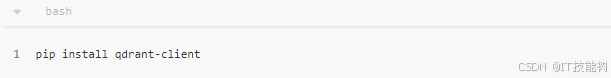
Python客户端使用:
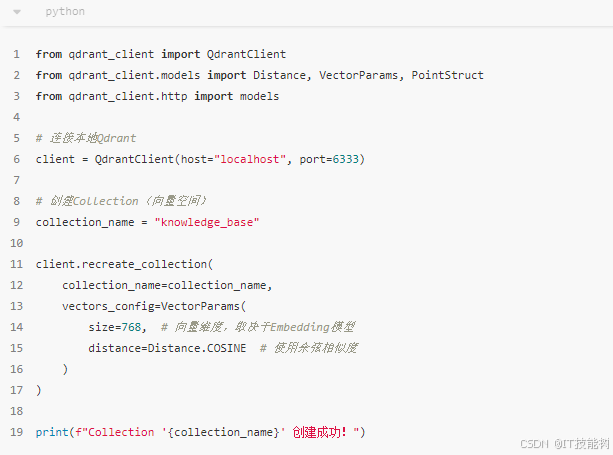
3.4 Embedding模型:从文本到向量
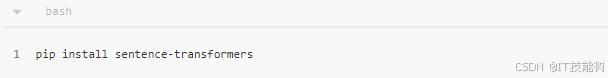
Sentence Transformers(SBERT)是目前最流行的开源Embedding模型,支持中文,且MIT许可证可商用。
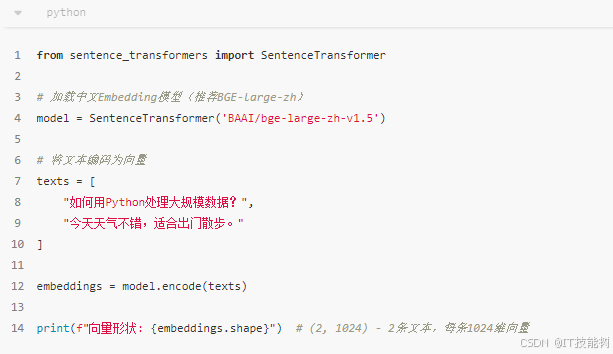
国产优秀Embedding模型推荐(BGE系列):
| 模型 | 维度 | 中文能力 | 许可证 | 适用场景 |
|---|---|---|---|---|
| BAAI/bge-large-zh-v1.5 | 1024 | 优秀 | MIT | 通用场景首选 |
| BAAI/bge-base-zh-v1.5 | 768 | 优秀 | MIT | 资源受限场景 |
| shibing624/text2vec-base-chinese | 768 | 良好 | Apache 2.0 | 轻量场景 |
3.5 完整RAG流程代码实战
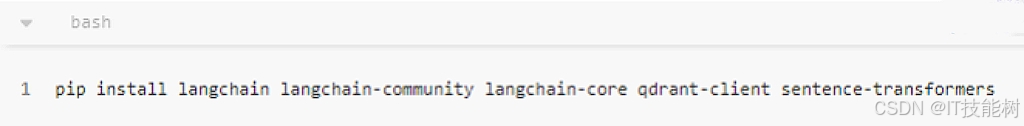
以下是一个完整的本地RAG系统实现(Ollama + Qdrant + LangChain):
四、Dify:全栈式LLM应用开发平台
4.1 Dify是什么
Dify(官网:dify.ai/,GitHub:htt…
Dify的核心能力:
- 可视化编排:拖拽式构建AI工作流
- 多模型集成:支持OpenAI、Claude、本地Ollama等数十种模型
- RAG引擎:内置完整的知识库管理流程
- Agent框架:支持构建多步骤AI代理
- API发布:一键将应用发布为API,供其他系统调用
Dify的定位介于"纯代码开发"和"纯SaaS"之间——它提供了足够灵活的可视化能力,同时保留了代码扩展的空间。
4.2 Docker快速部署Dify
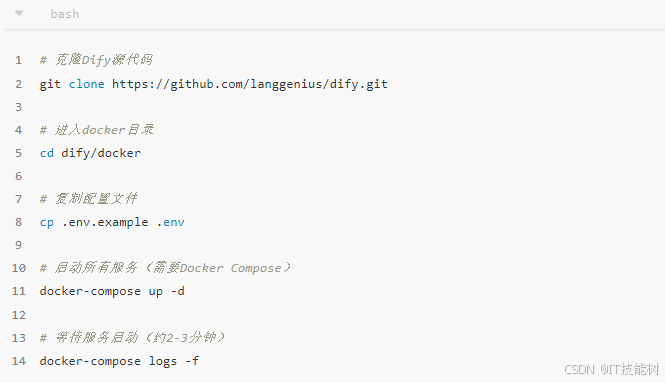
服务启动后,访问 http://你的服务器IP:80 即可打开Dify界面。
【图2:Dify工作流可视化编辑器截图,请自行截图。展示Dify中拖拽构建RAG流程的界面,来源:dify.ai/ 官网截图】
4.3 Dify知识库实战
步骤1:创建知识库
在Dify中创建知识库的操作非常直观:
- 进入「知识库」页面,点击「创建知识库」
- 上传文档(支持PDF、TXT、DOCX、Markdown等格式)
- 选择Embedding模型(推荐使用本地部署的BGE模型)
- 配置分块策略(块大小、重叠度)
- 确认并开始索引
步骤2:构建RAG应用
- 进入「工作室」,创建新应用(选择「Chatflow」或「Agent」)
- 接入知识库:在节点中选择「Knowledge Retrieval」节点
- 配置LLM:选择Ollama作为模型来源
- 设计提示词:编写RAG场景下的系统提示词,可能类似于:
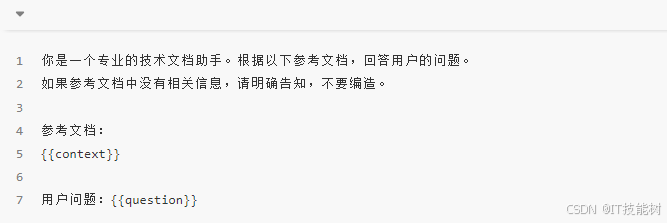
5.测试与发布
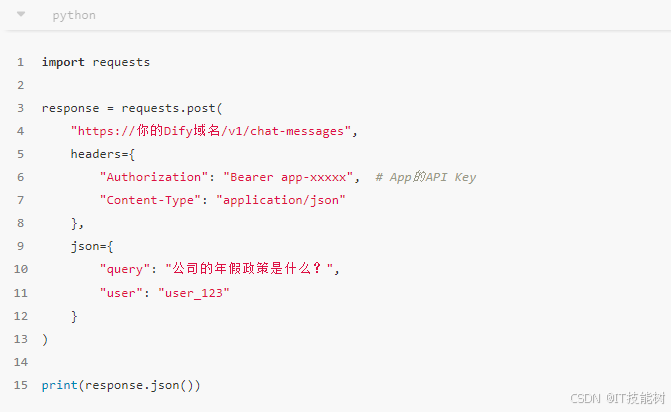
步骤3:通过API调用Dify应用
Dify应用可以一键发布为REST API:
4.4 Dify vs RAGFlow:关键区别
| 维度 | Dify | RAGFlow |
|---|---|---|
| 核心理念 | 全栈LLM应用平台 | 深度文档理解+RAG引擎 |
| 文档解析 | 基础文本提取 | 深度文档理解(表格、图表、公式) |
| 工作流 | 强大、灵活 | 相对简单 |
| RAG精度 | 良好 | 业界领先 |
| 学习曲线 | 中等 | 较低 |
| Agent能力 | 完善 | 较弱 |
| 适用人群 | 需要构建复杂AI应用的团队 | 以文档问答为核心需求的场景 |
五、RAGFlow:专注深度文档理解的RAG引擎
5.1 RAGFlow的核心优势
RAGFlow(GitHub:github.com/infiniflow/… in, quality out**(高质量输入,高质量输出)。
RAGFlow的核心差异化在于深度文档理解:
- 多模态文档解析:不仅提取文本,还能理解PDF中的表格、图表、公式、手写内容
- 智能分块:基于文档语义结构自动分块,而非简单的字符数切分
- 可视化审查:用户可以直观地看到文档被切成哪些块,每块的检索来源可追溯
- 混合检索:支持向量检索+关键词检索+知识图谱的多路召回
- 精确的引用溯源:生成的答案会标注引用来源,精确到具体的文档块
根据技术评测,在处理包含大量表格和图表的复杂PDF文档时,RAGFlow的问答准确率比传统RAG方案提升30%以上。
5.2 RAGFlow安装与部署
硬件要求:
- CPU: 4核以上
- 内存: 16GB以上(推荐32GB)
- 存储: 根据文档量,建议100GB以上
- 可选: NVIDIA GPU(用于加速文档解析和LLM推理)
Docker Compose部署:
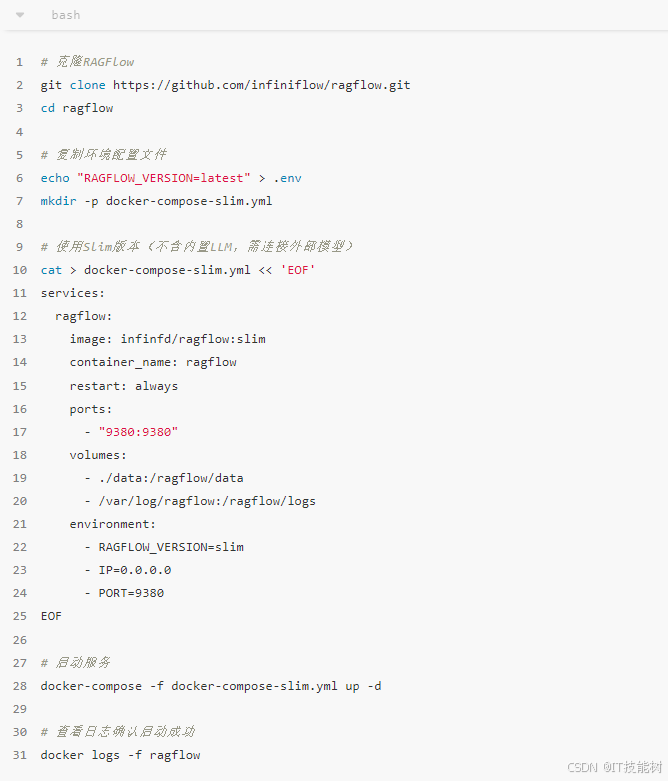
启动成功后,访问 http://你的服务器IP:9380 即可使用RAGFlow。
5.3 RAGFlow创建知识库
第一步:配置模型
RAGFlow需要配置Embedding模型和LLM模型。进入「系统设置」→「模型供应商」:
- Embedding模型:选择
BGE-large-zh(本地部署,通过Ollama或HuggingFace) - LLM模型:选择
Qwen2.5或DeepSeek-R1(通过Ollama)
第二步:上传文档
RAGFlow支持多种格式:PDF、Word、PPT、Excel、TXT、Markdown、HTML等。
上传后,RAGFlow会进行深度解析:
- 识别文档结构(标题、段落、列表)
- 提取表格内容并结构化
- 识别图表和图片中的文字
- 分析公式和符号
【图3:RAGFlow文档解析界面截图,请自行截图。展示上传PDF后RAGFlow的解析预览界面,来源:ragflow.io/ 官网截图】
第三步:配置分块策略
RAGFlow提供8种智能分块模板:
General:通用文档,适合书籍、论文Paper:学术论文,保留摘要和方法论结构Book:书籍,按章节和段落分块Manual:产品手册,保留操作步骤的完整性SOP:标准操作流程,保持步骤顺序Table:表格密集型文档,智能识别表头和行法律:法律文书,保留条款编号和层级Q&A:问答对,识别问题和答案的对应关系
第四步:对话测试
知识库创建完成后,进入「助理」页面,创建对话助手并关联知识库,即可进行问答测试。
RAGFlow实测问答效果:
以一份包含财务报表PDF为例进行测试:
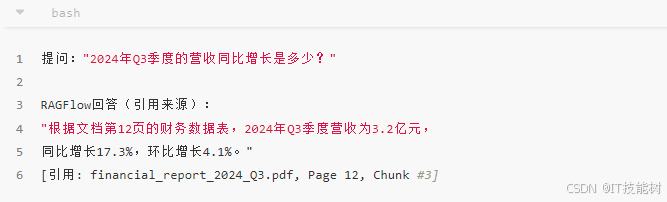
RAGFlow能够正确理解表格结构,定位到正确单元格的数据,并给出引用来源——这是传统RAG系统很难做到的。
六、多模态模型:本地部署视觉-语言模型
6.1 多模态模型概述
2025-2026年,多模态大模型(Large Multimodal Models, LMM)已经成为AI应用的另一核心方向。多模态模型能够同时理解和处理图像与文本,实现:
- 图片问答:上传图片,询问图片内容("这张图里有什么?")
- 视觉推理:基于图片进行逻辑推理和分析
- 多图对比:同时分析多张图片的异同
- 图表理解:从PDF、Excel截图中提取结构化信息
- 图文生成描述:为图片生成描述或标题
6.2 LLaVA:最流行的开源多模态模型
LLaVA(Large Language and Vision Assistant)是目前最流行的开源多模态模型之一,由微软研究院和威斯康星大学联合开发。
LLaVA的核心架构:
- 视觉编码器:使用CLIP的ViT(Vision Transformer)作为图像理解 backbone
- 语言模型:基于Vicuna或Llama等语言模型
- 连接层:一个线性投影层,将视觉特征映射到语言模型的输入空间
这种架构使得LLaVA能够将"看图"和"说话"结合起来。
通过Ollama运行LLaVA:
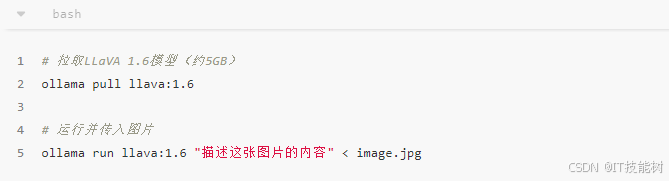
通过API调用LLaVA:
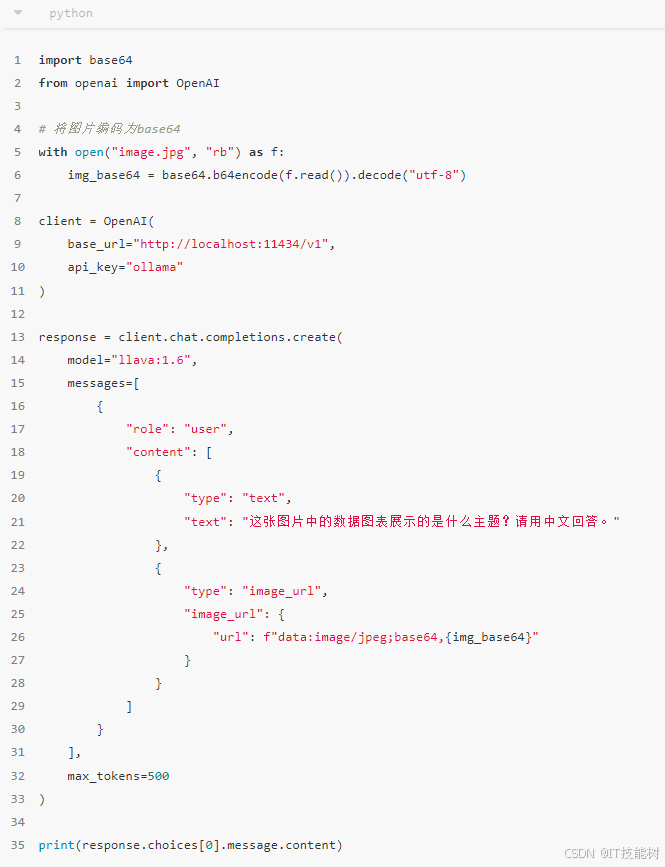
6.3 Qwen2-VL:中文优化的多模态模型
Qwen2-VL是阿里通义千问团队开源的多模态模型,在中文场景下表现优异,且支持超长图像输入(理论上支持72K token的图像)。
通过Ollama运行Qwen2-VL:
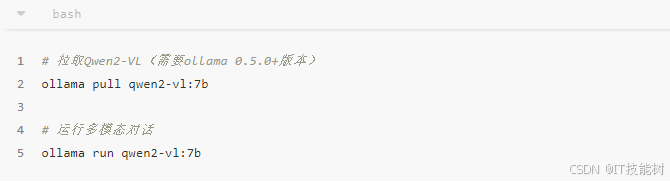
Qwen2-VL在中文OCR和中文图表理解方面,优于同级别的LLaVA模型,非常适合处理中文文档、截图和图表。
6.4 本地多模态RAG实战
结合多模态模型和RAG,可以构建支持图片和文本混合检索的知识库系统。以下是技术架构:
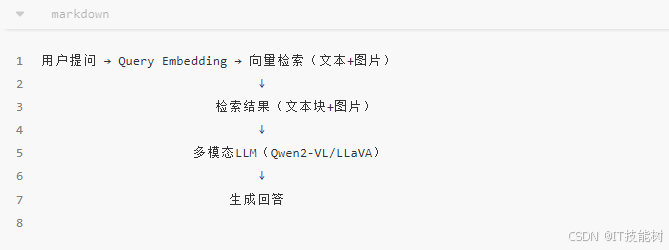
这种架构特别适合:
- 学术论文库(含图表、公式)
- 产品手册(含实物图、示意图)
- 设计文档(含UI截图)
- 医疗影像报告
七、性能优化:让本地AI跑得更快更省
7.1 GPU配置与选择
本地AI的性能瓶颈主要在显存(GPU)和内存(CPU)。
消费级GPU推荐(个人开发者):
| GPU | 显存 | 优势 | 劣势 |
|---|---|---|---|
| RTX 4090 | 24GB | 性价比最高,单卡最强 | 缺货,价格波动 |
| RTX 3090 | 24GB | 性价比尚可 | 较老,二手市场 |
| RTX 4080 Super | 16GB | 能效比高 | 16GB对大模型略小 |
| Apple M3 Max | 最高128GB统一内存 | Mac用户首选,内存大 | GPU算力弱于NVIDIA |
企业级GPU:
| GPU | 显存 | 适用场景 |
|---|---|---|
| NVIDIA A100 | 40/80GB | 70B以上大模型 |
| NVIDIA H100 | 80GB | 大规模推理 |
| NVIDIA L40S | 48GB | 企业级平衡方案 |
7.2 模型量化:用更少显存跑更大模型
**量化(Quantization)**是通过降低模型权重的精度(如从FP16→INT8→INT4)来减少显存占用和计算量的技术。
| 量化等级 | 精度损失 | 显存节省 | 推荐场景 |
|---|---|---|---|
| FP16(半精度) | 无 | 基准 | 追求质量 |
| INT8(8位整数) | 极小 | 50% | 平衡场景 |
| INT4(4位整数) | 可接受 | 75% | 显存受限 |
GGUF格式(由llama.cpp主导)是目前最流行的本地量化格式。Ollama可以直接使用GGUF格式的量化模型:
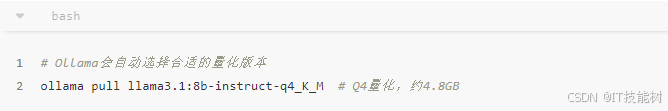
手动量化(使用llama.cpp):
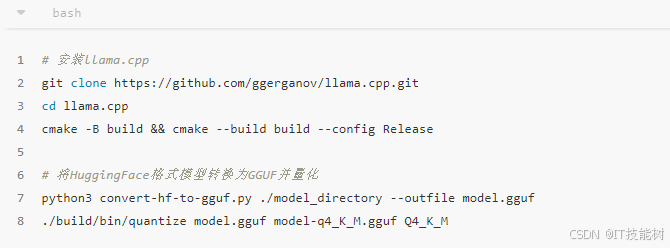
7.3 批处理与并发优化
vLLM(官网:vllm.ai/)是当前最高效的LLM…
vLLM安装:
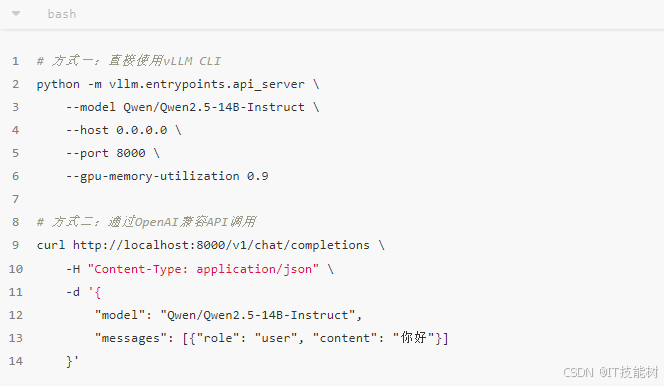
使用vLLM启动Ollama兼容API:
并发性能对比(实测数据):
| 引擎 | 并发请求数 | 平均响应时间 | 吞吐量(token/s) |
|---|---|---|---|
| Ollama | 5 | 8.2s | 45 |
| vLLM | 50 | 1.5s | 320 |
vLLM在高并发场景下性能是Ollama的6-7倍,是企业级部署的首选。
八、实战案例:搭建本地私有知识库
8.1 需求背景
假设你是一个技术团队的技术负责人,想要为团队搭建一个本地私有知识库,用于:
- 整合团队的技术文档、API文档、产品手册
- 支持新员工快速查找内部文档
- 所有数据必须本地存储,保证代码安全
8.2 技术方案选型
经过技术评估,选择以下方案:
| 组件 | 选型 | 理由 |
|---|---|---|
| LLM推理 | Ollama + Qwen2.5:14B | 中文能力强,部署简单 |
| Embedding | BGE-large-zh-v1.5(本地) | 中文优化,开源可商用 |
| 向量数据库 | Qdrant | 轻量高性能 |
| RAG框架 | LangChain | 最灵活,可深度定制 |
| 部署方式 | Docker Compose | 一键部署,环境隔离 |
8.3 Docker Compose完整配置
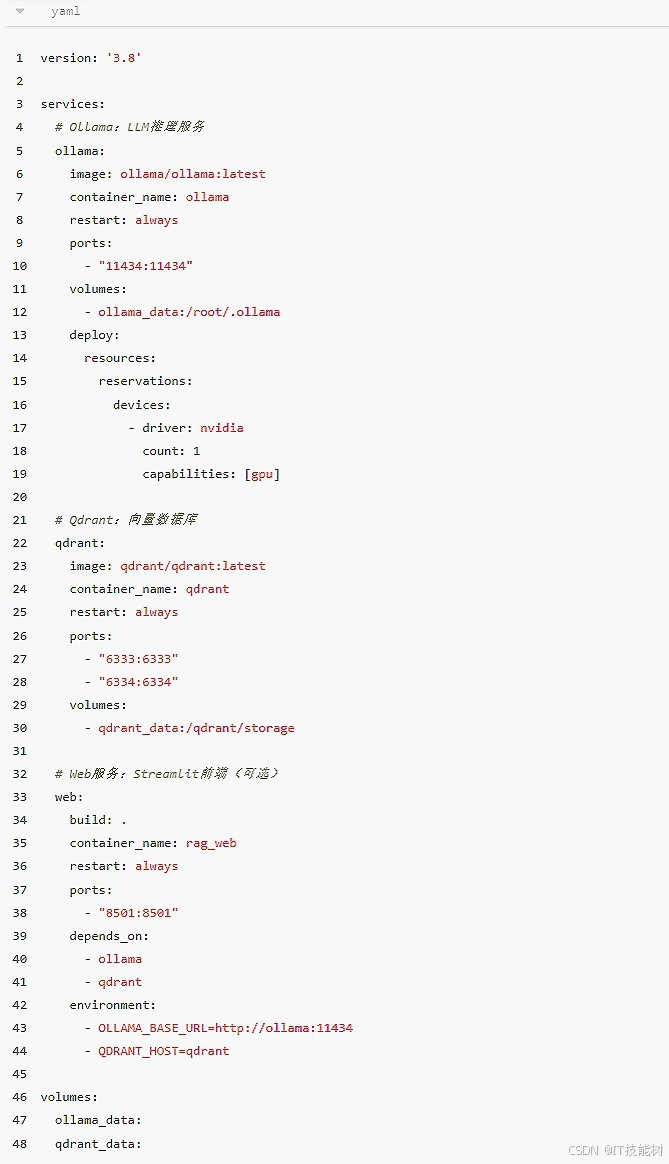
启动命令:
8.4 知识库核心代码
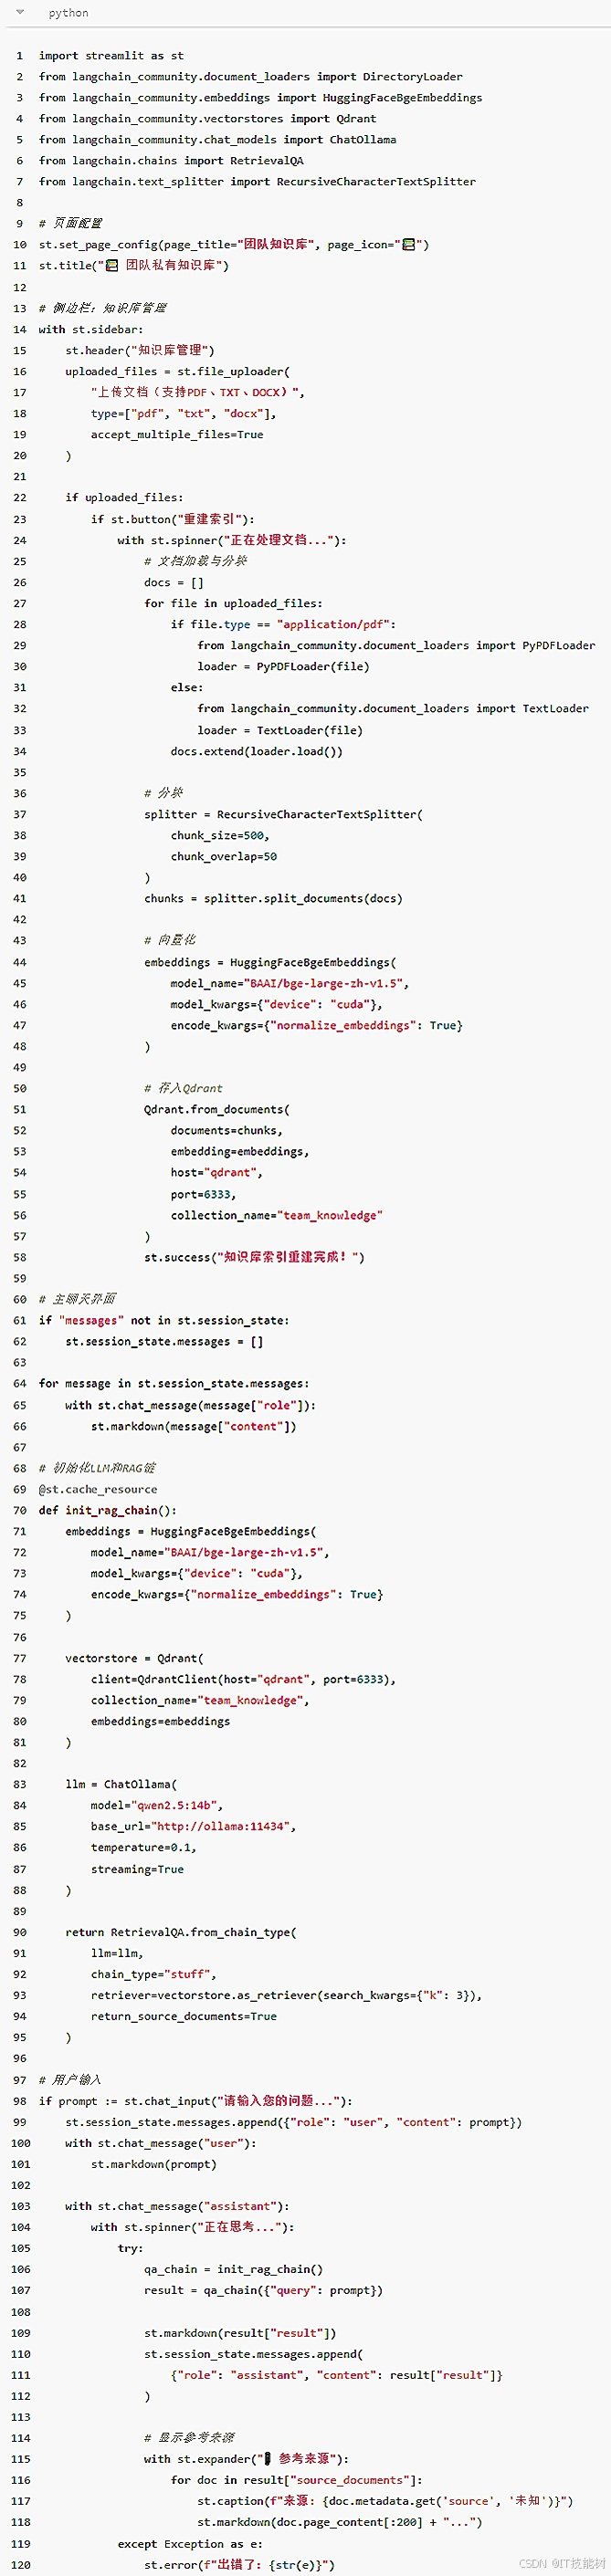
【图4:知识库Web界面截图,请自行截图。使用Streamlit构建的团队知识库问答界面,展示对话效果和参考来源功能】
九、本地AI的边界与未来
9.1 本地部署的能力边界
尽管本地AI在2026年已经取得了巨大的进步,我们仍然需要清醒地认识到它的局限性:
模型能力的上限受限于硬件:以消费级GPU为例,RTX 4090(24GB)能够本地运行的模型上限大约是30B-34B参数(INT4量化)。这与GPT-4o、Claude-3.5等顶级云端模型的水平仍有差距。
多模态能力相对薄弱:本地运行视觉-语言模型(如Qwen2-VL、LLaVA)虽然可行,但推理速度较慢,且对硬件要求较高。
无法像云端模型那样进行持续学习:本地模型的权重是固定的,无法像Claude/GPT那样从用户反馈中持续优化。
9.2 混合部署:最优解
当前最合理的工程实践是混合部署:
- 本地处理敏感数据:所有涉及隐私、机密的数据,通过本地Ollama/RAG处理
- 云端处理通用任务:翻译、润色、创意写作等非敏感任务,使用GPT/Claude等顶级云端模型
这种方案兼顾了数据安全性和模型能力,是目前企业级AI应用的主流架构。
9.3 未来趋势展望
展望2026-2027年,以下趋势值得关注:
- 推理引擎持续进化:vLLM、TGI等推理框架将持续优化,本地模型的推理效率将进一步提升
- 多模态RAG成为标配:向量数据库对图像、音频、视频的原生支持将逐步完善
- Agent与RAG深度融合:多步骤Agent将能够调用本地RAG知识库,实现更复杂的任务自动化
- 端侧AI加速:随着NPU(神经网络处理器)在消费级设备上的普及,未来甚至可以在手机和PC上运行小型多模态模型
结语
2026年,本地AI部署已经从"极客玩具"进化为"工程标配"。无论你是独立开发者想要保护项目代码,还是技术团队负责人需要构建私有知识库,或者企业决策者在评估AI合规方案——本地部署都已经成为你工具箱中不可或缺的一环。
本文覆盖了从Ollama入门、向量数据库选型、RAG框架搭建、多模态扩展到性能优化的完整链条。核心原则是从小处着手,快速验证,持续迭代——不要试图一次性构建完美的系统,而是从一个最小的可用版本开始,在实践中逐步优化。
本地AI的时代,已经到来。
资料展示
下面是我整理的AI大模型 学习资料和工具包 预览,适合收藏后按主题逐步学习

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献11条内容

所有评论(0)