【智能体】Agent的四种设计模式之:Reflection 模式
Reflection 模式 —— 自我批判与迭代进化的智能体
1、引言
小屌丝:小鱼,我又来诉苦了。我让 Agent 写了个排序函数,看着挺对,一跑测试,挂了五个。我丢给它报错信息,它说"哦我改",改完挂了八个……
小鱼:哈哈哈哈,经典!你这叫 “一错再错” 模式。模型第一次写代码,就像你第一次写简历——自我感觉良好,实际上漏洞百出。
小屌丝:那咋整?让它多写几遍?
小鱼:不是无脑重写,是让它 “写完先自己骂自己”。你想象一个场景:你写完代码,先不提交,而是站在审查者的角度挑刺——“这里没处理空指针”、“这里时间复杂度炸了”、“这里命名像坨屎”。挑完刺→再改→改完再挑→直到挑不出毛病。
小屌丝:自己骂自己?模型能这么自觉?
小鱼:这就是 Reflection(反思/自批判)模式。2026 年的数据显示,加了 Reflection 的 Agent,代码生成通过率能从 80% 干到 91%,而且不用微调模型,纯靠工程手段。
小屌丝:这么猛?快展开说说!
一句话定义:Reflection 是一种通过引入 Actor-Critic 架构,让智能体生成初稿后,由自身或独立评估器进行多维度批判,并根据反馈迭代优化输出的设计模式。
2、核心原理
2.1 Actor-Critic 双循环
Reflection 模式借鉴了强化学习中的 Actor-Critic 框架,但在 LLM 时代被重新诠释
┌─────────────────────────────────────────┐
│  Actor(执行者)                         │
│  ├─ 接收任务输入                        │
│  ├─ 生成初始输出(代码/文本/分析)       │
│  └─ 根据 Critic 反馈修改输出            │
└─────────────────────────────────────────┘
                    ↓
┌─────────────────────────────────────────┐
│  Critic(批判者)                        │
│  ├─ 接收 Actor 的输出                   │
│  ├─ 按预设标准(Rubric)评估质量         │
│  ├─ 指出具体问题(位置+原因+建议)       │
│  └─ 输出结构化反馈                      │
└─────────────────────────────────────────┘
                    ↓
         是否通过评估?
            /        \
          是          否
          /            \
    输出答案      返回 Actor 迭代(最多 N 次)
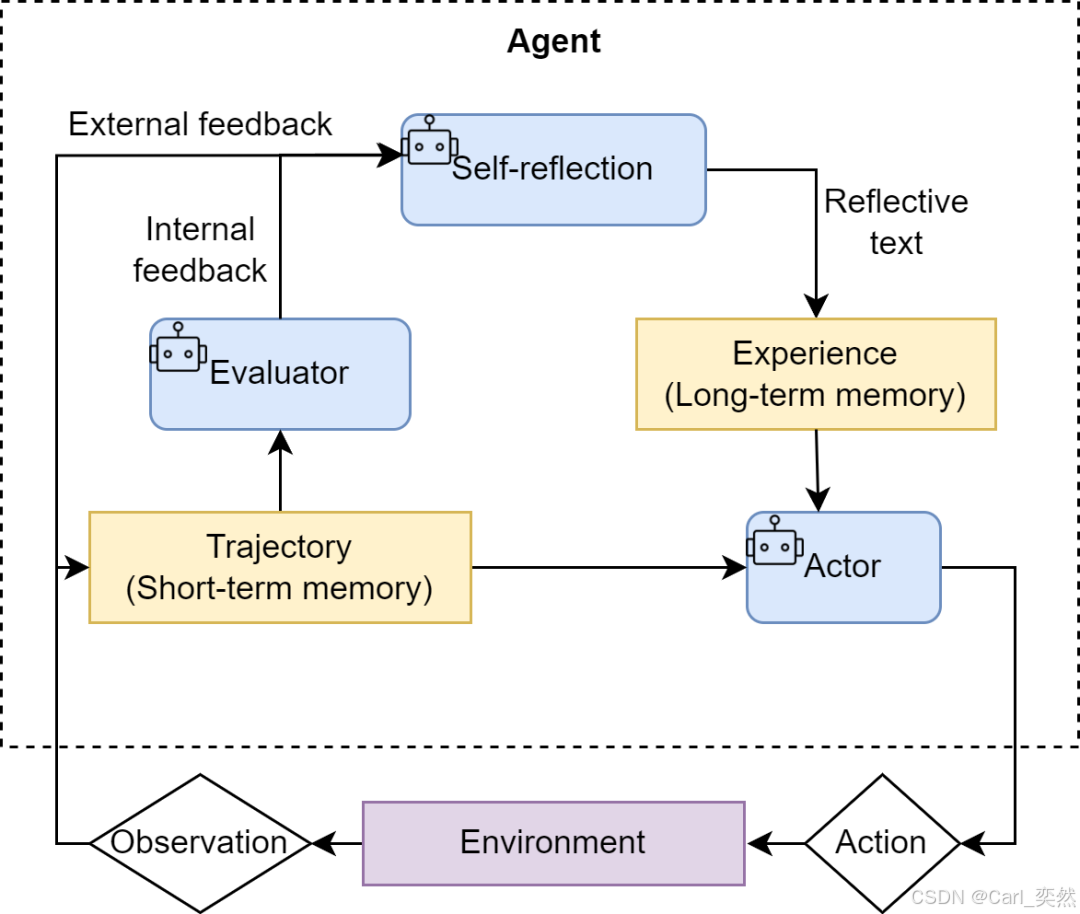
2.2 批判维度(Rubric Design)
2026 年的最佳实践表明,批判标准的质量直接决定 Reflection 的效果。一个完整的 Rubric 通常包含以下维度:
| 维度 | 权重 | 检查点 |
|---|---|---|
| 正确性 | 40% | 事实错误、逻辑矛盾、计算错误 |
| 完整性 | 20% | 是否遗漏需求、边界条件是否覆盖 |
| 安全性 | 20% | 是否有 SQL 注入、XSS、敏感信息泄露 |
| 风格规范 | 10% | 是否符合团队代码规范、文档标准 |
| 性能 | 10% | 时间/空间复杂度是否合理 |
3、代码实例(生产级)
以下是一个结合 单元测试作为外部验证器 的 Reflection Agent。这是 2026 年最成熟的落地场景
# 2026 年生产级 Reflection Agent(代码生成 + 单元测试验证)
from typing import TypedDict, Annotated, Sequence
import operator
from langgraph.graph import StateGraph, END
from langchain_openai import ChatOpenAI
from pydantic import BaseModel, Field
import subprocess
import tempfile
import os

# ========== 1. 状态定义 ==========
class ReflectionState(TypedDict):
    task: str                    # 原始任务描述
    code: str                    # 当前代码版本
    test_cases: str              # 测试用例
    critique: str                # 批判意见
    iteration: int               # 当前迭代次数
    max_iterations: int          # 最大迭代次数
    passed_tests: bool           # 是否通过测试
    trace_id: str

# ========== 2. 结构化输出定义(2026 年最佳实践) ==========
class CritiqueOutput(BaseModel):
    """Critic 的结构化输出"""
    passed: bool = Field(description="是否通过所有检查")
    score: float = Field(description="综合评分 0-100")
    issues: list[dict] = Field(description="问题列表,每项包含:location, severity, description, suggestion")
    summary: str = Field(description="总体评价")

class CodeOutput(BaseModel):
    """Actor 的结构化输出"""
    code: str = Field(description="生成的代码")
    explanation: str = Field(description="代码设计思路")

# ========== 3. Actor 节点:生成/修改代码 ==========
async def actor_node(state: ReflectionState, llm: ChatOpenAI):
    """Actor:根据任务和批判意见生成或修改代码"""

    system_prompt = """你是一位资深 Python 工程师。你的任务是生成高质量、可运行的代码。
规则:
1. 代码必须包含完整的函数实现
2. 必须处理边界条件和异常
3. 如果收到批判反馈,必须针对性修改
4. 只输出代码,不要输出测试用例
"""

    messages = [
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": f"任务:{state['task']}"}
    ]

    # 如果有历史批判,追加到上下文
    if state["critique"]:
        messages.append({
            "role": "user",
            "content": f"上次批判意见(请针对性修改):\n{state['critique']}"
        })

    # 使用结构化输出(2026 年标准)
    structured_llm = llm.with_structured_output(CodeOutput)
    result = await structured_llm.ainvoke(messages)

    return {
        "code": result.code,
        "iteration": 1 if state["iteration"] == 0 else 0
    }

# ========== 4. Critic 节点:多维度批判 ==========
async def critic_node(state: ReflectionState, llm: ChatOpenAI):
    """Critic:对代码进行多维度评估"""

    system_prompt = """你是一位严格的代码审查专家。请对以下代码进行全面评估。
评估维度:
1. 正确性:是否能正确实现需求?
2. 边界条件:是否处理了空输入、异常值?
3. 性能:时间复杂度是否合理?
4. 安全性:是否有注入风险或资源泄露?
5. 风格:是否符合 PEP8?

输出严格的 JSON 格式,包含 passed, score, issues[], summary。
"""

    messages = [
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": f"任务:{state['task']}\n\n代码:\n```python\n{state['code']}\n```"}
    ]

    structured_llm = llm.with_structured_output(CritiqueOutput)
    critique = await structured_llm.ainvoke(messages)

    return {
        "critique": critique.summary + "\n" + str(critique.issues),
        "passed_tests": critique.passed and critique.score >= 90
    }

# ========== 5. 外部验证器:单元测试执行 ==========
async def external_validator(state: ReflectionState):
    """外部验证器:运行单元测试,提供客观反馈"""
    if not state["test_cases"]:
        return {"passed_tests": state["passed_tests"]}

    # 创建临时文件运行测试
    with tempfile.NamedTemporaryFile(mode='w', suffix='.py', delete=False) as f:
        f.write(state["code"] + "\n\n" + state["test_cases"])
        temp_path = f.name

    try:
        result = subprocess.run(
            ['python', '-m', 'pytest', temp_path, '-v'],
            capture_output=True,
            text=True,
            timeout=30
        )
        passed = result.returncode == 0
    except Exception:
        passed = False
    finally:
        os.unlink(temp_path)

    # 如果单元测试失败,覆盖 Critic 的 passed 状态
    return {
        "passed_tests": passed,
        "critique": state["critique"] + f"\n[单元测试结果]: {'通过' if passed else '失败'}\n{result.stdout if not passed else ''}"
    }

# ========== 6. 构建 LangGraph ==========
def build_reflection_agent(llm: ChatOpenAI):
    workflow = StateGraph(ReflectionState)

    workflow.add_node("actor", lambda state: actor_node(state, llm))
    workflow.add_node("critic", lambda state: critic_node(state, llm))
    workflow.add_node("validator", external_validator)

    workflow.set_entry_point("actor")
    workflow.add_edge("actor", "critic")
    workflow.add_edge("critic", "validator")

    # 条件边:通过测试则结束,否则返回 Actor(最多 max_iterations 次)
    def should_continue(state):
        if state["passed_tests"] or state["iteration"] >= state["max_iterations"]:
            return END
        return "actor"

    workflow.add_conditional_edges("validator", should_continue, {"actor": "actor", END: END})

    return workflow.compile()

# ========== 7. 运行示例 ==========
async def main():
    llm = ChatOpenAI(model="gpt-5", temperature=0.2)
    app = build_reflection_agent(llm)

    result = await app.ainvoke({
        "task": "实现一个函数,接收整数列表,返回其中位数。要求时间复杂度 O(n log n) 或更优。",
        "test_cases": """
def test_median():
    assert median([1, 3, 2]) == 2
    assert median([1, 2, 3, 4]) == 2.5
    assert median([]) == None
    assert median([5]) == 5
""",
        "code": "",
        "critique": "",
        "iteration": 0,
        "max_iterations": 3,  # 最多迭代 3 次
        "passed_tests": False,
        "trace_id": "reflection-001"
    })

    print(f"最终代码:\n{result['code']}")
    print(f"迭代次数:{result['iteration']}")
    print(f"是否通过:{result['passed_tests']}")

if __name__ == "__main__":
    import asyncio
    asyncio.run(main())
4、2026 年的三种 Reflection 变体
4.1 Self-Refine(自我精炼)
最简单形式:同一个 LLM 实例,先以 Actor 角色生成,再以 Critic 角色批判,最后以 Refiner 角色修改。无需外部验证器,适用于文本生成、邮件润色等低 stakes 场景。
成本:最低(2-3 次 LLM 调用)
效果:质量提升约 20% 绝对值
4.2 Reflexion(带记忆的自反思)
2023 年论文提出的增强版。关键创新是 “记忆持久化”:每次 Reflection 的结果(特别是失败经验)被存入向量数据库,后续遇到相似任务时自动检索相关经验。
# Reflexion 记忆持久化示意
from langchain_chroma import Chroma  # 2026 年向量库标准

def store_reflection(task_embedding, reflection, success):
    """将反思存入记忆"""
    db.add_texts(
        texts=[reflection],
        metadatas=[{
            "task_hash": hash_task(task_embedding),
            "success": success,
            "timestamp": datetime.utcnow().isoformat()
        }]
    )

def retrieve_reflections(task_embedding, k=3):
    """检索相似任务的历史反思"""
    return db.similarity_search_by_vector(task_embedding, k=k,
                                          filter={"success": False})  # 优先检索失败经验
4.3 Multi-Critic Debate(多批判者辩论)
2026 年的前沿实践。引入 多个不同视角的 Critic(如安全专家、性能专家、业务专家),各自独立评估,最后由 Aggregator 综合意见。这本质上是将 Reflection 与 Multi-Agent 模式结合。
5、适用场景与成本分析
| 场景 | 推荐度 | 原因 |
|---|---|---|
| 代码生成 | ⭐⭐⭐⭐⭐ | 单元测试提供客观验证标准 |
| 数学推理 | ⭐⭐⭐⭐⭐ | 答案可精确验证 |
| 内容审核 | ⭐⭐⭐⭐ | 需符合合规标准,多轮检查必要 |
| 创意写作 | ⭐⭐ | 质量主观,难以定义 Rubric |
| 实时问答 | ⭐ | 延迟敏感,不适合多轮迭代 |
成本对比
| 模式 | 平均延迟 | Token 开销 | 单次成本 |
|---|---|---|---|
| 直接生成 | 1-2s | 基线 | $0.01-0.02 |
| Self-Refine(2 轮) | 8-15s | +100-200% | $0.08-0.12 |
| Reflexion(含记忆检索) | 10-18s | +150-250% | $0.10-0.15 |
| Multi-Critic | 15-25s | +300-500% | $0.15-0.25 |
6、总结
Reflection 模式是 Agent 质量的 “最后防线”。在 2026 年,它已经从简单的"让模型再想想"进化为 结构化、可度量、可记忆 的工程实践。
核心记忆点:
- 必须绑定外部验证器(单元测试、静态分析、人工审核)
- Rubric 设计决定上限 —— 投入 50% 精力设计评估标准
- Reflexion 记忆 让 Agent 越用越聪明
- 不要用于延迟敏感场景(平均增加 8-15s)
- 不要用于主观质量任务(没有客观标准时效果有限)
我是小鱼:
- CSDN 博客专家;
- AIGC 技术MVP专家;
- 阿里云 专家博主;
- 51CTO博客专家;
- 企业认证金牌面试官;
- 多个名企认证&特邀讲师等;
- 名企签约职场面试培训、职场规划师;
- 多个国内主流技术社区的认证专家博主;
- 多款主流产品(阿里云等)评测一等奖获得者;

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)