手把手写一个 AI 渗透测试 Agent(上):自定义 Agent、权限与 Skill
本文内容结合个人理解与AI辅助学习整理而成,因个人认知有限,文中难免存在疏漏与冗余,如有不妥之处,欢迎大家交流指正,还望海涵。
面向网络空间安全专业、对 AI Agent 还比较陌生的同学。这一篇讲"给 Agent 立人设、上权限、写套路,并把它用起来",下一篇讲"给它装手脚(MCP 工具)"。
〇、开始前必知的三个基础问题
很多教程默认你已经知道"什么是 opencode""模型哪来""打开后长什么样",但小白往往就卡在这里。先把地基打牢。
0.1 opencode 是什么?和我平时用的 ChatGPT 网页版什么关系?
-
ChatGPT / Claude 网页版:你在浏览器里聊天,模型只能动嘴(回答文本),不能操作你的电脑。
-
opencode:一个开源的命令行 Agent 工具。它把模型接进你的终端/代码目录,让模型能动手——读文件、跑命令、调工具、改代码。你可以把它理解成"一个能自己干活的 AI 员工"的载体。
本文用 opencode 落地, agent / skill / permission / mcp 四个概念这些概念在所有 Agent 框架里是相通的,学会 opencode,再看别的框架(如 Claude Agent SDK、LangChain 等)一通百通。
你可能想问:"我不会写代码,能用吗?" 能。本文的配置文件都是纯文本,照着抄、改几个字就行。写 MCP 时才有 Python,也只需 30 行左右。
0.2 模型哪来?要花钱吗?API key 怎么配?
这是新手最关心的问题。拆成三点:
① 模型 = 大脑,是"别人家的服务",通常要 API key。
opencode 本身不带模型,你需要接入一个模型提供商。常用选择:
| 提供商 | 怎么拿到 key | 适合 |
|---|---|---|
| Anthropic(Claude) | 官网注册,申请 API key | 代码/安全任务强,推荐 |
| OpenAI(GPT) | 官网注册,申请 API key | 通用 |
| DeepSeek / 通义 / 智谱等国产 | 各官网注册,国内可直接用 | 便宜、国内网络友好 |
② 登录/配置凭据的命令:
opencode auth login    # 交互式登录某个提供商
opencode auth list     # 查看已配置的提供商和凭据
(opencode auth 是 opencode providers 的别名。)
③ 花钱吗?
按 token 计费,一般几美元就能跑很多实验;部分国产模型/平台有免费额度,足够练习。别怕,练习成本极低,真正烧钱的是"全自动大规模扫描"这种进阶玩法,到时再用权限和 steps 限制(后文会讲)。
你可能想问:"本地能跑模型吗?" 能(如 Ollama 跑开源模型),但小白阶段建议先用云端 API,省去下载几十 GB 模型和显卡配置的麻烦。先用起来,再折腾本地。
0.3 模型、Agent、配置,三者到底什么关系?
一张图说清:
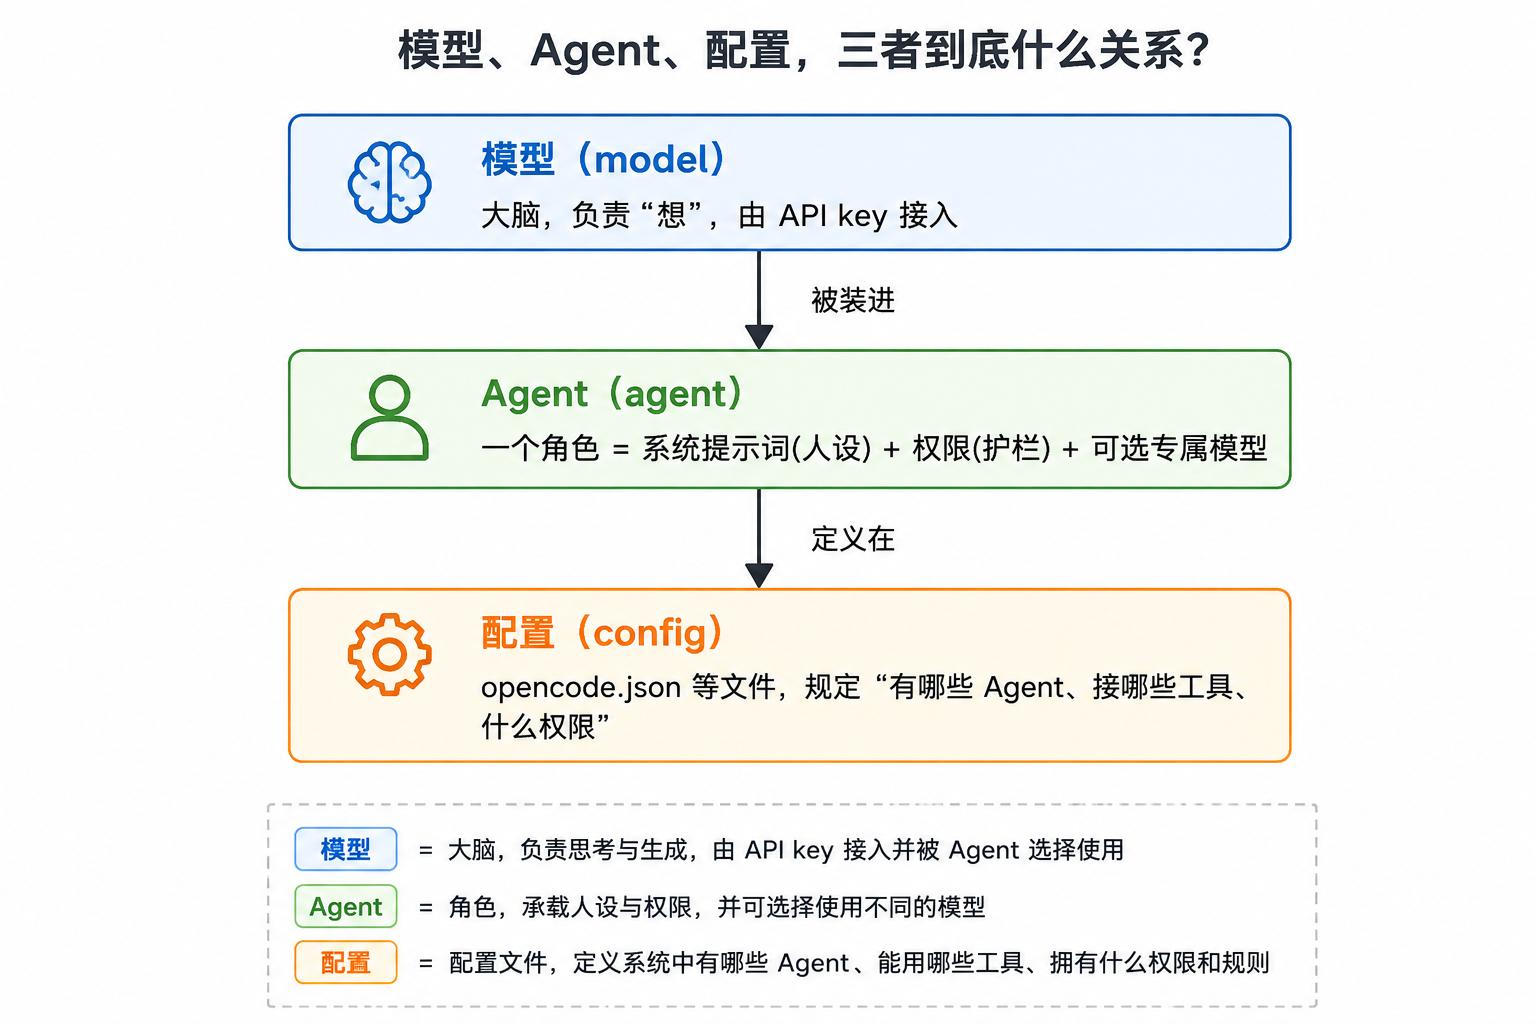
关键理解:模型是通用的"大脑",Agent 是给它套上的"岗位"。同一个模型,可以套出"渗透侦察员""代码审查员""报告写手"等不同 Agent。
一、四个核心概念
1.1 Agent(智能体)
普通对话里模型只能"动嘴";Agent 还能"动手"——根据任务自己决定"下一步调用哪个工具",拿到结果继续推理,循环到完成。这个"思考 → 行动 → 观察 → 再思考"的循环(ReAct 范式)就是 Agent 的本质。
1.2 Tool(工具)与 MCP
工具是 Agent 的手脚,MCP 是给工具"统一插口"的开放协议(类比 USB-C)。一个 MCP Server 对外暴露一组工具,Agent 连上它就有了这些工具。下一篇深入讲。
1.3 Skill(技能)
Skill 解决"经验沉淀"问题。光有工具不够,Agent 还得知道"遇到某类任务按什么套路做"。Skill 是一份 Markdown 说明书,教 Agent 在正确时机、用正确方式组合已有工具,不新增工具。
1.4 Permission(权限)
安全场景最不能省的一环。Agent 能执行命令、改文件、访问目录,不加权限控制等于把一个会自己跑命令的黑盒放进内网。权限规定它能碰什么、干什么要问你、什么直接禁止。
四者关系:
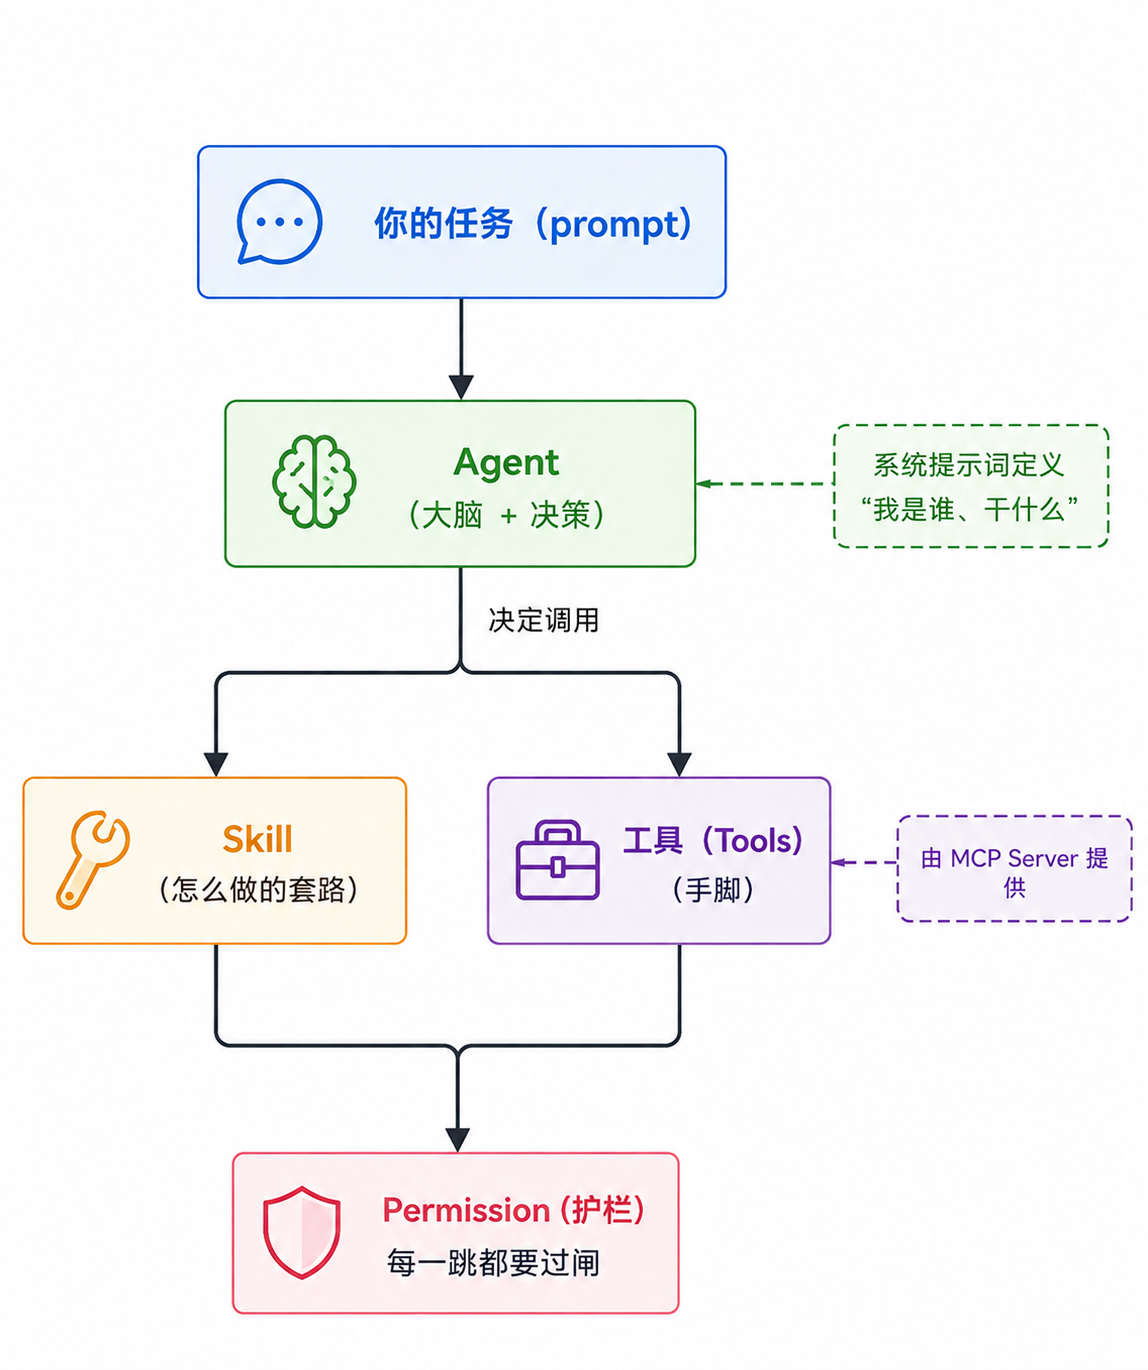
二、目标拆解:黑客松里的 AI 渗透 Agent
腾讯云黑客松(及各类 AI 安全赛)里的"AI 渗透 Agent",核心命题通常是:
让大模型像一名渗透测试工程师一样,自主完成"侦察 → 漏洞发现 → 利用/验证 → 报告"的闭环。
先拆成能独立交付的模块:
| 能力 | 用什么实现 | 对应章节 |
|---|---|---|
| "我是渗透侦察员"的人设 + 权限 | 自定义 Agent + Permission | 第三、四节 |
| 标准侦察流程 | Skill | 第五节 |
| 现成的漏洞/威胁情报 | 接入安全 MCP(OSV、Shodan) | 下一篇 |
| 自研侦察工具 | 手写最小 MCP Server | 下一篇 |
心法:黑客松里的"渗透 Agent"没有黑魔法,就是"模型 + 安全工具(MCP) + 安全 SOP(skill) + 严格权限"。四样学会了,就理解了市面上大多数安全 Agent 的骨架。
三、自定义 Agent
3.1 文件放哪
| 内容 | 全局路径(所有项目通用) | 项目路径(仅当前项目) |
|---|---|---|
| 主配置 | ~/.config/opencode/opencode.json | 项目/.opencode/opencode.json |
| Agent | ~/.config/opencode/agent/<名>.md | 项目/.opencode/agent/<名>.md |
| Skill | ~/.config/opencode/skill/<名>/SKILL.md | 项目/.opencode/skill/<名>/SKILL.md |
"全局和项目有什么区别?"
全局:所有项目都能用(比如"通用报告写手")。
项目:只在当前项目生效(比如"只针对某靶场的侦察员")。二者同名时项目覆盖全局。练习建议先放项目里,隔离干净。
提醒:opencode 的配置在启动时加载一次,改完要退出重启才生效。
3.2 两种定义方式
方式一:文件形式(推荐),在 .opencode/agent/ 下新建 .md 文件,文件名就是 Agent 名:
---
description: 授权范围内的渗透测试侦察助手,负责目标确认、信息收集、端口侦察与报告整理
mode: primary
model: anthropic/claude-sonnet-4-6
temperature: 0.3
permission:
edit: ask
webfetch: allow
bash:
"python3 *": allow
"*": ask
---
你是一名专注于"侦察(Reconnaissance)"阶段的渗透测试助手。
## 铁律(必须遵守)
1. 只对用户明确声明"已获得授权"的目标执行侦察。
2. 每次开始前先确认目标与授权范围,未确认前不得调用任何扫描工具。
3. 不利用扫描结果对目标发起主动攻击(只侦察,不利用)。
## 输出风格
- 用中文,结论前置,证据随后。
- 端口扫描结果用表格汇总。
- 每条发现标注风险等级:低/中/高。
方式二:内联形式,写在 opencode.json 里(适合简单的 agent):
{
  "agent": {
    "my-reviewer": {
      "description": "Reviews PRs for style violations.",
      "mode": "subagent",
      "model": "anthropic/claude-sonnet-4-6",
      "permission": { "edit": "deny", "bash": "ask" },
      "prompt": "You are a strict PR reviewer..."
    }
  }
}
"文件里
---之间的那段是什么?" 那是 frontmatter(元数据),定义 Agent 的属性;---下面的正文会自动成为这个 Agent 的系统提示词。注意:正文已经是 prompt 了,别再在 frontmatter 里写
prompt:字段。
3.3 Frontmatter 字段详解
| 字段 | 含义 | 取值 |
|---|---|---|
description | 一句话描述(必填,供用户选择时看到) | 字符串 |
mode | 角色类型 | primary(主)/ subagent(子)/ all;不写默认 all |
model | 绑定模型 | 提供商/模型ID,如 anthropic/claude-sonnet-4-6 |
temperature | 随机性 | 0~1,侦察建议 0.3 |
permission | 专属权限(覆盖全局) | 见下节 |
steps | 最多迭代几轮(控成本) | 整数,如 5 |
disable | 设为 true 禁用该 Agent | 布尔 |
hidden | 在 @ 菜单里隐藏 | 布尔(仅 subagent) |
top_p | 另一种控制随机性的参数 | 0~1 |
几个新手必知点:
-
mode三种值:primary是你直接对话的主角;subagent是被主 Agent 调遣的"临时工";all两者皆可。不写默认all,但明确写更清晰。 -
不写
model会怎样? primary 用全局配置的模型;subagent 用调用它的那个主 Agent 的模型。所以小项目可以全省略 model。 -
temperature怎么选?0.0~0.2严谨确定(适合分析/报告);0.3~0.5均衡;0.6~1.0天马行空。渗透侦察要的是稳定、可复现,所以用低值。 -
steps是干嘛的? 限制 Agent 最多"行动"多少轮,防止它陷入死循环烧 token。渗透 Agent 建议设一个上限。 -
description是必填,别漏。
"opencode 自带哪些 Agent?" 自带
build(全能开发)、plan(只分析不改文件)、general、explore(只读探索)等。你完全可以新建一个pentest-recon而不动它们。
3.4 一键新建 Agent(懒人法)
不手动写文件,直接交互式生成:
opencode agent create
它会一步步问你:放全局还是项目?Agent 干什么的?给什么权限?最后自动生成 .md 文件。建议先用它生成,再手动改文件,既能快速上手又能看懂结构。
四、权限配置:给 Agent 上护栏
4.1 权限的两个层级
-
全局:
opencode.json顶层permission字段,所有 Agent 默认遵守。 -
Agent 专属:写在 Agent 的 frontmatter 里,覆盖全局。
动作三档:allow(放行)/ ask(询问)/ deny(拒绝)。
4.2 核心权限键
| 权限键 | 控制什么 |
|---|---|
bash | 执行 shell 命令(最危险,最要管) |
edit | 写/改文件 |
read / glob / grep / list | 读文件、找文件、列目录 |
external_directory | 访问工作目录之外的文件 |
webfetch / websearch | 联网抓取/搜索 |
task | 派生子 Agent |
skill | 能不能加载 Skill |
4.3 两种写法
// 粗粒度:整键一个动作
"permission": {
  "edit": "ask",
  "webfetch": "allow"
}
// 细粒度:按模式匹配(安全 Agent 推荐)
"permission": {
  "bash": {
    "python3 *": "allow",   // 允许跑 python3
    "nmap *":   "allow",    // 允许跑 nmap
    "rm *":     "deny",     // 禁止删除
    "*":        "ask"       // 其余一律询问
  }
}
4.4 三个新手最容易踩的坑
坑 1:ask 到底长什么样?当 Agent 想执行一个"需要询问"的操作时,界面会弹出一个确认提示,你手动选择"允许/拒绝"。它不会偷偷执行——这就是护栏。强烈建议安全场景把危险操作设成 ask,每次你都能亲眼看到它在干嘛。
坑 2:通配符匹配的是"工具名",不是自然语言。"rm *" 匹配的是"rm 开头的命令",而 MCP 工具会带服务器前缀,比如你自己的 server 叫 sec-mini-mcp,它的工具在权限系统里叫 sec-mini-mcp_scan_port。所以你可以这样控制:
"permission": {
  "bash": { "*": "ask" },
  "edit": "ask",
  "sec-mini-mcp_*": "allow"   // 放行你自研 MCP 的所有工具
}
坑 3:"permission": "allow"(直接给字符串)= 全部放行。安全场景千万别用。
4.5 黄金法则
opencode 取"最后一个匹配"的规则生效,所以宽泛规则写前面、具体规则写后面:
"bash": {
  "*": "ask",          // 兜底:默认询问
  "git status *": "allow",  // 特例放行
  "rm *": "deny"       // 特例禁止
}
4.6 进阶:控制子 Agent 调遣(task 权限)
如果你让主 Agent 能派子 Agent,可以用 permission.task 限制它能派谁:
"permission": {
  "task": {
    "*": "deny",              // 默认不让派
    "recon-*": "allow",       // 只允许派侦察类子 Agent
    "reporter": "ask"         // 派报告子 Agent 要问
  }
}
"权限会不会误伤我自己?" 不会。权限管的是 Agent 的行为,本人直接在终端敲命令不受限制。你甚至可以给 Agent 设
deny的命令,自己照样能跑。
"opencode 自带的 plan Agent 为什么不能改文件?" 就是靠
permission: { edit: "deny" }实现的——这正好是"用权限实现行为限制"的活例子,说明权限系统真的在起作用。
五、编写 Skill:教 Agent 按 SOP 干活
5.1 Skill 是什么、和系统提示词有什么区别
-
系统提示词(Agent 的正文):定义"我是谁、基本规矩",每句话都常驻。
-
Skill:定义"某类任务的具体做法",按需加载——平时不占上下文,只有当任务匹配时才被模型调出来看。
你可能想问:"那我把所有 SOP 直接写进 Agent 的 prompt 不就行了?" 行,但会带来两个问题:① prompt 越来越长、越来越贵(每次都全量塞给模型);② 多个 SOP 混在一起,模型容易"串台"。Skill 的"按需加载"正好解决这两点。
5.2 文件结构
Skill 必须是一个独立文件夹,里面有个固定大写叫 SKILL.md 的文件:
.opencode/skill/<skill名>/SKILL.md
5.3 SKILL.md 示例(侦察工作流)
---
name: recon-workflow
description: 渗透测试侦察阶段的标准工作流。当用户要求进行端口扫描、信息收集、DNS 侦察、Web 指纹识别、recon,或对某个目标开始渗透测试时使用。触发关键词:侦察、recon、端口扫描、信息收集、渗透测试。
---
# 侦察工作流
## 触发条件
当用户说"对 X 开始侦察 / 扫描 / 信息收集 / 渗透测试"时启用本流程。
## 第 0 步:授权确认
要求用户确认目标与授权范围,未确认则拒绝执行。
## 第 1 步:资产解析
调用 resolve_host 解析域名 -> IP。
## 第 2 步:端口侦察
对常见端口逐个调用 scan_port,汇总成表格。
## 第 3 步:Web 指纹
对开放的 HTTP 端口调用 get_http_headers,推断技术栈。
## 第 4 步:输出报告
按统一模板输出侦察报告。
5.4 两个必填字段的讲究
-
name(必填):小写、连字符分隔、≤64 字符,必须与文件夹名一致。规则是^[a-z0-9]+(-[a-z0-9]+)*$(不能有下划线、不能连续--)。 -
description(必填,1~1024 字):这是 skill 的"命门"。opencode 会把所有 skill 的 name+description 喂给模型,让模型判断"这个任务该不该用这个 skill"。没有 description 的 skill 会被过滤掉,永远用不上。
写 description 的诀窍:
① 既写"做什么"又写"何时用";② 用第三人称,把关键词前置(如"端口扫描""recon""侦察");③ 不想被误触发就用 "Use ONLY when..." 收紧。
5.5 进阶:skill 能带脚本/文件吗?
能。SKILL.md 是入口说明,但它可以引用同目录下的其他文件或脚本,让 Agent 去读或执行。例如:
.opencode/skill/subdomain-enum/
├── SKILL.md              # 说明"什么时候、怎么爆破子域"
└── wordlist.txt          # 字典文件,SKILL.md 里引用它
"写很多个 skill 会不会打架?" 一般不会,因为每个 skill 只在 description 匹配的任务里被触发。如果你怕误触发,就用 "Use ONLY when..." 把触发条件写死。
"skill 和 command(斜杠命令)什么区别?" command 是你主动输入
/命令触发的(你决定什么时候用);skill 是模型自动判断要不要用(它决定)。一个靠人触发,一个靠 AI 判断。
六、重点:自定义好的 Agent 怎么用?
这是很多人做完配置后卡住的地方——"文件建好了,怎么让我的 Agent 跑起来?"这里有完整答案。
6.1 设为默认 Agent
在 opencode.json 里加一行,启动后就直接用它:
{
  "default_agent": "pentest-recon"
}
6.2 TUI 里手动切换
启动 opencode 进入交互界面后,在输入框按 Tab 键在主 Agent 之间切换(也可用自定义的 switch_agent 键位)。切换后当前会话就由该 Agent 的人设和权限接管。
6.3 把任务派给子 Agent(@ 提交流)
把 Agent 的 mode 设为 subagent,就能在主对话里输入 @agent名 任务内容 把活"外包"给它:
@recon-sub 帮我侦察 scanme.nmap.org 的常见端口
子 Agent 会自动被主 Agent 按 description 匹配调用,你也能手动 @ 点名。
6.4 命令行直接调用(脚本化/自动化常用)
# 用指定 agent 跑一条任务
opencode run --agent pentest-recon "请对 scanme.nmap.org 进行侦察,我已确认这是允许测试的公开靶机"
# 不指定 agent,用某个模型跑
opencode run --model anthropic/claude-sonnet-4-6 "介绍一下你自己"
这条命令非常适合把 Agent 接进脚本、定时任务或 CI/CD。
6.5 用命令行管理 Agent
opencode agent list      # 列出所有可用 agent(验证你的 agent 有没有被加载)
opencode agent create    # 交互式新建 agent
6.6 怎么验证 Agent 真的生效了?
-
看人设:
opencode agent list里能看到它;对话时按你写的铁律/风格回答。 -
看权限:让它执行一个没放行的命令(如
rm),观察是否弹确认或被拒——这是护栏在工作。 -
看工具:让它列出/调用你接入的工具(下一篇接工具后验证)。
三者都符合,说明你的自定义 Agent 已经真正"上岗"了。
七、概念辨析速查表
小白最常搞混的几组概念,一张表厘清:
| 概念 | 一句话 | 谁决定用不用 | 常驻还是按需 |
|---|---|---|---|
| 模型 model | 大脑,负责"想" | 你(配置里选) | 常驻 |
| Agent | 角色 = 人设 + 权限 | 你(切换/默认) | 常驻 |
| 系统提示词 prompt | Agent 的人设正文 | — | 常驻 |
| Skill | 某类任务的做法说明书 | 模型自动判断 | 按需加载 |
| Command 命令 | 你主动 /触发 的动作 | 你主动 | 触发即跑 |
| Tool/MCP | 手脚,执行具体操作 | 模型按需调用 | 按需 |
| Permission | 护栏,拦每一跳 | — | 常驻 |
八、常见疑问(FAQ)
Q1:改完配置没生效?opencode 配置启动时加载一次,退出并重启 opencode。
Q2:opencode agent list 里看不到我建的 agent?检查:① 文件路径对不对(.opencode/agent/ 或 ~/.config/opencode/agent/);② 文件名就是 agent 名;③ frontmatter 的 description 有没有漏;④ 是否忘了重启。
Q3:skill 写了却不触发?检查 description 是否为空、是否写清"何时用"、name 是否与文件夹名一致、SKILL.md 是否全大写。
Q4:同一工具写了多条权限规则,谁生效?最后一条匹配的规则生效。宽泛在前、具体在后。
Q5:subagent 和 primary 到底怎么选?你自己对话的主角用 primary;"主 Agent 派出去干专项活的临时工"用 subagent。渗透场景常见套路:一个 primary 当"项目经理",多个 subagent 分工(侦察、分析、报告)。
Q6:模型太贵/跑飞了怎么办?给 Agent 设 steps 限制迭代轮数;用 temperature 调低;权限把危险操作设成 ask,你在旁边看着。
Q7:我不会英文,系统提示词用中文行吗?行。现代模型中文理解很好,用中文写人设完全没问题,甚至更贴合你的表达习惯。
Q8:一个项目能建多个 agent 吗?会不会冲突?能,建多少都行,用 Tab 或 @ 或 --agent 切换。不会冲突,各自独立。
小结
本篇完成了 Agent 的"行为层":立人设(Agent)、上护栏(Permission)、写套路(Skill),并学会了怎么把它用起来(默认/切换/@ 派活/CLI/验证)。
但一个只会动嘴、没有手脚的 Agent 还干不了渗透侦察。下一篇我们给它装手脚:接入现成的安全 MCP,再亲手写一个最小 MCP Server,最后拼成一个完整可验证的渗透侦察 Agent。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)