当时序数据库学会语义:DolphinDB 的向量引擎与 RAG 实践
摘要
大模型应用普及之后,检索重新成了数据库领域最热闹的考场:语义检索要向量数据库,全文检索要搜索引擎,结构化筛选要时序库或数仓——一个 RAG 应用背后常常站着三套系统,各自存储、各自索引,结果在应用层对齐。DolphinDB 走了另一条路:2024 年的 3.00.1 版本在 TSDB 存储引擎上推出向量引擎 VectorDB,底层调用 Faiss,支持 Flat/PQ/IVF/IVFPQ/HNSW 五种索引与索引持久化;3.00.2 又在 PKEY 引擎上推出文本引擎 TextDB,内置倒排索引与中文分词;到 2026 年,这些能力被组装成企业级 RAG 智能体 DolphinMind(“混合检索 + 多路召回 + 重排序”)和智能投研平台 Starfish AI。本文沿这条线索展开:一个为多档行情设计的数组向量(Array Vector)如何成为语义数据的容器;一条同时带时间过滤和向量排序的 SQL 意味着什么;以及当语义检索回到数据原生地,RAG 架构会发生什么变化。
一、引言:RAG 的瓶颈,常常不在模型,在检索
过去两年,企业级大模型应用大多收敛到了 RAG(检索增强生成):把知识库切块、向量化、存进向量数据库;用户提问时把问题也向量化,检索最相似的若干块拼进提示词,再让模型作答。
这套架构能跑通,但在生产环境打磨过的人大多会承认:回答质量的上限是由检索质量决定的。模型再强,检索回来的上下文不对、不全,它只能在一堆错误证据上发挥。而检索质量差的原因,往往不是算法不行,而是架构不顺。
一个典型企业的数据版图是这样的:行情、传感器读数、交易记录这些时序与结构化数据,在时序数据库或数仓里;研报、公告、运维日志这些文本,需要全文检索,往往进了搜索引擎;大模型时代新增的 embedding 向量,又存进了专门的向量数据库。同一个业务问题的答案,碎片散落在三套系统里。比如"找上个月和今天行情最相似的时刻,再看看那几天针对相关板块写了什么研报"——这样一个金融里很自然的问题,要在向量库里做相似度检索、在时序库里做时间窗口过滤、在文本库里做关键词匹配,再把三份结果在应用层对齐、去重、合并。每一步都有一次数据搬运和一次一致性风险。
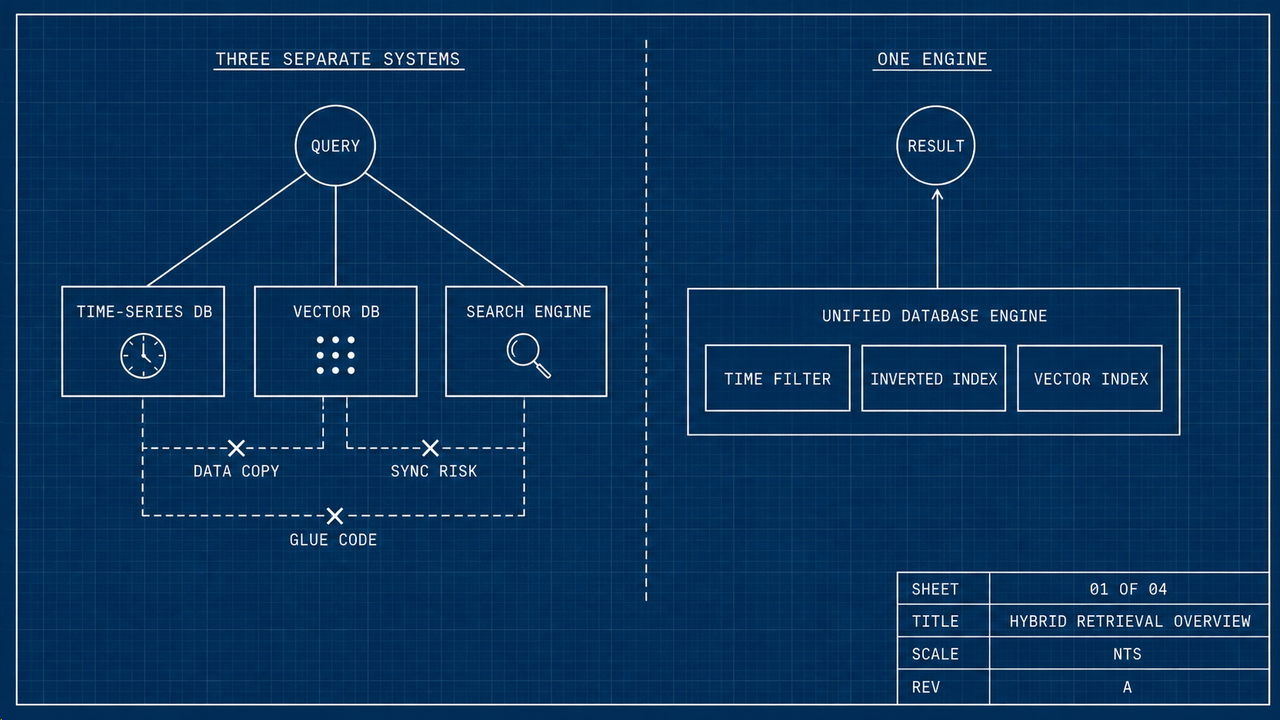
数据库行业对这个问题有两种回答。一种是"再买一个":专用向量数据库把语义检索做到极致。另一种是"长回去":让既有数据库原生获得语义能力,PostgreSQL 有了 pgvector,时序数据库这边,DolphinDB 的做法是从存储引擎层动手。本文要讲的就是这条路径——不是给时序数据库外挂一个向量插件,而是让向量、文本、时序三种数据出现在同一条 SQL 里。
二、伏笔:为行情而生的数组向量,成了语义的容器
这条路径的起点是一个和 AI 无关的功能。
DolphinDB 原生支持一种叫数组向量(Array Vector)的数据结构:一个列的每个单元格里存的不是单个值,而是一个定长或变长的一维数组。它的设计动机来自金融行情——股票十档报价、期货多档深度,一个时刻天然对应一组价格和量。用传统"一行一档"的宽表存,要么列数爆炸,要么查询别扭;用数组向量,一列装下整个订单簿,整存整取。
到了 embedding 模型普及之后,另一类数据呈现出同样的形态:文本编码后就是一组定长浮点数。一个 768 维的向量,和十档报价的十个价格在数据结构上没有本质区别,只是维度高一些。那个为行情设计的容器,几乎不需要改造就成了向量的容器。
2024 年 7 月,DolphinDB 发布 3.00.1 版本,正式推出基于 TSDB 存储引擎的向量引擎 VectorDB。这里的选择值得注意:它没有另建一个独立的向量系统,而是直接在 TSDB 引擎上叠加向量索引。向量以数组向量形式存储,复用 TSDB 原有的分区、排序、压缩体系,新增的部分只有向量索引。
几个工程决策可以展开说说。
- 其一,索引以 Level File 为单位构建。TSDB 引擎的数据落盘后组织为多层 Level File,VectorDB 在每个 Level File 内部独立构建向量索引,而不是全局维护一个大索引。索引的生命周期因此和数据文件对齐:新文件生成时建索引,文件合并时重建,不需要全局锁。索引还会持久化到磁盘,系统重启后直接读取现成索引,不必重建——对亿级向量场景,这决定了服务能不能快速恢复。
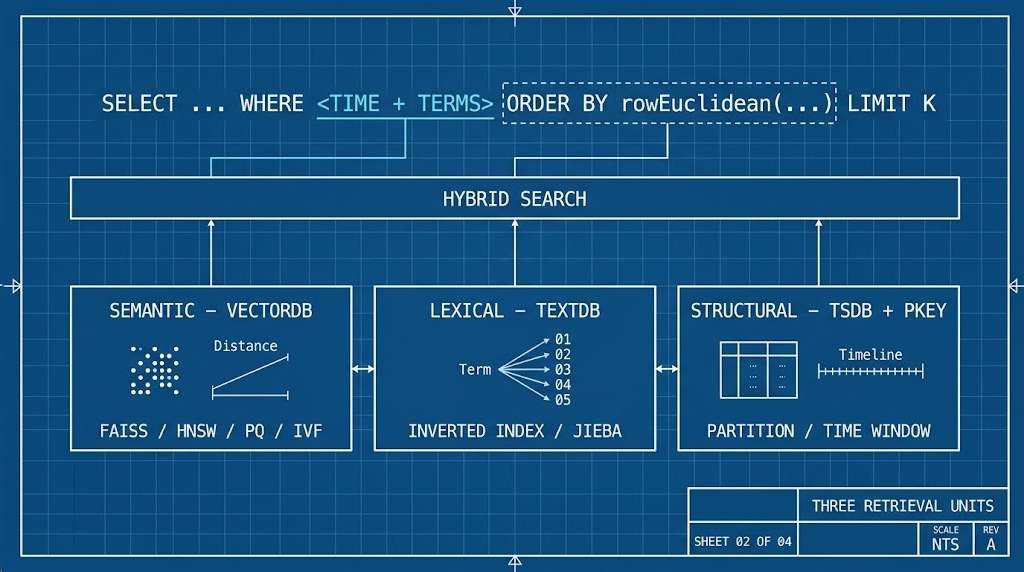
- 其二,底层调用 Facebook 开源的 Faiss。DolphinDB 没有重写近似最近邻搜索(ANNS),而是把工业界最成熟的实现嵌入引擎,对外提供 Flat、PQ、IVF、IVFPQ、HNSW 五种索引类型:Flat 精确穷举,适合十万级以内;PQ 乘积量化压缩存储,适合对精度要求不高的海量场景;IVF 倒排聚类,适合文本图片检索;IVFPQ 在速度和精度之间折中;HNSW 分层导航图在数亿至数十亿级向量下检索速度最快,官方文档列出的适用场景里明确包含 RAG。
- 其三,检索接口是 SQL,不是一套新的 API。在 VectorDB 里做向量检索是这样一条语句:
SELECT col1, col2 FROM pt
WHERE col2 < now()
ORDER BY rowEuclidean(vecCol, queryVector)
LIMIT 10
rowEuclidean 计算行向量与查询向量的欧氏距离,ORDER BY ... LIMIT K 取最相似的 K 条。这条语句里,WHERE 是时间条件,ORDER BY 是语义距离——结构化过滤和语义检索出现在同一条 SQL 的两个子句里。它的分量留到第四节再谈。
三、TextDB:词法检索补上另一半
向量检索解决的是"语义相近",但它有公认的短板:专业术语、代码、精确名词,向量反而不可靠。用户问某个具体函数怎么用,embedding 可能把相近但不同的名字都映射到邻近位置;语料中罕见的关键词,也可能因为训练覆盖不足而召回失败。这类必须逐字命中的需求属于词法检索,而词法检索的成熟答案是倒排索引——搜索引擎用了三十年的基座。
2024 下半年发布的 3.00.2 版本里,DolphinDB 推出了文本引擎 TextDB:在主键存储引擎 PKEY 之上,为 STRING 列构建倒排索引。做法和 VectorDB 一致,还是在既有引擎上叠加索引层,而不是再造一个搜索引擎。
几个细节值得注意。分词器内置且有四种:英文分词器按空格标点切分;中文分词器内置 Jieba 词库;混合分词器对英文按词、对中文按 Bigram 重叠切分,照顾中英混排的技术文档(“武汉市长江大桥"切成"武汉/汉市/市长/长江/江大/大桥”);还有不分词的 none 模式,把整段文本作为索引单元,用于等值查询加速。构建索引时自动做词干还原、大小写归一、停止词过滤,都是搜索引擎的标准预处理。
查询能力暴露为一组 SQL 函数,只能在 WHERE 子句中使用:matchAny(含任意一词)、matchAll(含全部词)、matchPhrase(含短语)、matchPrefix/matchSuffix(前后缀),以及更细的 matchSpan——给定短语和词距 slop,允许目标文本中间插入不超过 slop 个无关词。官方给的金融示例很能说明用途:在新闻表里查同时提及 “interest rates” 和 “global markets”、允许中间隔两个词的报道,matchSpan(content, "interest rates global markets", 2) 一句完成。相比 LIKE 的全表遍历,数据量越大、命中越稀疏,倒排索引的优势越明显。
到这里,引擎层集齐了两块拼图:向量管"意思像不像",倒排管"字面上有没有",TSDB/PKEY 原有的分区、时间窗口、属性过滤管"范围对不对"。三路检索,在同一个数据库里。
四、一条 SQL 的三路合流:混合检索为什么重要
现在可以回到第二节留的那个问题。
单看每一项能力都不稀奇,市面上各有专门产品做得很好。真正少见的是它们的交集,也就是官方文档所说的混合搜索(Hybrid Search):在向量检索的查询语句中使用 WHERE 条件过滤,先用结构化条件缩小候选集,再在候选集上做向量相似度排序。
这个交集重要,因为真实业务里的检索问题几乎从不是单纯的"找最像的",而是"在某个范围内的、最像的":
- 电商场景(官方文档的例子):在"品牌 = X、颜色 = 红"的商品里,找与用户上传图片最相似的十件;
- 金融场景:在"去年至今、板块 = 新能源"的新闻里,找与今天这份公告语义最相似的历史报道;
- 工业场景:在"设备 = 3 号机组、时间 = 上季度"的振动片段里,找与当前异常波形最相似的样本——找到了,往往就找到了上一次同类故障的处置记录。
在拼装架构里,这类问题要么把向量库当纯引擎、放弃条件过滤,拿回一大堆结果在应用层筛;要么把结构化条件硬塞给向量库模拟,而多数专用向量库的元数据过滤能力有限,数据还要和业务库冗余同步一份。在 DolphinDB 里,它是那条 SQL 的自然延伸:
-- 时间过滤 + 关键词过滤 + 向量相似度,一条语句
SELECT newsTime, content FROM news
WHERE matchAny(content, "inflation interest rate")
  AND newsTime BETWEEN 2023.01.01 : 2023.01.31
ORDER BY rowEuclidean(vecCol, queryVec) LIMIT 10
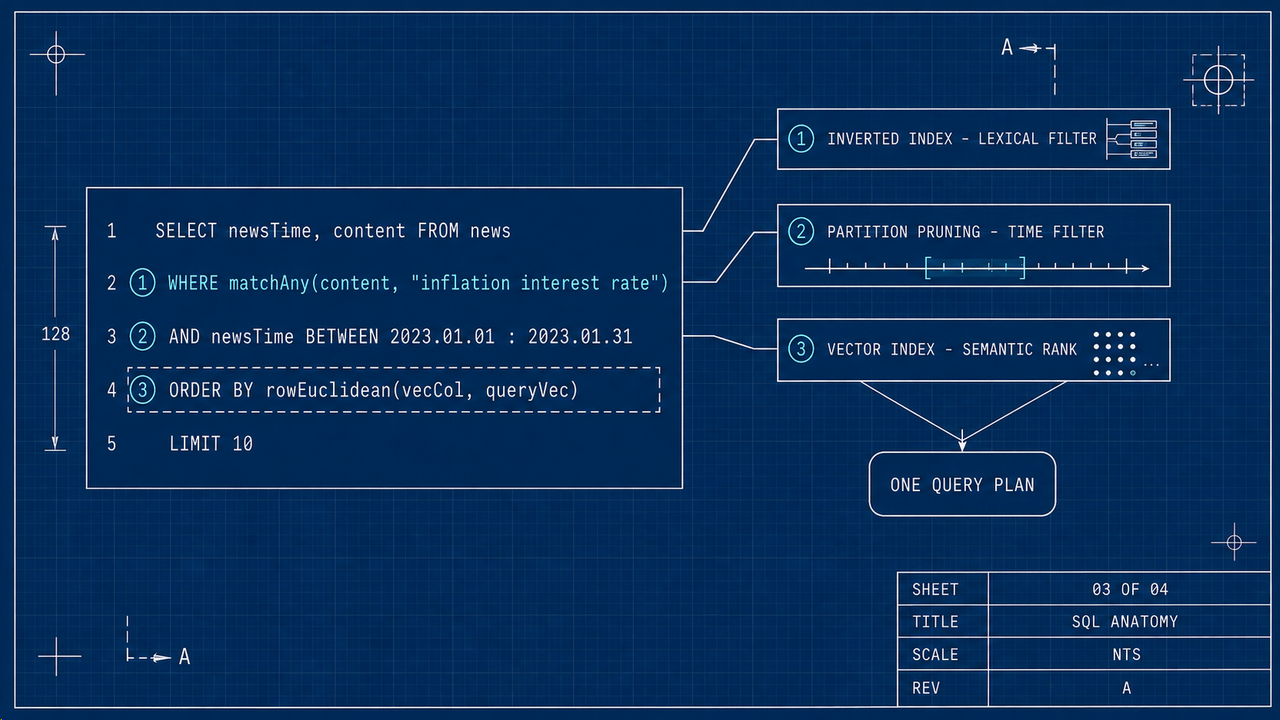
客观地说,当前版本也有清晰的边界:向量索引只能建在单个 FLOAT[] 列上;检索语句不能带表连接和分组;WHERE 条件不能命中排序键列;TextDB 的索引目前仅支持 PKEY 引擎,加速函数只能位于 WHERE 子句顶层。这些限制说明它还是一套年轻的引擎能力,覆盖的是"单表上的混合检索"这个核心场景。但方向是清楚的:当时间、词法、语义三种条件可以在同一个执行计划里被联合处理时,检索就不需要跨系统对齐了。
五、从引擎到应用:DolphinMind 与 Starfish AI
引擎能力要长成应用才能被检验。2026 年,DolphinDB 把这套"向量 + 文本 + 计算"的底座组装成了两个可以直接使用的产品。
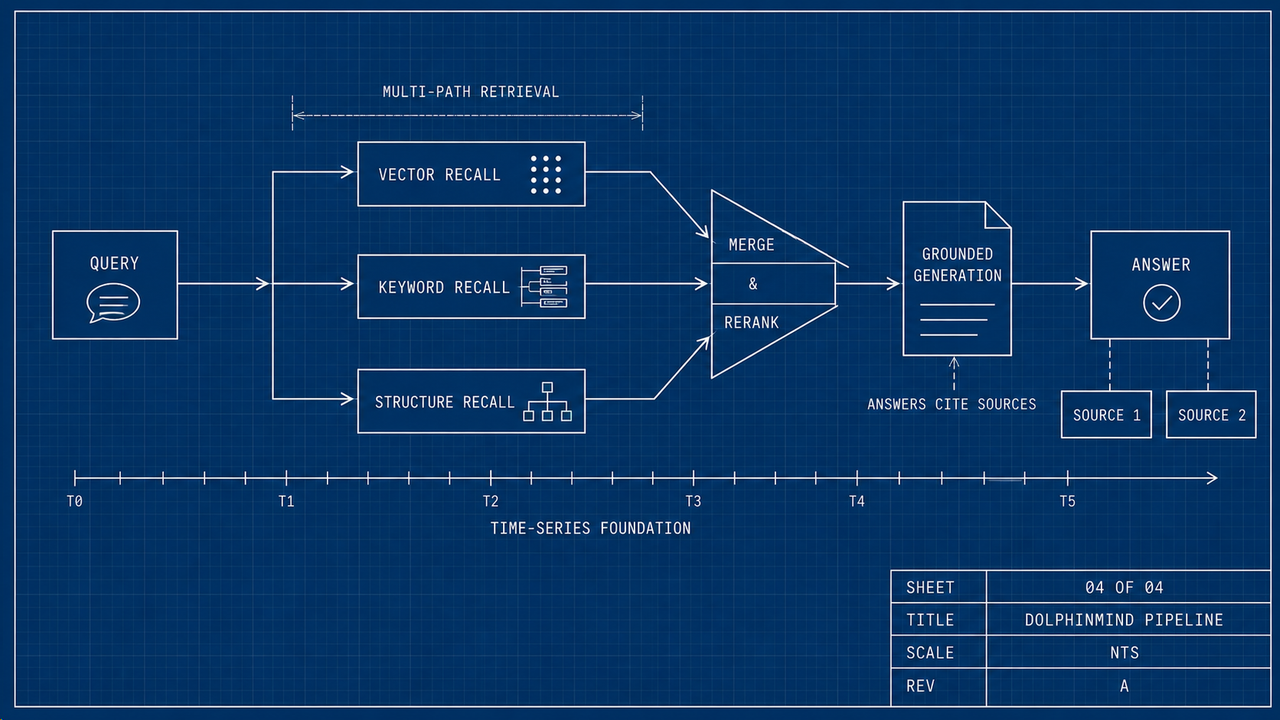
DolphinMind:企业级 RAG 智能体。 2026 年 2 月正式上线(dolphindb.cn/think 直接可用),定位是解答 DolphinDB 与 DLang 使用中的各类问题。它有讨论价值的地方不是"又一个 AI 客服",而是官方标注的架构:“混合检索 + 多路召回 + 重排序”。翻译成工程语言:一个问题进来,语义向量检索(VectorDB 的能力)、关键词词法检索(TextDB 的能力)、文档结构信息等多条通道并行召回候选,再用重排序模型对合并后的候选精排,最后才交给大模型生成。这是第四节论点的产品化印证——高质量 RAG 的检索层从来不是单路向量检索,而是词法与语义的多路合流,支撑这种合流的正是把两种索引放进同一个引擎的那个决定。DolphinMind 的每个回答右侧附源文档引用,可溯源核对,这是抑制幻觉最直接的手段:与其让模型更聪明,不如让证据更扎实。
具体到一次问答的完整链路,可以拆成四个环节。首先是问题理解:系统先对用户输入做意图识别,判断是函数用法、语法报错还是性能调优,再据此决定各检索通道的权重配比——比如语法类问题更依赖 TextDB 的精确命中,而"有没有类似场景的实践"这类开放问题则更依赖向量召回。其次是多路召回:向量通道用 rowEuclidean 在文档库上取语义相近的 Top-K,词法通道用 matchAny/matchPhrase 锁定函数名、报错码等必须逐字命中的片段,文档结构通道则按章节层级定位相关段落,三路结果合并去重。第三是重排序:合并后的候选集往往有几十条,直接全塞进提示词既超上下文窗口又稀释注意力,重排序模型按与问题的相关度精排,只保留最相关的前几条。最后才是生成与溯源:大模型基于精排后的证据作答,同时把每条结论对应的源文档片段以引用形式附在回答右侧,用户点开即可核对原文。
这套设计解决的是企业知识问答里最实际的两个痛点。其一是冷门但精确的问题:比如用户问"rowEuclidean 的第三个参数是什么",向量检索很可能把相近的函数名都召回来,但倒排索引能精确锁定包含该函数名的文档段落,两者互补后答案才完整。其二是答案的可信度:纯生成式回答即使内容正确,用户也难以判断依据是否可靠;带引用溯源后,回答的每个结论都能回到具体文档,既便于核对,也便于在文档更新后重新验证。从产品形态看,DolphinMind 把引擎层的三路检索能力封装成了用户无感的默认行为——使用者不需要知道背后是 VectorDB 还是 TextDB,只需要知道"问它,它能答,而且答得有据可查"。
Starfish AI:金融级投研与因子开发智能体。 它展示了同一个底座在垂直领域的形态:用自然语言描述因子逻辑,秒级生成可执行的 DolphinDB 计算脚本,直接对接回测;上传 PDF 研报,系统解析其中的因子逻辑并转化为代码,自动回测、根据结果迭代,输出归因报告——从文献到因子的闭环。这条链路里,向量检索负责理解研报在说什么,倒排索引负责精确锁定指标与术语,时序计算引擎负责验证它是否真的有效,三种能力缺一环都打不通。
另外,在最新的 V3.00.6 版本中,DolphinDB 通过 MCP 协议把数据与计算能力开放给了大模型生态(本系列前文已有详述,这里不展开)。与此同时,DolphinDB 推出了 DolphinX——企业级 AI Agent 开发与治理平台,正是这一开放生态的落地载体。它深度连接大模型与企业数据、计算脚本、知识库、MCP 工具和 Skill 能力,让运维人员能够通过自然语言完成实时问数、异常定位、报表生成和分析脚本开发,并通过自动上下文管理、权限继承和脚本安全执行机制,将 DolphinDB 的实时数据与行业经验转化为可治理、可审计、可复用的 Agent 能力。放在一起看,路径是连贯的:先把三种检索单元装进引擎,再把引擎组装成 RAG 应用,最后把应用接入 Agent 生态。
六、结语:语义检索回到数据原生地
回到开头的架构困境:三套系统、三次搬运、三份一致性风险。
DolphinDB 用三个版本的迭代给出了它的回答。这条路径背后有一个一致的判断:语义不是一种新的数据,而是既有数据的新维度。行情数据配上 embedding,就有了语义坐标;研报文本配上倒排索引,就有了词法坐标;它们本来就与时间戳、业务属性同生同存。既然如此,语义检索的合理归宿就不是另立一个系统把数据搬过去,而是回到数据原生的地方,成为原有引擎的一个新索引类型——就像二十年前数据库学会全文检索、十年前学会 JSON 一样,这一次,数据库要学会"意思"。
从为订单簿设计的数组向量,到 Faiss 加持的 VectorDB;从 Jieba 分词的倒排索引,到"混合检索 + 多路召回 + 重排序"的 DolphinMind——这条线索不是一次追热点的转型,而是一层一层叠加的工程复利:每一层能力都建立在前一层之上,每次加法都在同一个内核里完成。当别人在三套系统之间搬运数据时,这里的一切发生在一条 SQL 能触达的范围之内。
大模型的应用浪潮还会继续翻涌,检索的形态也还会进化。但有一件事大概不会变:离数据越近的智能,越有资格谈可靠。当时序数据库学会语义,学会的不只是向量检索——是让"理解"这件事,发生在数据一直居住的地方。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 32
 0
- 0


 已为社区贡献3条内容

所有评论(0)