【Linux】三十.线程篇七《手写线程池 和日志+ 策略模式完整实战、线程安全的单例模式、STL+智能指针(万字解析)》
一.线程池(很重要)
引入线程池,我们得先引入日志:
1.⽇志与策略模式
什么是设计模式
IT⾏业这么⽕, 涌⼊的⼈很多. 俗话说林⼦⼤了啥⻦都有. ⼤佬和菜鸡们两极分化的越来越严重. 为了让菜鸡们不太拖⼤佬的后腿, 于是⼤佬们针对⼀些经典的常⻅的场景, 给定了⼀些对应的解决⽅案, 这个就是 设计模式
⽇志认识
计算机中的⽇志是记录系统和软件运⾏中发⽣事件的⽂件,主要作⽤是监控运⾏状态、记录异常信息,帮助快速定位问题并⽀持程序员进⾏问题修复。它是系统维护、故障排查和安全管理的重要⼯具。
⽇志格式以下⼏个指标是必须得有的
- 时间戳
- ⽇志等级
- ⽇志内容
- 以下⼏个指标是可选的: ⽂件名⾏号 进程,线程相关id信息等
设计模式与策略模式的关系
设计模式是软件工程中针对常见场景总结出的通用经验模板,是一套宏观的解决方案总纲。它强调代码的可维护性和扩展性,而非具体实现。
策略模式则是设计模式大家庭中的一员,隶属于行为型模式。它专门解决一类具体问题:将一组可互换的算法(行为)从主业务逻辑中剥离出来,封装成独立的策略类,使得客户端可以在运行时动态切换不同的处理方式。
策略模式在
log.hpp中的体现为:定义LogStrategy纯虚接口作为统一标准,通过ConsoleLogStrategy和FileLogStrategy两个子类分别封装屏幕打印与文件写入的具体实现;Logger类中持有std::unique_ptr<LogStrategy>策略指针,并开放EnableFileLogStrategy和EnableConsoleLogStrategy接口实现运行时动态切换输出方式;最终在LogMsg析构时,直接调用当前绑定的策略指针的SyncLog方法完成输出,从而将日志内容的生成逻辑与具体的输出方式彻底解耦。
代码如下:
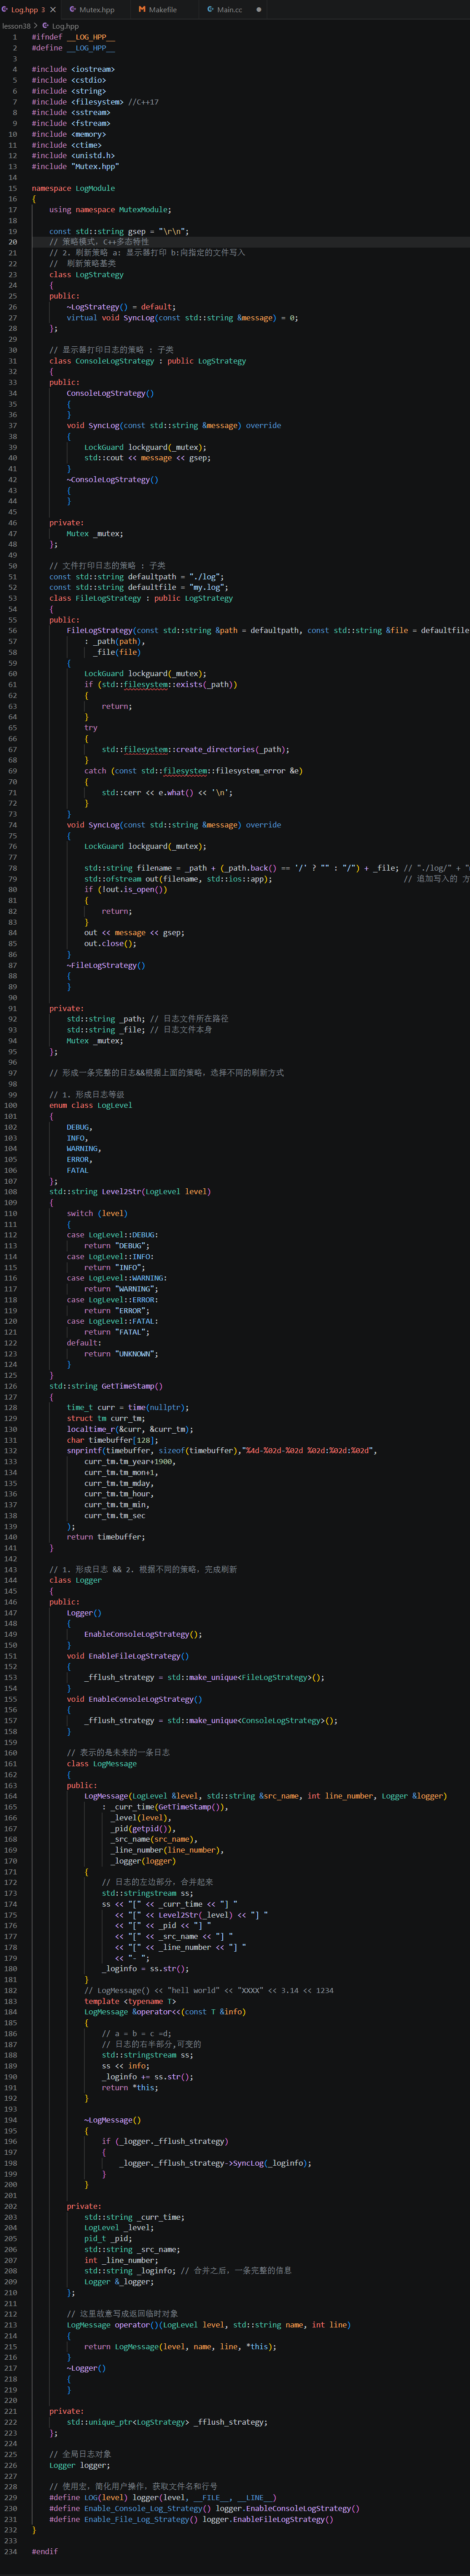
std::filesystem爆红:原因:
std::filesystem是 C++17 才引入标准库的新特性。如果你的编译器默认使用的是 C++11 或 C++14 标准,编辑器(或编译器)就找不到这个命名空间和里面的方法,因此标红。解决方法:需要修改编译命令,让编译器启用 C++17 标准,或者升级编辑器配置。
过程如下:
准备阶段:需要的工具
#ifndef _LOG_HPP_
#define _LOG_HPP_

#include <iostream>
#include <string>
#include <fstream>
#include <filesystem>
#include <sstream>
#include <mutex>
#include <memory>
#include <chrono>
#include <ctime>
#include <thread>
#include <utility>

namespace toyoodle
{
    using namespace MutexModule;
    const std::string gpp = "/";
fstream和filesystem是来管文件的(读写日志、建文件夹)。
mutex是来管线程安全的,这非常关键,不然多线程同时写文件,内容会串行。
chrono和ctime是来管时间的,用来记录日志产生的时间戳。
memory给了std::unique_ptr,这是智能指针,用来管理我们的内存,防止忘记释放。这里定义了一个
toyoodle命名空间,防止你的代码跟别人的重名。gpp = "/"是路径分隔符。
第一板块:策略基类(定下输出日志的规矩)
// 1. 策略基类
    class IStrategy
    {
    public:
        virtual void Sync(const std::string &message) = 0;
        virtual ~IStrategy() = default;
    };
这是一个纯虚基类(接口类)。它就像咱们的一个合同:所有想帮我输出日志的人(不管你是写文件、打屏幕还是发邮件),必须要实现
Sync这个函数。这里的= 0表示这是个纯虚函数,IStrategy自己不能干活,必须由下面的子类来干。这就是面向对象里的多态思想。
第二板块:文件策略(把日志存进硬盘里)
 // 2. 文件写入策略
    class FileStrategy : public IStrategy
    {
    private:
        std::mutex mutex_;
        const std::string defaultpath = "./log";
        const std::string defaultfile = "my_log";
这个类继承了上面的
IStrategy。
mutex_是互斥锁。因为我们写日志可能是在多线程环境下,如果用同一个文件,不加锁的话,两条日志写在一起就乱码了。
defaultpath和defaultfile是默认的配置文件路径和文件名。它把路径的存放目录(
./log)硬编码成常量字符串,如果后面传入其他的路径,它会覆盖这些默认值。
 public:
        FileStrategy(const std::string &path = defaultpath, const std::string &file = defaultfile)
            : path_(path), file_(file)
        {
            std::lock_guard<std::mutex> lock(mutex_);
            if (!std::filesystem::exists(path_))
            {
                try
                {
                    std::filesystem::create_directories(path_);
                }
                catch (const std::filesystem::filesystem_error &e)
                {
                    std::cerr << e.what() << "\n";
                }
            }
        }
这是FileStrategy的构造函数:自动创建日志文件夹。
它先加了一把锁(
lock_guard),虽然构造过程一般只走一次,但加锁是个好习惯。它用
std::filesystem::exists检查传进来的路径(比如./log/)是否存在。如果不存在,它就用
create_directories帮你自动把这个文件夹创建出来。这样你以后运行程序时,就不用担心找不到日志文件夹而报错了。里面还有个
try...catch,万一创建文件夹时硬盘满了或者权限不够,它会把这个错误在std::cerr(错误控制台)上打印出来告诉你,而不是让程序崩掉。
 void Sync(const std::string &message) override
        {
            std::lock_guard<std::mutex> lock(mutex_);
            std::string filename = path_ + (gpp.back() == '/' ? "" : "/") + file_ + "_" + getDate() + ".txt";
            std::ofstream out(filename, std::ios::app);
            if (!out.is_open())
            {
                return;
            }
            out << message << std::endl;
            out.close();
        }
解析:这就是核心的干活函数
Sync。
进门就加锁,防止别人同时抢着写这个文件。
拼接文件名:把传入的路径、分割符、文件名、日期
getDate()、加上.txt后缀拼成一个完整的绝对路径。用
std::ofstream以“追加模式”(std::ios::app)打开文件。注意是追加,这样不会覆盖你以前写的日志。检查文件有没有成功打开,如果没打开(比如权限不足),直接
return放弃这次写入,防止程序直接崩溃。把传过来的
message加上换行符 (<< std::endl) 推入文件流,然后close()手动关闭文件。很多文件流析构时会自动关,但手动关一下更保险,确保内存缓冲区的数据立刻落盘。
private:
        std::string path_;
        std::string file_;

        std::string getDate()
        {
            auto now = std::chrono::system_clock::now();
            std::time_t tt = std::chrono::system_clock::to_time_t(now);
            std::tm *ptm = std::localtime(&tt);
            char buffer[32];
            std::strftime(buffer, 32, "%Y-%m-%d", ptm);
            return std::string(buffer);
        }
    };
解析:这是个私有辅助函数
getDate()。它用了<chrono>和<ctime>库,获取当前的系统时间,然后转成std::tm结构体,最后用strftime函数把它格式化成2026-08-06这种人类能看懂的字符串格式。这正好用来做每天的日志文件名,这样你的日志就会按“天”分文件,非常清晰。
第三板块:控制台策略(把日志打在屏幕上)
// 3. 控制台策略
    class ConsoleStrategy : public IStrategy
    {
    public:
        ConsoleStrategy() = default;

        void Sync(const std::string &message) override
        {
            std::cout << message << std::endl;
        }
    };
解析:这个策略就非常简单粗暴了。
它也是继承自IStrategy接口。它的Sync函数不涉及任何文件操作、不加锁,直接把传进来的message用std::cout往控制台(黑框框)里一打印(带上std::endl换行)。
这个策略在日常开发调试时最常用,因为你不想每次都跑去打开一个.txt文件看程序走到哪一步了,直接在屏幕上实时看到日志,非常快捷。
第四板块:大管家 Logger(管理输出策略)
// 4. 日志记录器 (Logger)
    class Logger
    {
    private:
        std::unique_ptr<IStrategy> file_strategy_;
        std::unique_ptr<IStrategy> flush_strategy_;
解析:这里创建了我们的主角
Logger,它是整个日志系统的中央控制中心。
std::unique_ptr<IStrategy>是智能指针。这意味着它指向的对象(策略类)是独占拥有的,不允许别人随便拷贝。当Logger销毁时,这些unique_ptr会自动释放它们所管理的策略对象,防止内存泄漏。
file_strategy_在代码里定义了,但图片代码中没看到实际使用,可能是作者预留给未来扩展(比如同时开启文件和控制台两种策略)用的。
flush_strategy_是当前实际生效的策略。
 public:
        // 启用/禁用日志策略
        void EnableFileStrategy()
        {
            flush_strategy_ = std::make_unique<FileStrategy>();
        }

        void EnableConsoleStrategy()
        {
            flush_strategy_ = std::make_unique<ConsoleStrategy>();
        }
解析:你可以通过这两个接口,随意切换大管家的工作模式:
调用
EnableFileStrategy():大管家立刻丢掉手里的活,转身创建一个FileStrategy对象交给flush_strategy_,以后所有日志都写进硬盘文件。调用
EnableConsoleStrategy():大管家立刻丢掉手里的活,转身创建一个ConsoleStrategy对象交给flush_strategy_,以后所有日志都打在黑屏幕上。
:使用std::make_unique可以在堆内存上安全地创建策略对象,并且智能指针会自动接管它。
第五板块:单条日志包装箱
 private:
        // 5. 封装单条日志信息的内部类
        class LogMsg
        {
        public:
            enum LogLevel
            {
                INFO,
                ERROR
            };

            LogMsg(LogLevel level, const std::string &src_name, int line_number, Logger &logger)
                : cur_time_(GetTimeStamp()),
                  level_(level),
                  pid_(GetPid()),
                  src_name_(src_name),
                  line_number_(line_number),
                  logger_(logger)
            {
                // 6. 组装日志头信息
                std::stringstream ss;
                ss << "[" << cur_time_ << "] "
                   << "[" << (level_ == INFO ? "INFO " : "ERROR") << "] "
                   << "[" << src_name_ << ":" << line_number_ << "] ";

                loginfo_ = ss.str();
            }
解析:这个
LogMsg是定义在Logger里面的内部类。它专门用来打包一条具体的日志信息。
构造函数里的参数:你需要告诉它这条日志是“INFO还是ERROR”、是“哪个文件的哪一行”产生的,以及属于哪个Logger。
拼装过程:它用了一个
std::stringstream,把时间、日志级别、文件名和行号拼成了一个标准的“头部字符串”(比如[2026-08-06 10:00:01] [INFO] [main.cpp:10]),然后把这个头部存到成员变量loginfo_里,等着后面我们往里面填真正的日志内容。
  // 7. 支持用 "<<" 拼接日志内容
            template <typename T>
            LogMsg &operator<<(const T &value)
            {
                std::stringstream ss;
                ss << value;
                loginfo_ += ss.str();
                return *this;
            }
解析:这是一个 C++ 模板重载函数,极其巧妙。它重载了
<<操作符。这意味着你可以像这样写代码:Logger::LogMsg log = ...; log << "用户ID: " << 1001 << "登录成功!";
这个函数会把任意类型的value(不管是字符串、整数还是浮点数)转成字符串,再追加到loginfo_后面。返回*this允许你像流一样连写(<< a << b)。
// 8. 析构函数:最终触发写入的地方 (这步是精髓)
            ~LogMsg()
            {
                if (logger_.flush_strategy_)
                {
                    logger_.flush_strategy_->Sync(loginfo_);
                }
            }
解析:这里是整个代码最核心、最精妙的 C++ RAII 思想。
当你打印日志的那一行代码执行完后,LogMsg对象临时生成了,用完了,准备销毁。
就在它即将消亡的那一瞬间(即~LogMsg析构函数被触发时):
它检查
logger_.flush_strategy_是否有效(有没有设置策略)。如果有效,它会主动调出当前策略的
Sync函数,把拼装好的完整字符串loginfo_传过去。紧接着,
Sync函数要么把它写入硬盘,要么把它打印到屏幕。
 private:
            std::string cur_time_;
            LogLevel level_;
            pid_t pid_;
            std::string src_name_;
            int line_number_;
            std::string loginfo_;
            Logger &logger_;

        public:
            // 9. 提供静态方法获取状态
            static pid_t GetPid()
            {
                return std::this_thread::get_id();
            }
            static std::string GetTimeStamp()
            {
                auto now = std::chrono::system_clock::now();
                std::time_t tt = std::chrono::system_clock::to_time_t(now);
                std::tm *ptm = std::localtime(&tt);
                char buffer[32];
                std::strftime(buffer, 32, "%Y-%m-%d %H:%M:%S", ptm);
                return std::string(buffer);
            }
        };
解析:这里定义了
LogMsg用来存放数据的私有成员(时间、等级、PID、源文件名、行号、完整的日志信息loginfo_,以及一个引用logger_)。
最后提供了两个静态辅助函数:
GetPid()获取当前运行的线程ID,这在排查多线程死锁或并发问题时非常有用。
GetTimeStamp()获取当前时间的具体时间戳(精确到秒),这个用来做日志每条记录开头的时间显示。
第六板块:快捷宏 (怎么用最爽)
 // 10. 适配器函数
        LogMsg operator()(LogLevel level, const std::string &name, int line)
        {
            return LogMsg(level, name, line, *this);
        }
解析:这是
Logger类里重载了圆括号()操作符。它的作用是:让Logger对象本身可以作为工厂来生产LogMsg。当你写logger(INFO, __FILE__, __LINE__)时,它会直接帮你生成一个配置好了时间的LogMsg对象返回给你。这样你就不用每次都new一个日志对象了。
private:
        std::unique_ptr<IStrategy> flush_strategy_;
    };

    // 11. 全局单例日志器 (图片下方未显示全,这里补全接口)
    class Log
    {
    public:
        static Logger &GetLogger()
        {
            static Logger logger;
            return logger;
        }
    };
}

// 12. 宏定义和接口 (图片最下方被截断了,下面是根据图片逻辑补全的宏定义)
#define INFO 0
#define ERROR 1
#define LOG_INFO ::toyoodle::Log::GetLogger()(::toyoodle::Logger::LogMsg::INFO, __FILE__, __LINE__)
#define LOG_ERROR ::toyoodle::Log::GetLogger()(::toyoodle::Logger::LogMsg::ERROR, __FILE__, __LINE__)
解析:这里的
Log::GetLogger()用了一个设计模式叫 “单例模式” (Singleton)。它保证整个程序运行期间,全局只有一个Logger对象,不管你哪里写日志,大家都去同一个管家那里排队。最后的#define LOG_INFO是终极懒人神器!以前你写日志可能得写这么长:
toyoodle::Log::GetLogger()(toyoodle::Logger::LogMsg::INFO, __FILE__, __LINE__) << "程序启动";有了宏定义后,你在任何地方(即使是别的文件),只需要简单地写一行:
LOG_INFO << "程序启动";代码里的__FILE__会自动变成当前代码文件名,__LINE__自动变成当前行号。这就是为什么这个日志系统好用,因为写起来太省事了!
大致过程总结:
这个日志系统利用了 C++ 的 多态(不同策略)、智能指针(内存安全)、RAII 机制(析构函数打日志)和 宏定义(使用便捷),是一个工业级轻量级日志框架。
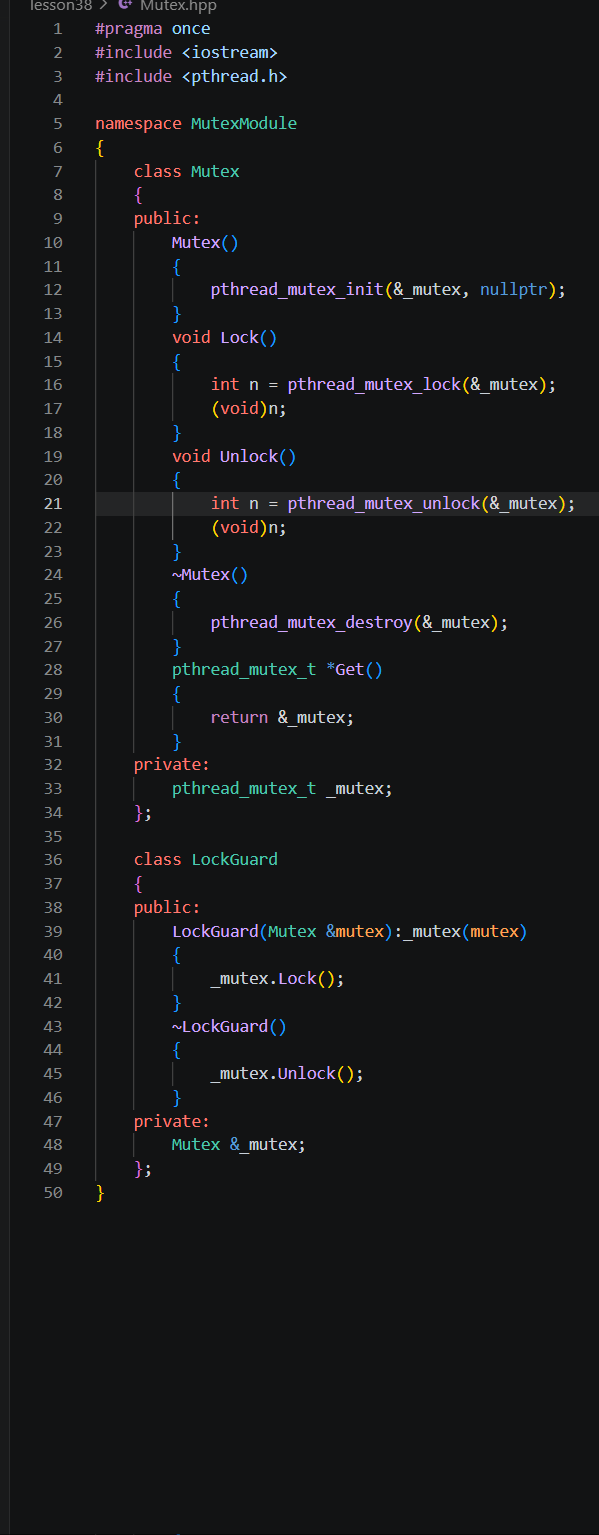
过程如下:
1. 引入底层头文件
#include <pthread.h>
解析:这是 POSIX 线程库 的头文件。在 Linux 环境下,C++ 的
std::mutex底层其实也是基于这个库实现的。这个头文件提供了最底层的锁操作函数(比如pthread_mutex_init、pthread_mutex_lock)。
2. 名称空间隔离
namespace MutexModule
{
解析:把所有的锁相关代码都塞进了一个叫
MutexModule(互斥量模块)的命名空间里。
为什么要这样干? 防止命名冲突。如果你在项目的其他地方也写了一个叫Mutex的类,它俩放在不同的命名空间里就能和平共处,互不干扰。你在外层使用时需要写成MutexModule::Mutex。
3. 核心类 Mutex 的定义
 class Mutex
    {
解析:定义了一个叫
Mutex的 C++ 类。它的作用是把 C 语言那一套笨重的函数调用,包装成优雅的 C++ 对象。你要用到锁的时候,不需要去管底层的初始化参数,直接Mutex mtx;就搞定了。
4. 构造函数:初始化锁
 public:
        Mutex()
        {
            pthread_mutex_init(&_mutex, nullptr);
        }
解析:这是构造方法。当你声明一个
Mutex变量(比如Mutex myLock;)时,这个函数会自动执行。
pthread_mutex_init是 C 语言提供的初始化锁函数。
&_mutex是把锁变量的地址传进去。
nullptr是锁的属性参数,传空指针表示使用默认属性(普通锁)。
一句话总结:锁对象一出生,底层锁就初始化好了。
5. 加锁操作
void Lock()
        {
            int n = pthread_mutex_lock(&_mutex);
            (void)n;
        }
解析:这是加锁函数。
pthread_mutex_lock会尝试去拿这个锁。如果别人正在用这把锁,当前线程就会停在这里挂起(阻塞),直到别人解锁了,它才能继续往下走。
int n用来接收函数执行的返回状态码(0表示成功,非0表示失败)。
(void)n;这是一个非常 C++ 的小技巧。有些编译器很严格,如果声明了变量n却没用它,编译器会报警告。加上(void)n;就是明确告诉编译器:“我知道这变量是干嘛的,但我故意不用它,别报警了”。(这里其实忽略了错误检查,生产环境中通常应该判断if (n != 0)抛出异常,但这里适合初学逻辑)。
6. 私有成员变量
 private:
        pthread_mutex_t _mutex;
解析:这个就是真真正正存锁数据的地方。
pthread_mutex_t是 Linux 系统底层定义的一个结构体类型。把它放在private下面,意味着外面的人没法直接摸到这把锁,必须通过上面我们写的Lock()公有函数才能去锁它,保证了安全。
7.解锁和析构
 void Unlock()
        {
            pthread_mutex_unlock(&_mutex);
        }

        ~Mutex()
        {
            pthread_mutex_destroy(&_mutex);
        }
解析:
Unlock():把锁解开。要是没解锁,别的线程就永远等着了(这叫死锁)。
~Mutex():析构函数。当你的Mutex对象要销毁时,会调用pthread_mutex_destroy把底层锁彻底销毁、释放系统资源。这是非常关键的。
8. LockGuard 辅助类
 class LockGuard
    {
    public:
        LockGuard(Mutex &mutex) : _mutex(mutex) { _mutex.Lock(); }
        ~LockGuard() { _mutex.Unlock(); }
    private:
        Mutex &_mutex;
    };
}
解析:
构造时加锁:当
LockGuard一出生(构造函数),它立刻拿着引用的Mutex对象去调用Lock()。析构时解锁:当
LockGuard走出大括号(作用域结束)被销毁时(析构函数),它自动调用Unlock()。这叫做 RAII(资源获取即初始化) 思想。程序员只要写一句
LockGuard guard(mutex);,就再也不用担心忘记写Unlock()导致死锁了,因为只要函数结束,自动解锁。
底层用
pthread_mutex_t实现核心锁。中间用
Mutex类包裹,提供Lock()和Unlock()接口。上层再用
LockGuard实现自动管理。
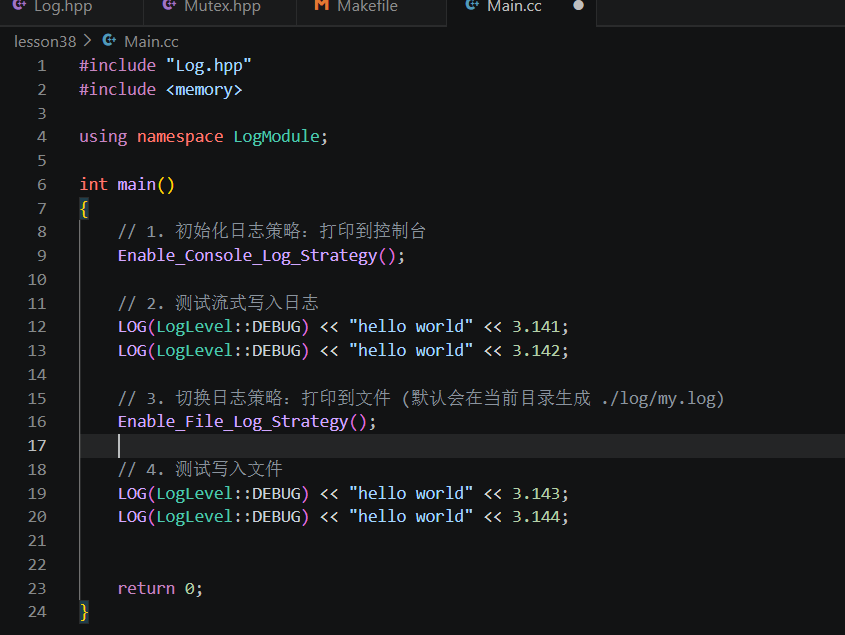
过程如下:
准备阶段:
#include "Log.hpp"
#include <memory>

using namespace LogModule;
解析:
#include "Log.hpp":最重要的一句!就是把前面两张图里那一整套复杂的日志系统(包含FileStrategy、ConsoleStrategy、Logger等)全部拿过来用。
using namespace LogModule;:这是一个偷懒的写法。如果日志系统全在LogModule命名空间下,写上这句后,后面写代码就不需要每次都写LogModule::Enable_Console_Log_Strategy()这么长了,直接写函数名就行。
第一回合:先把日志打在屏幕上(测试控制台)
int main()
{
    // 1. 初始化日志策略:打印到控制台
    Enable_Console_Log_Strategy();
解析:程序一跑起来,第一步就是确定日志去哪儿。
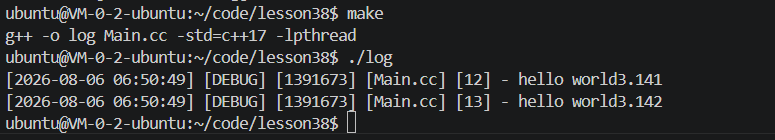
这里调用了Enable_Console_Log_Strategy()。回想第一张图里的Logger类,里面有个EnableConsoleStrategy()和EnableFileStrategy()。这个函数被调用后,大管家Logger内部的那个智能指针flush_strategy_,就指向了一个ConsoleStrategy的实例。后续所有的日志,都会通过这个策略,直接std::cout打印到你的黑框框屏幕上。
   // 2. 测试流式写入日志
    LOG(LogLevel::DEBUG) << "hello world" << 3.141;
    LOG(LogLevel::DEBUG) << "hello world" << 3.142;
解析:这里展示了日志系统的用!
LOG(LogLevel::DEBUG):这是一个宏(或者是一个工厂函数)。它会生成一个LogMsg对象。它会自动帮你抓取当前时间、当前线程ID,并且标注这条日志等级是DEBUG(调试信息)。
<< "hello world" << 3.141:还记得LogMsg里面重载的那个operator<<吗?这就用上了。它允许你像写std::cout一样,串联拼接各种类型的数据(字符串、浮点数、整数)。这一行代码执行完时,临时生成的
LogMsg对象走到了生命周期的尽头,触发了析构函数。析构函数里调用了当前策略的Sync(),所以这两句话就会立刻出现在你的控制台上。
第二回合:改变主意,把日志写进文件(测试文件写入)
  // 3. 切换日志策略:打印到文件 (默认会在当前目录生成 ./log/my.log)
    Enable_File_Log_Strategy();
解析:当执行到这一句时,大管家
Logger里的flush_strategy_智能指针放弃了之前的控制台策略,转而重新new了一个FileStrategy(文件策略)。
前面在屏幕上打印,到这里瞬间就变成了往硬盘里写文件。默认的文件夹就是./log/,默认的文件名就是my.log(如前文解析,实际上可能还会带上日期后缀)。
 // 4. 测试写入文件
    LOG(LogLevel::DEBUG) << "hello world" << 3.143;
    LOG(LogLevel::DEBUG) << "hello world" << 3.144;
解析:
这两句调用的写法跟前面一模一样,但因为上面的策略已经切换了,所以这两行日志不会出现在屏幕上,而是会悄悄地被写入到./log/my_日期.txt这个文件里。
2. 线程池设计(很重要)
1.线程池概念
⼀种线程使⽤模式。线程过多会带来调度开销,进⽽影响缓存局部性和整体性能。⽽线程池维护着多个线程,等待着监督管理者分配可并发执⾏的任务。这避免了在处理短时间任务时创建与销毁线程的代价。线程池不仅能够保证内核的充分利⽤,还能防⽌过分调度。可⽤线程数量应该取决于可⽤的并发处理器、处理器内核、内存、⽹络sockets等的数量
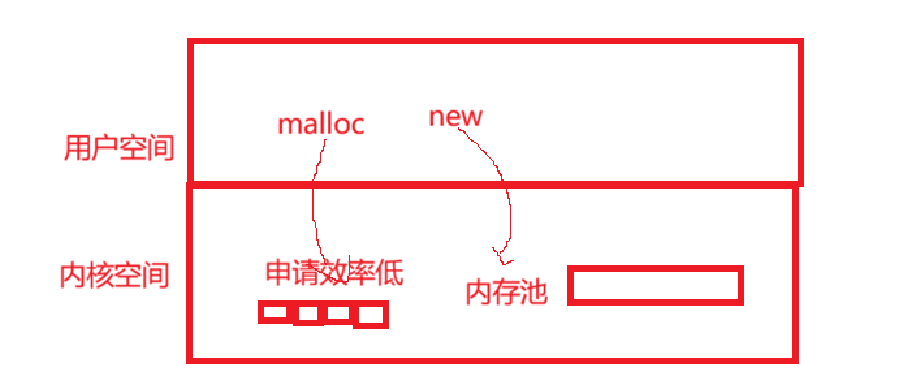
现实中有很多池化的例子。比如简历资源池,你去年去面了家大厂,技术确实不错,但当时岗位不匹配,HR没直接拒你,而是把你简历扔进了他们的人才库里。为啥搞这个池子?因为假如没有这个池子,等公司下回缺人了,他们又得重新在招聘软件上发JD、找简历、等投递、一轮轮筛,这中间花的时间、沟通成本高得吓人,有现成的好苗子在池子里,就直接捞起来面。
再比如外卖骑手接单池,你下班饿了点外卖,系统不是临时去马路上抓个路人来送,而是把方圆几公里在线的骑手放进一个“接单池”,你一点下单,池子里的骑手直接抢单或者系统派单,骑手顺路就给你送来了。没有这个接单池的话,每来一单就得临时找个新骑手注册、审核、派单,那外卖早凉透了。这就是池化带来的精准匹配和高效复用。
计算机里的“池”也是同一个道理,只不过把“人”和“单”换成了“内存”和“线程”。
内存池:以前咱们要内存,是写一行代码用一次 malloc,系统就切到内核态去申请一次,用完了再释放。用完再要,又要切进内核,来回折腾效率非常低。而内存池的做法是,一次性跟操作系统申请一大块内存拿在手里,后面程序再要小内存,就从这块大池子里直接划拉,不用反复切换进内核了,省下的就是中断和上下文切换的巨大开销,速度瞬间起飞。
线程池:那就更好理解了,相当于一家饭店提前雇好了一群服务员,让这些服务员一直坐在休息室“待机”。一旦客人点菜(有任务到来),直接招呼一个人去干活,干完活又坐回休息室,继续等下一波客人。为什么非要提前雇呢?因为如果临时来一桌客人,你就立马去大街上现招一个服务员,培训、签合同、再上岗,干完活又立马炒掉,这招人裁人的成本太高了。有了线程池,就是一次招好,随用随取,用完放回,反复利用,效率直接拉满。
为什么要有线程池?
线程池就是用提前常驻的固定人力,砍掉随叫随到的奔波成本,让每一次任务下达都能直接落地执行。落实到计算机层面,就是“池化复用”:通过一次性初始化节省高频的系统调用开销,保证任务到达时零延迟启动,且运行完成后资源不回收,始终处于待命状态。
2.线程池的应⽤场景:
- 需要⼤量的线程来完成任务,且完成任务的时间⽐较短。 ⽐如WEB服务器完成⽹⻚请求这样的任务,使⽤线程池技术是⾮常合适的。因为单个任务⼩,⽽任务数量巨⼤,你可以想象⼀个热⻔⽹站的点击次数。 但对于⻓时间的任务,⽐如⼀个Telnet连接请求,线程池的优点就不明显了。因为Telnet会话时间⽐线程的创建时间⼤多了。
- 对性能要求苛刻的应⽤,⽐如要求服务器迅速响应客⼾请求。
- 接受突发性的⼤量请求,但不⾄于使服务器因此产⽣⼤量线程的应⽤。突发性⼤量客⼾请求,在没有线程池情况下,将产⽣⼤量线程,虽然理论上⼤部分操作系统线程数⽬最⼤值不是问题,短时间内产⽣⼤量线程可能使内存到达极限,出现错误.
3.线程池的种类
1.固定数量线程池
初始化时创建固定数量的线程(如 N 个)。每个线程内部通过一个
while(true)循环,不断从任务队列中阻塞式获取任务对象。取到任务后,执行任务接口,执行完毕后再次进入循环等待。特点:线程数量恒定,资源占用稳定,不会因为任务激增而无限制消耗内存。
2. 动态(浮动)线程池
线程数量不固定,系统根据任务量的多少动态调整线程数。任务多时临时创建线程;任务空闲时自动销毁并回收多余线程。
特点:更灵活,适合任务量波动明显的场景,但需防止高峰流量下因创建过多线程导致系统宕机。
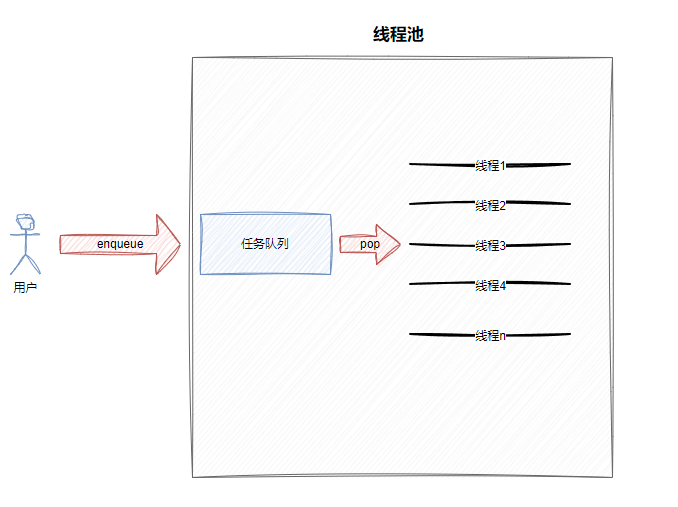
4.代码如下:
Task.hpp
Task.hpp就是给线程池定制的工作订单——线程(打工人)只管拿订单,订单里规定的“拿哪两个数、算什么算法、打什么日志报告”,都是Task这个文件负责的。这里就是Task.hpp 中的任务是完成一个具有两个整数操作数和一个处理函数的任务。
过程如下:
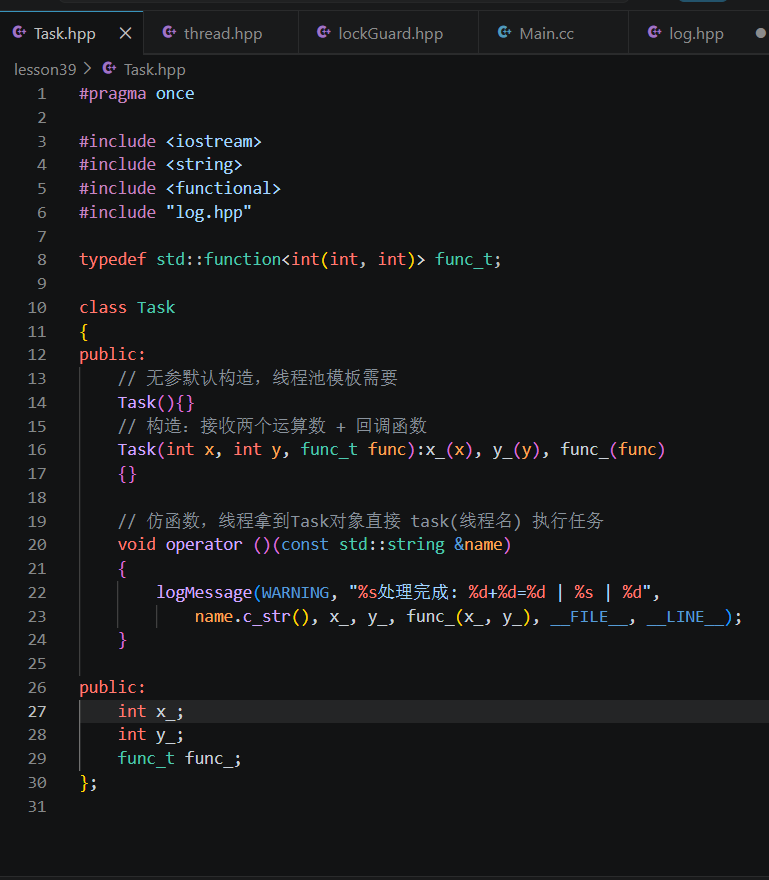
func_t:C++ 可调用对象包装器,保存一个接收两个 int、返回 int 的函数,这里用来做加法运算。Task(){}无参构造 模板类线程池getTask会T t;定义临时对象,必须要有无参默认构造,否则编译报错。operator()仿函数重载 对象可以像函数一样调用task(线程名字字符串),工作线程拿到任务直接执行。- 业务逻辑:调用保存的回调
func_(x_,y_)算出结果,调用logMessage写入日志,打印:线程名、计算表达式结果、文件名、行号。
ThreadPool.hpp
线程池
ThreadPool基于生产-消费者模型实现,采用类模板template<class T>以支持通用任务类型。核心成员包含任务队列task_queue_(临界资源)、互斥锁lock(规范命名)及条件变量cond,分别用于共享数据保护与线程休眠唤醒,同时利用threads_容器统一管理工作线程生命周期。对外暴露pushTask()负责加锁入队并触发信号,以及getTask()负责加锁判空取队首任务并自动弹栈。使用时需注意:任务类T须提供无参构造与operator();pthread_cond_wait内部自动解锁与重抢锁,无需手动干预;析构时需遍历线程join后销毁资源,防止内存与系统资源泄漏。
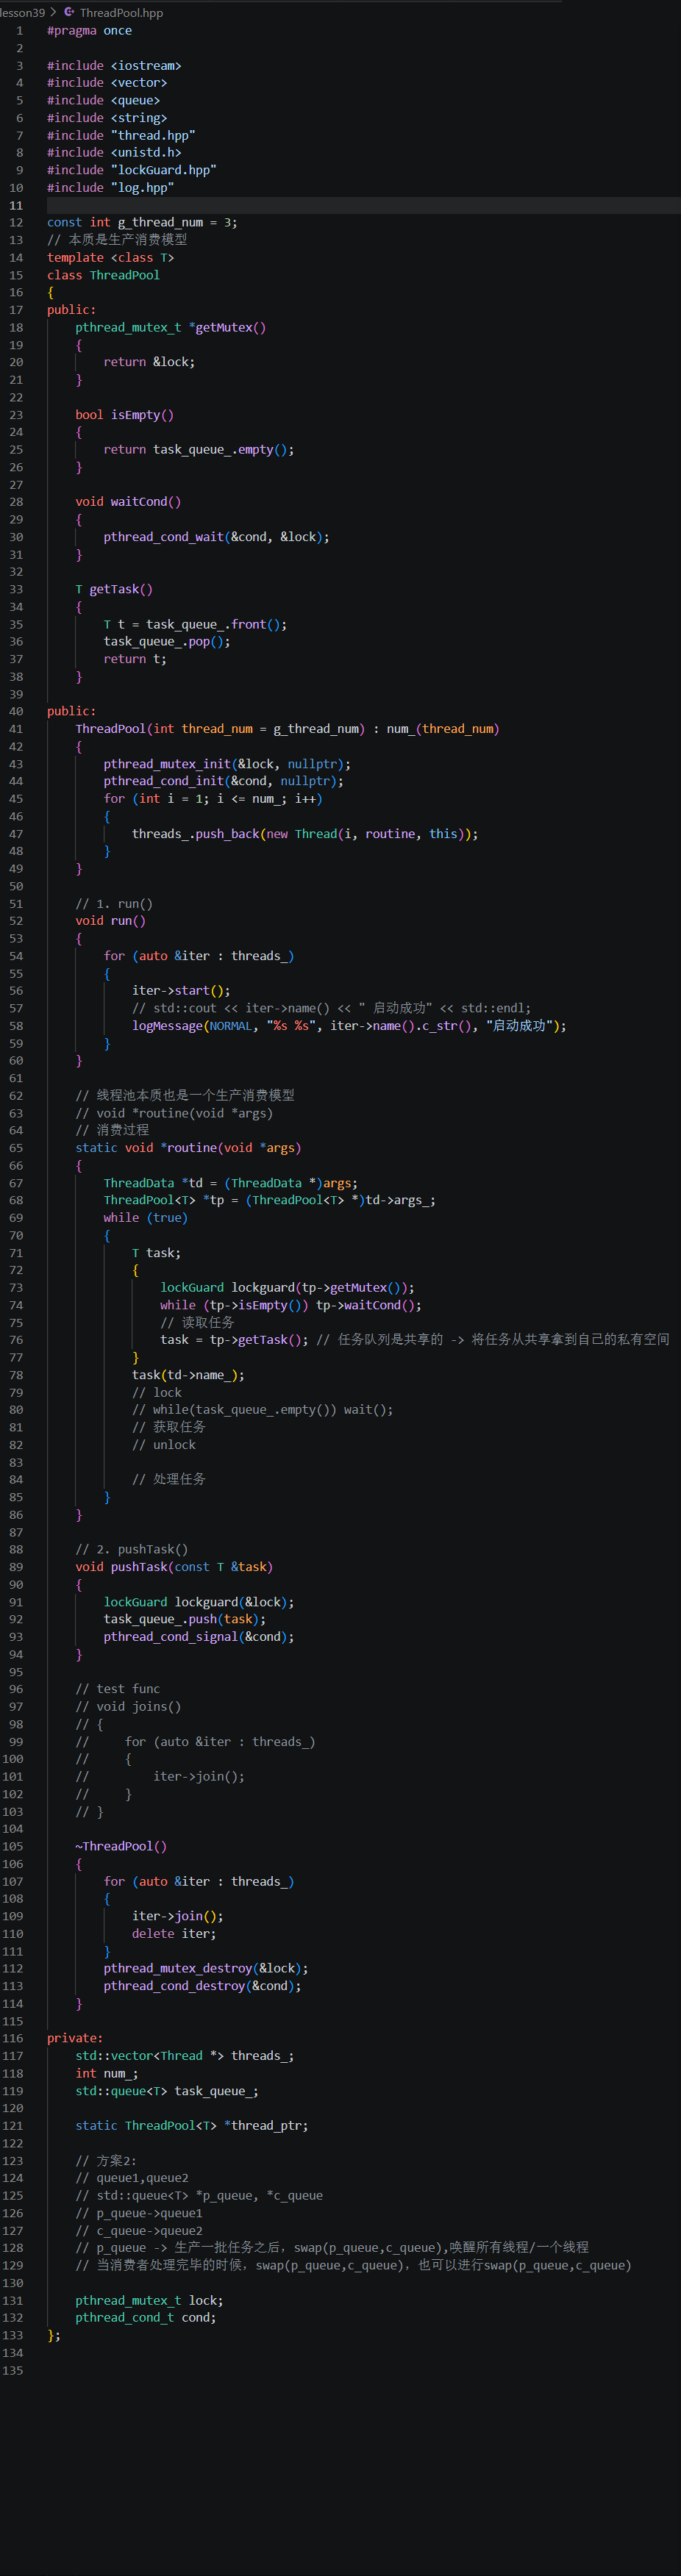
1. 头文件与常量定义(准备阶段)
#pragma once

#include <iostream>
#include <vector>
#include <string>
#include <queue>
#include <unistd.h>
#include "thread.hpp"
#include "lockGuard.hpp"
#include "log.hpp"

const int g_thread_num = 3;
// 本质是生产消费模型
template <class T>
class ThreadPool
{
引入了
"thread.hpp"(你自定义的Thread类) 和"lockGuard.hpp"(你的 RAII 锁守卫)。
const int g_thread_num = 3;:这里定义了全局默认线程数为 3。补充了上一段代码里缺的东西。
template <class T>:这是一个类模板。意味着这个线程池不绑定具体任务,只要是按照Task格式定义的类型 T,都可以塞进来跑。
2. 公有辅助接口(供线程调用的工具接口)
public:
    pthread_mutex_t *getMutex()
    {
        return &lock;
    }

    bool isEmpty()
    {
        return task_queue_.empty();
    }

    void waitCond()
    {
        pthread_cond_wait(&cond, &lock);
    }

    T getTask()
    {
        T t = task_queue_.front();
        task_queue_.pop();
        return t;
    }
这几个函数不是给主线程用的,而是专门给线程池里的工作线程准备的。
getMutex(),isEmpty(),waitCond():这三个是配合Thread类里的run()逻辑使用的。工作线程想要判断有没有任务、要不要挂起等待,全靠它们。
getTask():从队列里真正把任务拿出来的操作。注意:它没有加锁。这就意味着调用这个函数的线程,必须提前确保已经拿到了锁,才会调用这个函数,否则会出竞态问题。
3. 构造函数:初始化基础环境(未定义完)
public:
    ThreadPool(int thread_num = g_thread_num) : num_(thread_num)
    {
        pthread_mutex_init(&lock, nullptr);
        pthread_cond_init(&cond, nullptr);
        for (int i = 1; i <= num_; i++)
        {
            threads_.push_back(new Thread(i, routine, this));
        }
    }

    // 1. run()
    void run()
    {
        for (auto &iter : threads_)
        {
            iter->start();
            // logMessage(NORMAL, "%s", iter->name().c_str(), "启动成功");
        }
    }
- 构造函数:初始化 Linux 底层的互斥锁
lock和条件变量cond。根据预设的线程数num_,循环new出Thread对象。new Thread(i, routine, this):非常关键!它将静态函数routine作为线程的入口函数,并将当前线程池实例的指针this传给线程内部,让工作线程知道它属于哪个池子。
run()方法:遍历存好的线程列表,调用iter->start()让每个线程真正开始跑起来。注释:
logMessage语句是注释状态,用于在控制台提示线程启动成功。
4. 核心接口:投放任务(生产者)
 // 2. pushTask()
    void pushTask(const T &task)
    {
        lockGuard lockguard(&lock);
        task_queue_.push(task);
        pthread_cond_signal(&cond);
    }
这是主线程用的接口。
加锁:
lockGuard lockguard(&lock);包裹起来,自动构造加锁、析构解锁。入队:
task_queue_.push(task);唤醒:
pthread_cond_signal(&cond);,告诉正在休眠的线程“有新任务了,快来抢”。
5. 析构函数:回收线程与销毁资源(清理现场)
 ~ThreadPool()
    {
        for (auto &iter : threads_)
        {
            iter->join();
            delete iter;
        }
        pthread_mutex_destroy(&lock);
        pthread_cond_destroy(&cond);
    }
销毁对象时收尾。
iter->join():等待每个工作线程把当前任务处理完毕。
delete iter:释放new出来的Thread对象内存。
pthread_mutex_destroy/pthread_cond_destroy:归还系统底层的锁和条件变量资源。
6. 私有成员变量(数据仓库)
private:
    std::vector<Thread *> threads_;
    int num_;
    std::queue<T> task_queue_;

    static ThreadPool<T> *thread_ptr;

    // 方案2: ... (双队列 swap 优化策略注释)

    pthread_mutex_t lock;
    pthread_cond_t cond;
threads_:存放所有工作线程指针的动态数组。
task_queue_:存放任务对象的共享队列。
static ThreadPool<T> *thread_ptr;:一个静态指针,通常用于实现“单例模式”(全局只存在一个线程池),方便各处调用。方案2:非常专业的设计思路。它提到用两个队列(生产队列、消费队列),当一个队列满了以后直接用
swap交换指针。这样做的好处是:减少了加锁的时间,属于高效的无锁/少锁队列优化思想。
Main.cc测试
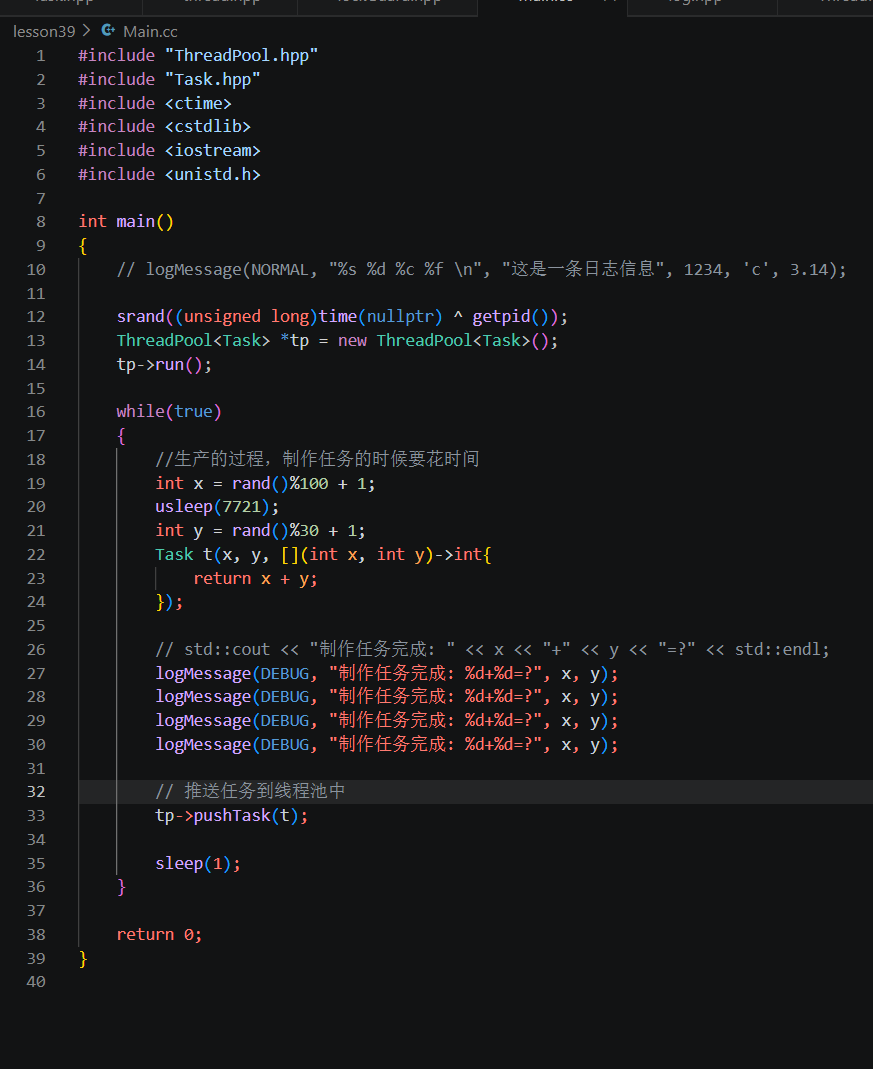
过程如下:
1.引入依赖与准备环境
#include "threadPool.hpp"
#include "Task.hpp"
#include <ctime>
#include <cstdlib>
#include <iostream>
#include <unistd.h>
解析:
引入了你最核心的两个自定义头文件:
threadPool.hpp(线程池调度)和Task.hpp(定义任务长什么样)。
<ctime>&<cstdlib>:用来生成随机数。
<unistd.h>:提供sleep和usleep函数,用来模拟耗时操作。
2. 初始化随机数种子
srand((unsigned long)time(nullptr) ^ getpid());
解析:
C 语言里生成随机数之前必须要播种。如果不播种,每次程序运行的随机数顺序都是一样的。
这里使用了
time(nullptr)(当前时间戳)与getpid()(当前程序的进程 ID)进行异或 (^) 操作,作为随机数种子。这种写法能极大增加种子的随机性,防止同一个时间运行的两个进程产生一模一样的随机数。
3. 创建线程池并启动
ThreadPool<Task> *tp = new ThreadPool<Task>();
    tp->run();
解析:
ThreadPool<Task>:因为你的线程池是一个类模板,所以这里用尖括号<Task>指定了线程池要处理的任务类型就是Task类。
new ThreadPool<Task>():在堆上动态申请了一个线程池对象(默认 3 个线程)。
tp->run();:调用run方法。根据你threadPool.hpp的代码,这里的run实际上是在执行join(),主线程会卡在这里等待子线程结束。
4. 生产任务循环
 while(true)
    {
        //生产的过程,制作任务的时候要花时间
        int x = rand()%100 + 1;
        usleep(7721);
        int y = rand()%30 + 1;
        Task t(x, y, [](int x, int y)->int{
            return x + y;
        });
解析:
while(true):这是主线程的死循环。程序不关,主线程就一直不断产生新任务。
rand()%100 + 1:随机生成 1~100 之间的数字作为操作数x。usleep(7721)给 CPU 一点喘息的时间,模拟“运算”或者“准备数据”的微小耗时。
Task t(x, y, [](int x, int y)->int{ return x + y; });:这段展示了现代 C++ 极简的写法。它直接在构造Task的时候,原地抛了一个 Lambda 匿名函数[](int x, int y)->int{ return x + y; }进去。意思就是:这个任务的任务就是“对 x 和 y 做加法”。
5. 打印日志记录生产情况
// std::cout << "制作任务完成: " << x << "+" << y << "=?" << std::endl;
        logMessage(DEBUG, "制作任务完成: %d+%d=?", x, y);
        logMessage(DEBUG, "制作任务完成: %d+%d=?", x, y);
        logMessage(DEBUG, "制作任务完成: %d+%d=?", x, y);
        logMessage(DEBUG, "制作任务完成: %d+%d=?", x, y);
解析:我弃用了
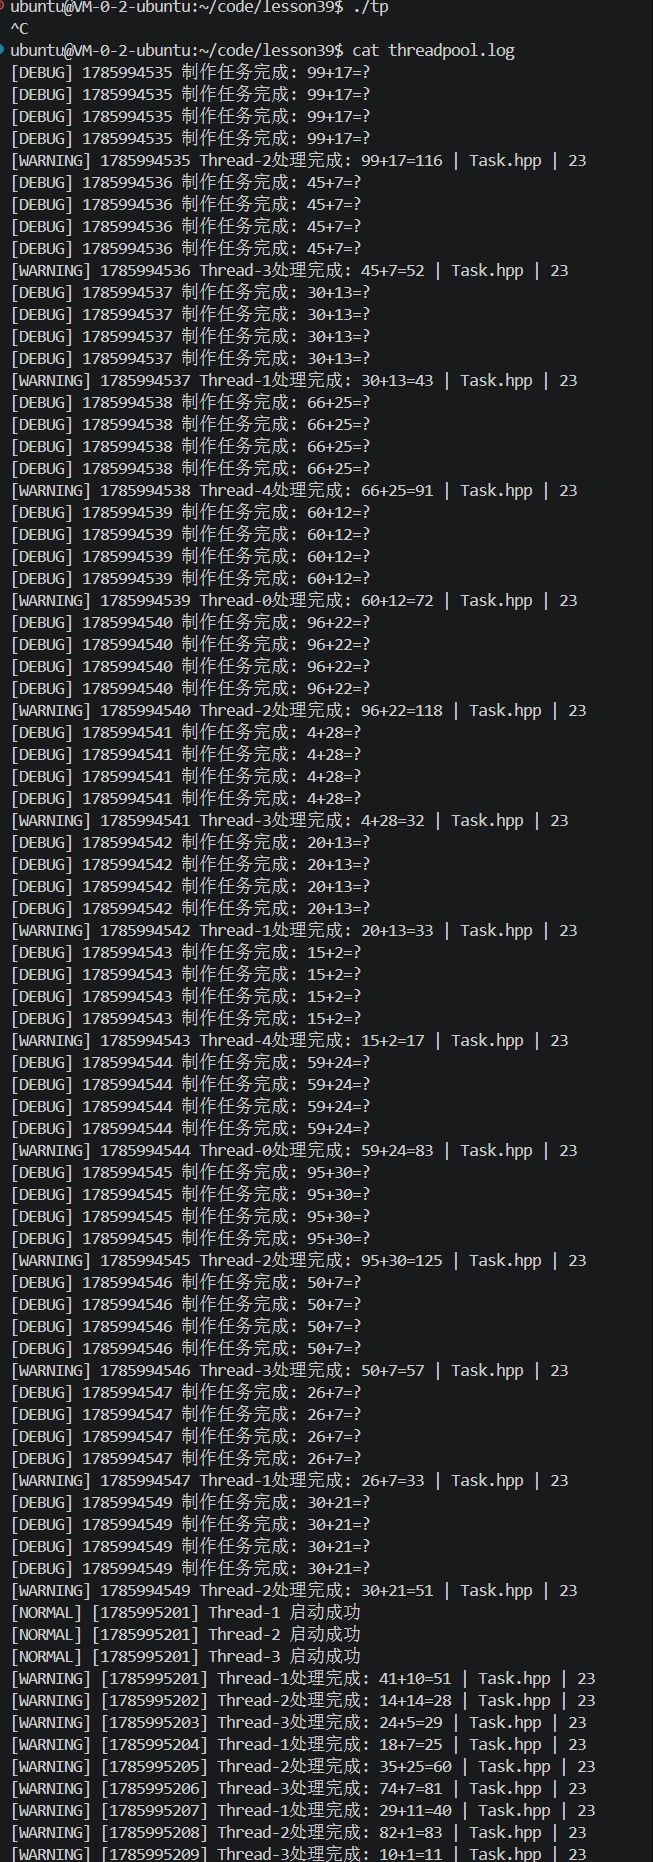
std::cout手动打印,改用了logMessage日志系统。我是在做日志并发测试,想看看当 3 个线程都在抢着执行任务、主线程在疯狂投递时,日志库能不能扛住连续高并发的输出,有没有丢失或者乱序。如果这是无意多贴的,后面删掉多余的即可。
6. 向线程池投递任务
// 推送任务到线程池中
        tp->pushTask(t);

        sleep(1);
    }
解析:
tp->pushTask(t);:老板把做好的订单(任务)扔进队列里。这一扔,池子里正在休眠的“打工仔”(线程)就会被pthread_cond_signal唤醒,然后从队列里把这个任务抢走开始计算。
sleep(1);:每次生产完一个任务,主线程休息 1 秒钟。这也是为了控制生产的速度,防止主线程瞬间生产几万个任务把任务队列撑爆。
log.hpp 日志模块
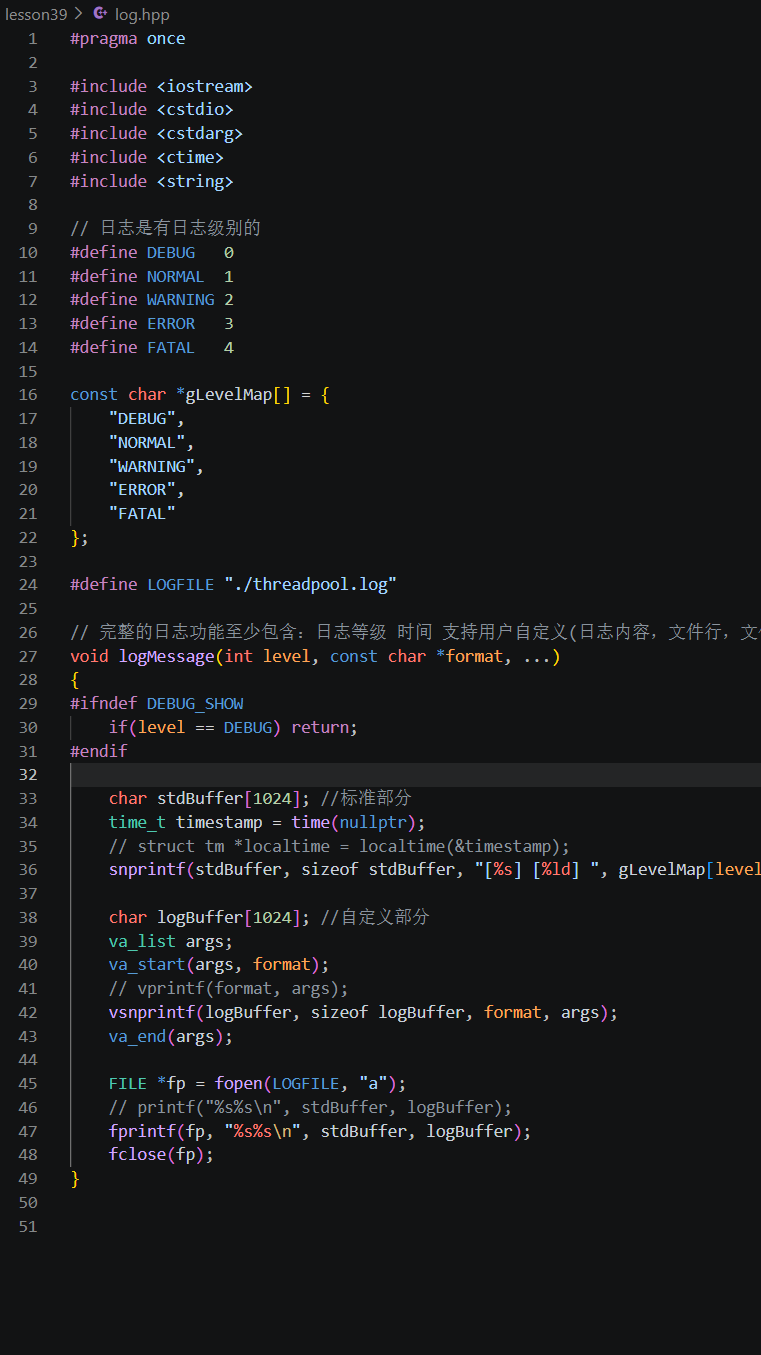
解析
- 使用
va_list处理 C 语言可变参数,模仿printf;- 每条日志包含日志级别 + 时间戳 + 用户信息,追加写入
threadpool.log;- 宏
DEBUG_SHOW可以控制是否屏蔽 DEBUG 日志。
thread.hpp 封装 pthread 原生线程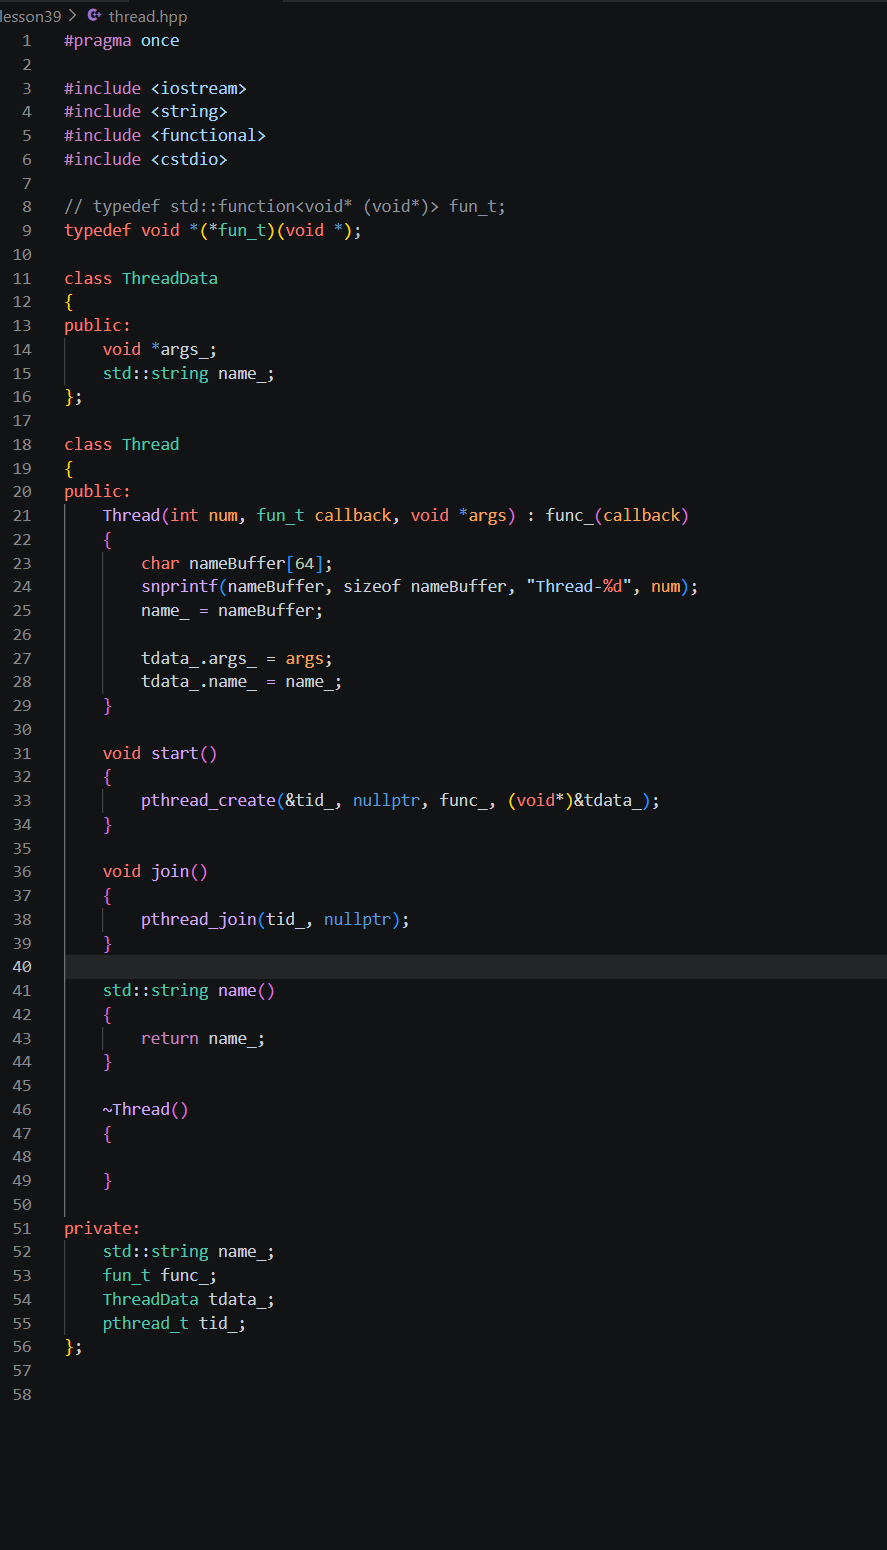
解析
- 对原生
pthread_create做面向对象封装;ThreadData用来传递线程名称、自定义参数给线程入口函数;start()负责创建线程,join()等待回收。
lockGuard.hpp RAII 锁封装
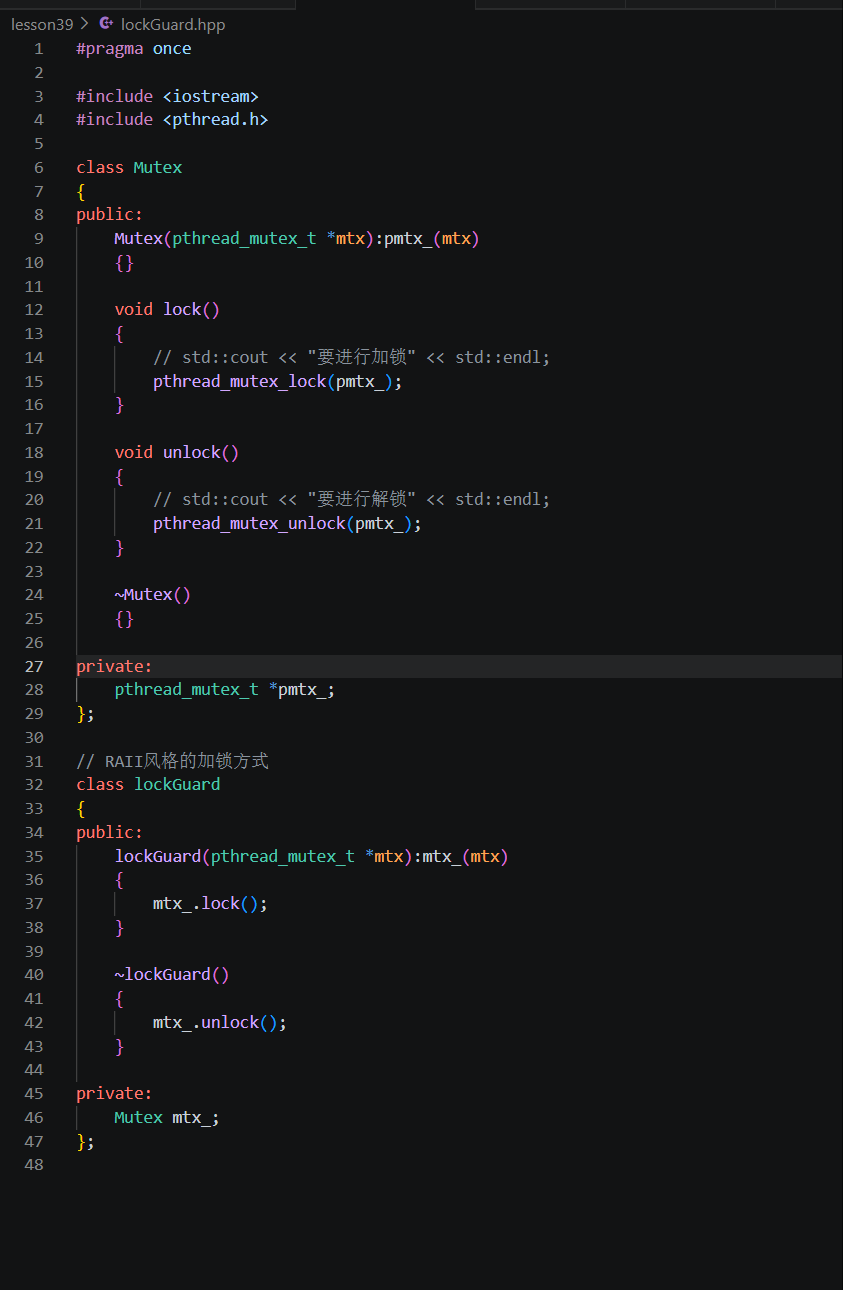
解析:
Mutex简单包装原生互斥锁接口;- lockGuard:RAII 思想,对象创建上锁,出作用域析构自动解锁;
- 前面线程池
pushTask就是用lockGuard lockguard(&lock);自动管理锁。
Makefile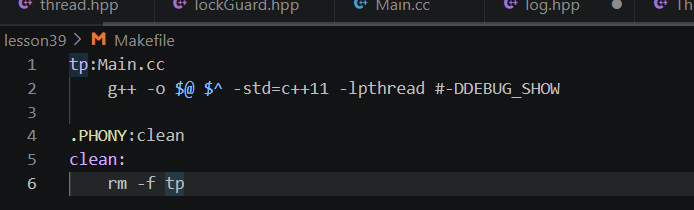
#-DDEBUG_SHOW:这是个被#注释掉的宏定义。如果去掉#,相当于在编译时添加了#define DEBUG_SHOW。这通常用来开启代码里打印调试信息的开关
整套工程关系梳理
log.hpp:日志工具,记录任务信息;thread.hpp:封装系统 pthread,便于创建多个工作线程;lockGuard.hpp:RAII 锁,代替手动 lock/unlock;threadPool.hpp:线程池本体,任务队列 + 条件变量,生产者消费者模型;testMain.cc:main 函数,循环生产任务丢进线程池;Task.hpp:任务类,重载operator()仿函数,保存计算任务。
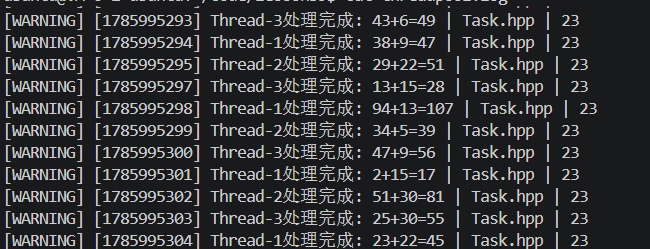
运行结果:
二.线程安全的单例模式
1.单例模式
单例模式是一种 “经典的,常用的,常考的” 设计模式;单例模式就是只准造一个,绝不准造第二个。
2.单例模式的特点
某些类, 只应该具有⼀个对象(实例), 就称之为单例.
例如⼀个男⼈只能有⼀个媳妇.
在很多服务器开发场景中, 经常需要让服务器加载很多的数据 (上百G) 到内存中. 此时往往要⽤⼀个单例的类来管理这些数据.
3.饿汉实现⽅式和懒汉实现⽅式
单例模式里面分为饿汉模式和懒汉模式,这两种模式在本质上的区别就只有一个,那就是这个单例对象是在什么时候被加载到内存里的。一般来说,一个单例对象可能占用很大的内存空间,饿汉模式就是程序一启动,立刻就把这个对象加载到内存里,而懒汉模式则是不着急,一直拖到别人第一次调用它的时候,才临时把对象创建出来加载到内存里。这也就是饿汉和懒汉各自存在的意义:饿汉模式可以省去多线程竞争创建的开销,但缺点是一开始就占用了内存;懒汉模式可以节省内存,但多线程首次创建时就必须考虑加锁保护的问题。
洗碗的例⼦
- 吃完饭, ⽴刻洗碗, 这种就是饿汉⽅式. 因为下⼀顿吃的时候可以⽴刻拿着碗就能吃饭.
- 吃完饭, 先把碗放下, 然后下⼀顿饭⽤到这个碗了再洗碗, 就是懒汉⽅式.
懒汉⽅式最核⼼的思想是 "延时加载". 从⽽能够优化服务器的启动速度.
4.饿汉⽅式实现单例模式
template <typename T>
class Singleton {
private:
    Singleton() = default;                    // 1. 私有构造,禁止外部 new
    Singleton(const Singleton&) = delete;     // 2. 禁止拷贝
    Singleton& operator=(const Singleton&) = delete; // 3. 禁止赋值

    static T data;                            // 4. 静态成员:程序启动时即构造(饿汉)

public:
    static T* GetInstance() {
        return &data;                         // 5. 返回唯一实例的地址
    }
};

template <typename T>
T Singleton<T>::data = T();                   // 6. 类外定义并初始化静态成员
5.懒汉⽅式实现单例模式
template <typename T>
class Singleton {
private:
    static T* inst;                         // 1. 静态指针,初始为空

    Singleton() = default;                  // 2. 私有构造,禁止外部 new
    Singleton(const Singleton&) = delete;   // 3. 禁止拷贝
    Singleton& operator=(const Singleton&) = delete; // 4. 禁止赋值

public:
    static T* GetInstance() {
        // 多线程下,线程A和线程B同时判断 inst == nullptr 都为真,
        // 结果 A 和 B 都执行了 new T(),内存里出现了两个不同的对象。
        if (inst == nullptr) {
            inst = new T();                 // 5. 没有加锁保护,不安全!
        }
        return inst;
    }
};

// 6. 静态成员变量必须在类外初始化
template <typename T>
T* Singleton<T>::inst = nullptr;
存在⼀个严重的问题, 线程不安全.第⼀次调⽤ GetInstance 的时候, 如果两个线程同时调⽤, 可能会创建出两份 T 对象的实例.
但是后续再次调⽤, 就没有问题了.
6.懒汉⽅式实现单例模式(线程安全版本)
#include <mutex>
#include <atomic> // 引入原子操作头文件

template <typename T>
class Singleton {
private:
    // 现代 C++ 不建议用 volatile 解决多线程同步问题。
    // 使用 std::atomic 保证赋值操作的原子性,防止指令重排。
    static std::atomic<T*> inst;
    static std::mutex lock;

    Singleton() = default;
    Singleton(const Singleton&) = delete;
    Singleton& operator=(const Singleton&) = delete;

public:
    static T* GetInstance() {
        // 1. 第一层检查:不用加锁,快速判断
        T* tmp = inst.load(std::memory_order_acquire); // 读取当前状态
        if (tmp == nullptr) {
            // 2. 加锁,保证只有一个线程能进入 new 逻辑
            lock.lock();

            // 3. 第二层检查(双重判定):防止刚才释放锁的时候,别的线程已经 new 好了
            tmp = inst.load(std::memory_order_relaxed);
            if (tmp == nullptr) {
                tmp = new T();
                // 4. 存储指针,使用 release 语义防止 new 的构造过程被重排到赋值之后
                inst.store(tmp, std::memory_order_release);
            }

            lock.unlock();
        }
        return tmp;
    }
};

//静态成员变量必须在类外定义并初始化
template <typename T>
std::atomic<T*> Singleton<T>::inst = nullptr;

template <typename T>
std::mutex Singleton<T>::lock;
注意事项:
- 加锁解锁的位置
- 双重 if 判定, 避免不必要的锁竞争
- volatile关键字防⽌过度优化
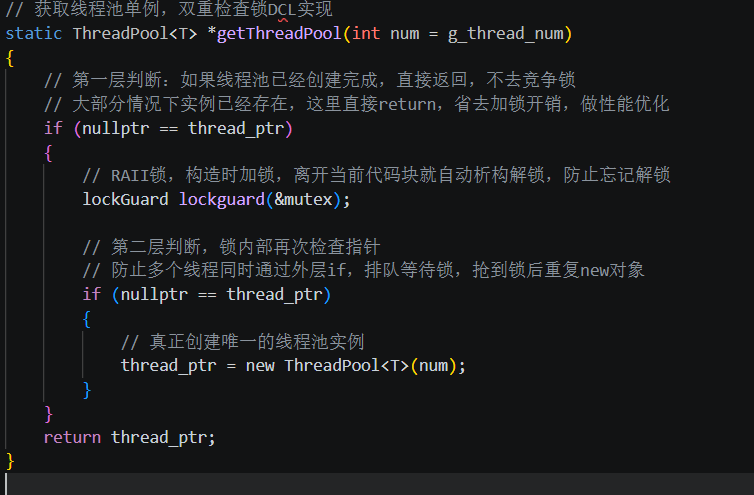
普通懒汉单例不加锁,多线程会创建多个对象;如果函数开头直接加锁,每次调用都要抢锁,效率很低。 双重检查锁兼顾安全和效率。但要注意 CPU 指令重排序问题,极端可能返回还没构造完毕的对象,C++11 可以用 atomic 修饰指针规避这个问题。
代码如下:
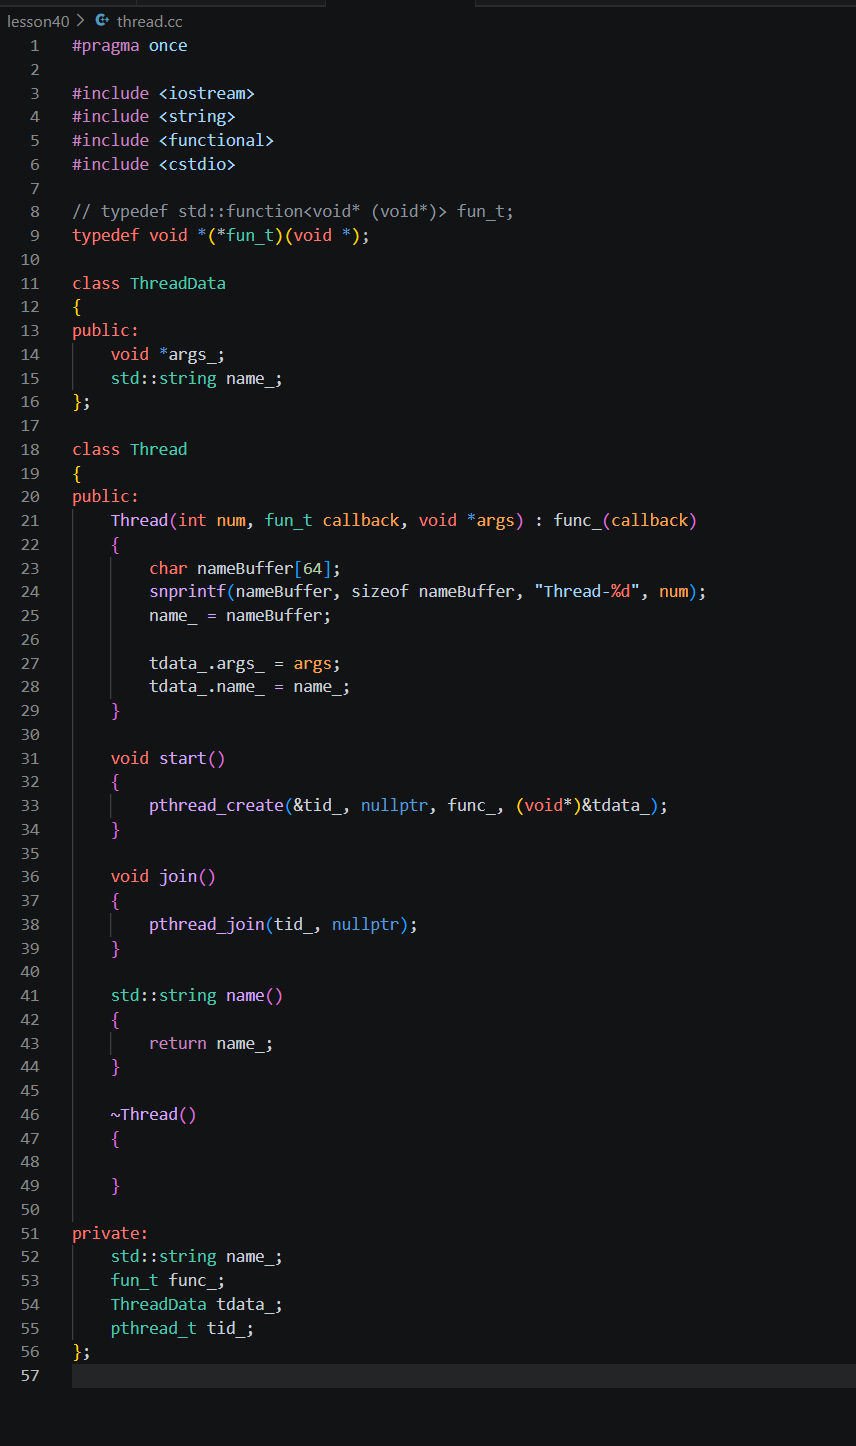
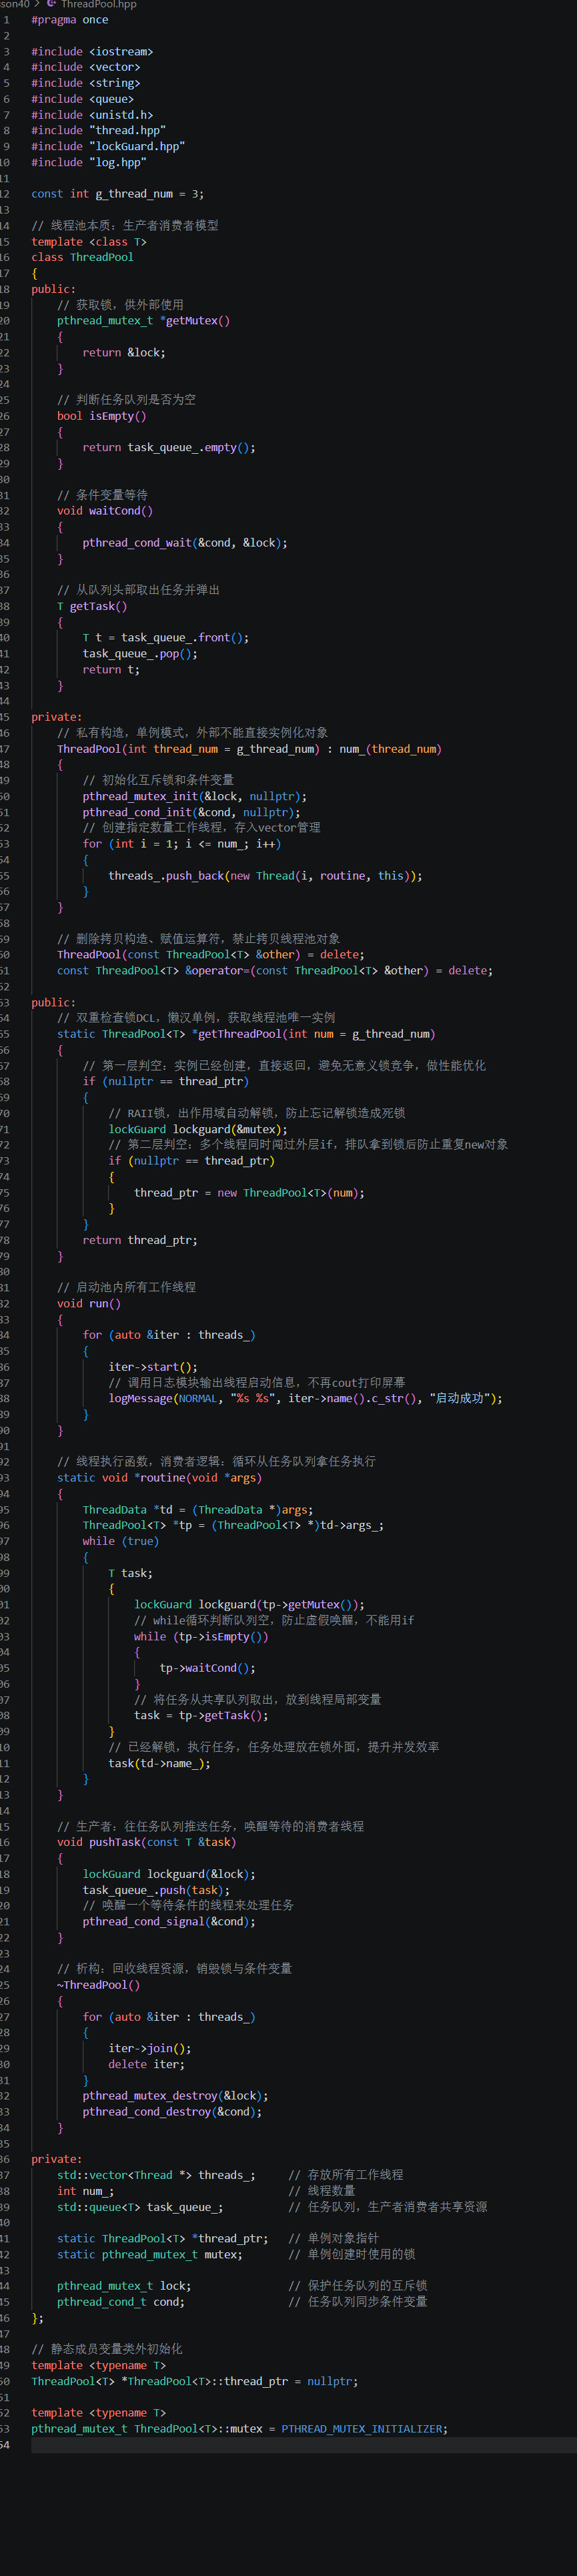
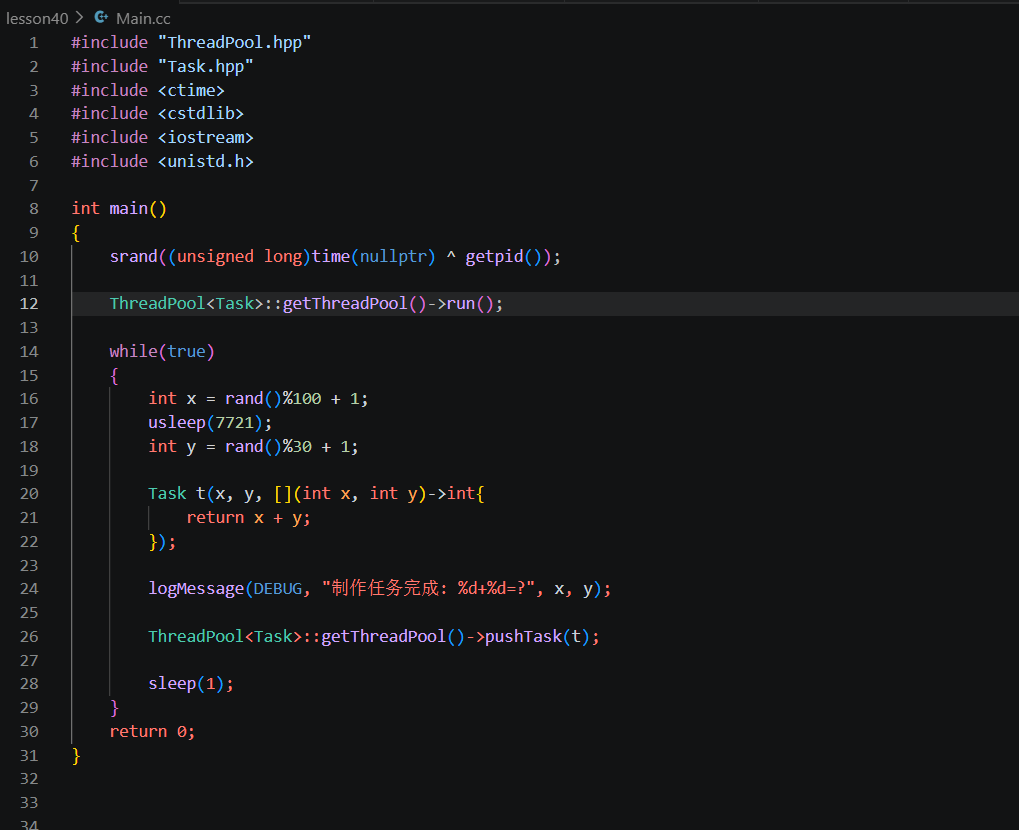
三.STL,智能指针和线程安全
1.STL中的容器是否是线程安全的?
不是.原因是, STL 的设计初衷是将性能挖掘到极致, ⽽⼀旦涉及到加锁保证线程安全, 会对性能造成巨⼤的影响.⽽且对于不同的容器, 加锁⽅式的不同, 性能可能也不同(例如hash表的锁表和锁桶).因此 STL 默认不是线程安全. 如果需要在多线程环境下使⽤, 往往需要调⽤者⾃⾏保证线程安全.
2.智能指针是否是线程安全的?
智能指针的线程安全性因类型而异:
对于 unique_ptr, 由于只是在当前代码块范围内⽣效, 因此不涉及线程安全问题.
对于 shared_ptr, 多个对象需要共⽤⼀个引⽤计数变量, 所以会存在线程安全问题. 但是标准库实现的时候考虑到了这个问题, 基于原⼦操作(CAS)的⽅式保证 shared_ptr 能够⾼效, 原⼦的操作引⽤计数.
四.其他常⻅的各种锁
- 悲观锁:在每次取数据时,总是担⼼数据会被其他线程修改,所以会在取数据前先加锁(读锁,写锁,⾏锁等),当其他线程想要访问数据时,被阻塞挂起。
- 乐观锁:每次取数据时候,总是乐观的认为数据不会被其他线程修改,因此不上锁。但是在更新数据前,会判断其他数据在更新前有没有对数据进⾏修改。主要采⽤两种⽅式:版本号机制和CAS操作。
- CAS操作:当需要更新数据时,判断当前内存值和之前取得的值是否相等。如果相等则⽤新值更新。若不等则失败,失败则重试,⼀般是⼀个⾃旋的过程,即不断重试。
- ⾃旋锁,读写锁,加餐课详细介绍

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 35
 0
- 0


 已为社区贡献1条内容

所有评论(0)