高可用与负载均衡
一、C/S 架构 和 B/S 架构
概念定义
- C/S(Client / Server,客户端 / 服务器架构)
结构:专门安装客户端程序 + 服务端
例子:微信、QQ、迅雷、桌面版钉钉、英雄联盟游戏
工作方式:用户电脑安装独立客户端软件,客户端直接和服务器通信。 - B/S(Browser / Server,浏览器 / 服务器架构)
结构:浏览器 + Web 服务器
例子:网页版淘宝、网页邮箱、你实验访问的 Apache 网页
工作方式:不需要安装专用软件,只用 Chrome/Firefox 浏览器访问服务器。
二、高可用架构
2.1 基础概念
高可用:尽量消除单点故障,保证业务持续对外提供服务,减少停机时间。
核心目标:故障发生时,业务自动切换,用户几乎感知不到中断。
2.2 核心思想
- 消除单点:关键服务部署多台节点(主 / 备、多活)
- 故障检测:程序持续探测节点健康状态
- 自动转移:故障节点下线,流量切换至正常节点
- 数据同步:保证主、备节点数据一致(Web 页面、数据库数据)
2.3 两种常见模式
1.主备模式(Active / Standby)
- 主节点:正常承担业务流量
- 备节点:平时空闲,只同步数据;主宕机,备自动接管
✅ 优点:简单、成本低
❌ 缺点:备用资源长期闲置
2.双活 / 多活模式(Active / Active)
多台服务器同时对外提供服务,共同分担流量;一台故障,剩下节点承接全部请求。
例:多台 Apache 负载均衡集群。
2.4 Linux 环境典型高可用组件
- 负载均衡(LVS / Nginx)
前端分发流量到多台 Web 服务器,实现水平扩展 + 故障隔离 - 集群资源管理(Pacemaker+Corosync)
RHCE 标准 HA 集群套件,管理虚拟 IP、服务自动迁移 - 虚拟 IP(VIP / 浮动 IP)
对外统一访问地址;主服务器故障,VIP 自动漂移到备机
三、负载均衡架构
3.1 核心概念
负载均衡(Load Balance)
将客户端的大量访问请求,按照策略分发到后端多台业务服务器,分摊压力。
解决单机性能瓶颈,实现业务水平扩容;同时附带故障隔离能力。
✅ 高可用 HA:解决「服务器宕机,业务不中断」
✅ 负载均衡:解决「访问量太大,一台服务器扛不住」
二者经常组合部署,但目标不一样。
3.2 标准架构模型
客户端 → 负载均衡调度器 → 后端Web服务器集群(多台httpd/nginx)
- 调度器:接收所有请求,选择一台后端节点转发
- 后端池:多台功能一致的业务服务器
3.3 Linux 常见负载均衡实现方案
- LVS(Linux Virtual Server,内核四层负载均衡)
工作在传输层(TCP/IP),性能极高;只转发数据包,不拆解应用层内容。 - Nginx(七层负载均衡)
工作在应用层,可以识别 HTTP 协议、URL、Cookie;灵活性强,适合 Web 业务。 - HAProxy
专业四层 / 七层均衡,常用于 Web、数据库集群。
3.4 常见调度算法
- 轮询 rr:请求依次轮流分给每台服务器
- 加权轮询 wrr:性能强的机器分配更多请求
- IP_hash:同一客户端 IP 始终访问同一台后端(用于保持会话)
- 最小连接:优先分给当前连接数最少的服务器
四、LVS负载均衡
4.1 什么是 LVS
LVS(Linux Virtual Server,Linux 虚拟服务器)
- 工作在内核层(
ip_vs内核模块) - 四层负载均衡(基于 TCP/IP 端口,不解析 HTTP 七层内容)
- 调度器名字:Director;后端真实服务器:RealServer(RS)
- 工具:用户空间管理工具
ipvsadm
四层负载特点:转发速度极快,性能远超 Nginx 七层负载。
4.2 三大工作模式
1. NAT 模式(LVS-NAT)
原理:网络地址转换
- 用户请求→Director;Director 修改数据包目标 IP,转发给 RS
- RS 响应数据包必须经过 Director,Director 修改源 IP 回包给用户
特点
- RS 和 Director 内网互通,RS 网关必须指向 Director 内网网卡
- RS 可以是任意操作系统
- 缺点:所有进出流量都经过 Director,Director 容易瓶颈
2. DR 模式(LVS-DR)
原理:直接路由,修改二层 MAC 地址转发
- 请求:用户→Director;Director 只修改目标 MAC,转发给同网段 RS
- 响应:RS 直接把数据包回复客户端,不经过 Director
特点
- Director 只处理入站流量,出站流量绕开调度器,性能高
- Director 与 RS 必须在同一个广播域(同一网段)
- RS 需要在 lo 网卡绑定 VIP,抑制 ARP 响应(关键配置)
3. TUN 模式(LVS-TUN,隧道模式)
原理:IP 隧道封装
Director 把原始 IP 包外层再套一层 IP 头,通过隧道发给 RS;RS 解封装处理,直接回包
特点
- Director 和 RS可以跨网段、跨公网
- RS 内核必须支持 IPIP 隧道模块
生产使用很少。
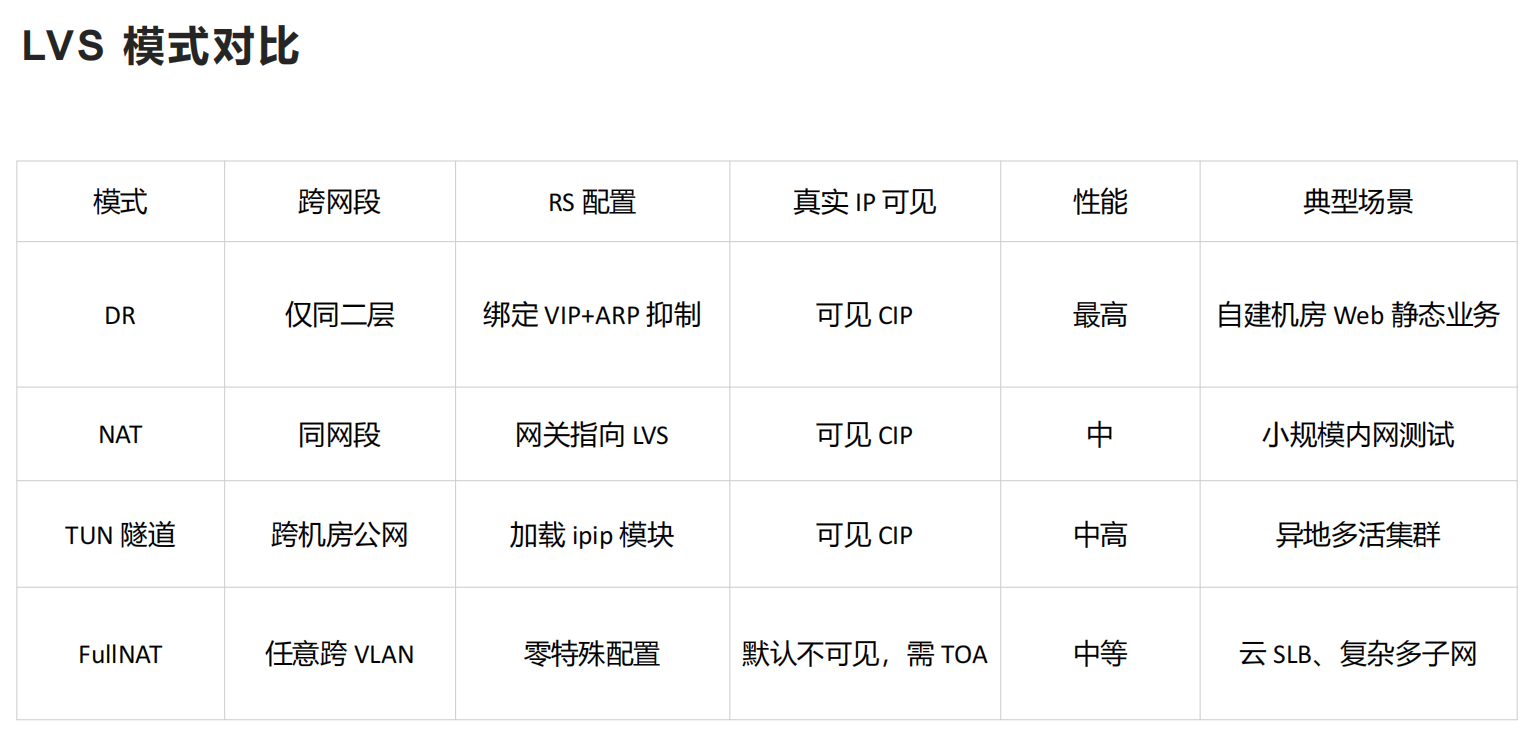
4.3 核心概念补充
- VIP(Virtual IP):虚拟服务的 IP 地址,对外提供服务的入口。
- RIP(Real IP):后端真实服务器的 IP 地址。
- 调度算法:决定请求如何分配到后端服务器的规则。
- 转发模式:LVS 实现负载均衡的技术方式(DR 模式最常用,性能最好)。ipvsadm 是构建 LVS 集群的核心工具,配合 Keepalived 可实现负载均衡 + 高可用的完整解决方案。
4.4 两种服务
ipvsadm:部署在 Director(调度器),管理四层负载均衡规则,LVS 三种模式通用
arptables:部署在 RealServer(后端节点),仅 DR 模式用来解决 ARP 冲突;NAT 模式完全不用
4.4.1 ipvsadm
-
添加虚拟服务 VS
作用:创建 VIP + 端口,指定调度算法
格式:ipvsadm -A|-E -t|u VIP:端口 -s 算法
-A新增;-E编辑;-tTCP;-uUDP;-s调度算法
常用算法:
rr:轮询(Round Robin)
wrr:加权轮询(Weighted RR)
lc:最少连接(Least Connections)
wlc:加权最少连接(Weighted LC)
sh:源地址哈希(Source Hash,会话保持)
dh:目标地址哈希(Destination Hash) -
添加后端服务器 RS
作用:给虚拟服务增加真实后端节点,指定 LVS 工作模式
格式:ipvsadm -a|-e -t|u VIP:端口 -r RSIP[:端口] [-g|-m|-i]
-a新增 RS;-gDR;-mNAT;-iTUN -
查看规则
作用:查看当前内核 LVS 转发策略
格式:ipvsadm -ln -
清空全部 ipvs 规则
作用:清空内存中所有 LVS 策略
格式:ipvsadm -C -
保存规则
作用:把内核内存规则导出到文件
格式:ipvsadm-save [-n] > 文件路径
4.4.2 arptables
- 添加 ARP 过滤规则
作用:禁止本机响应针对 VIP 的 ARP 请求
格式:arptables -A 链名 -d VIP -j DROP
-A IN入站 ARP;-d匹配 ARP 目标 IP - 查看 ARP 规则
作用:查看当前 arptables 策略
格式:arptables -L - 清空所有 ARP 规则
作用:清空全部 arptables 策略
格式:arptables -F - 保存 arptables 规则
作用:持久化 ARP 防火墙规则
格式:arptables-save > 文件路径
4.5 DR模式示例
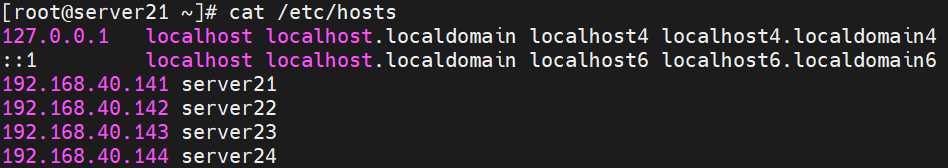
| 主机名 | ip | vip | 角色 |
|---|---|---|---|
| server21 | 192.168.40.141 | 192.168.40.100 | 调度器(VS) |
| server22 | 192.168.40.142 | 192.168.40.100 | 真实服务器(RS) |
| server23 | 192.168.40.143 | 192.168.40.100 | 真实服务器(RS) |
| server24 | 192.168.40.144 | 测试机 |
配置之前需要将四台虚拟机的IP地址分别写进四台机器的/etc/hosts进行解析
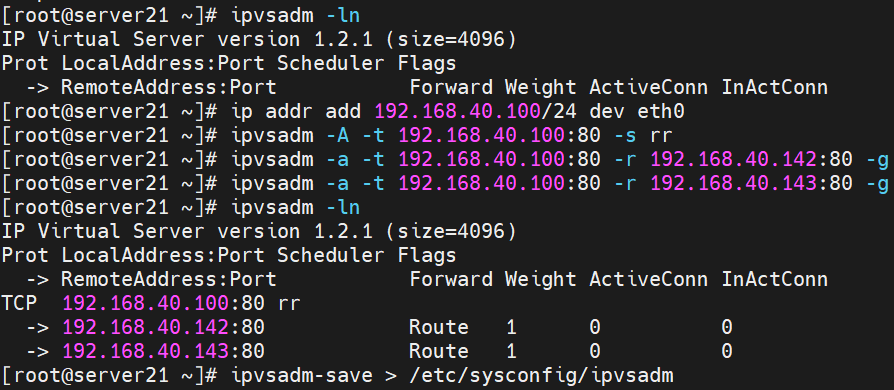
- VS调度器配置
[root@server21 ~]# yum install -y ipvsadm
[root@server21 ~]# ipvsadm -ln
[root@server21 ~]# ip addr add 192.168.40.100/24 dev eth0
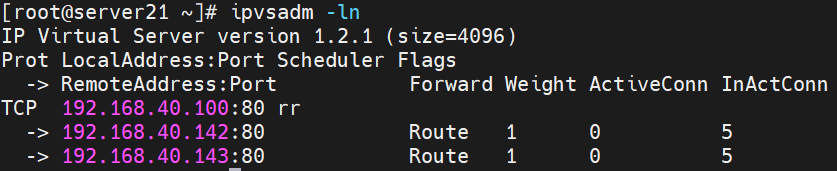
[root@server21 ~]# ipvsadm -A -t 192.168.40.100:80 -s rr
[root@server21 ~]# ipvsadm -a -t 192.168.40.100:80 -r 192.168.40.142:80 -g
[root@server21 ~]# ipvsadm -a -t 192.168.40.100:80 -r 192.168.40.143:80 -g
[root@server21 ~]# ipvsadm -ln
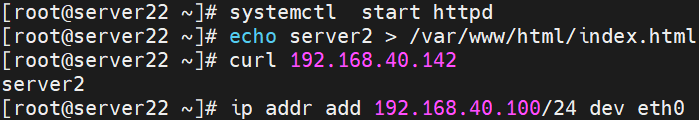
- RS真实服务器配置
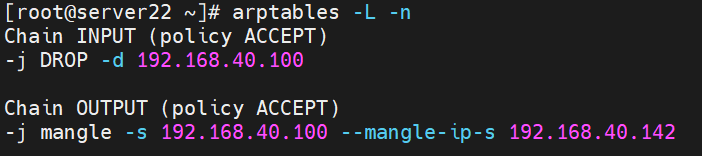
server22:
[root@server22 ~]# yum install -y httpd
[root@server22 ~]# systemctl  start httpd
[root@server22 ~]# echo server2 > /var/www/html/index.html
[root@server22 ~]# curl 192.168.40.142
[root@server22 ~]# ip addr add 192.168.40.100/24 dev eth0
[root@server22 ~]# yum install arptables
[root@server22 ~]# arptables -A INPUT -d 192.168.40.100 -j DROP
[root@server22 ~]# arptables -A OUTPUT -s 192.168.40.100 -j mangle --mangle-ip-s 192.168.40.142
[root@server22 ~]# arptables-save  > /etc/sysconfig/arptables
[root@server22 ~]# systemctl enable arptables

server23:
[root@server23 ~]# yum install -y httpd
[root@server23 ~]# systemctl  enable --now httpd
[root@server23 ~]# echo server3 > /var/www/html/index.html
[root@server23 ~]# ip a a 192.168.40.100/24 dev eth0
[root@server23 ~]# yum install arptables
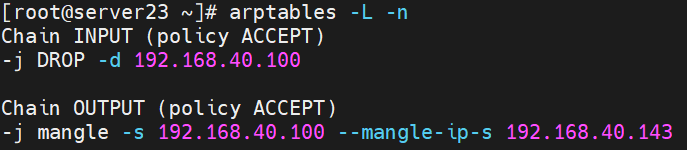
[root@server23 ~]# arptables -A INPUT -d 192.168.40.100 -j DROP
[root@server23 ~]# arptables -A OUTPUT -s 192.168.40.100 -j mangle --mangle-ip-s 192.168.40.143
[root@server23 ~]# arptables-save  > /etc/sysconfig/arptables
[root@server23 ~]# systemctl enable arptables
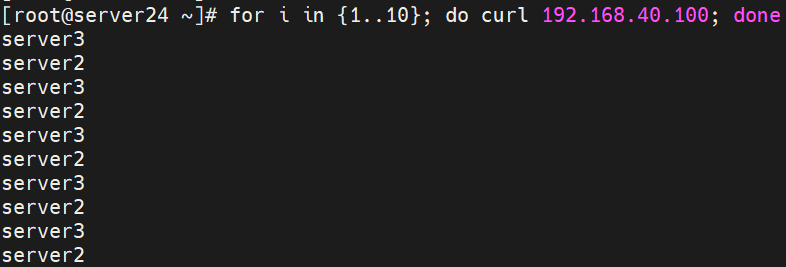
- server24测试
4.6 NAT模式示例
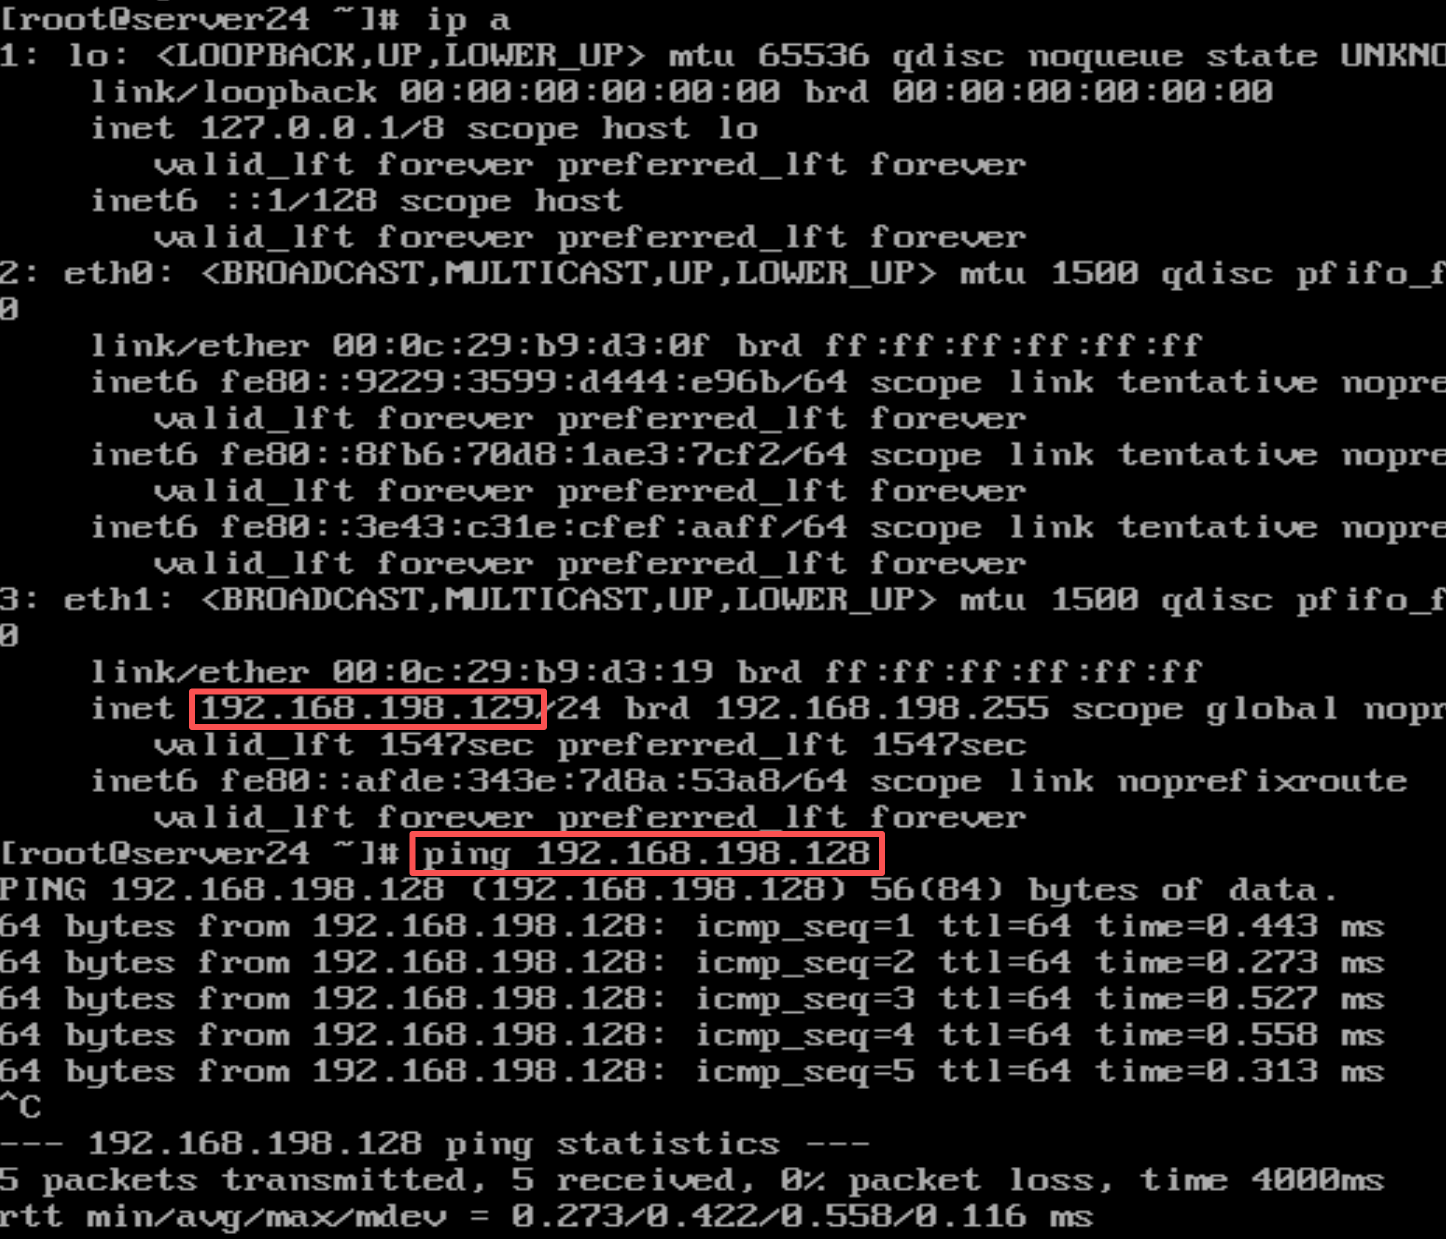
给server21添加一块网卡,网络连接设置仅主机模式
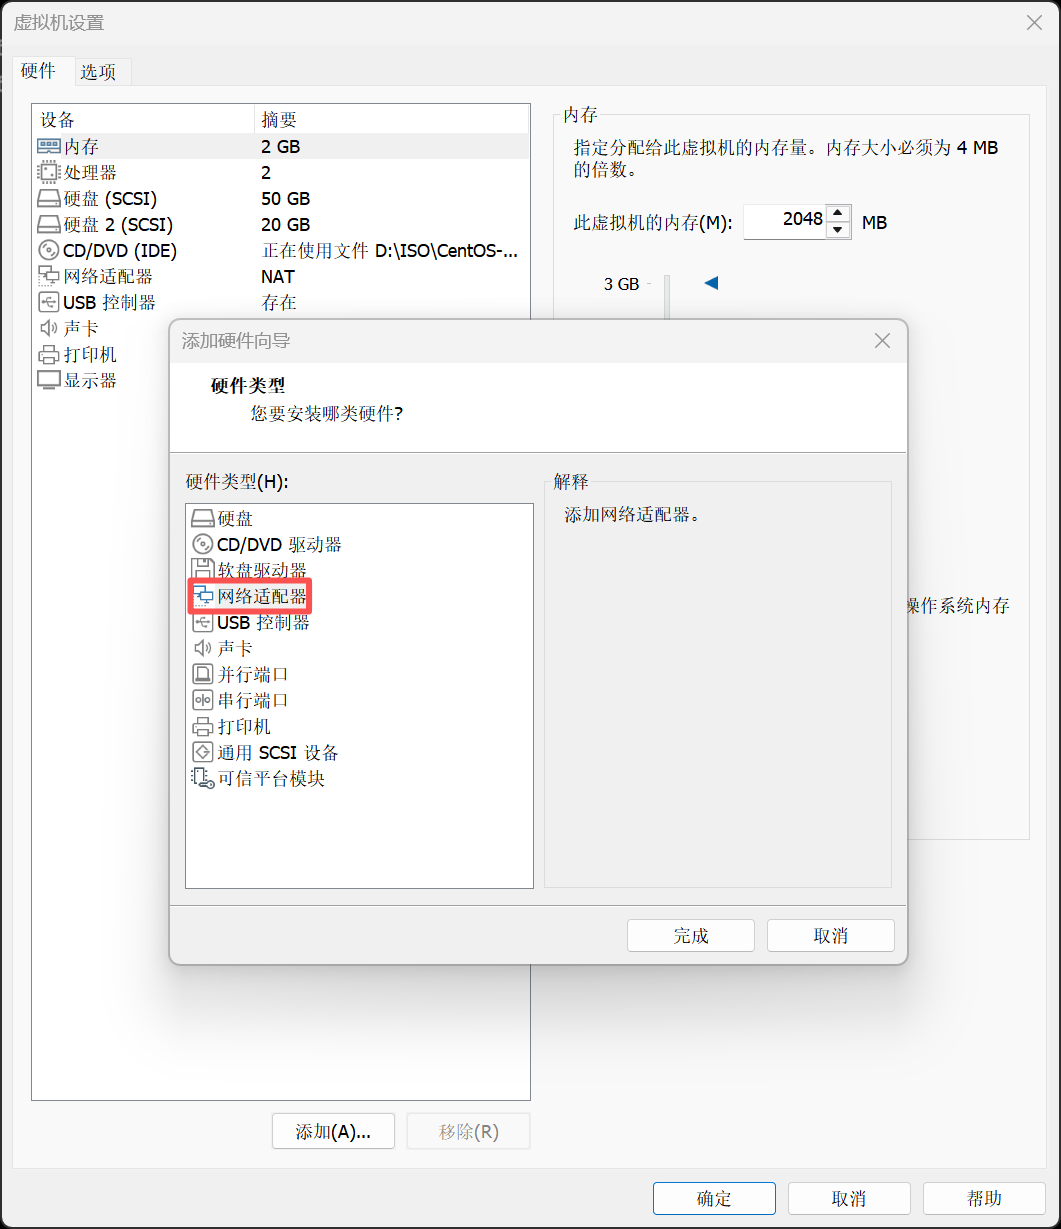
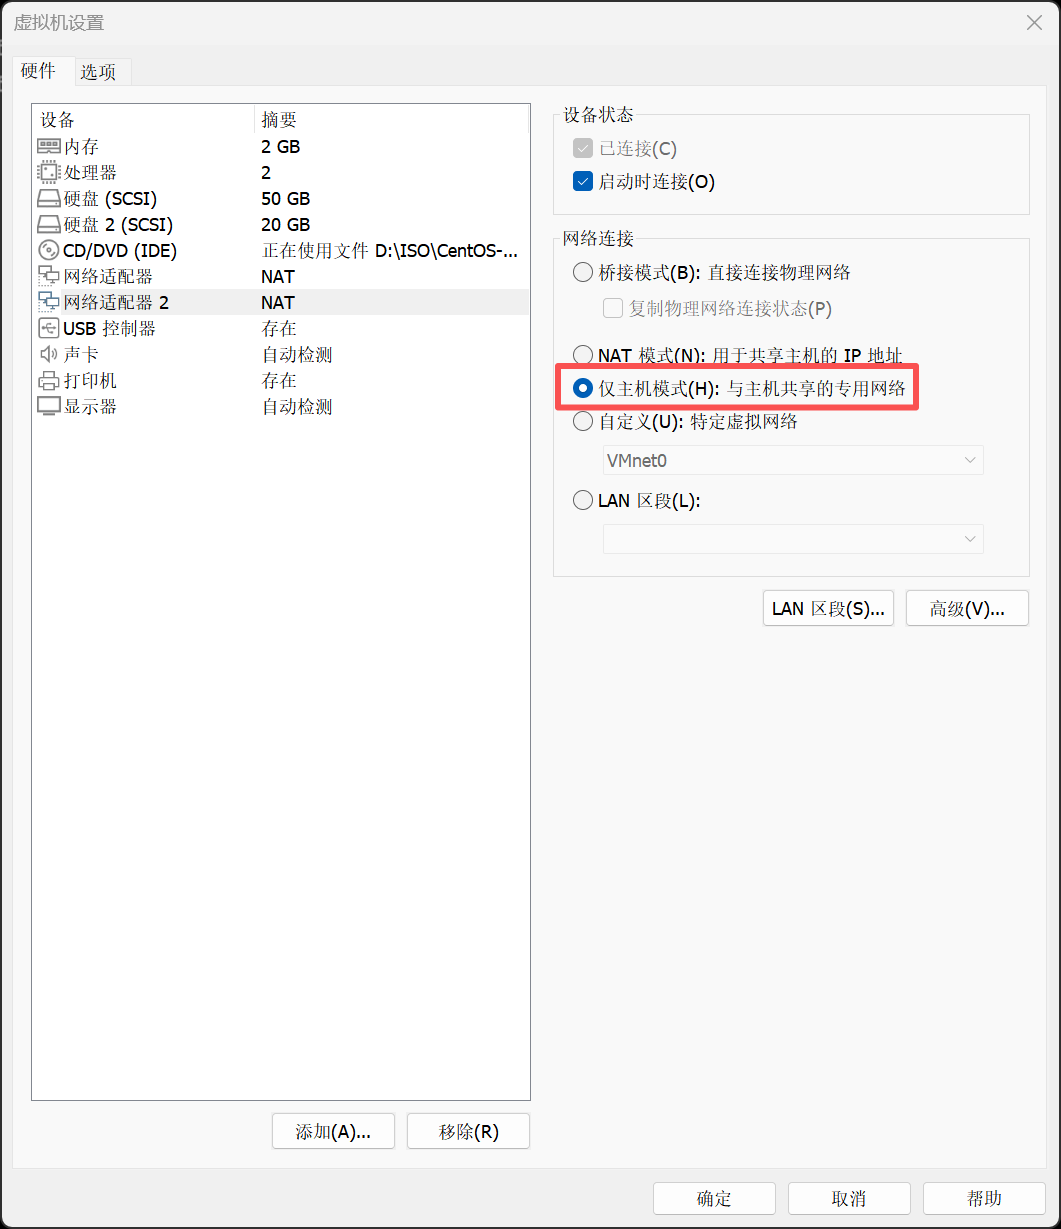
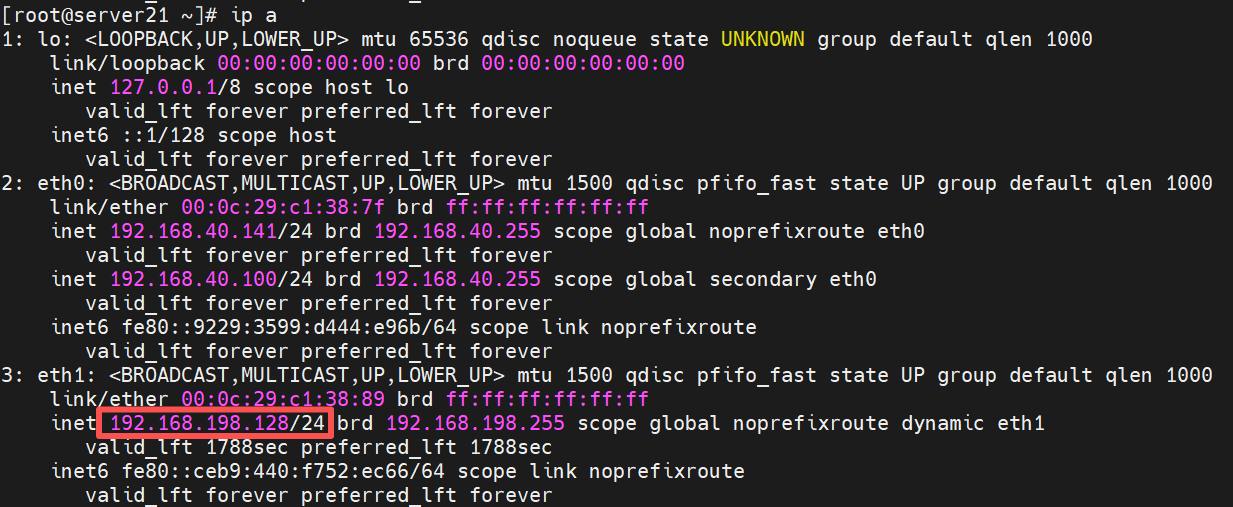
下图为所分配的网卡,当作VIP
给server24也添加一块新网卡,设置只能访问VIP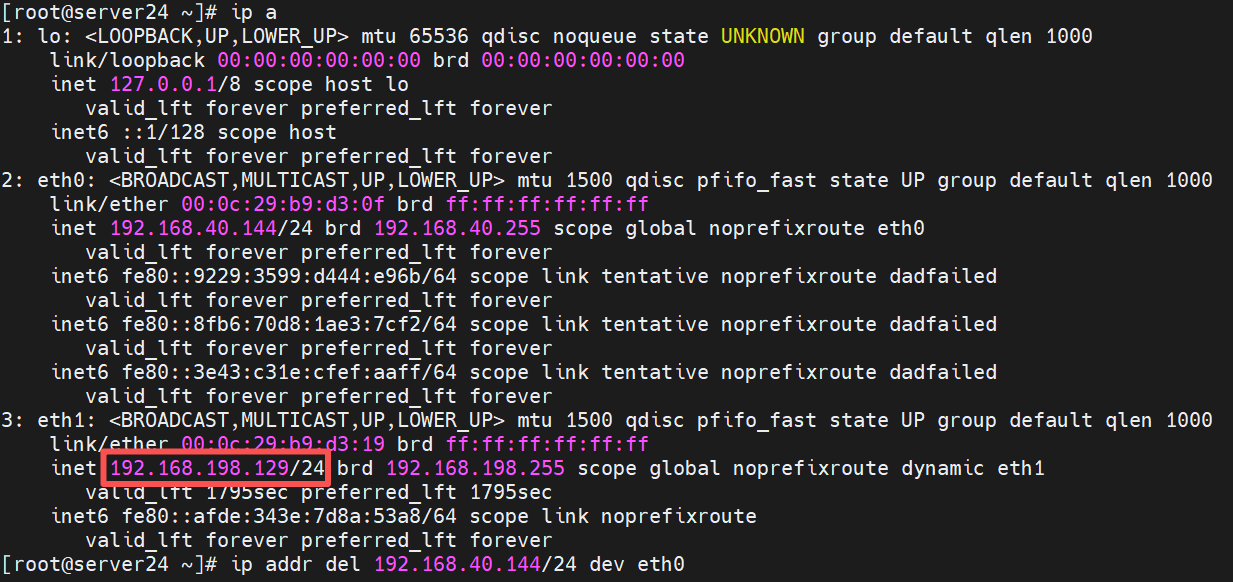 测试,能ping通给server21新分配的网卡
- 将我们在DR实例中绑定的VIP删除
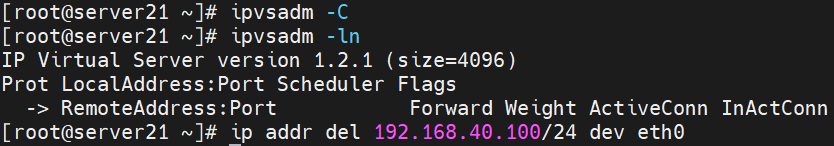
- server22和server23进行如下操作
[root@server22 ~]# ip addr del 192.168.40.100/24 dev eth0
[root@server22 ~]# arptables-save > /etc/sysconfig/arptables
[root@server22 ~]# arptables -F
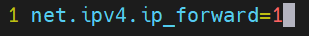
- 开启路由机制
[root@server21 ~]# vim /etc/sysctl.d/lvs.conf
#编辑内容如下图
[root@server21 ~]# sysctl --system
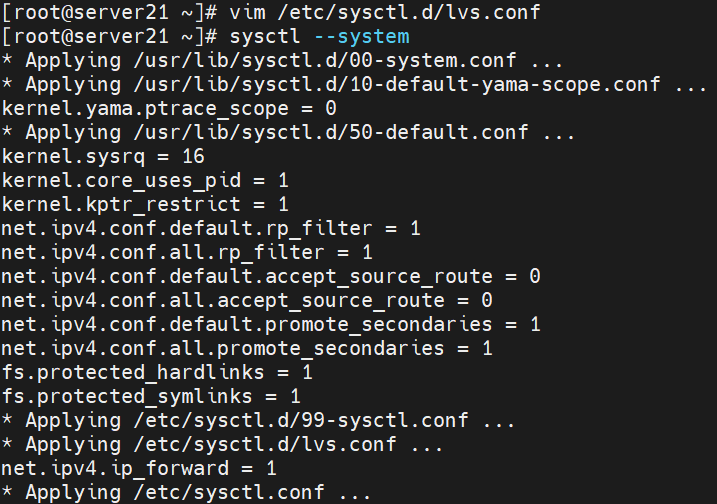
- 加载nat模块
[root@server21 ~]# modprobe iptable_nat
- 加载 lvs规则
[root@server21 ~]# ipvsadm -A -t 192.168.198.128:80 -s rr
[root@server21 ~]# ipvsadm -a -t 192.168.198.128:80 -r 192.168.40.142:80 -m
[root@server21 ~]# ipvsadm -a -t 192.168.198.128:80 -r 192.168.40.143:80 -m
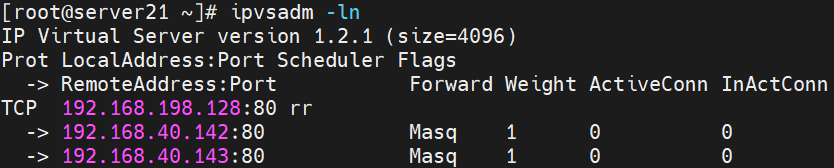
- RS上配置静态路由
server22和server23的网关应该指向server21的IP
[root@server22 ~]# ip r d default via 192.168.40.2
[root@server22 ~]# ip r a default via 192.168.40.141
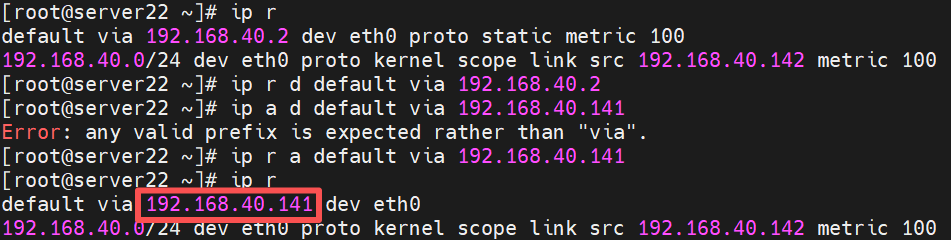
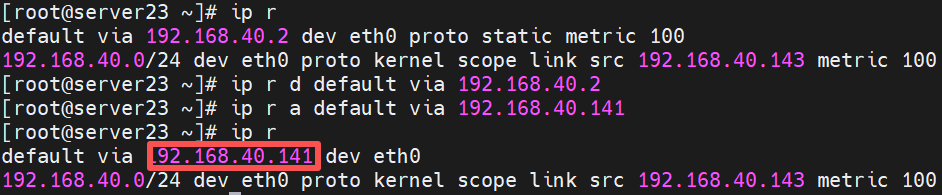
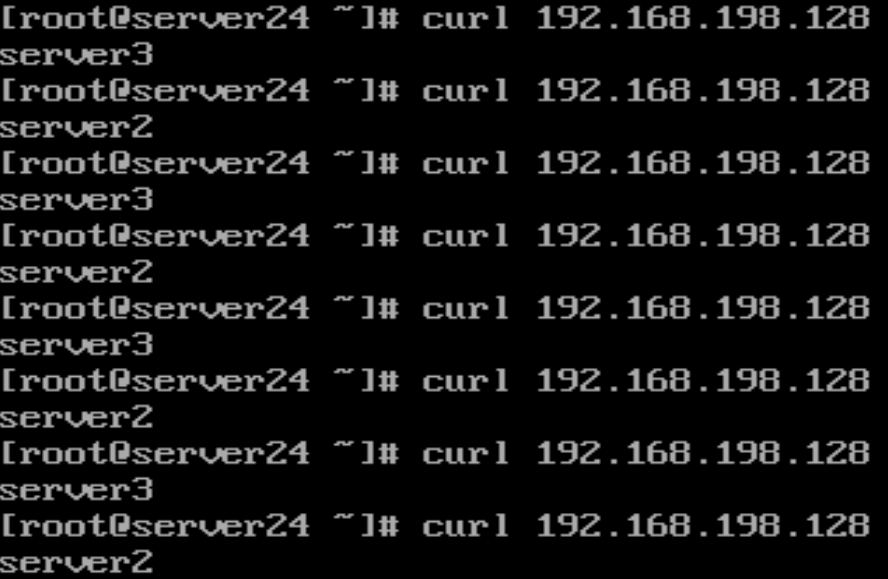
- 测试
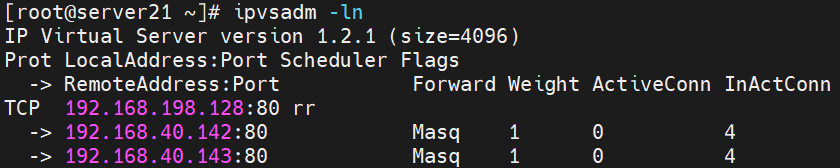
4.7 故障解决
如果某台 RS down了,解决问题需要健康检测
如果LVS本身down了,解决问题需要LVS冗余
Keepalivedd是LVS管理软件,同时支持健康检测和主备冗余,可使用此服务辅助解决问题,服务详情见模块 “五、keepalived高可用”
移除添加的两块网卡,恢复为DR模式
- server21策略恢复
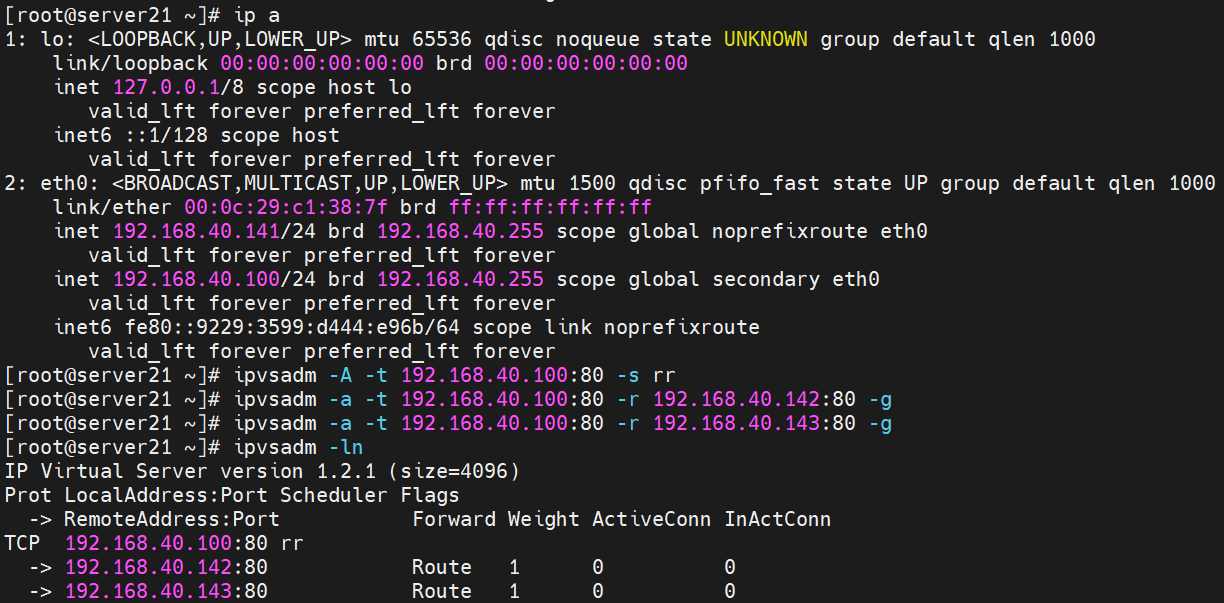
- server22和server33网关恢复
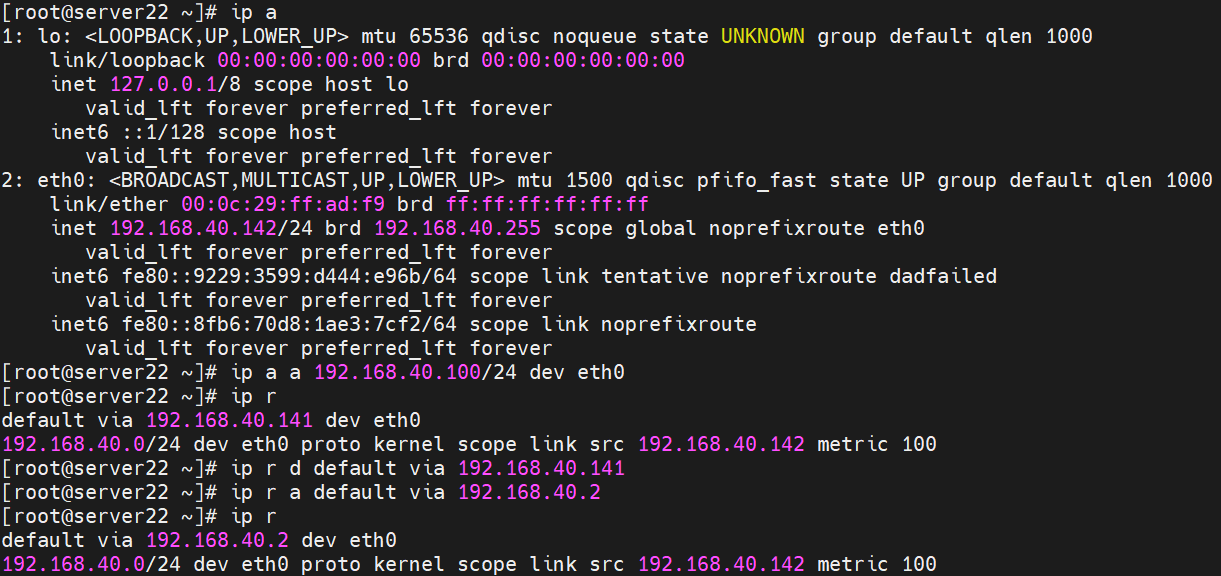
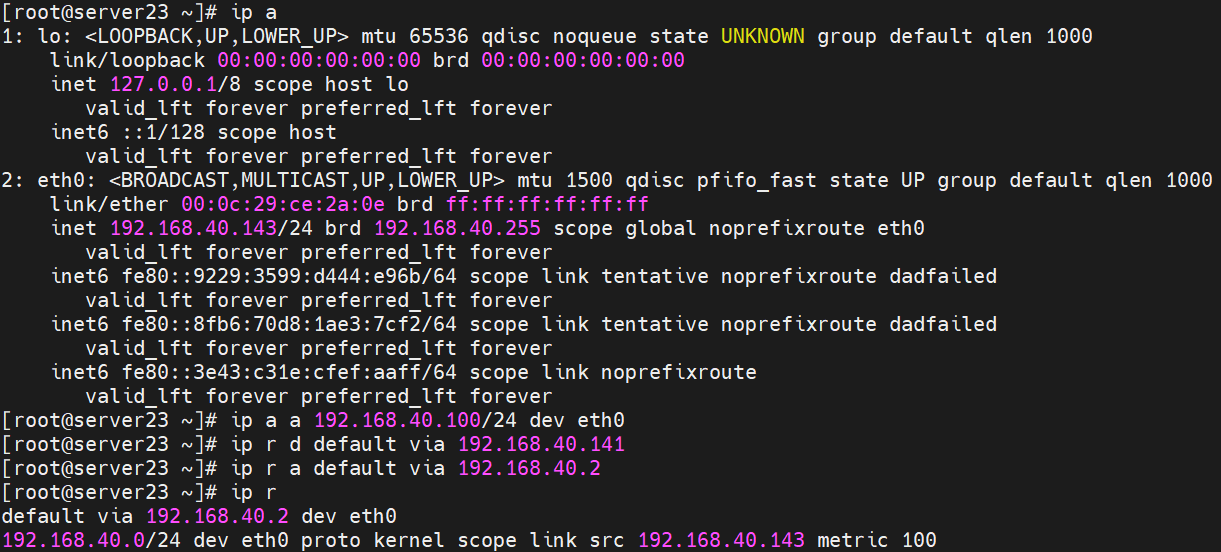
- 恢复策略,如果保存了可直接启动
systemctl start arp-ethers.service,没保存则需要重新配置
[root@server22 ~]# arptables -A INPUT -d 192.168.40.100 -j DROP
[root@server22 ~]# arptables -A OUTPUT -s 192.168.40.100 -j mangle --mangle-ip-s 192.168.40.142
[root@server22 ~]# arptables-save  > /etc/sysconfig/arptables
[root@server22 ~]# systemctl enable arptables
[root@server23 ~]# arptables -A INPUT -d 192.168.40.100 -j DROP
[root@server23 ~]# arptables -A OUTPUT -s 192.168.40.100 -j mangle --mangle-ip-s 192.168.40.143
[root@server23 ~]# arptables-save  > /etc/sysconfig/arptables
[root@server23 ~]# systemctl enable arptables
- 测试成功
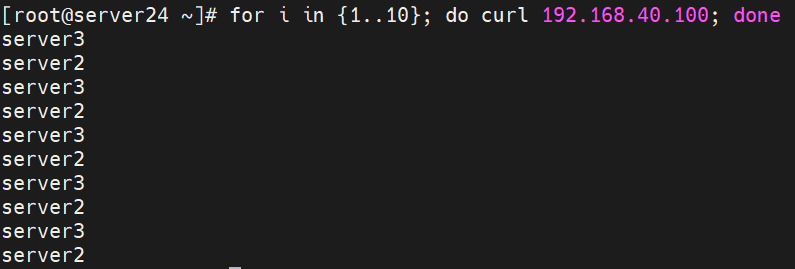
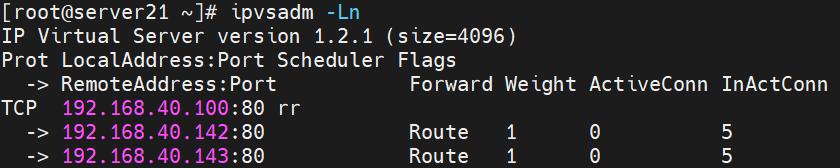
4.7.1 某台 RS down了——健康检测
# 保存ipvsadm规则至配置文件,开机自动加载
ipvsadm-save > /etc/sysconfig/ipvsadm

# 保存arptables规则
arptables-save > /etc/sysconfig/arptables
- 关闭server22的httpd服务,模拟一台 RS down的情况
[root@server22 ~]# systemctl stop httpd
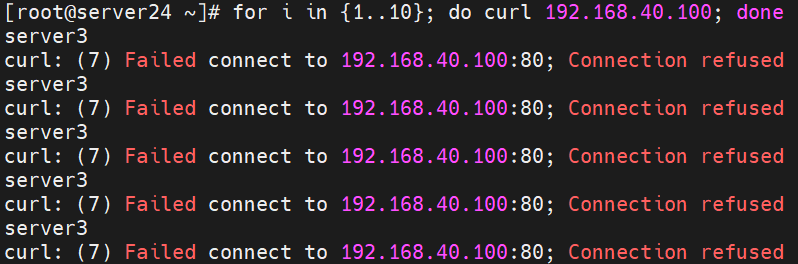
- 确保双方都没有策略,也没有绑定VIP
[root@server21 ~]# ipvsadm-save > /etc/sysconfig/ipvsadm
[root@server21 ~]# ipvsadm -C
[root@server21 ~]# ip a d 192.168.40.100/24 dev eth0
[root@server21 ~]# yum install -y keepalived
[root@server21 ~]# ipvsadm -C
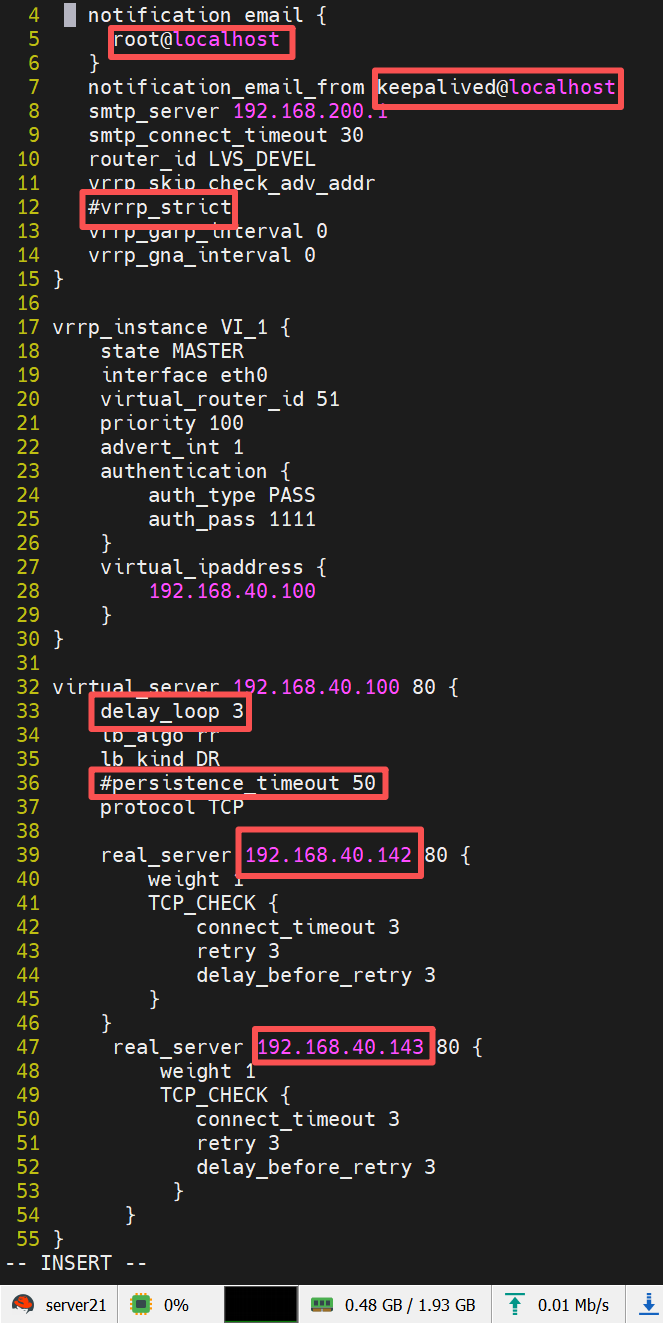
- master即server21配置
[root@server21 ~]# vim /etc/keepalived/keepalived.conf
#编辑内容如下图
[root@server21 ~]# systemctl start keepalived.service
[root@server21 ~]# ip a   #查看配置,自动添加了网卡和策略
[root@server21 ~]# ipvsadm -ln
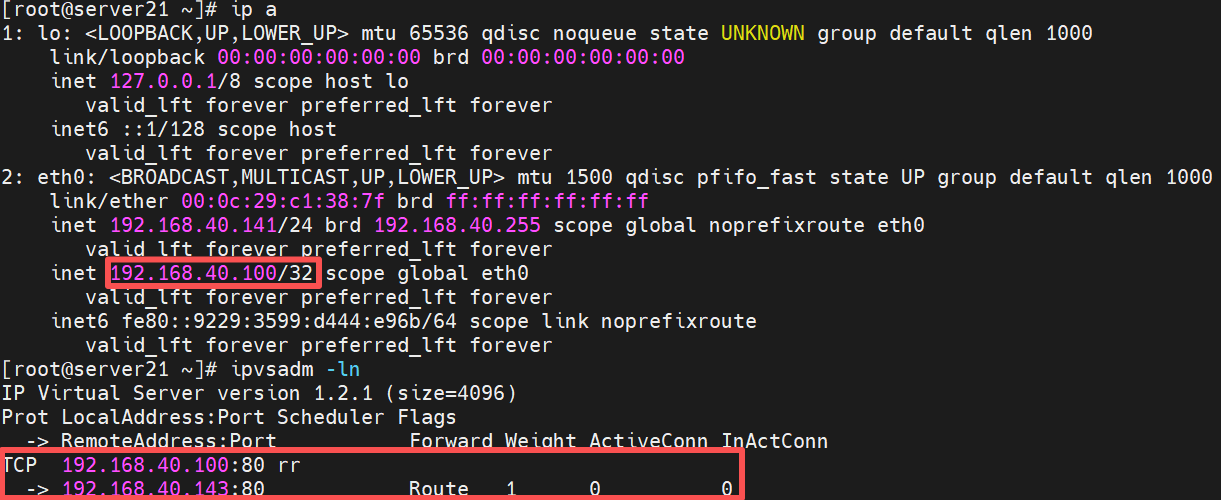
- 测试keepalived对后端RS的健康检测
[root@server22 ~]# systemctl start httpd
#启动server22的httpd服务,恢复的RS会自动添加到调度列表;若再停止,会自动从调度列表中被摘除
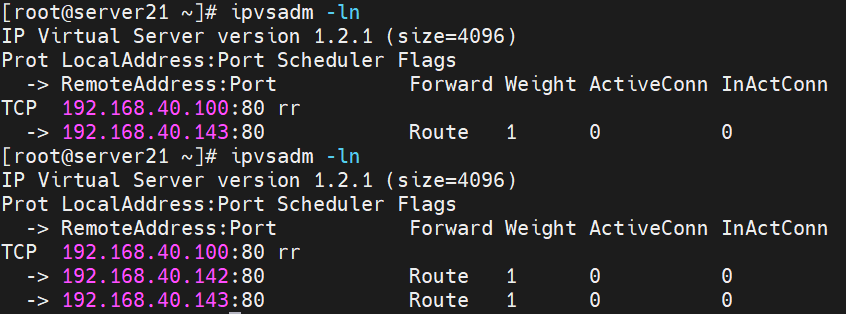
4.7.2 LVS本身down了——LVS冗余
- backup即server24配置:
[root@server24 ~]# yum install -y keepalived
- 从server1拷贝配置文件
[root@server21 ~]# scp /etc/keepalived/keepalived.conf server24:/etc/keepalived/
- 修改配置文件
[root@server24 ~]# vim /etc/keepalived/keepalived.conf
#priority必须低于MASTER的,当MASTER的keepalived服务恢复,自动将VIP绑回MASTER
[root@server24 ~]# systemctl start keepalived.service
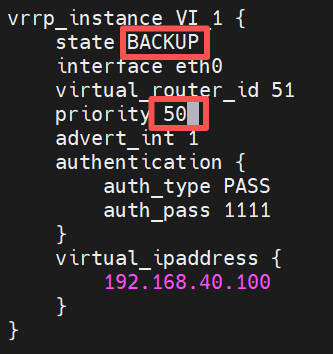
- 测试:
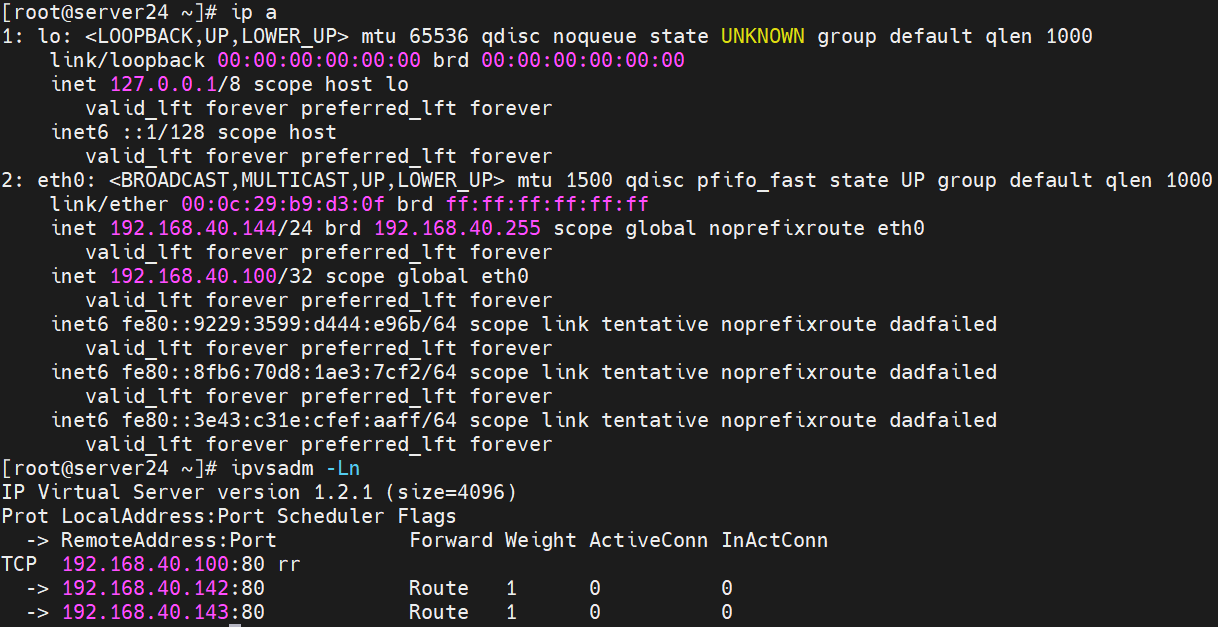
在server21上停止keepalived服务,VIP自动被摘掉
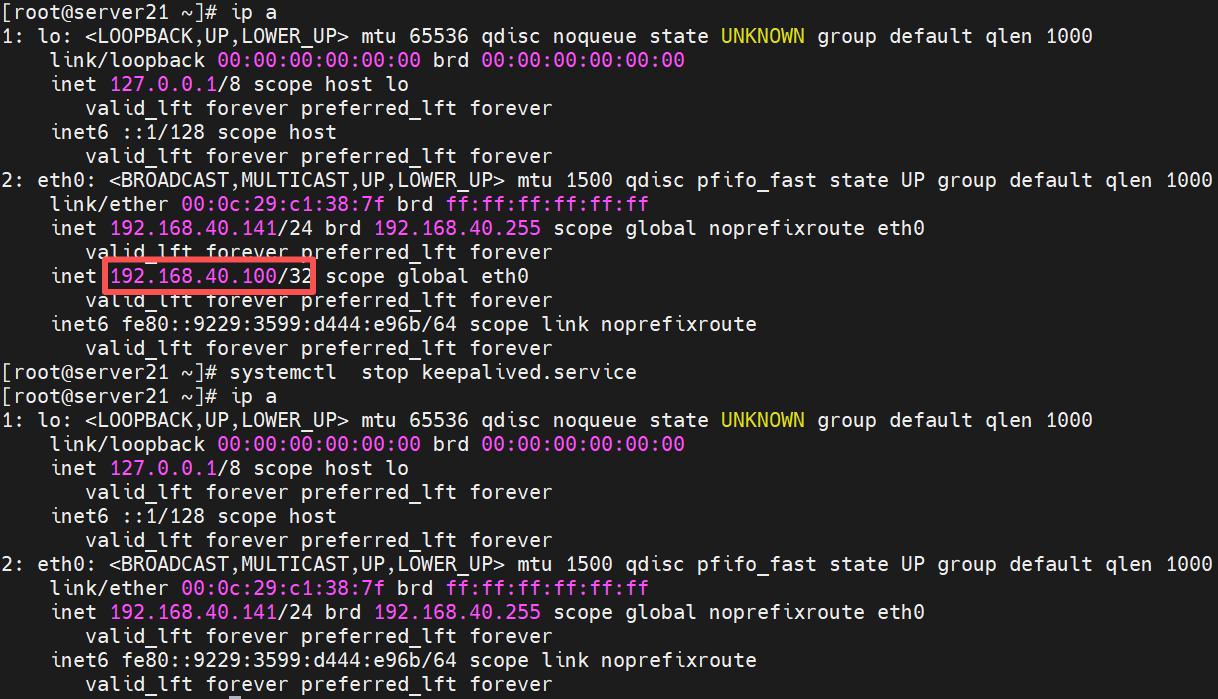
资源自动被迁移到server24
4.7.3 拓展:keeplived服务失效可使用haproxy七层负载均衡器
server21和server24的keepalived服务停掉,模拟失效。VIP和策略都会消失。
[root@server21 ~]# systemctl stop keepalived
[root@server24 ~]# systemctl stop keepalived
[root@server21 ~]# yum install -y haproxy   #支持四层和七层服务
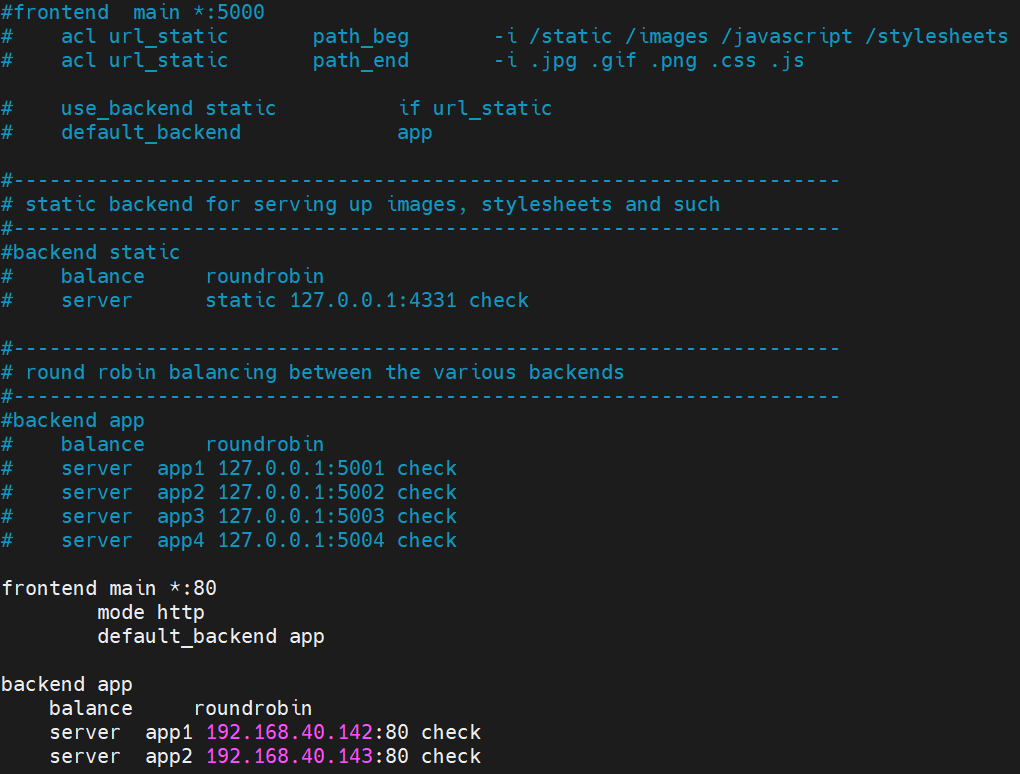
[root@server21 ~]# vim /etc/haproxy/haproxy.cfg
[root@server21 ~]# systemctl start haproxy.service
#一定要确认服务开启成功,80端口有可能被其他服务占用
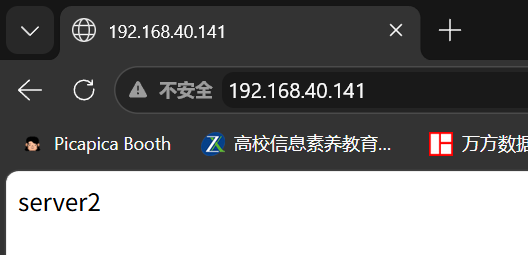
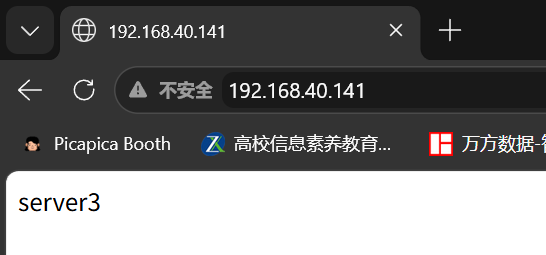
在网页访问server21的IP,刷新页面可看到server2和server3交替出现
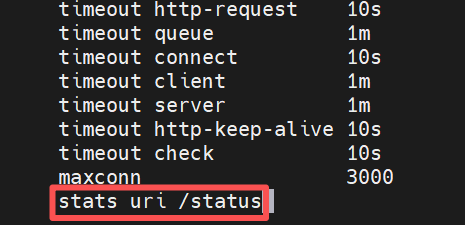
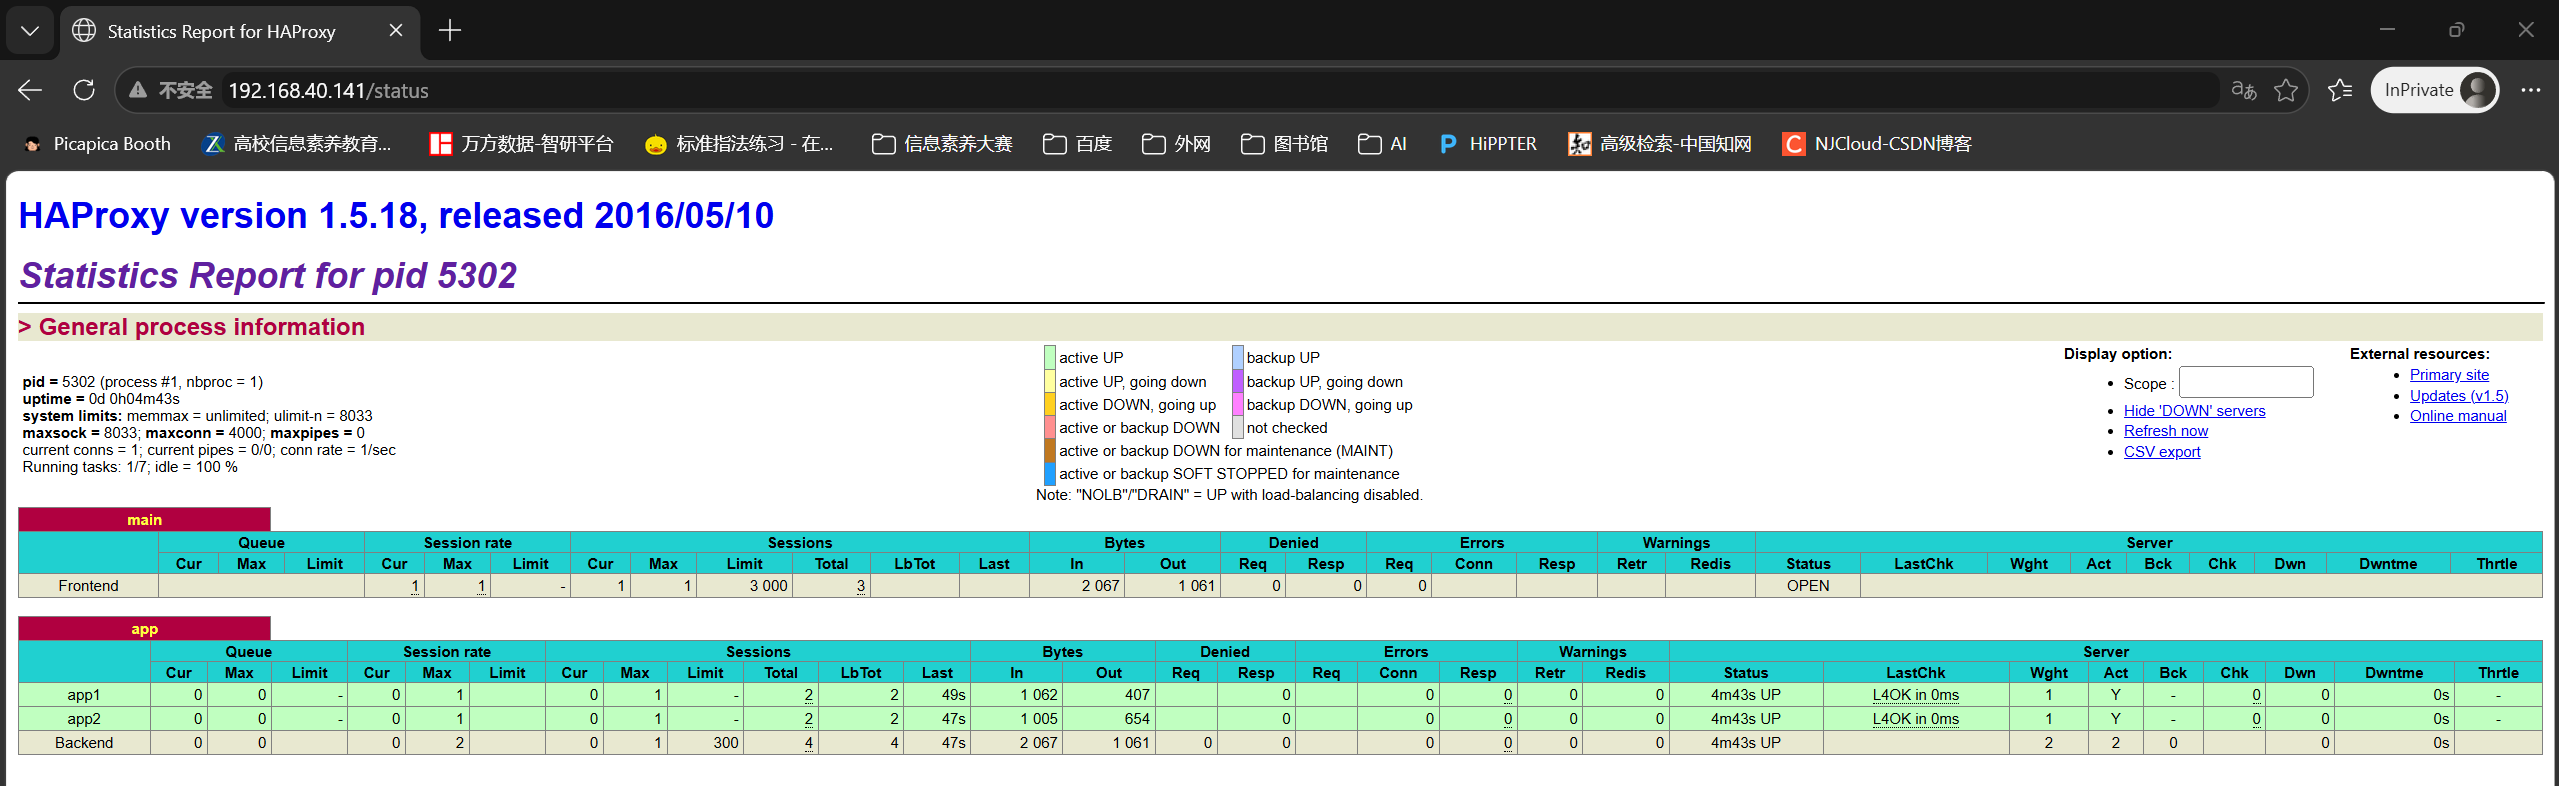
也可以监控其运行状态
提示:此服务不需要VIP和arptables服务,可以做端口转发,例如将server22的端口改为8080,服务不受影响。
4.7.4 keepalived和haproxy结合使用
[root@server24 ~]# yum install -y haproxy
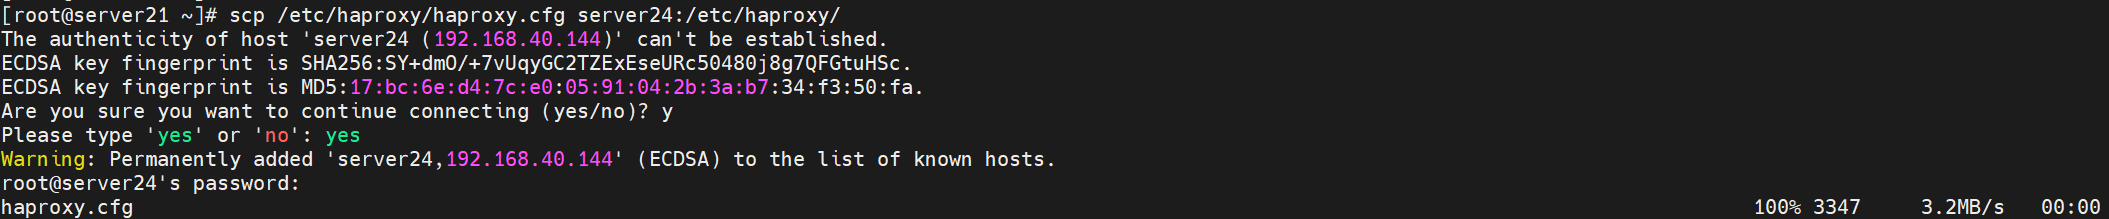
[root@server21 ~]# scp /etc/haproxy/haproxy.cfg server24:/etc/haproxy/
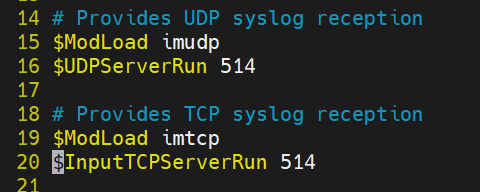
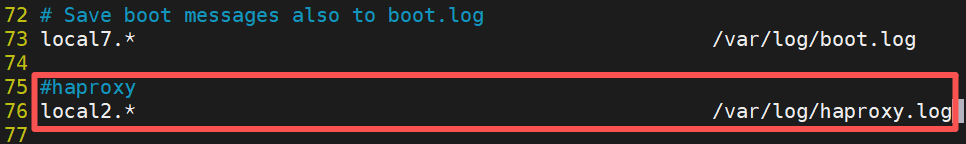
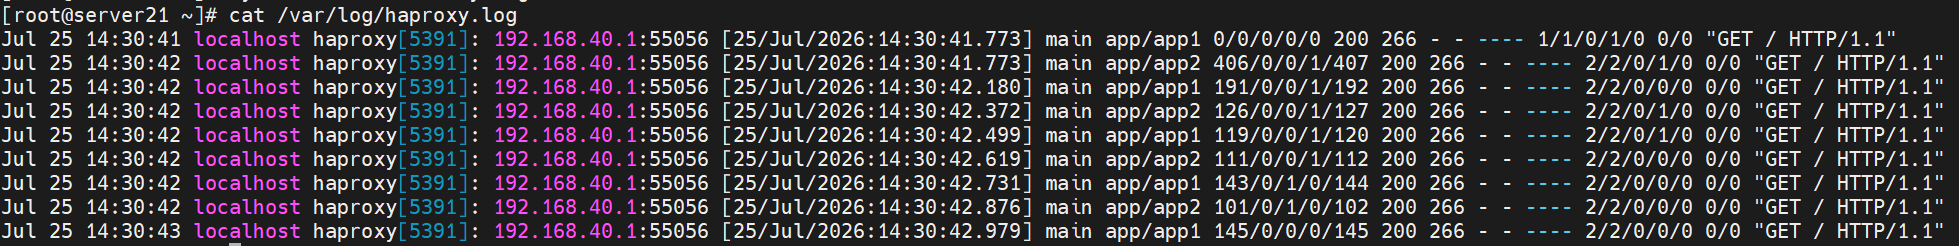
- 若想查看日志
[root@server21 ~]# vim /etc/rsyslog.conf
[root@server21 ~]# systemctl restart rsyslog.service
[root@server21 ~]# cat /var/log/haproxy.log
- 主备机配置
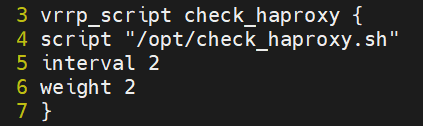
[root@server21 ~]# vim /etc/keepalived/keepalived.conf
[root@server21 ~]# scp /etc/keepalived/keepalived.conf server24:/etc/keepalived/
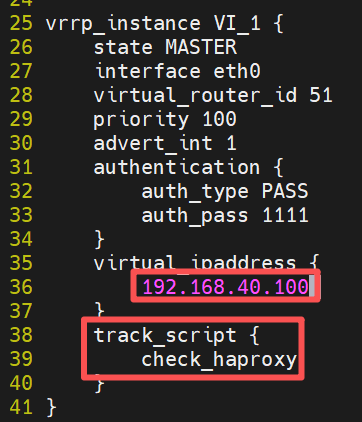

[root@server24 ~]# vim /etc/keepalived/keepalived.conf
[root@server24 ~]# systemctl start keepalived.service
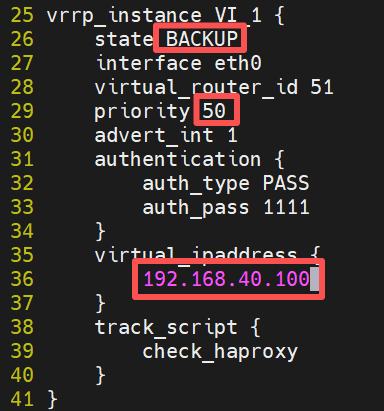
[root@server21 ~]# vim /opt/check_haproxy.sh
[root@server21 ~]# chmod +x /opt/check_haproxy.sh
[root@server21 ~]# scp -p /opt/check_haproxy.sh server24:/opt/
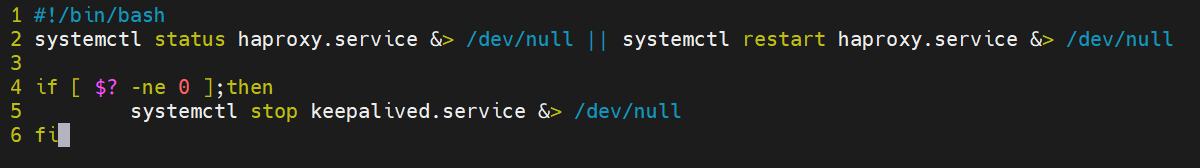

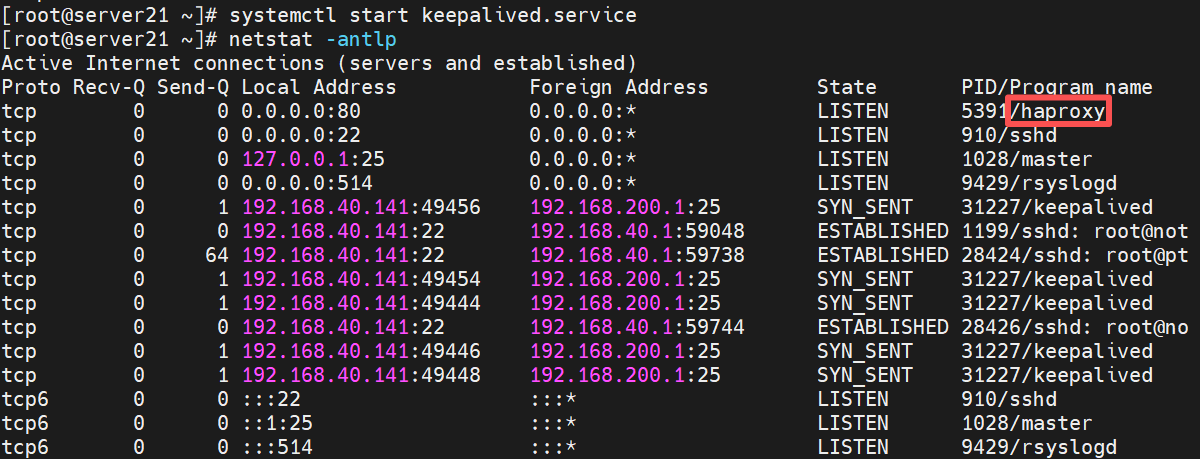
启动keepalived服务,haproxy服务自启动
[root@server21 ~]# systemctl stop haproxy.service
[root@server21 ~]# systemctl start keepalived.service
[root@server21 ~]# netstat -antlp
- 测试
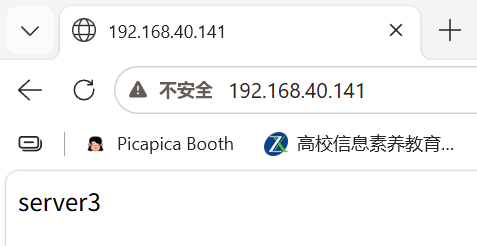
访问server21的IP地址192.168.40.141,依旧server2和server3交替出现
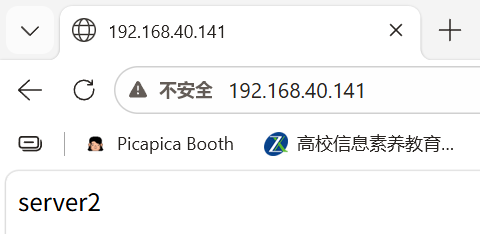
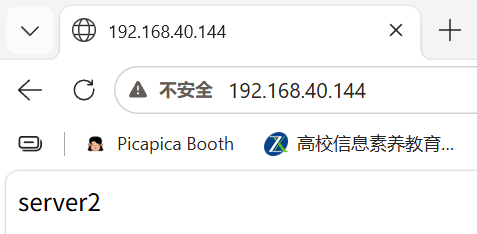
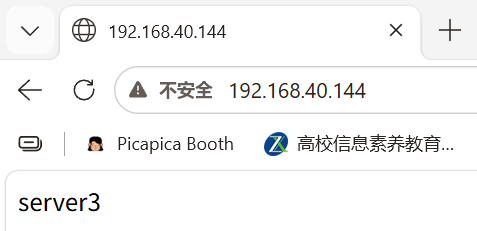
停掉server21的keepalived服务,server24自动绑定VIP,访问server24的IP,server2和server3交替出现
五、keepalived服务
5.1 概念
Keepalived 是基于 VRRP(虚拟路由冗余协议) 的开源高可用工具,核心作用是为服务器集群提供 “虚拟 IP(VIP)漂移” 能力,实现主备节点故障自动切换,确保业务 IP 不中断。它常与 LVS、Nginx 等服务搭配,构建高可用负载均衡或单服务高可用架构。
5.2 核心原理:VRRP 协议与 VIP 漂移
Keepalived 的高可用能力依赖 VRRP 协议,本质是让多台节点(主、备)共享一个 “虚拟 IP(VIP)”,对外呈现为一个统一的服务入口,核心逻辑如下:
- 角色划分:集群包含 1 个 主节点(Master) 和 1 个 / 多个 备节点(Backup)。
- 心跳检测:主节点定期向备节点发送 VRRP 通告报文(默认每 1 秒),证明自己 “存活”。
- VIP 持有:正常情况下,主节点绑定 VIP 并对外提供服务,备节点仅监听心跳,不持有 VIP。
- 故障切换:若备节点超过指定时间(默认 3 秒)未收到主节点心跳,判定主节点故障,备节点立即升级为新主节点,绑定 VIP 并接管服务,整个过程无需人工干预。
5.3 核心组件与配置
Keepalived 由 核心组件 和 配置文件 两部分组成,配置决定其行为逻辑。
-
核心组件
- vrrp_instance:VRRP 实例,是 Keepalived 配置的核心单元,一个实例对应一个 VIP 及一组主备节点(如 VI_1 实例管理 VIP 192.168.36.200)。
- Global_defs:全局配置,定义集群标识(如 router_id)、邮件通知(故障时发告警邮件)等基础参数。
- Track_script:健康检查脚本,用于检测主节点上 “核心业务服务”(如 Nginx、LVS)是否存活。若服务挂了,即使主节点本身存活,也会主动释放 VIP,触发切换(避免 “主节点存活但服务不可用” 的问题)。
-
配置文件(以双节点为例)
Keepalived 主配置文件默认路径为/etc/keepalived/keepalived.conf,主、备节点配置差异主要在 state(角色)和 priority(优先级,数值越高越优先成为主节点)。
六、Pacemaker高可用
Pacemaker 是 Linux 环境下主流的 开源高可用集群管理工具,核心作用是通过监控集群节点和服务状态,实现 “故障自动检测与切换”,确保业务服务持续运行(即服务不中断)。它通常与 Corosync(负责集群通信与成员管理)配合使用,组成完整的高可用集群解决方案。
6.1 核心概念
1. 资源 Resource
集群管理的对象,两类最常见:
- 虚拟 IP(VIP / 浮动 IP):客户端统一访问地址,跟随主节点漂移
- 业务服务(httpd、数据库等)
客户端永远连接 VIP,不需要关心业务跑在哪台物理机器。
2. 资源组 Group
把 VIP + Web 服务放进同一个组,保证两个资源永远运行在同一台节点;
启动顺序:先 VIP,再服务;故障切换一起迁移。
3. 脑裂Split-brain
网络故障,两台节点互相认为对方宕机,同时抢占 VIP、同时启动服务,引发数据冲突。
4. 防脑裂机制STONITH
故障节点强制关机,避免两台机器同时抢占 VIP、同时写数据造成损坏。
实验环境没有电源管理设备,临时关闭:
pcs property set stonith-enabled=false
生产环境必须开启STONITH。
6.2 组件
Pacemaker 集群的正常运行依赖 “底层通信” 和 “上层资源管理” 两大模块,关键组件如下:
| 组件 | 定义 | 解读 |
|---|---|---|
| Corosync | 底层通信引擎,负责集群节点间的心跳检测(确认节点是否存活)、集群状态同步,是 Pacemaker 的 通信基石。 | 1. 节点之间周期性发送心跳报文;2. 心跳中断 → Corosync 判定节点故障,将消息上报给 Pacemaker;3. 只负责通信,不管理业务资源。 |
| Pacemaker | 上层资源管理器,基于 Corosync 提供的节点状态,实现资源(如服务、IP、存储)的调度、故障切换和约束管理。 | 集群 “大脑”;收到故障通知后,执行资源停止、迁移、启动动作;所有资源启停逻辑由它决策。 |
| 资源(Resource) | 集群需管理的 “业务实体”,如虚拟 IP(VIP)、Web 服务(Apache/Nginx)、数据库 (MySQL) 等,是高可用保护的核心对象。 | 两类最常用资源:VIP 浮动 IP(客户端统一访问入口) 和业务服务(httpd、数据库) 。故障时整体漂移到备节点。 |
| 资源代理(RA) | 用于控制资源启停、状态检查的 “脚本 / 程序”(如ocf:heartbeat:IPaddr2管理 VIP),Pacemaker 通过 RA 与资源交互。 | Pacemaker 本身不会直接操作 IP / 服务,依靠 RA 标准化调用;实验高频:ocf:heartbeat:IPaddr2(VIP)ocf:heartbeat:apache(Apache 服务) |
| 约束(Constraint) | 定义资源调度规则,如 “资源必须运行在特定节点”(位置约束)、“多个资源需在同一节点运行”(共置约束)。 | 资源组(Group)本质就是共置约束;把 VIP+Apache 放进一组,保证二者永远在同一台服务器,先启 VIP、后启 Web 服务。 |
6.3 核心工作原理
Pacemaker 实现高可用的核心逻辑是 “心跳检测 + 故障切换”,流程如下:
- 集群初始化:多节点(至少 2 个)通过 Corosync 建立通信,选举出 “主节点”(负责资源调度)和 “备节点”。
- 资源部署:Pacemaker 根据配置,将资源(如 VIP + Nginx)部署到主节点,备节点处于 “待命” 状态。
- 心跳检测:Corosync 定期在节点间发送 “心跳报文”(默认每 1 秒),主节点需向备节点证明自己 “存活”。
- 故障检测:若备节点长时间(如 5 秒)未收到主节点心跳,判定主节点 “故障”,触发切换流程。
- 自动切换:Pacemaker 清理主节点上的资源(标记为 “失效”),并在备节点上启动资源,最终备节点升级为新主节点,业务恢复访问。
6.4 典型集群架构
Pacemaker 支持多种集群拓扑,最常用的是 “双节点主备架构”(适用于绝大多数业务场景):
- 主节点:运行核心业务资源(如 VIP、应用服务),对外提供服务。
- 备节点:实时监控主节点状态,不运行业务资源,仅在主节点故障时接管。
- 共享存储(可选):若业务需数据共享(如 MySQL),需配合共享存储(如 NFS、iSCSI),确保主备节点访问同一数据。
6.5 示例
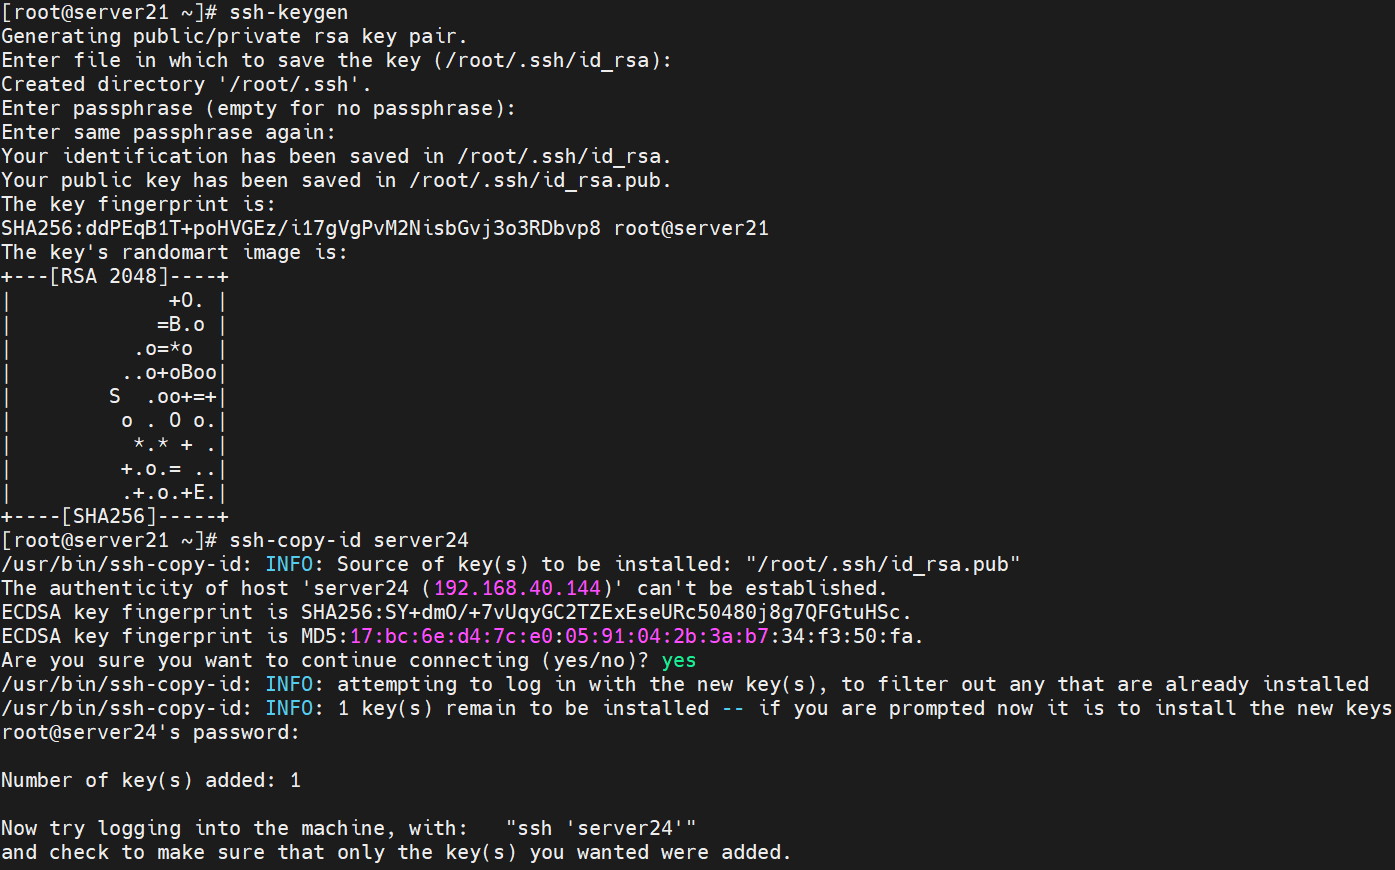
- 主机配置免密
[root@server21 ~]# ssh-keygen
[root@server21 ~]# ssh-copy-id server24
- 配置ntp时间同步
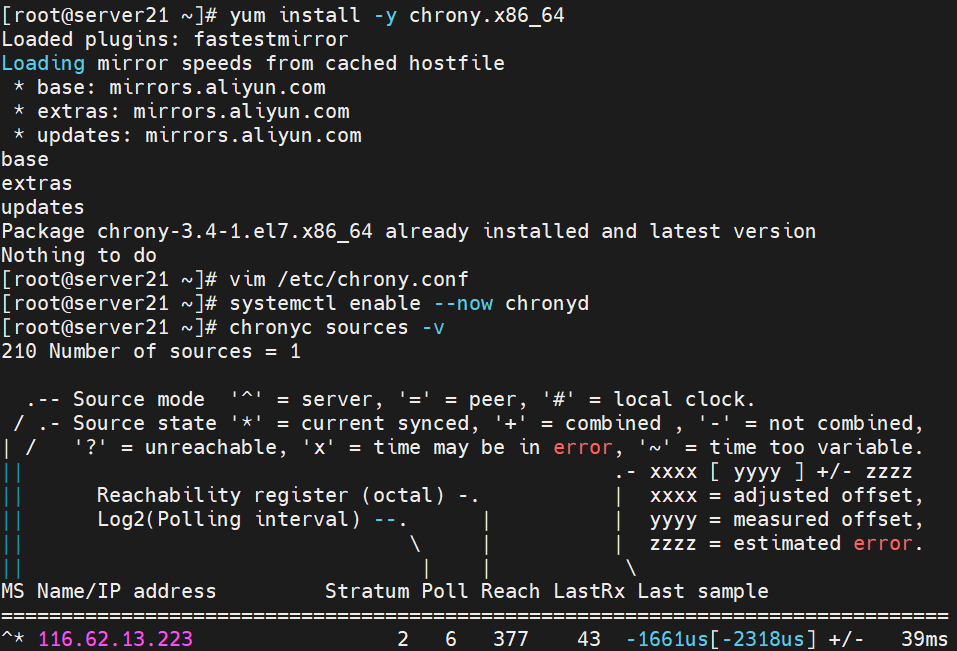
[root@server21 ~]# yum install -y chrony.x86_64   #时间同步服务包
[root@server21 ~]# vim /etc/chrony.conf   #配置内容如下图
[root@server21 ~]# systemctl enable --now chronyd
[root@server21 ~]# chronyc sources -v

- 安装集群软件
- pacemaker
集群资源管理器,高可用核心,负责资源调度、故障迁移。 - pcs
集群管理命令工具,配套 pcsd 服务;用来创建集群、认证节点、管理资源、查看集群状态。 - psmisc
提供killall、pstree等进程管理工具;
集群排错时,方便批量终止异常进程。 - policycoreutils-python
SELinux 管理工具集合,提供semanage、restorecon;
集群、httpd 服务遇到 SELinux 403 权限拦截时,用来修改安全上下文。
[root@server21 ~]# yum install -y pacemaker pcs psmisc policycoreutils-python
[root@server21 ~]# ssh server24 yum install -y pacemaker pcs psmisc policycoreutils-python
- 启动pcsd服务
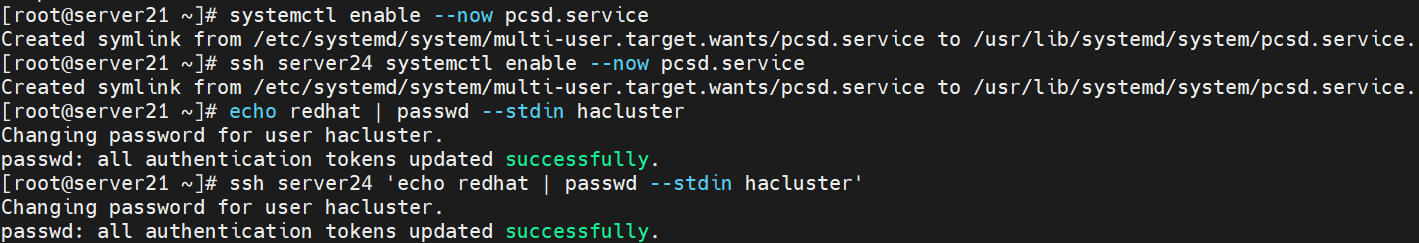
[root@server21 ~]# systemctl enable --now pcsd.service
[root@server21 ~]# ssh server24 systemctl enable --now pcsd.service
[root@server21 ~]# echo redhat | passwd --stdin hacluster
[root@server21 ~]# ssh server24 'echo redhat | passwd --stdin hacluster'   #非交互式设置 hacluster 用户的密码为 redhat,安装pcs软件包的时候,安装脚本自动创建该用户,所有节点 hacluster 密码必须一致,否则认证失败
- 配置corosync
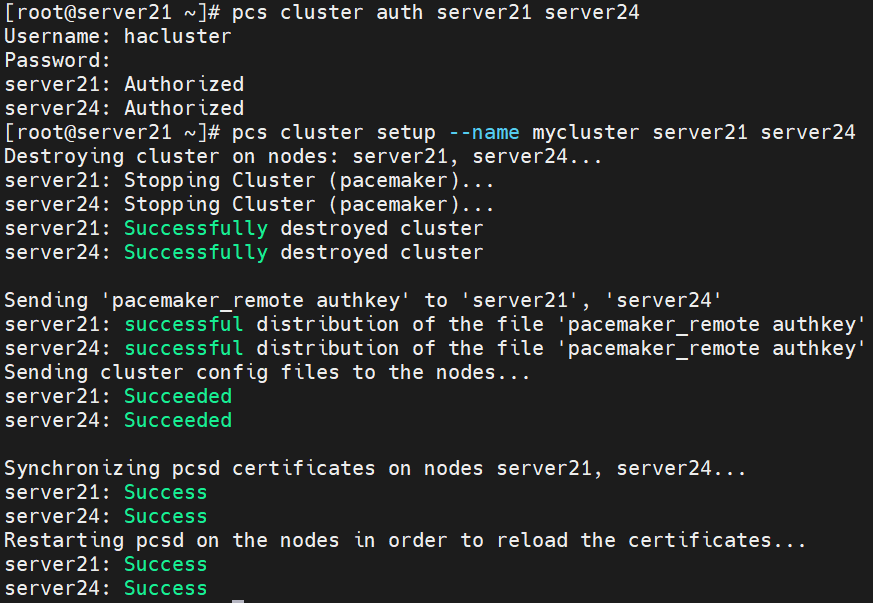
[root@server21 ~]# pcs cluster auth server21 server24   #对集群节点 server21、server24 进行双向认证,交换通信凭证,password:redhat
[root@server21 ~]# pcs cluster setup --name mycluster server21 server24   #在 server21、server24 两个节点上初始化集群配置,生成集群相关配置文件
- 启动集群
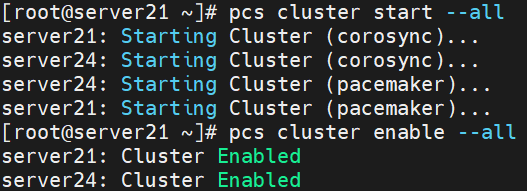
[root@server21 ~]# pcs cluster start --all
[root@server21 ~]# pcs cluster enable --all
- 校验集群
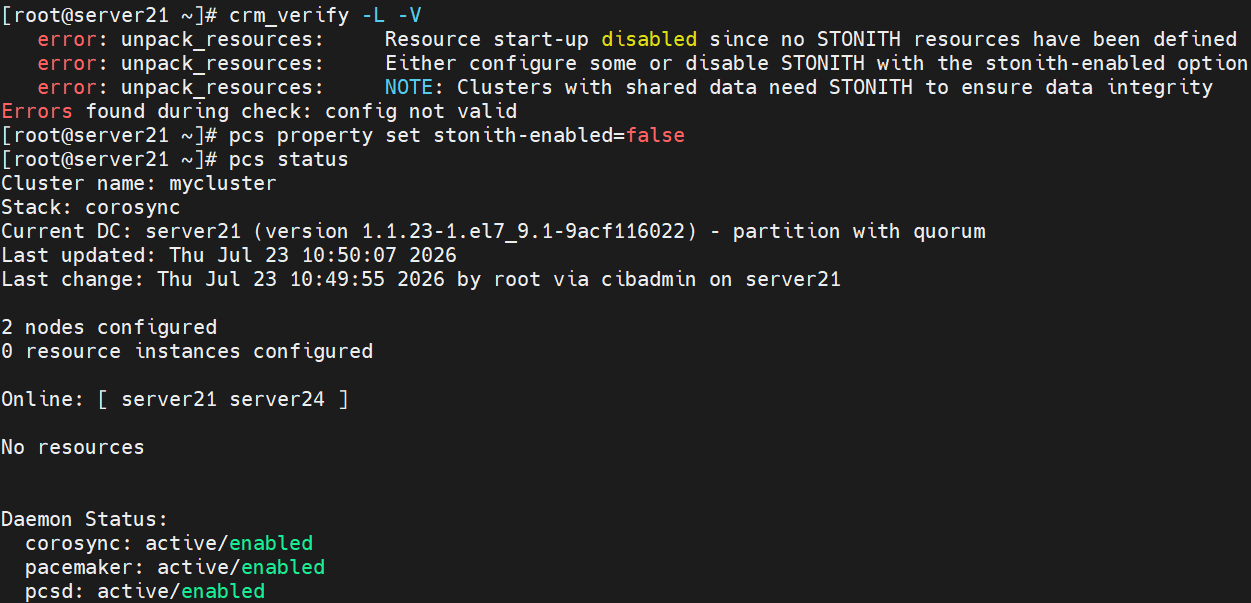
[root@server21 ~]# crm_verify -L -V   #检查 Pacemaker 集群当前配置是否合法、有无语法冲突、约束错误、资源配置异常
[root@server21 ~]# pcs property set stonith-enabled=false   #修改集群全局属性,关闭 STONITH 功能
[root@server21 ~]# pcs status   #查看 Pacemaker 集群实时运行状态
- 创建集群资源
[root@server21 ~]# pcs resource create vip ocf:heartbeat:IPaddr2 ip=192.168.40.100 op monitor interval=30s   #创建一个虚拟 IP(VIP)集群资源,集群会自动在节点上绑定浮动 IP `192.168.40.100`;故障时 VIP 漂移到备用节点
[root@server21 ~]# ip a d 192.168.40.100/24 dev eth0
pcs resource create
创建集群资源的基础命令。vip
自定义资源名称,是集群内部识别该资源的名字(标识符),后续管理资源用这个名字,可以随意起名ocf:heartbeat:IPaddr2
资源代理 RA
ocf:资源代理标准类型
heartbeat:代理所属厂商
IPaddr2:专门用来管理虚拟 IP 地址
Pacemaker 依靠这个脚本实现 IP 的添加、删除、状态检测。
-
ip=192.168.40.100
指定浮动 VIP 地址,客户端统一访问这个 IP。
注意:该 IP 不能和任何物理网卡静态 IP 冲突。 -
op monitor interval=30s
定义监控操作
op monitor:状态检测动作
interval=30s:每 30 秒检查一次该 VIP 资源是否正常运行
一旦检测失败,判定资源故障,触发迁移。
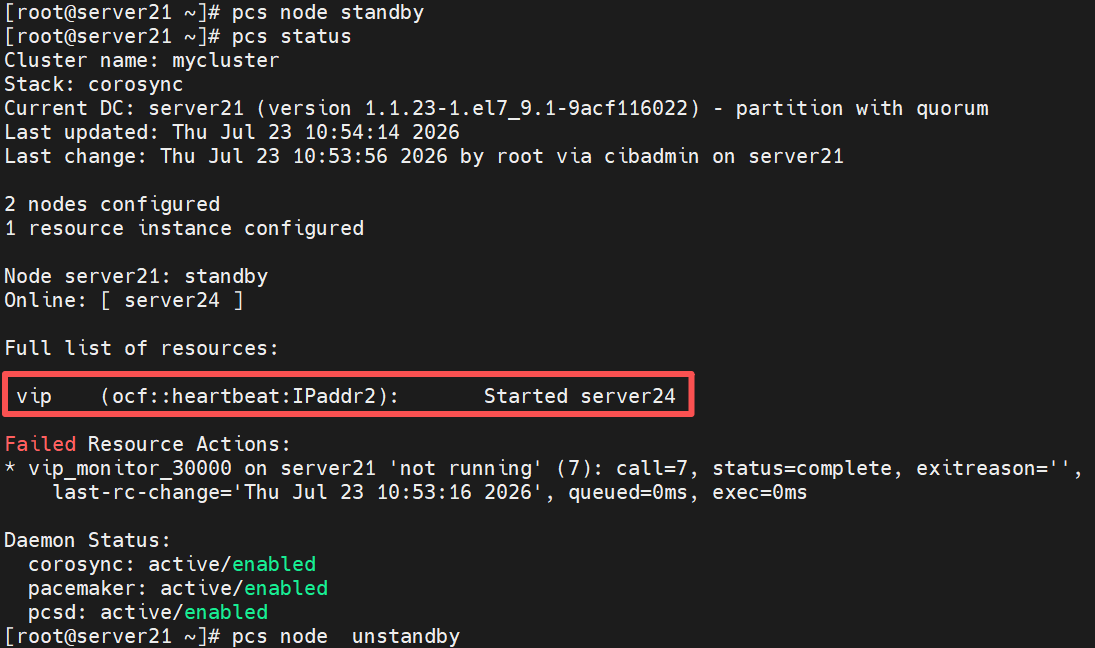
- 节点失效备援
[root@server21 ~]# pcs node standby  #把指定节点设置为待机状态。集群判定该节点不可用:运行在这台节点上的所有资源全部停止,资源自动迁移到集群内其他正常节点
[root@server21 ~]# pcs status
[root@server21 ~]# pcs node unstandby   #恢复server21
- 添加apache服务资源
在添加资源之前,确保server1和server4主机上已经安装了httpd软件
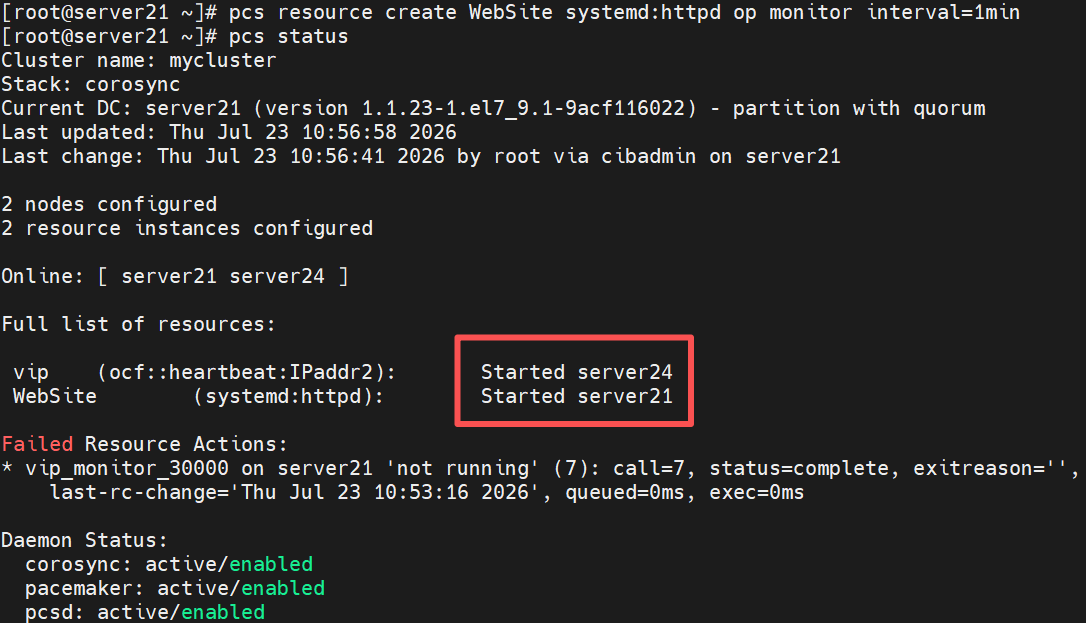
[root@server21 ~]# pcs resource create WebSite systemd:httpd op monitor interval=1min   #创建集群资源,由 Pacemaker 管理httpd(Apache)服务
[root@server21 ~]# pcs status
pcs resource create
创建集群资源命令。WebSite
自定义资源名称,后续操作资源时使用这个名字,可以自定义。systemd:httpd
资源代理 RA 类型:
systemd:代表直接调用系统 systemd 单元管理服务
httpd:对应systemctl start httpd
systemd:httpd:通用 systemd 代理,简单直接,适合实验
ocf:heartbeat:apache:heartbeat 官方专用 Web 资源代理,功能更完善;op monitor interval=1min
op monitor:资源监控动作
interval=1min:每 60 秒检查一次 httpd 运行状态
一旦检测到 httpd 异常崩溃,集群触发资源迁移。
此时发现资源并不在同一台主机上
创建资源组,强制资源运行在同一节点
[root@server21 ~]# pcs resource group add webgroup vip WebSite   #创建资源组 webgroup,并把两个资源加入组内:vip、WebSite
[root@server21 ~]# pcs status
资源组核心规则
- 同组资源永远运行在同一台节点(共置约束);
- 启动顺序:按照书写先后
先启动vip→ 后启动WebSite - 停止顺序逆序
先停止WebSite→ 后停止vip - 故障迁移时,一组资源整体一起漂移
注意:必须先有 VIP,再启动 Web 服务;防止 Web 启动后没有对外访问 IP。
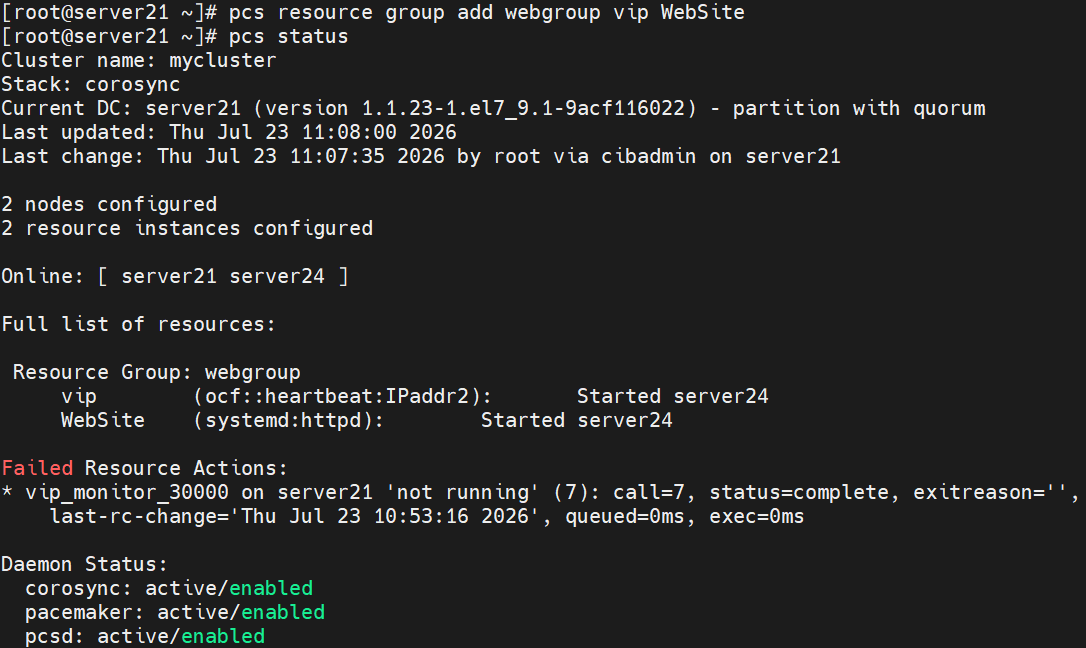
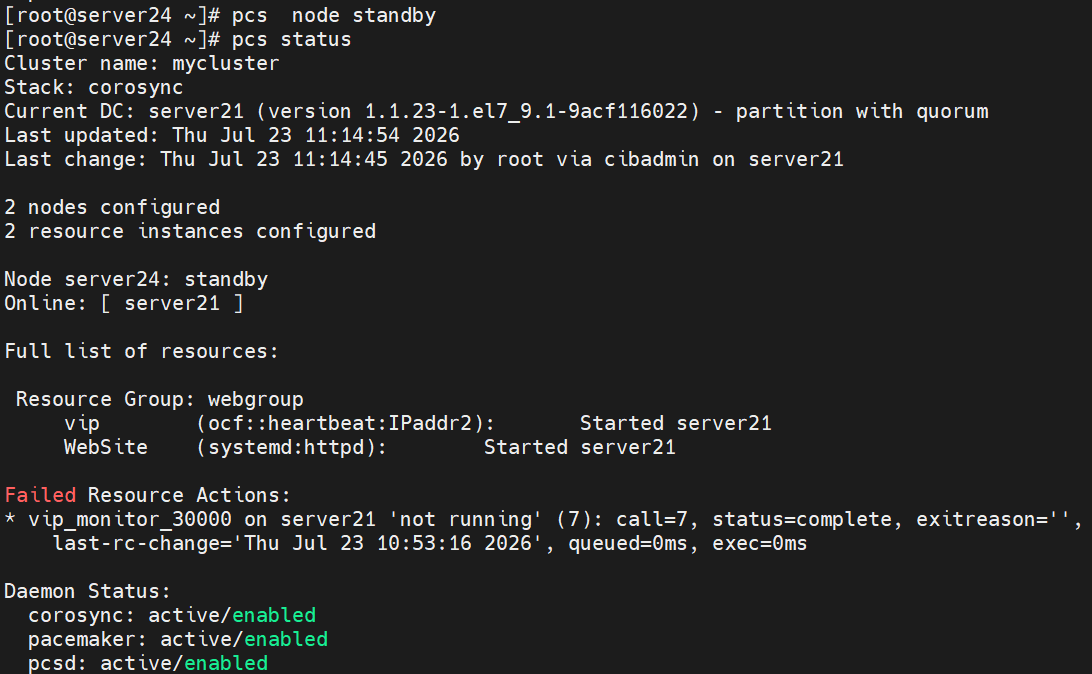
server24节点失效,资源整体迁移到server21
[root@server24 ~]# pcs node standby
6.6 与haproxy结合使用
- 启动server22和server23的httpd服务
[root@server22 ~]# systemctl status httpd
[root@server23 ~]# systemctl status httpd
- 加入paproxy服务
[root@server21 ~]# pcs resource create haproxy systemd:haproxy op monitor interval=1min
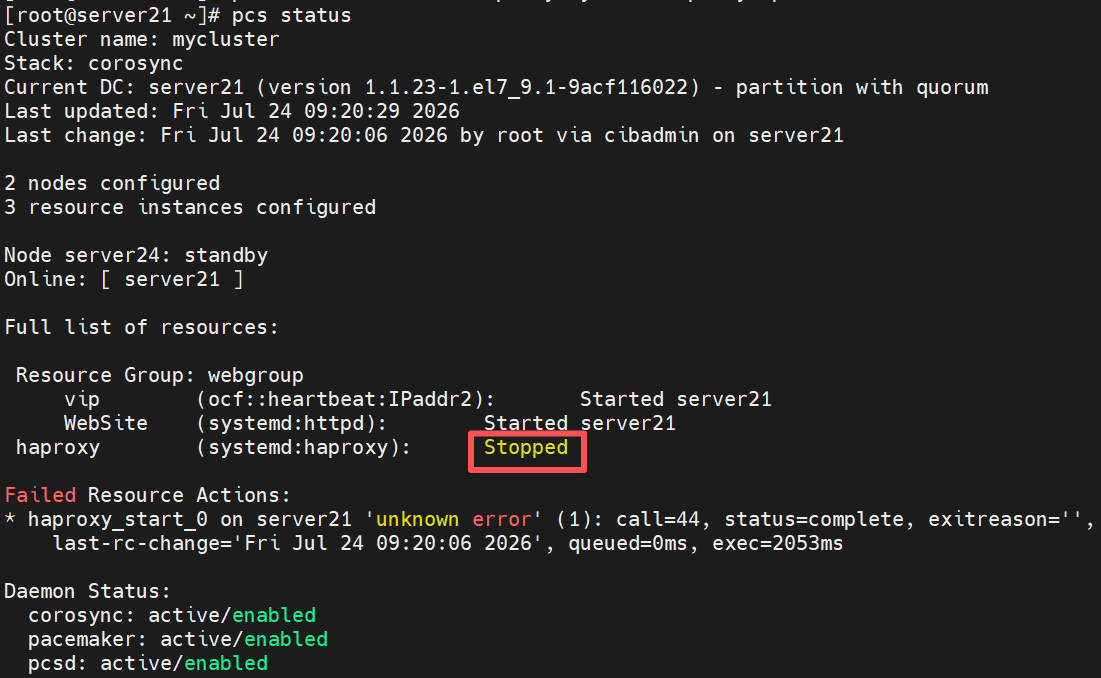
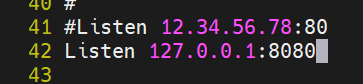
[root@server21 ~]# vi /etc/httpd/conf/httpd.conf
[root@server21 ~]# httpd -t
[root@server21 ~]# pcs resource clear WebSite
[root@server21 ~]# pcs resource restart webgroup
[root@server21 ~]# pcs resource clear haproxy
[root@server21 ~]# pcs resource start haproxy
6.7 配置iscsi存储
配置iscsi输出端
- 在server22上添加虚拟机磁盘 /dev/sdb
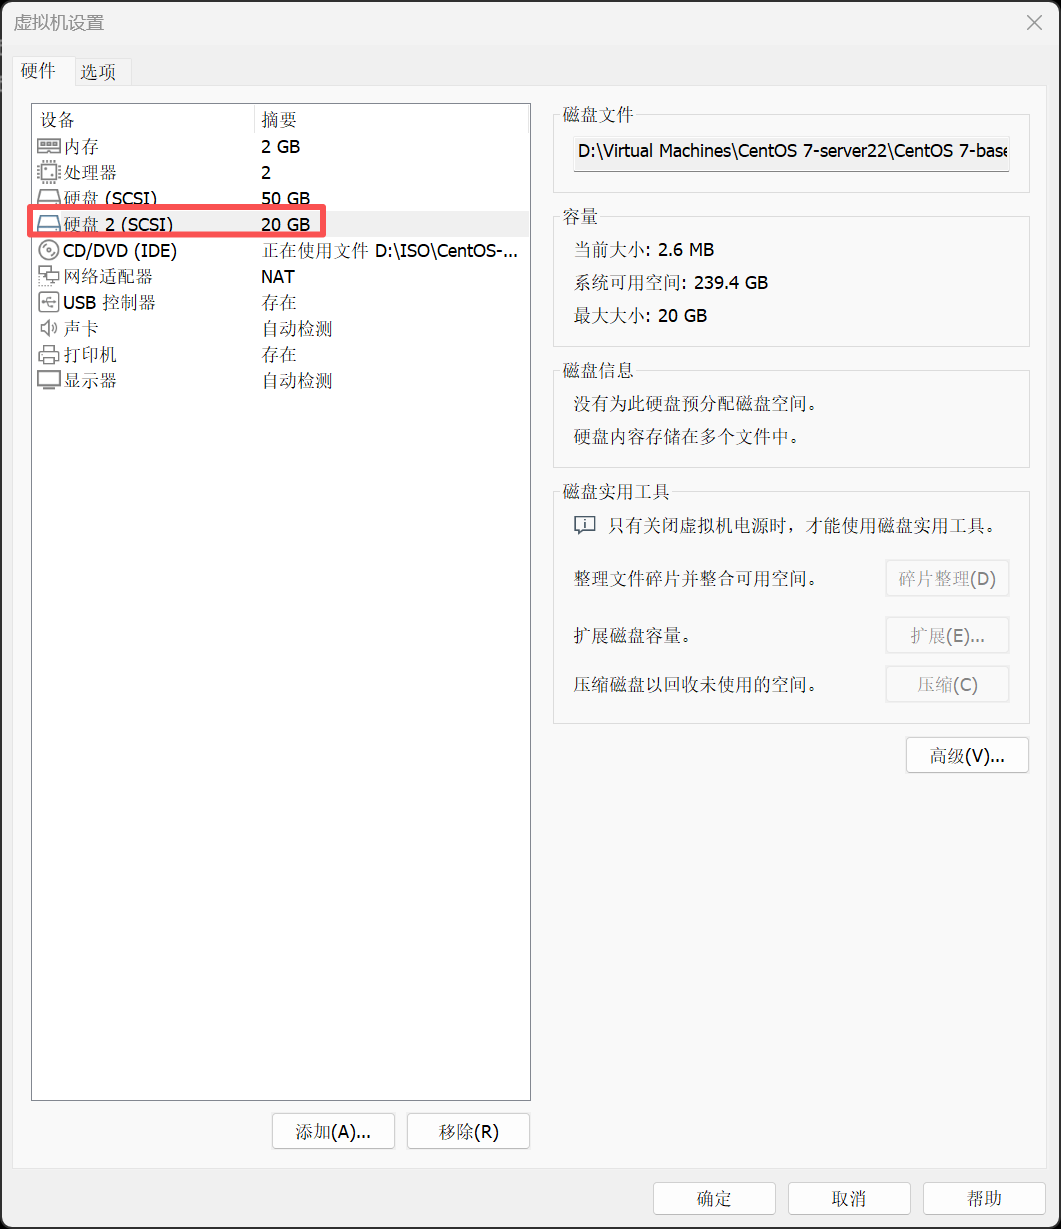
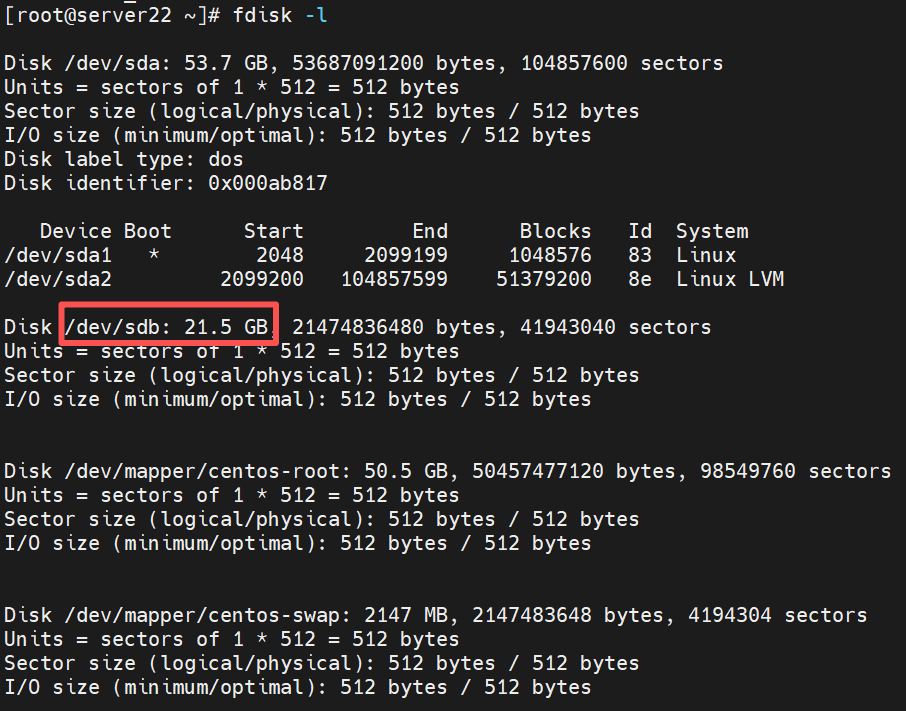
- server22
[root@server22 ~]# yum install -y targetcli
[root@server22 ~]# systemctl enable --now target
[root@server22 ~]# targetcli
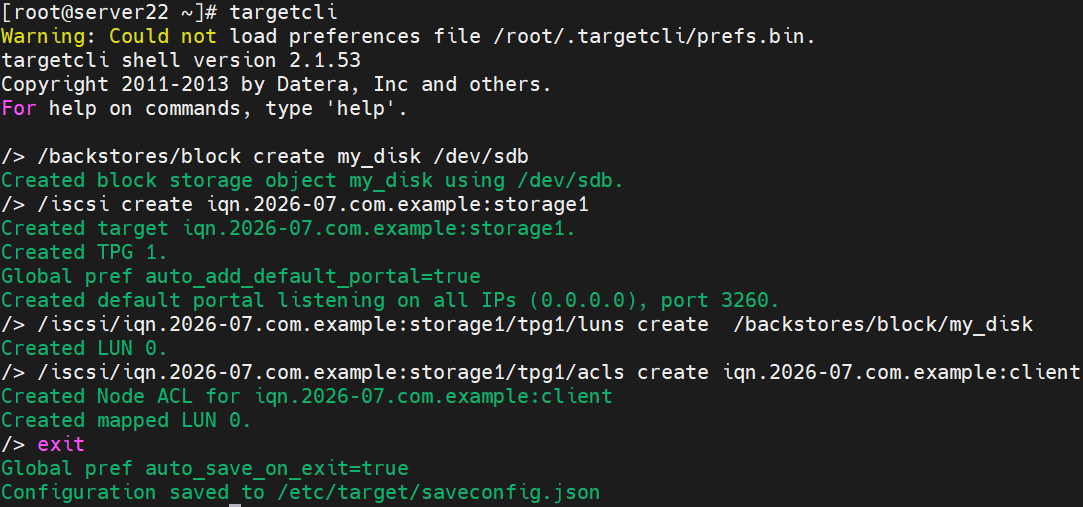
配置iscsi客户端
- 删除集群资源
[root@server21 ~]# pcs resource group remove webgroup
[root@server1 ~]# pcs resource delete vip
[root@server1 ~]# pcs resource delete WebSite
- server21
[root@server21 ~]# yum install -y iscsi-initiator-utils.x86_64
[root@server21 ~]# yum install -y mariadb-server
[root@server21 ~]# vim /etc/iscsi/initiatorname.iscsi
#编辑内容如下图
[root@server21 ~]# iscsiadm -m discovery -t st -p 192.168.40.142
[root@server21 ~]# iscsiadm -m node -l

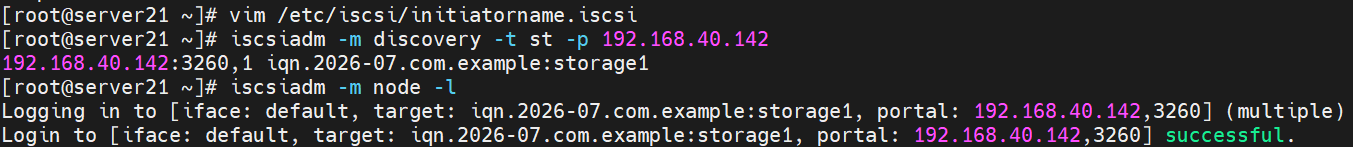
- server24
[root@server24 ~]# yum install -y iscsi-initiator-utils.x86_64
[root@server24 ~]# yum install -y mariadb-server
[root@server24 ~]# vim /etc/iscsi/initiatorname.iscsi
- server21
查看硬盘是否连接成功,此前我在server21上添加过一块硬盘sdb,server22远程连接的为sdc
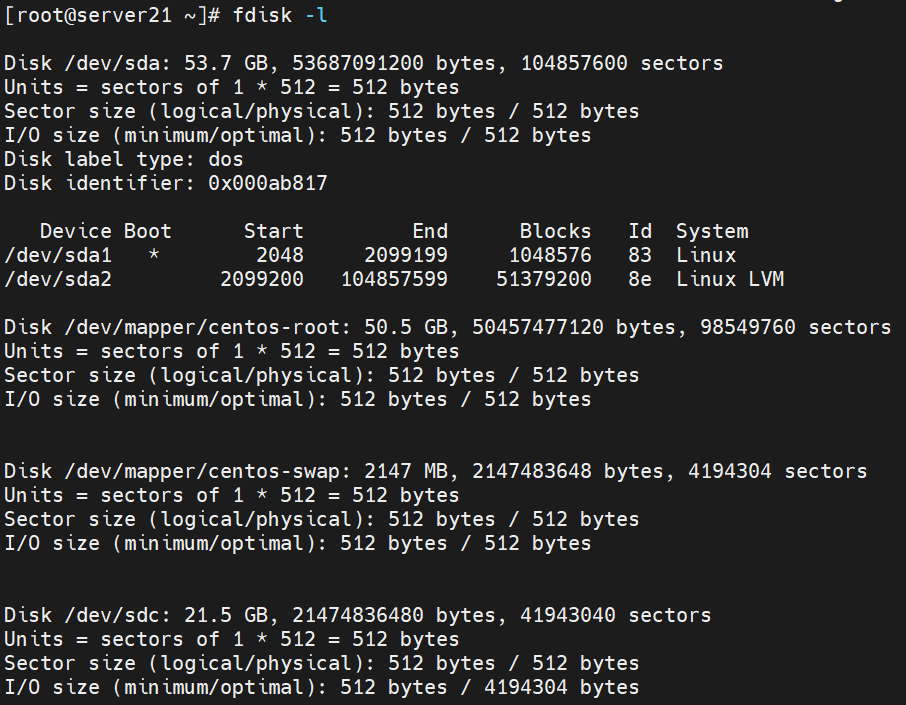
[root@server21 ~]# fdisk /dev/sdc   #分区格式化
[root@server21 ~]# mkfs.xfs /dev/sdc1
[root@server21 ~]# mount /dev/sdc1 /var/lib/mysql   #挂载存储
[root@server21 ~]# chown mysql.mysql /var/lib/mysql   #修改属性
[root@server21 ~]# systemctl start mariadb.service   #数据初始化,会直接初始化到sdc1上
注意:挂载完成再执行 chown!
如果先 chown,再挂载,修改的只是本地被遮挡的空目录权限。一旦挂载远程磁盘,新的磁盘文件系统权限不受影响,数据库启动依然权限报错。
挂载之后再 chown,修改的是 iSCSI 磁盘分区 /dev/sdc1 内部文件系统的根目录权限,MySQL 读写远程存储时权限正常。
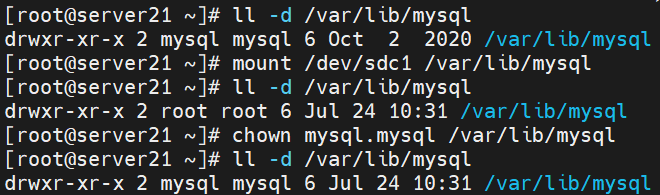
确认配置成功
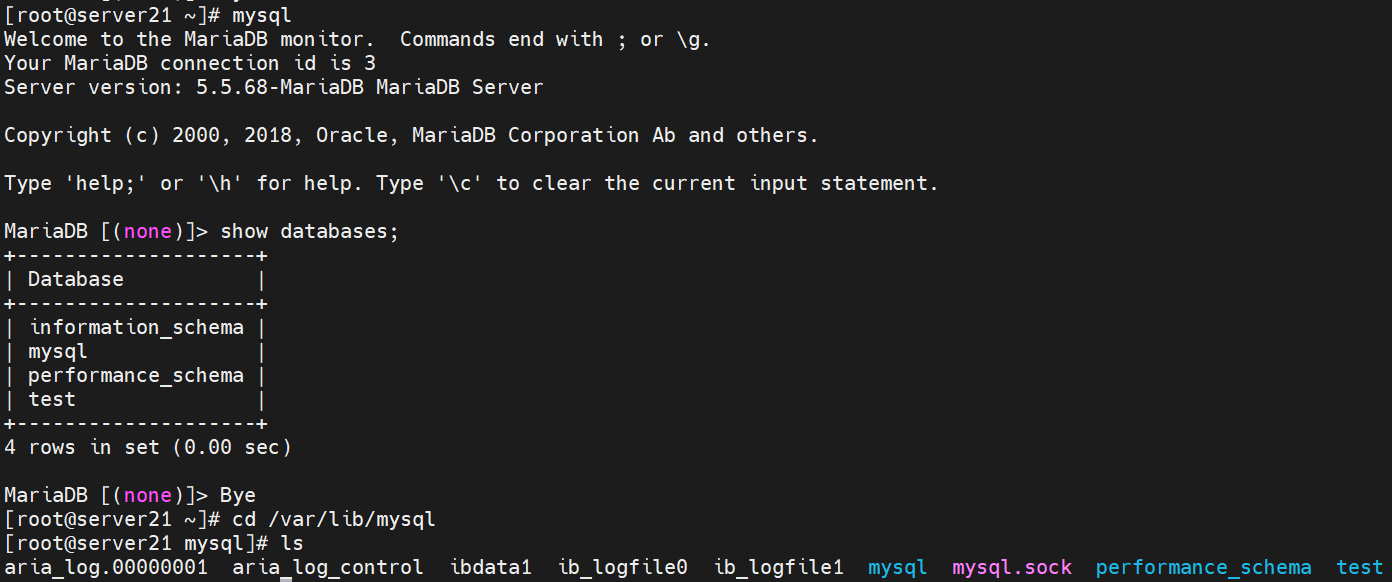
卸载存储,卸载后数据消失
[root@server21 ~]# systemctl stop mariadb.service
[root@server21 ~]# umount /var/lib/mysql
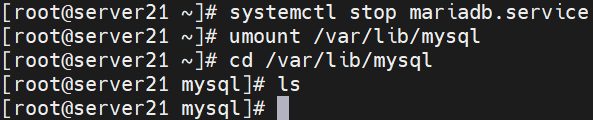
- server24只需导入存储,无需格式化
[root@server24 ~]# iscsiadm -m discovery -t st -p 192.168.40.142
[root@server24 ~]# iscsiadm -m node -l
可以看到已经存在分区了
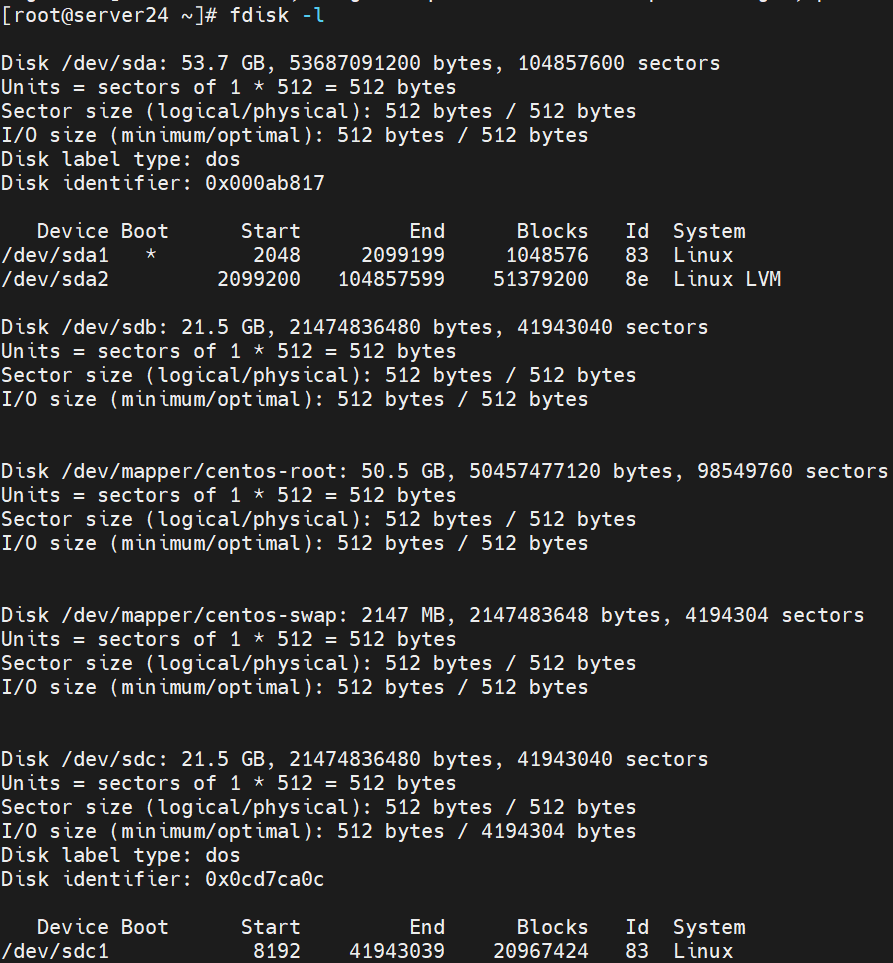
挂载之后数据也直接出现

测试完后停止mariadb服务,取消挂载
[root@server24 ~]# systemctl stop mariadb
[root@server24 ~]# umount /var/lib/mysql
整合iscsi存储和mariadb数据库
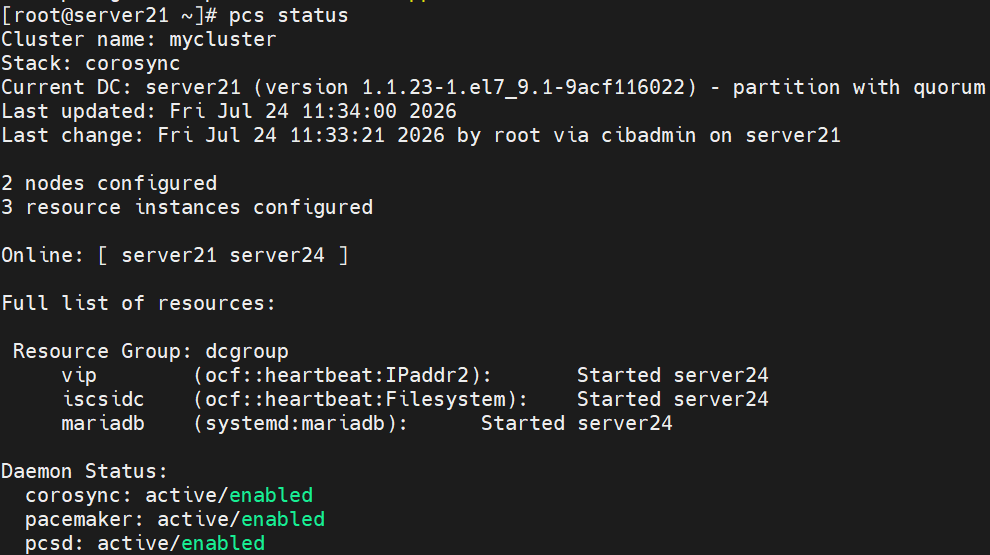
[root@server21 ~]# pcs resource create vip ocf:heartbeat:IPaddr2 ip=192.168.40.100 op monitor interval=30s
[root@server21 ~]# pcs resource create iscsidc ocf:heartbeat:Filesystem device=/dev/sdc1 directory=/var/lib/mysql fstype=xfs op monitor interval=1min
[root@server21 ~]# pcs resource create mariadb systemd:mariadb op monitor interval=1min
[root@server21 ~]# pcs resource group add dcgroup vip iscsidc mariadb

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 7
 0
- 0


 已为社区贡献2条内容

所有评论(0)