【LangGraph实战】《LangGraph实战》_239.[第12章 实战进阶] Agent可靠性工程:重试、降级与容错机制
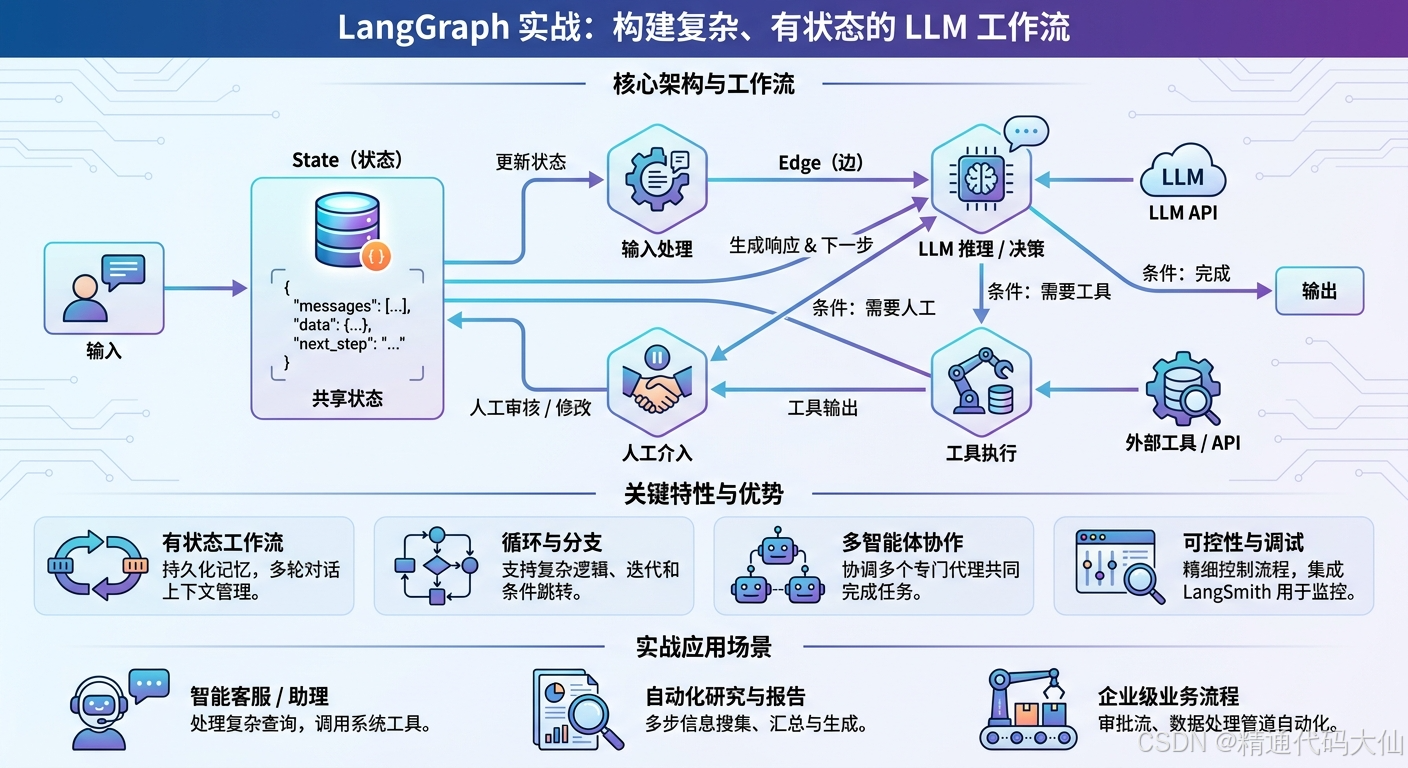
你的Agent不是不能跑,而是跑得太脆弱!从“一崩就跪”到“稳如老狗”:手把手教你用LangGraph打造具备重试、降级与容错能力的工业级Agent,让异常成为你的日志而不是你的噩梦。本文将带你建立Agent可靠性工程的SRE思维,从认知重塑到重试策略,从降级预案到容错隔离,最终落地到LangGraph的状态机设计,让你的Agent在面对LLM抽风、工具超时、状态丢失时依然能体面地为用户服务。
目录
- 认知重塑:Agent的“脆弱”是天生的
- 重试机制:别让“重新加载”成为你的唯一救命稻草
- 降级策略:当LLM“罢工”时,Agent要学会“苟住”
- 容错设计:出错不可怕,可怕的是“死”得悄无声息
- LangGraph落地:把可靠性编织进状态机的每一个节点
- 写在最后
嗨,大家好呀,我是你的老朋友精通代码大仙。接下来我们一起学习 《LangChain核心技术与LLM项目实践》
俗话说得好,“常在河边走,哪有不湿鞋”。咱们做Agent开发的,谁还没经历过半夜被报警电话叫醒,发现LLM抽风、工具超时、状态丢失的至暗时刻?
很多小伙伴刚开始学LangGraph的时候,满脑子都是怎么让Agent“更聪明”——怎么设计更复杂的Prompt,怎么调用更多的工具,怎么让Chain-of-Thought更长更酷。这没毛病。但你要是把Agent捧上线,面对真实用户的奇葩输入、第三方API的突然抽风、模型偶尔的神经刀,你就会发现:一个只能跑通Happy Path的Agent,就像一个只能在晴天骑的自行车,稍微下点雨就散架。
今天咱们不聊那些花里胡哨的“智能”,咱们聊点硬核的——Agent可靠性工程。别一听“工程”俩字就觉得枯燥,这可是区分“玩具Demo”和“生产级应用”的分水岭。重试、降级、容错,这三板斧你练好了,你的Agent才能真正做到“7x24小时稳如老狗”。
1. 认知重塑:Agent的“脆弱”是天生的
点题
先别急着写代码,咱们得先统一思想。为什么传统Web服务那套“加台机器就能解决”的思路,在Agent世界里经常碰壁?因为Agent本质上是一个长周期、不确定、多依赖的异步编排系统。LLM不是确定性的函数,输入一样输出可能天差地别;工具链可能来自五六个不同的第三方,各有各的脾气;状态还要在多个节点之间流转,稍有不慎就上下文爆炸。你把这三座大山叠在一起,不出问题才是奇迹。
看看这张图,你的Agent就像一个走在钢丝上的人,手里还抛着三个球。任何一个球掉了,表演都得砸。
痛点分析
我见过太多新手,拿着写REST API的惯性来写LangGraph节点。他们觉得:“我调OpenAI的接口,就跟调自己公司的内部服务一样,顶多出错抛个异常呗,前端捕获一下就好了。”太天真了!
首先,LLM的响应时间是个玄学。你本地测试50ms就返回,生产环境高峰期可能直接给你干到30秒,然后超时。其次,工具的报错信息往往“夹带私货”。比如你用Python的requests去调一个搜索工具,对方返回个502,你解析JSON直接抛异常,结果这个异常没有被LangGraph捕获,直接把你整个状态机给干停了。
最典型的新手错误,就是把所有逻辑写在一个大节点里,没有任何保护:
def naive_agent_node(state):
    # 1. 调LLM规划
    plan = llm.invoke(state["messages"])
    # 2. 调工具执行
    tool_result = search_tool.invoke(plan.tool_calls[0])
    # 3. 调LLM总结
    final = llm.invoke(f"基于{tool_result}总结")
    return {"messages": [final]}
这段代码在Demo里跑得顺风顺水,但一旦search_tool在第二步挂了,第三步直接作废,前面LLM调用花的钱也白扔了。更惨的是,LangGraph如果没有配置检查点,这一次错误可能让用户从头再来。你说冤不冤?
解决方案
咱们得建立SRE(站点可靠性工程)思维。把Agent的每一个节点都当成一个可能故障的微服务,把每一次LLM调用都当成一次跨网络请求。
核心就三句话:
第一,假设依赖会挂。LLM会限流,工具会超时,数据库会连接池打满。
第二,错误要隔离。一个节点挂了,不能污染整个状态图。
第三,状态要持久。走到哪一步都要能“存盘”,方便恢复和审计。
在LangGraph里,这意味着你从一开始设计图的时候,就要画出“异常处理节点”和“降级边”。别等代码写完了再套try-except,那时候已经晚了。你要在脑子里先有一张“故障地图”:这里可能超时,那里可能限流,这里需要兜底。把这张地图变成你的架构设计文档,而不是事后补丁。
小结
Agent的脆弱不是因为你代码写得烂,而是它的架构天生就暴露在多重不确定性之下。接受这一点,是可靠性工程的第一步。
2. 重试机制:别让“重新加载”成为你的唯一救命稻草
点题
重试是应对瞬时故障的第一道防线,但重试不是“无脑for循环”。真正靠谱的重试,讲究的是“天时地利人和”——什么错误值得重试,等多久再试,试几次就放弃。
这张图看起来简单,但里面的门道可不少。
痛点分析
我见过最离谱的重试代码长这样:
def bad_retry(prompt):
    for i in range(100):  # 疯狂重试100次
        try:
            return llm.invoke(prompt)
        except Exception as e:
            print(f"错了,第{i}次")
            time.sleep(1)  # 固定睡1秒
    raise e
这代码简直是“自杀式袭击”。你想啊,如果是API Key错了(401 Unauthorized),你重试100次有意义吗?如果是对方限流(429 Too Many Requests),你固定间隔1秒去撞墙,不是找死吗?更可怕的是,这100次调用都在一个同步请求里,用户前端等了你100秒,早就关闭页面了。
还有的同学稍微高级一点,知道用tenacity,但配了个retry=retry_if_exception_type(Exception),结果代码里一个ValueError也触发重试,重试三次还是一样的错误,白白浪费token。这就是典型的“为了重试而重试”,根本没过脑子。
解决方案
好的重试机制必须回答三个问题:什么错误值得重试?等多久再试?试几次就放弃?
第一,区分错误类型。
可重试的错误通常是网络层面的:网络超时、连接断开、429限流、503服务不可用。不可重试的错误往往是逻辑层面的:400参数错误、401认证失败、422校验失败。这些都是你的锅,重试一百遍也没用。
第二,指数退避加抖动。
别固定间隔。第一次等2秒,第二次等4秒,第三次等8秒。同时加点随机抖动,防止所有客户端同时重试形成“惊群效应”。
第三,设置熔断与超时上限。
重试次数别超过3到5次。总耗时必须小于你的接口SLA。你要保证即使走到重试上限,用户等待的时间依然是可接受的。
来看个靠谱的写法:
from tenacity import (
    retry,
    stop_after_attempt,
    wait_exponential_jitter,
    retry_if_exception_type,
    before_sleep_log
)
import logging
from openai import RateLimitError, APITimeoutError

logger = logging.getLogger(__name__)

@retry(
    stop=stop_after_attempt(3),
    wait=wait_exponential_jitter(initial=1, max=10),
    retry=retry_if_exception_type((RateLimitError, APITimeoutError)),
    before_sleep=before_sleep_log(logger, logging.WARNING)
)
def robust_llm_call(messages):
    return primary_llm.invoke(messages)
在LangGraph里,你可以在节点函数上加这个装饰器。但要注意:如果重试都失败了,这个节点会抛出异常。这时候你需要在图层面捕获它,而不是让图崩溃。
进阶一点,你还可以做分层重试。节点内部对单次API调用做重试,应对瞬时网络抖动;图层面做节点级重试,应对整个子流程失败。这就像TCP有重传,HTTP也可以有重试,分层治理,互不干扰。
小结
重试是门艺术,讲究的是“对症下药,欲擒故纵”。给故障一点冷却时间,但别给脸不要脸,该熔断时就熔断。
3. 降级策略:当LLM“罢工”时,Agent要学会“苟住”
点题
当重试用尽、主链路彻底挂掉时,Agent必须学会“苟住”。降级不是认输,而是为了保证Agent“至少能说人话”,而不是直接给用户抛个traceback。
这张图就是降级的金字塔。每一层都牺牲一点体验,但换来的是系统不崩溃。
痛点分析
新手最容易犯的毛病,就是“单点依赖”。整个Agent的智商全系于一个GPT-4 API上。一旦这个API挂了,或者你的余额不足了,或者OpenAI抽风了,你的Agent瞬间从“爱因斯坦”变成“植物人”。
我见过一个真实案例:某同学做客服Agent,所有对话都走GPT-4。有一天OpenAI亚太地区维护,他的Agent连“你好,请问有什么可以帮您”这种最简单的问候都说不出来,因为连路由判断都是GPT-4做的。这就好比你家所有电器都插在一个插排上,插排一烧,全屋黑灯。
错误代码往往长这样:
def customer_service_agent(query):
    # 没有任何降级,一条路走到黑
    response = gpt4.invoke([
        SystemMessage(content="你是客服助手..."),
        HumanMessage(content=query)
    ])
    return response.content
还有更隐蔽的错误:做了“伪降级”。比如捕获异常后返回“系统繁忙,请稍后再试”。这在技术层面是降级吗?不,这是“躺平”。真正的降级是“虽然我没法给你最好的答案,但我至少能给你有用的答案”。
解决方案
降级的本质是用确定性换可用性,用质量换连续性。你需要提前设计好几档服务等级。
第一,模型降级。
GPT-4 降级到 GPT-3.5-turbo,再降级到 Claude Haiku,再到本地Qwen或GLM。前面的模型负责复杂推理,后面的模型至少能处理寒暄、FAQ和简单分类。用户问“今天天气怎么样”,哪怕用最便宜的模型也能答得上来。
第二,工具降级。
全量工具集降级到核心工具集,再降级到纯LLM知识。RAG挂了就直接靠模型记忆回答,虽然可能不够新,但总比报错强。
第三,响应降级。
详细分析报告降级到一句话摘要,再降级到安抚话术加记录工单。用户问“帮我分析这份财报”,如果分析工具挂了,至少能回一句“目前分析服务维护中,我已记录您的需求,将在恢复后第一时间推送给您”。
第四,缓存降级。
对于高频问题,维护一个语义缓存,比如用向量数据库做相似度匹配。主链路挂了,先从缓存里找最接近的历史答案。
来看个LangGraph风格的伪代码:
def llm_node(state, config):
    query = state["messages"][-1].content
    try:
        resp = gpt4.invoke(state["messages"])
        return {"messages": [resp], "service_level": "full"}
    except (RateLimitError, APIError):
        try:
            resp = gpt35.invoke(state["messages"])
            return {"messages": [resp], "service_level": "degraded"}
        except Exception:
            cached = semantic_cache.search(query)
            if cached:
                return {
                    "messages": [AIMessage(content=cached)],
                    "service_level": "cache"
                }
            return {
                "messages": [AIMessage(content="小助手有点累,换个问题试试?")],
                "service_level": "fallback"
            }
然后你可以在LangGraph里用条件边,根据service_level决定后续是走深度工具链,还是直接结束对话。这样你的Agent永远有退路。
小结
降级不是摆烂,而是一种负责任的“苟且”。在主链路崩塌时,能让Agent体面地完成任务,才是成熟工程师的担当。
4. 容错设计:出错不可怕,可怕的是“死”得悄无声息
点题
如果说重试和降级是“治病”,那容错就是“强身”——让你的Agent内部结构足够健壮,局部故障不会引发全身瘫痪。
左边是新手常写的“一崩全崩”,右边才是生产级该有的“伤而不残”。
痛点分析
容错设计的反面教材,我见过太多了。
错误一:级联调用不设防。
def research_node(state):
    # 三个工具串行,一个崩全崩
    result1 = search_web(state["query"])
    result2 = scrape_page(result1[0]["url"])
    result3 = summarize(result2)
    return {"result": result3}
错误二:异常吞了不说话。
try:
    result = risky_operation()
except Exception as e:
    pass  # 异常没了,结果也返回None,下游节点拿到None继续崩
错误三:状态不持久,一崩回到解放前。
LangGraph默认如果不用checkpointer,状态都在内存里。进程一重启,用户聊了半天的上下文全没了。你修复了bug重新部署,用户回来发现Agent“失忆”了。这种体验简直灾难。
解决方案
第一,细粒度错误隔离。
特别是在工具调用节点,每个工具独立try-catch。LangGraph的ToolNode其实内部已经做了这件事,但很多人自己写自定义工具节点时忘了。
def safe_tools_node(state):
    tool_messages = []
    for tool_call in state["tool_calls"]:
        try:
            observation = execute_single_tool(tool_call)
            tool_messages.append(ToolMessage(
                content=str(observation),
                tool_call_id=tool_call["id"]
            ))
        except Exception as e:
            tool_messages.append(ToolMessage(
                content=f"工具执行失败:{type(e).__name__}: {e}",
                tool_call_id=tool_call["id"]
            ))
    return {"messages": tool_messages}
这样做的好处是,即使某个工具挂了,其他工具的结果依然能回到LLM,LLM可以根据部分信息做出最好的回应,而不是直接掀桌子。
第二,状态快照与断点续传。
这是LangGraph的杀手锏。配置一个持久的checkpointer,比如Postgres、Redis或SQLite,让每一次状态流转都落盘。
from langgraph.checkpoint.sqlite import SqliteSaver

memory = SqliteSaver.from_conn_string("checkpoints.sqlite")
graph = builder.compile(checkpointer=memory)

config = {"configurable": {"thread_id": "user_123"}}
graph.invoke(initial_state, config)
这意味着你的Agent节点崩了,修复代码后可以从中断的地方继续跑,而不是让用户重新输入一遍。这种“记忆不灭”的能力,是可靠性工程的压舱石。
第三,优雅退出与人工介入。
有些错误确实处理不了,比如用户要求涉及敏感操作。这时候别抛500错误,而是进入一个人工审核节点,或者礼貌地告知用户边界。
def boundary_check_node(state):
    if state["risk_score"] > 0.9:
        return {
            "messages": [AIMessage(content="该请求涉及高风险操作,已转人工审核。")],
            "status": "human_in_loop"
        }
    return {"status": "continue"}
小结
容错设计的最高境界是 fail fast, recover faster。错误隔离防止扩散,状态持久化让恢复成为可能。
5. LangGraph落地:把可靠性编织进状态机的每一个节点
点题
前面讲的都是“道”和“法”,现在咱们聊聊“术”——在LangGraph这个特定框架里,怎么把这些可靠性模式编织进你的状态机。
这张图就是你可靠性工程的蓝图。每一条边、每一个子图,都对应着一种故障处理策略。
痛点分析
很多新手学完了LangGraph基础,知道了Node和Edge,也知道了StateSchema,但一遇到异常就懵:
“我应该把重试逻辑写在节点里,还是写个循环边?”
“节点抛异常了,LangGraph会自动捕获吗?”
“我想让用户在出错时选择重试或取消,怎么中断流程?”
最常见的错误,就是把业务逻辑和可靠性逻辑揉成一团。比如在一个节点里既做LLM调用,又做重试循环,又做降级判断,最后这个节点代码200行,测都没法测。还有一种错误,就是滥用add_conditional_edges做异常路由,结果图画出来像意大利面条,维护成本极高。
解决方案
第一,节点单一职责。
一个节点只做一件事:调用LLM、调用工具、或者做错误处理。不要把重试逻辑和业务逻辑混写。你的节点应该像乐高积木,拼起来清晰可读。
第二,子图封装复杂可靠性模式。
如果你有一个“调用外部API”的流程,需要经过“调用→重试→降级→缓存”四步,把这四步封装成一个子图,对外暴露一个统一的节点接口。
def make_robust_llm_subgraph(primary_llm, fallback_llm):
    sub_builder = StateGraph(AgentState)

    def call_primary(state):
        try:
            msg = primary_llm.invoke(state["messages"])
            return {"messages": [msg], "_status": "ok"}
        except ModelUnavailable:
            return {"_status": "retry"}
        except Exception:
            return {"_status": "fallback"}

    def retry_node(state):
        # 指数退避逻辑
        return {"_status": "primary"}

    def call_fallback(state):
        msg = fallback_llm.invoke(state["messages"])
        return {"messages": [msg], "_status": "ok"}

    sub_builder.add_node("primary", call_primary)
    sub_builder.add_node("retry", retry_node)
    sub_builder.add_node("fallback", call_fallback)
    sub_builder.add_edge(START, "primary")
    # 根据_status路由
    sub_builder.add_conditional_edges("primary", route_by_status)
    sub_builder.add_conditional_edges("retry", route_by_status)

    return sub_builder.compile()
这样做的好处是,主图依然干净整洁,可靠性细节被封装在子图内部。
第三,善用Interrupt做人工介入。
LangGraph的NodeInterrupt允许你在节点中暂停整个图,等待外部输入,比如用户确认或运维修复。这在高风险操作或不可恢复错误时非常有用。
from langgraph.errors import NodeInterrupt

def sensitive_action_node(state):
    if not state.get("admin_approved"):
        raise NodeInterrupt("需要管理员授权才能继续执行")
    return {"result": execute_sensitive_action()}
恢复时,通过更新状态中的admin_approved为True,然后重新调用图,流程会从断点无缝继续。
第四,Checkpoint策略。
生产环境不要用内存MemorySaver。至少用Redis或Postgres。配置合理的checkpoint命名空间,按用户session隔离。
from langgraph.checkpoint.postgres import PostgresSaver

checkpointer = PostgresSaver(conn_string="postgresql://...")
graph = builder.compile(checkpointer=checkpointer)
第五,可观测性埋点。
在每个节点入口和出口打日志,记录状态快照的摘要。利用LangSmith或自定义Metrics,监控重试次数、降级触发率、节点错误率。没有监控的可靠性工程都是盲人摸象。你得知道你的Agent“病”在哪里,才能对症下药。
小结
LangGraph的图结构不是束缚,而是你的可靠性蓝图。把重试画成环,把降级画成分支,把容错画成子图,你的架构图本身就是一份故障处理手册。
写在最后
咱们今天聊了这么多,从认知重塑到重试机制,从降级策略到容错设计,最后落实到LangGraph的工程实践。说白了,Agent可靠性工程没有银弹,也不是靠引入一个库就能万事大吉。它是一种思维方式,一种“假设世界充满恶意,但我依然能优雅应对”的工程师气质。
很多新手总觉得,先把功能做出来,可靠性后面再补。但现实往往是,当你上线第一天面对真实流量时,那些你欠下的技术债会连本带利地找上门。LLM不会因为你加班就对你仁慈,第三方API也不会因为你新手就给你免死金牌。
所以,从现在开始,画你的第一张“故障地图”吧。给每个LLM调用加上重试,给每个关键链路设计好降级,给每一次状态流转配上Checkpoint。你会发现,当你的Agent从“一碰就碎”进化到“百毒不侵”时,你收获的不仅是系统的稳定性,还有作为工程师那份踏实的底气。
编程之路不易,但每一步成长都算数。保持好奇,持续学习,你也能写出那个在风暴中依然从容不迫的Agent。咱们下回接着唠!
关注私信备注:“资料代找获取”,全网计算机学习资料代找:例如:
《课程:AI 大模型工程师系统课程 (22 章完整版 持续更新)》
《课程:AI 大模型系统实战课第四期 (2026 年开课 持续更新)》
《课程:2026 年 AGI 大模型系统课 23 期》
《课程:2026 年 AGI 大模型系统课 21 期》
《课程:AI 大模型实战课 8 期 (2026 年 2 月最新完结版)》
《课程:AI 大模型系统实战课三期》
《课程:AI 大模型系统课程 (2026 年 2 月开课 持续更新)》
《课程:AI 大模型全阶课程 (2025 年 12 月开课 2026 年 6 月结课)》
《课程:AI 大模型工程师全阶课程 (2025 年 10 月开课 2026 年 4 月结课)》
《课程:2026 年最新大模型 Agent 开发系统课 (持续更新)》
《课程:LLM 多模态视觉大模型系统课》
《课程:大模型 AI 应用开发企业级项目实战课 (2026 年 1 月开课)》
《课程:大模型智能体线上速成班 V2.0》
《课程:Java+AI 大模型智能应用开发全阶课》
《课程:Python+AI 大模型实战视频教程》
《书籍:软件工程 3.0: 大模型驱动的研发新范式.pdf》
《课程:人工智能大模型系统课 (2026 年 1 月底完结版)》
《课程:AI 大模型零基础到商业实战全栈课第五期》
《课程:Vue3.5+Electron + 大模型跨平台 AI 桌面聊天应用实战 (2025)》
《课程:AI 大模型实战训练营 从入门到实战轻松上手》
《课程:2026 年 AI 大模型 RAG 与 Agent 智能体项目实战开发课》
《课程:大模型训练营配套补充资料》

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献15条内容

所有评论(0)