(7)FPGA-CNN卷积层verilog实现
CNN
CNN(Convolutional Neural Network,卷积神经网络)是一种广泛应用于计算机视觉领域的深度学习模型。其核心思想是利用卷积运算提取图像特征,再通过激活函数、池化层和全连接层完成特征压缩与分类决策。其中卷积层包含大量乘加运算,是网络计算量最集中的部分,因此常作为 FPGA 硬件加速的重点对象,以提高推理速度并降低功耗。
卷积层
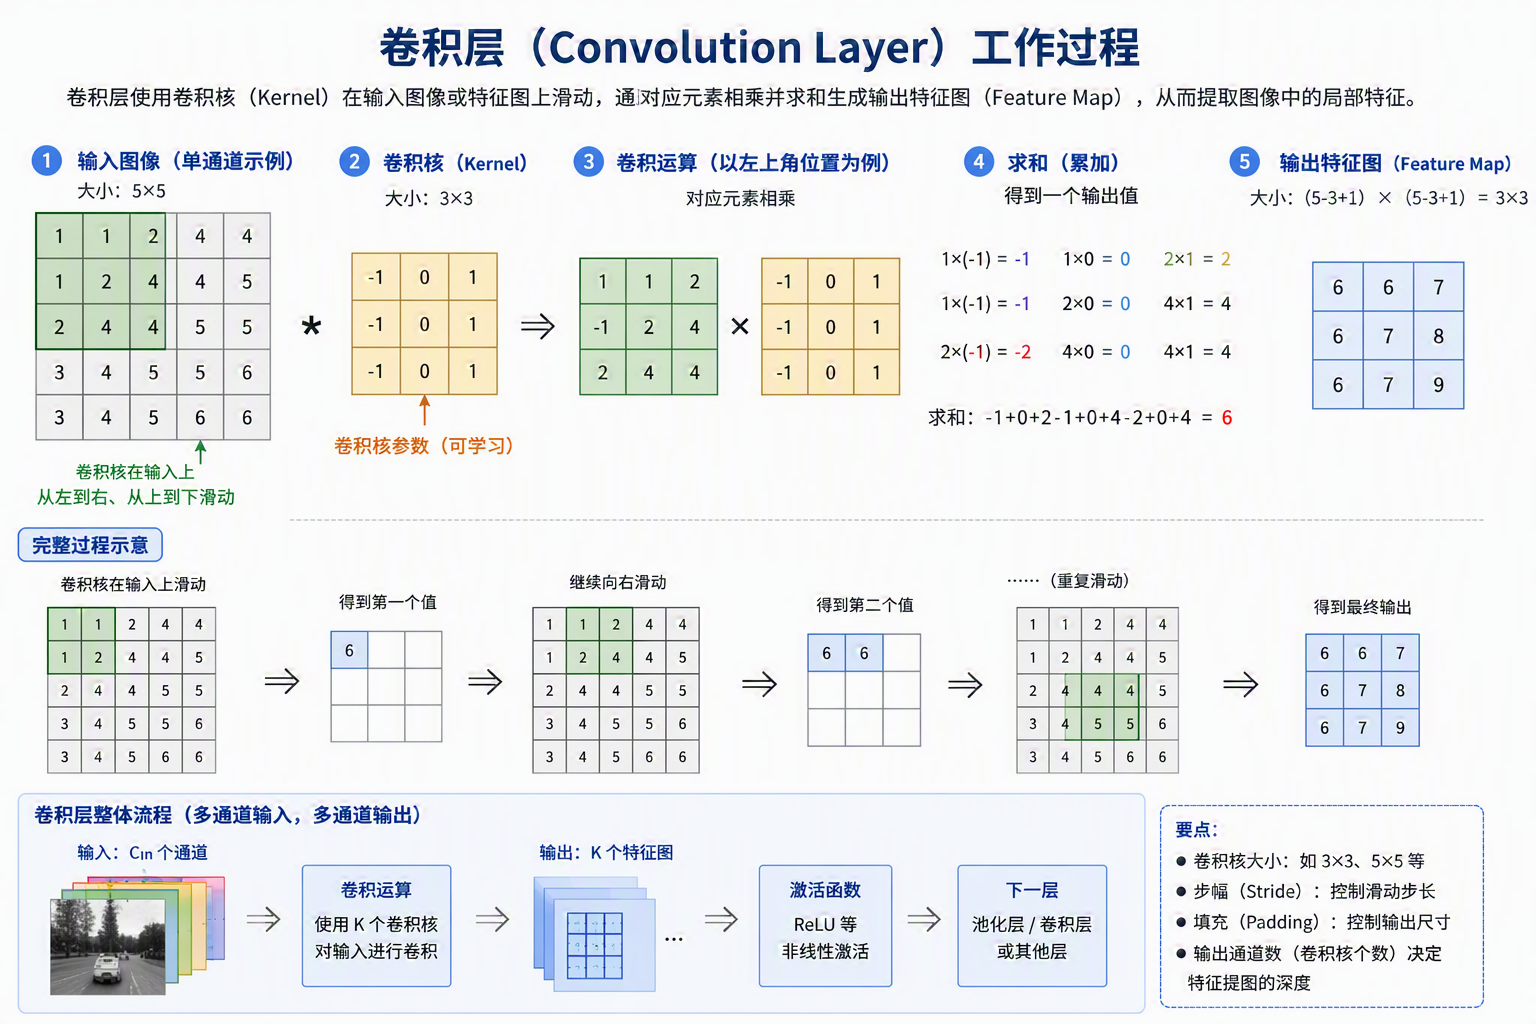
卷积层(Convolution Layer)是 CNN 中最核心的组成部分,主要负责从输入图像或特征图中提取有效特征。其基本原理是利用卷积核(Kernel)在输入数据上滑动,通过对应元素相乘并求和的方式生成新的特征图(Feature Map)。随着网络层数的加深,卷积层能够逐步学习图像中的边缘、纹理、角点以及更高层次的目标特征。由于卷积运算包含大量乘加(MAC)操作,因此卷积层通常占据 CNN 网络绝大部分的计算量,也是 FPGA、GPU 等硬件平台重点加速的对象。对于 FPGA 实现而言,卷积层通常采用并行乘法器和流水线加法树结构来提高运算吞吐率和处理性能。
verilog实现卷积层
(1)加载权重
在 FPGA 实现 CNN 卷积层时,卷积核权重通常预先存储在 ROM 中,并在卷积运算过程中根据地址依次读出。系统上电后,ROM 通过预初始化的 .mem 文件加载训练得到的权重参数,卷积模块按照设定的地址顺序读取对应权重,并与输入特征图像素进行乘法运算。由于卷积核参数在推理过程中通常保持不变,因此采用 ROM 存储不仅能够节省逻辑资源,还可以提高数据访问效率。在 FPGA 实现中,ROM 一般由 Block RAM(BRAM)或 Distributed RAM 构成,通过地址计数器控制权重读取,并与卷积计算单元形成流水线结构,从而实现卷积层的高速并行计算。示例代码如下。
//=========init kernel weights=========
always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        addr <= 0;
    end else if(ena)begin
        if(addr <= param_num - 1)begin
            addr <= addr + 1;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        r_addr <= 0;
        r_ena <= 0;
    end else begin
        r_addr <= addr;
        r_ena <= ena;
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        ena <= 0;
    end else if(addr < param_num - 1)begin
        ena <= 1;
    end else begin
        ena <= 0;
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0; i<param_num; i=i+1)
            weight[i] <= 8'd0;
    end else if(r_ena)begin
        weight[r_addr] <= data;
    end
end

xpm_memory_sprom #(
    .ADDR_WIDTH_A       (8                  ),
    .MEMORY_SIZE        (2048               ),
    .READ_DATA_WIDTH_A  (8                  ),
    .MEMORY_INIT_FILE   ("../rtl/coef.mem"  ),
    .SIM_ASSERT_CHK     (1                  ),
    .READ_LATENCY_A     (1                  ),
    .MESSAGE_CONTROL    (1                  ),
    .MEMORY_PRIMITIVE   ("block"            )
)u_rom(
    .clka               (clk                ),
    .rsta               (1'b0               ),
    .ena                (ena                ),
    .regcea             (1'b1               ),

    .addra              (addr               ),

    .injectsbiterra     (1'b0               ),
    .injectdbiterra     (1'b0               ),

    .douta              (data               )
);
(2)5x5窗口
在卷积运算开始之前,需要从输入特征图中提取与卷积核尺寸对应的数据窗口。对于 5×5 卷积核,FPGA 通常采用 4 个行缓存(Line Buffer)配合移位寄存器 的方式构建 5×5 滑动窗口。当图像数据按行连续输入时,行缓存用于保存前四行像素数据,而当前输入行作为第五行数据,通过移位寄存器不断更新每一行的最近 5 个像素。随着每个时钟周期输入一个新像素,窗口整体向右滑动一个像素位置,从而实时输出完整的 5×5 邻域数据供卷积计算单元使用。该方法无需存储整帧图像,具有资源占用少、处理延迟低和易于流水线实现等优点,因此被广泛应用于 FPGA 图像处理和 CNN 卷积加速器设计中。示例代码如下。
//================generate 5x5 window=============
//reset fifo

reg     [23:0]  tdata_d1,tdata_d2,tdata_d3,tdata_d4,tdata_d5;
reg             tvalid_d1,tvalid_d2,tvalid_d3,tvalid_d4,tvalid_d5;
reg             tready_d1,tready_d2,tready_d3,tready_d4,tready_d5;
reg     [9:0]   col_cnt,row_cnt;
wire            fifo_rst   = s_axis_tuser;

wire    [3:0]   wr_en;
wire    [23:0]  wr_data[0:3];
wire    [3:0]   rd_en;
wire    [23:0]  rd_data[0:3];

assign          wr_en[0] = tready_d5 & tvalid_d5;
assign          wr_en[1] = rd_en[0];
assign          wr_en[2] = rd_en[1];
assign          wr_en[3] = rd_en[2];
assign          wr_data[0] = tdata_d5;
assign          wr_data[1] = rd_data[0];
assign          wr_data[2] = rd_data[1];
assign          wr_data[3] = rd_data[2];
assign          rd_en[0] = wr_en[0] & (row_cnt >= 1);
assign          rd_en[1] = wr_en[0] & (row_cnt >= 2);
assign          rd_en[2] = wr_en[0] & (row_cnt >= 3);
assign          rd_en[3] = wr_en[0] & (row_cnt >= 4);

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        col_cnt <= 0;
    end else if(fifo_rst)begin
        col_cnt <= 0;
    end else if(wr_en)begin
        if(col_cnt == WIDTH - 1)begin
            col_cnt <= 0;
        end else begin
            col_cnt <= col_cnt + 1;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        row_cnt <= 0;
    end else if(fifo_rst)begin
        row_cnt <= 0;
    end else if(wr_en)begin
        if(col_cnt == WIDTH - 1)begin
            row_cnt <= row_cnt + 1;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        tdata_d1 <= 0;
        tdata_d2 <= 0;
        tdata_d3 <= 0;
        tdata_d4 <= 0;
        tdata_d5 <= 0;
        tvalid_d1 <= 0;
        tvalid_d2 <= 0;
        tvalid_d3 <= 0;
        tvalid_d4 <= 0;
        tvalid_d5 <= 0;
        tready_d1 <= 0;
        tready_d2 <= 0;
        tready_d3 <= 0;
        tready_d4 <= 0;
        tready_d5 <= 0;
    end else begin
        tdata_d1 <= s_axis_tdata;
        tdata_d2 <= tdata_d1;
        tdata_d3 <= tdata_d2;
        tdata_d4 <= tdata_d3;
        tdata_d5 <= tdata_d4;
        tvalid_d1 <= s_axis_tvalid;
        tvalid_d2 <= tvalid_d1;
        tvalid_d3 <= tvalid_d2;
        tvalid_d4 <= tvalid_d3;
        tvalid_d5 <= tvalid_d4;
        tready_d1 <= s_axis_tready;
        tready_d2 <= tready_d1;
        tready_d3 <= tready_d2;
        tready_d4 <= tready_d3;
        tready_d5 <= tready_d4;
    end
end

genvar j;
generate
    for(j = 0; j < 4; j=j+1)begin:gen_line_buffer
        xpm_fifo_sync #(
            .FIFO_MEMORY_TYPE   ("block"            ), // "auto" / "block" / "distributed" / "ultra"
            .FIFO_WRITE_DEPTH   (FIFO_DEPTH         ),
            .WRITE_DATA_WIDTH   (24                 ),
            .READ_DATA_WIDTH    (24                 ),
            .READ_MODE          ("fwft"             )
        ) u_lane_buffer(
            .wr_clk             (clk                ),
            .rst                ((~aresetn)|fifo_rst),

            .din                (wr_data[j]         ),
            .wr_en              (wr_en[j]           ),
            .full               (                   ),

            .dout               (rd_data[j]         ),
            .rd_en              (rd_en[j]           ),
            .empty              (                   )
        );
    end
endgenerate

wire [23:0] w04;
wire [23:0] w14;
wire [23:0] w24;
wire [23:0] w34;
wire [23:0] w44;
reg  [23:0] w00,w01,w02,w03;
reg  [23:0] w10,w11,w12,w13;
reg  [23:0] w20,w21,w22,w23;
reg  [23:0] w30,w31,w32,w33;
reg  [23:0] w40,w41,w42,w43;
wire        wd_valid;

assign  w04 = rd_data[3];
assign  w14 = wr_data[3];
assign  w24 = wr_data[2];
assign  w34 = wr_data[1];
assign  w44 = wr_data[0];
assign  wd_valid = wr_en & (row_cnt >= 4) & (col_cnt >= 4);

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        w03 <= 0;
        w02 <= 0;
        w01 <= 0;
        w00 <= 0;
        w13 <= 0;
        w12 <= 0;
        w11 <= 0;
        w10 <= 0;
        w23 <= 0;
        w22 <= 0;
        w21 <= 0;
        w20 <= 0;
        w33 <= 0;
        w32 <= 0;
        w31 <= 0;
        w30 <= 0;
        w43 <= 0;
        w42 <= 0;
        w41 <= 0;
        w40 <= 0;
    end else begin
        w03  <= w04;
        w02  <= w03;
        w01  <= w02;
        w00  <= w01;
        w13  <= w14;
        w12  <= w13;
        w11  <= w12;
        w10  <= w11;
        w23  <= w24;
        w22  <= w23;
        w21  <= w22;
        w20  <= w21;
        w33  <= w34;
        w32  <= w33;
        w31  <= w32;
        w30  <= w31;
        w43  <= w44;
        w42  <= w43;
        w41  <= w42;
        w40  <= w41;
    end
end
(3)乘法累加
乘法累加(Multiply-Accumulate,MAC)是卷积层计算的核心操作。在卷积运算过程中,5×5 窗口中的像素数据与对应位置的卷积核权重分别进行乘法运算,得到多个乘积结果,再将所有乘积项累加求和,从而生成当前输出特征图中的一个像素值。以 5×5×3 卷积为例,需要完成 75 次乘法和 74 次加法运算。为了提高运算性能,FPGA 通常利用 DSP 资源实现并行乘法,并采用流水线加法树对乘积结果进行逐级累加,从而在保证高时钟频率的同时实现高吞吐量的卷积计算。示例代码如下:
//================multi================
wire signed [8:0]  s_data[74:0];
//flatten
assign  s_data[0] = {1'b0,w00[23:16]};
assign  s_data[1] = {1'b0,w01[23:16]};
assign  s_data[2] = {1'b0,w02[23:16]};
assign  s_data[3] = {1'b0,w03[23:16]};
assign  s_data[4] = {1'b0,w04[23:16]};
assign  s_data[5] = {1'b0,w10[23:16]};
assign  s_data[6] = {1'b0,w11[23:16]};
assign  s_data[7] = {1'b0,w12[23:16]};
assign  s_data[8] = {1'b0,w13[23:16]};
assign  s_data[9] = {1'b0,w14[23:16]};
assign  s_data[10] = {1'b0,w20[23:16]};
assign  s_data[11] = {1'b0,w21[23:16]};
assign  s_data[12] = {1'b0,w22[23:16]};
assign  s_data[13] = {1'b0,w23[23:16]};
assign  s_data[14] = {1'b0,w24[23:16]};
assign  s_data[15] = {1'b0,w30[23:16]};
assign  s_data[16] = {1'b0,w31[23:16]};
assign  s_data[17] = {1'b0,w32[23:16]};
assign  s_data[18] = {1'b0,w33[23:16]};
assign  s_data[19] = {1'b0,w34[23:16]};
assign  s_data[20] = {1'b0,w40[23:16]};
assign  s_data[21] = {1'b0,w41[23:16]};
assign  s_data[22] = {1'b0,w42[23:16]};
assign  s_data[23] = {1'b0,w43[23:16]};
assign  s_data[24] = {1'b0,w44[23:16]};
assign  s_data[25] = {1'b0,w00[15:8]};
assign  s_data[26] = {1'b0,w01[15:8]};
assign  s_data[27] = {1'b0,w02[15:8]};
assign  s_data[28] = {1'b0,w03[15:8]};
assign  s_data[29] = {1'b0,w04[15:8]};
assign  s_data[30] = {1'b0,w10[15:8]};
assign  s_data[31] = {1'b0,w11[15:8]};
assign  s_data[32] = {1'b0,w12[15:8]};
assign  s_data[33] = {1'b0,w13[15:8]};
assign  s_data[34] = {1'b0,w14[15:8]};
assign  s_data[35] = {1'b0,w20[15:8]};
assign  s_data[36] = {1'b0,w21[15:8]};
assign  s_data[37] = {1'b0,w22[15:8]};
assign  s_data[38] = {1'b0,w23[15:8]};
assign  s_data[39] = {1'b0,w24[15:8]};
assign  s_data[40] = {1'b0,w30[15:8]};
assign  s_data[41] = {1'b0,w31[15:8]};
assign  s_data[42] = {1'b0,w32[15:8]};
assign  s_data[43] = {1'b0,w33[15:8]};
assign  s_data[44] = {1'b0,w34[15:8]};
assign  s_data[45] = {1'b0,w40[15:8]};
assign  s_data[46] = {1'b0,w41[15:8]};
assign  s_data[47] = {1'b0,w42[15:8]};
assign  s_data[48] = {1'b0,w43[15:8]};
assign  s_data[49] = {1'b0,w44[15:8]};
assign  s_data[50] = {1'b0,w00[7:0]};
assign  s_data[51] = {1'b0,w01[7:0]};
assign  s_data[52] = {1'b0,w02[7:0]};
assign  s_data[53] = {1'b0,w03[7:0]};
assign  s_data[54] = {1'b0,w04[7:0]};
assign  s_data[55] = {1'b0,w10[7:0]};
assign  s_data[56] = {1'b0,w11[7:0]};
assign  s_data[57] = {1'b0,w12[7:0]};
assign  s_data[58] = {1'b0,w13[7:0]};
assign  s_data[59] = {1'b0,w14[7:0]};
assign  s_data[60] = {1'b0,w20[7:0]};
assign  s_data[61] = {1'b0,w21[7:0]};
assign  s_data[62] = {1'b0,w22[7:0]};
assign  s_data[63] = {1'b0,w23[7:0]};
assign  s_data[64] = {1'b0,w24[7:0]};
assign  s_data[65] = {1'b0,w30[7:0]};
assign  s_data[66] = {1'b0,w31[7:0]};
assign  s_data[67] = {1'b0,w32[7:0]};
assign  s_data[68] = {1'b0,w33[7:0]};
assign  s_data[69] = {1'b0,w34[7:0]};
assign  s_data[70] = {1'b0,w40[7:0]};
assign  s_data[71] = {1'b0,w41[7:0]};
assign  s_data[72] = {1'b0,w42[7:0]};
assign  s_data[73] = {1'b0,w43[7:0]};
assign  s_data[74] = {1'b0,w44[7:0]};

reg signed [16:0]  r_mul_result[74:0];
always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<75;i=i+1)begin
            r_mul_result[i] <= 0;
        end
    end else if(wd_valid)begin
        for(i=0;i<75;i=i+1)begin
            r_mul_result[i] <= s_data[i] * weight[i];
        end
    end else begin
        for(i=0;i<75;i=i+1)begin
            r_mul_result[i] <= 0;
        end
    end
end
//=============Accumulate============
//total 2^7 = 128 > 75 ,so total 7 times add.
reg signed [17:0]   step_0[37:0];
reg signed [18:0]   step_1[18:0];
reg signed [19:0]   step_2[9:0];
reg signed [20:0]   step_3[4:0];
reg signed [21:0]   step_4[2:0];
reg signed [22:0]   step_5[1:0];
reg signed [23:0]   conv_sum;
reg                 conv_sum_vld;
reg                 valid_d1,valid_d2,valid_d3,valid_d4,valid_d5,valid_d6,valid_d7;

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        valid_d1 <= 0;
        valid_d2 <= 0;
        valid_d3 <= 0;
        valid_d4 <= 0;
        valid_d5 <= 0;
        valid_d6 <= 0;
        valid_d7 <= 0;
        conv_sum_vld <= 0;
    end else begin
        valid_d1 <= wd_valid;
        valid_d2 <= valid_d1;
        valid_d3 <= valid_d2;
        valid_d4 <= valid_d3;
        valid_d5 <= valid_d4;
        valid_d6 <= valid_d5;
        valid_d7 <= valid_d6;
        conv_sum_vld <= valid_d7;
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<38;i=i+1)begin
            step_0[i] <= 0;
        end
    end else if(valid_d1)begin
        for(i=0;i<38;i=i+1)begin
            if(i == 37)begin
                step_0[i] <= r_mul_result[2*i];
            end else begin
                step_0[i] <= r_mul_result[2*i] + r_mul_result[2*i + 1];
            end
        end
    end else begin
        for(i=0;i<38;i=i+1)begin
            step_0[i] <= 0;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<19;i=i+1)begin
            step_1[i] <= 0;
        end
    end else if(valid_d2)begin
        for(i=0;i<19;i=i+1)begin
            step_1[i] <= step_0[2*i] + step_0[2*i + 1];
        end
    end else begin
        for(i=0;i<19;i=i+1)begin
            step_1[i] <= 0;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<10;i=i+1)begin
            step_2[i] <= 0;
        end
    end else if(valid_d3)begin
        for(i=0;i<10;i=i+1)begin
            if(i == 9)begin
                step_2[i] <= step_1[2*i];
            end else begin
                step_2[i] <= step_1[2*i] + step_1[2*i + 1];
            end
        end
    end else begin
        for(i=0;i<10;i=i+1)begin
            step_2[i] <= 0;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<5;i=i+1)begin
            step_3[i] <= 0;
        end
    end else if(valid_d4)begin
        for(i=0;i<5;i=i+1)begin
            step_3[i] <= step_2[2*i] + step_2[2*i + 1];
        end
    end else begin
        for(i=0;i<5;i=i+1)begin
            step_3[i] <= 0;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<3;i=i+1)begin
            step_4[i] <= 0;
        end
    end else if(valid_d5)begin
        for(i=0;i<3;i=i+1)begin
            if(i == 2)begin
                step_4[i] <= step_3[2*i];
            end else begin
                step_4[i] <= step_3[2*i] + step_3[2*i + 1];
            end
        end
    end else begin
        for(i=0;i<3;i=i+1)begin
            step_4[i] <= 0;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        for(i=0;i<2;i=i+1)begin
            step_5[i] <= 0;
        end
    end else if(valid_d6)begin
        for(i=0;i<2;i=i+1)begin
            if(i == 1)begin
                step_5[i] <= step_4[2*i];
            end else begin
                step_5[i] <= step_4[2*i] + step_4[2*i + 1];
            end
        end
    end else begin
        for(i=0;i<2;i=i+1)begin
            step_5[i] <= 0;
        end
    end
end

always @(posedge clk or negedge aresetn) begin
    if(~aresetn)begin
        conv_sum <= 0;
    end else if(valid_d7)begin
        conv_sum <= step_5[0] + step_5[1];
    end else begin
        conv_sum <= 0;
    end
end
该模块可以实现任意尺寸的图像输出,并通过mem文件加载权重,灵活性非常高。
仿真验证
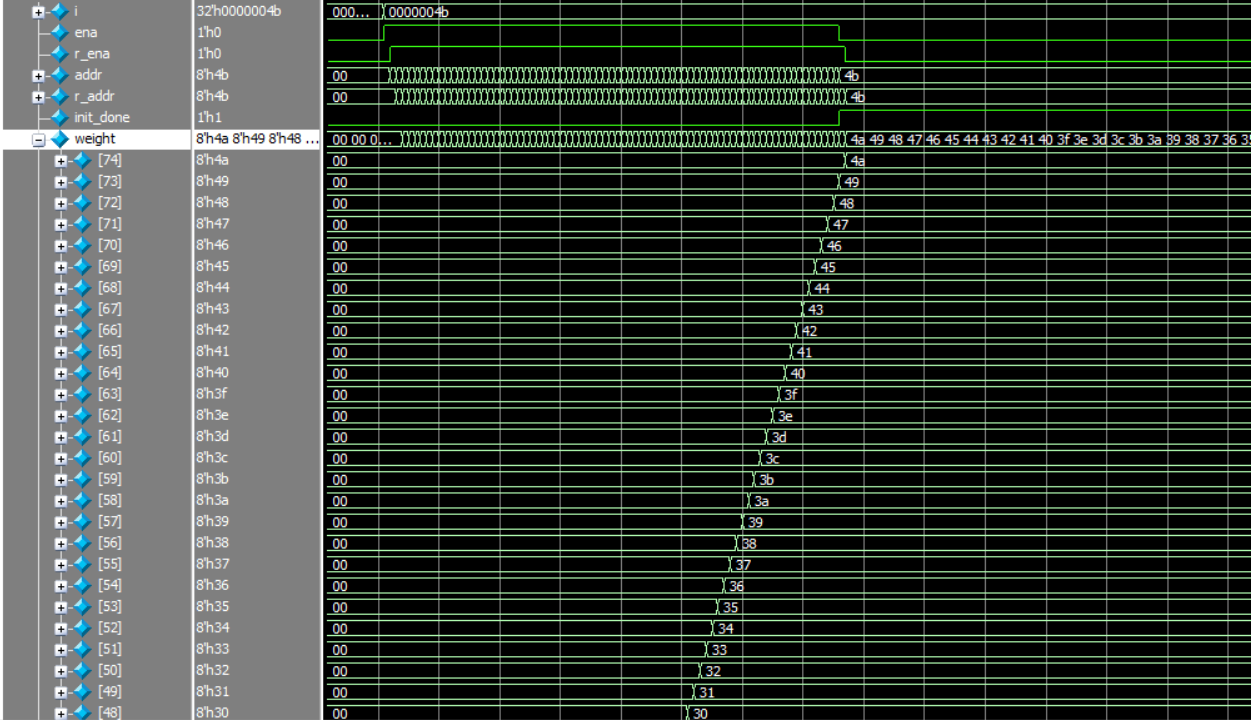
(1)加载权重
5x5x3一共是75个权重参数。验证时给的数据是有规律的,方便判断。
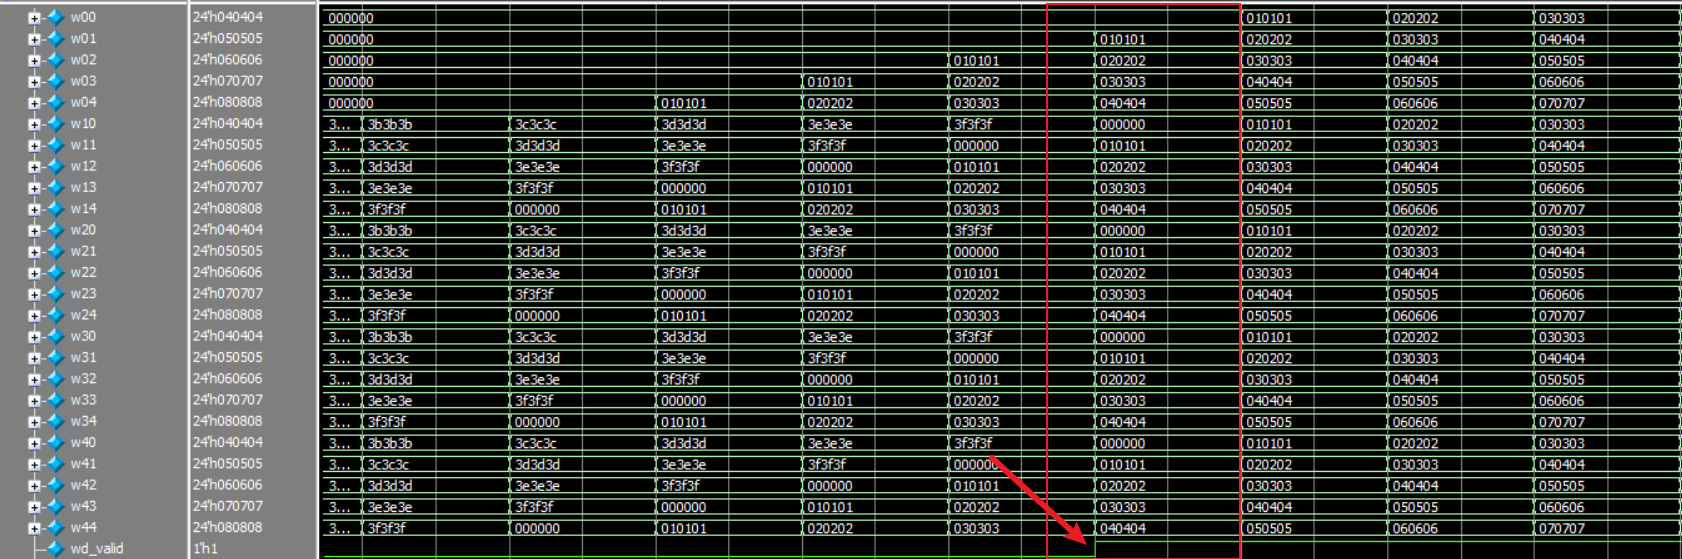
(2)5x5窗口
在window的valid信号拉高时,观察窗口的25个值,发现没问题,验证时给的数据是有规律的,方便判断。
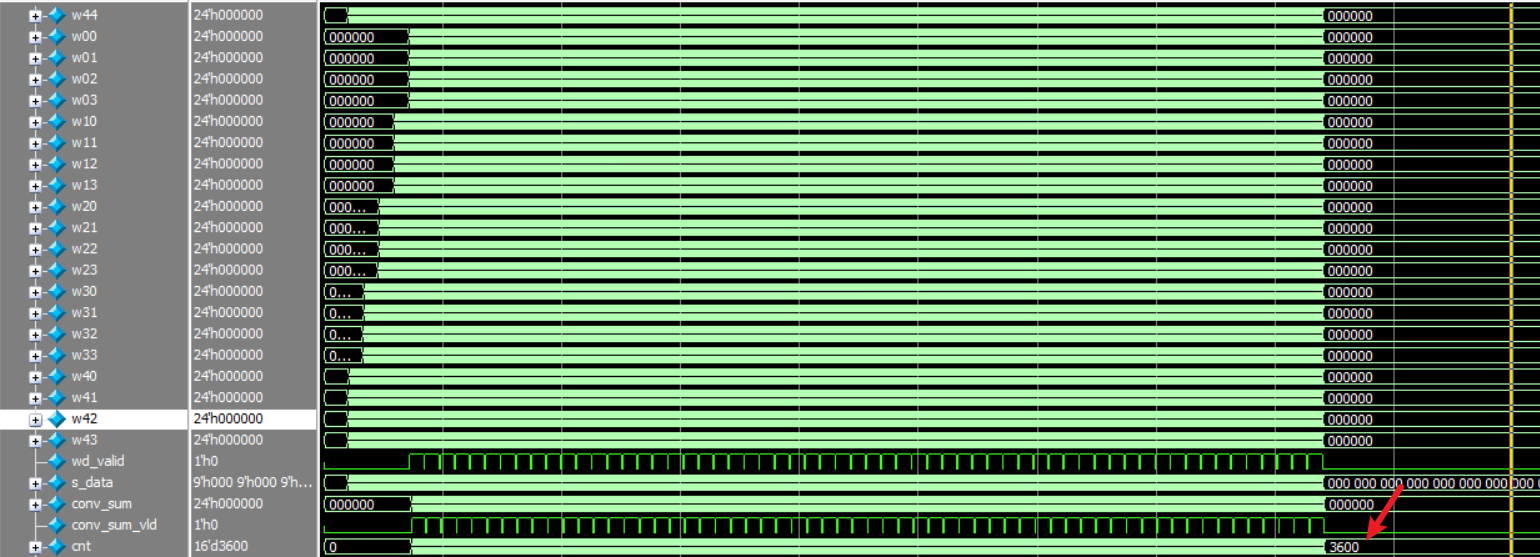
(3)乘法累加
每一个conv_sum_vld拉高时cnt加1,64x64x3经过卷积核后是60x60x1,正好是3600个值,因此这部分也正确。
(4)python与verilog结果对比
随机产生卷积核并且量化成int8类型同时给到python和rtl。
kernel_f = np.array([
    [[ 0.12, -0.35,  0.07], [ 0.21,  0.08, -0.18], [ 0.05, -0.11,  0.02], [-0.19,  0.14,  0.17], [-0.08,  0.06, -0.03]],
    [[ 0.18, -0.22,  0.09], [ 0.31,  0.05, -0.27], [ 0.03, -0.16,  0.12], [-0.25,  0.18,  0.06], [-0.07,  0.02, -0.11]],
    [[ 0.15, -0.28,  0.10], [ 0.27,  0.01, -0.21], [ 0.00,  0.00,  0.00], [-0.21,  0.16,  0.04], [-0.09, -0.01, -0.13]],
    [[ 0.11, -0.24,  0.08], [ 0.25,  0.03, -0.23], [ 0.04, -0.12,  0.08], [-0.23,  0.20,  0.02], [-0.05,  0.04, -0.08]],
    [[ 0.09, -0.19,  0.05], [ 0.17,  0.07, -0.15], [ 0.02, -0.08,  0.01], [-0.14,  0.12,  0.03], [-0.03,  0.01, -0.06]]
], dtype=np.float32)
scale = 127.0 / np.max(np.abs(kernel_f))
kernel = np.round(kernel_f * scale).astype(np.int8)

weight_flat = kernel.transpose(2, 0, 1).reshape(-1)
weight_flat = weight_flat.reshape(-1)
with open("coef.mem","w") as f:
    for w in weight_flat:
        f.write(f"{int(w) & 0xFF:02X}\n")
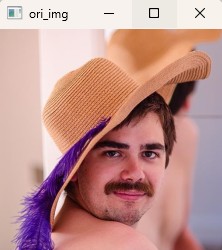
仿真的激励为224x224尺寸的lena图,case主要实现rtl对输入图片进行卷积运算,并接收结果,然后和python的golden ref作一个对比。
@cocotb.test()
async def tb_conv(dut):
    ori_img = load_img(IMG_PATH)
    gold_ref = golden_ref(ori_img,kernel)
    h, w, c = ori_img.shape
    out_buf = np.zeros((h-4, w-4), dtype=np.int32)
    #sim begin
    await init_sys(dut,10)
    await Timer(200,units="ns")
    #启动接收图像
    recv_task = cocotb.start_soon(recv_gray_task(dut, h-4, w-4, out_buf))
    await load_img_2_dut(dut,ori_img)
    await recv_task
    await Timer(20000,units="ns")
    if COMPARE_RESULT_ON:
        compare_result(gold_ref,out_buf)
    else:
        pass
golden ref 的代码如下
def golden_ref(img,kernel):
    img = img.astype(np.int32)
    H, W, C = img.shape
    out_h = H - 5 + 1
    out_w = W - 5 + 1
    output = np.zeros((out_h, out_w), dtype=np.int32)
    for y in range(out_h):
        for x in range(out_w):
            window = img[y:y+5, x:x+5, :]     # 5x5x3
            output[y, x] = np.sum(window * kernel)
    return output
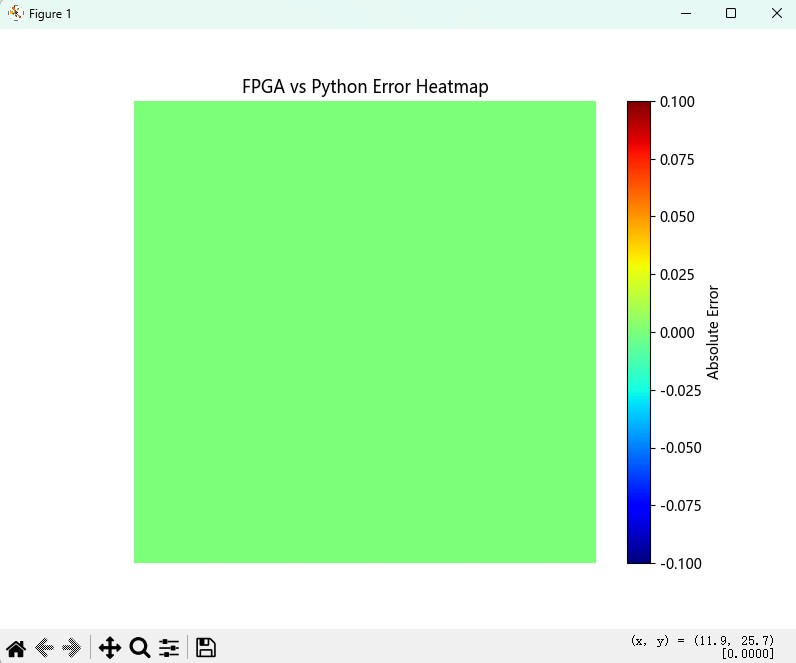
卷积结果误差对比热力图如下,可以发现,误差为0,因为权重量化过后python与rtl的行为完全一致,所以卷积结果的误差为0是正常的,结果也证明了逻辑实现的功能完全正确。
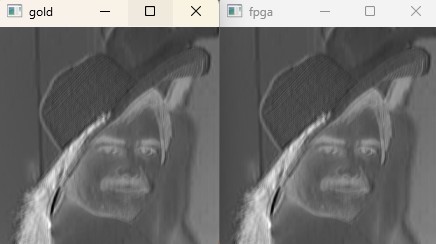
卷积后的效果图:
总结
本文实现卷积层采用 Verilog HDL 进行设计,支持任意分辨率图像的卷积运算。输入图像数据通过行缓存(Line Buffer)和移位寄存器构建 5×5 滑动窗口,卷积核权重则通过预初始化的 MEM 文件加载至 ROM 中,实现卷积参数的灵活配置与快速更新。模块内部采用并行乘法器与流水线加法树结构完成乘法累加(MAC)运算,在保证高吞吐率的同时有效提高系统时钟频率。通过修改 MEM 文件即可切换不同卷积核,因此具有良好的可扩展性、可移植性和参数化配置能力。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献1条内容

所有评论(0)