达梦慢SQL获取及执行计划查看
一、从动态视图获取慢SQL
慢SQL最简单直接的方式,是从数据库的动态性能视图中获取。
1.1 查询正在运行的慢SQL
可以从当前会话动态视图 v$sessions 中获取数据库中正在运行的慢SQL。
select sess_id, last_recv_time,
       datediff(ss, last_recv_time, sysdate) exetime,
       cast(sf_get_session_sql(sess_id) as varchar) fullsql,
       clnt_ip
from v$sessions
where state='ACTIVE'
order by exetime desc;
1.2 查询历史慢SQL
V$SQL_HISTORY 中记录数据库中的历史运行SQL,根据运行时间可以获取慢SQL语句信息(该表记录数由参数 SQL_HISTORY_CNT 指定,默认10000);使用该视图需要开启SQL监控 ENABLE_MONITOR=1(默认开启)。
--查询最近排行前十的慢SQL,按照耗时倒序排列
select top 10 t.TOP_SQL_TEXT, t.TIME_USED, t.START_TIME
from v$sql_history t
order by time_used desc;
1.3 查询超过运行时间(默认1秒)的慢SQL
DM 开启SQL监控(ENABLE_MONITOR=1、MONITOR_TIME=1,默认开启),可以通过查询动态视图 V$LONG_EXEC_SQLS 或 V$SYSTEM_LONG_EXEC_SQLS 来获取慢SQL语句。
V$LONG_EXEC_SQLS 默认显示最近1000条执行时间较长的SQL语句,V$SYSTEM_LONG_EXEC_SQLS 显示服务器启动以来执行时间最长的300条SQL语句。具体记录数由如下两个参数控制:
SQL> show parameter long_exec_sqls
行号     PARA_NAME                 PARA_VALUE
---------- ------------------------- ----------
1          LONG_EXEC_SQLS_CNT        1000
2          SYSTEM_LONG_EXEC_SQLS_CNT 20
相关参数说明如下:
| 参数名 | 缺省值 | 属性 | 说明 |
|---|---|---|---|
| ENABLE_MONITOR | 1 | 动态,系统级 | 用于打开或者关闭系统的监控功能。1:打开;0:关闭。 |
| MONITOR_TIME | 1 | 动态,系统级 | 用于打开或者关闭时间监控。该监控项的生效必须是在ENABLE_MONITOR打开的情况下。1:打开;0:关闭。 |
| SQL_HISTORY_CNT | 10000 | 动态,系统级 | 动态视图 V$SQL_HISTORY 的记录数上限,取值范围 1000~100000。 |
| LONG_EXEC_SQLS_CNT | 1000 | 动态,系统级 | 动态视图 V$LONG_EXEC_SQLS 的记录数上限,取值范围 1000~1000000。 |
| SYSTEM_LONG_EXEC_SQLS_CNT | 300 | 动态,系统级 | 动态视图 V$SYSTEM_LONG_EXEC_SQLS 的记录数上限,取值范围 10~1000。 |
V$LONG_EXEC_SQLS 和 V$SYSTEM_LONG_EXEC_SQLS 记录超过预定值时间的SQL,默认预定值时间是1000毫秒。可通过 SP_SET_LONG_TIME 修改,通过 SF_GET_LONG_TIME 查看当前值。
SQL> select SF_GET_LONG_TIME;
行号     SF_GET_LONG_TIME
---------- ----------------
1          1000

SQL> SP_SET_LONG_TIME(2000);

SQL> select SF_GET_LONG_TIME;
行号     SF_GET_LONG_TIME
---------- ----------------
1          2000
二、SQL跟踪
SQL跟踪用于记录数据库中的运行SQL日志,配合DM日志分析工具使用从中找出历史慢SQL:
(1)可以统计SQL执行次数;
(2)可以筛选跟踪历史慢SQL。
2.1 开启SQL跟踪
DM默认没有开启SQL跟踪日志,如需开启需打开 SVR_LOG 参数。
SQL> show parameter svr_log

行号       PARA_NAME       PARA_VALUE
---------- --------------- ----------
1          SVR_LOG_NAME    SLOG_ALL
2          SVR_LOG         0
3          SVR_LOG_PLN_STR 0

SQL> alter system set 'SVR_LOG'=1 both;
DMSQL 过程已成功完成

SQL> show parameter svr_log

行号       PARA_NAME       PARA_VALUE
---------- --------------- ----------
1          SVR_LOG_NAME    SLOG_ALL
2          SVR_LOG         1
3          SVR_LOG_PLN_STR 0
SQL跟踪主要相关参数说明如下:
| 参数名 | 缺省值 | 属性 | 说明 |
|---|---|---|---|
| SVR_LOG | 0 | 动态,系统级 | 是否打开SQL日志功能。0:关闭;1:打开,并按照 SQLLOG.INI 中的配置来记录SQL日志;2:打开,按文件中记录数量切换日志文件,日志记录为详细模式;3:打开,不切换日志文件,日志记录为简单模式,只记录时间和原始语句。 |
| SVR_LOG_NAME | SLOG_ALL | 动态,系统级 | SQLLOG.INI 中预设模式的名称。支持指定多个预设模式名,限制如下:1、最多指定 10 个预设模式名;2、预设模式名之间使用逗号分隔,不允许换行;3、每个预设模式名长度不能超过 128 个字节,否则该模式名无效;4、SVR_LOG_NAME 参数总长度不能超过 256 个字节,否则使用默认模式 SLOG_ALL;5、若指定的预设模式名不在 SQLLOG.INI 文件中,则该预设模式名无效。若所有预设模式名均不在文件中,则按照 SQLLOG.INI 的默认配置来记录SQL日志。例如:SVR_LOG_NAME=SLOG_ALL,SLOG_LOGIN |
| SQL_TRACE_MASK | 1 | 动态,系统级 | 指定SQL日志中需要被记录的语句类型。 |
| MIN_EXEC_TIME | 0 | 动态,系统级 | 详细模式下,记录的最小语句执行时间,单位毫秒。执行时间小于该值的语句不记录在日志文件中。取值范围 0~2147483647。 |
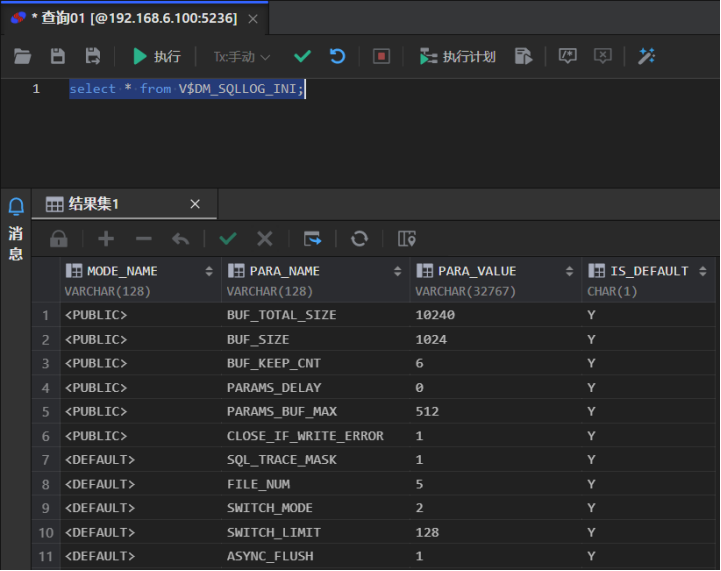
SQL跟踪相关配置由 sqllog.ini 指定,该文件位于数据库目录,内容参考如下。设置 SQL_TRACE_MASK 和 MIN_EXEC_TIME 参数可以设置跟踪条件。
[dmdba@localhost]$ pwd
/dm/dmdata/DAMENG
[dmdba@localhost]$ cat sqllog.ini
BUF_TOTAL_SIZE = 10240         #SQLs Log Buffer Total Size(K)(1024~1024000)
BUF_SIZE       = 1024          #SQLs Log Buffer Size(K)(50~409600)
BUF_KEEP_CNT   = 6             #SQLs Log buffer keeped count(1~100)

[SLOG_ALL]
FILE_PATH      = ../log
PART_STOR      = 0
SWITCH_MODE    = 2
SWITCH_LIMIT   = 128
ASYNC_FLUSH    = 1
FILE_NUM       = 5
ITEMS          = 0
SQL_TRACE_MASK = 1
MIN_EXEC_TIME  = 0
USER_MODE      = 0
USERS          =

[SLOG_ERROR]
SQL_TRACE_MASK = 23
FILE_PATH      = ../log

[SLOG_DDL]
SQL_TRACE_MASK = 3

[SLOG_LONG_SQL]
SQL_TRACE_MASK = 25
MIN_EXEC_TIME  = 1000
如果在服务器启动过程中修改了 sqllog.ini 文件,修改之后需调用过程 SP_REFRESH_SVR_LOG_CONFIG() 使其生效。V$DM_SQLLOG_INI 可以查询 sqllog.ini 文件中SQL日志配置参数。
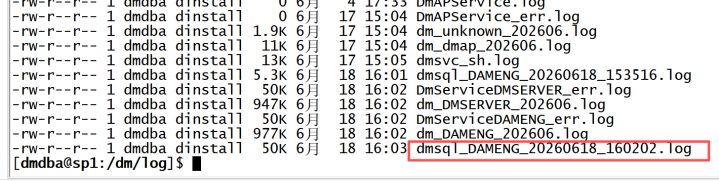
开启SQL跟踪后,会在配置的 log 目录下生成以 dmsql_实例名 开头的日志文件。
2.2 日志分析工具
DM SQL日志分析工具可实现达梦SQL日志分析功能,统计分析日志并根据执行时间和执行频次进行排序生成Excel文档。支持生成 EChart 散点图,支持生成SQL统计图,根据执行次数和执行时间统计。
Dmlog 可以在达梦论坛或联系达梦技术获取,相关目录结构如下,该工具下有详细的使用手册。注意使用该工具需连接页大小为32K的数据库。
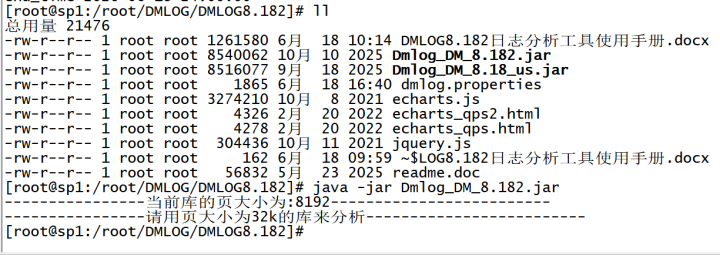
使用前需配置 dmlog.properties 文件连接数据库信息,并指定日志文件目录等;使用该工具操作如下:
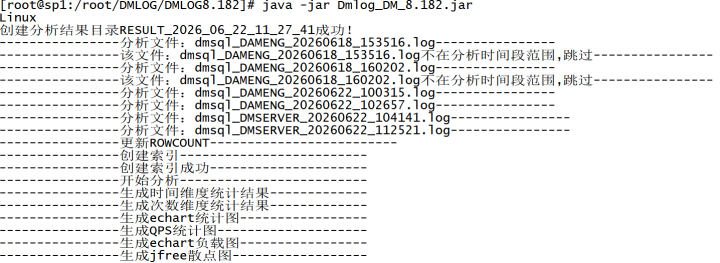
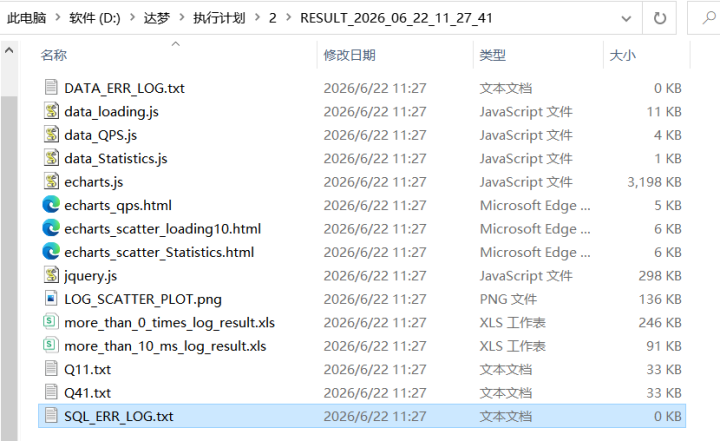
分析完成后,工具目录下会生成一个 RESULT 开头的结果目录,该目录下有根据配置的执行时间和执行次数上限值命名的 Excel 文件(.xls),报错的SQL和长度超过30000的SQL会另外生成 txt 文件,以及 EChart 散点图、QPS折线图及90%平均次数和平均耗时的SQL统计图(.html)。
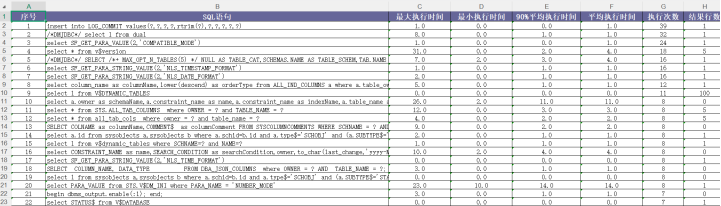
两个 Excel 分别是按照最大执行时间和执行次数进行降序排序。有了SQL就方便根据需要考虑是否需要优化。
三、 查看执行计划
3.1 先创建测试表,插入测试数据
-- 1. 创建测试表用户表 t_user
CREATE TABLE t_user (
    id INT PRIMARY KEY,          -- 用户主键
    user_name VARCHAR(50),       -- 用户名
    phone VARCHAR(20),           -- 手机号
    create_time DATETIME,        -- 创建时间
    status TINYINT               -- 状态 0禁用 1正常
);

-- 2. 创建测试表用户订单表 t_order(关联用户ID,用于联表查询)
CREATE TABLE t_order (
    order_id INT PRIMARY KEY,    -- 订单主键
    user_id INT,                 -- 关联用户ID
    order_no VARCHAR(32),        -- 订单编号
    order_amount DECIMAL(12,2),  -- 订单金额
    pay_time DATETIME,           -- 支付时间
    pay_status TINYINT           -- 支付状态 0未付 1已付 2退款
);

-- 给关联字段加索引
CREATE INDEX idx_t_order_userid ON t_order(user_id);
CREATE INDEX idx_t_user_phone ON t_user(phone);

-- 插入5000条用户数据
DECLARE
    v_id INT;
BEGIN
    FOR v_id IN 1..5000 LOOP
        INSERT INTO t_user(id,user_name,phone,create_time,status)
        VALUES(
            v_id,
            '用户'||v_id,
            '138'||LPAD(v_id,8,'0'),
            SYSDATE - INTERVAL '1' DAY * MOD(v_id,30),
            MOD(v_id,3)
        );
    END LOOP;
    COMMIT;
    PRINT 't_user 插入完成';
END;
/

-- 插入5000条订单数据,user_id随机关联用户
DECLARE
    v_oid INT;
BEGIN
    FOR v_oid IN 1..5000 LOOP
        INSERT INTO t_order(order_id,user_id,order_no,order_amount,pay_time,pay_status)
        VALUES(
            v_oid,
            MOD(v_oid,5000)+1,
            'ORD'||TO_CHAR(SYSDATE,'YYYYMMDD')||LPAD(v_oid,6,'0'),
            ROUND(DBMS_RANDOM.VALUE(10,9999),2),
            SYSDATE - INTERVAL '2' DAY * MOD(v_oid,45),
            MOD(v_oid,3)
        );
    END LOOP;
    COMMIT;
    PRINT 't_order 插入完成,共1500条';
END;
/

SELECT
    u.user_name,
    COUNT(o.order_id) AS order_cnt,
    SUM(o.order_amount) AS total_money
FROM t_user u
LEFT JOIN t_order o ON u.id = o.user_id
WHERE u.status = 1
GROUP BY u.id, u.user_name
HAVING SUM(o.order_amount) > 1000
ORDER BY total_money DESC;
3.2 查看执行计划的方式
- 方式一:通过达梦的ET工具查看。
- 方式二:使用explain命令查看。
- 方式三:使用disql的SET AUTOTRACE 查看。
3.3 ET工具查看执行计划
使用et工具需要确保两个参数开启。
SP_SET_PARA_VALUE(1,'ENABLE_MONITOR',1);
SP_SET_PARA_VALUE(1,'MONITOR_SQL_EXEC',1);
在 DM 配套管理工具或者sqlark中,执行SQL语句,获取SQL语句的执行号。
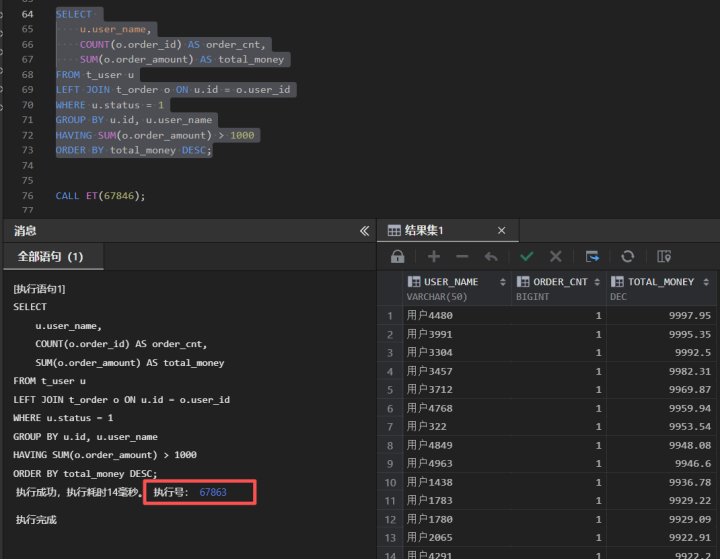
执行et,call et(执行号)
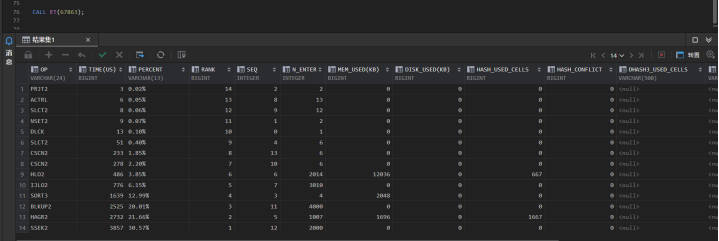
以下是et执行结果的含义:
| 字段 | 含义 |
|---|---|
| OP | 执行计划算子名称(核心,判断扫描 / 关联 / 排序 / 分组类型) |
| TIME(US) | 该算子总耗时,单位微秒,数值越大越慢 |
| PERCENT | 该算子耗时占整条 SQL 总耗时的百分比 |
| RANK | 耗时从高到低排序(RANK=1 就是最大瓶颈) |
| SEQ | 算子在执行计划中的节点编号 |
| N_ENTER | 该算子被调用 / 循环执行次数 |
| MEM_USED(KB) | 算子占用内存大小 |
| DISK_USED(KB) | 算子溢出到磁盘的数据量(>0 代表内存不足,产生磁盘 IO,性能暴跌) |
| HASH_USED_CELLS | 哈希分组 / 哈希连接使用的哈希槽数量 |
| HASH_CONFLICT | 哈希冲突次数,数值大代表哈希算法效率差 |
3.4 使用 explain 命令查看执行计划
在待查看执行计划的SQL语句前加 explain 执行SQL语句即可查看预估的执行计划:
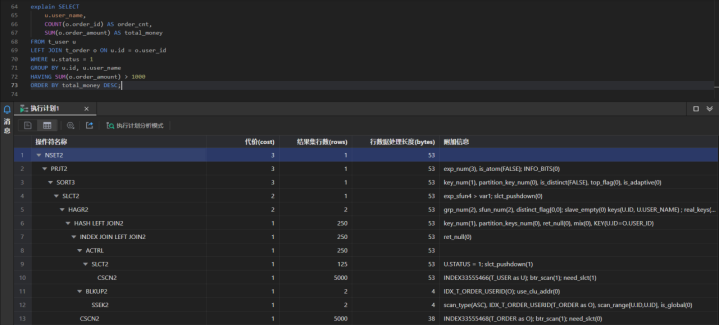
3.5 使用 disql 命令行 SET AUTOTRACE 查真实执行计划
语法:
SET AUTOTRACE <OFF(缺省值) | NL | INDEX | ON | TRACE | TRACEONLY>
各选项含义如下:
- 当
SET AUTOTRACE OFF时,停止 AUTOTRACE 功能,常规执行语句。 - 当
SET AUTOTRACE NL时,开启 AUTOTRACE 功能,不执行语句,如果执行计划中有嵌套循环操作,那么打印 NEST LOOP 相关操作符的内容。 - 当
SET AUTOTRACE INDEX(或者ON)时,开启 AUTOTRACE 功能,不执行语句,如果有表扫描,那么打印执行计划中表扫描的方式、表名和索引。 - 当
SET AUTOTRACE TRACE时,开启 AUTOTRACE 功能,执行语句,打印执行计划,并展示执行过程中的部分监控信息;需要设置 INI 中监控参数ENABLE_MONITOR、MONITOR_SQL_EXEC、ENABLE_MONITOR_DMSQL均为开启(即等于1)才有实际意义。此功能与服务器 EXPLAIN 语句的区别在于,EXPLAIN 只生成执行计划,并不会真正执行SQL语句,因此产生的执行计划有可能不准;而通过 TRACE 获得的执行计划,是服务器实际执行的计划(可能是重用了计划缓存中计划,也可能是新生成的计划)。 - 当
SET AUTOTRACE TRACEONLY时,开启 AUTOTRACE 功能,执行语句,打印执行计划,并展示执行过程中的部分监控信息;需要设置 INI 参数ENABLE_MONITOR、MONITOR_SQL_EXEC、ENABLE_MONITOR_DMSQL均为开启(即等于1)才有实际意义。使用完毕后需要关闭。此功能与 TRACE 的区别在于对于查询语句不打印结果集。
示例:
SQL> set autotrace traceonly
SQL> SELECT
  2      u.user_name,
  3      COUNT(o.order_id) AS order_cnt,
  4      SUM(o.order_amount) AS total_money
  5  FROM t_user u
  6  LEFT JOIN t_order o ON u.id = o.user_id
  7  WHERE u.status = 1
  8  GROUP BY u.id, u.user_name
  9  HAVING SUM(o.order_amount) > 1000
 10  ORDER BY total_money DESC;

1513 rows got

1   #NSET2: [3, 1->1513, 53]
2     #PRJT2: [3, 1->1513, 53]; exp_num(3), is_atom(FALSE); INFO_BITS(0)
3       #SORT3: [3, 1->1513, 53]; key_num(1), partition_key_num(0), is_distinct(FALSE), is_adaptive(0), MEM_USED(2048KB), DISK_USED(0KB)
4         #SLCT2: [2, 1->1513, 53]; exp_sfun4 > var1, slct_pushdown(0)
5           #HAGR2: [2, 2->1667, 53]; grp_num(2), sfun_num(2), MEM_USED(1696KB), DISK_USED(0KB), distinct_flag[0,0]; slave_empty(0) keys(U.ID, U.USER_NAME)
6             #HASH LEFT JOIN2: [1, 250->667, 53]; key_num(1); col_num(4); partition_keys_num(0); mix(0); MEM_USED(12036KB), DISK_USED(0KB) KEY(U.ID=O.USER_ID)
7               #INDEX JOIN LEFT JOIN2: [1, 250->1000, 53]: col_num(4) ret_null(0)
8                 #ACTRL: [1, 250->1667, 53];
9                   #SLCT2: [1, 125->1667, 53]; U.STATUS = 1, slct_pushdown(1)
10                    #CSCN2: [1, 5000->5000, 53]; INDEX33555466(T_USER); btr_scan(1); need_slct(1)
11                #BLKUP2: [1, 2->1000, 4]; IDX_T_ORDER_USERID(T_ORDER); use_clu_addr(0)
12                  #SSEK2: [1, 2->1000, 4]; scan_type(ASC), IDX_T_ORDER_USERID(T_ORDER), is_global(0), scan_range[U.ID,U.ID]
13              #CSCN2: [1, 5000->5000, 38]; INDEX33555468(T_ORDER); btr_scan(1); need_slct(0)

Statistics
-----------------------------------------------------------------
        0                           data pages changed
        0                           undo pages changed
        4042                        logical reads
        0                           physical reads
        0                           redo size
        72574                       bytes sent to client
        389                         bytes received from client
        2                           roundtrips to/from client
        1                           sorts (memory)
        0                           sorts (disk)
        0                           rows processed
        0.000                       io wait time(ms)
        22.337                      exec time(ms)

已用时间: 22.977(毫秒). 执行号:65308.

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)