NeurIPS 2025 | TimeXL:融合 LLM-in-the-Loop 的可解释多模态时序预测框架!
由于微信推送机制改版,是不是经常看不到论文推送啦?
如果你也在做交通+机器学习相关研究,别再让优质论文分享从指尖溜走了。
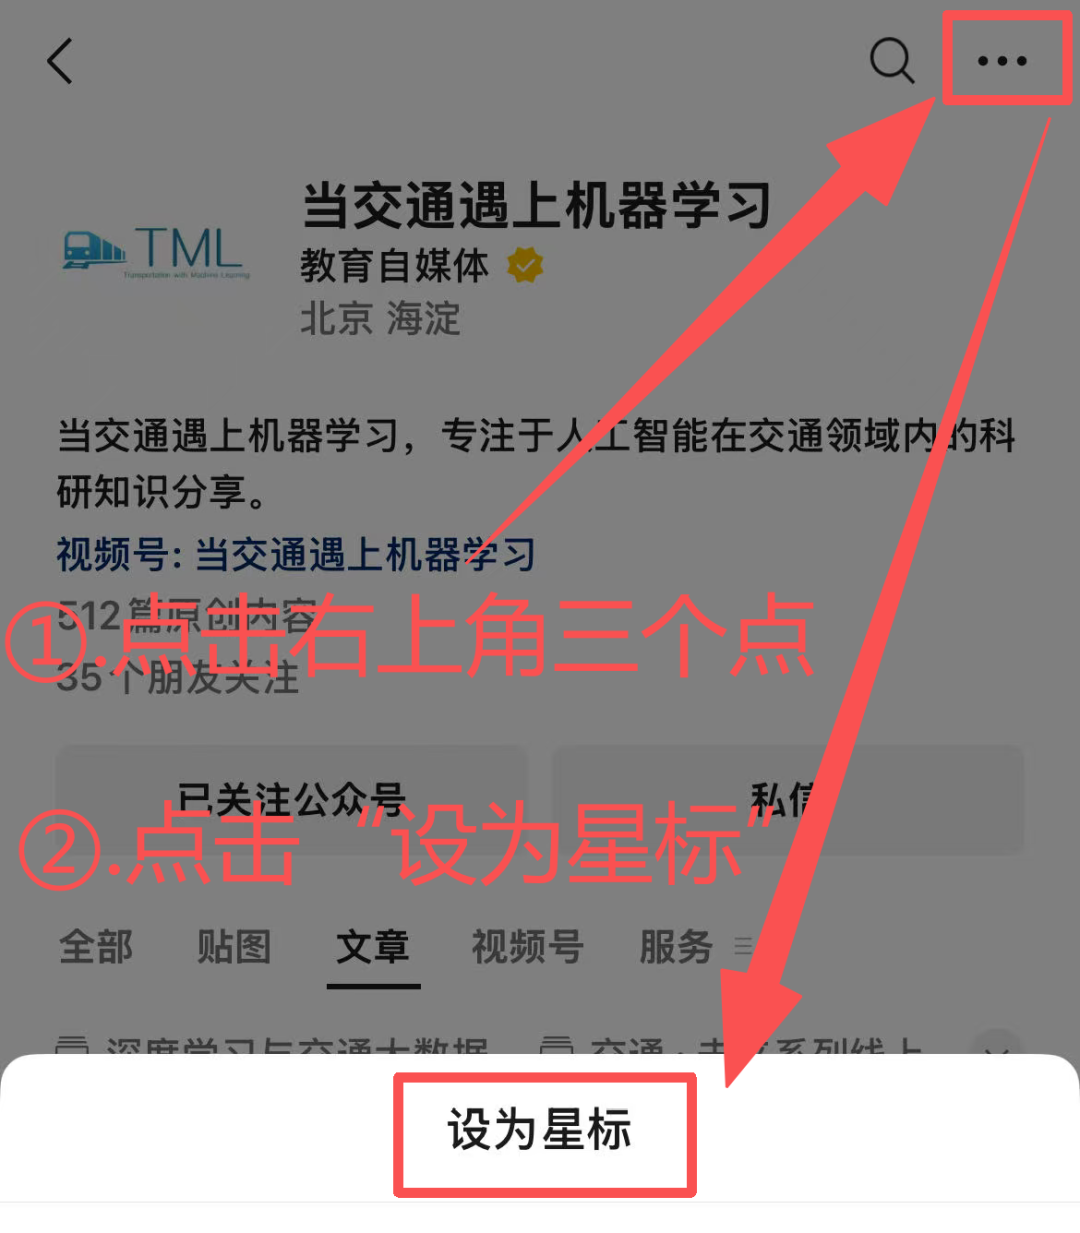
👉给「交通遇上机器学习」点个⭐️星标
第一时间获取最新论文解读、前沿方向,不再错过任何一次灵感碰撞。
把时间留给真正有价值的内容,我们帮你筛选好。
文章信息
论文标题:TimeXL: Explainable Multi-modal Time Series Prediction with LLM-in-the-Loop
作者:Yushan Jiang, Wenchao Yu, Geon Lee, Dongjin Song, Kijung Shin, Wei Cheng, Yanchi Liu, Haifeng Chen
所属机构:University of Connecticut, NEC Labs America, KAIST
会议/期刊:39th Conference on Neural Information Processing Systems (NeurIPS 2025)
发布时间:2025 年 10 月 25 日
摘要
时间序列分析为理解真实世界系统的动态演化提供了关键洞察,并为下游决策制定提供依据;然而,大多数现有方法往往忽略了辅助模态中蕴含的丰富上下文信号。为弥合这一差距,这篇文章提出了TimeXL一个多模态预测框架,该框架将基于原型的时间序列编码器与三个协同工作的大语言模型(LLMs) 相结合,以实现更精准的预测结果与可解释的解释输出。具体而言:首先,一个多模态原型编码器同步处理时间序列与文本输入,生成初步预测结果及基于案例的推理依据;随后,这些输出被送入预测大语言模型,该模型通过对编码器输出的预测与解释进行逻辑推理,进一步优化预测精度;接着,反思大语言模型将预测值与真实标签进行比对,识别文本解释中的不一致性或噪声;在该反馈的指导下,优化大语言模型迭代式地提升文本质量,并触发编码器的重新训练。这一"预测→批判(反思)→优化"的闭环工作流程,持续提升了框架的整体性能与可解释性。在四个真实世界数据集上的实证评估表明:TimeXL实现了最高8.9%的AUC提升,并能生成以人为中心、融合多模态信息的解释内容,充分彰显了大语言模型驱动的逻辑推理在时间序列预测任务中的强大潜力。
研究动机
• 尽管已经有大量的方法利用辅助数据(文本+时间序列)来提升预测准确性,但它们往往缺乏显式机制,无法系统地推理和解释上下文信号为何及如何影响结果。这种可解释性方面的缺失,为金融和医疗等高风险应用场景带来了显著障碍,并且在这些场景中,预测结果的可信性与透明度至关重要。
• 大语言模型凭借其跨领域处理与推理文本数据的卓越能力而备受瞩目,能够在零样本与少样本设定下胜任情感分析、问答及内容生成等任务。近期智能体架构的进一步发展,更增强了LLMs的能力,使其能够在富含上下文的场景中实现结构化推理与迭代式决策。其内嵌的领域知识,使LLMs天然适合支撑真实世界的多模态时间序列分析,在此类任务中,文本上下文(例如新闻报道或专家备注)往往发挥着关键作用。
研究贡献
• 提出了一种基于多模态原型的编码器,该编码器融合时间序列数据与文本上下文,生成透明且基于案例的推理依据。
• 利用大语言模型的解释能力,对多模态原型的编码器的输出进行逻辑推理,并迭代优化预测结果与文本内容,从而显著提升预测精度与解释质量。
• 在四个真实世界基准数据集上的实验表明,TimeXL 持续优于基线方法,AUC 指标最高提升 8.9%,同时提供忠实、以人为本的多模态解释。总体而言,TimeXL 通过将基于原型的推理与LLM驱动的推理相结合,为可解释的多模态时间序列分析开辟了新途径。
重要概念
原型学习
一种机器学习方法,它的核心思想是通过存储一组代表性的样本(原型),然后使用这些原型来进行分类、回归或聚类等任务。这种方法模拟了人类学习的方式,人们往往通过记住一些典型的例子来理解和泛化到新的情况。原型学习的主要优势在于它能够有效地处理复杂的数据分布,特别是当数据类别之间存在重叠或不均衡时。
原型
在原型学习中,原型通常是从训练数据中选择的一组代表性样本,每个原型代表一个类别或簇。原型可以是数据点的中心(如均值向量)或者是具有代表性的样本点。
研究方法
TimeXL框架
TimeXL整体由一个多模态原型编码器与三个协同工作LLM构成。
• 多模态原型编码器并行处理时间序列与文本,输出初步预测及基于原型的可解释依据;
• 预测LLM基于这些解释进行语义推理优化预测;反思LLM与精炼LLM则在训练阶段形成“预测-反思-精炼”闭环,迭代提升文本质量与多模态原型编码器性能。最终的预测结果由多模态原型编码器与预测LLM的结果加权融合得到。
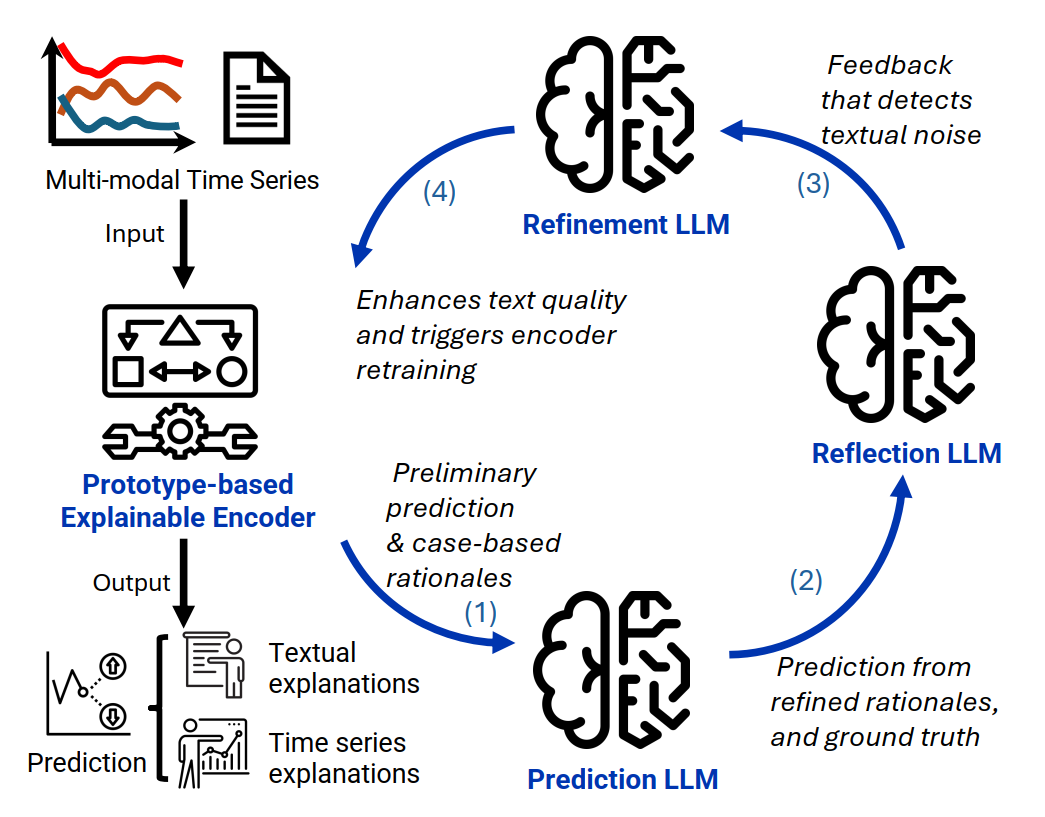
首先,基于原型的可解释编码器并行处理时间序列与文本,输出初步预测及基于案例的可解释依据;随后,预测LLM依据这些解释优化预测结果(步骤1);反思LLM将预测与真实标签对比分析,识别文本中的噪声或不一致(步骤2-3);精炼LLM据此迭代更新描述时间序列的文本质量,并触发编码器重训练(步骤4)。最终,编码器与预测LLM的输出经加权融合,进一步提升整体准确性。整个流程形成'预测-反思-精炼'的闭环迭代机制。
问题表述
问题可以表述为一个多模态时间序列预测问题。每个实例由多模态输入 表示,其中 表示包含 个变量和 个历史时间步的时间序列数据, 表示描述现实世界上下文的对应文本数据。文本数据 可进一步划分为 个有意义的片段。基于历史时间序列和文本上下文,目标是预测未来结果 ,它可以是分类任务中的离散值,也可以是回归任务中的连续值。
基于多模态原型的编码器
这项研究设计了一种基于多模态原型的编码器,能够以端到端的方式在不同模态之间生成预测和解释,如图 2 所示。
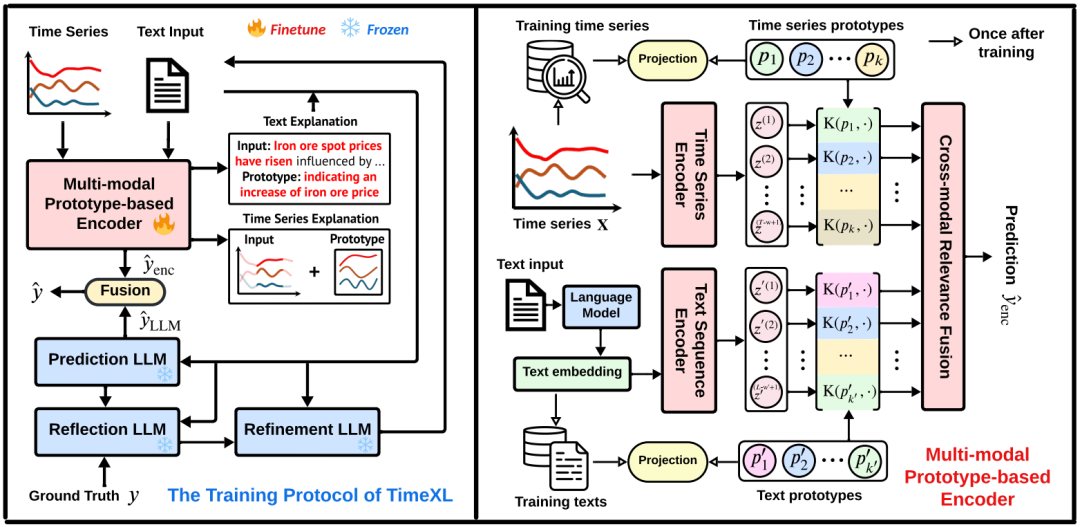
① 双模态(文本+时间序列)片段特征提取:分别采用两个独立的编码器处理时间序列(基于 CNN)和文本(基于冻结的 PLM ,如 BERT)。
② 原型学习与匹配:为训练数据集中的每个类别
学习一组时间序列原型和文本原型,计算输入片段与原型之间的相似度
相似度越高表示该片段越能代表该原型的特征。
最后,将两种模态的相似度分数拼接,通过一个可学习的权重矩阵
融合。最终输出类别预测概率
损失函数
(1)聚类损失
:让每个学习片段表示靠近其最近的原型,形成清晰的聚类结构。
(2)证据损失
:让每个原型靠近某个具体的片段表示,确保每个原型有实际的数据支撑。
(3)多样性损失
:惩罚原型之间的相似性,避免冗余,保持解释空间的紧凑性。
(4)交叉熵损失:标准的分类任务损失函数
原型投影与解释生成
在最小化损失函数之后,所学习到的多模态原型得到了良好的正则化处理,并且具有良好的解释性特征。然而,这些原型仍然难以直接解释,因为它们只是在表示空间中接近某些示例片段。因此,需要对原型进行投影处理,将每个原型与来自其所属类别的训练片段相关联,赋予其实际意义。
通过将每个原型与表示空间中的一个训练片段关联起来,进而能够得到其多模态的物理意义。在测试阶段,一个多模态实例将与不同模态下的原型进行比较,以推断预测结果,其中相似度得分、贡献权重以及原型的类别信息共同构成了推理的解释。
利用LLM闭环交互的可解性的预测
为了在实际的时间序列情境中进一步发挥大型语言模型的推理和推断能力,本文提出了一个由三个相互作用的大型语言模型代理组成的框架:预测LLM、反思LLM和精炼LLM。这些大型语言模型代理与基于多模态原型的编码器进行交互,以实现更高的预测准确性和更好的可解释性。
基于丰富语境的预测。预测LLM根据输入文本生成预测结果。为了提高预测的准确性,编码器会选择与输入文本中任何文本片段的相关性最高的 ω 个原型。相关性是通过下面这个公式中使用的相似度得分来确定的。
这些选定的原型随后被添加到预测LLM的输入提示词中作为解释,从而提供了更丰富的现实世界背景。构建输入文本的解释的 ω 个原型-片段对是根据下面这个公式获取的:
最后, 基于多模态编码器和预测 LLM的线性组合来生成最终预测。
其中
是从验证数据中选择的超参数。多模态编码器和预测LLM基于各自的独特优势相互补充。编码器是基于明确的监督信号进行微调的,以确保在捕捉多模态时间序列的时序和上下文依赖性方面具有准确性。另一方面,预测LLM从广泛的文本语料库中汲取深度语义理解。通过将来自两个不同视角的预测结果相结合,能够实现了协同增强的效果,从而能够对复杂的多模态时间序列做出更准确的预测。
通过反思性反馈实现迭代优化
虽然预测 LLM 利用可解释的成果来进行有依据的预测,但它本身并非为适应多模态时间序列数据的环境而设计的,这可能会导致在文本上下文质量不佳的情况下产生不准确的预测。为了解决这个问题,这篇文章利用反思 LLM 和精炼 LLM 分别为上下文生成反思性的反馈和改进意见,以获得更好的预测。其中,每个LLM的具体输入与迭代中的作用如下:
1. 预测LLM (Prediction LLM):
• 输入:当前文本、编码器检索到与当前样本的最相关的 个原型 - 片段对作为解释。
• 作用:利用 LLM 的语义理解能力,基于提供的案例理由生成新的预测 。
2. 反思LLM (Reflection LLM):
• 输入:预测LLM的预测结果 、真实值 、输入文本 。
• 作用:分析预测逻辑,与真实值对比并生成反思反馈。
3. 精炼LLM (Refinement LLM):
• 输入:反思 LLM 输出的反思反馈以及当前文本 。
• 作用:根据反馈更新文本描述内容(强调相关模式,去除噪声),生成改进后的文本 。
训练与优化流程
给定由预测 LLM 生成的预测,反思 LLM 旨在理解预测 LLM 隐式预测逻辑背后的推理。具体而言,它通过分析输入文本及其预测结果,并与真实值进行对比,生成反思反馈,以提供可操作的改进见解。在该反馈的指导下,精炼 LLM 通过选择并强调最相关的内容,将先前的文本进行优化,确保重要模式被适当地置于上下文中。
迭代算法伪代码
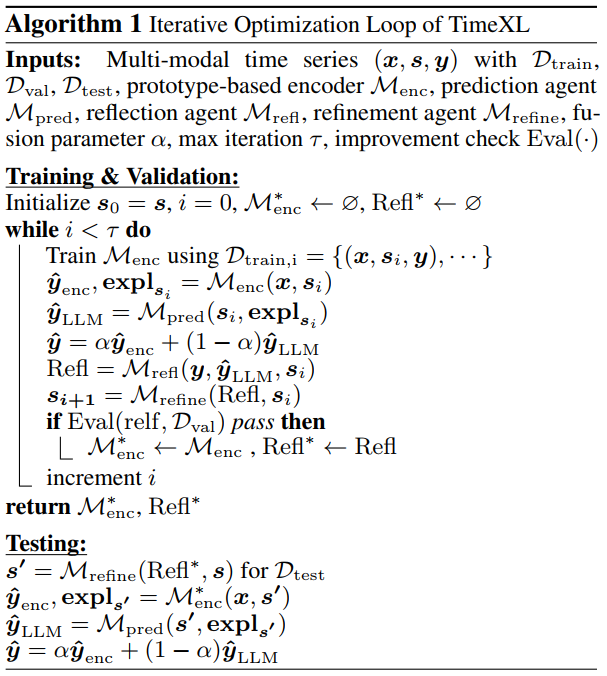
迭代优化流程 (Algorithm 1):
1. 使用当前文本训练编码器。
2. 生成预测和解释。
3. LLM 进行预测、反思和文本精炼。
4. 如果在验证集上性能提升,则保存模型和反思反馈,进入下一轮迭代(直到达到最大迭代次数)。测试阶段:使用验证阶段最佳迭代产生的反思LLM 来指导测试集文本的优化,再进行预测。
结果评估
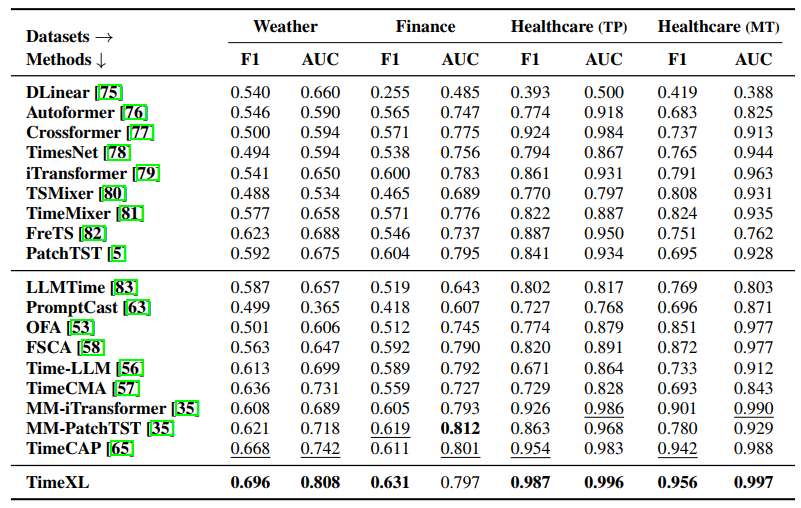
针对来自三个不同现实领域(包括天气、金融和医疗保健)的四个多模态时间序列数据集对方法进行了评估。在所有数据集上,多模态方法一致地优于时间序列方法。这些方法包括利用文本嵌入来增强时间序列预测的 LLM 方法(例如 Time-LLM、TimeCMA、FSCA)。此外,多模态变体(MM-iTransformer 和 MM-PatchTST)提高了最先进的时间序列方法的性能,表明整合真实世界的情境信息具有优势。此外,TimeCAP将两种模态的预测结果进行整合,进一步提高了预测性能。TimeXL 一致地取得最高的 F1 和 AUC 分数,与时间序列和多模态基准相比,AUC 的提升幅度高达 8.9%(在天气数据集上与 TimeCAP 相比)。这突显了 TimeXL 的优势,它将多模态编码器与语言代理相结合,以增强可解释性,从而在多模态时间序列中提高预测性能。
表1:算法性能对比
文章展示由 TimeXL 生成的可解释的多模态原型,这些原型构建了基于案例的推理过程。图3展示了在天气数据集上学习到的一组时间序列和文本原型。时间序列原型展示了与不同实际天气状况(即有雨和无雨)相对应的典型时间模式。例如,适度水平的恒定或降低的湿度,结合高且稳定的气压,通常表明无雨的场景。持续的风向也是温和天气状况的一个标志。相反,高湿度、低且波动的压力以及多变的风通常预示着即将到来的不稳定天气系统。除了时间序列之外,文本原型还突出了针对不同天气状况的一致语义模式,例如特定区域的特定描述(例如,干燥的空气进入该区域、高压系统的增强)以及整体描述(例如,干燥天气的可能性)。TimeXL 通过利用时间序列及其实际应用场景,提供了连贯且信息丰富的原型,这有助于进行预测和解释。
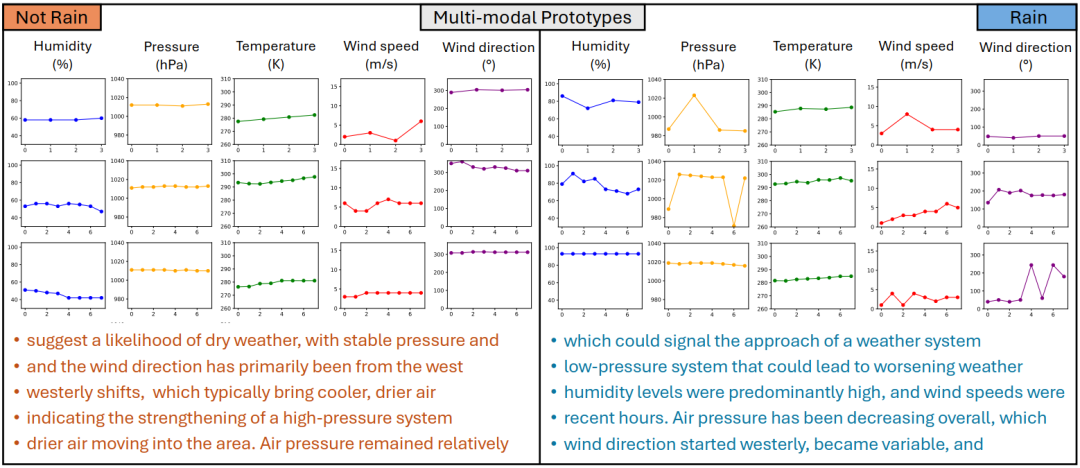
图 3:基于“天气”数据集学习得到的关键时间序列原型和文本原型。图中的每一行代表一个具有不同通道的时间序列原型。 基于这些多模态原型,这项工作针对天气数据的测试集进行了一个案例研究,将原始推理过程与 TimeXL 的推理过程进行了对比,以突出其解释能力,如图 4 所示。在这个案例中,原始文本被错误地预测为没有降雨。有三个关键观察结果:(1)精炼过程会过滤原始文本,以更突出表明降雨可能性的天气条件,这是基于训练示例的反馈进行的引导。精炼后的文本保留了关于稳定性的陈述,同时更强调湿度和风作为关键指标。(2)因此,原始文本中的匹配段原型对重点更集中在温度稳定性和典型的日变化上,而精炼文本中的匹配对则更突出风的变化性、水分传输和即将到来的天气系统,这更符合降雨条件。(3)此外,时间序列推理为评估天气状况提供了一种互补的视角。匹配的时序原型能够识别出高湿度及其升降趋势、风速的波动和方向变化,以及气压波动的下降阶段。
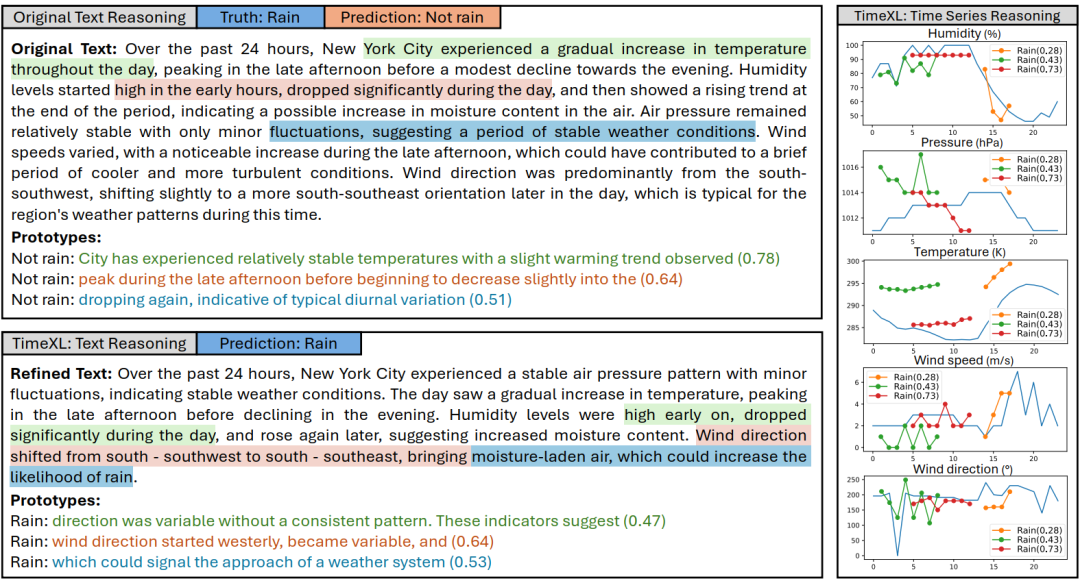
图 4:基于多模态案例推理的示例,针对“天气”数据集。左侧部分展示了 TimeXL 中原始文本和精炼文本的推理过程,其中匹配的原型 - 输入对以相同颜色突出显示,并附有其相似度分数。右侧部分呈现了 TimeXL 中的时间序列推理过程,其中匹配的原型被叠加在时间序列之上 期待你的
分享
点赞
在看
END
欢迎关注微信公众号《当交通遇上机器学习》!如果你和我一样是轨道交通、道路交通、城市规划相关领域的,也可以加微信:Dr_JinleiZhang,备注“进群”,加入交通大数据交流群!希望我们共同进步!
· 往期推荐
TR-C 2026|北交大 TransFM:统一建模多模态交通,实现跨城市泛化
TR-C 2026 | 同济:GATSim,基于生成式智能体的城市交通仿真框架
TR-B | 中南-北航团队:连续通勤走廊早高峰均衡,终于完整破解!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 13
 0
- 0


 已为社区贡献14条内容

所有评论(0)