python编程语法基础笔记(4.9)(数据结构与算法)
一、算法基础
1. 算法的定义与独立性
算法是为满足业务需求、实现业务目的的解决问题的方法和思路,具有语言独立性 —— 核心是思想,可通过 Python、Java、C 等不同语言实现。
2. 穷举法(暴力枚举)
穷举法是对问题的所有可能情况逐一检验,核心是 “不遗漏”。(1000 以内满足 i+j+k=1000 且 i²+j²=k² 的整数解)为例:
原始版本:三层循环遍历 i、j、k,时间复杂度 O (n³),效率极低;
优化版本:去掉第三重循环,通过 k=1000-i-j 直接计算 k,缩小 j 的遍历范围(保证 k>0),时间复杂度降至 O (n²),大幅提升效率。
for i in range(1001):
    for j in range(1001):
        for k in range(1001):
            if i + j + k == 1000 and i **2 + j**2 == k**2:
                print(i, j, k)

# 优化版:去掉第三重循环,直接计算k=1000-i-j
for i in range(1, 1001):
    for j in range(1, 1001 - i):  # j范围缩小,保证k>0
        k = 1000 - i - j
        if k > 0 and i**2 + j**2 == k**2:
            print(i, j, k,sep='-')
3. 算法的五大特性
| 特性 | 说明 |
|---|---|
| 有输入 | 算法可包含 0 个或多个输入(如无参数函数的算法无输入) |
| 有输出 | 算法至少有 1 个输出(无输出的算法无实际意义) |
| 有穷性 | 算法在有限步骤后自动结束,不会无限循环 |
| 确定性 | 每一步操作含义明确,无歧义 |
| 可行性 | 每一步都能通过有限次执行完成(如不能要求 “执行无限次循环后输出结果”) |
4. 算法效率衡量
(1)时间复杂度
核心逻辑:衡量算法随问题规模 n 变化的时间量级,而非实际运行时间(受硬件 / 环境影响),用大 O 记法表示;
计算规则:
基本操作(如变量赋值、单次判断):O (1);
顺序结构:按加法计算(如先执行 O (n) 再执行 O (1),总复杂度 O (n));
循环结构:按乘法计算(如双层循环 O (n)×O (n)=O (n²));
分支结构:取分支中复杂度最大值(如 if 分支 O (n)、else 分支 O (1),总复杂度 O (n));
忽略次要项:只关注最高次项,忽略常数、低次项(如 T (n)=10n³+5n+2 → O (n³));
默认最坏情况:无特殊说明时,时间复杂度指最坏时间复杂度。
常见时间复杂度(效率从高到低):
O (1) < O (logn) < O (n) < O (nlogn) < O (n²) < O (n³) < O (2ⁿ) < O (n!)
常数阶 O (1):无循环 / 递归,操作数固定;
对数阶 O (logn):典型场景为二分法(如 while 循环中 i=i×2,循环次数 k 满足 2ᵏ≤n → k=log₂n);
线性阶 O (n):单层循环遍历 n 个元素;
线性对数阶 O (nlogn):单层循环 + 内层二分操作(如归并排序);
平方阶 O (n²):双层嵌套循环;立方阶 O (n³):三层嵌套循环;
指数阶 O (2ⁿ)、阶乘阶 O (n!):效率极低,仅适用于极小 n。
(2)空间复杂度
核心逻辑:衡量算法运行过程中临时占用的存储空间大小,同样用大 O 记法;
# 空间复杂度O(1):仅占用固定变量空间,循环未新增大规模存储
a = 10
for i in range(1, 1001):
    a = i

# 空间复杂度O(n²):双层循环生成n×n的二维列表,存储规模随n²增长
l1 = []
for i in range(1, n):
    l2 = []
    for j in range(1, n):
        l2.append(j)
    l1.append(l2)
二、数据结构基础
1. 数据结构的核心定义
数据结构是存储、组织数据的方式,相同数据采用不同数据结构,运行 / 存储效率差异显著:
数据结构:静态描述元素间的关系(“怎么存”);
算法:为解决问题设计的思路(“怎么用”);
核心关系:数据结构 + 算法 = 程序(高效程序需结合合适的算法与数据结构)。
2. 数据结构的分类
(1)线性结构
特点:非空集;每个节点最多 1 个前驱、1 个后继。
逻辑结构(使用方式):栈、队列;
物理结构(存储方式):顺序表、链表。
(2)非线性结构
特点:非空集;节点可拥有多个前驱 / 后继。
典型类型:树结构、图结构。
3. 顺序表(重点)
(1)核心定义
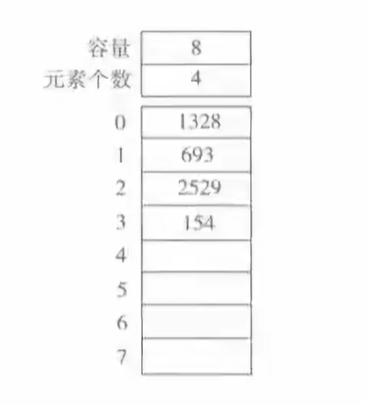
将元素顺序存放于连续的存储区域,元素关系由存储顺序表示,完整结构分为两部分:
表头信息区:存储元素存储区容量、已存元素个数;
数据区:存储真实数据或数据的内存地址(指针)。
(2)关键特性
| 维度 | 说明 |
|---|---|
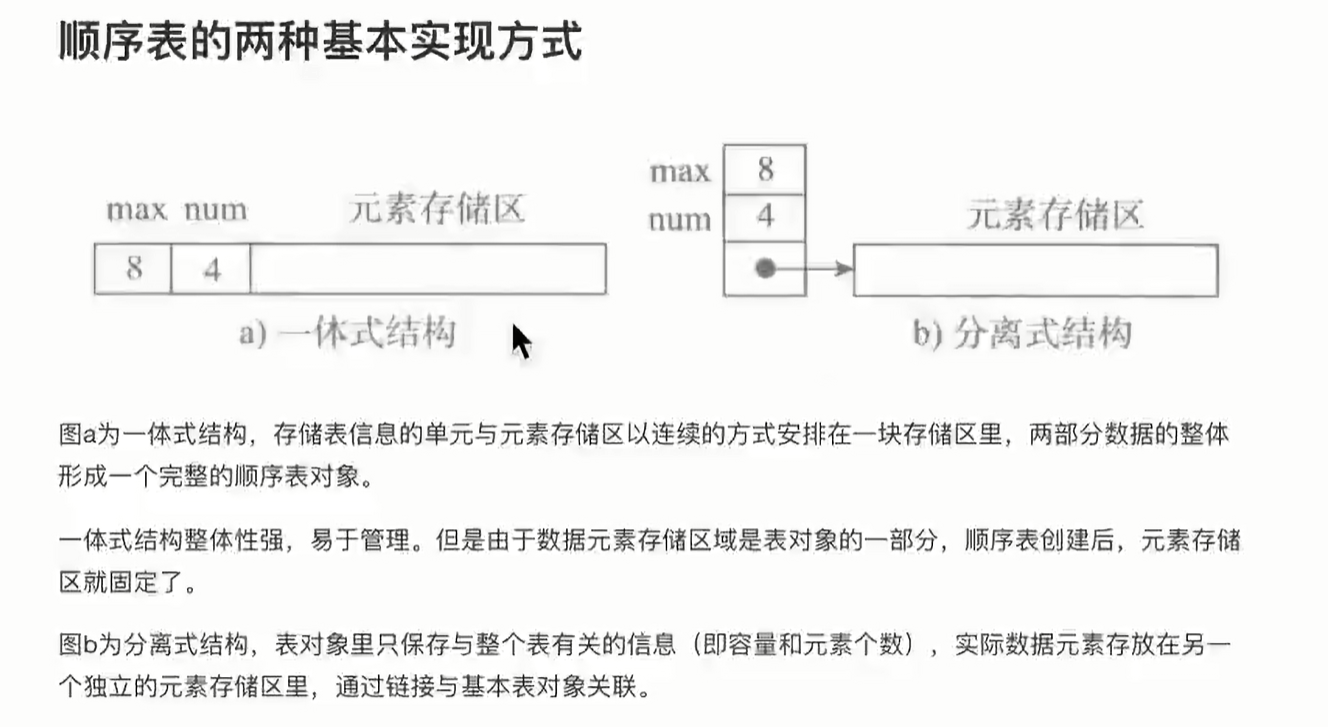
| 存储方式 | 分为一体式(表头 + 数据存同一块连续内存)、分离式(表头 + 数据分两块内存,用指针连接);Python 无一体式存储,列表均为 “分离式 + 存地址” |
| 数据区内容 | 存真实数据 / 地址,由语言设计 + 数据类型决定(C 静态数组:一体式 + 存数据;Python 列表:分离式 + 存地址) |
| 访问效率 | 通过下标偏移直接定位数据地址,时间复杂度 O (1)(无需遍历) |
| 扩充方式 | ① 线性增长:每次增加固定容量(省空间,但扩充操作频繁);② 翻倍扩充:每次容量翻倍(减少扩充次数,以空间换时间) |
(2)实现方式
4. 链表(实现存储方式在下节)
将元素存放于非连续的存储块中,通过链结构连接存储块,与顺序表的核心区别是存储区域不连续。
5. 内存存储基础
内存最小单位:位(bit,0/1);基本存储单位:字节(Byte),1Byte=8bit;
地址规则:每个字节有唯一内存地址;多字节类型(int 占 4 字节、float 占 8 字节)占用连续地址,“变量地址” 指首地址;
示例:整数 1(int 类型)占 4 字节,存储在 4 个连续地址中,变量地址仅指向第一个字节的地址。
三、核心对比与总结
| 概念 | 核心要点 |
|---|---|
| 算法效率 | 优先看时间复杂度(最高次项),其次看空间复杂度,需在时间 / 空间间做权衡 |
| 顺序表 vs 链表 | 顺序表:连续存储、下标访问 O (1)、扩充需重新分配内存;链表:非连续存储、访问需遍历、扩充灵活 |
| Python 列表 | 本质是 “分离式顺序表”:id (list) 指向表头,表头通过指针连接数据区,数据区存元素的内存地址 |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)