数据结构拟面试题
1.快排算法
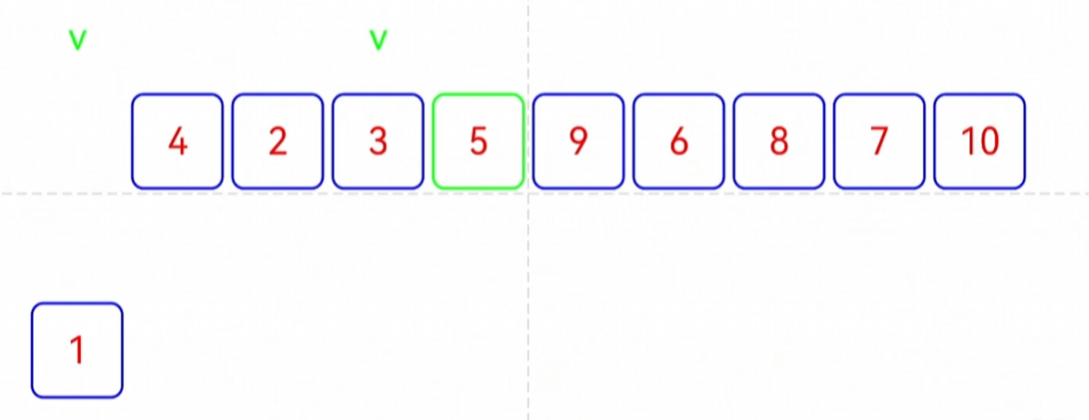
void QuickSort(int *arr, int low, int high)
{
    if (low >= high)
    {
        return;
    }
    int first = low;
    int last = high;
    int key = arr[first];
    while (first < last)
    {
        while (first < last && arr[last] > key)
        {
            --last;
        }
        arr[first] = arr[last];
        while (first < last && arr[first] < key)
        {
            ++first;
        }
        arr[last] = arr[first];
        arr[first] = key;
    }
QuickSort(arr, low, first - 1);
QuickSort(arr, first + 1, high);
}
1. 时间复杂度
最好情况:O(n log n)
每次都能把数组均匀分成两半(基准值选得好)
最坏情况:O(n²)
数组已经有序 / 逆序,基准值选到最大或最小
平均情况:O(n log n)
2. 空间复杂度
O(log n)
主要是递归调用栈的开销
3. 稳定性
不稳定排序
2.链表反转(原地反转)
// 链表节点定义
struct ListNode {
    int val;
    struct ListNode *next;
};

// 核心函数:三指针反转链表
struct ListNode* reverseList(struct ListNode* head) {
    struct ListNode *prev = NULL, *curr = head, *next = NULL;
    while (curr != NULL) {
        next = curr->next;  // 暂存后继节点
        curr->next = prev;  // 反转当前节点的指向
        prev = curr;        // prev后移
        curr = next;        // curr后移
    }
    return prev;  // prev是新的头节点
}
可以把curr->next抽象的看成一根有指向的线,也就是指针
//逆序
/*
从第二个节点开始打断成两个链表
遍历第二个链表,依次取出节点,头插到第一个链表中
*/
void ReverseLinkList(node *head)
{
    if (head == NULL || head->next == NULL) {
        return ;
    }

    //打断成两个链表
    node *tmp = head->next->next;  //保存第二个链表头的位置
    head->next->next = NULL;

    node *p = NULL;
    //遍历第二个链表
    while (tmp != NULL) {
        p = tmp;  //保存要头插的节点
        tmp = tmp->next;  //tmp遍历

        //头插
        p->next = head->next;
        head->next = p;
    }
}
2.判断链表是否成环
//判断链表是否成环 快慢指针
int IsLoop(node *head)
{
    if (head == NULL || head->next == NULL) {
        return 0;
    }

    node *quick = head;
    node *slow = head;

    while (quick != NULL && quick->next != NULL) {
        slow = slow->next;
        quick = quick->next->next;
        if (slow == quick) {
            return 1;
        }
    }
    return 0;
}
3.数组与链表的区别是什么?各有什么优缺点?
底层结构
数组:连续内存空间,元素依次紧挨存放,通过下标访问。
链表:非连续内存,每个节点包含「数据 + 下一节点指针」,靠指针串联。
数组
✅ 优点
随机访问快:下标直接寻址,时间复杂度 O(1)
内存紧凑,无额外指针开销,缓存命中率高,遍历效率高。
实现简单,支持下标、位运算等便捷操作。
❌ 缺点
插入 / 删除效率低:中间增删需要移动大量元素,O(n)
容量固定:静态数组大小编译 / 初始化时确定,易出现空间浪费或溢出;动态数组扩容也伴随拷贝开销。
无法灵活碎片化利用内存。
链表
✅ 优点
插入 / 删除极快:只需修改指针,O(1)
(找到目标节点后)。
动态扩容:按需申请节点,无固定容量限制,内存利用灵活。
可利用零散内存碎片。
❌ 缺点
不支持随机访问:查找元素必须从头遍历,O(n)
每个节点额外占用指针内存,开销更大;链表节点分散,缓存效率差。
实现相对复杂,指针操作易出现野指针、断链问题。
适用场景
数组:频繁查询、遍历,元素数量相对固定;如查表、矩阵、缓冲区、普通数据存储。
链表:频繁增删元素,数据量动态变化大;如 LRU 缓存、哈希表拉链、多项式存储。
数组:连续内存,随机访问快、遍历高效;增删慢、容量固定。适合查询多、数据量稳定场景。
链表:非连续内存,增删快、动态扩容;不支持随机访问、有指针开销。适合频繁增删、数据动态变化场景。
数组的物理结构为顺序存储,链表的物理结构为链式存储
数组的长度是固定的,链表的长度是可变的
数组内存占用紧凑,链表要存地址有额外开销
数组方便任意访问和查找,链表方便增和删操作
栈是先进后出,队列是先进先出
栈顶端出入,队列是一端进入一端出
栈主要应用在函数的调用和递归,以及网页和手机的回退
队列主要应用在任务排队和消息队列、缓冲区
4.栈和队列的区别
栈(Stack)
规则:后进先出 LIFO,只允许在同一端(栈顶) 做插入、删除、访问。
队列(Queue)
规则:先进先出 FIFO,队尾入队、队头出队,两端分别操作。
栈
✅ 结构简单,操作速度快,内存开销小;函数调用天然依赖栈。
❌ 访问受限,只能操作栈顶,无法随机访问内部元素;普通顺序栈存在栈溢出风险。
队列
✅ 天然实现排队逻辑,解耦生产与消费;循环队列可高效复用内存。
❌ 顺序队列易出现 “假溢出”,需实现循环队列优化;无法快速访问中间元素。
适用场景
栈
函数调用、递归调用(保存返回地址、局部变量、栈帧)。
表达式求值、括号匹配、语法解析(编译器 / 解释器)。
页面 / 路由后退、浏览器历史记录、撤销操作。
深度优先搜索(DFS)。
队列
任务排队、消息队列、请求排队(服务器处理客户端请求)。
生产者 - 消费者模型(线程 / 进程间数据传递)。
广度优先搜索(BFS)。
打印机、IO 设备等外设任务调度。
限流、削峰,缓冲突发流量。
栈:后进先出,仅栈顶操作;用于函数调用、递归、括号匹配、撤销功能、DFS。
队列:先进先出,队尾入队、队头出队;用于任务排队、生产者消费者、消息队列、BFS、流量削峰。
栈是先进后出,队列是先进先出
栈顶端出入,队列是一端进入一端出
栈主要应用在函数的调用和递归,以及网页和手机的回退
队列主要应用在任务排队和消息队列、缓冲区
5.链表排序(直插)
void SortLinkList(node *head)
{
    if (head == NULL || head->next == NULL) {
        return;
    }

    //打断成两个链表
    node *tmp = head->next->next;  //保存第二个链表头的位置
    head->next->next = NULL;

    node *p = NULL;   //虚拟头节点
    node *h = NULL;  //用来遍历第一个链表,找插入位置的指针
    //遍历第二个链表
    while (tmp != NULL) {
        p = tmp;  //拿到当前要插入的结点
        tmp = tmp->next;  //tmp遍历

        for (h = head; h->next != NULL && h->next->data < p->data; h = h->next);
            \\这个循环的意思是遍历h为头结点的链表,如果遍历完还是满足条件就直接走下面插入的那一步。

        /*
        h = head;
        while (1) {
            if (h->next == NULL || h->next->data > p->data) {
                break;
            }
            h = h->next;
        }
        */

        //p插入到h后面
        p->next = h->next;
        h->next = p;
    }
}
ListNode* insertionSort(ListNode* head) {
    if (!head || !head->next) return head;

    // 1. 初始化:哑节点简化操作
    ListNode* dummy = (ListNode*)malloc(sizeof(ListNode));
    dummy->next = head;

    ListNode* lastSorted = head;  // 已排序部分的最后一个节点
    ListNode* curr = head->next;  // 当前要插入的节点(从第二个开始)

    while (curr != NULL) {
        if (curr->val >= lastSorted->val) {
            // 情况1:当前节点已经比已排序部分大,直接扩展
            lastSorted = curr;
        } else {
            // 情况2:需要找到插入位置
            ListNode* prev = dummy;

            // 找到第一个大于curr->val的节点的前一个位置
            while (prev->next->val < curr->val) {
                prev = prev->next;
            }

            // 执行插入
            lastSorted->next = curr->next;
            curr->next = prev->next;
            prev->next = curr;
        }

        curr = lastSorted->next;
    }

    ListNode* result = dummy->next;
    free(dummy);
    return result;
}
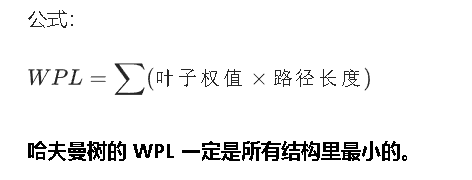
6.哈夫曼树权值计算方法
7.合并有序链表
/*
1、传参的出错判断
2、释放掉一个头节点
3、创建两个指针p1和p2分别遍历两个链表,用于数据大小比较
4、创建tmp指针做链表
*/
node *CombineLinkList(node *head1, node *head2)
{
    if (head1 == NULL) {
        return head2;
    }
    if (head2 == NULL) {
        return head1;
    }

    node *p1 = head1->next;
    node *p2 = head2->next;
    node *tmp = head1;  //使用tmp做拼接工作
    free(head2);  //释放多余的头节点

    while (1) {
        if (p1->data > p2->data) {
            tmp->next = p2;
            p2 = p2->next;
            tmp = tmp->next;

            if (p2 == NULL) {  //当第二个链表没有数据时
                tmp->next = p1;  //tmp直接指向第一个链表的结尾
                break;
            }
        }
        else {
            tmp->next = p1;
            p1 = p1->next;
            tmp = tmp->next;

            if (p1 == NULL) {  //当第二个链表没有数据时
                tmp->next = p2;  //tmp直接指向第一个链表的结尾
                break;
            }
        }
    }
    return head1;
}
typedef struct ListNode {
    int val;
    struct ListNode *next;
} Node;

Node* CombineList(Node* l1, Node* l2) {
    // 1. 终止条件:如果有一个为空,直接返回另一个
    if (l1 == NULL) return l2;
    if (l2 == NULL) return l1;

    // 2. 比较并递归
    if (l1->data < l2->data) {
        l1->next = CombineList(l1->next, l2);
        return l1; // l1 作为当前的头
    } else {
        l2->next = CombineList(l1, l2->next);
        return l2; // l2 作为当前的头
    }
}
8.二分查找
int binarySearch(int a[], int n, int key) {
    int left = 0, right = n - 1;
    while (left <= right) {
        int mid = (left + right) / 2;  // 中间位置
        if (a[mid] == key)
            return mid;
        else if (a[mid] < key)
            left = mid + 1;   // 去右边
        else
            right = mid - 1;  // 去左边
    }
    return -1;
}
9.数据结构物理与逻辑结构速记表
| 分类 | 结构类型 | 核心关键词(背这个) | 特性与公式 | 常见对应数据结构 |
|---|---|---|---|---|
| 物理结构(怎么存) | 1. 顺序存储 | 连续、相邻、随机访问 | 逻辑相邻 = 物理相邻访问 O (1),插入删除 O (n) | 数组、顺序表、顺序栈、堆 |
| 2. 链式存储 | 指针、不连续、前连后 | 靠指针链接访问 O (n),插入删除 O (1) | 单 / 双链表、循环链表、二叉树 | |
| 3. 散列存储(哈希) | Hash 函数、直接寻址 | 关键字 -> 地址冲突解决:链地址法、开放定址 | 哈希表 (HashMap)、字典 | |
| 4. 索引存储 | 索引表、关键字 - 地址 | 额外建立索引表,以空间换时间 | B + 树索引、数据库索引 | |
| 逻辑结构(怎么关) | 1. 线性结构 | 一对一、前驱后继 | 有且仅有一个首和尾元素排成一条线 | 数组、链表、栈、队列、串 |
| 2. 树形结构 | 一对多、层次关系 | 根节点、父节点、子节点非线性层次结构 | 二叉树、BST、红黑树、堆 | |
| 3. 图状结构 | 多对多、网状关系 | 任意两点可连接存在路径与环路 | 无向图、有向图、网 | |
| 4. 集合结构 | 同属集合、无特定关系 | 元素之间无逻辑关联仅属于同一个集合 | Set (集合) |
a区分概念:
顺序存储是物理结构,线性表是逻辑结构。数组是 “顺序存储的线性表”。
哈希表基于散列存储(物理结构),不是逻辑结构。
b判空 / 判满公式:
循环队列(顺序存储)判空:front == rear
循环队列判满:(rear + 1) % MAXSIZE == front
c时间复杂度:
顺序存储访问最快 O (1)。
链式存储遍历慢 O (n)。
散列存储查找最快 O (1)(平均情况)。
|
类别 |
名称 |
主要特点 |
常见应用 |
|---|---|---|---|
|
逻辑结构 |
集合 |
元素之间无特定关系,只属于同一集合 |
集合运算、去重 |
|
线性结构 |
元素一对一,有唯一前驱和后继 |
数组、链表、栈、队列 | |
|
树形结构 |
元素一对多,存在层次和分支关系 |
二叉树、堆、B树 | |
|
图形结构 |
元素多对多,任意元素可相连 |
社交网络、地图、依赖关系 | |
|
物理结构 |
顺序存储 |
元素在内存中连续存放,支持随机访问 |
数组、顺序表 |
|
链式存储 |
元素通过指针/引用连接,不要求连续 |
链表、树、图的邻接表 | |
|
索引存储 |
建立附加索引结构提高查找效率 |
数据库索引、字典 | |
|
散列存储 |
通过哈希函数直接计算存储位置 |
哈希表、缓存 |
逻辑结构:
• 集合:元素无关系
• 线性:一对一
• 树形:一对多
• 图形:多对多
物理结构:
• 顺序:连续存储,随机访问快
• 链式:不连续,插入删除方便
• 索引:额外索引,查找快
• 散列:哈希定位,效率高
| 结构大类 | 具体结构名称 | 核心逻辑关系 | 核心特点 | 典型适用场景 |
|---|---|---|---|---|
| 线性结构(元素间一对一的有序关联) | 线性表 | 元素按线性顺序排列,除首尾元素外,每个元素有唯一前驱和唯一后继 | 1. 元素有序、同类型2. 支持随机访问(顺序实现)3. 插入 / 删除操作需移动大量元素(顺序实现) | 基础数据存储、线性表的基础操作封装 |
| 栈(Stack) | 受限线性表,仅允许在栈顶一端进行插入、删除操作 | 1. 核心规则:后进先出(LIFO)2. 操作受限,仅栈顶可读写3. 无随机访问能力 | 函数调用栈、表达式求值、括号匹配、深度优先搜索(DFS) | |
| 队列(Queue) | 受限线性表,仅允许在队尾插入、队头删除 | 1. 核心规则:先进先出(FIFO)2. 操作受限,仅队头出、队尾入3. 无随机访问能力 | 任务调度、消息队列、广度优先搜索(BFS)、缓冲区管理 | |
| 数组(Array) | n 维线性表,元素按行 / 列顺序排列,所有元素同类型 | 1. 支持多维索引,随机访问效率极高(O (1))2. 元素连续存储,内存密度高3. 插入 / 删除操作复杂度高,需移动大量元素 | 矩阵运算、多维数据存储、批量同类型数据管理 | |
| 非线性结构(元素间一对多 / 多对多的复杂关联) | 树(Tree) | 一对多的层次结构,根节点无父节点,其余节点有唯一父节点,可有多棵子树,无环路 | 1. 严格的层次结构,天然适合表达层级关系2. 子树之间相互独立,无交叉关联3. 遍历方式多样(前 / 中 / 后 / 层序) | 目录结构、组织架构、分类体系、哈夫曼编码 |
| 二叉树(Binary Tree) | 特殊的树结构,每个节点最多有 2 棵子树(左子树、右子树),子树有严格的左右顺序 | 1. 结构规范,遍历、查找、插入操作的算法成熟2. 可衍生出二叉搜索树、平衡二叉树、红黑树等高效结构3. 是绝大多数树型算法的基础模型 | 二叉搜索树、AVL 树、红黑树、堆、表达式树 | |
| 图(Graph) | 多对多的网状结构,由顶点(Vertex)和边(Edge)组成,顶点间可通过边任意关联,允许有环路 | 1. 最灵活的非线性结构,可表达任意复杂的关联关系2. 分为有向图 / 无向图、带权图 / 无权图、连通图 / 非连通图3. 核心算法围绕遍历、最短路径、最小生成树、拓扑排序展开 | 社交网络、交通路网、网络拓扑、任务依赖、状态机 | |
| 集合(Set) | 元素间无明确逻辑关系,仅存在「属于 / 不属于」的归属关系,元素唯一、无序 | 1. 元素不可重复,无顺序要求2. 核心操作是交集、并集、差集、成员判断3. 是最简单的非线性结构,无复杂的关联规则 | 数据去重、集合运算、标签管理、权限控制 |
时间复杂度:算法执行基本操作的次数,衡量运行快慢。
空间复杂度:算法额外开辟的内存空间,含递归栈、临时数组、辅助变量。
10.完全二叉树编码
a.数组静态初始化(最简单)
直接用一维数组表示完全二叉树,数组顺序就是层序遍历顺序。
#include <stdio.h>

// 最大节点数
#define MAX_SIZE 100

// 完全二叉树结构体(数组实现)
typedef struct {
    int data[MAX_SIZE];
    int size;   // 实际节点个数
} CompleteBiTree;

// 1. 初始化完全二叉树:用给定数组构建
void InitTree(CompleteBiTree *tree, int arr[], int n)
{
    if (tree == NULL || n > MAX_SIZE)
        return;

    // 逐个拷贝数据
    for (int i = 0; i < n; i++)
    {
        tree->data[i] = arr[i];
    }
    tree->size = n;
}

// 2. 层序遍历(数组本身就是层序,直接遍历即可)
void LevelOrder(CompleteBiTree *tree)
{
    if (tree == NULL || tree->size == 0)
    {
        printf("树为空\n");
        return;
    }
    for (int i = 0; i < tree->size; i++)
    {
        printf("%d ", tree->data[i]);
    }
    printf("\n");
}

// 3. 前序遍历(递归)
void PreOrder(CompleteBiTree *tree, int idx)
{
    // 下标越界,递归终止
    if (idx >= tree->size)
        return;

    printf("%d ", tree->data[idx]);        // 访问根
    PreOrder(tree, 2 * idx + 1);           // 左子树
    PreOrder(tree, 2 * idx + 2);           // 右子树
}

int main(void)
{
    // 原始数据,按层序给出,构建完全二叉树
    int arr[] = {1, 2, 3, 4, 5, 6};
    int n = sizeof(arr) / sizeof(arr[0]);

    CompleteBiTree tree;
    // 初始化
    InitTree(&tree, arr, n);

    printf("层序遍历:");
    LevelOrder(&tree);

    printf("前序遍历:");
    PreOrder(&tree, 0);
    printf("\n");

    return 0;
}
b.动态逐个插入初始化(动态构建)
不提前给完整数组,逐个节点插入,保持完全二叉树形态(只能从末尾追加)。
#include <stdio.h>
#include <string.h>

#define MAX_SIZE 100

typedef struct {
    int data[MAX_SIZE];   //int 数组,用来存放树上所有节点数值
    int size;              //size有效节点个数,记录现在树上实际有几个数据
} CompleteBiTree;

// 初始化空树
void CreateEmptyTree(CompleteBiTree *tree)
{
    if (tree == NULL)
        return;
    memset(tree->data, 0, sizeof(tree->data));
    tree->size = 0;
     //memset(起始地址, 填充字节值, 填充总字节数);
}

// 尾部插入节点(完全二叉树只能末尾追加)
int InsertNode(CompleteBiTree *tree, int val)
{
    if (tree == NULL || tree->size >= MAX_SIZE)
        return 0; // 失败

    tree->data[tree->size] = val;
    tree->size++;
    return 1; // 成功
}

// 层序遍历
void LevelOrder(CompleteBiTree *tree)
{
    if (tree == NULL || tree->size == 0)
    {
        printf("空树\n");
        return;
    }
    for (int i = 0; i < tree->size; i++)
    {
        printf("%d ", tree->data[i]);
    }
    printf("\n");
}

int main(void)
{
    CompleteBiTree tree;
    CreateEmptyTree(&tree);

    // 逐个插入节点,完成初始化
    InsertNode(&tree, 1);
    InsertNode(&tree, 2);
    InsertNode(&tree, 3);
    InsertNode(&tree, 4);
    InsertNode(&tree, 5);
    InsertNode(&tree, 6);

    printf("动态插入后层序遍历:");
    LevelOrder(&tree);

    return 0;
}
11冒泡排序
#include <stdio.h>

int main() {
    int array[] = {12, 8, 13, 9, 110, 34, 1, 90, 85, 101};
    int len = sizeof(array) / sizeof(array[0]);
    int i, j, temp;

    // 冒泡排序(升序:小到大)
    for (i = 0; i < len - 1; i++) {
        for (j = 0; j < len - 1 - i; j++) {
            if (array[j] > array[j+1]) {  // 修改比较条件:大于号(>)
                // 交换元素
                temp = array[j];
                array[j] = array[j+1];
                array[j+1] = temp;
            }
        }
    }

    // 输出排序后的数组
    printf("排序后的数组(升序):");
    for (i = 0; i < len; i++) {
        printf("%d ", array[i]);
    }
    printf("\n");

    return 0;
}
7.顺序表和链表的区别
| 对比维度 | 顺序表 (如 ArrayList) | 链表 (如 LinkedList) |
|---|---|---|
| 内存布局 | 物理地址连续 | 物理地址不连续,节点分散 |
| 随机访问 | 支持,时间复杂度 O(1) | 不支持,需遍历,时间复杂度 O(n) |
| 插入/删除 | 效率低,O(n) | 效率高,O(1) |
| 空间管理 | 需预分配,可能浪费或溢出 | 动态分配,按需申请 |
| 缓存效率 | 高(对CPU缓存友好) | 低(缓存命中率低) |
·内存布局:连续 vs 分散
顺序表:它基于数组实现,要求所有元素在内存中必须存放在一块连续的区域。这种特性使得它可以通过首地址和元素下标,直接计算出任意元素的内存位置,这是其高效访问的基础。
链表:它的节点可以在内存中任意位置动态生成,物理上是离散的。每个节点除了存储自身数据,还必须包含一个或多个指针,用于记录下一个(或上一个)节点的地址,从而将这些分散的节点在逻辑上串联起来。
. 访问方式:随机访问 vs 顺序访问
顺序表:支持随机访问。就像数组一样,你可以通过下标 arr[i] 在 O(1) 的时间内直接访问到第 i 个元素,效率极高。
链表:只支持顺序访问。如果你想访问第 i 个元素,必须从头节点开始,沿着指针一个接一个地遍历,直到找到目标,平均时间复杂度为 O(n)。
. 插入与删除:移动元素 vs 修改指针
顺序表:在中间位置插入或删除元素时,为了保持内存的连续性,需要将该位置之后的所有元素向后或向前移动,平均需要移动约一半的元素,时间复杂度为 O(n)。
链表:在已知插入或删除位置的前提下,只需要修改相关节点的指针指向即可,无需移动任何数据,时间复杂度为 O(1)。这也是链表最大的优势所在。
. 空间管理与缓存效率
顺序表:
空间管理:需要预先分配一块固定大小的内存。分配太小容易溢出,分配太大会造成浪费。虽然动态顺序表(如 ArrayList)可以扩容,但扩容操作(申请新内存、复制旧数据)开销很大。
缓存效率:由于数据在内存中连续存放,非常符合CPU缓存的局部性原理。访问一个元素时,CPU会预加载其附近的一整块数据到高速缓存中,使得后续访问速度极快。
链表:
空间管理:非常灵活,用多少申请多少,没有空间浪费和扩容问题。但每个节点都需要额外的空间来存储指针,导致存储密度低于顺序表。
缓存效率:由于节点在内存中随机分布,CPU无法有效预取数据,导致缓存命中率低,访问速度相对较慢。
8.不同数据结构适用
| 数据结构 | 核心优势 | 核心劣势 | 典型应用场景 |
|---|---|---|---|
| 数组 (Array) | 随机访问极快 O(1) | 插入/删除慢 O(n),大小固定 | 矩阵运算、缓存、静态数据列表 |
| 链表 (Linked List) | 插入/删除快 O(1) | 无法随机访问 O(n),额外内存开销 | 频繁增删的列表、底层实现栈/队列 |
| 哈希表 (Hash Table) | 查找/插入/删除极快 O(1) | 无序,占用内存较多,有冲突风险 | 字典、缓存(Redis)、统计词频、数据库索引 |
| 栈 (Stack) | 后进先出 (LIFO) | 只能访问栈顶 | 函数调用、撤销操作(Undo)、括号匹配 |
| 队列 (Queue) | 先进先出 (FIFO) | 只能访问队头/队尾 | 任务调度、消息队列、广度优先搜索(BFS) |
| 二叉搜索树 (BST) | 有序,查找/插入 O(log n) | 可能退化为链表 O(n) | 动态查找表 |
| 平衡树 (AVL/红黑树) | 严格平衡,稳定 O(log n) | 实现复杂,旋转开销 | 数据库索引、C++ map/set、Java TreeMap |
| 堆 (Heap) | 快速获取最大/最小值 O(1) | 查找普通元素慢 | 优先队列、Top K 问题、堆排序 |
| 图 (Graph) | 表达复杂关系 | 算法复杂,空间开销大 | 社交网络、地图导航、推荐系统 |
| Trie树 (前缀树) | 字符串前缀匹配极快 | 空间消耗大 | 搜索自动补全、敏感词过滤 |
8.哈夫曼树编码
// ===================== 1. 哈夫曼树节点定义 =====================
typedef struct HuffmanNode {
    char ch;          // 字符(叶子才有)
    int weight;       // 权值(频率)
    int parent;       // 父节点下标(数组实现方便)
    int lchild, rchild;
} HuffmanNode;

// ===================== 2. 哈夫曼编码结构体 =====================
typedef struct HuffmanCode {
    char ch;          // 字符
    char code[100];   // 编码串(01串)
} HuffmanCode;

// ===================== 3. 选两个权值最小的节点(核心) =====================
// 在 0~n-1 中找 parent=-1 的两个最小节点
void selectMin(HuffmanNode* HT, int n, int* s1, int* s2) {
    int i;
    // 找第一个最小 s1
    *s1 = -1;
    for (i = 0; i < n; i++) {
        if (HT[i].parent == -1) {
            if (*s1 == -1 || HT[i].weight < HT[*s1].weight)
                *s1 = i;
        }
    }
    // 找第二个最小 s2
    *s2 = -1;
    for (i = 0; i < n; i++) {
        if (HT[i].parent == -1 && i != *s1) {
            if (*s2 == -1 || HT[i].weight < HT[*s2].weight)
                *s2 = i;
        }
    }
}

// ===================== 4. 构造哈夫曼树 =====================
// n: 叶子数
void createHuffmanTree(HuffmanNode* HT, int n, int* weights, char* chars) {
    if (n <= 1) return;

    int totalNodes = 2 * n - 1;  // 总节点数固定:叶子n → 2n-1

    // 初始化所有节点
    for (int i = 0; i < totalNodes; i++) {
        HT[i].parent = HT[i].lchild = HT[i].rchild = -1;
        HT[i].weight = 0;
        HT[i].ch = 0;
    }

    // 初始化叶子节点(前n个)
    for (int i = 0; i < n; i++) {
        HT[i].weight = weights[i];
        HT[i].ch = chars[i];
    }

    // 开始合并 n-1 次
    for (int i = n; i < totalNodes; i++) {
        int s1, s2;
        selectMin(HT, i, &s1, &s2);  // 选两个最小

        // 建立父子关系
        HT[s1].parent = i;
        HT[s2].parent = i;
        HT[i].lchild = s1;
        HT[i].rchild = s2;
        HT[i].weight = HT[s1].weight + HT[s2].weight;
    }
}
- 把所有权值看成n 棵只有根节点的树,构成森林
- 在森林中选两棵权值最小的树,作为左右子树,构造一棵新树
- 新树根节点权值 = 两棵子树权值之和
- 把这两棵小树从森林删除,加入新树
- 重复 2~4,直到森林只剩一棵树 → 就是哈夫曼树
特点:
权值越小的叶子,离根越远
权值越大的叶子,离根越近
哈夫曼树没有度为 1 的节点
总节点数 = 2n - 1(n 是叶子数)
9.环型队列
一、循环队列(顺序存储,数组实现)
默认规则:
队头:front(指向第一个元素)
队尾:rear(指向最后一个元素的下一个位置)
数组大小:MAXSIZE
牺牲一个位置,用来区分空和满
判空
front == rear
判满
(rear + 1) % MAXSIZE == front
二、循环链表(链式存储)
循环链表没有队满一说,因为是动态申请结点,空间无限。
判空
带头结点:
head->next == head
不带头结点:
head == NULL
判满
循环链表不存在判满!永远不会满
三、总结
循环队列
空:front == rear
满:(rear+1) % MAXSIZE == front
循环链表
空:head->next == head
满:无,不存在
循环队列不能用 rear == front 判满,会和空冲突
循环链表永远不会满,考试问 “循环链表判满条件” 直接答:无
循环队列是物理结构,循环链表是逻辑 + 存储结构
#include <stdio.h>
#define MAXSIZE 5

// 循环队列结构
typedef struct {
    int data[MAXSIZE];
    int front;  // 队头指针
    int rear;   // 队尾指针
} Queue;

// 初始化队列
void InitQueue(Queue *q) {
    q->front = q->rear = 0;
}

// 判断队列是否为空
int IsEmpty(Queue *q) {
    return q->front == q->rear;
}

// 判断队列是否满
// 常用方法:牺牲一个位置,(rear+1)%MAXSIZE == front 表示满
int IsFull(Queue *q) {
    return (q->rear + 1) % MAXSIZE == q->front;
}

// 入队
int EnQueue(Queue *q, int val) {
    if (IsFull(q)) {
        printf("队列满,无法入队!\n");
        return 0;
    }
    q->data[q->rear] = val;
    q->rear = (q->rear + 1) % MAXSIZE;
    return 1;
}

// 出队
int DeQueue(Queue *q, int *val) {
    if (IsEmpty(q)) {
        printf("队列空,无法出队!\n");
        return 0;
    }
    *val = q->data[q->front];
    q->front = (q->front + 1) % MAXSIZE;
    return 1;
}

// 取队头元素
int GetFront(Queue *q, int *val) {
    if (IsEmpty(q)) return 0;
    *val = q->data[q->front];
    return 1;
}

// 测试主函数
int main() {
    Queue q;
    InitQueue(&q);

    EnQueue(&q, 10);
    EnQueue(&q, 20);
    EnQueue(&q, 30);
    EnQueue(&q, 40);
    EnQueue(&q, 50);  // 这里会满,因为牺牲了一个位置

    int x;
    while (!IsEmpty(&q)) {
        DeQueue(&q, &x);
        printf("%d ", x);
    }
    return 0;
}
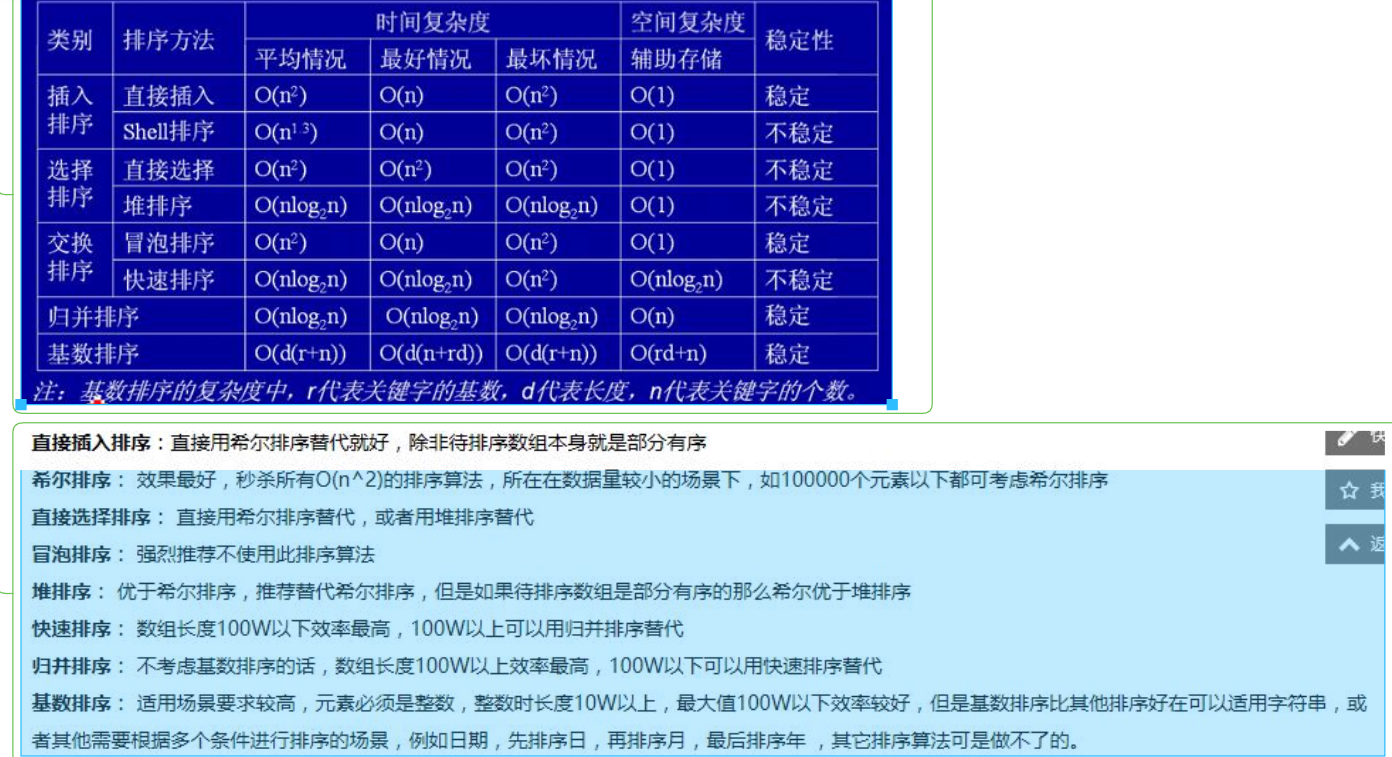
10.各种算法的复杂度
11.各种数据结构的用处
| 数据结构 | 核心优势 | 核心劣势 | 典型应用场景 |
|---|---|---|---|
| 数组 (Array) | 随机访问极快 O(1) | 插入/删除慢 O(n),大小固定 | 矩阵运算、缓存、静态数据列表 |
| 链表 (Linked List) | 插入/删除快 O(1) | 无法随机访问 O(n),额外内存开销 | 频繁增删的列表、底层实现栈/队列 |
| 哈希表 (Hash Table) | 查找/插入/删除极快 O(1) | 无序,占用内存较多,有冲突风险 | 字典、缓存(Redis)、统计词频、数据库索引 |
| 栈 (Stack) | 后进先出 (LIFO) | 只能访问栈顶 | 函数调用、撤销操作(Undo)、括号匹配 |
| 队列 (Queue) | 先进先出 (FIFO) | 只能访问队头/队尾 | 任务调度、消息队列、广度优先搜索(BFS) |
| 二叉搜索树 (BST) | 有序,查找/插入 O(log n) | 可能退化为链表 O(n) | 动态查找表 |
| 平衡树 (AVL/红黑树) | 严格平衡,稳定 O(log n) | 实现复杂,旋转开销 | 数据库索引、C++ map/set、Java TreeMap |
| 堆 (Heap) | 快速获取最大/最小值 O(1) | 查找普通元素慢 | 优先队列、Top K 问题、堆排序 |
| 图 (Graph) | 表达复杂关系 | 算法复杂,空间开销大 | 社交网络、地图导航、推荐系统 |
| Trie树 (前缀树) | 字符串前缀匹配极快 | 空间消耗大 | 搜索自动补全、敏感词过滤 |
12.顺序表和链表哪个空间利用率高
a. 顺序表(数组)
空间利用率:较低 / 有浪费
原因:
必须一次性申请连续的一大块内存(比如大小 100)
实际只用了 20 个,剩下 80 个空着,闲置浪费
扩容时通常扩 1.5~2 倍,会更浪费
每个元素只存数据,没有额外开销
b.链表(动态节点)
空间利用率:较高 / 几乎不浪费
原因:
用一个节点,申请一个空间
不用提前分配,不会闲置
但每个节点都多存一个指针域(next)
这部分是额外开销,属于 “有效利用率下降”
一句话:
不浪费空位,但每个节点都要多带一个指针。
顺序表:浪费在 “空位置”
链表:浪费在 “指针域”
一般题目问:
谁空间利用率更高?
答:通常认为链表更高,因为它不预留、不闲置。
| 对比项 | 顺序表 | 链表 |
|---|---|---|
| 内存连续性 | 连续 | 不连续 |
| 预分配空间 | 一次性分配,易闲置浪费 | 随用随分配,无闲置 |
| 额外开销 | 无(只存数据) | 每个节点多一个指针 |
| 空间利用率 | 较低(有空隙浪费) | 较高(无空隙,但有指针开销) |
| 适合场景 | 数据稳定、不频繁增删 | 频繁增删、长度变化大 |
13.哈希表初始化、插入、查询代码
#include <stdio.h>
#include <stdlib.h>
#include <string.h>

/* 哈希表节点:键值对 + 链表指针 */
typedef struct HashNode {
    int key;                /* 假设键为整数 */
    int value;
    struct HashNode *next;
} HashNode;

/* 哈希表结构 */
typedef struct HashTable {
    HashNode **buckets;     /* 桶数组,每个元素指向链表头 */
    int size;               /* 桶的数量 */
} HashTable;

/* 哈希函数:简单的取模 */
static int hash_func(int key, int size) {
    return key % size;
}

/* 初始化哈希表 */
HashTable* hash_init(int size) {
    HashTable *ht = (HashTable*)malloc(sizeof(HashTable));
    if (!ht) return NULL;

    ht->size = size;
    ht->buckets = (HashNode**)calloc(size, sizeof(HashNode*));
    if (!ht->buckets) {
        free(ht);
        return NULL;
    }
    return ht;
}

/* 插入键值对(若 key 已存在则更新 value) */
void hash_insert(HashTable *ht, int key, int value) {
    int index = hash_func(key, ht->size);
    HashNode *p = ht->buckets[index];

    /* 查找是否已存在相同 key */
    while (p) {
        if (p->key == key) {
            p->value = value;   /* 更新值 */
            return;
        }
        p = p->next;
    }

    /* 不存在,头插法创建新节点 */
    HashNode *new_node = (HashNode*)malloc(sizeof(HashNode));
    new_node->key = key;
    new_node->value = value;
    new_node->next = ht->buckets[index];
    ht->buckets[index] = new_node;
}

/* 查询 key 对应的 value,成功返回 1,失败返回 0;结果通过 value 指针返回 */
int hash_get(HashTable *ht, int key, int *value) {
    int index = hash_func(key, ht->size);
    HashNode *p = ht->buckets[index];
    while (p) {
        if (p->key == key) {
            *value = p->value;
            return 1;
        }
        p = p->next;
    }
    return 0;
}

/* 销毁哈希表(释放所有内存) */
void hash_destroy(HashTable *ht) {
    if (!ht) return;
    for (int i = 0; i < ht->size; ++i) {
        HashNode *p = ht->buckets[i];
        while (p) {
            HashNode *temp = p;
            p = p->next;
            free(temp);
        }
    }
    free(ht->buckets);
    free(ht);
}

/* 演示示例 */
int main() {
    HashTable *ht = hash_init(10);   /* 10 个桶 */

    hash_insert(ht, 1, 100);
    hash_insert(ht, 2, 200);
    hash_insert(ht, 12, 1200);       /* 12 % 10 = 2,与 key=2 同桶,测试冲突 */
    hash_insert(ht, 2, 250);          /* 更新 key=2 的值 */

    int val;
    if (hash_get(ht, 2, &val))
        printf("key 2 -> value %d\n", val);
    else
        printf("key 2 not found\n");

    if (hash_get(ht, 12, &val))
        printf("key 12 -> value %d\n", val);

    if (hash_get(ht, 99, &val))
        printf("key 99 -> value %d\n", val);
    else
        printf("key 99 not found\n");

    hash_destroy(ht);
    return 0;
}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)