单阶段视觉3D占用网络SGN:用“密集-稀疏-密集”范式打破计算瓶颈
0.引言
近年来,基于视觉的 3D 占用网络(Occupancy Networks, 简称 OCC)在自动驾驶领域热度居高不下。相比于昂贵的 LiDAR,纯视觉方案极具成本优势,但也面临着“维度诅咒(Curse of Dimensionality)”的严峻挑战:从 2D 像素到 3D 体素的转换往往会带来特征模糊、深度缺失等几何难题。
今天我们来深度剖析一篇极具启发性的单阶段 OCC 佳作——SGN (Sparse Guidance Network)。本文将带你跳出枯燥的公式,从底层工程逻辑出发,拆解它是如何用“密集-稀疏-密集”的巧妙范式,突破显存与算力的瓶颈,做到参数量仅 12.5M 却能硬刚乃至超越超大模型的。
论文全称:Camera-based 3D Semantic Scene Completion with Sparse Guidance Network
论文链接:arXiv:2312.05752
核心标签:自动驾驶、纯视觉 3D 感知、Semantic Scene Completion (SSC)、单阶段网络、轻量化部署
1. 核心动机:为什么我们需要 SGN?
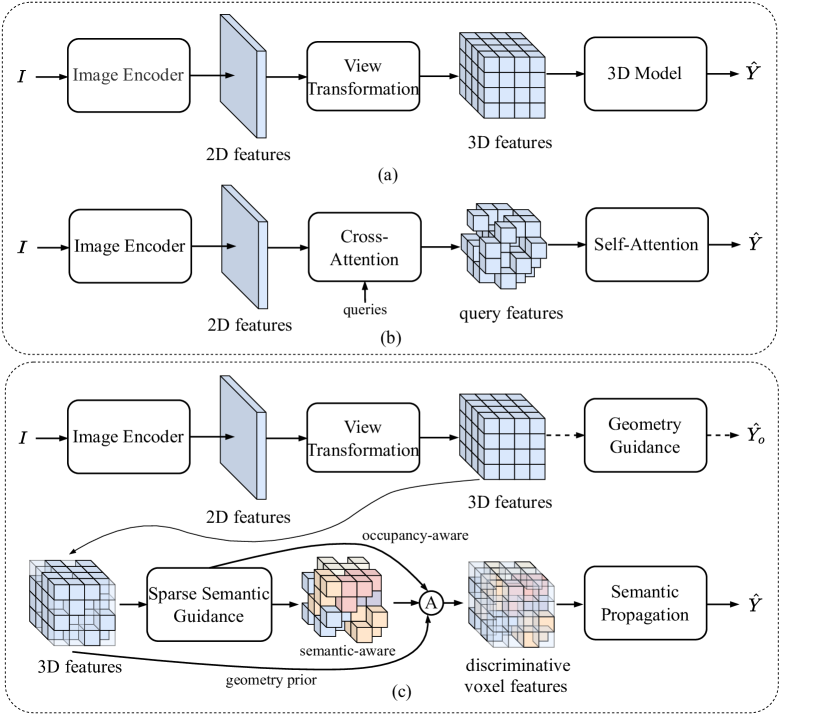
图 1: (a) 全密集处理,具有繁重且复杂的 3D 模型。 (b) MAE 风格的架构,采用“稀疏到密集”的方式。 (c) 我们采用混合引导和语义传播的“密集-稀疏-密集”设计。 “A”表示用于几何线索的体素聚合层。
在 SGN 出现之前,主流的纯视觉 SSC(语义场景补全)方案主要分为两派,但它们在工程落地时各自暴露出难以克服的痛点:
重型 3D 模型派(如 MonoScene, OccFormer): 这类方法通常利用 LSS或 3D-2D 投影,直接把 2D 图像特征“拉升”成 3D 体素特征。然后用庞大且极其耗显存的 3D 卷积或 3D Transformer 硬算。
-
缺点:首先是计算量呈立方级爆炸,极度消耗 GPU 资源。其次,由于 2D 到 3D 的映射缺乏显式深度指导,同一个像素的特征会被均匀“涂抹”在整条相机射线上,导致初始 3D 特征充满“伪影”。模型为了在这些一团乱麻的特征中寻找清晰的分割边界,会学得极其吃力。
两阶段稀疏派(如 VoxFormer): 为了降低计算量,这类方法提出先离线生成不区分类别的体素查询,然后再通过多阶段的注意力机制去补全场景。
-
缺点:两阶段的设计割裂了梯度的反向传播,无法端到端联合优化。更致命的是,它忽视了“种子体素”本身的类别差异——也就是在传播特征之前,并没有给这些种子赋予明确的“身份”(是车、是树还是行人?),且一旦第一阶段漏检了远处的车辆,第二阶段将误差累积。
SGN 的破局思路: 作者看透了上述痛点,决定打破“大力出奇迹”的固有思维,提出了一种单阶段的“密集-稀疏-密集(Dense-Sparse-Dense)”设计。其核心理念非常像人类雕刻艺术品:先用大块泥巴粗略建构空间(密集),然后借助深度图精准找到包含关键物体的“锚点”或“种子体素(Seed Voxels)”(稀疏),给这些种子注入强大的语义和几何属性后,再让种子发芽,顺着物体的纹理把语义平滑地传播到整个 3D 空间(密集)。
2. 架构拆解
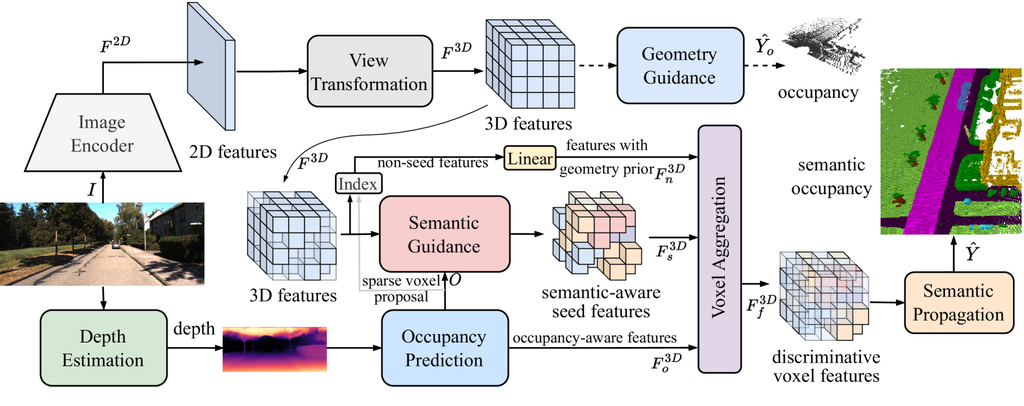
图 2: SGN 的整体框架。 图像编码器提取 2D 特征,为通过视图变换生成的 3D 特征奠定基础。 应用了一个辅助占用头来提供几何引导。 稀疏语义引导包含两部分:稀疏体素提议和语义引导。 基于深度的占用预测是为稀疏体素提议设计的。 该提议与 3D 特征一起被馈送到后续的语义引导,以索引种子特征并将语义上下文注入这些种子特征。 之后,体素聚合层结合了语义感知的种子特征、来自非种子特征的几何先验以及来自基于深度的占用预测的占用感知的特征。 这形成了由多尺度语义传播处理以进行最终预测的信息体素特征。
SGN 的网络架构如同一套精密的流水线,三条主要的数据流(全局几何、深度提议、语义传播)最终交汇于一点。我们可以将其分为四个核心模块来理解:
2.1 视图变换:建立初始的“密集”特征
-
Image Encoder:使用带有 FPN 的 ResNet 提取 2D 图像特征。它提供了丰富的表观和纹理信息。
-
View Transformation:利用相机的内外参,通过 3D-2D 投影映射,把 2D 图像特征投射到 3D 体素网格中,得到密集的初始 3D 特征。正如前面提到的,由于射线上的深度歧义,这团特征虽然囊括了场景的整体信息,但几何边界十分粗糙,就像隔着毛玻璃看世界。
2.2 混合引导机制(核心创新点)
为了让粗糙的毛玻璃特征迅速具备判别力,缩短网络收敛的路径,作者巧妙设计了混合引导机制:
几何引导 (Geometry Guidance):
在粗糙的后面接一个轻量级的 3D 占用头(由各向异性卷积构成)。注意,这是一个辅助头,在推理部署时会被直接丢弃,做到“零额外算力开销”。它利用二元交叉熵损失函数进行强监督:
稀疏语义引导 (Sparse Semantic Guidance):
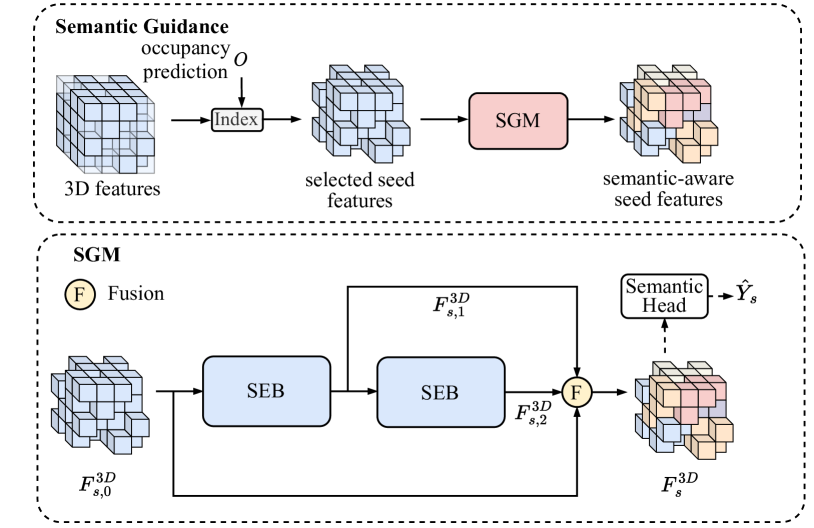
图3:所提出的语义指导模块(SGM)的详细架构。 稀疏编码器块(SEB)由[52]采用的稀疏特征编码器和稀疏几何特征编码器组成。
-
稀疏体素提议网络 (SVPN):在另一条支路上,引入预训练的深度估算模型(如 MobileStereoNet),把深度图反投影成清晰的 3D 点云,预测出空间占用概率O。
-
种子提取与语义注入:基于深度概率 O,设定阈值,从全局庞杂的特征池中精准“抠出”高置信度的“种子体素(Seed Voxels)”。接着,让这些精选的种子经过稀疏卷积网络和辅助语义头。这一步的物理意义在于:在特征扩散前,给种子完成身份认证(明确区分路面、汽车、建筑等类别的特征距离),确保后续传播的是纯正的、无歧义的信号。
2.3 体素聚合层(Voxel Aggregation)
如果单靠深度图选种子,这就产生了一个致命隐患:深度估计在自动驾驶场景中很容易因为恶劣天气(雨雪天)、大面积纯色物体(大卡车侧面白墙)、或者严重遮挡而失效。如果第一步找错了种子,模型岂不是全军覆没?
SGN 在这里展现了极强的工程容错智慧:在体素聚合模块中,网络不仅仅使用了前一步精炼出的语义种子特征 (),它还把之前打过几何底稿的非种子特征(non-seed features,
),以及 SVPN 传来的底层感知占用特征 (
) 通过全连接层(Linear)聚合在了一起。
2.4 多尺度语义传播 (MSSP):回到“密集”
聚合完成后的特征虽然强大,但它是散落在 3D 空间中的。最后一步,模型利用各向异性 3D 卷积(降低 3D 卷积参数量的利器)和 ASPP(空洞空间卷积池化金字塔)模块,获取多尺度的感受野。通过这一模块,提纯后的种子语义,如同墨水滴入水中一般,沿着几何边界,平滑、准确且密集地扩散(Propagate)到整个 3D 空间中,输出最终的稠密语义占用结果。
3.实验结果
3.1 定量分析
表1:SemanticKITTI 隐藏测试集上的语义场景完成。 † 表示 MonoScene [7] 提供的结果。 粗体和下划线分别表示最好的性能和第二好的性能。
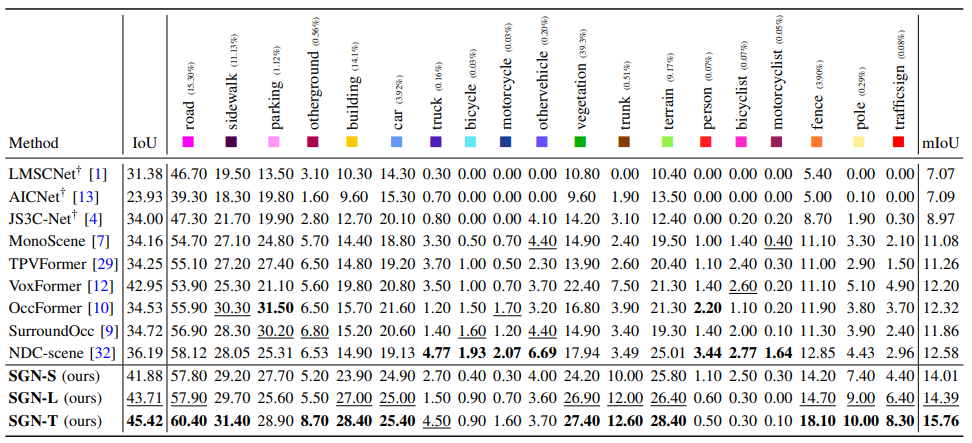
表2:SemanticKITTI val 集上的语义场景完成。 †表示MonoScene提供的结果。 粗体和下划线分别表示最好的性能和第二好的性能。
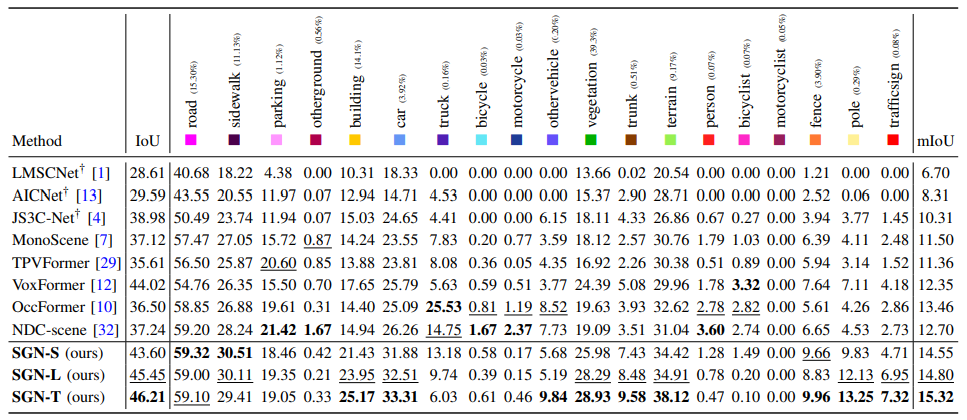
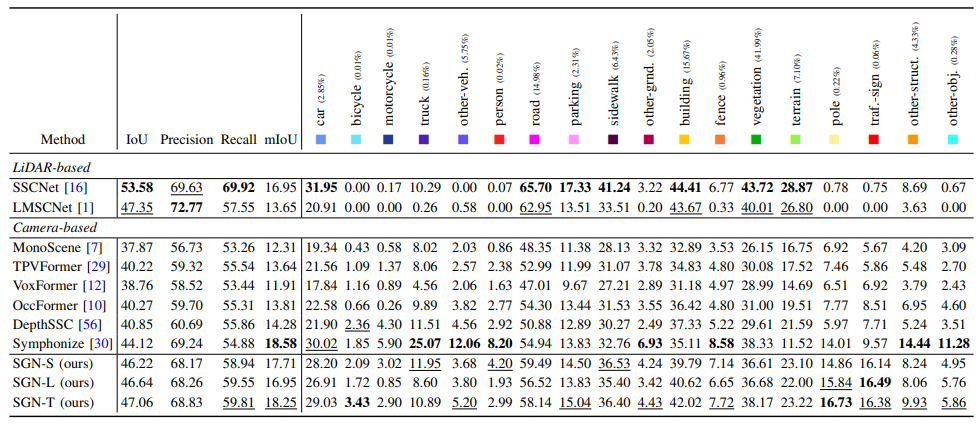
表3:SSCBench-KITTI360 测试集上的定量结果。 粗体和下划线分别表示最好的性能和第二好的性能。
3.2 定性分析
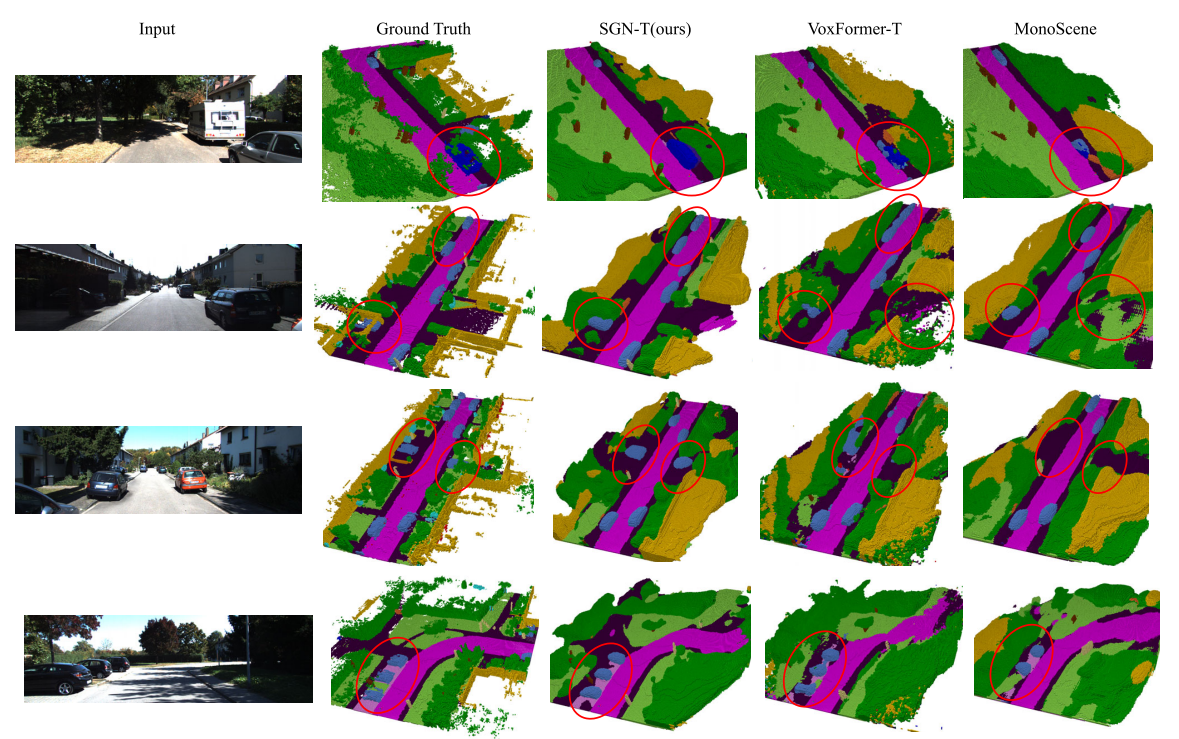
图 4: 我们 SGN-T 与最先进的方法在 SemanticKITTI 验证集上的视觉比较。 与 VoxFormer-T 和 MonoScene 相比,我们的 SGN-T 生成了更精确的分割边界(用红色圆圈标记)。
4.未来研究方向
4.1 告别无脑卷积:基于物理先验与偏微分方程(PDE)的特征扩散
-
当前痛点:SGN 在最后一步的“多尺度语义传播(MSSP)”中,使用了标准的 3D 卷积。这意味着网络在扩散“汽车(刚体)”和扩散“草地(流形表面)”的特征时,用的是同一种感受野法则。这会导致语义经常“溢出”其物理边界(比如车的语义渗透到了路上)。
-
颠覆性思路:能否用**可微的偏微分方程(Differentiable PDEs)**替代 3D 卷积来进行特征聚合?我们可以针对不同类别引入物理扩散定律:对于车辆等可移动刚体,引入具有各项同性、有界限的体积扩散方程;对于路面、墙壁,引入各向异性、沿着表面张力方向的流体扩散方程。让语义种子严格按照现实世界的物理和几何张力进行扩散。这种将经典物理方程与深度学习几何融合的方法,在底层解释性上具有极高降维打击能力。
4.2 从相关性到因果:基于视觉大模型 (VLM) 的“反事实”几何推理补全
-
当前痛点:现有的 SSC(场景补全)本质上是在做数据分布的相关性拟合。如果一辆车的下半部分被完全遮挡,网络只是“猜”那里可能有车轮。一旦遇到长尾场景(Corner Cases),模型极易输出悬空的物体或断裂的道路。
-
颠覆性思路:让 OCC 网络具备**“因果物理结构推理(Causal Structural Reasoning)”**能力。我们可以在几何引导头中注入轻量级的视觉大模型先验:利用 VLM 的常识推理(如:“电线杆必须连接地面”、“车底必须有支撑”),将其转换为空间约束损失函数。当网络遇到极端遮挡时,不再是基于像素特征去瞎猜,而是进行“反事实推理(Counterfactual Reasoning)”——因为上方有红绿灯,所以即便下方全是盲区,也必须强制生成一根向下延伸的占据柱。打造具备开放世界常识推理的 Causal-OCC 框架。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)