保姆级教程:5步在Ollama部署Qwen3-8B,消费级显卡也能流畅运行
·
保姆级教程:5步在Ollama部署Qwen3-8B,消费级显卡也能流畅运行
1. 引言:为什么选择Qwen3-8B?
Qwen3-8B是阿里巴巴通义千问系列的最新成员,作为一款80亿参数的大语言模型,它在推理能力、多语言支持和资源效率之间取得了完美平衡。相比动辄需要专业级GPU的百亿参数模型,Qwen3-8B最大的优势在于:
- 消费级显卡友好:仅需8GB显存即可流畅运行
- 响应速度快:在RTX 3060等中端显卡上能达到20+ tokens/秒的生成速度
- 功能全面:支持32K上下文长度、多轮对话、代码生成等实用功能
本教程将手把手教你如何在Ollama平台快速部署Qwen3-8B,即使你是刚接触大模型的新手,也能在10分钟内完成部署并开始使用。
2. 准备工作
2.1 硬件要求
虽然Qwen3-8B对硬件要求不高,但为了获得最佳体验,建议满足以下配置:
| 组件 | 最低要求 | 推荐配置 |
|---|---|---|
| GPU | NVIDIA GTX 1660 (6GB) | RTX 3060 (12GB) |
| 内存 | 16GB | 32GB |
| 存储 | 20GB可用空间 | SSD硬盘 |
2.2 软件环境
确保你的系统已安装:
- Docker最新版本
- NVIDIA驱动(版本>=525.60.13)
- CUDA Toolkit(版本>=11.7)
可以通过以下命令检查环境:
nvidia-smi  # 查看GPU状态
docker --version  # 检查Docker版本
3. 部署步骤详解
3.1 访问Ollama平台
- 打开浏览器,访问Ollama官方网站
- 注册/登录账号后,进入控制台页面
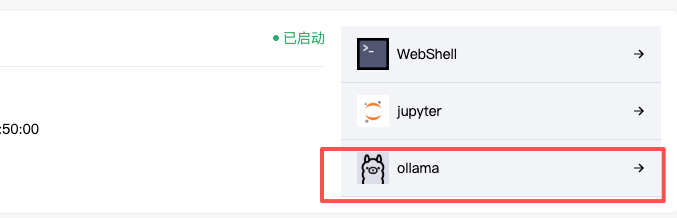
- 在左侧导航栏找到"模型仓库"入口
3.2 选择Qwen3-8B模型
- 在模型仓库页面顶部找到搜索框
- 输入"qwen3:8b"进行搜索
- 从结果中选择官方发布的Qwen3-8B镜像

3.3 一键部署模型
- 点击模型卡片上的"部署"按钮
- 选择适合你硬件的配置选项:
- 显存<8GB:选择4-bit量化版本
- 显存>=8GB:选择FP16版本
- 确认部署,等待镜像拉取完成(约5-10分钟,取决于网络速度)
3.4 启动模型服务
部署完成后,在"我的模型"页面找到Qwen3-8B,点击"启动"按钮。系统会自动分配一个API端点,形如:
http://localhost:11434/api/generate
你可以通过这个端点与模型交互,也可以直接在Ollama提供的Web界面中使用。
3.5 验证部署成功
在Web界面输入以下测试提示词:
请用一句话介绍你自己
如果看到类似下面的回复,说明部署成功:
我是通义千问Qwen3-8B,一个由阿里巴巴开发的大语言模型,擅长回答问题、创作内容和代码生成等任务。
4. 使用技巧与优化建议
4.1 基础使用方式
在Ollama的Web界面中,你可以:
- 在输入框直接输入问题或指令
- 点击"清除"按钮重置对话
- 使用"停止"按钮中断长文本生成

4.2 提升响应速度的技巧
如果你的显卡性能有限,可以尝试以下优化:
# 在API调用时添加这些参数
{
    "temperature": 0.7,  # 降低随机性
    "top_p": 0.9,       # 限制采样范围
    "max_tokens": 512   # 控制生成长度
}
4.3 处理长文本的配置
Qwen3-8B原生支持32K上下文,通过YaRN技术可扩展到128K。如需处理长文档,建议这样配置:
{
    "rope_scaling": {
        "type": "yarn",
        "factor": 4.0,
        "original_max_position_embeddings": 32768
    }
}
5. 常见问题解决
5.1 显存不足报错
如果遇到"CUDA out of memory"错误,可以:
- 换用4-bit量化版本
- 减少
max_tokens参数值 - 添加
--low-vram启动参数
5.2 响应速度慢
尝试以下方法提升速度:
- 确保使用NVIDIA显卡并正确安装了CUDA
- 关闭其他占用GPU资源的程序
- 在较新的驱动版本上运行
5.3 模型无法加载
如果模型启动失败:
- 检查Docker日志:
docker logs <容器ID> - 确保下载的镜像完整:
docker images | grep qwen - 重新拉取镜像:
docker pull ollama/qwen3:8b
6. 总结与下一步
通过本教程,你已经成功在Ollama平台部署了Qwen3-8B模型,并掌握了基本的使用方法。这个轻量级但能力强大的模型特别适合:
- 个人开发者进行AI应用原型开发
- 中小企业构建智能客服系统
- 研究人员进行自然语言处理实验
下一步,你可以尝试:
- 通过API将模型集成到自己的应用中
- 探索模型的高级功能如工具调用和思维链
- 使用微调功能让模型适应特定领域任务
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献16条内容

所有评论(0)