穿透指针迷雾:C语言手撕 LeetCode 二叉树四大遍历(附内存级剖析)
二叉树
本文主要梳理并分享我在攻克 LeetCode 链表类题目时总结的底层解题方法与技巧。如果在阅读过程中发现任何纰漏,敬请各位在评论区批评指正,探讨交流。本文的所有代码示例将采用 C 语言进行实现。
在开始本文之前,先回顾下题目
一、前序遍历
1.1 递归法
前序遍历 顺序为:根→左→右
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 * int val;
 * struct TreeNode *left;
 * struct TreeNode *right;
 * };
 */

// 辅助递归函数
void preorder(struct TreeNode* root, int* res, int* resSize)
{
    // *returnSize = 0;

    if (NULL == root) {
        return;
    }

    // 1. 访问根节点
    res[(*resSize)++] = root->val;

    // 2. 递归遍历左子树
    preorder(root->left, res, resSize);

    // 3. 递归遍历右子树
    preorder(root->right, res, resSize);
}

// 主函数
int* preorderTraversal(struct TreeNode* root, int* returnSize)
{
    int* res = (int*)malloc(sizeof(int) * 100);

    // 必须初始化
    *returnSize = 0;

    preorder(root, res, returnSize);

    return res;
}
在 递归法 中需要明确以下几点
- 函数参数:
struct TreeNode* root:当前正在访问的树节点。随着递归的进行,该指针会不断地指向树的更深层。int* res:用来存放最终结果的首地址int* resSize:这是该函数中最关键的参数。指向主函数(preorderTraversal)中记录数组当前长度的变量。
- 代码逻辑:
-
终止条件
if (NULL == root) {
	return;
}
当指针走至叶子结点下面,此时该路已走到底,直接
return返回至上一层调用; -
访问并记录当前节点
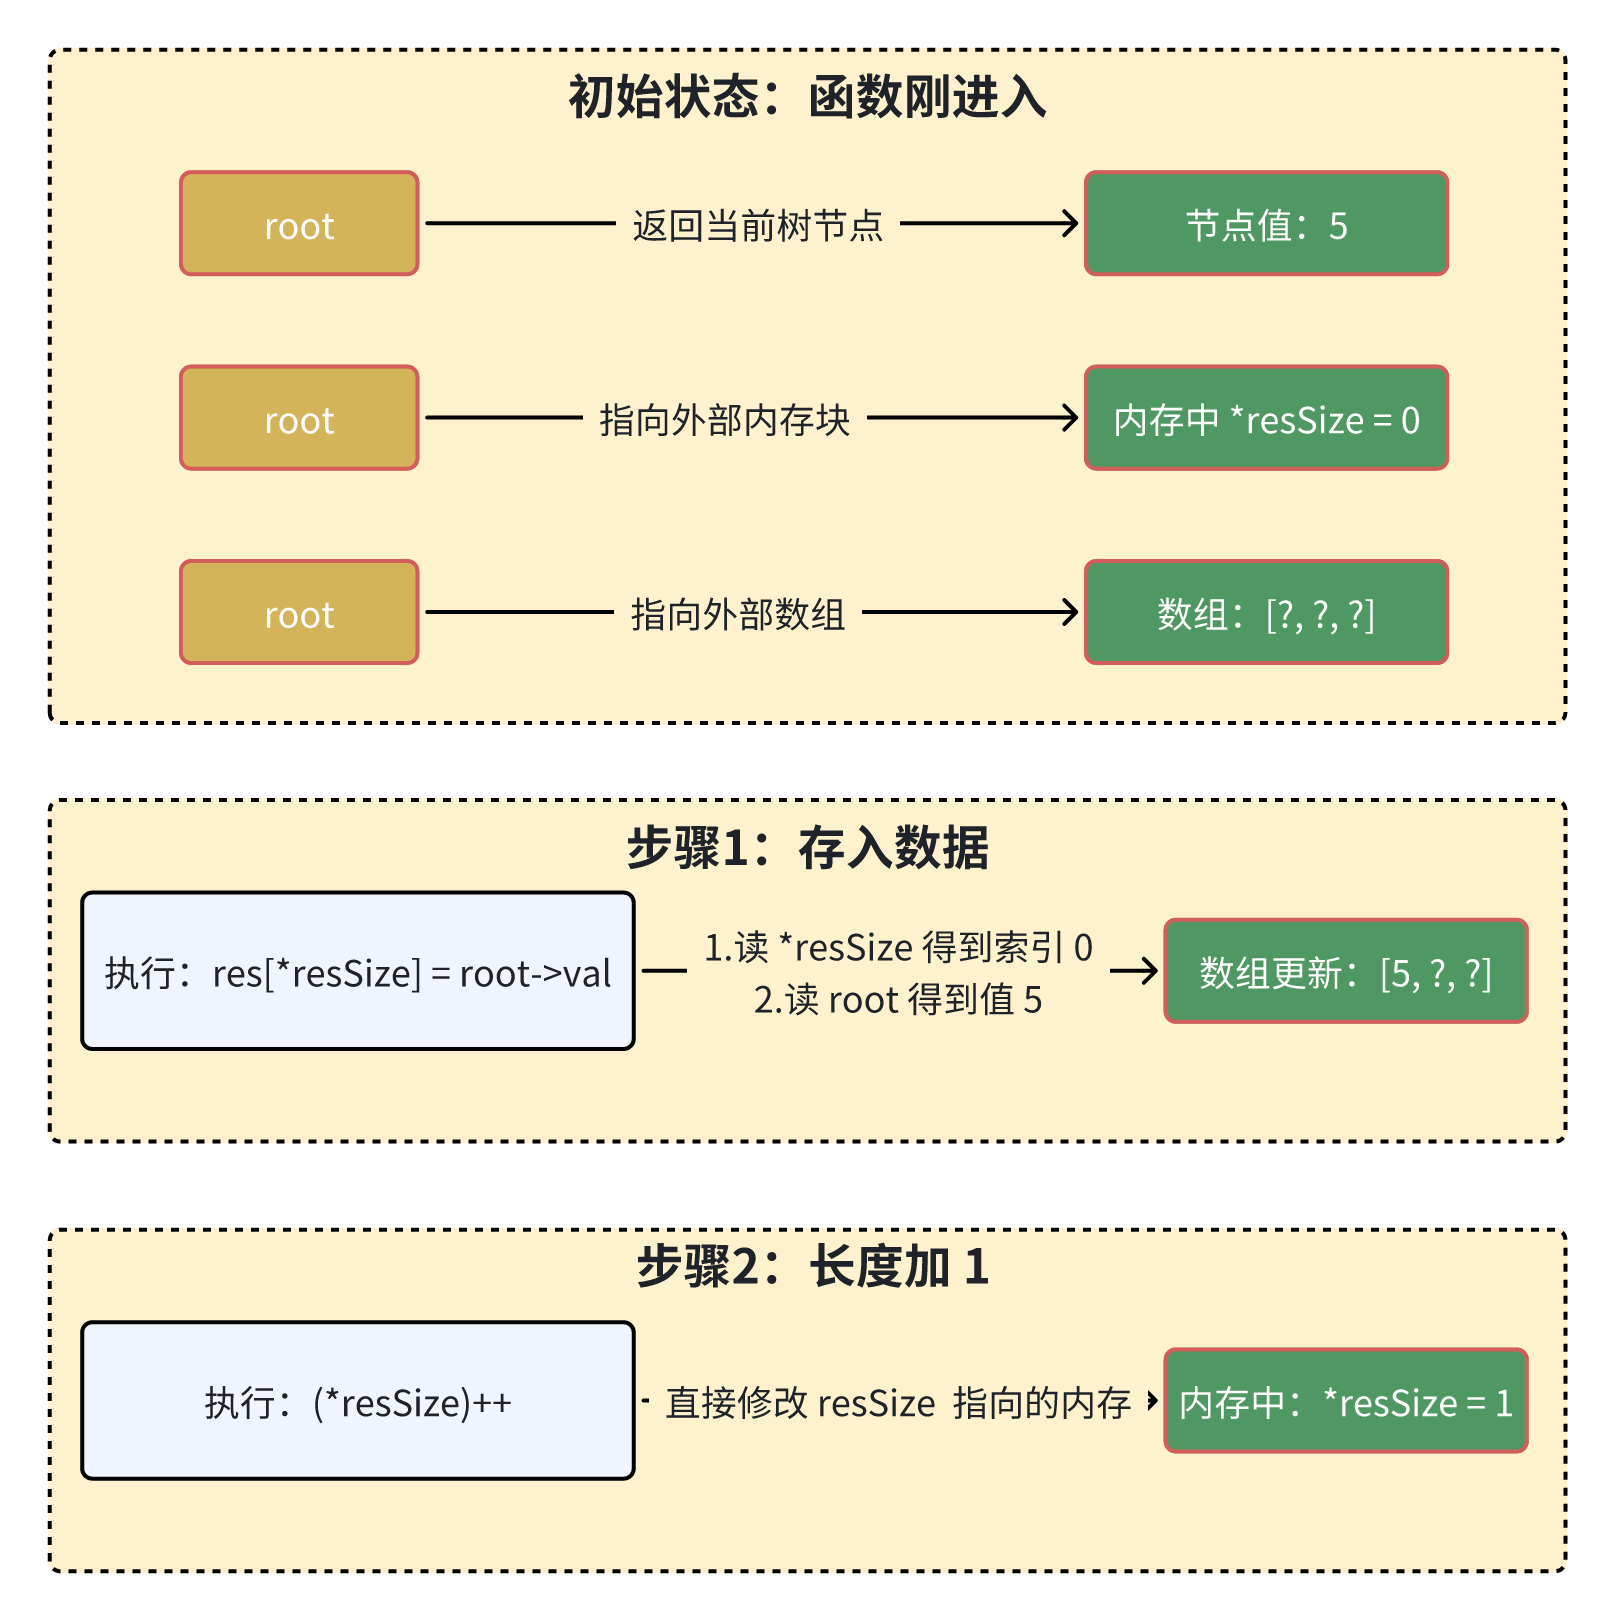
res[(*resSize)++] = root->val;这段代码是 前序遍历 也是后续遍历的核心代码,一定要深入理解
为便于理解,将该段代码拆分开来,即:
// 1.先将当前节点的值,存进数组当前对应的位置 res[*resSize] = root->val; // 2. 存完之后,将记录长度的变量加 1,为下一个数字腾出位置 (*resSize)++;- 解引用获取当前长度:通过对
resSize解引用(*resSize),拿到当前数组已经存了几个数。例如目前存了0个,那*resSize即为0; - 存入数据:将当前节点值(
root->val)放进数组的对应位置。例如res[0] = root->val; - 计数器加一:
++符号将*resSize的值加1。当下一次再存数据时,即会存到res[1]的位置。
- 解引用获取当前长度:通过对
-
一条道走到黑 (左)
preorder(root->left, res, resSize);当前节点记录完后,程序不会立刻往下走,而是暂停在这里,带着左孩子(
root->left)再次进入这个函数本身。只要左边还有节点,它就会一直往左下角钻,并不断把左边的节点值加入数组。 -
回头处理另一边 (右)
preorder(root->right, res, resSize);当左边所有的子孙节点都被处理完,且返回(遇到
NULL返回)后,程序才会回到这里,接着去处理右孩子。同样地,进入右子树后,又会重复“先记录自己,再找左,再找右”的过程。
-
3.图示:
假设当前root遍历到一个值为 5 的节点,此时数组里还未存任何东西(*resSize 为 0)。如下图:
1.2 迭代法(使用栈)
该方法仅作了解
int* preorderTraversal(struct TreeNode* root, int* returnSize)
{
    int* res = (int*)malloc(sizeof(int) * 100);
    *returnSize = 0;

    if (NULL == root) {
        return res;
    }

    // 使用数组模拟一个简单的栈
    struct TreeNode* stack[100];
    int top = -1; // 栈顶指针

    // 根节点入栈
    stack[++top] = root;

    while (top >= 0) {
        // 弹出栈顶元素并记录它的值
        struct TreeNode* node = stack[top--];
        res[(*returnSize)++] = node->val;

        // 入栈顺序:先右后左。出栈时才是先左后右!
        if (NULL != node->right) {
            stack[++top] = node->right;
        }
        if (NULL != node->left) {
            stack[++top] = node->left;
        }
    }

    return res;
}
二、中序遍历
中序遍历 顺序为:左 → 根 → 右
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     struct TreeNode *left;
 *     struct TreeNode *right;
 * };
 */

// 中序遍历
void inorder(struct TreeNode* root, int* res, int* resSize)
{
    if (NULL == root) {
        return;
    }

    // 1. 递归遍历左子树
    inorder(root->left, res, resSize);

    // 2. 访问当前根节点
    res[(*resSize)++] = root->val;

    // 3. 递归遍历右子树
    inorder(root->right, res, resSize);
}

// 主函数
int* inorderTraversal(struct TreeNode* root, int* returnSize)
{
    // 分配内存
    int* res = (int*)malloc(sizeof(int) * 100);
    *returnSize = 0;

    inorder(root, res, returnSize);

    return res;
}
三、后序遍历
后序遍历 顺序为:左 → 右 → 根
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 * int val;
 * struct TreeNode *left;
 * struct TreeNode *right;
 * };
 */

// 辅助递归函数:实现后序遍历核心逻辑
void postorder(struct TreeNode* root, int* res, int* resSize)
{
    if (NULL == root) {
        return;
    }

    // 1. 递归遍历左子树
    postorder(root->left, res, resSize);

    // 2. 递归遍历右子树
    postorder(root->right, res, resSize);

    // 3. 访问当前根节点
    res[(*resSize)++] = root->val;
}

// 主函数
int* postorderTraversal(struct TreeNode* root, int* returnSize)
{
    // 分配内存
    int* res = (int*)malloc(sizeof(int) * 100);
    *returnSize = 0;

    postorder(root, res, returnSize);

    return res;
}
四、层序遍历
在使用C语言解答该题时,首先应当具备以下知识
可以参照我编写的顺序及时查漏补缺。
4.1 指针和一维数组
通过三种示例明确指针和一维数组的关系:
-
三种方式遍历并读取数组
#include <stdio.h>

int main()
{
	int a[5] = {10, 20, 30, 40, 50};
	int *p = a; // 指针 p 指向数组 a 的首地址

	// 1. 使用数组下标访问
	for (int i = 0; i < 5; i++) {
    	printf("%d ", a[i]);
	}

 	// 2. 使用数组名偏移访问
	for (int i = 0; i < 5; i++) {
    	printf("%d ", *(a + i));
	}

	// 3. 使用指针偏移访问
	for (int i = 0; i < 5; i++) {
    	printf("%d ", *(p + i));
	}

	return 0;
}
在编译器内部,
a[i]即被转化为*(a+i)执行
- 利用指针修改数组中的数据
#include <stdio.h>

int main()
{
    int a[4] = {1, 2, 3, 4};
    int *p = a;

    // 将数组中的每个元素都乘以 2
    for (int i = 0; i < 4; i++) {
        *(p + i) = *(p + i) * 2;
    }

    for (int i = 0; i < 4; i++) {
        printf("%d ", a[i]);
    }

    return 0;
}
对
*(p + i)对它赋值即对a[i]赋值。
-
指针的自增遍历
#include <stdio.h>

int main()
{
	int a[5] = {100, 200, 300, 400, 500};
	int *p = a;

	// 指针 p 向后移动
	for (int i = 0; i < 5; i++) {
    	printf("%d ", *p);
    	p++; // 指针本身向后移动一个元素的内存单位 (此处是 4 个字节)
	}

return 0;
}
1
*(p + i)并不会改变指针p本身的指向,而此处的p++会修改改p里面保存的地址,让它依次指向a[0]、a[1]、a[2]…;
2.p++合法,但a++非法,数组名a是一个常量指针,它的地址是固定的,不能被修改。
4.2 指针和二维数组
从内存的视角理解下C语言的二维数组
二维数组的本质,其实是“数组的数组”
当我们写下int a[3][4];时,此时:
- 数组名代表“行”的地址:
a是整个二维数组的首地址,但它的视角是“行”。a指向第0行,如果写a + 1,在内存中会直接跳过一整行(即4个int的长度),指向第1行的起始位置; - 解引用一次,得到“列”的地址:对行地址解引用(如
*a或*(a + i)),即从“管一整行”变成了“管一个元素”。*(a + i)就等同于a[i],表示第i行第0列元素的物理地址,即&a[i][0]。 - 计算具体元素的地址:在确定了某一行第 0 列的地址后,再加上列偏移量
j,就能找到具体元素的地址。因此,*(a + i) + j就等同于&a[i][j]。 - 解引用两次,获取最终数据:在元素地址外面再套一层解引用,即可取出数据。因此,
*(*(a + i) + j)等价于a[i][j]。
需要重点关注当“二维数组+指针”函数传参时,应当如何传参:
-
法一:明确“列数”的数组指针传参
当传递二维数组a时,会退化成一个指向一维数组的指针。为让编译器能够正确计算内存偏移量,须在函数形参中告诉编译器“每一行有多长(列数)”。int (*p)[4] // 外面的括号不能少 -
法二:强制“降维”为一维指针
processArray((int *)a, 3, 4);
下一个需要关注使用 malloc 动态分配二维数组时,内存结构会发生怎样的变化:
-
动态数组的内存结构:
通过malloc构建一个 M × N M \times N M×N(例如 3 行 4 列)的二维数组,不能直接申请一块 3 × 4 3 \times 4 3×4 的空间并用二维下标访问。可分两步:- 先分配一个“目录”:申请一块内存,用来存放 3 个指针。每个指针负责指向将来的一行。
- 再分配具体的“行”:通过循环,为这 3 个指针各自 malloc 一块长度为 4 的一维数组。
-
为什么必须用
int **p(二级指针)传参?-
其中分配的“目录”本质上是一个一维数组,装满了
int *(整型指针)。 -
当把这个“目录”传给函数时,数组名会退化为指向其首元素的指针。
-
指向普通
int的指针是int *;指向int *的指针,即为int **(二级指针)了。
-
-
示例:
#include <stdio.h>
#include <stdlib.h>

// 形参必须使用二级指针 int **p
void processDynamicArray(int **p, int rows, int cols)
{
	for (int i = 0; i < rows; i++) {
    	for (int j = 0; j < cols; j++) {
       		printf("%d ", p[i][j]);
    	}
    	printf("\n");
	}
}
int main()
{
	int rows = 3;
	int cols = 4;

	// 步骤 1:分配“目录” (装了 rows 个 int* 的数组)
	//内部为指针,使用 sizeof(int *)
	int **matrix = (int **)malloc(rows * sizeof(int *));

	// 步骤 2:分配“行”
	for (int i = 0; i < rows; i++) {
    	// 为每行分配 cols 个 int 的空间
    	matrix[i] = (int *)malloc(cols * sizeof(int));

    	// 初始化
    	for (int j = 0; j < cols; j++) {
        	matrix[i][j] = i * cols + j;
    	}
	}

	// 将动态分配的二维数组传入函数
	processDynamicArray(matrix, rows, cols);

	// 步骤 3:释放内存
	for (int i = 0; i < rows; i++) {
    	free(matrix[i]);
	}

	free(matrix);

return 0;
}
4.3 指针数组
指针数组:
int* arr[3];
- 当写下
int* arr[3];时,首先是一个数组arr[3],数组内部有3个空格,里面装的东西的类型是int* - 示例:
// 定义一个包含 3 个指针的数组
char* names[3] = {
	"Tom",        // 长度为 3
	"Alexander",  // 长度为 9
	"Bob"         // 长度为 3
};
4.4 交错数组
交错数组本质上就是“一个装满指针的数组,其中每个指针又指向长度各不相同的普通数组”。
#include <stdio.h>
#include <stdlib.h>

int main()
{
    int numRows = 3;

    // 1. 分配主干:定义一个能存 3 个 int* 指针的数组
    int** jagged = (int**)malloc(sizeof(int*) * numRows);

    // 2. 分配分支
    jagged[0] = (int*)malloc(sizeof(int) * 2); // 第 0 行长度为 2
    jagged[1] = (int*)malloc(sizeof(int) * 4); // 第 1 行长度为 4
    jagged[2] = (int*)malloc(sizeof(int) * 1); // 第 2 行长度为 1

    // 3. 使用:存入数据(语法和普通二维数组一模一样)
    jagged[0][0] = 10; jagged[0][1] = 20;
    jagged[1][0] = 30; jagged[1][1] = 40; jagged[1][2] = 50; 	jagged[1][3] = 60;
    jagged[2][0] = 70;

    // 4. 释放内存:
    free(jagged[0]);
    free(jagged[1]);
    free(jagged[2]);
    free(jagged);    // 最后释放主干

    return 0;
}
上面的代码中存在两个重要的概念:主干 和 分支
- 主干:主干(行指针) 它是一个一维数组,里面存的全部都是内存地址(指针);
- 第二级:分支(真实数据) 根据主干里提供的地址,散落在内存不同地址、长短不一的一维数组,存着真正的数字(
val)。
嵌入式开发中,一个函数里可能要依次申请多个资源。如果中间某一步失败了,前面已经申请的资源都要释放,可通过
goto的进行通过。
4.5 层序遍历代码
先阅读下本题题目:
/**
 * Return an array of arrays of size *returnSize.
 * The sizes of the arrays are returned as *returnColumnSizes array.
 * Note: Both returned array and *columnSizes array must be malloced, assume caller calls free().
 */
int** levelOrder(struct TreeNode* root, int* returnSize, int** returnColumnSizes) {

}
int** res(函数最终返回的二维数组):存放所有的节点值。比如[[3], [9, 20], [15, 7]]。int* returnSize(外部传入的指针):该二维数组一共有几行(也就是树有几层)。int** returnColumnSizes(外部传入的二级指针):需要动态分配一个一维数组,告诉 LeetCode 每一行具体有几个元素(也就是每一层有几个节点)。- 代码实例:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 * int val;
 * struct TreeNode *left;
 * struct TreeNode *right;
 * };
 */
/**
 * Return an array of arrays of size *returnSize.
 * The sizes of the arrays are returned as *returnColumnSizes array.
 * Note: Both returned array and *columnSizes array must be malloced, assume caller calls free().
 */
int** levelOrder(struct TreeNode* root, int* returnSize, int** returnColumnSizes) {
    *returnSize = 0;
    if (NULL == root) {
        return NULL;
    }

    // 2. 分配二维数组(存放最终结果)和一维数组(存放每一层的节点个数)
    int** res = (int**)malloc(sizeof(int*) * 2000);
    *returnColumnSizes = (int*)malloc(sizeof(int) * 2000);

    // 3. 使用数组模拟队列(此处取巧,分配一个足够大的数组)
    struct TreeNode* queue[2000];
    int front = 0;
    int rear = 0;

    // 4. 根节点入队
    queue[rear++] = root;

    // 5. 只要队列不为空,就继续遍历
    while (front < rear) {
        // 当前队列里的元素个数,就是“该层”的节点总数
        int currentLevelSize = rear - front;

        // 为当前层分配内存
        res[*returnSize] = (int*)malloc(sizeof(int) * currentLevelSize);
        // 记录当前层的节点数
        (*returnColumnSizes)[*returnSize] = currentLevelSize;

        // 【内层循环】:一次性把当前层的所有节点全部处理完
        for (int i = 0; i < currentLevelSize; i++) {
            // 出队
            struct TreeNode* node = queue[front++];
            // 存入当前层的结果数组中
            res[*returnSize][i] = node->val;

            // 将下一层的节点(左右孩子)入队
            if (node->left != NULL) {
                queue[rear++] = node->left;
            }
            if (node->right != NULL) {
                queue[rear++] = node->right;
            }
        }
        // 当前层处理完毕,层数 +1
        (*returnSize)++;
    }

    return res;
}
在上面这段 层序遍历 的代码中,存在两个重要循环,即:外层 while + 内层 for 循环。
-
锁定“当前层”的边界
int currentLevelSize = rear - front;
当外层 while 循环刚开始时,此时队列刚好且只有某一层的全部节点。 例如第一层只有根节点,此时 rear - front 就是 1。就将此数值存入 currentLevelSize。
-
内层
for循环:处理当前层,处理下一层for (int i = 0; i < currentLevelSize; i++) { // 1. 拿出一个当前层的节点 (出队) struct TreeNode* node = queue[front++]; // 2. 存入结果数组 res[*returnSize][i] = node->val; // 3. 把它的左右孩子(也就是下一层)塞入队列尾部 (入队) if (node->left != NULL) queue[rear++] = node->left; if (node->right != NULL) queue[rear++] = node->right; } -
下一层到来
- 当前层的节点已经被全部移出队列(
front追上rear)。 - 下一层的所有节点,已经在
for循环的过程中,排在队列的后半段。 此时,(*returnSize)++(层数加一),然后回到while的开头,再次计算rear - front,即可计算出全新一层的节点总数。
- 当前层的节点已经被全部移出队列(
-
简单示例
假设我们存在一个简单的二叉树:1 / \ 2 3
- 初始:
queue = [1], front = 0, rear = 1。 - 第 1 次
while循环 (处理第 0 层):
currentLevelSize = 1 - 0 = 1,队列中存在 1 个元素。
进入for循环(只跑 1 次):- 节点 1 出队。
- 节点 1 的孩子 (2, 3) 入队。
结束for循环。此时queue = [1(已出), 2, 3], front = 1, rear = 3。层数returnSize变成 1。
- 第 2 次
while循环 (处理第 1 层):currentLevelSize = 3 - 1 = 2。说明这一层有 2 个元素。- 进入
for循环(要跑 2 次):- 第 1 次:节点 2 出队,没有孩子,无节点入队。
- 第 2 次:节点 3 出队,没有孩子,无节点入队。
- 结束
for循环。此时queue = [1, 2, 3(均已出)], front = 3, rear = 3。
- 第 3 次
while循环:front == rear (3 == 3),说明队列空了,循环结束。
需要说明的是,本文的层序遍历代码中使用了线性数组来模拟队列,因此需要分配一个足够大的数组空间。若读者为了节省内存,可以使用循环队列(或环形数组)来复用已出队节点的空间。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)