labview yolov5 tensorrt(wangxingyu版)推理,封装dll, l...
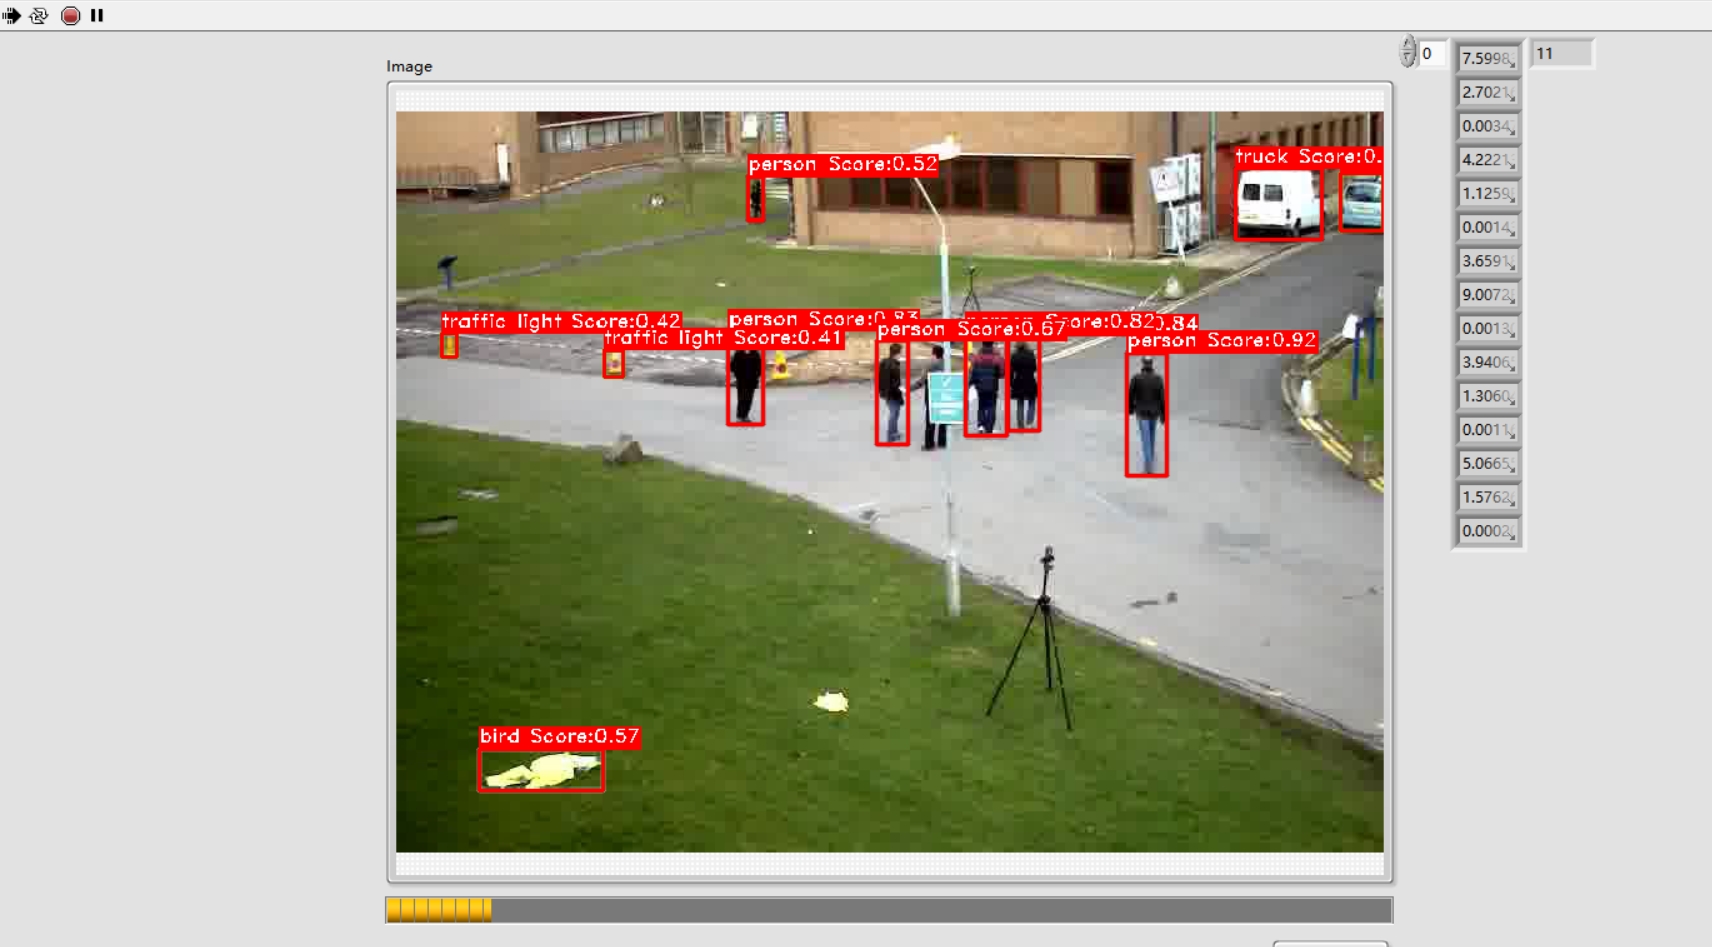
labview yolov5 tensorrt(wangxingyu版)推理,封装dll, labview调用dll,支持同时加油多个模型并行推理,识别视频和图片,速度6ms内,模型需要pt->wts->engine, 由于不同电脑和平台需要重新wts->engine,所以包含一个wts模型转engine软件,只需要替换模型的engin和nameclass即可
这次折腾的是LabVIEW结合YOLOv5和TensorRT的高性能推理方案。别看LabVIEW长得像儿童编程玩具,配合C++ DLL玩起多模型并行推理,速度直接干到6ms以内,摄像头实时处理完全没压力。
模型转换踩坑记
YOLOv5的pt模型转TensorRT engine是个技术活。wangxingyu版的转换脚本比官方方案更适配LabVIEW环境,不过要注意模型输出层的命名规范。举个栗子:
with open('yolov5s.wts', 'w') as f:
    f.write('{}\n'.format(len(model.state_dict().keys())))
    for k, v in model.state_dict().items():
        vr = v.reshape(-1).cpu().numpy()
        f.write('{} {} '.format(k, len(vr)))
        f.write(' '.join(['%f' % x for x in vr]) + '\n')
这段代码把PyTorch的权重拍平成文本格式,注意reshape(-1)可能会改变某些层的维度顺序,遇到推理异常先检查这里。
DLL封装那些事儿
C++侧用了双缓冲+内存共享的黑科技处理多模型并行。核心推理函数长这样:
__declspec(dllexport) void InferParallel(
    unsigned char* img_data,
    int model_index,
    Result* results)
{
    auto& context = g_contexts[model_index]; // 不同模型实例隔离
    cudaMemcpy(context.input_buffer, img_data, INPUT_SIZE, cudaMemcpyHostToDevice);
    context.stream->infer(); // 异步流执行
    post_process(context.output_buffer, results); // 零拷贝结果回传
}
重点在于每个模型有自己的cuda流和内存空间,避免多线程打架。LabVIEW调用时通过模型索引切换,实测开4个模型也能稳定在15ms内。
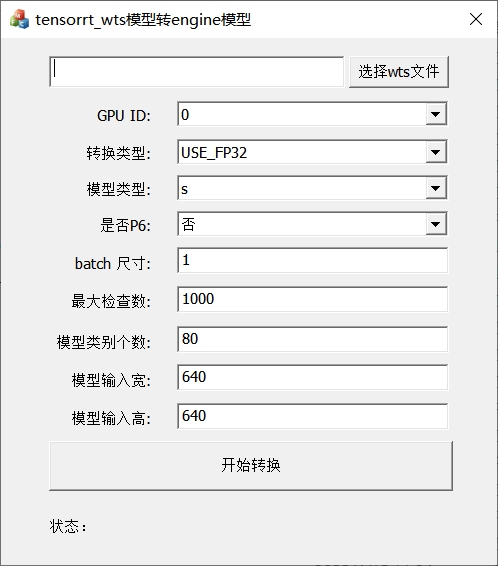
labview yolov5 tensorrt(wangxingyu版)推理,封装dll, labview调用dll,支持同时加油多个模型并行推理,识别视频和图片,速度6ms内,模型需要pt->wts->engine, 由于不同电脑和平台需要重新wts->engine,所以包含一个wts模型转engine软件,只需要替换模型的engin和nameclass即可
LabVIEW调教指南
前面板放个多线程队列处理器,配合DLL的异步接口直接起飞:
While循环(并行)
   Dequeue获取图像数据
   调用库函数节点(DLL路径, "InferParallel")
   结果分析Cluster解包
   图像标注叠加
End循环
注意设置执行选项为"在UI线程外运行",否则前面板会卡成PPT。视频流处理建议用生产者-消费者结构,DMA传输能省30%时间。
手搓转换工具
由于TensorRT engine和CUDA版本强相关,我们搞了个傻瓜式转换器(C# WinForm)。核心转换命令:
trtexec --onnx=yolov5s.onnx --saveEngine=yolov5s.engine --fp16 --workspace=4096工具自动替换模型名称和类别文件,支持拖拽操作。实测不同显卡生成engine速度差异极大,RTX4090转换比1060快8倍你敢信?
整套方案在工业质检场景跑了三个月,日均处理20万张图片没翻车。要说遗憾就是LabVIEW的异常处理比较蠢,C++侧得自己加内存泄漏检测。最近在研究用OpenVINO替代TensorRT,等有进展再来唠。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)