c语言之蓝桥杯
小猫取名【新生编程赛】
问题描述
小蓝最近喜添一只可爱的小猫,正为给它取一个长度恰好为 6 的名字而绞尽脑汁。为了集思广益,他邀请了 66 位朋友帮忙,每位朋友各自想一个单词。小蓝计划将这 6 个单词的首字母按顺序拼接起来,组成小猫的名字。
朋友们提供的单词分别记为 W1,W2,W3,W4,W5,W6W1,W2,W3,W4,W5,W6。例如,朋友们提供的单词依次是 agile,brave,cute,delightful,energetic,fluffy,那么小猫的名字将是 "abcdef"。
现在,请你编写一个程序,根据朋友们提供的单词,生成小猫的名字。
输入格式
输入共 6 行,每行包含一个长度不超过 10、仅由小写字母构成的字符串,表示朋友提供的单词。
输出格式
输出一个长度为 6 的字符串,表示小猫的名字。
样例输入
agile
brave
cute
delightful
energetic
fluffy
样例输出
abcdef
方法一:【在系统里通过不了,代码是对的,只是没有进行存储,写出来,只是为后边的方法进行理解。】
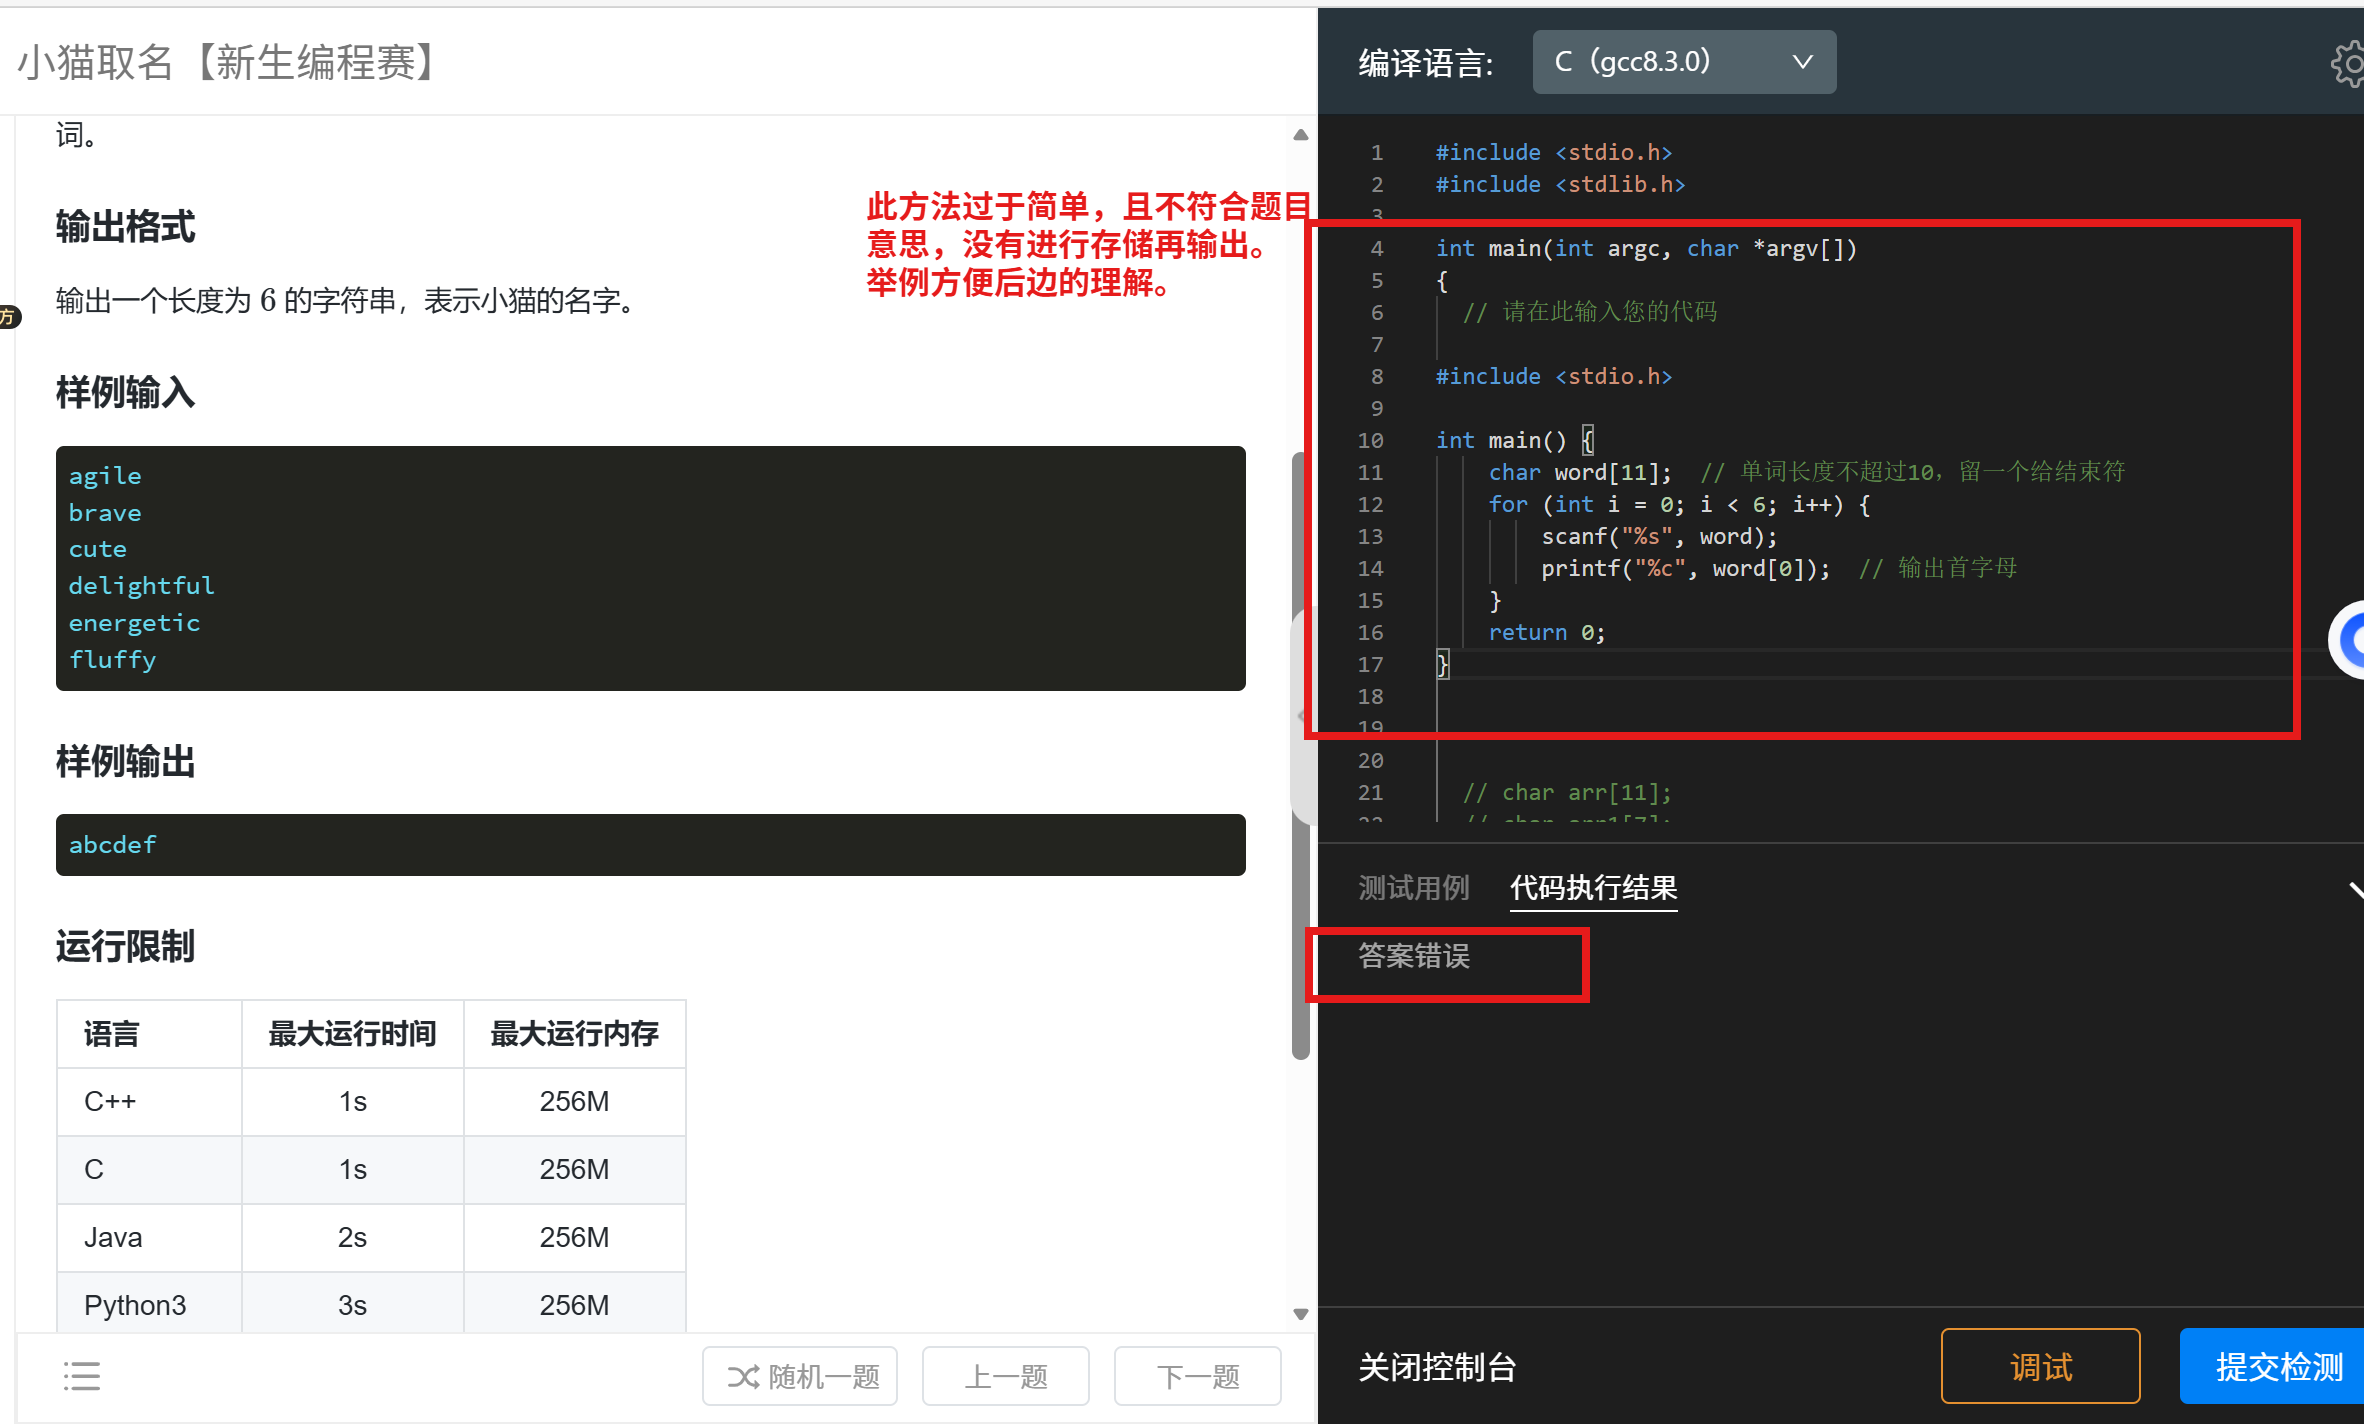
逐步输出:读取 6 行单词,将每个单词的首字母按顺序拼接成字符串输出。
实现方法非常简单:
-
循环 6 次,每次读一个字符串。
-
立即输出该字符串的第一个字符(或者先存到结果数组再统一输出)。
因为输入只有 6 行,可以边读边输出,无需额外存储。
#include <stdio.h>

int main() {
    char word[11];  // 单词长度不超过10,留一个给结束符
    for (int i = 0; i < 6; i++) {
        scanf("%s", word);
        printf("%c", word[0]);  // 输出首字母
    }
    return 0;
}
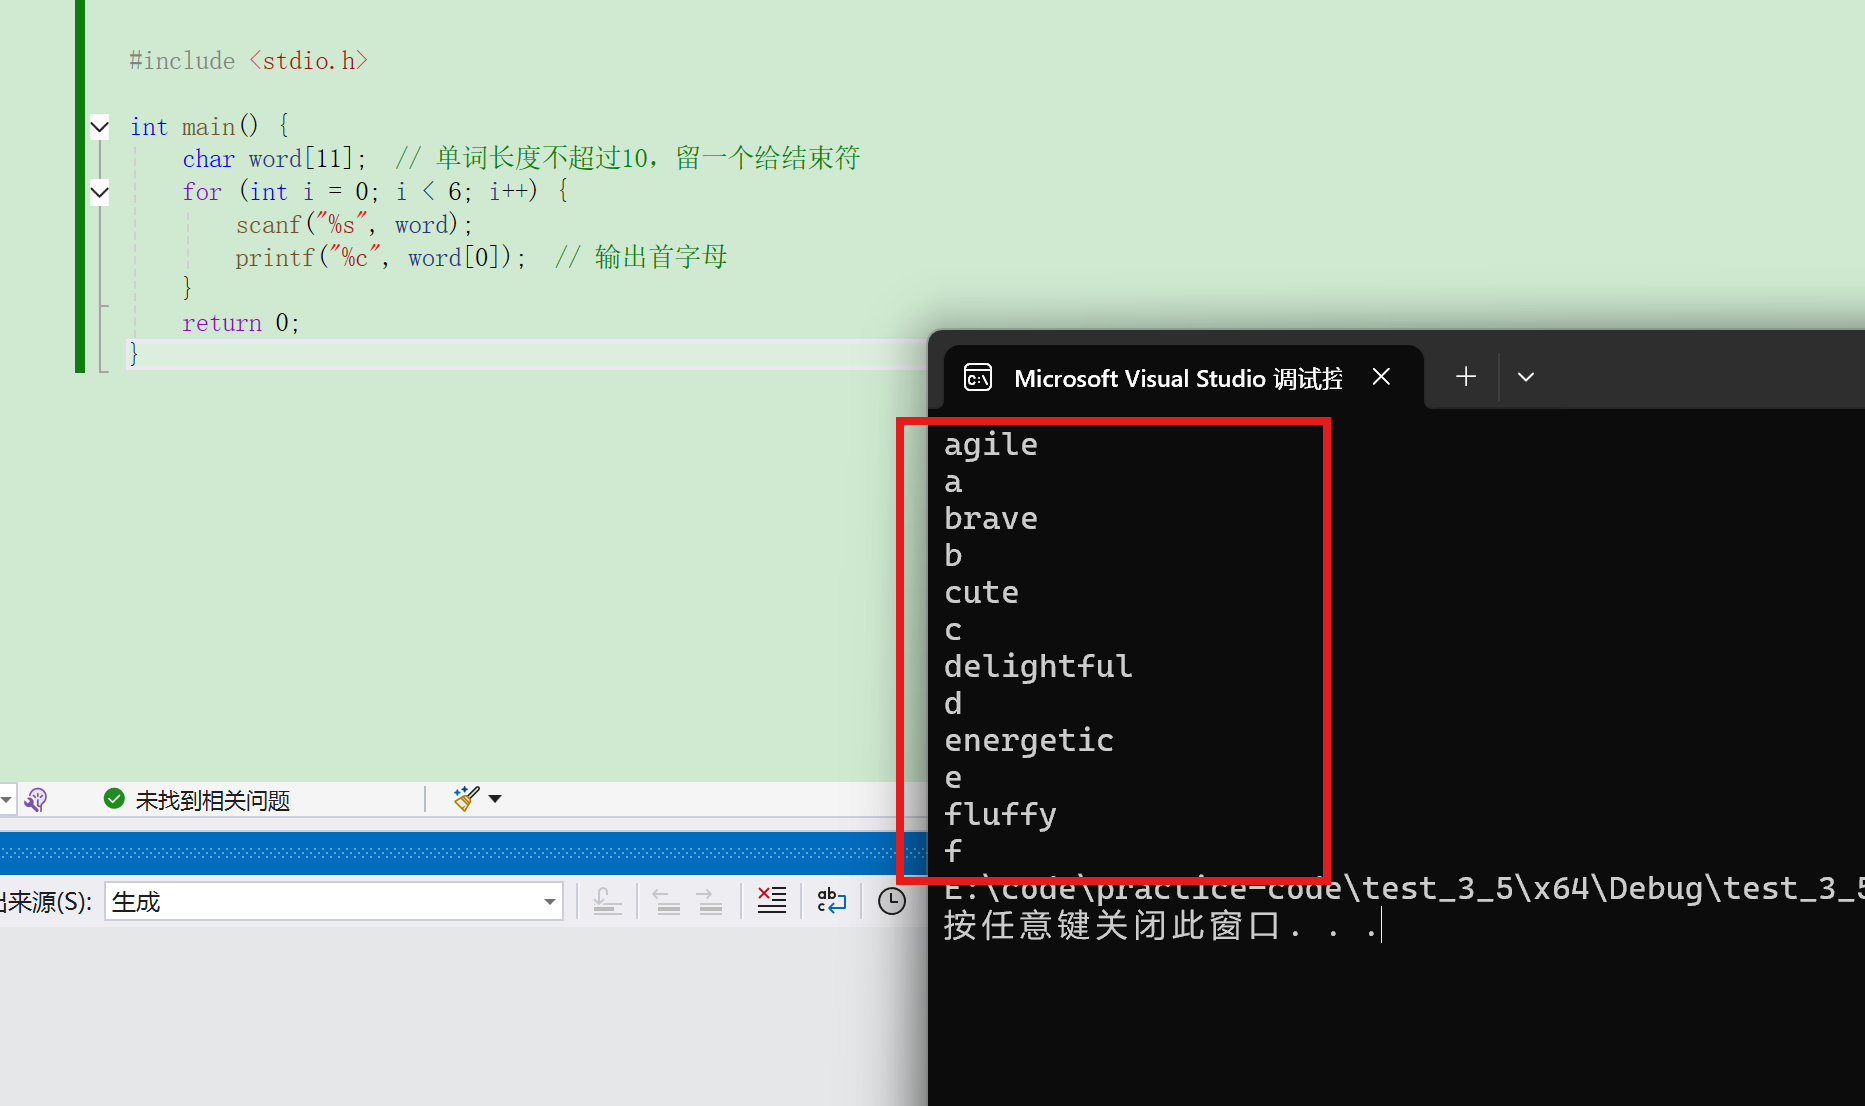
代码说明:
-
char word[11]用于暂存每个单词。 -
循环 6 次,每次用
scanf读取一个单词。 -
word[0]就是单词的首字母,用%c格式输出字符。 -
循环结束后,6 个首字母已按顺序输出,构成小猫的名字。
方法二:【先输入所有单词,最后一次性输出结果;先存储,后输出】
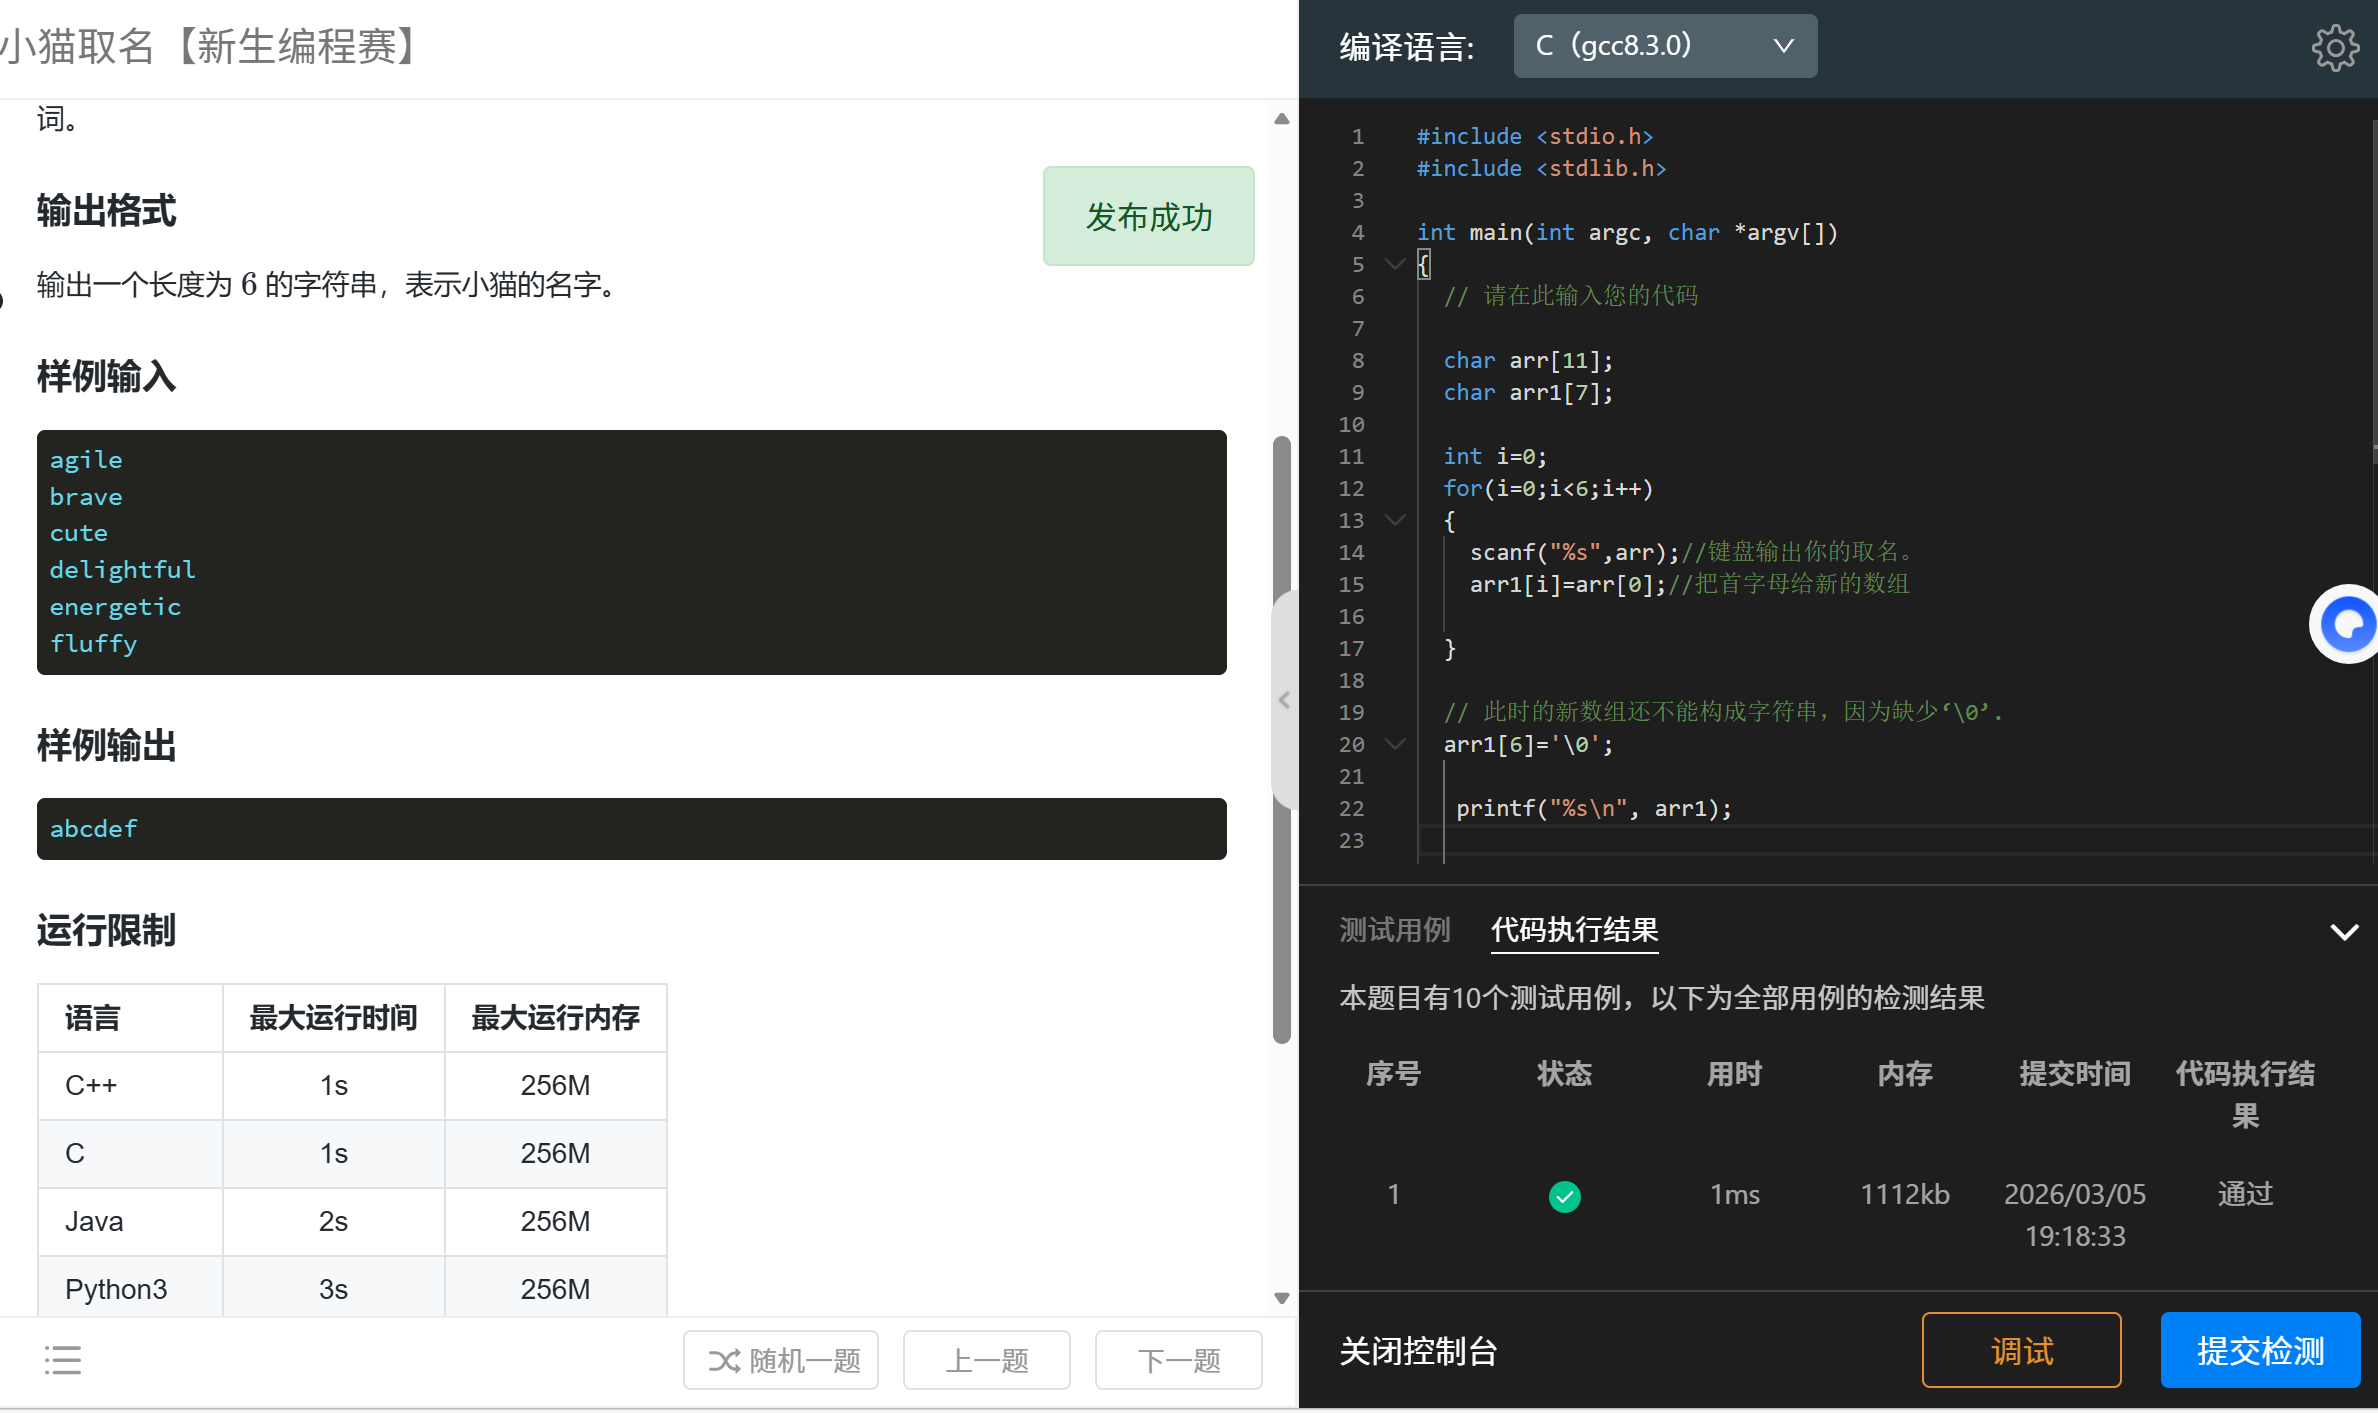
每个单词的首字母保存起来,等6个单词都读完后再统一输出。
#include <stdio.h>

int main() {
    char word[11];          // 临时存储每个单词
    char result[7];         // 用于存储6个首字母,多留一个位置给字符串结束符'\0'

    for (int i = 0; i < 6; i++) {
        scanf("%s", word);
        result[i] = word[0]; // 将首字母存入结果数组
    }
    result[6] = '\0';        // 添加字符串结束符,使其成为字符串

    printf("%s\n", result);  // 一次性输出结果
    return 0;
}
思路:
先得得到六个单词,然后还得有六个首字母;
所以先定义两个字符数组。一个用来存储单词,一个用来存储首字母。
【有点像扫雷里面对雷与棋子的布置。一个用来呈现给用户,一个用来布置。】
然后输入的单词需要得到他的首字母,而首字母刚好就是数组的首地址,用另外定义的字符数组存储起来,放在里面,等循环结束后,一起输出。
【需要注意此时的存储首字母的元素不够完整,构成不了字符串,
因为字符串必须是以‘\0’,结尾的,
而且我们前面也只是定义了字符数组并没有初始,所以里面的值是由循环决定的。】
代码:
#include <stdio.h>
int main() {
char word[11]; // 临时存储每个单词
char result[7]; // 用于存储6个首字母,多留一个位置给字符串结束符'\0'
for (int i = 0; i < 6; i++) {
scanf("%s", word);
result[i] = word[0]; // 将首字母存入结果数组
}
result[6] = '\0'; // 添加字符串结束符,使其成为字符串
printf("%s\n", result); // 一次性输出结果
return 0;
}j解析:
char word[11];
为什么是11?
题目规定每个单词长度不超过10,因此需要至少10个字符的数组来存储单词内容,加上C语言字符串末尾必须有一个空字符\0作为结束标志,所以数组大小至少为 10+1 = 11。作用:
word是一个临时缓冲区,每次循环读入一个单词就存放在这里,下一次循环会被新单词覆盖。2.
char result[7];
为什么是7?
需要存储6个首字母,每个首字母占一个字符,最后还要加上一个字符串结束符\0,因此总长度是 6+1 = 7。作用:
result用于保存最终要输出的6个字母组成的字符串。注意它不是用来存储单词本身,而是专门存放提取出的首字母。3.
for (int i = 0; i < 6; i++)循环
为什么循环6次?
题目明确要求输入6个单词,因此循环次数固定为6。循环体内:
scanf("%s", word);
读取一个单词(以空白符分隔),存入word数组。
result[i] = word[0];
将当前单词的第一个字符(即word[0])赋值给result数组的第i个位置。这样,第一次循环存入result[0],第二次存入result[1],依此类推,保证了首字母的顺序与输入单词顺序一致。4.
result[6] = '\0';
为什么必须加
\0?
在C语言中,字符串是以\0结尾的字符数组。如果不加结束符,printf("%s", result)就无法知道字符串在哪里结束,可能会继续输出内存中后面的随机内容,导致错误。因此必须手动在最后一个有效字符后面放置一个空字符。为什么下标是6?
因为result的有效数据是下标0~5(共6个字符),所以下标6的位置恰好是第7个元素,用来存放\0。5.
printf("%s\n", result);
为什么用
%s而不用循环输出每个字符?
%s格式符可以直接打印一个以\0结尾的字符串,代码更简洁高效。由于我们已经正确构造了result字符串,这一行就能一次性输出结果,并换行。
方法三:【用二维数组实现,先存储,后输出】
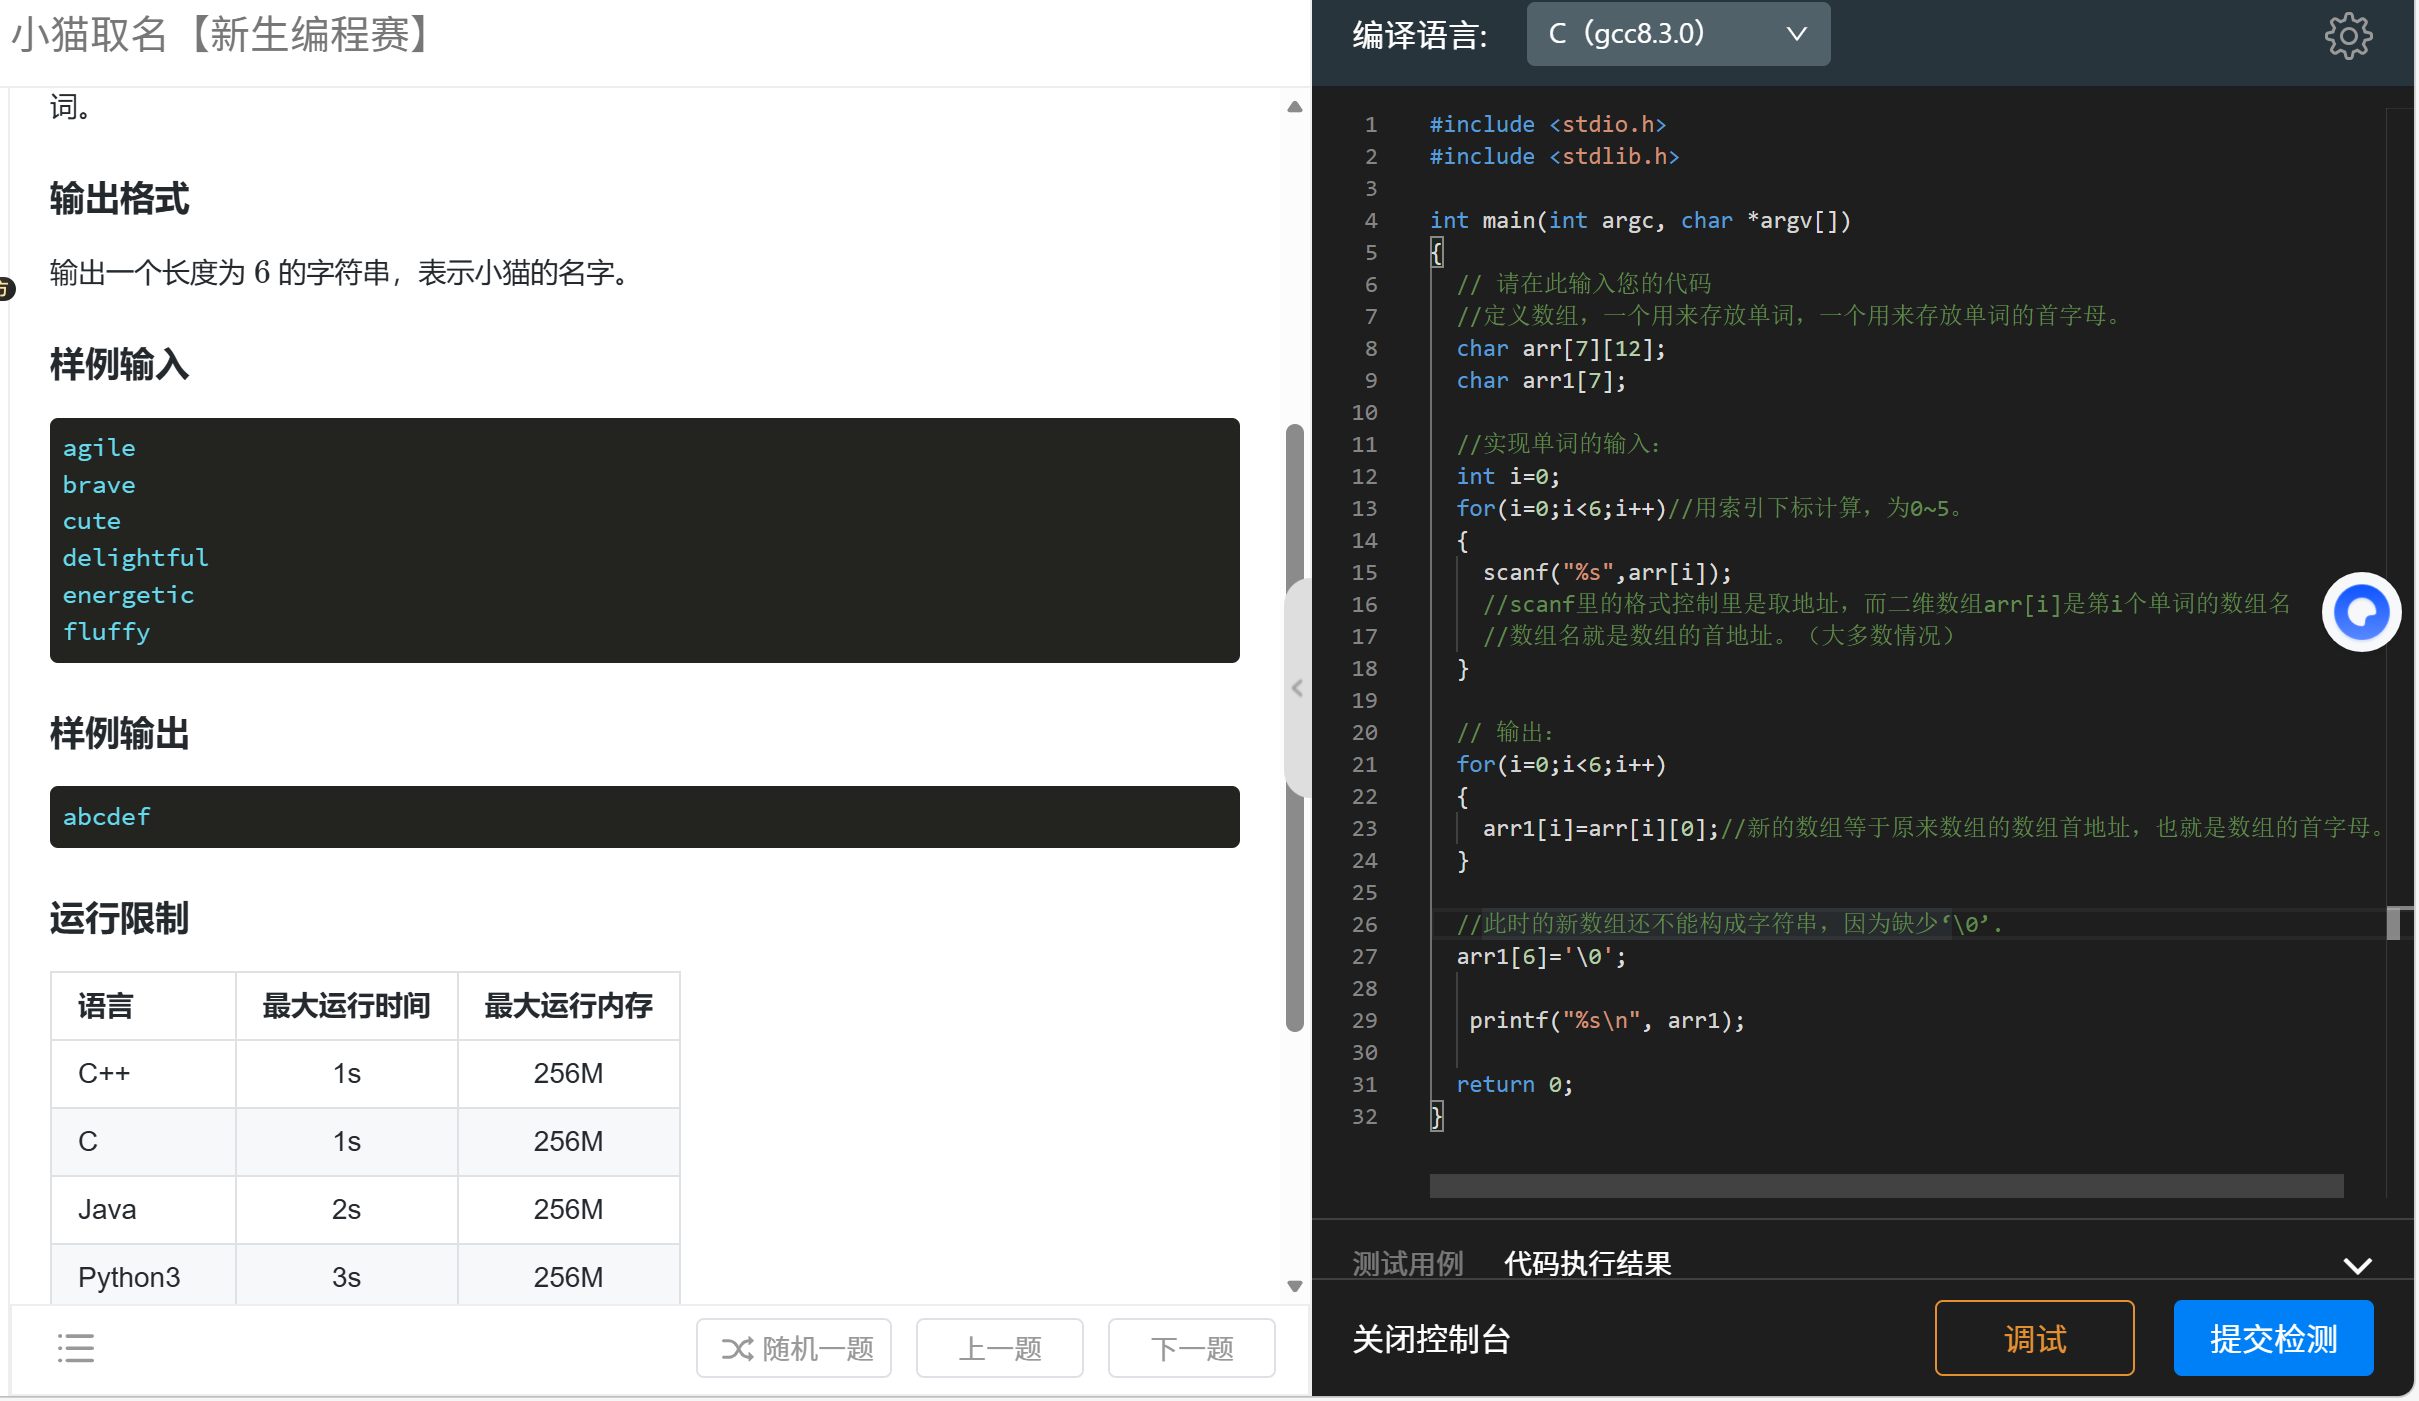
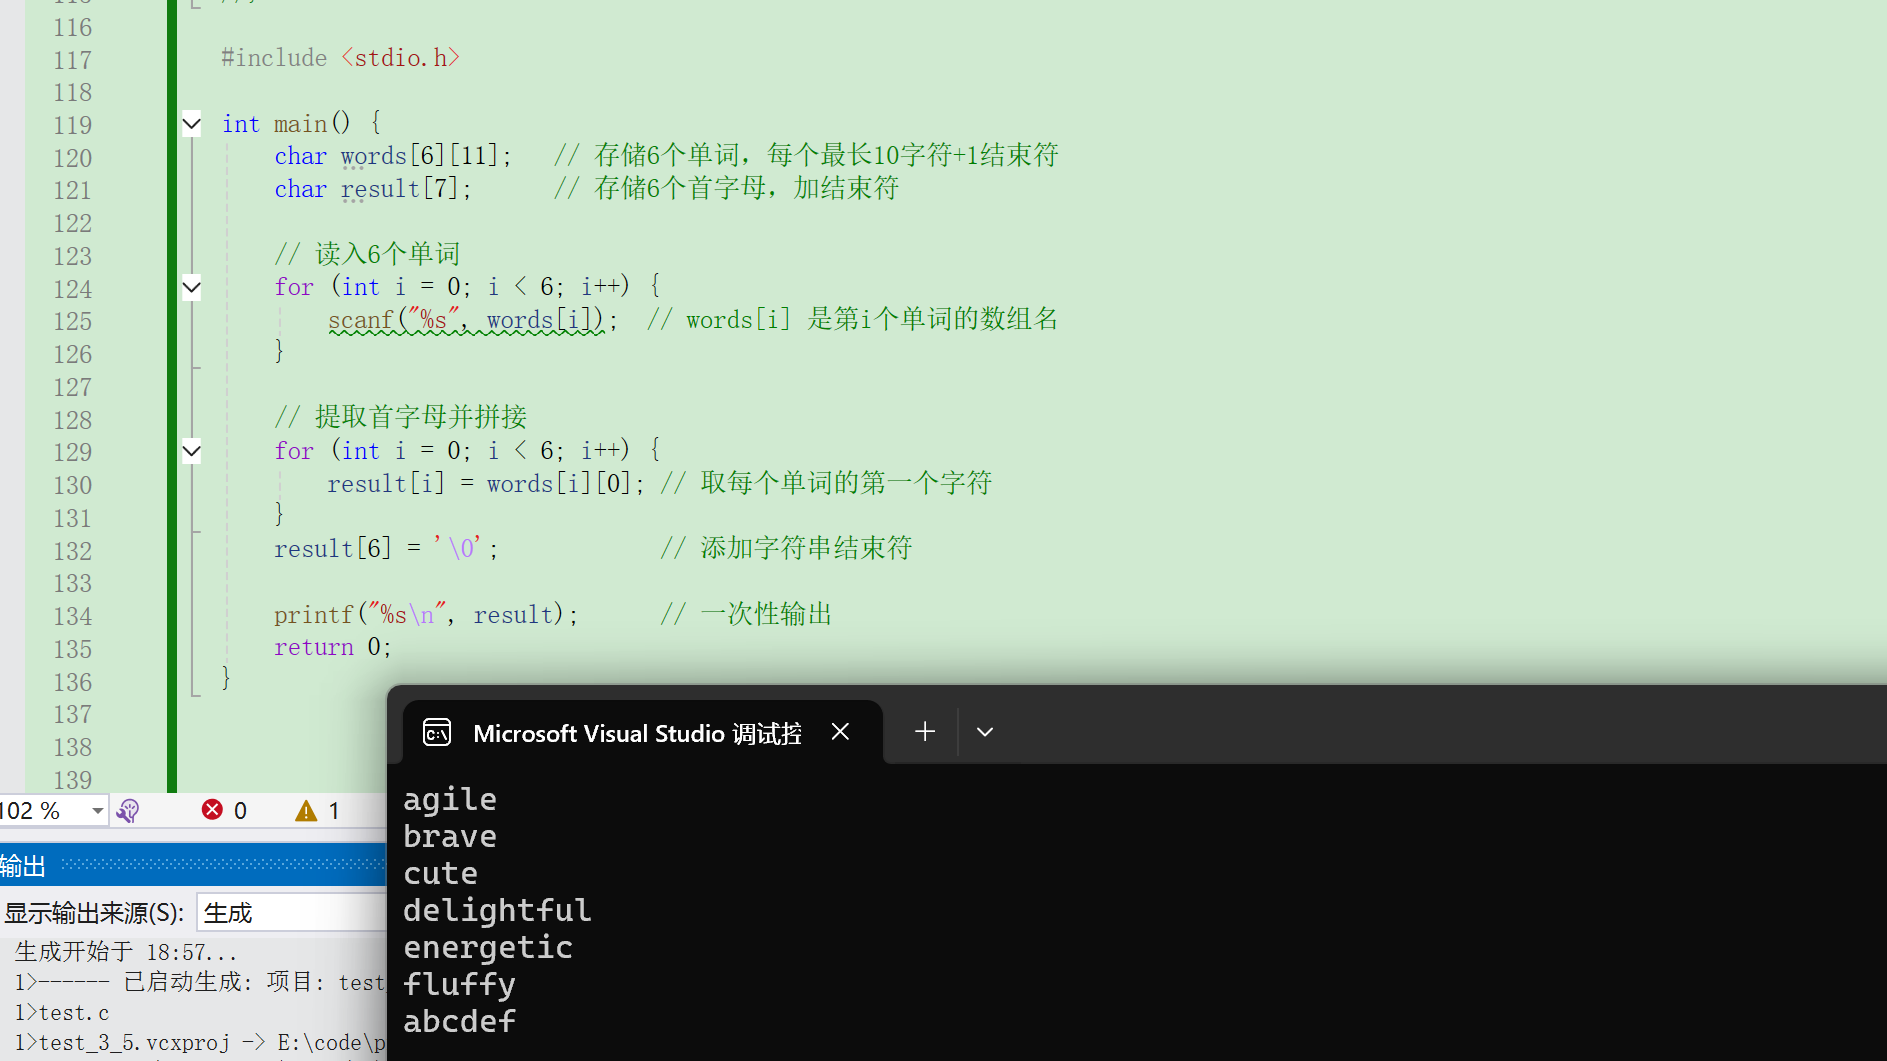
目标:读入6个单词 → 取每个单词的首字母 → 拼接成结果输出。
代码:
#include <stdio.h>
int main() {
char words[6][11]; // 存储6个单词,每个最长10字符+1结束符
char result[7]; // 存储6个首字母,加结束符// 读入6个单词
for (int i = 0; i < 6; i++) {
scanf("%s", words[i]); // words[i] 是第i个单词的数组名
}// 提取首字母并拼接
for (int i = 0; i < 6; i++) {
result[i] = words[i][0]; // 取每个单词的第一个字符
}
result[6] = '\0'; // 添加字符串结束符printf("%s\n", result); // 一次性输出
return 0;
}#include <stdio.h> int main() { char words[6][11]; // 存储6个单词,每个最长10字符+1结束符 char result[7]; // 存储6个首字母,加结束符 // 读入6个单词 for (int i = 0; i < 6; i++) { scanf("%s", words[i]); // words[i] 是第i个单词的数组名 } // 提取首字母并拼接 for (int i = 0; i < 6; i++) { result[i] = words[i][0]; // 取每个单词的第一个字符 } result[6] = '\0'; // 添加字符串结束符 printf("%s\n", result); // 一次性输出 return 0; }解析:
1. 为什么需要二维数组?
题目要求读取6个单词,并且后面要提取每个单词的首字母。
如果只用一个一维字符数组(比如
char word[11]),那么每次读入新单词时,原来的单词会被覆盖掉,最后只能得到最后一个单词。为了同时保留所有6个单词,我们需要一个能够存储多个字符串的数据结构,这就是二维数组。
2. 二维数组的定义
char words[6][11];
words是一个二维数组。第一个维度
6表示有6个元素,每个元素都是一个一维数组(即一个字符串)。第二个维度
11表示每个一维数组可以存储最多10个字符 + 1个结束符\0。可以这样理解:
words[0]是一个一维字符数组,用来存储第1个单词。
words[1]存储第2个单词。...
words[5]存储第6个单词。在内存中,这6个一维数组是连续存放的,但逻辑上我们可以把它们看作6个独立的字符串。
3. 如何访问每个单词?
words[i]表示第i个单词的数组名(即首地址),相当于一维数组的名字。因此,
scanf("%s", words[i])就是把输入的字符串存入第i个单词的位置。例如,第一次循环
i=0,scanf将第一个单词存入words[0];第二次i=1存入words[1],以此类推。4. 如何提取首字母?
words[i][0]表示第i个单词的第一个字符。因为
words[i]是一个一维数组,words[i][0]就是该数组的第一个元素,即首字母。在第二个循环中,将每个单词的首字母依次赋值给
result[i],最终result数组就包含了6个首字母。5. 对比你最初的一维数组思路
你最初只定义了一维数组
char s[100],试图用它存储所有单词,但这只能存一个字符串。二维数组正是解决“存储多个字符串”问题的标准方法。
二维数组 words 在内存中的布局大致如下:
| words[0] | a | g | i | l | e | \0 | ... |
|---|---|---|---|---|---|---|---|
| words[1] | b | r | a | v | e | \0 | ... |
| words[2] | c | u | t | e | \0 | ... | ... |
| words[3] | d | e | l | i | g | h | tful\0...(实际会占满11个,但这里简化) |
| words[4] | e | n | e | r | g | e | tic\0... |
| words[5] | f | l | u | f | f | y | \0... |
每个 words[i] 都是一个以 \0 结尾的字符串。提取首字母即取每行的第一个字符:words[0][0]='a', words[1][0]='b', ... 得到 result = "abcdef"。
二维数组 char words[6][11] 在这里用于存储6个独立的单词,每个单词最多10个字符加一个结束符。你可以把它想象成一个表格,有6行,每行是一个单词。words[i] 表示第 i 行(第 i 个单词),words[i][0] 就是该行的第一个字符(首字母)。这样就能同时保留所有单词,便于后续提取首字母。
补充:
一维数组的局限
-
一维数组
char s[100]只能存放一个字符串(比如"agile")。 -
再次用
scanf("%s", s)读入"brave"时,"agile"就被覆盖了,s里只剩"brave"。 -
如果不在读入时立即处理,后面的单词就会丢失前面的信息。
二维数组的作用
-
二维数组
char words[6][11]相当于 6 个独立的一维数组,每个可以存放一个单词。 -
words[0]存放第一个单词,words[1]存放第二个单词,…… 互不干扰。 -
这样输入结束后,6 个单词都还在,你可以再遍历它们提取首字母。
完成后的思考与总结:
1️⃣ 基础语法
-
变量定义:如
char s[100005];int i;,理解不同类型(char,int)的用途。 -
输入输出:
-
scanf("%s", 数组名)读取字符串(注意不加&,因为数组名已是地址)。 -
printf的正确格式:输出字符串用%s,输出单个字符用%c,输出整数用%d。
-
-
循环控制:
for循环的初始条件、终止条件、步进;避免循环体内随意修改循环变量。 -
条件判断:
if/else if判断字符范围('a'<=c && c<='z'等)。
2️⃣ 数组与字符串
-
一维字符数组:用来存储一个字符串,必须预留
'\0'的位置(如char word[11]存最多10个字符)。 -
字符串结束符
'\0':C 语言字符串的标志,输出(printf("%s"))和库函数(strlen)都依赖它。忘记加\0会导致输出乱码或错误。 -
二维字符数组:用来存储多个字符串,如
char words[6][11],每个words[i]是一个一维数组,可独立存放一个单词。 -
数组名与指针:数组名在大多数场合代表首地址,但要注意
sizeof和&时的特殊含义(不过对初学者,先记住“数组名是首地址”即可安全使用)。
3️⃣ 逻辑思维与算法设计
-
分步思考:先做什么、后做什么。例如“先读单词,再取首字母,最后输出”。
-
两种常用模式:
-
边读边处理:循环中直接对当前输入进行处理,节省空间,效率高(如第一题替换字符,第二题边读边存首字母)。
-
先存后处理:用二维数组保留所有数据,之后再遍历处理(适合需要对所有数据二次操作的场景)。
-
-
边界条件:循环次数(6次)、数组下标(0~5)、结束符位置(下标6)。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献1条内容

所有评论(0)