从一到无穷大 #63 谁才是时序数据库在可观测领域真正的对手?
 本作品采用知识共享署名-非商业性使用-相同方式共享 4.0 国际许可协议进行许可。
本作品 (李兆龙 博文, 由 李兆龙 创作),由 李兆龙 确认,转载请注明版权。
文章目录
引言
做一款产品,第一步是什么?
针对问题,设定清晰、可衡量的目标。而设置目标的过程中一个最大的陷阱就是贪心,既要做这个,又要做那个,最终就是一个也做不好。那么如何去定目标?
以时序数据库举例子,在这个高度同质化的产品中,什么才是一个即合理又有挑战的目标?首先我们要搞清楚竞争对手。
在可观测性基础设施的讨论中,友商的PR稿往往习惯于罗列产品、比较功能、对照 benchmark,仿佛只要把市场上的名字摆在一起,竞争关系便不言自明。但这种讨论方式,很容易掩盖一个更根本的问题:
在当下的技术条件与产业环境下,时序数据库真正需要正视的对手,究竟是谁?
如果不先回答这个问题,那么后续所有讨论就容易陷入“见招拆招”的被动状态:业务遇到了某个痛点问题,修一下;看到某个数据库加了新索引,补一个;某个平台支持了新缓存,跟一个;最终产品边界不断扩张,却越来越难回答“我是谁”
因此,本文试图从技术本质出发,重新审视时序数据库在可观测领域中的竞争格局,以此推断出作为一款时序数据库,我们的目标到底是什么?
时序数据库是什么?
如果剥离场景修饰和产品包装,时序数据库的技术本质并不复杂:即一种以时间为第一组织维度、面向高写入吞吐与实时&近实时查询的 AP 系统。
围绕这一核心目标,时序数据库确实在垂直场景中做了大量“针对性优化”(非物化视图、Rollup、查询缓存等通用优化),例如:
- 特化索引,特化Cache
- 面向典型查询模式的执行优化(单车、单设备、单实例、多实例聚合)
- 垂直场景需求:重复数据、乱序、延迟到达
- 有损压缩、特化的压缩方式
- 对应物联网和车联网的边云一体
- MQTT、InfluxDB Line Protocol、OTLP、OpenTSDB、Prometheus RemoteWrite、MySQL、PG等写入协议支持
- PromQL、InfluxQL、SQL等查询协议支持
但需要明确的是,这些优化本身,并没有改变系统本质,只是让它在某些场景下更优、更容易接入。这也意味着,当应用场景开始发生变化——例如查询模式更复杂、写入维度更多、数据关联更广——竞争的边界就会自然外溢。
类似于熵增的趋势,各类数据库产品的能力在不断收敛、差异逐渐被抹平。热力学第二定律告诉我们,在一个相对封闭的系统里,能量和信息的梯度会逐渐耗散,最终达到一种平衡状态。映射到数据库领域,这意味着一旦某些功能被市场验证,各家产品就会相继补齐这些功能,把自己从最初的“高度差异化”拉回到“能力均匀化”的均衡位置。
简而言之,现状是我看到时序数据库和通用分析系统的能力越来越一致,以致于已有份额往往不是被同类时序时序数据库蚕食,而是被更广义的AP分析系统、数据湖、搜索平台、宽表等系统逐步抢占。
考虑到这种熵增效应,我想先厘清时序数据库关注的目标领域与场景:包括车联网、物联网、互联网服务、金融、serverless计费等领域、AI,它们都会产生大量时间序列数据。在这些领域里,最典型的应用场景是实时指标监控(Monitoring)、日志检索(Logging)、分布式追踪(Tracing)和持续性能分析(Profiling)。
- 车联网&物联网指标监控:每辆车持续上报速度、位置、温度、电量等指标,Schemaless、数据量庞大、查询实时性要求高、乱序重复写入、单车查询多、聚合操作少
- 互联网服务指标监控:Schemaless、数据量庞大、重复写入、随机多维筛选能力、存在多维聚合操作极多与极少的业务、维度元数据操作多、存在维度稳定和维度爆炸的不同业务、存在正则搜索、存在大规模分析查询;
- 日志 :正则搜索多、聚合操作少、扫描操作多、随机多维筛选能力、维度爆炸
- Tracing:正则搜索多、扫描操作多、按照TraceID,SpanId过滤多、存在随机多维筛选能力、维度爆炸
可以看到,日志 + Tracing和指标监控的业务场景逐渐模糊了。
竞争对手分类
在明确了目标场景后,我们发现真正的竞争对手往往不局限于“另一套时序数据库”,而是包括更广泛的系统:
- 传统/云原生时序数据库:IotDB、TDengine、Lindorm TSDB、华为云GeminiDB、GrepTimeDB、InfluxDB IOX、InfluxDB、VictoriaMetrics
- 实时AP引擎:Clickhouse、Doris、Druid、StarRocks
- 搜索引擎: Elasticsearch
- StreamHouse流式湖仓:Apache Paimon
- 宽表数据库:Lindorm宽表、HBase、Cassandra
上述竞争对手不仅来源于司外,司内各BG团队也在积极扩展边界,未来会形成正面竞争关系。下面我从技术维度逐类分析,说明为什么它们会成为竞争,以及各自的能力特征与优劣势。
传统/云原生时序数据库
从公司战略与主攻业务来讲,可以清晰的划分为三个阵营:
- GrepTimeDB、InfluxDB IOX:面向指标、日志、Trace的全链路可观测性解决方案
- IotDB、TDengine:凭借不俗的产品力、强大的销售能力与海量领域经验,IOT垂类领域王者,其他产品很难涉足
- InfluxDB、VictoriaMetrics、阿里云Lindorm TSDB、华为云GeminiDB、腾讯云CTSDB:面向通用metric监控的解决方案,不拘泥于IOT领域
不同的主攻业务形态导致了技术架构的差异。
全链路可观测性解决方案
GrepTimeDB、InfluxDB IOX采用Arrow、Parquet、Datafusion的统一开源技术栈,两个产品技术架构相差不大。
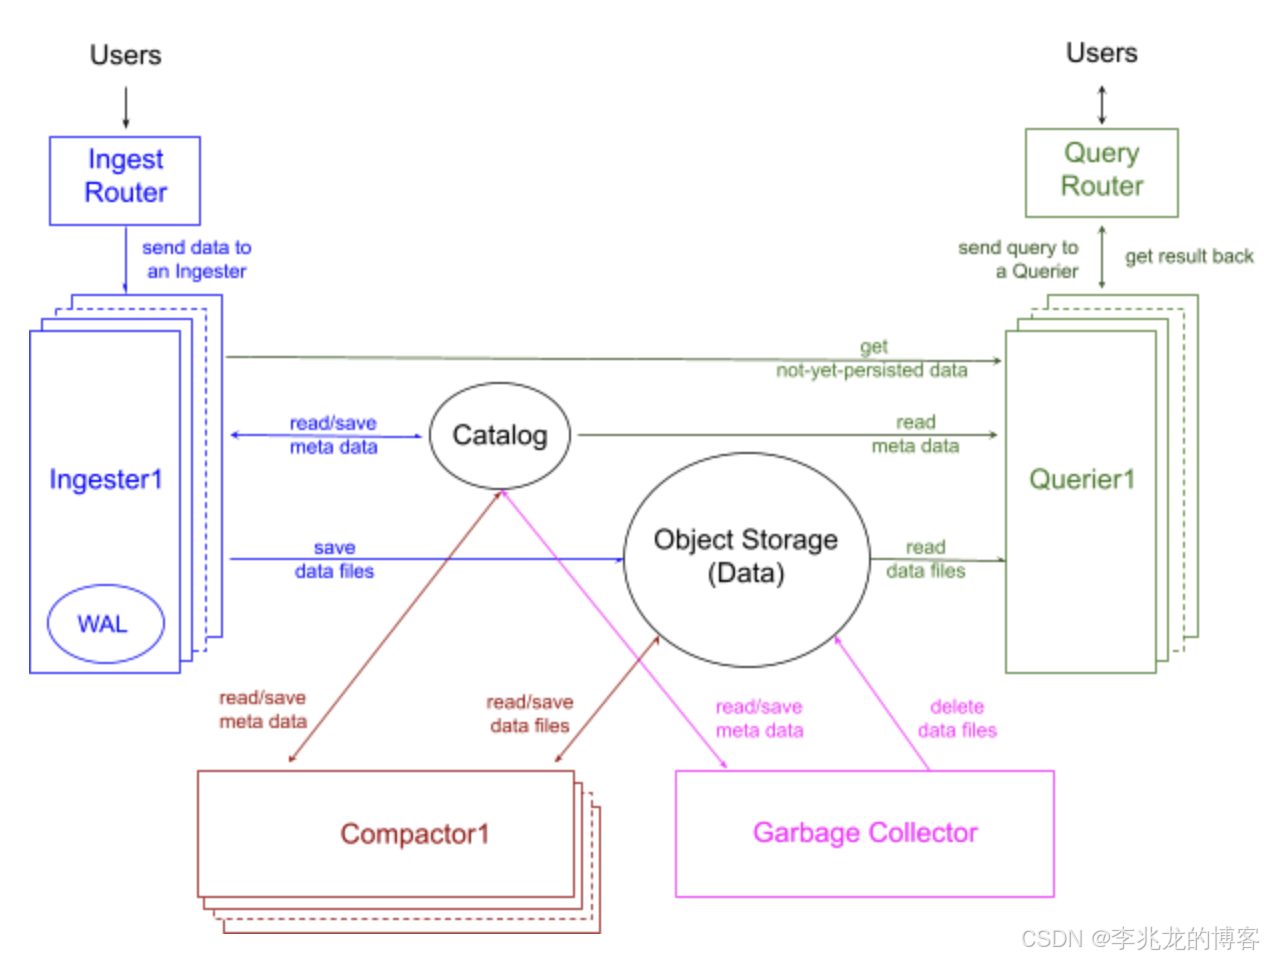
这套架构其实肉眼看过去很优秀,读写分离,读读分离,存算分离、没有冗余计算;使用Datafusion作为计算引擎,查询性能对齐Presto、DuckDB等老牌AP分析引擎;Parquet 作为存储格式,无限基数扩展。
但是实际有几个核心问题:
- 随机多维聚合操作性能低: 存储采用固定顺序排序,就算提供了倒排索引,查询时IO还是非常离散,比如存储排序为region、Database、Partition、ErrorCode、Timestamp、LSN如果select count(ErrorCode) from xxx where ErrorCode =xxx;这种情况下还是需要扫描无数个IO块,当然这里的本质在于还是时间线多值存储,单Field的数据就是会分布在多处。
- 实时性低:数据写入kafka就返回成功了,但是在写入Ingester前不可见,经验看时延可以到达15s[8]以上,而IOT、IOV场景对于实时性要求在ms以内,要求写入即可见。
- Parquet格式:存在IO放大,元数据解析开销高,查询宽列时内存问题等[9],存在Nimble,Lance,krypton等更优选择;parquet推进新的压缩算法阻力较大,压缩比上低于自研结构,且不支持有损压缩。
虽然我没看出来这样的架构做Log和Tace相对于ES和CK有什么好处,但是以GrepTimedb的PR文来看,虽然不多,其不同的业务还是有一些客户的:
- Metric:理想汽车、得物、贵阳机场
- Trace: 某出海物流电商
- Log:OB Cloud
- 端云一体:国家电网
IOT领域解决方案
以下是IotDB的存储格式TsFile。
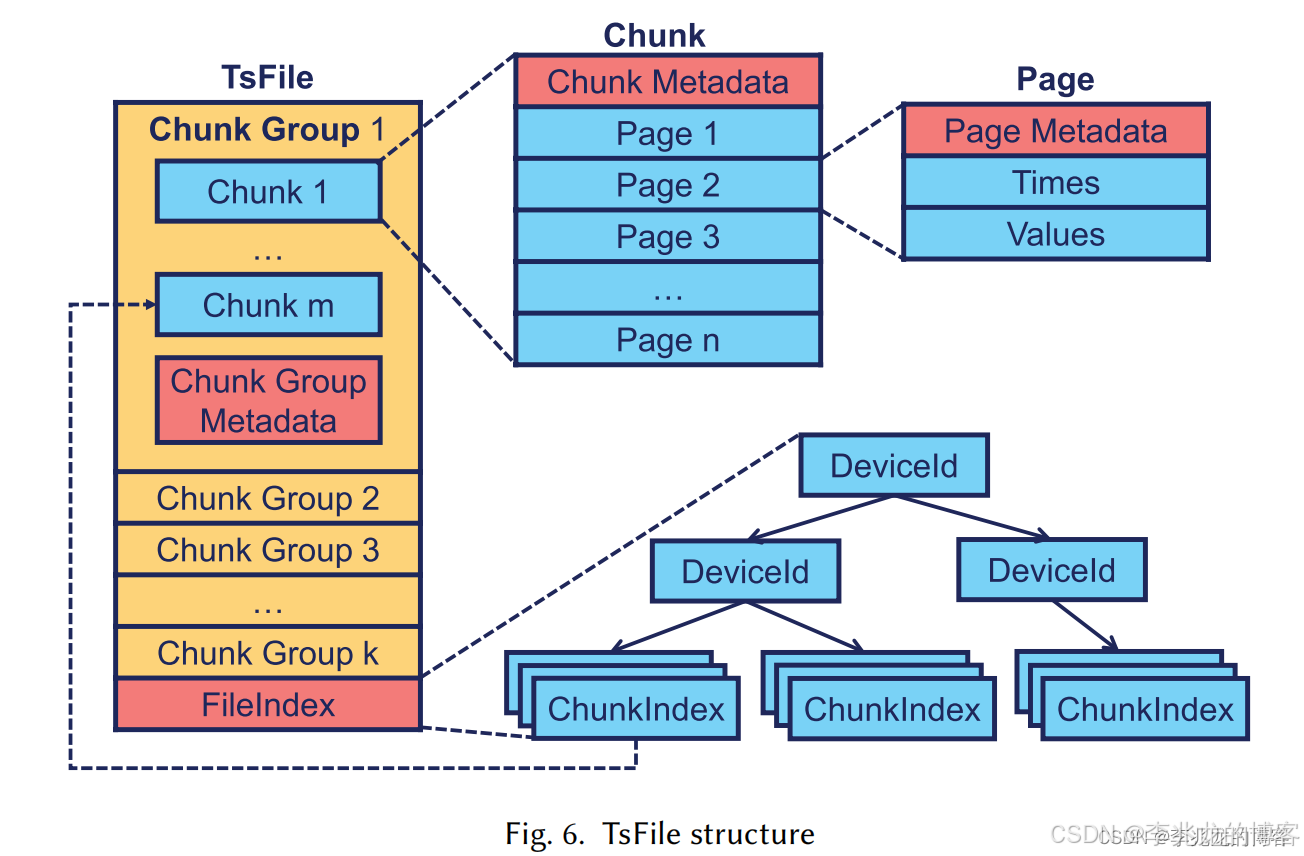
TsFile将设备ID存储为树状;而TDengine则通过超级表+子表的形式抽象设备;
TDengine中采用TDB(B+数)存储元数据,采用独立的存储引擎存储时序数据;
这里TsFile更加垂类,在时间线较低时非常优秀,而且依托于清华的学术能力,落地了不少看实验效果非常好的功能,但是这种格式在时间线爆炸时和非树状指标时基本不可用;
而TDengine则更加通用,但是因为TDB存储维度信息,仍然有维度爆炸的问题。
这里还有几个问题:
- 租户内大查询影响写和在线读,这是单机引擎的死穴
- 租户间互相影响,SQL很难像KV一样用RU去做限制,只要存在超卖租户间的影响就是不可避免的。
- 查询较多时间线时IO次数多。
- 和GrepTimedb一样,时序中实现一个不落盘的流计算引擎是一个很挫的做法,变版影响打,内存消耗大
但是这两家因为销售策略领先,和我们不是正面竞争对手。
通用metric监控的解决方案
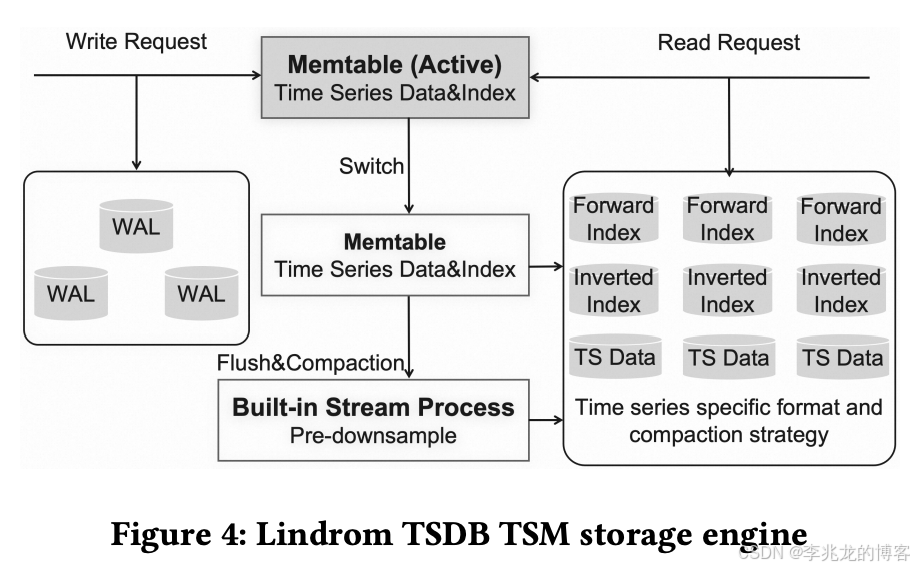
典型的由三部分构成,ForwardIndex、InvertedIndex、TsData;中国几家公有云的解决方案和 InfluxDB、VictoriaMetrics都是这样。这种架构的好处是对于互联网监控业务很友好,因为内置原生倒排索引,不需要依靠主键排序做筛选,随机多维筛选能力极强。
缺点也很明显,因为维度本身作为元数据的一部分,架构上无法处理维度爆炸的情况,时间线爆炸就会存储和性能双双提升。尤其是在没有RouteTag的时候单collection的分片数是有限的(读需要聚合的分片多),这也意味着这种架构下单Measurement的时间线是有上限的,此种架构不支持无限时间线,自然也没法支持Log和Trace了。
因为产品面向场景高度一致,这里属于公有云的首要竞对,更多是在成本、稳定性、兼容性(SQL、PromQL(尤其是VictoriaMetrics))、客情上的竞争,性能上没法做出数量级差异。
实时AP引擎
在文章开头我提到日志 + Tracing和指标监控的业务场景边界已经逐渐模糊,其实话只说了一半,事实上是可观测领域的技术诉求本质上就是实时分析应用,而计算引擎由于可组合式基础架构的影响,已经强行把所有玩家拉到一个终点线上,玩不出花来;差异点都在于数据组织、缓存、索引上的特殊优化,在xxx业务场景下,比xxx更快,比如TDengine的超级表和IotDB的压缩算法,确实在IOT场景下有自己的沉淀。
而这个赛道上可谓百家争鸣,这里以Clickhouse和Druid举例子。
首先Clickhouse从存储结构讲,其放弃了传统时序数据库使用的倒排索引方式,而是使用主键索引+Projections的形式去模拟倒排索引,之前的文章聊到过[13]Projections本身会多存储一列数据,在即席查询没有命中主键或者Projections的情况下,Clickhouse表现很差,需要全表扫描。但是因为在列级别有minmax、set、各类Bloomfilter的跳过索引,在筛选条件存在时也不会扫描非常多的数据。其次不是schemaLess这一点比较致命。
Clickhouse在其文章中提到现在在可观测领域进军指标市场还存在不足,主要是Prometheus生态的缺失。但是其已经推出了TimeSeries table engine[14],其实Clickhouse的人也很清楚,metric的关键是时间线的抽象,但是TimeSeriesEngine的实现比较挫,用两张表来模拟索引和数据存储,在索引中把tags当做一个map类型与tsid存储在一列中,这样就导致倒排索引的查询很慢,没法像独立的倒排索引一样。但是公司体量这么大加上开源,这里要是做成了Ck就一统可观测性了,但是当前Prometheus Read的路线肯定是错误的,正确的思路是PromQL转化为CK的执行计划。
而Druid则更加像时序数据库,其基本设计原则为:A high performance, real-time analytics database that delivers sub-second queries on streaming and batch data at scale and under load.
相比于后来的InfluxDB-IOX和GrepTimedb,我反倒认为Druid这种把实时数据存储在Historical(SSD)上,历史数据可以降冷至对象存储上相对于全对象存储的SLO更加可控,而Druid早在2012年就开源了,真是很有技术远见。
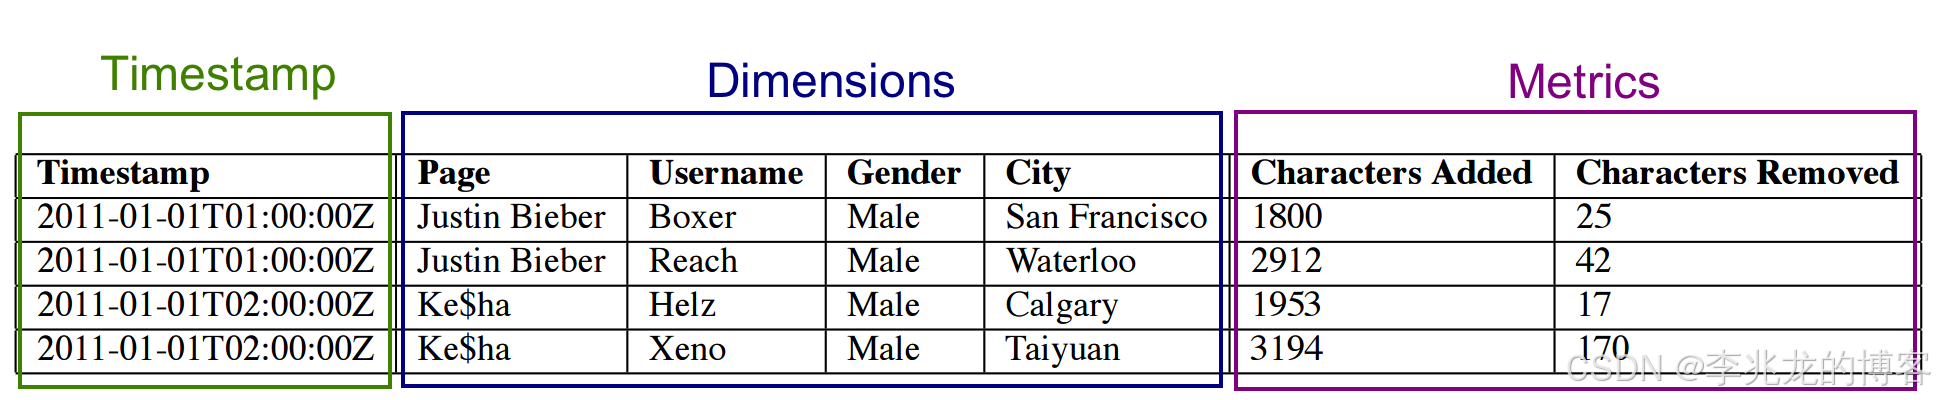
1: Dictionary
   {
    "Justin Bieber": 0,
    "Ke$ha":         1
   }

2: List of column data
   [0,
   0,
   1,
   1]

3: Bitmaps
   value="Justin Bieber": [1,1,0,0]
   value="Ke$ha":         [0,0,1,1]
在存储结构方面维度和指标是分离存储的,维度部分很标准的字典+倒排索引,不过值得注意的是索引的粒度很细,到了行级别,这种方式在维度爆炸时存在索引膨胀的可能,durid使用roaingBitmap压缩。另外在压缩算法方面选择比较少,仅有LZ4、LZF、Zstd。
搜索引擎
冷知识,腾讯云CTSDB1.0是基于ES做的。
我们来思考luence的存储结构,一个基于Fst的倒排索引,DocValues存储列值,不需要用分词器,当然现在最大的问题是默认按照DocID排序,同时间线的数据无法存储在一起(因为根本没有区分哪些列是维度),导致查询IO多且压缩率差。
但是和Clickhouse一样,ES推出了Time series data streams(TSDS)[3],其核心点在于使用维度和时间戳来生成tsid值,在写入的时候需要对部分列标记 “time_series_dimension”: true,具有相同维度和时间戳的两个文档被视为重复项,有一些关键点:
- 重复项在数据写入过程中会被拒绝,而不是像原生时序数据库一样会依靠Compact过程去做去重
- 路由逻辑使用维度字段将时间序列的所有数据点映射到同一个分片,从而提高存储效率和查询性能
- TSDS 使用内部索引排序按 tsid 和 timestamp 对segment内部数据排序,以实现更好的压缩
- 使用Doc values skippers(min、max、count)对 tsid、timestamp、dimension、metric执行跳过流程,不包含set索引和Bloomfilter
- keyword、ip、byte、short、integer、long、unsigned_long、boolean都允许被标记为time_series_dimension,但是keyword 字段建立倒排索引,如果维度是数值 / ip / boolean会建立BKD Tree,查询的过程中依旧是走索引去找到对应的DocID,TSID本身只是内部字段,用作排序
在引入TSDS后,ES已经具备作为metric存储的核心能力了,但是其缺点是不支持去重。
StreamHouse流式湖仓
在[15]中有聊过当前我们的AP计算引擎中的catalog选项思考,IceBerg、DeltaLake、Hudi、Paimon主要存在如下问题:
- 元数据一致性依赖云存储弱保证,需要引入额外组件保证原子性
- 仅支持单表级别的事务,一致性无法跨表保证
- 查询规划需读取并合并大量元数据文件,元数据查询开销大
- 索引支持弱
比较关键的点其实是[3][4],原因是时序中因为即席查询的强需求,倒排索引是必要的(FST、哈希、B+树、Tire树);其次时序数据库不要求事务和Time Travel,完全没必要引入复杂的元数据协调机制。
最重要的是时序的Compact中需要做去重、列重组和重压缩,而IceBerg、DeltaLake、Hudi只是表格式,并不支持Compact,需要依赖于ETL去做Compact;
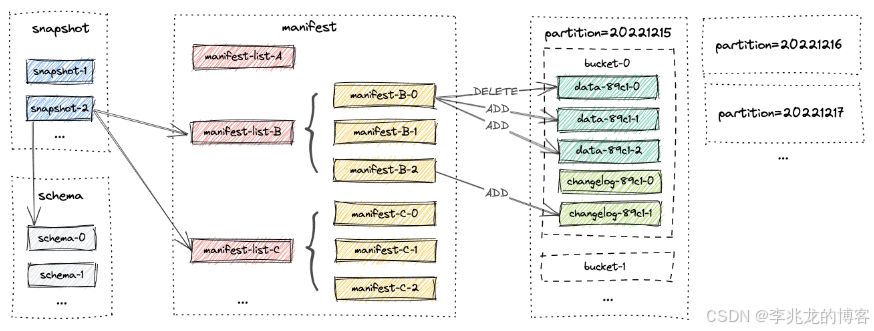
但是Paimon的设计理念中以流优先,其更贴近时序数据库的设计原则。
Paimon 采用与 Apache Hive 相同的分区概念来分离数据,未分区表或分区表中的分区被细分为桶,以便为数据提供额外的结构,从而提高查询效率。
在主键表中主键由一组列组成,每条记录都包含唯一值。Paimon 通过对每个桶内的主键进行排序来强制执行数据排序,使用户能够通过对主键应用筛选条件来实现高性能,其支持Merge Engines,主键的最后一个条目会被保留,这就是一个简单的去重。
仅追加表是指没有主键的表。此类表仅允许插入操作,不支持删除或更新操作。这种类型的表适用于不需要更新的用例,例如日志数据同步。
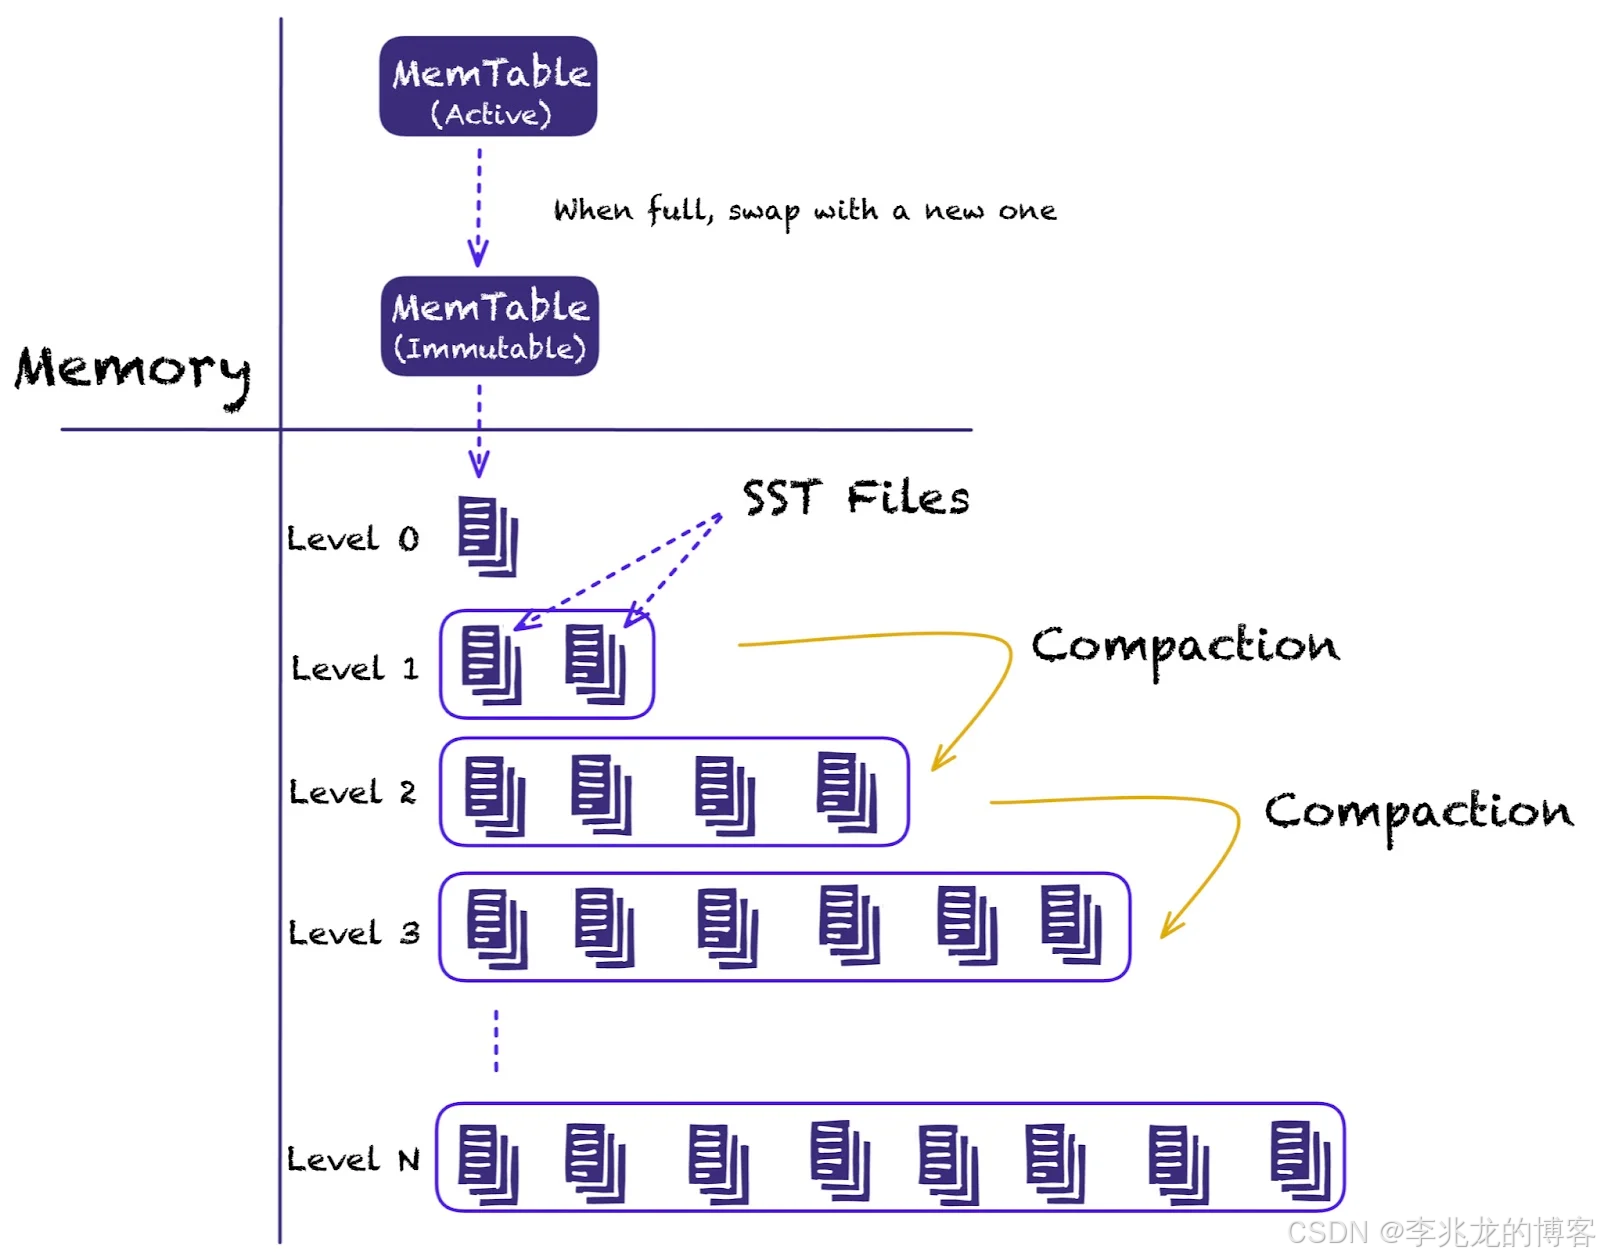
Paimon 每一个桶都使用 LSM进行文件存储,并采用类似于 RocksDB 的分层压缩机制。LSM 数据结构的一个特点是,当增量数据到达时,不一定需要将其合并到较低层级(为了在多个tag之间重用较低级别的文件,因为它们并不总是会受到压缩的影响)
这里的点在于
- 首先没有办法做到完全实时(分钟级别);
- 其次分区方式还是hash+bucket,不满足时序特殊的分区方式(不同时间区间分区键变动);
- 不支持索引
- Compact不支持Field级别去重,深度压缩
毕竟湖仓和时序数据库的第一性目标不一样:
湖仓主要解决:
- 数据统一与治理:统一存储(一个湖)承载多种数据:明细、宽表、日志、半结构化、外部数据等;元数据管理、数据血缘、权限、审计、数据质量、数据契约
- 数据可靠性与一致性:ACID / 并发读写 / 版本管理(time travel)、可回滚、Schema 演进、变更可追溯
- 多工作负载:批处理 ETL、交互式 SQL、BI、机器学习特征、数据共享、甚至流批一体(通常以“离线/近实时”为主)
- 成本与开放生态:低成本对象存储 + 开放表格式,解耦计算与存储,避免被单一引擎锁死
TSDB 主要解决:
- 高吞吐写入 + 时间有序组织:秒级/毫秒级采样,高并发写入、乱序、补写、延迟数据的处理
- 时间窗口查询与聚合:最近 5 分钟、1 小时、 downsample、滑动窗口、聚合
- 高压缩与高效存储:针对时间序列的编码(delta-of-delta、gorilla 类编码等)、Block压缩、冷热分层、自动降采样、物化视图、缓存、索引
- 可观测性生态:PromQL / 监控面板 / 告警等生态兼容、自动保留策略、自动降采样、自动清理
所以很多时候用户会把时序数据库本身作为湖仓前的一层Cache;
但是时序数据库想要做到的是时序数据全生命周期的管理,毕竟公司对于存储部门的指标其实是存储量的增长。
在[18][19]中可以看到InfluxdbIOX对于这件事情的见解:
- 热层 / 实时服务层(前一层):InfluxdbIOX接住高频写入,提供毫秒级查询、实时聚合、告警、看板等能力。
- 冷层 / 资产沉淀层(lakehouse):把数据(通常会做归档、降采样、整理)落到 lakehouse 的表格式/对象存储中,做长期留存、复杂分析、治理与共享
宽表数据库
Lindorm UWC中就标榜其解决车联网中的超宽表问题,这个切入点就很漂亮。
因为列式存储最大的问题就是宽列的情况下开销极高,主要来源于每一列都需要独立的page和RowVector做计算,且IO是分离的。而宽表是行存,对于:
Select BMS_volt, DCU_temp, VehicleID, timestamp from IOV_Table where VehicleID = v001 and timestamp between 1699254000 and 1699257600
这样的SQL有天然的优势,尤其对于一般tsid+field的存储结构而言,宽列的扫描是N个执行过程,虽然可以行存,但是这会导致存储量本身的激增,而UWC中引入Parquet对聚合计算的列作为列存索引,解决部分列的聚合问题。
作为一个开箱即用的方案,车联网确实是比较合适的,Lindorm因为起步较早,也确实拿下了不少公有云大客户。
但是时序分析中扫描型的需求毕竟是少数,监控等场景完全不能用UWC,所以Lindorm有自己的TSDB,以解决不同的业务挑战,这里并不是正面竞争对手,但是业务存在交叠。
总结
谁才是时序数据库在可观测领域真正的对手?产品的目标是什么?我们现在可以答复了。
- 传统/云原生时序数据库:
- 全链路可观测性解决方案:垂类公司需要故事,希望以一套架构去解决全部问题,metric领域实时性欠佳、性能弱于全SSD、没有物理机,成本弱于公有云;日志、Trace领域弱于CK等AP引擎;当前来看不处于竞争关系。
- IOT领域解决方案:低时间线、实时性有限、压缩比优秀、销售顶级 IOT领域内龙头,正面竞争关系。
- 通用metric监控的解决方案:产品力差别不大,高度同质化,成本稳定性优先,正面竞争关系。
- 实时AP引擎:Trace领域首选解决方案,其希望通过收敛metric统一可观测性,持续发展中;且由于metric时间线的逐年增加,未来会成为通用metric监控的解决方案的正面竞争对手。
- 搜索引擎:日志领域首选解决方案,通过TSDS扩展metric领域监控,正面竞争对手。
- StreamHouse流式湖仓:第一性目标不一致,协同共存。
- 宽表数据库:IOV领域宽表形态下有不俗的竞争力,在IOV领域存在正面竞争关系。
我们的产品现阶段目标是成为司内外多场景Metric开箱即用的存储量最高的产品。
这要求我们:
- 进攻:在成本、稳定性、开源生态兼容性方面持续精进,POC击败时序数据库与宽表的竞争对手
- 防守:在时间线爆炸的Metric监控领域瞄准CK的非Schemaless、无倒排索引、不支持去重、metric生态弱;ES不支持去重、metric生态弱、乱序重复写入无法处理等弱点持续演进,并补充物化视图、查询缓存等通用能力。
最后提一句,销售很重要,不然POC的机会都没有,以上。
参考:
- Lucene索引存储结构
- What’s the difference between “store” and “doc_values” in field properties?
- ES Time series data streams
- Clickhouse Time Series Engine
- Time-bound indices and dimension-based routing
- 腾讯云ES
- 浅析下开源时序数据库VictoriaMetrics的存储机制
- 从一到无穷大 #60 时序数据库到底有多实时?
- 从一到无穷大 #54 数据管理中宽表(Wide Table)的问题阐述与解决方案
- Druid Storage
- Druid-A Real-time Analytical Data Store sigmod2014
- [论文阅读] Druid-A Real-time Analytical Data Store
- 从一到无穷大 #62 ClickHouse 加速机制持久化格式拆解
- TimeSeries table engine
- 从一到无穷大 #52:Lakehouse 不适用时序?打破范式 —— Catalog 架构选型复盘
- Apache Paimon: Streaming Lakehouse is Coming
- Apache Paimon: the Streaming Lakehouse
- Unleashing Real-Time Insights: Pairing InfluxDB with Data Lakes and Data Warehouses
- How Time Series Databases and Data Lakes Work Together

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)