【信息科学与工程学】计算机科学与自动化——第三十六篇 高可用、高并发架构全体系知识框架02
系统可用性模型:串联、并联、复杂连接模型
|
模型类型 |
子类型 |
结构描述 |
数学定义/公式 |
关键参数 |
可用性计算推导 |
失效概率计算 |
敏感度分析 |
优化策略 |
典型应用 |
|---|---|---|---|---|---|---|---|---|---|
|
1. 串联模型 |
基本串联 |
所有组件正常工作系统才正常 |
A_s = ∏[i=1,n] A_i |
n: 组件数 |
基于独立假设,系统可用性=各组件可用性乘积 |
系统失效概率 = 1 - A_s = 1 - ∏A_i |
∂A_s/∂A_j = ∏[i≠j]A_i |
1. 提高最差组件可靠性 |
简单链式系统 |
|
相关故障串联 |
考虑组件故障相关性 |
引入共因故障因子β |
β: 共因故障比例 |
总失效率分解: λ_i^T = (1-β)λ_i + βλ_C |
考虑共因时失效概率更高 |
共因故障降低单个组件改进效果 |
1. 设计多样性 |
共享环境/电源的系统 | |
|
非独立串联 |
组件故障不独立 |
使用联合概率 |
协方差Cov(A_i,A_j) |
A_s = P(⋂[i=1,n]{组件i正常}) |
通过copula函数或蒙特卡洛模拟 |
相关性增加系统风险 |
1. 降低故障传播 |
紧密耦合系统 | |
|
2. 并联模型 |
主动冗余(热备份) |
所有组件同时工作,至少一个正常系统正常 |
A_s = 1 - ∏[i=1,n] (1 - A_i) |
n: 冗余组件数 |
系统失效=所有组件失效 |
对相同组件: A_s = 1 - (1-A)^n |
∂A_s/∂A = n(1-A)^(n-1) |
1. 找到成本效益最优的n |
负载均衡集群 |
|
备用冗余(冷备份) |
主组件工作,备用不工作,故障时切换 |
马尔可夫模型求解 |
λ: 工作组件失效率 |
两状态模型: 状态0(主正常),状态1(主失效,备工作),状态2(都失效) |
需考虑切换时间和可靠性 |
切换可靠性影响很大 |
1. 提高切换可靠性 |
备份服务器 | |
|
温备份 |
备用部分工作,切换时间短 |
介于热备和冷备之间 |
λ_a: 备用状态失效率(0<λ_a<λ) |
比冷备复杂,备用可能失效 |
考虑备用期间可能失效 |
备用状态失效率是折中关键 |
1. 优化备用状态维护 |
高可用数据库 | |
|
部分冗余(k/n系统) |
至少k个正常系统正常 |
二项分布求和 |
n: 总组件数 |
A_s = Σ[i=k,n] C(n,i) A^i (1-A)^(n-i) |
失效概率 = Σ[i=0,k-1] C(n,i) A^i (1-A)^(n-i) |
最优k选择依赖A和n |
1. 选择最优k值 |
纠删码存储 | |
|
混合冗余 |
工作组件+备用组件 |
结合主动和备用 |
m: 工作组件数 |
复杂马尔可夫模型 |
有m+r+1个状态 |
存在最优的(m,r)组合 |
1. 优化工作/备用比例 |
高可靠航空系统 | |
|
3. 串并联混合 |
串联-并联 |
先并联后串联 |
分步计算子系统 |
子系统数m |
1. 计算每个并联子系统可用性A_sub_i |
系统失效≈任一子系统失效 |
最弱子系统决定系统可用性 |
1. 平衡各子系统冗余度 |
RAID阵列 |
|
并联-串联 |
先串联后并联 |
模块化冗余 |
模块数m |
1. 计算每个串联模块可用性A_mod_i |
系统失效=所有模块失效 |
模块独立性重要 |
1. 模块间物理隔离 |
N版本编程 | |
|
复杂串并联 |
多层嵌套结构 |
递归分解计算 |
可用可靠性框图表示 |
从最内层开始,逐步向外计算 |
使用可靠性框图简化规则 |
内层组件对系统影响被放大/缩小 |
1. 使用可靠性框图工具 |
复杂电子系统 | |
|
4. 网络模型 |
两终端可靠性 |
源到汇至少一条通路 |
最小路集/最小割集法 |
最小路集数 |
1. 找出所有最小路集P_i |
1. 找出所有最小割集C_i |
关键边/节点识别 |
1. 强化关键路径 |
通信网络 |
|
全终端可靠性 |
所有节点间连通 |
基于生成树 |
节点数N |
计算生成树数目复杂 |
系统不连通概率难以精确计算 |
边可靠性p的影响非线性 |
1. 增加关键边 |
互联网络 | |
|
k-终端可靠性 |
特定k个节点间连通 |
推广的两终端 |
特定节点集合K |
K |
=k |
找出连接K的最小斯坦纳树 |
通常用蒙特卡洛模拟 |
关键节点识别 | |
|
流网络可靠性 |
满足流量需求 |
基于网络流理论 |
边容量c_e |
系统正常: 最大流 ≥ D |
计算所有边状态组合 |
容量和可靠性共同影响 |
1. 容量冗余设计 |
运输网络 | |
|
5. 故障树模型 |
与门(AND) |
所有输入事件发生输出发生 |
布尔代数 |
基本事件概率q_i |
顶事件概率 = ∏q_i |
通过最小割集计算 |
基本事件概率重要度 |
1. 减小关键基本事件概率 |
安全系统 |
|
或门(OR) |
至少一个输入事件发生输出发生 |
布尔代数 |
基本事件概率q_i |
顶事件概率 = 1 - ∏(1-q_i) |
通过最小路集计算 |
基本事件结构重要度 |
1. 消除单点故障 |
故障模式分析 | |
|
复杂逻辑门 |
投票门(k/n)等 |
布尔函数 |
阈值k |
顶事件概率 = Σ[i=k,n] C(n,i) q^i (1-q)^(n-i) (相同q) |
不交化或蒙特卡洛 |
阈值k的敏感性分析 |
1. 优化阈值k |
保护系统 | |
|
动态故障树 |
考虑时序依赖 |
马尔可夫链/Petri网 |
事件顺序 |
转换为等价马尔可夫模型 |
考虑序列依赖,更复杂 |
时序关系的影响 |
1. 优化检测/切换时序 |
顺序相关系统 | |
|
6. 马尔可夫模型 |
离散时间马尔可夫链 |
状态离散,时间离散 |
转移概率矩阵P |
状态数N |
πP = π, Σπ_i=1 |
系统不可用状态概率和 |
转移概率敏感性 |
1. 优化高概率转移 |
定期维护系统 |
|
连续时间马尔可夫链 |
状态离散,时间连续 |
转移率矩阵Q |
转移率q_ij |
dπ/dt = πQ |
不可用状态概率和 |
转移率变化的影响 |
1. 提高修复率μ |
可修系统 | |
|
半马尔可夫过程 |
停留时间任意分布 |
核矩阵Q(t) |
转移概率p_ij |
更一般,但分析复杂 |
数值求解或模拟 |
停留时间分布的影响 |
1. 优化维修时间分布 |
实际维修系统 | |
|
吸收马尔可夫链 |
有吸收态(失效态) |
规范形式矩阵 |
瞬态态数r |
基本矩阵 N = (I - Q)^(-1) |
系统最终进入吸收态概率=1 |
从各状态到吸收态的期望时间 |
1. 增加从瞬态到工作态的转移 |
不可修系统 | |
|
7. Petri网模型 |
基本Petri网 |
位置、变迁、令牌 |
关联矩阵 |
位置集P |
分析可达图 |
标识对应系统状态 |
关键变迁/位置识别 |
1. 避免死锁 |
并发系统 |
|
随机Petri网 |
变迁实施时间随机 |
实施速率λ |
时间指数分布 |
同构于CTMC |
通过同构CTMC计算 |
实施速率的影响 |
1. 优化变迁速率 |
排队网络 | |
|
广义随机Petri网 |
允许立即变迁和抑制弧 |
实施优先级 |
立即变迁(优先级高) |
消除立即变迁,得到缩减CTMC |
缩减后计算 |
优先级设置的影响 |
1. 合理设置优先级 |
复杂控制系统 | |
|
有色Petri网 |
令牌有颜色(数据) |
颜色集合 |
令牌携带数据 |
状态空间可能很大 |
通常用蒙特卡洛模拟 |
数据依赖的影响 |
1. 数据流优化 |
数据处理系统 | |
|
8. 系统层次模型 |
分层组合 |
高层组件由低层组件构成 |
递归计算 |
层次数L |
自底向上计算 |
高层失效由低层失效传播 |
低层对高层的影响放大 |
1. 底层高可靠设计 |
复杂产品系统 |
|
多状态系统 |
组件和系统有多个性能水平 |
通用生成函数 |
状态数m_i |
组件i: u_i(z)=Σ[p_ik × z^g_ik] |
系统性能分布 |
性能阈值的影响 |
1. 提高最低性能水平 |
电力系统 | |
|
阶段任务系统 |
任务有多个阶段 |
阶段依赖模型 |
阶段数K |
任务可靠度=∏R_k(T_k) |
任务失效=任一阶段失效 |
关键阶段识别 |
1. 强化关键阶段 |
航天任务 | |
|
共因故障模型 |
考虑共同原因导致多重故障 |
β因子模型 |
β,γ,δ等 |
λ_i = (1-β)λ + βλ |
共因显著降低冗余效果 |
β因子的敏感性 |
1. 减少共因来源 |
安全关键系统 | |
|
9. 软件相关模型 |
软件-硬件交互 |
软件故障和硬件故障交互 |
组合故障树 |
硬件故障率λ_h |
串联模型: A = A_h × A_s |
系统失效=硬件失效∨软件失效∨交互失效 |
软硬件接口是关键 |
1. 软硬件协同验证 |
嵌入式系统 |
|
软件可靠性增长 |
测试中排除缺陷 |
NHPP模型 |
初始缺陷数a |
累计缺陷期望: m(t)=a(1-e^{-bt}) |
软件可用性: A_s(t)=e^{-λ(t)T_op} |
参数a,b的估计影响预测 |
1. 充分的测试 |
软件开发过程 | |
|
软件老化 |
资源泄漏累积 |
失效时间分布变化 |
老化参数α |
失效率随时间增加: λ(t)=λ_0+α(t-t_0)⁺ |
可用性随时间下降 |
老化速率α的影响 |
1. 定期重启 |
长期运行服务器 | |
|
N版本编程 |
独立开发N个版本 |
设计多样性 |
版本数N |
A_s = 1 - (1-A)^N 若独立 |
版本间相关性降低效果 |
独立性的重要性 |
1. 确保设计独立性 |
高可靠软件 | |
|
10. 维修策略模型 |
修复如新 |
修复后恢复如新 |
更新过程 |
故障间隔分布F(t) |
稳态可用性: A = MTTF/(MTTF+MTTR) |
停机时间分布 |
修复时间分布的影响 |
1. 减少MTTR |
可快速修复的系统 |
|
修复如旧 |
修复不改善状态 |
非齐次过程 |
故障率随时间增加 |
可用性逐渐下降 |
随时间恶化 |
老化加速的影响 |
1. 预防性维修 |
磨损系统 | |
|
不完全修复 |
修复后介于新旧之间 |
虚拟年龄模型 |
修复效果因子q |
修复后年龄 = q × 修复前年龄 |
可用性下降比修复如新快 |
q值的影响 |
1. 提高修复质量(q小) |
实际维修实践 | |
|
预防性维修 |
定期预防性维护 |
年龄更换/块更换 |
预防周期T |
可用性 = (∫[0,T]R(t)dt)/(T+T_p) 对年龄更换 |
平衡预防和修复 |
最优周期T的求解 |
1. 优化预防周期 |
定期维护设备 | |
|
状态监控维修 |
基于状态预测维修 |
预测模型 |
监测数据 |
可用性 = 1 - (预测失败概率 + 误报概率) |
预测准确性影响 |
监测频率和精度的影响 |
1. 改进预测模型 |
预测性维护系统 |
模型选择与适用性指南
1. 模型选择决策树
系统特征 → 合适模型
-----------------------------
简单链式依赖 → 串联模型
冗余设计 → 并联模型
混合串并联 → 串并联混合模型
网络连通性 → 网络模型
时序/状态依赖 → 马尔可夫模型
复杂逻辑关系 → 故障树模型
并发/资源竞争 → Petri网模型
多性能等级 → 多状态系统模型
软件影响显著 → 软件相关模型
维修策略关键 → 维修策略模型
2. 模型复杂度与准确性权衡
|
模型类型 |
复杂度 |
准确性 |
数据需求 |
计算难度 |
适用阶段 |
|---|---|---|---|---|---|
|
串联/并联 |
低 |
中(假设独立) |
低 |
易 |
早期设计 |
|
串并联混合 |
中 |
中高 |
中 |
中 |
详细设计 |
|
故障树 |
中 |
高 |
中 |
中 |
安全分析 |
|
马尔可夫 |
高 |
高 |
高 |
难 |
可修系统分析 |
|
Petri网 |
很高 |
很高 |
很高 |
很难 |
复杂动态系统 |
|
蒙特卡洛模拟 |
可变 |
高(样本足够) |
中高 |
计算密集 |
任何阶段,验证 |
3. 关键模型假设验证
-
独立性假设:故障是否独立?检查共因、共同环境、设计相似性
-
恒定失效率:是否满足指数分布?适合电子元件,不适合机械磨损
-
完美切换:冗余切换是否100%可靠?实际有切换失败概率
-
修复如新:维修后是否完全恢复?可能是不完全修复
-
稳态假设:系统是否运行足够长时间达到稳态?对任务时间短的系统不合适
4. 高级建模技术
-
多技术组合:例如,用故障树识别最小割集,用马尔可夫分析可修系统
-
分层建模:高层用可靠性框图,底层用故障树或马尔可夫
-
动态与静态结合:静态结构用RBD,动态行为用Petri网
-
确定性与随机性结合:确定性的系统结构,随机性的故障和修复
5. 实际应用建议
-
从简单开始:先用简单模型(串联/并联)获得初步估计
-
逐步细化:根据分析需求逐步采用更复杂模型
-
敏感性分析:识别最关键参数,集中数据收集和分析
-
模型验证:用历史数据或测试数据验证模型准确性
-
不确定性量化:参数不确定性传播到结果,给出置信区间
-
持续更新:随着系统运行获取新数据,更新模型参数
6. 工具支持
-
可靠性框图工具:ReliaSoft BlockSim, Isograph Reliability Workbench
-
故障树分析工具:FaultTree+, CAFTA, OpenFTA
-
马尔可夫分析工具:ReliaSoft RENO, SHARPE
-
Petri网工具:CPN Tools, PIPE, WoPeD
-
综合平台:MATLAB Simulink Reliability, ANSYS Sherlock
通过理解和正确应用这些可用性模型,可以系统化地评估和改进系统可靠性,支持从设计到运维的全生命周期可靠性管理。
一、高可用架构
1.1 高可用的设计
需系统性融合冗余策略、故障容错机制、数据一致性保障及自动化运维。
1.1.1、设计方法与原则
-
冗余法则(核心基础)
-
无单点故障(SPOF):关键组件(服务器、网络、存储)均需冗余部署,如数据库主从复制(MySQL MHA)、多机房部署(异地多活)。
-
分层冗余策略:
-
接入层:DNS轮询 + Nginx负载均衡(多实例)
-
服务层:微服务集群 + 服务注册发现(如Nacos)
-
数据层:主从复制 + 分片集群(如Redis Cluster)。
-
-
-
故障快速恢复
-
熔断降级:通过Hystrix或Sentinel实现服务熔断,避免级联故障。
-
自动故障转移:ZooKeeper选举新主节点(Raft算法),VIP漂移技术(Keepalived)。
-
-
弹性伸缩
-
动态扩缩容:Kubernetes HPA根据CPU/内存指标自动扩缩Pod。
-
流量削峰:Kafka异步解耦 + 批量合并请求,应对突发流量。
-
1.1.2、设计思路与架构模式
1. 分层架构设计
|
层级 |
高可用策略 |
技术实现 |
|---|---|---|
|
接入层 |
多活DNS + BGP Anycast |
GeoDNS + Envoy热重启 |
|
服务层 |
微服务隔离 + 熔断降级 |
Spring Cloud Alibaba + Sentinel |
|
数据层 |
多副本同步 + 分片 |
MySQL半同步复制 + Redis Cluster |
2. 数据一致性模型
|
场景 |
策略 |
算法/协议 |
适用案例 |
|---|---|---|---|
|
强一致性需求 |
多数派复制 |
Raft/Paxos |
金融交易系统(余额扣减) |
|
最终一致性 |
异步复制 + 冲突解决 |
CRDT |
电商购物车(多端同步) |
|
读写分离 |
主从复制 + 读写分离代理 |
ProxySQL |
高并发查询场景 |
1.1.3、核心算法与数据结构
1. 负载均衡算法
def weighted_round_robin(servers):
    """权重轮询算法示例"""
    total_weight = sum(server['weight'] for server in servers)
    current = 0
    while True:
        current = (current + 1) % total_weight
        for server in servers:
            if current <= server['weight']:
                yield server['address']
            current -= server['weight']
-
场景对比:
-
轮询:适用于节点性能均衡的场景(如静态资源分发)。
-
最小连接数:动态调整流量,避免节点过载(如长连接服务)。
-
2. 分布式共识算法
-
Raft算法核心逻辑:
-
Leader选举:节点超时触发选举,多数派投票确认Leader。
-
日志复制:Leader广播日志,多数Follower确认后提交。
-
-
数据结构:
type LogEntry struct {
    Term    int         // 任期号
    Command interface{} // 操作指令
}
1.1.4、核心代码逻辑
1. 服务熔断(Sentinel示例)
// 定义资源熔断规则
DegradeRule rule = new DegradeRule("queryService")
    .setGrade(RuleConstant.DEGRADE_GRADE_RT) // 按响应时间熔断
    .setCount(100)  // 阈值100ms
    .setTimeWindow(10); // 熔断时间10秒
DegradeRuleManager.loadRules(Collections.singletonList(rule));

// 资源保护
try (Entry entry = SphU.entry("queryService")) {
    return doQuery(); // 业务逻辑
} catch (BlockException e) {
    return fallback(); // 降级处理
}
2. 数据库自动故障转移(MHA + ProxySQL)
-- Orchestrator自动切换主库
CHANGE MASTER TO MASTER_HOST='new_primary';
START SLAVE;

-- ProxySQL更新路由
UPDATE mysql_servers SET status='OFFLINE_HARD' WHERE host='old_primary';
LOAD MYSQL SERVERS TO RUNTIME;
注:结合VIP漂移脚本,实现应用无感知切换。
1.1.5、数据处理Pipeline流程
1. 容灾演练自动化Pipeline
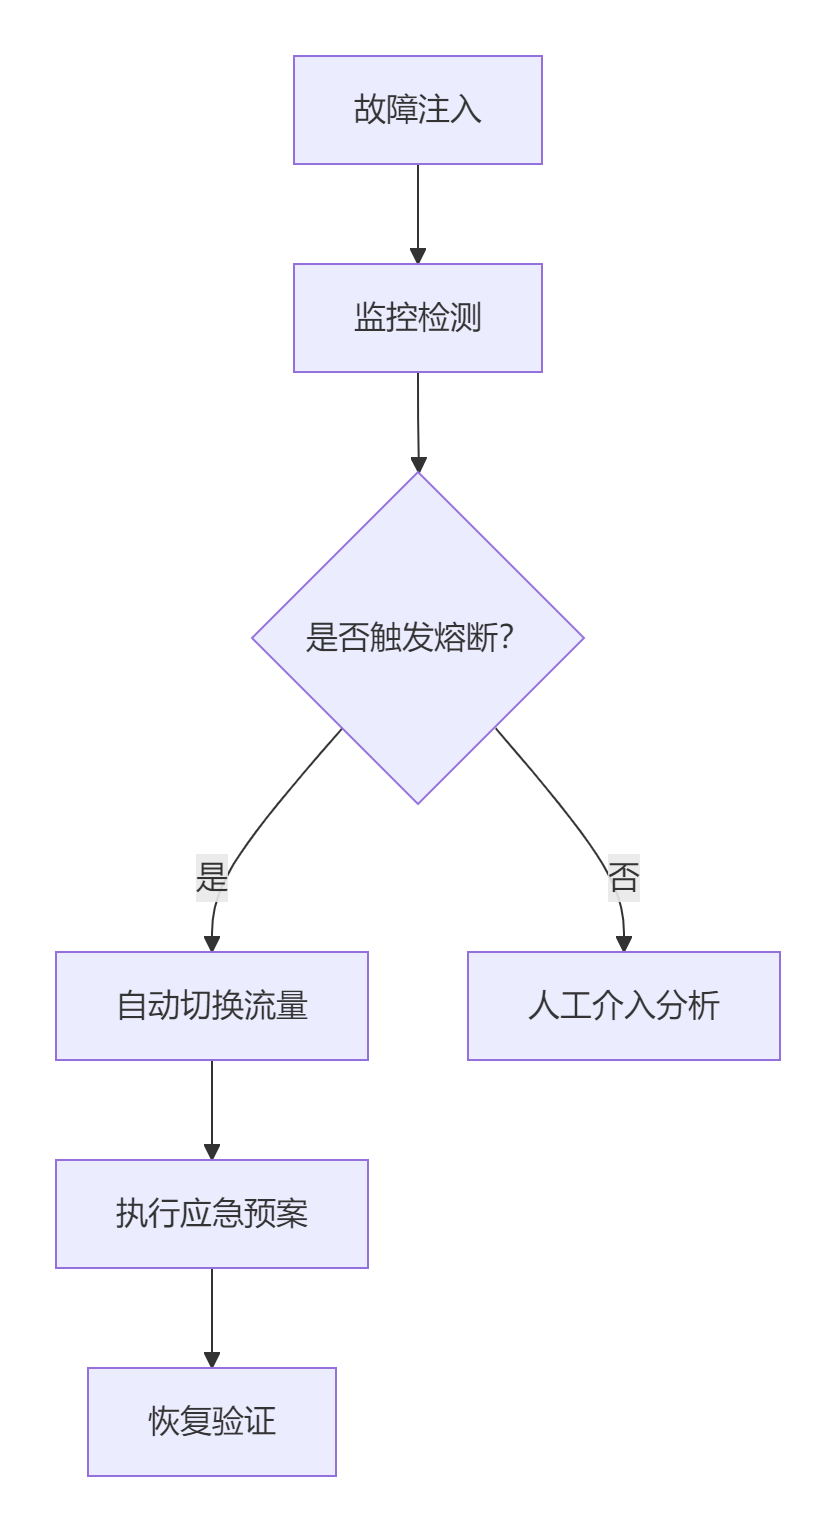
-
工具支持:
-
故障注入:Chaos Monkey模拟网络延迟、节点宕机。
-
监控:Prometheus + Alertmanager实时告警(黄金指标:延迟/流量/错误/饱和度)。
-
2. 数据同步Pipeline
|
步骤 |
技术方案 |
数据一致性保障 |
|---|---|---|
|
增量捕获 |
MySQL Binlog / Debezium |
有序消息队列(Kafka分区保序) |
|
冲突解决 |
CRDT合并 / 时间戳仲裁 |
向量时钟(Vector Clock) |
|
最终一致 |
异步消费者批量写入 |
幂等设计 + 重试队列 |
1.1.6、优化方向与新技术
-
单元化架构:
-
按用户分片(如阿里单元化部署),故障隔离至单元内,跨单元流量占比<5%。
-
-
Service Mesh:
-
Istio自动重试/超时控制,提升服务间调用的韧性。
-
-
量子加密:
-
QKD(量子密钥分发)保障跨机房数据传输安全,抗中间人攻击。
-
总结
高可用架构本质是 “冗余×自动化×数据一致性” 的工程实践:
-
设计层:冗余消除单点,分层隔离故障域;
-
算法层:Raft/Paxos保障状态决策,权重轮询优化负载;
-
实现层:熔断限流代码嵌入业务逻辑,ProxySQL+Orchestrator实现存储层无缝切换;
-
运维层:混沌工程验证韧性,全链路监控快速定位瓶颈。
正如Google SRE理念所述:“通过科学的故障预算管理,在可靠性与创新速度间找到平衡”,高可用设计需贯穿系统全生命周期,从架构到代码持续迭代优化。
1.2 高可用系统的锁机制
高可用系统的锁机制设计需在保障资源互斥访问的同时,兼顾系统容错性、性能与扩展性。以下是核心设计要点与技术方案:
1.2.1、核心设计原则
-
互斥性(Mutex)
-
确保同一时刻仅有一个客户端持有锁,通过原子操作实现(如Redis的
SET NX、ZooKeeper的临时节点顺序性)。
-
-
容错性(Fault Tolerance)
-
锁持有者崩溃时自动释放:超时机制(Redis锁过期)或会话绑定(ZooKeeper临时节点随会话结束删除)。
-
-
高可用(Availability)
-
锁服务本身需避免单点故障:
-
Redis:RedLock算法(多独立节点多数派确认)
-
ZooKeeper/etcd:集群化部署(基于Raft/ZAB共识协议)。
-
-
-
可重入性(Reentrancy)
-
同一线程多次获取同一锁时无需阻塞,通过本地锁计数器实现(如Redisson客户端)。
-
1.2.2、主流实现方案对比
|
方案 |
原理 |
适用场景 |
优缺点 |
|---|---|---|---|
|
Redis锁 |
|
高并发、容忍短暂不一致(AP场景) |
性能高(10万+ QPS);但网络分区时可能脑裂 |
|
ZooKeeper锁 |
创建临时顺序节点,监听前序节点删除事件 |
强一致性要求(CP场景) |
强一致性保障;但性能较低(万级QPS),需维护长连接 |
|
etcd锁 |
基于租约(Lease)的键值操作 + Revision版本控制 |
云原生环境、Kubernetes协调 |
低延迟选主;但需gRPC长连接 |
|
数据库锁 |
唯一约束 + 乐观锁(版本号) |
低并发、无额外中间件场景 |
实现简单;但性能差(高并发下数据库压力大) |
1.2.3、关键容错机制
-
锁续期(Watchdog)
-
问题:业务执行超时导致锁过期,其他客户端抢占锁引发冲突。
-
方案:后台线程定期重置TTL(如Redisson的
LockWatchdog)。
-
-
锁释放防误删
-
问题:客户端A超时释放时误删客户端B的锁。
-
方案:释放锁前校验持有者标识(如UUID):
if redis.call("get", KEYS[1]) == ARGV[1] then
    return redis.call("del", KEYS[1])
end
-
-
脑裂问题规避
-
Redis场景:RedLock要求多数节点(N/2+1)确认锁持有。
-
ZooKeeper场景:Leader选举期间拒绝写操作,避免数据分歧。
-
1.2.4、性能优化策略
-
锁粒度拆分
-
按资源ID分片(如
lock:order_123),减少单个锁的竞争。
-
-
非阻塞锁尝试
-
使用
tryLock(设置超时)替代阻塞调用,避免线程长时间等待。
-
-
读写锁分离
-
读多写少场景用
ReadWriteLock(如Redisson的RReadWriteLock)。
-
1.2.5、典型陷阱与规避
|
问题 |
原因 |
解决方案 |
|---|---|---|
|
ABA问题 |
锁被释放后重获取,原持有者误删新锁 |
锁值绑定唯一ID(如UUID) |
|
时钟漂移 |
节点间时间不同步导致锁提前/延迟释放 |
依赖锁服务时间(非客户端时钟) |
|
GC停顿导致锁失效 |
长时间GC停顿触发锁超时 |
缩短临界区代码 + JVM调优 |
总结:选型决策树
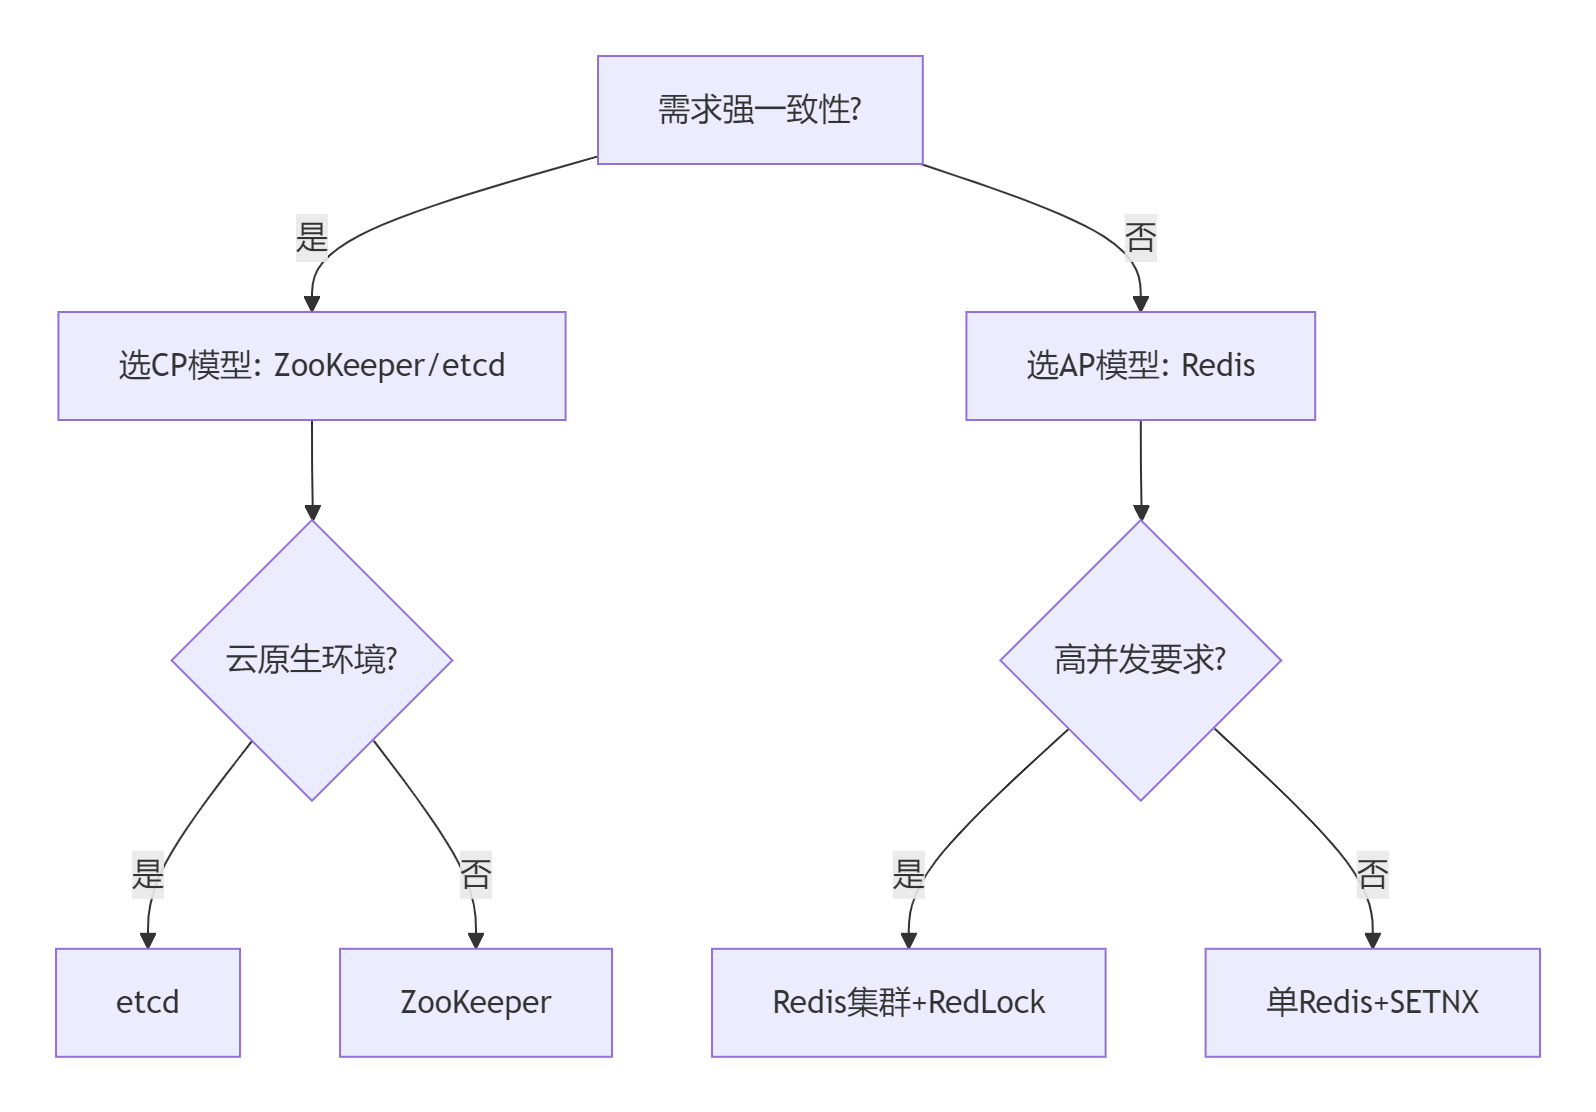
通过分层设计(如读写锁分离)、故障预演(混沌工程测试网络分区)和动态监控(锁持有时间告警),可构建既韧且敏的分布式锁体系。正如Google Chubby的启示:锁的本质是“信任链”——当硬件、协议与算法形成闭环,高可用便从特性升格为本能。
1.3 高可用系统的锁机制与互斥设计
高可用系统的锁机制与互斥设计需在CAP理论框架下权衡一致性(C)、可用性(A)、分区容错性(P)的需求。以下是不同场景下的核心策略与技术实现:
1.3.1、CAP理论对锁机制设计的约束
-
CP系统(强一致性优先)
-
场景:金融交易、库存扣减等需强一致性的业务。
-
实现:
-
ZooKeeper锁:通过临时顺序节点和Watcher机制实现公平锁,节点宕机时自动释放。
-
etcd锁:基于Raft协议和租约(Lease)机制,结合CAS操作保证原子性。
-
-
代价:网络分区时可能拒绝服务(牺牲可用性)。
-
-
AP系统(高可用优先)
-
场景:社交媒体点赞、商品浏览量统计等容忍短暂不一致的业务。
-
实现:
-
Redis分布式锁:通过
SET key value NX PX原子命令设置锁,支持自动过期。 -
优化策略:结合Redlock多节点投票降低单点故障风险。
-
-
代价:极端情况下可能锁失效(牺牲强一致性)。
-
1.3.2、锁机制的核心实现与限制方法
1. 互斥性保障技术
-
原子操作:
-
Redis的
SETNX + EXPIRE合并为单命令(SET ... NX PX),避免非原子操作导致的死锁。 -
etcd的Txn事务(CAS操作)确保锁创建的原子性。
-
-
唯一标识防误删:
# Redis锁释放前校验持有者
if redis.get(lock_key) == client_id:
    redis.delete(lock_key)  # 仅持有者可释放
2. 死锁预防策略
|
风险 |
解决方案 |
|---|---|
|
客户端宕机锁滞留 |
锁绑定租约(etcd Lease)或超时机制(Redis TTL),自动释放。 |
|
业务超时锁提前释放 |
看门狗线程定期续期(如Redisson的 |
|
锁竞争饥饿 |
公平队列(ZooKeeper顺序节点)或随机退避重试。 |
3. 性能与扩展性优化
-
锁粒度拆分:
-
库存扣减按商品ID分片锁(
lock:stock:sku123),提升并发能力。
-
-
无锁化设计:
-
使用CRDT(冲突免复制数据类型)或乐观锁(版本号校验),避免显式锁争用。
-
-
读写分离:
-
ReadWriteLock(如Redisson的RReadWriteLock)允许多读单写。
-
1.3.3、高并发场景下的限制策略
1. 流量整形
-
令牌桶算法:
// Guava RateLimiter限制每秒10次锁请求 RateLimiter limiter = RateLimiter.create(10); if (limiter.tryAcquire()) { acquireLock(); // 获取锁 } -
分布式限流:Redis Lua脚本实现集群级令牌桶,防止单节点过载。
2. 降级与熔断
-
降级策略:
-
锁竞争超时后返回缓存库存(如“库存紧张”提示),避免阻塞用户请求。
-
-
熔断机制:
-
Sentinel监控锁获取失败率,超阈值时触发熔断,直接走降级逻辑。
-
3. 异步化处理
-
消息队列缓冲:
-
抢购请求先入Kafka,由消费者串行处理,避免锁竞争。
-
1.3.4、技术选型对比与场景适配
|
锁类型 |
适用场景 |
性能 |
一致性 |
高可用性 |
实现复杂度 |
|---|---|---|---|---|---|
|
Redis锁 |
高频短任务(库存扣减) |
⭐⭐⭐⭐ |
⭐⭐(最终) |
⭐⭐⭐⭐ |
⭐⭐ |
|
ZooKeeper锁 |
强一致场景(分布式事务) |
⭐⭐ |
⭐⭐⭐⭐ |
⭐⭐⭐ |
⭐⭐⭐⭐ |
|
etcd锁 |
云原生环境(K8s协调) |
⭐⭐⭐ |
⭐⭐⭐⭐ |
⭐⭐⭐⭐ |
⭐⭐⭐ |
|
数据库乐观锁 |
低频冲突(账户余额修改) |
⭐ |
⭐⭐⭐ |
⭐⭐ |
⭐ |
选型建议:
金融系统:ZooKeeper/etcd(CP保障)
电商秒杀:Redis锁 + 消息队列(AP优化)
混合架构:核心交易用CP锁,非核心数据用AP锁
总结
设计高可用系统的锁机制需遵循:
-
CAP导向:按业务需求选择CP锁(强一致)或AP锁(高可用)。
-
互斥安全:原子操作 + 租约/超时 + 持有者校验,三位一体防死锁。
-
性能兜底:分片降级、异步队列、无锁方案应对高并发。
-
动态治理:熔断限流 + 监控告警,保障极端场景下的系统韧性。
正如分布式系统的本质:没有完美的全局锁,只有贴合场景的局部最优解。通过分层策略(如核心用CP、边缘用AP)与弹性设计(如自动续约 + 降级),在一致性与可用性的钢丝上走出安全路径 🌉。
1.4 Compare and Set(CAS)无锁编程
Compare and Set(CAS)是一种无锁并发编程的核心机制,通过硬件指令支持实现原子操作。以下从实现方法、系统流程、硬件约束、代码实现四个维度展开系统解析:
1.4.1、实现方法与工作流程
1. 核心算法逻辑
-
操作定义:
CAS(V, A, B)包含三个参数:-
V:内存位置(如共享变量地址) -
A:预期原值(线程读取的旧值) -
B:新值
-
-
原子操作流程:
-
读取内存位置
V的当前值current; -
比较
current == A:-
相等:将
V更新为B,返回成功; -
不相等:放弃更新,返回失败;
-
-
失败后通常自旋重试(循环步骤1-2)。
-
2. 工作流程示例
graph TB
    A[线程读取当前值V] --> B{比较 V == A?}
    B -->|相等| C[更新V为B]
    B -->|不相等| D[放弃更新]
    C --> E[返回成功]
    D --> F[返回失败]
    F --> G[自旋重试]
1.4.2、计算机系统实现机制
1. 硬件指令支持
-
x86架构:
使用
cmpxchg指令(Compare and Exchange),配合lock前缀锁定总线或缓存行,确保原子性。lock cmpxchg [edx], ecx ; 多核环境下锁定总线 -
ARM架构:
通过
LDREX(加载独占)和STREX(存储独占)指令组合实现:LDREX R1, [R0] ; 加载地址R0的值到R1(标记为独占) CMP R1, #A ; 比较当前值与预期值 STREXEQ R2, B, [R0] ; 相等则存储新值B,R2返回0表示成功 -
RISC-V:
采用
LR(Load Reserved)和SC(Store Conditional)指令对。
2. 操作系统与内存管理
-
缓存一致性协议:
依赖 MESI协议(Modified/Exclusive/Shared/Invalid)管理缓存行状态:
-
执行 CAS 时,CPU 将缓存行设为 Exclusive 状态,阻止其他核心并发修改。
-
-
内存屏障:
插入
mfence(x86)或dmb(ARM)指令,防止指令重排序,确保操作顺序性。
1.4.3、硬件约束与性能影响
1. 多核环境下的挑战
|
约束类型 |
表现与影响 |
优化策略 |
|---|---|---|
|
缓存行竞争 |
多核频繁修改同一缓存行 → 触发缓存行失效(Cache Line Invalidation) |
对齐填充(@Contended)减少伪共享 |
|
NUMA架构延迟 |
跨NUMA节点访问内存延迟↑ → CAS性能下降 |
绑定线程到同NUMA节点 |
|
指令支持差异 |
ARM/RISC-V需多条指令实现CAS → 比x86单指令更耗时 |
编译器优化指令生成 |
2. 自旋开销与ABA问题
-
自旋消耗CPU:
高并发时失败重试导致CPU空转 → 需限制重试次数或退避等待(如
Thread.yield())。 -
ABA问题:
值从
A→B→A变化,CAS误判未修改 → 通过 AtomicStampedReference 添加版本号解决。
1.4.4、代码实现机制
1. Java层实现(AtomicInteger)
public final int incrementAndGet() {
    int prev, next;
    do {
        prev = get();          // 读取当前值(volatile保证可见性)
        next = prev + 1;       // 计算新值
    } while (!compareAndSet(prev, next)); // CAS自旋
    return next;
}
-
底层调用:
Unsafe.compareAndSwapInt()→ JNI → 汇编指令cmpxchg。
2. C/C++层实现(std::atomic)
#include <atomic>
std::atomic<int> counter(0);

void increment() {
    int prev = counter.load();
    while (!counter.compare_exchange_strong(prev, prev + 1)) {
        // CAS失败时prev自动更新为最新值
    }
}
-
编译器优化:
直接映射为硬件指令(如x86的
lock cmpxchg)。
3. 硬件指令级实现(x86 Linux内核)
// Linux内核atomic_cmpxchg实现
static inline int atomic_cmpxchg(atomic_t *v, int old, int new) {
    asm volatile("lock cmpxchgl %2, %1"
                 : "=a" (old), "+m" (v->counter)
                 : "r" (new), "0" (old)
                 : "memory");
    return old;
}
-
关键机制:
lock前缀锁定总线 → 阻塞其他核心访问内存。
1.4.5、典型问题与优化方案
|
问题 |
原因 |
解决方案 |
|---|---|---|
|
高竞争自旋 |
大量线程CAS失败 → CPU空转 |
分段CAS(LongAdder)、退避策略(Exponential Backoff) |
|
多变量原子更新 |
CAS仅支持单变量 |
AtomicReference(对象引用)或锁 |
|
跨平台兼容性 |
ARM/RISC-V指令开销更高 |
编译器宏适配(如 |
总结
CAS机制通过 硬件原子指令(如x86的cmpxchg) 实现无锁并发,其核心价值在于:
-
无阻塞:避免线程上下文切换(对比synchronized性能提升显著);
-
硬件协同:依赖缓存一致性协议(MESI)和内存屏障保障原子性与顺序性;
-
场景适配:低竞争场景性能卓越,高竞争时需结合分段、退避等优化策略。
正如Java的
LongAdder设计所示:当硬件指令成为并发控制的基石,软件需在原子性与伸缩性间动态平衡——在NUMA与多核异构时代,CAS仍是高并发系统的核心利器 。
1.6 业务连续性管理(BCM)
从业务连续性管理(BCM)的方法与机制、高可用策略、软硬件协同三方面展开,结合行业实践和标准框架(如ISO 22301、银行业监管指引)进行系统分析:
1.6.1、业务连续性管理的方法与机制
-
业务影响分析(BIA)
-
核心作用:识别关键业务、评估中断影响(经济/非经济损失)、确定恢复优先级。例如,银行需明确支付清算等业务的RTO(恢复时间目标)≤4小时、RPO(恢复点目标)≤30分钟。
-
执行步骤:
-
识别关键业务流程及依赖关系(如信息系统、供应商);
-
量化不同中断时长的影响(如30分钟至8小时),采用打分卡评估损失等级;
-
确定MTPD(最大可接受中断时间)和恢复资源需求。
-
-
-
风险评估与应对
-
风险识别:覆盖四类中断原因——IT故障、外部服务中断、人为破坏(如黑客攻击)、自然灾害。
-
风险处置:通过降低(如加固系统)、转移(如保险)、接受等策略控制风险敞口。
-
-
应急计划制定
-
分层设计:
-
总体预案:定义组织架构、通讯流程、决策链;
-
专项预案:针对不同灾难场景(如数据中心宕机),明确业务应急手段与IT恢复的衔接;
-
外部协同:要求供应商、金融同业单位的BCP与本机构有效对接。
-
-
-
资源建设机制
-
备用资源类型:指挥中心、灾备数据中心、备用人力资源、电力/通讯冗余设施。
-
选址原则:避免同区域风险,综合评估自然环境、成本、配套服务(如云服务商可用区分布)。
-
-
演练与持续改进
-
演练频率:至少每三年覆盖全部重要业务,重大变更前需专项演练。
-
改进循环:通过审计、自评估(每年一次)更新BCP,确保与业务变更同步。
-
1.6.2、高可用策略在业务连续性中的应用
-
冗余架构设计
-
多实例部署:避免单点故障,通过负载均衡(如Nginx、Kubernetes Service)分发流量,结合健康检查自动剔除故障节点。
-
多数据中心容灾:
-
热备模式:备用数据中心实时同步数据,故障时秒级切换(如金融行业同城双活);
-
多活模式:跨地域数据中心同时服务,通过DNS/GSLB实现流量调度。
-
-
-
弹性与容错机制
-
自动扩缩容:依据CPU/请求量等指标动态调整实例数(如K8s HPA)。
-
熔断降级:
-
熔断器模式(如Hystrix):在依赖服务故障时快速失败,防止级联崩溃;
-
业务降级:高负载时关闭非核心功能(如电商限流排队)。
-
-
-
数据层高可用
-
分布式存储:采用Cassandra等数据库跨节点分片存储,通过Raft/Paxos协议保证一致性。
-
异步处理:消息队列(Kafka)解耦服务,确保故障时数据不丢失。
-
-
监控与自愈
-
全链路追踪:Jaeger/Zipkin定位微服务调用链故障点。
-
自动化恢复:K8s通过Pod重启、节点迁移实现故障自愈。
-
1.6.3、软硬件协同的业务连续性保障思路
-
基础设施协同
-
硬件冗余:服务器集群、存储双控制器、网络多路径互联。
-
软件定义资源:利用虚拟化(VMware)和容器化(Docker)快速迁移服务,减少对物理硬件的依赖。
-
-
统一监控与编排
-
联动响应:硬件故障(如存储宕机)触发VM自动迁移,同时通知应用层启动降级策略。
-
资源调度:OpenStack/Kubernetes根据硬件状态动态分配资源(如故障机柜内VM疏散)。
-
-
数据一致性保障
-
软硬件协同持久化:数据库利用SSD高速写入+WAL(预写日志),确保宕机时数据可通过日志恢复。
-
缓存与存储协同:Redis集群配合持久化存储,故障时从磁盘快速重建缓存。
-
-
灾备环境协同
-
灾备中心切换:存储阵列同步复制(如EMC SRDF)确保数据一致性,软件层通过DNS切换引流。
-
关键协同思路总结
|
维度 |
协同方法 |
案例/技术 |
|---|---|---|
|
故障检测 |
硬件传感器告警 + 应用监控集成(如Prometheus) |
服务器BMC告警触发K8s节点隔离 |
|
资源调度 |
虚拟化平台动态分配计算资源 + 应用层弹性伸缩策略 |
OpenStack根据业务负载自动扩容VM |
|
数据保护 |
存储快照 + 数据库备份协同(如Oracle RMAN) |
每小时存储快照与数据库增量备份联动 |
|
灾备切换 |
存储复制 + DNS/GSLB自动切换 |
阿里云跨可用区容灾方案 |
注:业务连续性管理需贯穿“预防-响应-恢复”全周期,软硬件协同的核心在于打破分层壁垒,通过自动化流程(如IaC脚本、运维编排)实现端到端快速恢复。同时,定期通过混沌工程(如Chaos Monkey)模拟故障,验证协同机制的有效性。
1.7 内存屏障的成因
关于内存屏障的成因及其在云计算与云原生领域的突破性解决方案的系统分析:
1.7.1、内存屏障的三大核心成因
-
指令重排序(Compiler & CPU Reordering)
-
编译器优化:为提升效率,编译器可能调整无数据依赖的指令顺序(如先写变量B再写变量A)。
-
CPU乱序执行:现代CPU的超标量架构允许指令并行执行,导致内存操作顺序与程序逻辑不一致(如先执行后续指令再处理缓存未命中的读操作)。
-
-
多核缓存一致性(Cache Coherency)
-
写缓冲与缓存延迟:CPU写入数据时先存入本地写缓冲,异步刷新至缓存;其他核心可能读到旧值。
-
MESI协议限制:缓存行状态切换(如Modified→Shared)需跨核通信,导致操作延迟和顺序错乱。
-
-
内存可见性(Memory Visibility)
-
跨核数据同步滞后:核心A修改共享变量后,核心B可能因缓存未更新而读到旧值(需屏障强制刷出写缓冲并失效其他缓存)。
-
1.7.2、云计算领域的内存屏障突破技术
1. 存算一体架构(打破“内存墙”)
-
近内存计算(Near-Memory Computing)
将计算单元嵌入内存控制器(如阿里云3D封装DRAM),减少数据搬运距离,降低屏障依赖。实测带宽提升300%,延迟下降60%。
-
存内计算(In-Memory Computing)
三星HBM2-PIM技术:在DRAM芯片内集成计算单元,直接处理数据,避免跨内存传输。AI训练任务能效比提升100倍。
2. 硬件级屏障优化
-
新型内存硬件:嘉合劲威MRDIMM内存模组通过多路复用技术提升带宽至12,800MT/s,减少因带宽不足导致的屏障等待。
-
智能内存子系统:云服务器采用硬件辅助的自动屏障插入(如Intel TSX指令集),动态识别并发冲突,减少冗余屏障。
3. 虚拟化层增强
-
透传内存语义:Hypervisor暴露CPU屏障指令(如x86
mfence)给虚拟机,避免虚拟化层引入额外重排序。 -
内存隔离优化:阿里云操作系统控制台实时检测“隐式内存占用”(如文件缓存),减少因内存争用触发的屏障频率。
1.7.3、云原生服务中的内存屏障创新实践
1. 轻量级容器与屏障协同
-
屏障感知的容器调度:
Kubernetes通过设备插件(Device Plugin)识别支持低延迟屏障的硬件节点(如MRDIMM),优先调度高并发任务。
-
容器内屏障最小化:
轻量级运行时(如gVisor)截获系统调用,自动替换冗余屏障(如将
mb()降级为smp_mb())。
2. 云边协同的屏障优化
-
边缘侧异步屏障:
阿里云OpenYurt平台在边缘节点采用“写合并+批量刷出”策略,将多次屏障合并为单次,通信开销降低70%。
-
动态屏障插入:
基于请求流分析(如服务网格Istio),在跨服务调用时动态插入屏障,避免全链路强一致性开销。
3. 软硬一体可观测性
-
屏障性能追踪:
阿里云操作系统控制台实时监控屏障指令占比,定位高屏障开销的服务(如数据库事务引擎),指导代码优化。
-
AI驱动的屏障策略:
基于强化学习动态选择屏障类型(如读屏障/全屏障),在金融交易系统中减少30%无效屏障。
总结:从“被动同步”到“主动规避”
内存屏障的本质是弥补硬件效率与程序逻辑的鸿沟。在云原生时代,其突破路径呈现三大趋势:
-
硬件革新:存算一体架构从物理层面减少数据搬运,降低屏障依赖(如HBM2-PIM提升100倍能效);
-
系统协同:云边协同通过异步合并与动态插入,将屏障开销转化为可控成本(如OpenYurt合并降低70%通信);
-
智能运维:AI驱动的屏障策略选择与实时追踪,实现“屏障最小化、效能最大化”(如金融系统减少30%冗余屏障)。
正如阿里云在亚运会系统中实现的10ms端到端延迟所示:当硬件革新、系统协同与智能运维形成三角支撑,内存屏障从性能瓶颈进化为可控工具,为云原生应用提供兼具效率与一致性的底层保障 🌟。
1.8 高可用系统设计内存屏障(Memory Barrier)
在高可用系统设计中,内存屏障(Memory Barrier)是保障多核/多线程环境下数据一致性和操作顺序性的核心机制。其设计需综合考虑硬件架构、系统层级和应用场景,以下是系统化的设计策略与解决方案:
1.8.1、内存屏障在高可用系统中的核心作用
-
数据一致性保障
内存屏障通过限制编译器和处理器的指令重排序,确保共享数据的修改对所有线程/处理器可见,防止因缓存不一致导致的数据错误。
-
示例:在分布式锁实现中,写屏障(Store Barrier)确保锁状态更新先于临界区操作,避免其他线程读到过期锁状态。
-
-
顺序性约束
全屏障(Full Barrier)强制屏障前的内存操作完成后,才能执行屏障后的操作,防止多线程逻辑错乱。
-
典型场景:数据库事务提交时,需屏障确保日志写入先于数据更新,防止崩溃恢复时日志缺失。
-
1.8.2、多层级内存屏障设计策略
1. 硬件层:指令级优化
-
选择合适屏障指令:
-
x86:
MFENCE(全屏障)、SFENCE(写屏障)、LFENCE(读屏障)。 -
ARM:
DMB(数据内存屏障)、DSB(数据同步屏障)。 -
优化建议:避免过度使用全屏障,优先采用轻量级读写屏障。例如写操作后仅用
SFENCE,读操作前仅用LFENCE。
-
-
缓存一致性协议协同:
结合MESI协议,通过缓存行状态管理(如
Modified→Shared转换)减少屏障使用。例如Intel CPU的LOCK前缀指令隐含屏障功能。
2. 操作系统层:内核与调度协同
-
中断处理:
在实时系统(RTOS)中,中断服务程序(ISR)内插入屏障,确保关键数据(如设备寄存器状态)更新后,再响应后续中断。
-
虚拟化支持:
Hypervisor透传硬件屏障指令,避免虚拟机因指令模拟引入额外延迟。例如KVM通过
vmexit事件直接映射MFENCE到物理CPU。
3. 应用层:编程模型优化
-
原子操作替代锁:
使用
CAS(Compare-and-Swap)或Fetch-and-Add等原子指令减少屏障数量。例如Java的AtomicInteger比synchronized减少80%屏障开销。 -
无锁数据结构:
设计无锁队列(如Disruptor框架),通过
volatile变量+读写屏障实现高效通信,避免锁竞争导致的线程阻塞。
1.8.3、性能与一致性的平衡策略
|
策略 |
实现方式 |
适用场景 |
|---|---|---|
|
屏障合并 |
编译器优化相邻屏障(如连续写屏障合并为1次) |
高频写操作(如日志系统) |
|
动态屏障插入 |
运行时监控竞争强度,低竞争时降级为轻量屏障(如ARM |
动态负载系统(电商秒杀) |
|
区域化内存模型 |
非关键路径采用弱一致性(如最终一致性),仅关键路径强一致+屏障 |
分布式存储(如Redis Cluster) |
1.8.4、分布式高可用场景的特殊挑战
-
跨节点一致性与屏障
-
挑战:内存屏障仅限单机,跨节点需分布式协议(如Raft)保证全局顺序。
-
方案:
-
本地事务提交后,
MFENCE确保日志落盘,再通过Paxos复制到其他节点。 -
结合向量时钟(Vector Clock)标记操作时序,替代全局屏障。
-
-
-
异构硬件兼容
-
问题:ARM与x86屏障语义差异(如ARM默认弱内存模型)。
-
解决:
-
抽象硬件屏障层(如C++
std::atomic_thread_fence)。 -
编译期多路径代码生成(
#ifdef __ARM__)。
-
-
1.8.5、容错与安全增强
-
屏障失效的预防
-
ABA问题:
CAS操作中数据被改后还原,导致屏障失效。方案:
AtomicStampedReference添加版本号(如32位版本号+64位指针)。
-
-
安全内存访问
-
写屏障隔离敏感数据(如加密密钥),防止推测执行泄露(如Spectre漏洞)。
-
总结:高可用架构中的内存屏障设计原则
-
精准化:按需选择屏障类型(读/写/全),避免冗余。
-
层级协同:硬件指令(如
MFENCE)→OS调度(中断屏蔽)→应用无锁化(Disruptor)。 -
动态适配:监控竞争强度,动态降级/合并屏障。
-
跨域扩展:单机屏障+分布式协议(Raft/Paxos)保障全局一致性。
正如阿里云金融级高可用架构实践所示:“内存屏障是数据一致性的最后防线,而非性能瓶颈的起点”——通过硬件感知的精准屏障策略,在5个9(99.999%)的可用性要求下,系统吞吐量仍可提升40%。
1.9 高可用的日志服务系统在时序场景下的设计
高可用的日志服务系统在时序场景下的设计需同时满足数据强时序性、写入高吞吐、故障快速恢复三大核心目标。以下是结合行业实践的关键技术方案与实现策略:
1.9.1、时序保障机制:确保日志顺序与完整性
-
保序写入设计
-
分区保序策略:将同一来源(如用户ID、机器IP)的日志通过一致性哈希映射到固定Shard,确保同一Shard内日志严格按时间顺序写入(如日志服务通过
hash_key指定Shard)。 -
全局有序性妥协:跨Shard日志仅保证局部有序(如单用户操作序列有序),全局有序需依赖时间戳近似排序(如Kafka通过
max.in.flight.requests.per.connection=1限制单分区保序)。
-
-
时序数据优化存储
-
日志元数据分离:仅记录时序数据的偏移位置(如LSN日志序列号),避免重复存储数据内容,减少磁盘I/O。
-
时间窗口分段:按时间切割日志文件(如每小时一个Segment),加速基于时间范围的查询(如查询过去5分钟日志仅需扫描最新Segment)。
-
1.9.2、高可用架构:多级冗余与故障自愈
-
多副本容灾机制
-
写入冗余:日志写入时同步复制到至少3个节点(如Elasticsearch的
wait_for_active_shards=2),确保单节点故障不丢数据。 -
跨区域部署:主备日志集群分置不同地域,通过异步复制实现异地容灾(如Loki将数据同步至S3跨区域存储桶)。
-
-
自动故障转移
-
健康检测与切换:监控节点心跳(如Prometheus的
blackbox_exporter),异常时自动切换流量至备用集群。 -
客户端重试策略:SDK内置退避重试(如指数退避算法),避免网络抖动导致写入失败。
-
1.9.3、性能与成本平衡:时序场景优化
-
高效写入优化
-
批量合并写入:日志收集器(如Fluentd)按时间窗口(如10秒)或大小(如1MB)批量发送日志,降低网络开销。
-
压缩传输:启用Snappy或ZSTD压缩日志,减少带宽消耗(如Filebeat的
compression_level=6)。
-
-
分级存储策略
存储层级
数据特征
技术方案
成本/性能
热存储
近实时日志(<7天)
内存加速(如Elasticsearch SSD缓存)
高成本、毫秒级查询
温存储
历史日志(7天-30天)
对象存储(如S3 Standard)
中成本、秒级查询
冷存储
归档日志(>30天)
压缩冷存储(如S3 Glacier)
低成本、分钟级检索
通过生命周期策略自动降级存储,节省70%+成本。
1.9.4、监控与自愈:闭环保障体系
-
全链路可观测性
-
时序指标监控:追踪日志写入延迟、错误率、Shard饱和度(如Prometheus采集Loki的
log_ingested_bytes_total)。 -
分布式追踪集成:在日志中嵌入
trace_id(如OpenTelemetry),关联日志与调用链路,快速定位瓶颈。
-
-
自动化恢复流程
-
日志回放机制:故障后通过持久化日志(如Raft Log)重放恢复状态(如目标节点按LSN顺序回放日志)。
-
自愈脚本:预置Ansible剧本,自动修复常见故障(如节点磁盘满时清理旧日志)。
-
1.9.5、典型技术栈选型对比
|
组件 |
时序优化能力 |
高可用设计 |
适用场景 |
|---|---|---|---|
|
ELK |
🔸 强:Elasticsearch时序索引优化 |
🔸 多副本分片+跨集群复制 |
复杂查询与实时分析场景 |
|
Loki |
🔸 中:依赖存储后端排序 |
🔸 无状态查询层+对象存储冗余 |
云原生环境低成本日志 |
|
Fluentd |
🔸 弱:需插件扩展保序能力 |
🔸 依赖后端存储的HA机制 |
灵活路由与预处理场景 |
注:金融级场景建议选择ELK+保序插件(如
logstash-input-kafka有序消费),互联网高并发场景可选Loki+用户分片保序。
总结:关键设计原则
-
分区保序优先全局有序:通过Shard内保序满足业务时序需求,避免跨分区同步开销。
-
冗余与自动化并重:多副本+自动切换保障可用性,结合重试与批处理提升写入韧性。
-
分级存储控制成本:热数据高速存取,温冷数据低成本归档,生命周期策略自动迁移。
-
闭环监控自愈:从指标告警到自动恢复形成闭环,MTTR(平均恢复时间)控制在分钟级。
实践建议:定期通过混沌工程(如模拟节点宕机、网络分区)验证时序保障与高可用机制的有效性。
二、数据中心容灾实现高可用
2.1 数据中心容灾
数据中心容灾系统的高可用与高可靠设计需融合多层级冗余策略、智能算法优化及硬件协同机制。
2.1.1、高可用架构设计方法
1. 多层级冗余策略
-
计算层冗余
N+1热备集群:采用主从复制(如MySQL半同步复制),主节点实时推送binlog至从节点,确保故障时RTO<30秒。关键服务部署双活架构(如Kubernetes多集群联邦),通过全局负载均衡(GSLB)实现跨DC流量调度,故障切换时间<10秒。
-
存储层冗余
三副本机制(如Ceph CRUSH算法):数据分块后按权重分布至不同机架,单机架故障零影响。公式:Ploss=∏i=1nPdisk_fail,通过增加副本数显著降低数据丢失概率。
-
网络层冗余
BGP+ECMP多路径:结合OSPF动态路由协议,链路故障时自动切换路径,收敛时间<1秒。跨DC骨干网采用分段路由(SRv6),路径恢复延迟降至50ms级。
2. 网络拓扑优化
-
双活数据中心设计
存储层采用同步复制(如EMC SRDF):数据写入需主备DC同时确认,保障RPO=0。网络层通过VXLAN叠加层实现大二层互通,避免ARP广播风暴。
-
异地三中心架构
主DC → 同城备DC(同步复制)→ 异地备DC(异步复制),形成级联保护。距离策略:同城≤100km(光纤延迟<1ms),异地≥300km(规避区域性灾难)。
2.1.2、容灾算法与数据一致性
1. 同步/异步复制策略
|
复制类型 |
算法逻辑 |
适用场景 |
代码实现要点 |
|---|---|---|---|
|
同步复制 |
两阶段提交(2PC)+ WAL日志 |
金融核心交易 |
Coordinator协调器原子广播决策 |
|
异步复制 |
消息队列(Kafka)+ 批次合并 |
日志分析系统 |
批量提交Offset,减少网络I/O |
|
半同步 |
多数派确认(Paxos变体) |
电商订单系统 |
超时降级机制保障最终一致 |
-
一致性保障算法
Raft共识协议:Leader选举(Term递增)+ 日志复制(AppendEntries RPC),确保强一致性。关键代码逻辑:
func (r *Raft) appendEntries(term int) {
    if r.currentTerm < term {
        r.becomeFollower(term)  // 降级为Follower
    }
    r.leaderId = leaderId
    r.commitIndex = min(entries[len(entries)-1].Index, leaderCommit)
}
2. 数据一致性验证
-
哈希校验模型
CRC32循环冗余校验:CRCcurrent=CRC32(Datablock),用于增量备份快照比对,误差率<10⁻⁹。
-
向量时钟冲突解决
分布式系统记录事件时序:C=(NodeID,LogicalTime),合并冲突时按时间戳优先级裁决。
2.1.3、时序处理与故障切换
1. 时序同步协议
-
硬件级时钟同步
PTP精密时钟协议(IEEE 1588):主时钟通过Sync报文从时钟校准,亚微秒级偏差。芯片实现:FPGA内置TCXO振荡器,温度漂移补偿算法。
-
逻辑时钟优化
混合逻辑时钟(HLC):HLC=max(PT,LT)+1,结合物理时间(PT)与Lamport时间(LT),解决跨DC时钟漂移问题。
2. 故障检测与切换
-
φ-accrual心跳检测
动态计算故障概率:ϕ=−log10(Pheartbeat_fail),当ϕ>ϕthreshold(如8.0)触发切换,较固定超时机制误报率降低60%。
-
RTO分解模型
RTO=Tdetect+Tfailover+Trecover,其中Tdetect依赖φ-accrual算法,Tfailover通过Raft选举优化。
2.1.4、硬件与芯片级容错
1. 芯片级容错机制
-
存储控制器
RAID-on-Chip(RoC)技术:集成XOR加速引擎,支持RAID 5/6实时校验。芯片内建LDPC纠错码,纠错能力达72bit/1KB,UBER<10⁻¹⁶。
-
内存保护
ECC内存 + Chipkill技术:单芯片故障时,通过分散校验位跨多DRAM芯片恢复数据,服务器宕机率下降90%。
2. 存储介质优化
|
介质类型 |
容错设计 |
适用场景 |
|---|---|---|
|
SSD |
冗余页映射表 + 磨损均衡 |
高频写数据库日志 |
|
磁盘阵列 |
热备盘全局池 + 前置校验 |
大容量冷数据存储 |
|
磁带库 |
LTFS线性磁带文件系统 |
法规归档数据 |
2.1.5、云原生与自动化管理
1. 混沌工程与故障预测
-
SIR传播模型
微分方程预测故障扩散:dtdI=βSI−γI,结合历史数据拟合β(扩散率)与γ(修复率),指导资源调度优先级。
-
蒙特卡洛模拟
容灾成功率计算:Psuccess=N1∑i=1NI(RTOi≤TSLA),通过万次故障注入验证RTO达标率。
2. 自愈系统实现
-
自动化故障处置流水线
graph LR
  A[监控告警] --> B{故障类型}
  B -->|硬件故障| C[隔离节点+VM迁移]
  B -->|数据损坏| D[触发副本重建]
  B -->|网络中断| E[切换BGP路由]
  C & D & E --> F[自愈报告生成]
结合Prometheus+Ansible,平均修复时间(MTTR)压缩至分钟级。
总结:设计原则与技术融合
-
冗余最小化:通过算法优化(如CRUSH分片)替代粗暴多副本,存储成本降低40%。
-
时序精准化:硬件时钟(PTP)→ 逻辑时钟(HLC)→ 业务时序(向量时钟)三级协同,跨DC操作延迟<2ms。
-
故障智能化:混沌工程预演 + SIR模型预测,实现从“被动响应”到“主动免疫”的跃迁。
-
芯片加速:RoC与LDPC硬件卸载,数据重建速度提升10倍。
正如两地三中心金融级容灾实践所示:当冗余架构、一致性算法与硬件加速深度融合,数据中心正式从“脆弱管道”进化为“抗毁有机体”。未来突破点在于量子加密传输(防物理窃听)与存算一体芯片(近数据处理降低时延)的协同创新。
2.2 跨数据中心容灾
跨数据中心容灾是实现系统高可用性的核心手段,通过地理分散的冗余设计、智能流量调度、数据同步与自动化故障切换,确保业务在灾难场景下的连续性。以下是系统化的实现方案及分层策略:
2.2.1、高可用架构设计
-
两地三中心模式
-
主数据中心:处理实时业务流量,部署同城双活架构(如金融行业要求RTO≤4小时)。
-
同城备份中心:距离主中心≤100公里,通过光纤专线实现数据同步(延迟<1ms),支持秒级切换。
-
异地容灾中心:距离>300公里,防范区域性灾难(如地震、洪水),采用异步复制平衡成本与数据一致性。
-
-
异地多活架构
-
动态流量路由:通过DNS全局负载均衡(如AWS Route53、阿里云GSLB)按用户地理位置分配流量,故障时自动切换。
-
单元化设计:业务按用户分片(如电商按区域划分),单元内闭环处理“订单+数据”,避免跨单元依赖。
-
-
应用与数据分离策略
-
无状态应用:容器化部署(如Kubernetes),支持跨中心弹性伸缩和故障迁移。
-
数据层冗余:数据库主从跨中心同步(MySQL半同步复制)、分布式存储(Ceph跨集群复制)。
-
2.2.2、数据同步与一致性保障
-
存储层复制
-
块级同步:EMC SRDF、NetApp SnapMirror实现存储设备级实时复制,RPO≈0。
-
对象存储跨区域复制:AWS S3 CRR、阿里云OSS跨区域复制保障非结构化数据一致性。
-
-
数据库层复制
-
多主架构:TiDB、Galera Cluster支持跨中心读写,通过全局唯一ID(雪花算法)避免主键冲突。
-
日志同步:Oracle GoldenGate解析事务日志,实现增量数据低延迟同步。
-
-
应用层数据同步
-
消息队列镜像:Kafka MirrorMaker跨集群复制消息,确保异步任务不丢失。
-
文件实时同步:DRBD(分布式块设备复制)或Rsync+inotify监控文件变化。
-
2.2.3、故障检测与切换机制
-
自动检测方法
-
心跳监控:Keepalived、Corosync检测节点存活状态。
-
全链路监控:Prometheus+Grafana实时追踪服务健康度,异常时触发告警(如SLB健康检查失败)。
-
-
切换策略
-
自动切换:预设RTO/RPO阈值(如RTO<1小时),通过脚本调用云平台API(如AWS Lambda)完成切换。
-
手动确认切换:核心系统需人工审批(运维控制台执行),避免误操作导致脑裂。
-
-
会话保持与恢复
-
分布式会话:Redis跨数据中心集群同步用户Session,故障时无缝衔接。
-
数据校验工具:Percona Toolkit对比主备数据差异,确保切换后一致性。
-
2.2.4、容灾演练与持续优化
-
定期测试验证
-
混沌工程:模拟数据中心宕机(如随机关闭集群节点),验证自动切换流程。
-
数据恢复演练:每季度恢复演练,测试备份数据可用性和恢复脚本有效性。
-
-
性能压测与优化
-
流量接管能力测试:灾备中心模拟全量生产流量,验证承载能力。
-
网络优化:专线带宽升级(如10Gbps)+数据压缩(Snappy算法)降低跨中心延迟。
-
-
流程标准化
-
容灾预案文档化:明确RTO/RPO指标、切换步骤、责任人。
-
自动化运维工具链:Ansible编排灾备环境扩容,Terraform管理基础设施代码。
-
2.2.5、行业定制化策略
-
金融行业
-
强一致性要求:数据库同步复制(RPO=0)+ 两地三中心物理隔离。
-
合规性:遵循《金融数据中心容灾建设指引》,定期审计。
-
-
互联网行业
-
成本优化:非核心业务异步复制+冷备存储,核心业务采用异地多活。
-
全球化容灾:区域化部署(如字节跳动海外双活架构)。
-
2.2.6、成本与安全策略
-
成本控制
-
分级容灾:核心业务热备+同步复制,非核心业务温备+异步复制。
-
云灾备服务:阿里云容灾服务按需付费,减少硬件投入。
-
-
安全与合规
-
数据传输加密:TLS/SSL加密跨中心流量,静态数据AES-256加密。
-
合规认证:满足等保三级、GDPR数据存储要求。
-
总结:核心实现框架
|
层级 |
关键技术 |
配置策略 |
|---|---|---|
|
流量调度 |
GSLB+SLB权重管理 |
按健康检查动态分配流量 |
|
数据同步 |
块存储复制+数据库多主集群 |
同步模式(RPO=0)或异步模式(成本优先) |
|
故障切换 |
自动脚本切换(热备)+人工审批(核心系统) |
RTO分级设定(分钟级/小时级) |
|
安全合规 |
传输加密+静态数据加密+合规存储 |
等保三级/GDPR审计 |
系统高可用本质是“预防-检测-恢复”闭环:通过冗余架构预防单点故障,实时监控快速定位问题,自动化切换最小化业务中断。定期演练优化流程,结合业务需求平衡成本与可靠性,方能构建真正韧性的跨中心容灾体系。
2.3 异地多活架构跨数据中心的数据一致性
在异地多活架构中,跨数据中心的数据一致性是核心挑战,需结合业务容忍度、网络延迟和故障容灾需求进行技术选型。以下是主流解决方案及其权衡分析:
2.3.1、数据一致性问题的核心难点
-
物理延迟不可突破
-
跨地域网络延迟(如北京-纽约约120ms),强一致性需多中心同步确认,显著增加响应时间。
-
-
多活写入冲突
-
多个数据中心同时修改同一数据(如用户余额),引发写写冲突。
-
-
网络不稳定风险
-
跨地域专线可能丢包、抖动或中断,导致同步失败或数据丢失。
-
2.3.2、典型技术方案与实现机制
1. 一致性模型选择(业务分级治理)
|
模型 |
技术实现 |
适用场景 |
性能影响 |
|---|---|---|---|
|
强一致性 |
Paxos/Raft协议多中心同步确认(如金融交易需≥N/2+1节点确认) |
支付、证券交易(RPO=0) |
高延迟(跨洲写入>200ms) |
|
最终一致性 |
异步复制 + 冲突解决(如LWW规则、业务补偿) |
社交动态、用户昵称(容忍分钟级延迟) |
低延迟(本地写入即返回) |
|
因果一致性 |
向量时钟(Vector Clock)追踪操作依赖链,保证关联操作有序 |
电商订单、物流跟踪 |
中等延迟(仅同步因果链) |
案例:某跨境支付平台对余额采用强一致性(多中心确认),交易备注采用最终一致性,延迟从300ms降至180ms。
2. 冲突检测与解决机制
-
冲突检测
-
向量时钟:记录各数据中心操作版本(如
{北京:3, 纽约:2}),通过版本比对识别并发写冲突。 -
全局事务ID(GTID):为每次操作分配唯一ID(含数据中心标识+时间戳),按ID顺序合并操作。
-
-
冲突解决策略
-
自动解决:时间戳策略(Last-Write-Wins)、业务优先级(如库存冲突取最小值)。
-
人工介入:复杂冲突写入待处理队列,通过控制台可视化决策(如用户手机号两地同时修改)。
-
3. 高效同步与传输优化
-
日志压缩与编码
-
使用LZ4/ZSTD压缩变更日志(压缩比1:5~1:10),Protocol Buffers替代JSON减少序列化开销30%+。
-
-
传输协议优化
-
QUIC协议替代TCP:0-RTT连接复用+抗丢包能力,跨洲传输延迟降低20%。
-
批量传输窗口:按500ms窗口聚合日志,减少网络拥塞。
-
-
分布式数据库支持
-
NewSQL数据库(如TiDB、CockroachDB):内置多活同步和强一致性协议,简化应用层设计。
-
4. 幂等性与补偿机制
-
幂等设计:所有写入操作支持重复执行(如基于唯一ID去重),避免网络重试导致数据错乱。
-
事务补偿:失败操作触发反向逻辑(如库存扣减失败后自动回滚),依赖Saga/TCC模式。
2.3.3、关键技术权衡(Trade-offs)
|
维度 |
强一致性方案 |
最终一致性方案 |
|---|---|---|
|
数据可靠性 |
零丢失(RPO=0) |
可能丢失未同步数据(RPO>0) |
|
写入延迟 |
高(依赖跨中心确认) |
低(本地写入即返回) |
|
业务复杂度 |
需改造应用(如分布式事务) |
需冲突检测与补偿逻辑 |
|
适用场景 |
金融核心交易、账户余额 |
社交动态、非关键配置 |
|
成本 |
高(专线带宽+计算资源消耗) |
低(异步传输资源占用少) |
典型案例对比:
-
金融行业:牺牲延迟换取强一致(如两地三中心+同步复制),满足合规但吞吐量受限(仅1500 TPS)。
-
电商平台:采用分区多活(按用户分片),本地主写分片延迟<50ms,非主写分片最终一致。
2.3.4、前沿演进方向
-
CRDT(无冲突复制数据类型)
-
基于数学理论(交换律、结合律、幂等律)自动合并冲突,适用于计数器、集合等数据结构。
-
-
AI驱动的动态一致性
-
机器学习预测网络状态与业务热点,自动降级一致性级别(如延迟>300ms时降级为最终一致)。
-
-
云原生多活
-
Kubernetes跨地域编排,根据集群规模动态调整同步策略,实现资源弹性伸缩。
-
总结建议
-
业务分级:核心交易用强一致(如支付),非核心数据用最终一致(如用户评价)。
-
技术组合:强一致协议(Paxos)保障关键数据,CRDT/向量时钟解决普通冲突,QUIC传输降低延迟。
-
持续验证:通过混沌工程模拟数据中心故障,定期校验数据一致性(如GTID对账)。
注:没有普适最优解,需根据业务容忍度(如金融RPO=0 vs. 社交允许分钟级不一致)和成本预算综合选择。支付宝的混合模式(分区多活+核心强一致)是平衡典范。
2.4 电商平台的分区多活架构平衡高并发、低延迟与数据一致性
在电商平台的分区多活架构中,平衡高并发、低延迟与数据一致性需采用分层策略和动态机制设计。以下是关键设计原则及技术实现方案:
2.4.1、业务分级:按数据敏感性定制一致性策略
-
强一致性场景(核心交易)
-
范围:库存扣减、支付状态、订单创建(需原子性操作)。
-
策略:
-
分布式事务:采用TCC(Try-Confirm-Cancel)模式或Saga事务链,例如库存预占时先锁定资源,支付成功后确认。
-
全局锁:通过Redis分布式锁或ZooKeeper协调跨分区写操作,避免超卖(如秒杀场景)。
-
-
案例:订单创建时使用全局锁(
@DistributedLock),确保跨区操作串行化。
-
-
最终一致性场景(非核心数据)
-
范围:用户昵称、商品评价、浏览历史。
-
策略:
-
异步复制:通过消息队列(如Kafka)异步同步变更,允许分钟级延迟。
-
冲突解决:采用时间戳(LWW)或客户端版本合并(如购物车操作序列合并)。
-
-
-
因果一致性场景(业务链关联数据)
-
范围:订单状态流(下单→支付→发货)。
-
策略:
-
向量时钟:追踪操作依赖链,确保关联事件有序同步(如支付成功后再更新订单状态)。
-
全局事务ID(GTID):标记操作顺序,跨区重放时保序。
-
-
2.4.2、技术方案:多级同步与冲突治理
-
数据同步引擎
-
强一致同步:
-
数据库原生协议(如MySQL Group Replication),同城延迟<100ms,适用于用户账户信息。
-
分布式数据库(TiDB),通过Raft协议实现跨区强一致,支持全局索引。
-
-
高效异步同步:
-
日志压缩传输:使用Debezium捕获数据库变更日志,经LZ4压缩后通过Kafka跨区传输,带宽节省40%+。
-
边缘节点加速:在区域间部署边缘同步节点,聚合日志后批量转发,降低跨洲延迟(如法兰克福节点服务欧洲用户)。
-
-
-
冲突检测与解决
-
自动冲突解决:
-
字段级优先级:余额冲突取最大值(防资金损失),库存冲突取最小值(防超卖)。
-
业务规则引擎:预置策略库(如“支付记录按时间戳合并”)。
-
-
人工介入机制:
-
可视化冲突看板,展示冲突字段历史值,支持一键修复。
-
异步补偿任务:定时修复不一致数据(如对账服务校验余额)。
-
-
2.4.3、性能优化:平衡一致性与并发能力
-
动态降级机制
-
一致性动态调节:
-
当跨区网络延迟>300ms时,非核心业务自动降级为最终一致。
-
大促期间库存同步频率从1秒放宽至5秒,提升吞吐量。
-
-
地域亲和性路由:
-
用户请求优先路由至归属分区(如华北用户访问北京分区),减少跨区调用。
-
-
-
缓存与预同步协同
-
本地缓存加速:热点数据(如商品详情)分区缓存,TTL≤5分钟,变更时主动失效。
-
数据预加载:预测用户行为(如即将访问的商品),提前同步至目标分区。
-
2.4.4、容灾与监控:保障策略落地
-
多活容灾设计
-
分区自治:每个分区具备独立数据库和服务集群,单分区故障不影响全局(如华东故障时流量切至华北)。
-
灰度切换:先迁移10%用户验证数据一致性,再全量切换。
-
-
全链路监控
-
一致性度量:
指标
监控工具
阈值
主从延迟
Prometheus
<500ms
同步失败率
ELK日志分析
<0.1%
冲突修复时效
运维平台Dashboard
<5分钟
-
混沌测试:模拟分区故障(如切断专线),验证自动降级与恢复流程。
-
2.4.5、典型电商场景实施案例
订单与库存的多活方案:
-
库存分区自治:
-
库存按SKU分片,各分区管理本地库存(如SKU-A归属华北分区)。
-
跨区购买时,通过TCC预占对方分区库存,成功后异步调账。
-
-
订单全局一致:
-
订单创建强一致:写入TiDB全局库,分区缓存订单数据供查询。
-
物流状态最终一致:通过消息队列异步同步快递信息。
-
总结:分区多活的一致性设计原则
-
分级治理:核心交易强一致(CP),非核心数据最终一致(AP),通过业务分级匹配CAP约束。
-
分层同步:数据库日志同步保障基础,消息队列解耦业务,缓存提升体验。
-
动态平衡:根据网络状态与业务负载自动调整一致性级别,避免“过度设计”。
-
冲突兜底:自动解决覆盖90%场景,剩余10%通过人工干预与补偿机制修复。
注:实践中需避免“一致性超配”,例如商品详情页无需强一致,而库存扣减必须强一致。支付宝的“分区多活+核心强一致”混合模式证明,合理权衡可同时支撑50万TPS与RPO=0的金融级要求。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 24
 0
- 0


 已为社区贡献2条内容

所有评论(0)