RAG基础:基于markdown_split的Markdown文本分割实战
·
一、要求实现如下功能:
功能:
headers_to_split_on
支出混合的拆块(支持 chunk_size、chunk_overlap)
支持 chunk 元数据
markdown 中的代码不拆分
支持strip_headers 参数设置
二、题解
思路解析:
实现思路
1. 分层处理策略 :
- 第一层:使用 MarkdownHeaderTextSplitter 按标题级别分割文本,保留标题结构
- 第二层:对非代码块内容使用 RecursiveCharacterTextSplitter 进行语义分割
- 特殊处理:识别并完整保留代码块,不进行拆分
2. 核心功能实现 :
- 标题分割 :通过 headers_to_split_on 参数定义要分割的标题级别
- 混合拆块 :结合标题分割和字符分割,支持 chunk_size 和 chunk_overlap 参数
- 元数据保留 :在分割过程中传递和保留文档元数据
- 代码块保护 :通过检测代码块标记(```),确保代码块完整性
3. 技术要点 :
- 使用状态机识别代码块的开始和结束
- 对普通文本和代码块采用不同的处理策略
- 保留原始文档的元数据信息
- 支持自定义标题级别和分割参数
代码:
from langchain_text_splitters import MarkdownHeaderTextSplitter,RecursiveCharacterTextSplitter

def markdown_split(
    markdown_text,  # 输入的Markdown文本
    headers_to_split_on=None,  # 要分割的标题级别
    chunk_size=500,  # 单个块最大字符数
    chunk_overlap=100,  # 相邻块重叠字符数
    code_block_handling=True  # 是否保留代码块完整性
):
    """
    Markdown文本分割函数

    Args:
        markdown_text: 输入的Markdown文本
        headers_to_split_on: 要分割的标题级别,格式为[(\"#\", \"一级标题\"), (\"##\", \"二级标题\")]
        chunk_size: 单个块最大字符数
        chunk_overlap: 相邻块重叠字符数
        code_block_handling: 是否保留代码块完整性

    Returns:
        分割后的Document对象列表
    """

    # 默认标题级别
    if headers_to_split_on is None:
        headers_to_split_on = [
            ("#", "一级标题"),
            ("##", "二级标题"),
            ("###", "三级标题"),
        ]

    # 1. 使用MarkdownHeaderTextSplitter按标题分割
    markdown_splitter = MarkdownHeaderTextSplitter(
        headers_to_split_on=headers_to_split_on,
        strip_headers=False,
        return_each_line=False
    )

    # 执行标题分割
    header_split_docs = markdown_splitter.split_text(markdown_text)

    # 2. 初始化递归字符分割器,用于二次分割长内容
    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=chunk_size,
        chunk_overlap=chunk_overlap,
        separators=["\n\n", "\n", "。", "!", "?", ";", ",", " "],
        length_function=len,
        is_separator_regex=False
    )

    # 3. 处理每个标题分割后的部分
    final_docs = []

    for doc in header_split_docs:
        content = doc.page_content
        metadata = doc.metadata.copy()

        # 如果需要保留代码块完整性
        if code_block_handling and "```" in content:
            # 分割代码块和普通文本
            parts = []
            #
            current_part = ""
            in_code_block = False

            for line in content.split("\n"):
                if line.startswith("```"):
                    if in_code_block:
                        # 代码块结束
                        current_part += line + "\n"
                        parts.append((current_part, True))  # True表示是代码块
                        current_part = ""
                        in_code_block = False
                    else:
                        # 代码块开始
                        if current_part:
                            parts.append((current_part, False))  # False表示普通文本
                        current_part = line + "\n"
                        in_code_block = True
                else:
                    current_part += line + "\n"

            # 处理最后一个部分
            if current_part:
                parts.append((current_part, False))

            # 对普通文本进行分割,保留代码块完整
            for part, is_code in parts:
                if is_code:
                    # 代码块直接添加,不分割
                    final_docs.append(type(doc)(page_content=part, metadata=metadata))
                else:
                    # 普通文本使用递归分割器
                    sub_docs = text_splitter.create_documents([part])
                    for sub_doc in sub_docs:
                        # 保留原始元数据
                        sub_doc.metadata = metadata.copy()
                        final_docs.append(sub_doc)
        else:
            # 不需要保留代码块完整性,直接使用递归分割器
            sub_docs = text_splitter.create_documents([content])
            for sub_doc in sub_docs:
                # 保留原始元数据
                sub_doc.metadata = metadata.copy()
                final_docs.append(sub_doc)

    return final_docs

with open("测试数据.md",'r',encoding='utf-8')as f:
        test_markdown=f.read()

# 执行分割
result_docs = markdown_split(
    test_markdown,
    chunk_size=200,
    chunk_overlap=50
)

# 输出结果
print("=== markdown_split 分割结果 ===")
for i, doc in enumerate(result_docs, 1):
    print(f"\n块 {i}:")
    print(f"字符数: {len(doc.page_content)}")
    print(f"元数据: {doc.metadata}")
    print(f"内容:\n{doc.page_content}")
    print("-" * 80)
运行结果:
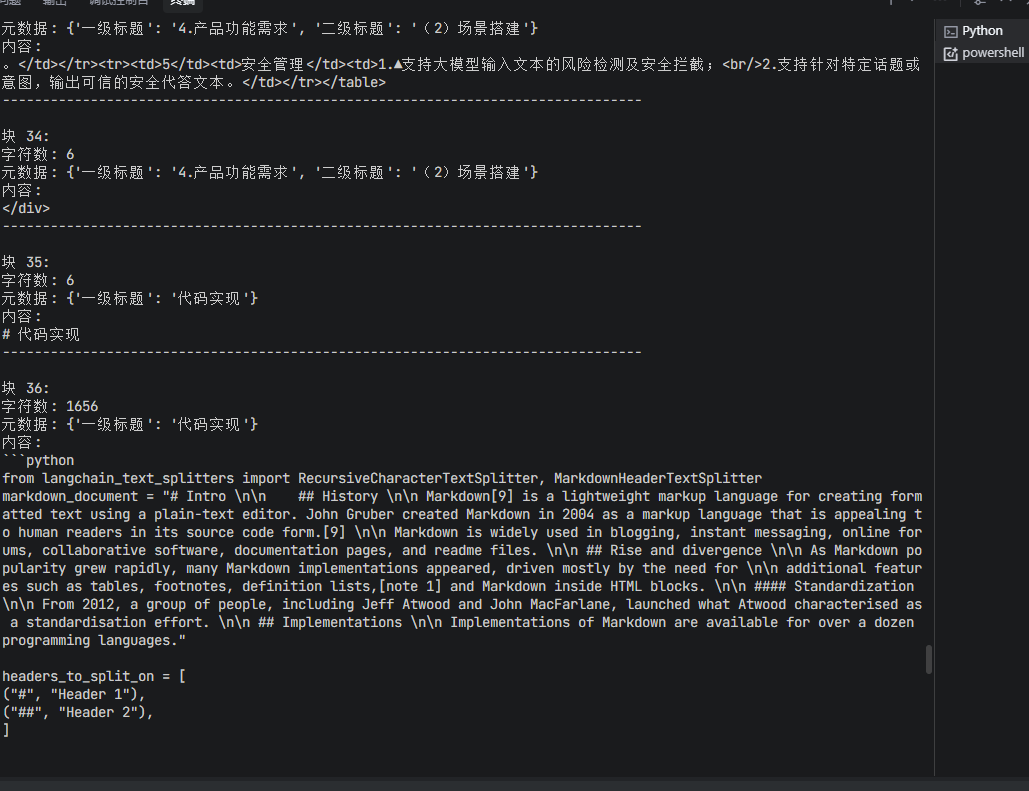
数据样例已上传。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)