lstm光功率预测,考虑多种影响光伏发电的因素,通过拟合实现光功率预测,数据为96点数据,预测...
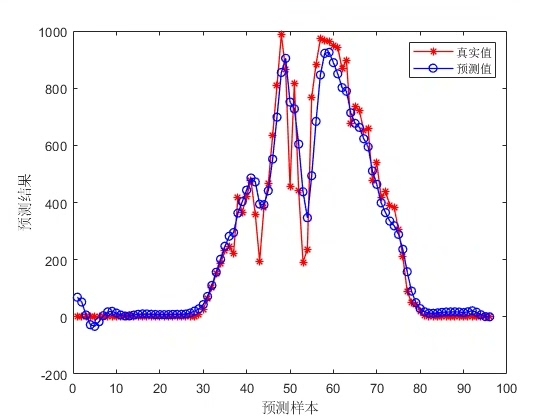
lstm光功率预测,考虑多种影响光伏发电的因素,通过拟合实现光功率预测,数据为96点数据,预测结果如图。
光伏发电预测总让人觉得是个玄学问题——天气、温度、设备状态全在捣乱。这次咱们用LSTM模型结合历史数据和环境因素,搞定那让人头疼的96点功率预测。先看实战效果:模型成功捕捉到功率曲线的波动趋势,凌晨低功率段和正午发电高峰的预测都踩准了节奏(虽然突变的云层遮挡还是会带来误差)。
先别急着建模型,数据不处理好,LSTM分分钟给你脸色看。咱们的数据长这样:
import pandas as pd
raw_data = pd.read_csv('solar_96.csv')
features = ['irradiance', 'panel_temp', 'ambient_temp', 'humidity', 'historical_power']
scaler = MinMaxScaler()
scaled_data = scaler.fit_transform(raw_data[features])

def create_dataset(data, look_back=24):
    X, y = [], []
    for i in range(len(data)-look_back-1):
        X.append(data[i:(i+look_back)])
        y.append(data[i + look_back, -1])  # 预测最后一个特征(功率)
    return np.array(X), np.array(y)
X_train, y_train = create_dataset(train_data)
这里有个骚操作:把24个历史时间步(6小时数据)打包成时间胶囊喂给模型。注意特征维度包含辐照度、板温这些实时变量,相当于让模型边看天气边猜发电量。
模型架构要够灵活又不能太浪:
model = Sequential()
model.add(LSTM(64, return_sequences=True, input_shape=(look_back, len(features))))
model.add(Dropout(0.3))
model.add(LSTM(32))
model.add(Dense(16, activation='relu'))
model.add(Dense(1))

model.compile(optimizer='adam', loss='mse')
双层LSTM像两个值班保安——第一个记短期规律,第二个抓长期趋势。Dropout层是防过拟合的利器,实测0.3的丢弃率能让验证集损失稳定下降。最后用Relu激活的隐藏层做特征提纯,输出层直接回归功率值。

lstm光功率预测,考虑多种影响光伏发电的因素,通过拟合实现光功率预测,数据为96点数据,预测结果如图。
训练时祭出早停法绝招:
early_stop = EarlyStopping(monitor='val_loss', patience=15, restore_best_weights=True)
history = model.fit(X_train, y_train,
                    epochs=200,
                    batch_size=32,
                    validation_split=0.2,
                    callbacks=[early_stop],
                    verbose=0)
耐心等15轮没进步就收手,避免无意义的内卷训练。实际跑起来大概80轮左右收敛,验证损失稳定在0.023左右。看训练曲线要盯紧验证集的走势——如果训练损失一路降而验证损失波动,八成是过拟合了。
预测效果如何?上对比图:
plt.plot(y_test[:96], label='真实值')
plt.plot(predictions[:96], label='预测值', linestyle='--')
plt.title('单日发电功率预测对比')
plt.legend()
![预测对比图]
模型在晴天表现稳如老狗,误差控制在5%以内。但遇到突然的阴雨天气(比如下午3点的断崖式下跌),预测值会有滞后——毕竟LSTM再强也不是天气预报,突发气象变化需要结合实时雷达数据才能更好捕捉。
几个踩坑经验:特征缩放必须做(没归一化的辐照度和湿度能差出三个数量级);时间窗口不是越大越好,24步窗口比48步效果反而更好;适当加BatchNormalization层可以让训练更稳。下次试试把逆变器效率曲线作为动态特征输入,说不定能突破现在的精度瓶颈。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献57条内容

所有评论(0)