软件测试之接口自动化测试篇(沉淀中)
文章目录
1. 接⼝测试
1.1 接⼝的概念
接⼝⼀般来说有两种,⼀种是程序内部的接⼝,⼀种是系统对外的接⼝。程序内部的接⼝:⽅法与⽅法之间,模块与模块之间的交互,程序内部抛出的接⼝,⽐如贴吧系统,有登录模块、发帖模块等等,那你要发帖就必须先登录,要发帖就得登录,那么这两个模块就得有交互,它就会抛出⼀个接⼝,供内部系统进⾏调⽤。系统对外的接⼝:⽐如你要从别的⽹站或服务器上获取资源或信息,别⼈肯定不会把数据库共享给你,他只能给你提供⼀个他们写好的⽅法来获取数据,你引⽤他提供的接⼝就能使⽤他写好的⽅法,从⽽达到数据共享的⽬的,⽐如说咱们⽤的app、⽹址这些它在进⾏数据处理的时候都是通过接⼝来进
⾏调⽤的。
接⼝类型有很多,如HTTP API接⼝、RPC等等,接下来我们基于HTTP API接⼝继续讲解。
1.2 接⼝测试
1.2.1 概念
接⼝测试是测试系统组件间接⼝的⼀种测试。接⼝测试主要⽤于检测外部系统与系统之间以及内部各
个⼦系统之间的交互点。测试的重点是要检查数据的交换,传递和控制管理过程,以及系统间的相互
逻辑依赖关系等。
简⽽⾔之,所谓接⼝测试就是通过测试不同情况下的⼊参与之相应的出参信息来判断接⼝是否符合或
满⾜相应的功能性、安全性要求。
其实接⼝测试很简单,⽐⼀般的功能测试还简单(⾮官⽅表述,有感⽽发),因为功能测试是从⻚⾯
输⼊值,然后通过点击按钮或链接等传值给后端,⽽且功能测试还要测UI、前端交互等功能,但接⼝
测试没有⻚⾯,它是通过接⼝规范⽂档上的调⽤地址、请求参数,拼接报⽂,然后发送请求,检查返
回结果,所以它只需测⼊参和出参就⾏了,相对来说简单了不少。
1.2.2 接⼝组成
接⼝⽂档⽰例接口文档
接⼝⽂档应该包含以下内容:
• 接⼝说明
• 调⽤url
• 请求⽅法(get\post)
• 请求参数、参数类型、请求参数说明
• 返回参数说明
由接⼝⽂档可知,接⼝⾄少应有请求地址、请求⽅法、请求参数(⼊参和出参)组成,部分接⼝有请求头 header 。标头 (header):是服务器以HTTP协议传HTML资料到浏览器前所送出的字符串,在标头与 HTML ⽂件
之间尚需空⼀⾏分隔,⼀般存放 cookie 、 token 等信息header和⼊参有什么关系?它们不都是发送到服务器的参数吗?
它们确实都是发送到服务器⾥的参数,但它们是有区别的,header⾥存放的参数⼀般存放的是⼀些校验信息,⽐如cookie,它是为了校验这个请求是否有权限请求服务器,如果有,它才能请求服务器,然后把请求地址连同⼊参⼀起发送到服务器,然后服务器会根据地址和⼊参来返回出参。也就是说,服务器是先接受header信息进⾏判断该请求是否有权限请求,判断有权限后,才会接受请求地址和⼊参的。
1.3 接⼝测试重要性
接⼝其实就是前端⻚⾯或APP等调⽤与后端做交互⽤的,有⼈会问,功能测试都测好了,为什么还要测
接⼝呢?
eg:
⽐如测试⽤⼾注册功能,规定⽤⼾名为6~18个字符,包含字⺟(区分⼤⼩写)、数字、下划线。
⾸先功能测试时肯定会对⽤⼾名规则进⾏测试时,⽐如输⼊20个字符、输⼊特殊字符等,但这些可能
只是在前端做了校验,后端可能没做校验,如果有⼈通过抓包绕过前端校验直接发送到后端怎么办
呢?试想⼀下,如果⽤⼾名和密码未在后端做校验,⽽有⼈⼜绕过前端校验的话,那⽤⼾名和密码不
就可以随便输了吗?如果是登录可能会通过SQL注⼊等⼿段来随意登录,甚⾄可以获取管理员权限,
那这样不是很恐怖?
所以,接⼝测试的必要性就体现出来了:
• 可以发现很多在⻚⾯上操作发现不了的bug
• 检查系统的异常处理能⼒
• 检查系统的安全性、稳定性
• 前端随便变,接⼝测好了,后端不⽤变
1.4 如何执⾏接⼝测试
在进⾏接⼝测试前,还需要了解:
- get和post请求
get请求:get
get和post是常⻅的请求⽅法。如果是get请求的话,直接在浏览器⾥输⼊就⾏了,只要在浏览器⾥⾯
直接能请求到的,都是get请求,如果是post的请求的话,就不⾏了,就得借助⼯具来发送。 - http状态码
每发出⼀个http请求之后,都会有⼀个响应,http本⾝会有⼀个状态码,来标⽰这个请求是否成功,
常⻅的状态码有以下⼏种:• 200 2开头的都表⽰这个请求发送成功,最常⻅的就是200,就代表这个请求是ok的,服务器也返
回了。
• 300 3开头的代表重定向,最常⻅的是302,把这个请求重定向到别的地⽅了。
• 400 400代表客⼾端发送的请求有语法错误,401代表访问的⻚⾯没有授权,403表⽰没有权限访
问这个⻚⾯,404代表没有这个⻚⾯
• 500 5开头的代表服务器有异常,500代表服务器内部异常,504代表服务器端超时,没返回结果
接⼝测试分两步⾛:通过接⼝设计⽤例 + 结合业务逻辑来设计⽤例
1.4.1 接⼝⽤例的编写
-
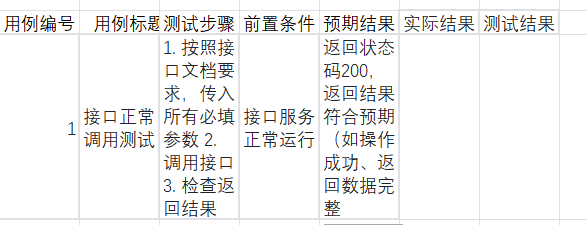
通过性验证:⾸先肯定要保证这个接⼝功能是好使的,也就是正常的通过性测试,按照接⼝⽂档上
的参数,正常传⼊,是否可以返回正确的结果。
-
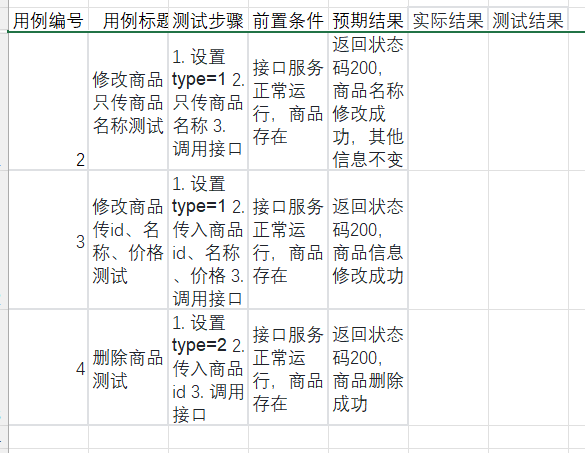
参数组合:现在有⼀个操作商品的接⼝,有个字段type,传1的时候代表修改商品,商品id、商品名称、价格有⼀个是必传的,type传2的时候是删除商品,商品id是必传的,这样的,就要测参数组合了,type传1的时候,只传商品名称能不能修改成功,id、名称、价格都传的时候能不能修改成功。
-
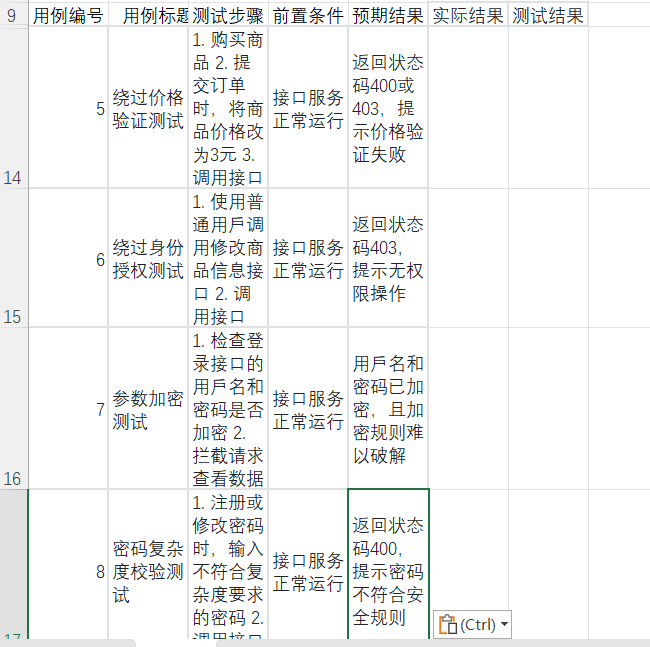
接⼝安全:
◦ 绕过验证,⽐如说购买了⼀个商品,它的价格是300元,那我在提交订单时候,我把这个商品的
价格改成3元,后端有没有做验证,更狠点,我把钱改成-3,是不是我的余额还要增加?
◦ 绕过⾝份授权,⽐如说修改商品信息接⼝,那必须得是卖家才能修改,那我传⼀个普通⽤⼾,
能不能修改成功,我传⼀个其他的卖家能不能修改成功
◦ 参数是否加密,⽐如说我登陆的接⼝,⽤⼾名和密码是不是加密,如果不加密的话,别⼈拦截
到你的请求,就能获取到你的信息了,加密规则是否容易破解。
◦ 密码安全规则,密码的复杂程度校验
-
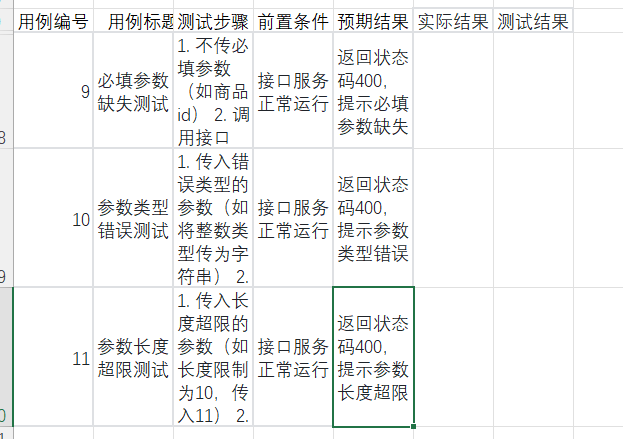
异常验证:
所谓异常验证,也就是我不按照你接⼝⽂档上的要求输⼊参数,来验证接⼝对异常情况的校验。⽐如
说必填的参数不填,输⼊整数类型的,传⼊字符串类型,⻓度是10的,传11,总之就是你说怎么来,
我就不怎么来,其实也就这三种,必传⾮必传、参数类型、⼊参⻓度。⽤例编
号
1.4.2 结合业务逻辑来设计⽤例
根据业务逻辑来设计的话,就是根据⾃⼰系统的业务来设计⽤例,这个每个公司的业务不⼀样,就得
具体的看⾃⼰公司的业务了,其实这也和功能测试设计⽤例是⼀样的。
举个例⼦,拿贴吧来说,贴吧的需求是这样的:
- 登录失败5次,就需要等待15分钟之后再登录
- 新注册的⽤⼾需要过了实习期才能发帖
- 删除帖⼦扣除积分
- …
像这样需要把这些测试点列出来,然后再去造数据测试对应的测试点。
2. 接⼝⾃动化测试
2.1 概念
接⼝⾃动化是通过对接⼝进⾏测试和模拟,以确保软件系统内部的各个组件能够正确地相互通信和交换数据。接⼝⾃动化测试可以显著提⾼测试效率和准确性。因为接⼝测试专注于测试系统内部的逻辑和数据传输,⽽不是像UI测试那样关注⽤⼾的操作和交互。同时,由于接⼝测试直接针对系统内部的结构和功能,可以更容易地发现和定位问题,减少测试成本和时间。
2.2 接⼝⾃动化流程
- 需求分析◦ 分析请求:明确接⼝的URL、请求⽅法(如get、post、PUT、DELETE等)、请求头、请求参
数和请求体等信息。
◦ 分析响应:确定接⼝返回的数据格式、状态码以及可能的错误信息。 - 挑选⾃动化接⼝
◦ 根据项⽬的时间、⼈员安排和接⼝的复杂度,挑选适合⾃动化测试的接⼝。
◦ 优先选择核⼼业务接⼝、频繁使⽤的接⼝以及容易出错的接⼝进⾏⾃动化测试。
功能复杂度:优先选择功能复杂、逻辑分⽀多的接⼝进⾏⾃动化测试。例如,涉及多种⽀付⽅式、
多种订单状态转换的订单管理接⼝,⼿动测试难以全⾯覆盖所有场景,⾃动化测试可以更⾼效地进
⾏测试.
⾼⻛险功能:选择对业务影响⼤、⻛险⾼的接⼝进⾏⾃动化测试,确保其稳定性和可靠性。例如,
涉及资⾦操作的⽀付接⼝,⼀旦出现问题可能导致严重的经济损失,因此需要进⾏充分的⾃动化测
试.
重复性⾼:对于需要频繁执⾏的测试任务,如回归测试中的接⼝测试,⾃动化测试可以避免重复⼿
动测试的繁琐和低效,提⾼测试效率.
假设我们正在开发⼀个在线教育平台,该平台包含以下接⼝:
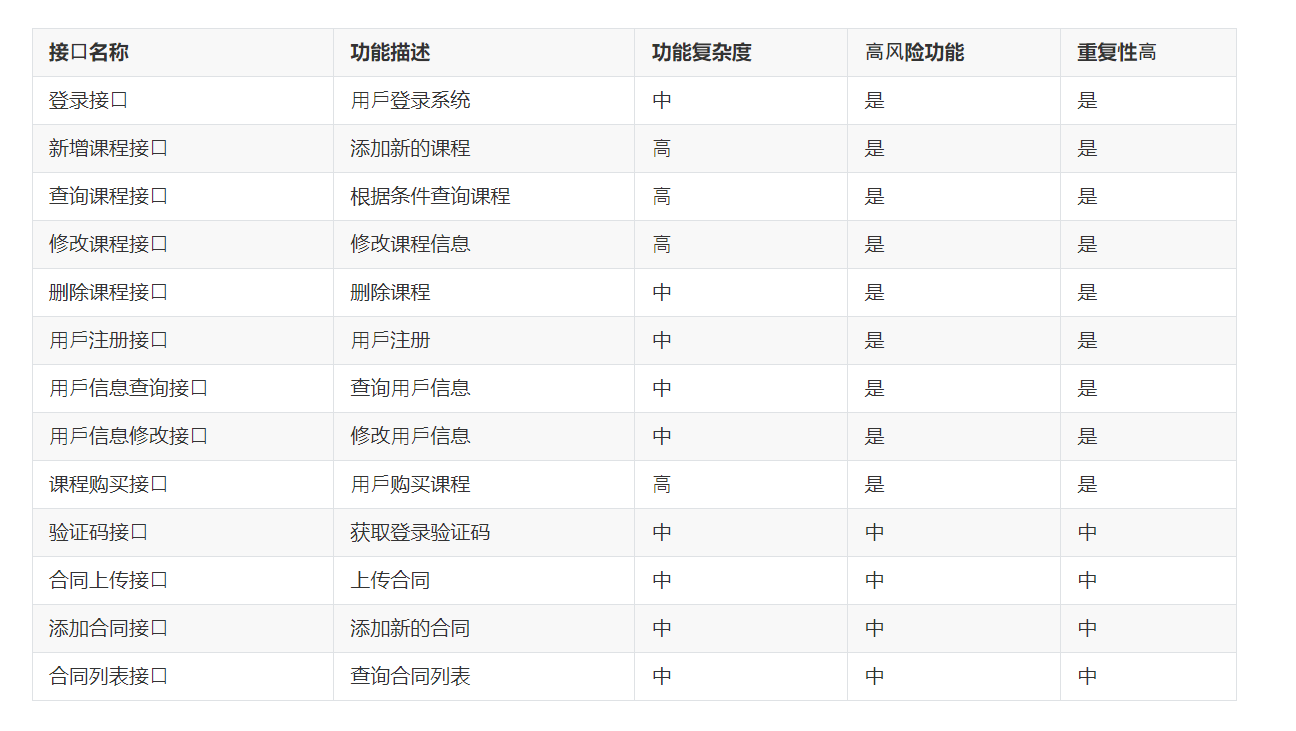
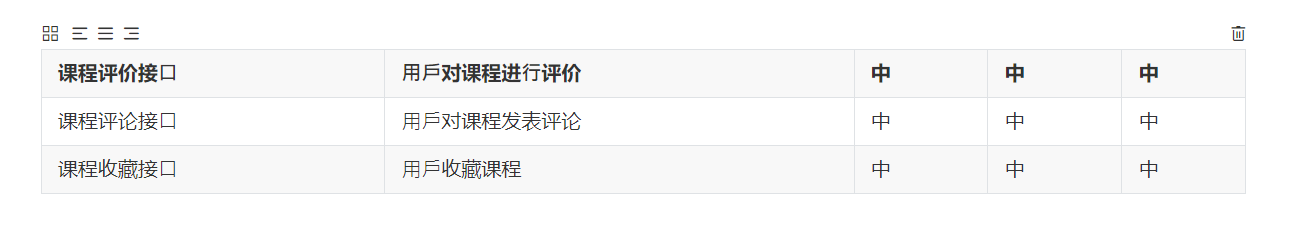
◦ 功能复杂度:
▪ 新增课程接⼝:涉及多个参数(课程名称、课程描述、课程价格等),需要与其他模块(如课程分类模块)交互。
▪ 查询课程接⼝:⽀持多种查询条件(课程名称、课程类型、课程状态等),逻辑复杂。
▪ 课程购买接⼝:涉及⽀付流程、订单⽣成等复杂逻辑。
◦ ⾼⻛险功能:
▪ 登录接⼝:⽤⼾登录是系统的核⼼功能,任何问题都会影响⽤⼾体验。
▪ 新增课程接⼝:课程信息的正确性直接影响平台的运营。
▪ ⽤⼾注册接⼝:⽤⼾注册是系统的基础功能,任何问题都会影响⽤⼾获取服务。
◦ 重复性⾼:
▪ 登录接⼝:⽤⼾每次使⽤系统都需要登录。
▪ 查询课程接⼝:⽤⼾频繁查询课程信息。
▪ ⽤⼾信息查询接⼝:⽤⼾经常查看⾃⼰的信息。
3. 设计⾃动化测试⽤例
◦ 如果在功能测试阶段已经设计了测试⽤例,可以直接拿来使⽤。
◦ 根据接⼝需求和功能,设计正向测试⽤例(正常场景)和反向测试⽤例(异常场景),包括边界值测试、参数组合测试等。
4. 搭建⾃动化测试环境
◦ 选择合适的编程语⾔(如Python、Java等)和开发环境(如PyCharm、IntelliJ IDEA等)来实现⾃动化测试。
◦ 以Python为例,安装必要的依赖库,如requests⽤于发送HTTP请求,pytest⽤于测试框架。
5. 设计⾃动化执⾏框架
◦ 设计⼀个框架来执⾏测试⽤例,包括报告⽣成、参数化处理和⽤例执⾏逻辑。
6. 编写代码
◦ 根据设计好的测试⽤例和框架,编写⾃动化测试脚本。
7. 执⾏⽤例
◦ 使⽤测试框架(如unittest、pytest)来执⾏编写的测试⽤例。 8. ⽣成测试报告
◦ 测试完成后,⽣成测试报告。可以使⽤⼯具如HtmlTestRunner或Allure来⽣成易于阅读的报告。
tips:接⼝⾃动化流程是⾯试考点
2.3 第⼀个简单的接⼝⾃动化
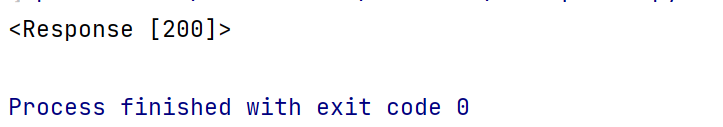
⽰例:对百度接⼝发起请求
代码块
import requests
r = requests.get("https://www.baidu.com")
print(r)
返回值:
2.4 requests模块
2.4.1 安装
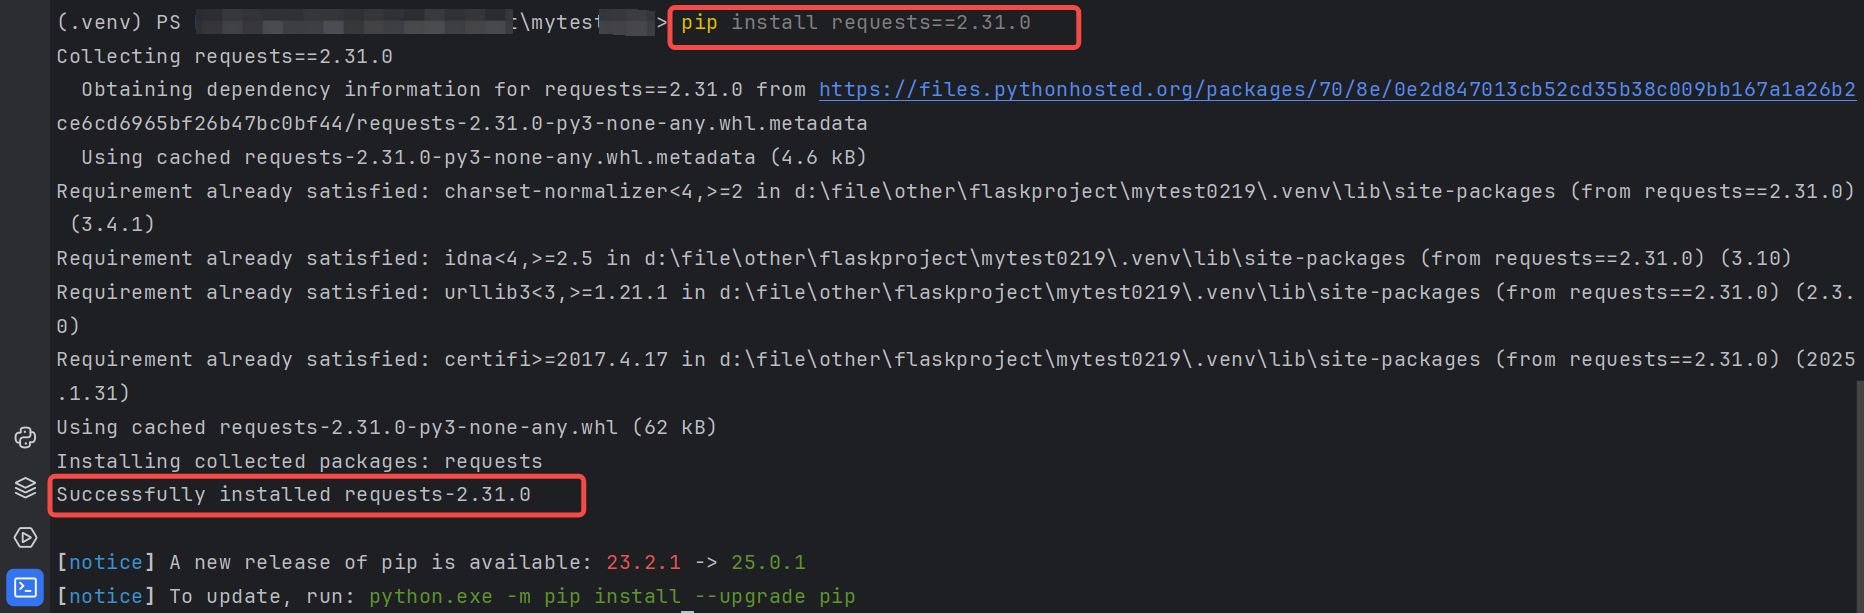
命令⾏通过pip⼯具进⾏安装,命令:
代码块
pip install requests==2.31.0
安装成功⽰例:
检查当前项⽬下包是否更新:
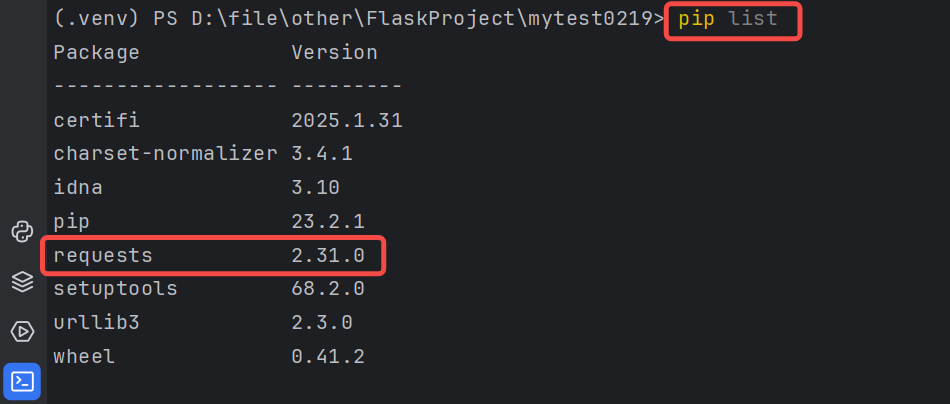
2.4.2 介绍
requests 库是⼀个⾮常流⾏的HTTP客⼾端库,⽤于发送HTTP请求。 requests.get ⽅法⽤于发送⼀个HTTP get 请求到指定的URL
requests.get ⽅法返回⼀个 Response 对象,这个对象包含了服务器返回的所有信息。如:
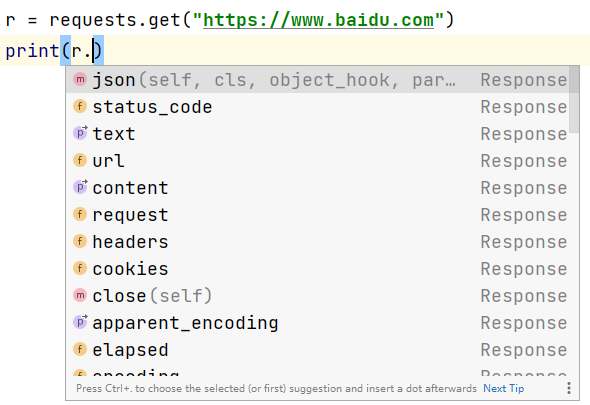
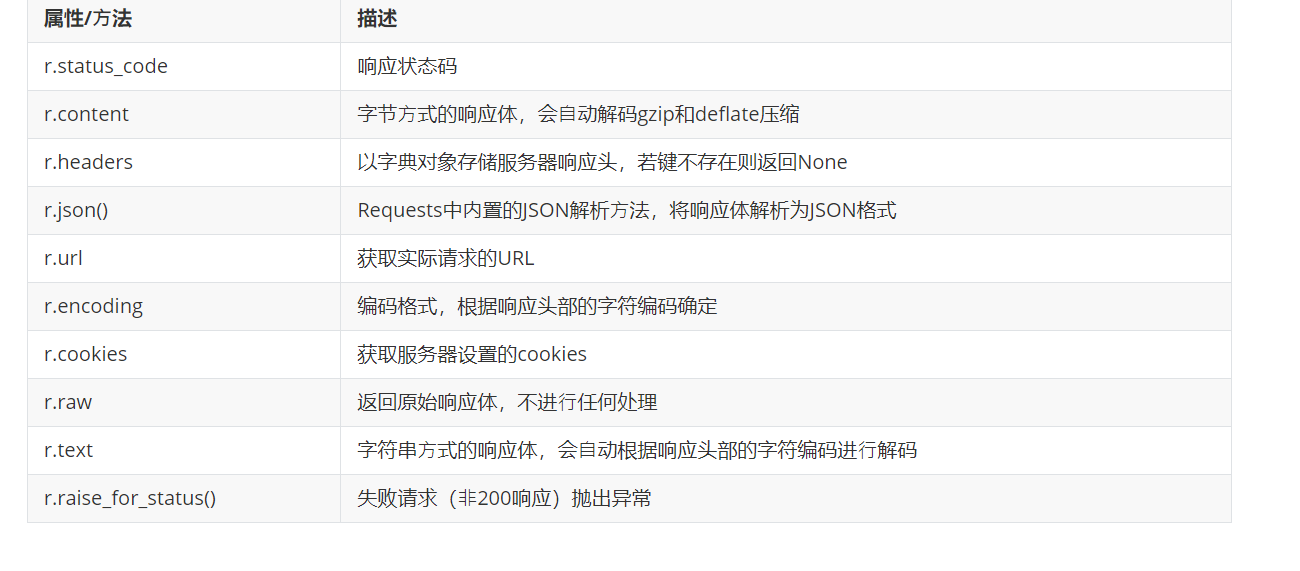
Response 对象提供的属性/⽅法介绍:
2.4.3 常⻅请求⽅法
代码块
1 #发起get请求def get(url, params=None, **kwargs)
#发起post请求
def post(url, data=None, json=None, **kwargs)
#⽀持不同请求⽅式,method:指定请求⽅法,
#⽀持``get``, ``OPTIONS``, ``HEAD``, ``post``, ``PUT``, ``PATCH``, or ``DELETE``
def request(method, url, **kwargs)
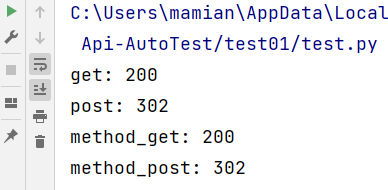
使⽤⽰例:
代码块
import requests
get_r = requests.get("https://www.baidu.com")
post_r = requests.post("https://www.baidu.com")
req_r1 = requests.request(method="get", url="https://www.baidu.com")
req_r2 = requests.request(method="post", url="https://www.baidu.com")
print("get:", get_r.status_code)
print("post:", post_r.status_code)
print("method_get:", req_r1.status_code)
print("method_post:", req_r2.status_code)
结果:
2.4.4 添加请求信息
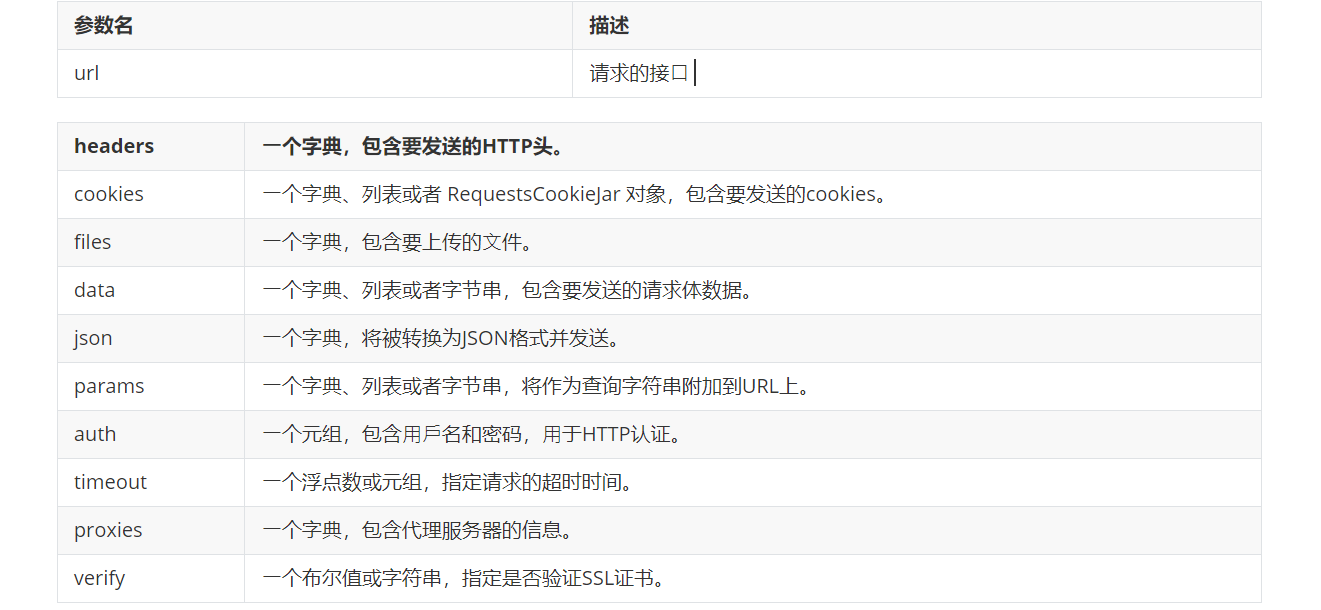
get() 、 post() 底层都是调⽤ request() ⽅法,因此这三个⽅法在发送请求时,传参⽆太⼤区别,可传递的参数展⽰如下:
⽰例1:博客详情接⼝
代码块
url = "http://8.137.19.140:9090/blog/getBlogDetail"
# 定义查询参数
params = {
"blogId":9773
}
#定义请求头信息
header = {
"user_token_header":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MSwidXNlck5hbWUiOiJ6aGFuZ3Nhb
iIsImV4cCI6MTczNTU1ODk2Mn0.72oh-gQ-5E6_aIcLsjotWL4ZHmgy0jF1794JDE-uUkg",
"x-requested-with":"XMLHttpRequest"
}
r= requests.post(url=url, params=params, headers=header)
print(r.json())
⽰例2:博客登录接⼝
代码块
url = "http://8.137.19.140:9090/user/login"
# 定义要发送的数据
data = {
"username":"zhangsan",
"password": "123456"
}
r= requests.post(url=url, data=data)
print(r.json())
⽰例3:添加 cookie 信息
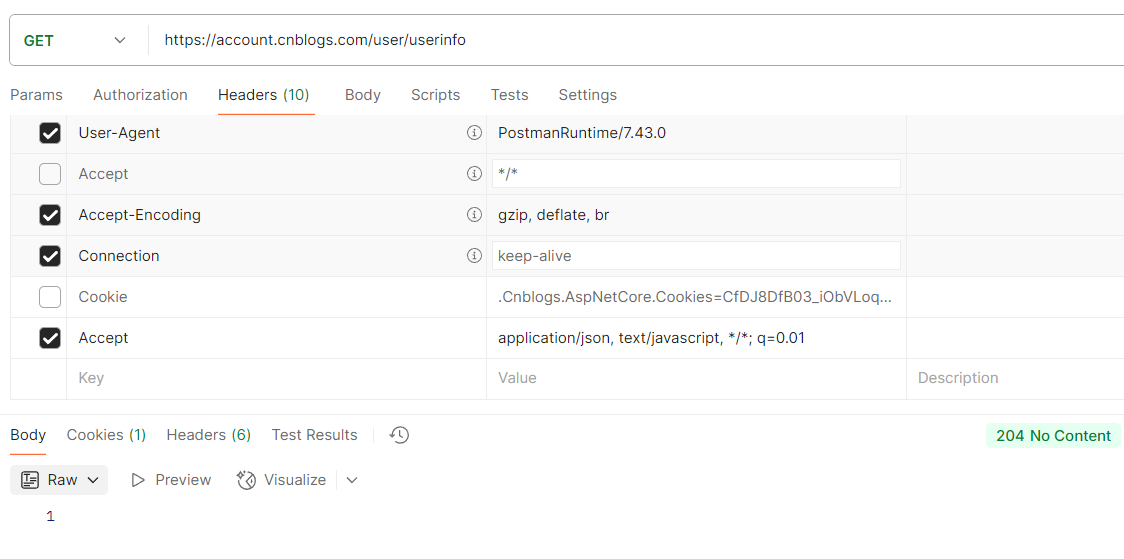
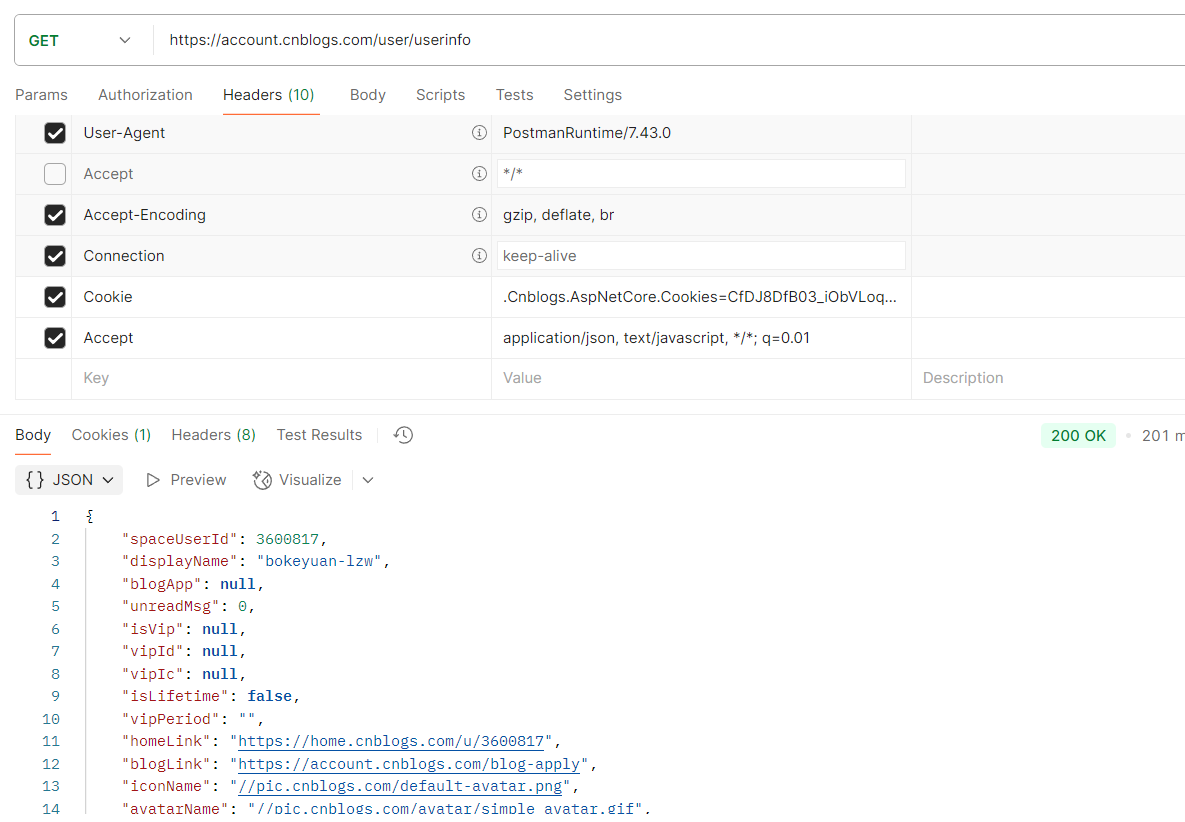
以博客园接⼝为例:https://account.cnblogs.com/user/userinfo
未登录状态下接⼝返回值:
登录状态下接⼝返回值:
代码:
代码块
def test_01():
url = "https://account.cnblogs.com/user/userinfo"
# 定义请求头信息
header = {
"Accept":"application/json, text/javascript, */*; q=0.01"
}
 #定义cookie信息
cookie = {
".Cnblogs.AspNetCore.Cookies":"CfDJ8DfB03_iObVLoqH7ndAeeDgVJetjhlYbwnntg9Uy7_bc
LryJ_RIEtfbgLsOt7uinPvbNdpBCrZ_PSO5PvJVIw1lWKGW_BmqUG4pK2jDjEGKO8vaJdJ74bQWmCZW5U5wMaUO6QMrJFftQN8k31pgT
buD4X4lX-
9kWMqGkzXkGkNb8C8hU_MyCqe9ZqjSDDSoPp4lFXTZ_MgBMGJLMzyw61Otnrrp2BXpw9oGbK14Q5ibK
4_cAAL0cOPN1hYq1tDjbUs_CoDAyJanjddoezpNU6KQTchSOAmfFCbcuTLrDBlrHYHgnP75YE8pb4-
10AsJuaNrN74fBlYhJ_BQHKmvs_GJmj1L1seks5C32Lx7it67uq9be_7oDyj6ZLvTnZdryWXlucNb7EPE
27P1-djOPq8MY15hSNVjO86Gcn8kDBbfyCee8Yi3exGOr026dRtPLSVjPdSbKV0st6Xd8so1oVJlKH2amdiX1Pofe7h_Yf6S-eVG_pnL6_frtvpCNbpVgApxB5Wm1yyy0UXLy31UmVSuo5RJN6BQr4DXQ7umCz-yfpFjnZSUiuskBcwG83N3ww"
}
 r= requests.post(url=url, headers=header, cookies=cookie)
print(r.json())
问题:上传参数选择 params 、 json 还是 data ?
• params ⽤于在URL中传递查询参数(Query Parameters),通常⽤于 GET 请求,但也可以⽤
于其他类型的请求。
• json ⽤于在请求体(Body)中传递 JSON 格式的数据,通常⽤于 POST 或 PUT 请求。
• data ⽤于在请求体(Body)中传递表单数据,通常⽤于 POST 或 PUT 请求。
若参数上传格式选择为 json 格式, Content-Type 会⾃动被设置为application/json
有了 requests 库,可以实现对接⼝发起 http 请求,然⽽⾃动化测试中,我们需要编写⼤量的测
试⽤例,这些⽤例的组织、执⾏和管理也需要使⽤其他更强⼤的框架⸺ pytest 框架。
requests 库专注于HTTP请求的发送,⽽ pytest 框架则提供了测试的组织、执⾏和管理功能。
2.5 ⾃动化框架pytest
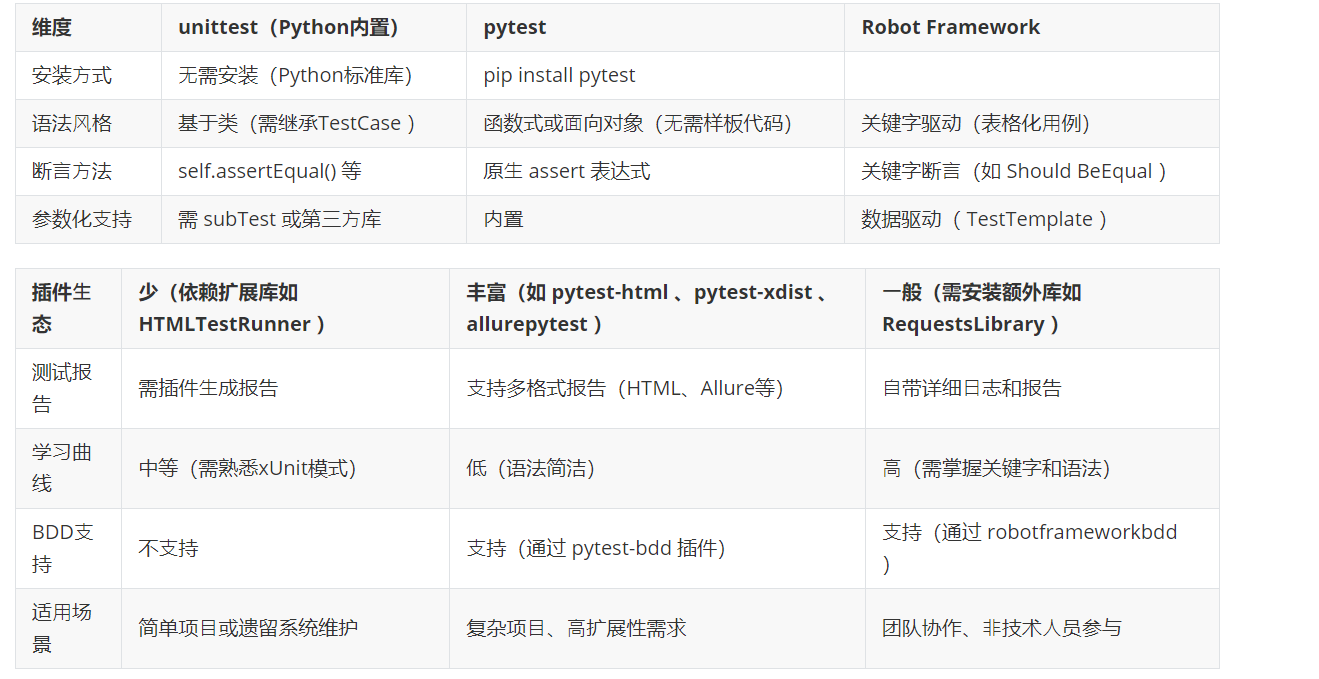
⽀持Python语⾔的接⼝⾃动化框架有很多,以下是⽀持Python的接⼝⾃动化主流框架对⽐分析:
主流框架对⽐表:
2.5.1 pytest介绍
pytest官⽅⽂档:https://docs.pytest.org/en/stable/getting-started.html
pytest 是⼀个⾮常流⾏且⾼效的Python测试框架,它提供了丰富的功能和灵活的⽤法,使得编写和运⾏测试⽤例变得简单⽽⾼效。
为什么选择pytest:
• 简单易⽤: pytest 的语法简洁清晰,对于编写测试⽤例⾮常友好,⼏乎可以在⼏分钟内上⼿。
• 强⼤的断⾔库: pytest 内置了丰富的断⾔库,可以轻松地进⾏测试结果的判断。
• ⽀持参数化测试: pytest ⽀持参数化测试,允许使⽤不同的参数多次运⾏同⼀个测试函数,这⼤⼤提⾼了测试效率。
• 丰富的插件⽣态系统: pytest 有着丰富的插件⽣态系统,可以通过插件扩展各种功能,⽐如覆盖率测试、测试报告⽣成(如 pytest-html 插件可以⽣成完美的HTML测试报告)、失败⽤例重复执⾏(如 pytest-rerunfailures 插件)等。此外, pytest 还⽀持与selenium、requests、appinum等结合,实现Web⾃动化、接⼝⾃动化、App⾃动化测试。
• 灵活的测试控制: pytest 允许跳过指定⽤例,或对某些预期失败的case标记成失败,并⽀持重复执⾏失败的case。
2.5.2 安装
安装 pytest8.3.2 要求 python 版本在3.8及以上。
代码块
pip install pytest==8.3.2
若python版本低于3.8,可参考表格不同的pytest 版本⽀持的python版本:
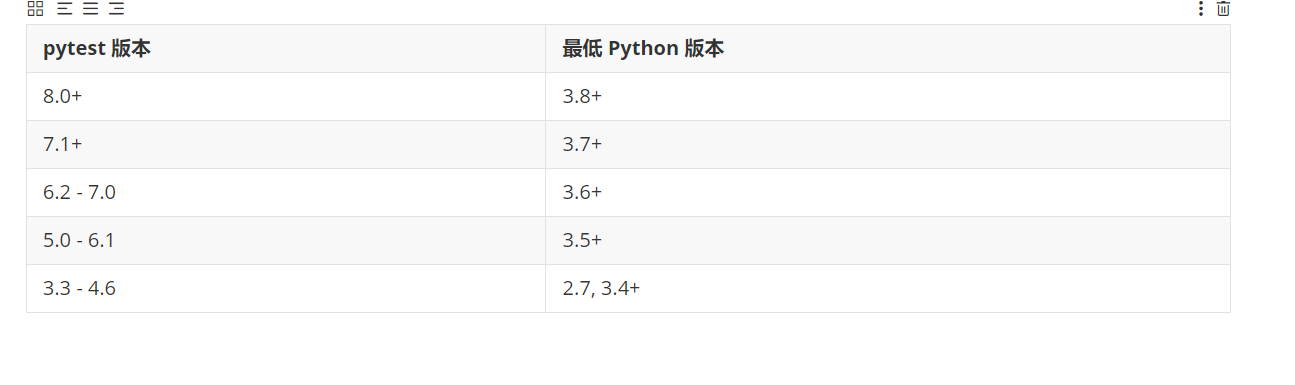
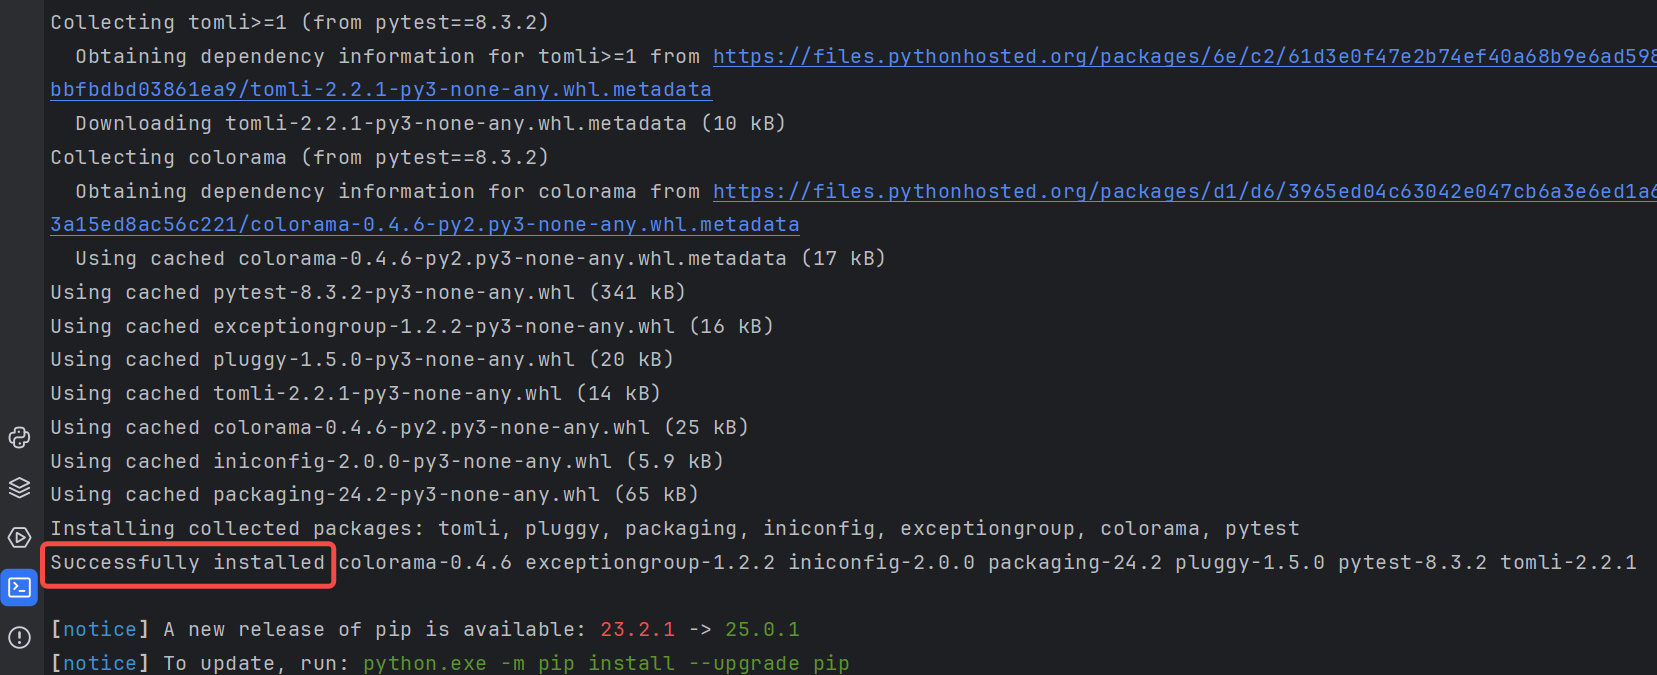
安装成功⽰例:

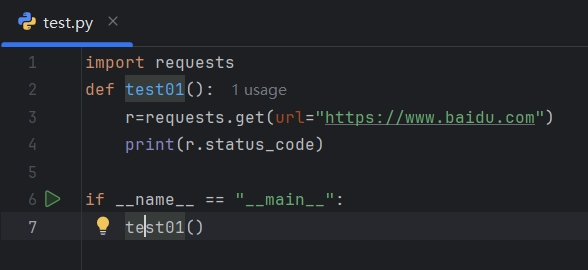
安装好 pytest 后,确认pycharm中python解释器已经更新,来看⼀下有 pytest 框架和没有
pytest 框架编写代码的区别:
未安装pytest:
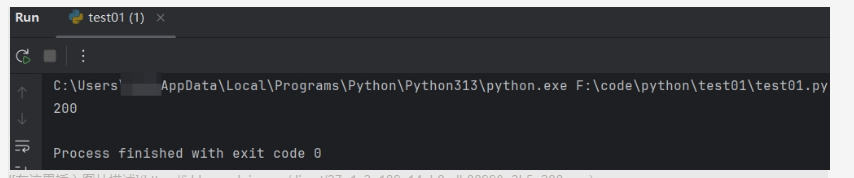
运⾏结果:
安装pytest:
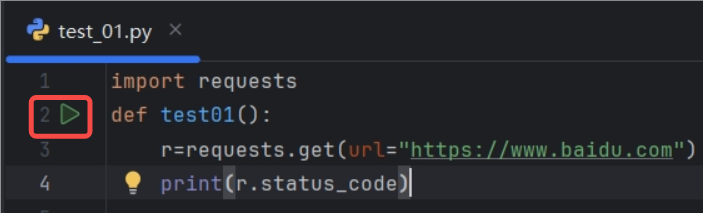
运⾏结果:
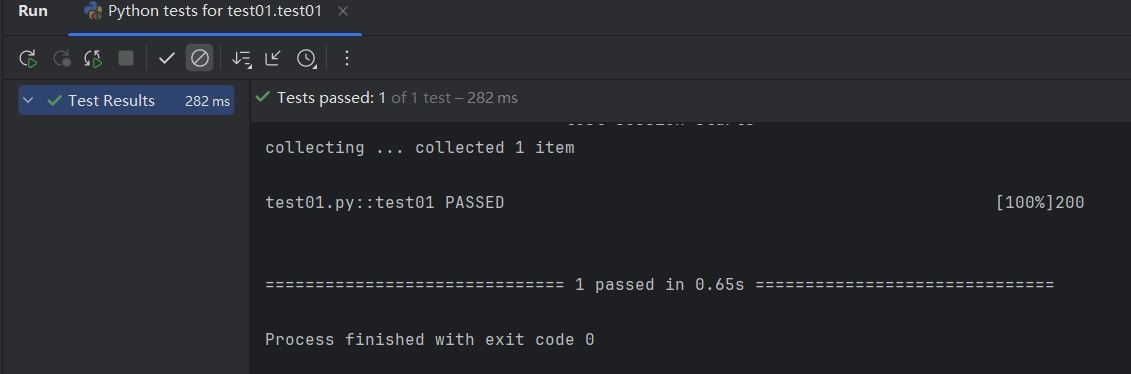
两张对⽐图可以明显看出来,未安装pytest框架的情况下需要编写 main 函数,在 main 函数中⼿动调⽤测试⽤例test01;安装了 pytest 框架后⽅法名前有直接运⾏标志。 然⽽并不是所有的⽅法都可以直接运⾏,需要遵循 pytest 中的⽤例命名规则。
2.5.3 ⽤例运⾏规则
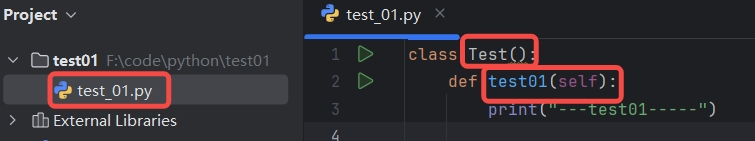
- ⽂件名必须以 test_ 开头或者 _test 结尾
- 测试类必须以 Test 开头,并且不能有 init ⽅法。
- 测试⽅法必须以 test 开头
当满⾜以上要求后,可通过命令⾏参数 pytest 直接运⾏符合条件的⽤例:
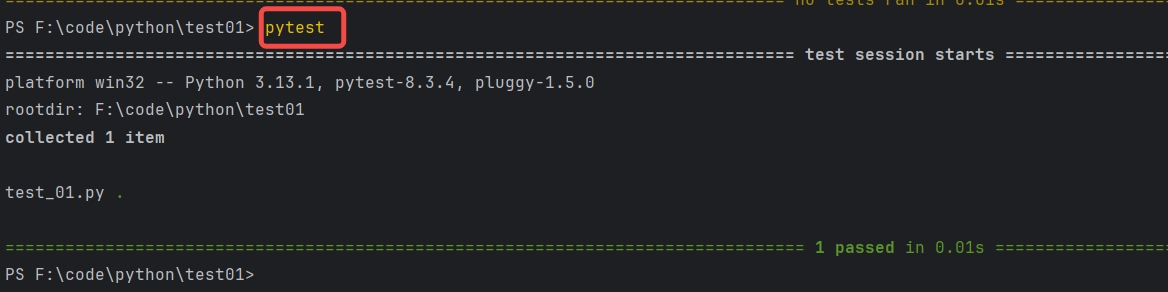
注意:Python类中不可以添加init⽅法
代码块
class Test():
def __init__(self):
print("-----init-------")
def test_a(self):
print("-----test_a----")
执⾏结果:
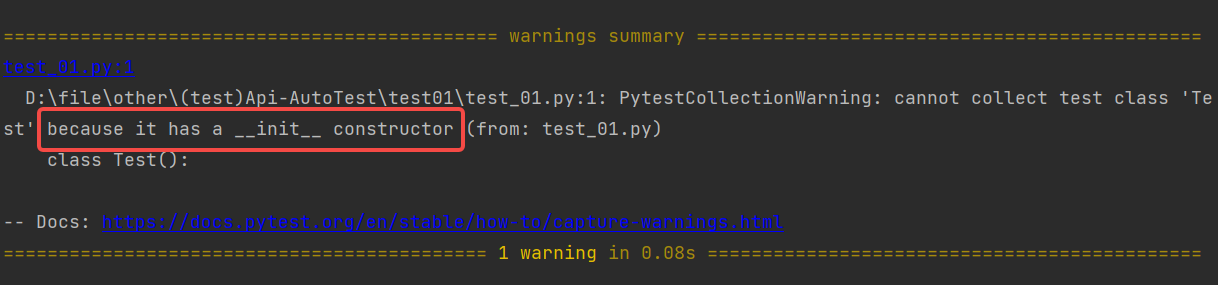
由于 pytest 的测试收集机制,测试类中不可以定义 init ⽅法。 pytest 采⽤⾃动发现机制来收集测试⽤例。它会⾃动实例化测试类并调⽤其所有以 test 结尾的⽅法作为测试⽤例。如果测试类中定义了 init ⽅法,那么当 pytest 实例化该类时, init ⽅法会被调⽤,这可能会掩盖测试类的实际测试逻辑,并引⼊额外的副作⽤,影响测试结果的准确性。
若测试类中存在初始化操作该采取什么⽅案?
为了避免使⽤ init ⽅法,建议在 pytest 中使⽤其他替代⽅案,如使⽤ setUp() 和tearDown() ⽅法、使⽤类属性、使⽤ fixture 函数
2.5.4 pytest命令参数
pytest 提供了丰富的命令⾏选项来控制测试的执⾏。以下是⼀些常⽤的 pytest 命令⾏参数及其使⽤说明。
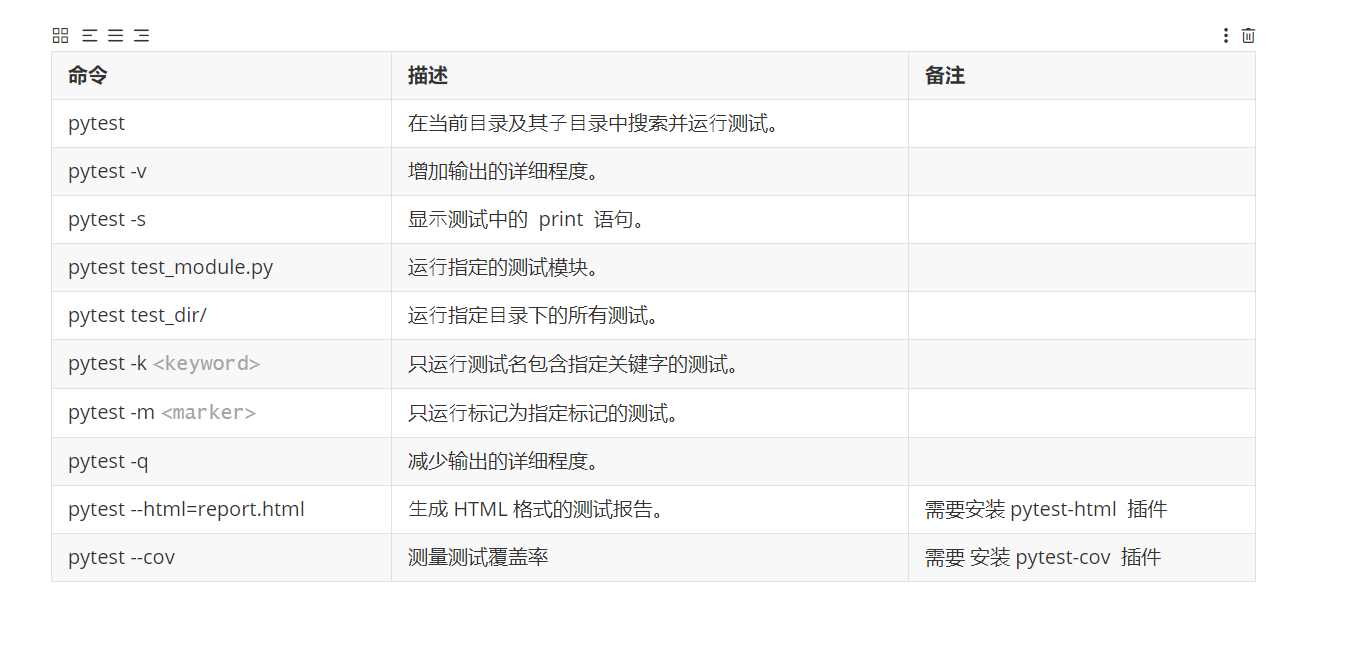
⽰例1:运⾏符合运⾏规则的⽤例
代码块
pytest
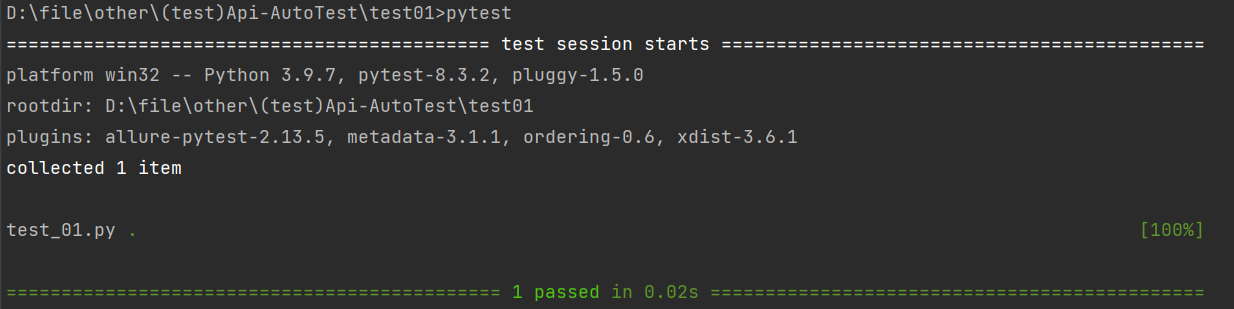
注意,这⾥不会输出测试⽤例中printf内容
⽰例2:详细打印,并输⼊print内容
代码块
pytest -s -v 或者 pytest -sv (可以连写)
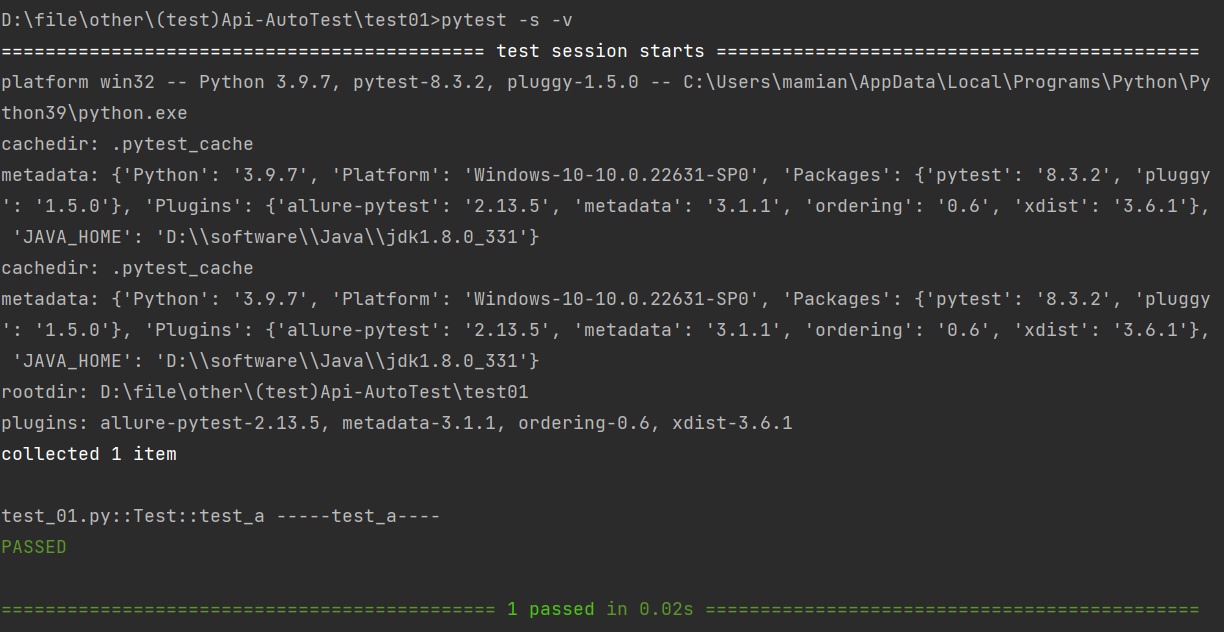
⽰例3:指定⽂件/测试⽤例
代码块
#指定⽂件:pytest 包名/⽂件名
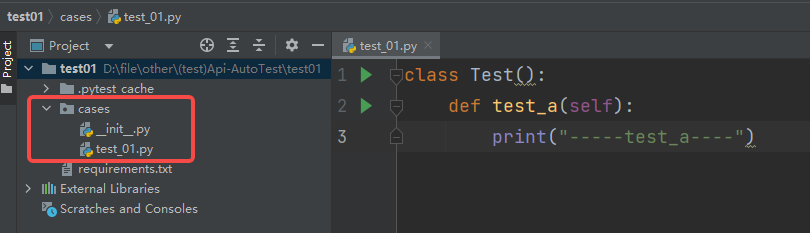
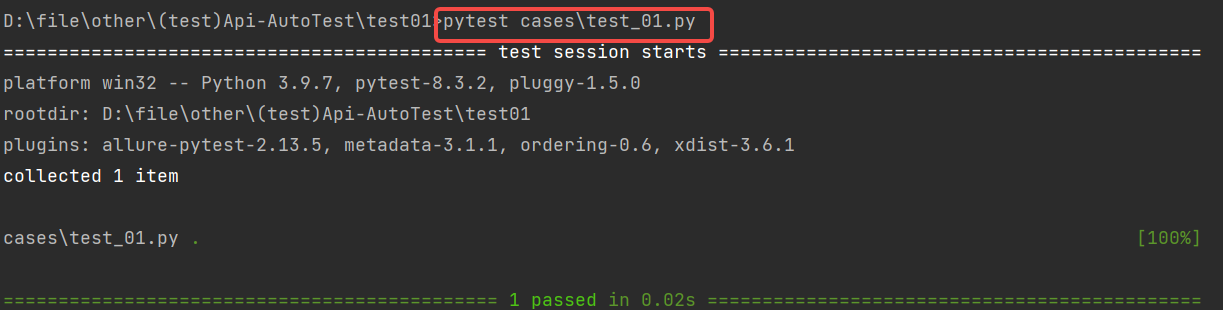
pytest cases/test_01.py
#指定测试⽤例: pytest 包名/⽂件名::类名::⽅法名
pytest cases/test_01.py::Test::test_a
问题:当我们既要详细输出,⼜要指定⽂件时,命令会⼜臭⼜⻓,⽽且每次运⾏都需要⼿动输⼊命令,如何解决?
将需要的相关配置参数统⼀放到 pytest 配置⽂件中。
2.5.5 pytest配置⽂件
在当前项⽬下创建 pytest.ini ⽂件,该⽂件为 pytest 的配置⽂件,以下为常⻅的配置选项:
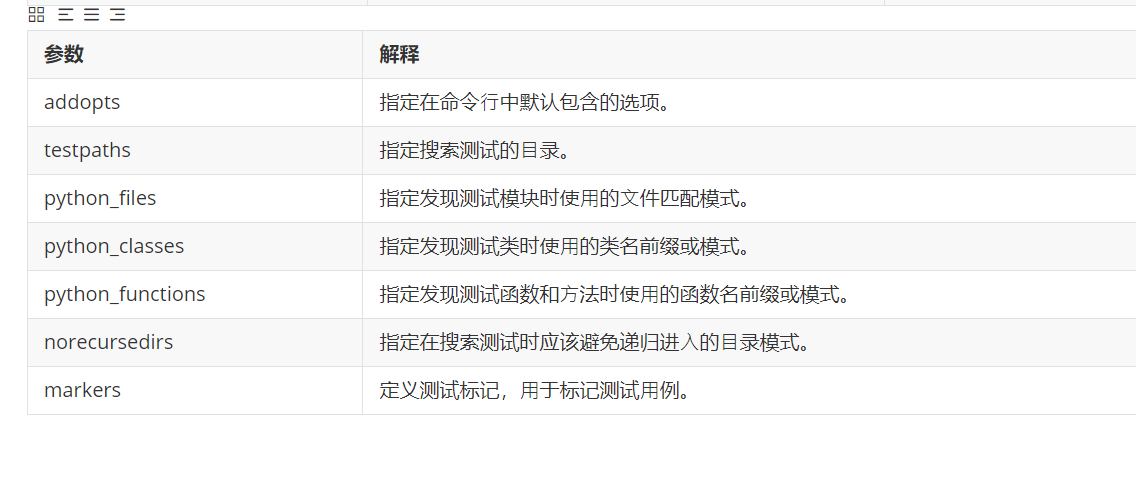
⽰例:详细输出 cases 包下⽂件名以 test_ 开头且⽅法名以 Test 开头的所有⽤例
代码块
[pytest]
addopts = -vs
testpaths = ./cases
python_files = test_*.py
python_classes = Test*
配置好 pytest.ini ⽂件后,命令⾏执⾏ pytest 命令即可,⽆需再额外指定其他参数:
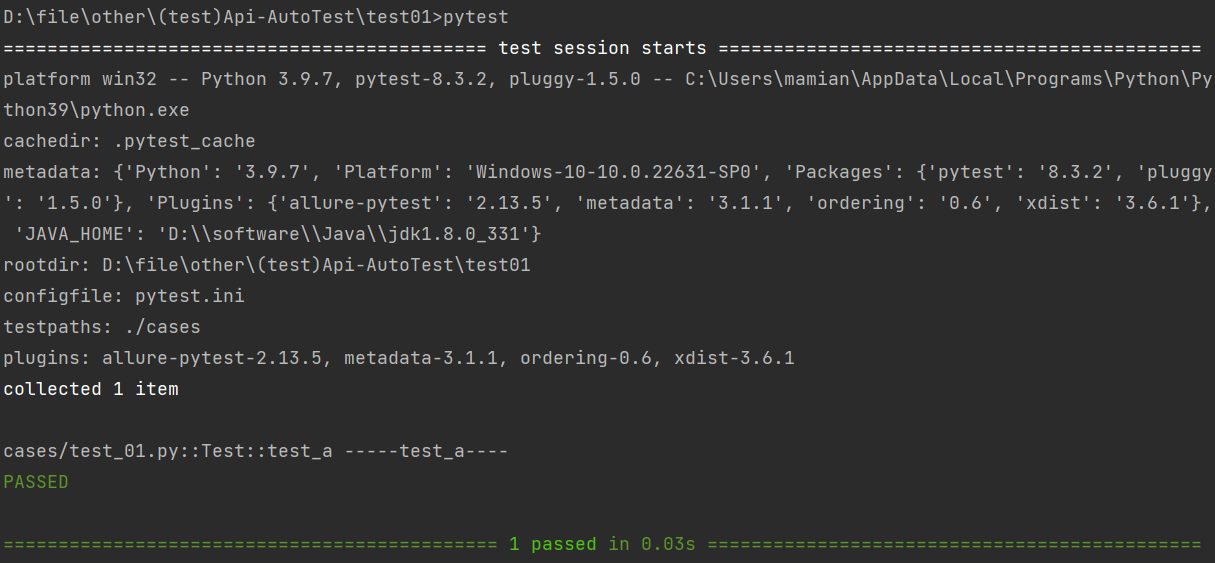
pytest.ini ⽂件通常位于项⽬的根⽬录下。通过在 pytest.ini 中定义配置项,可以覆盖 pytest 的默认⾏为,以满⾜项⽬的需求。
2.5.6 前后置
遗留问题:使⽤pytest框架,测试类中不可以添加init()⽅法,如何进⾏数据的初始化?
在测试框架中,前后置是指在执⾏测试⽤例前和测试⽤例后执⾏⼀些额外的操作,这些操作可以⽤于设置测试环境、准备测试数据等,以确保测试的可靠性
pytest 框架提供三种⽅法做前后置的操作:
• setup_method 和 teardown_method :这两个⽅法⽤于类中的每个测试⽅法的前置和后置操
作。
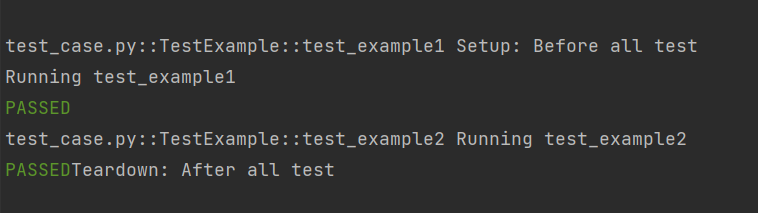
• setup_class 和 teardown_class :这两个⽅法⽤于整个测试类的前置和后置操作。
• fixture :这是 pytest 推荐的⽅式来实现测试⽤例的前置和后置操作。 fixture 提供了更灵活的控制和更强⼤的功能。
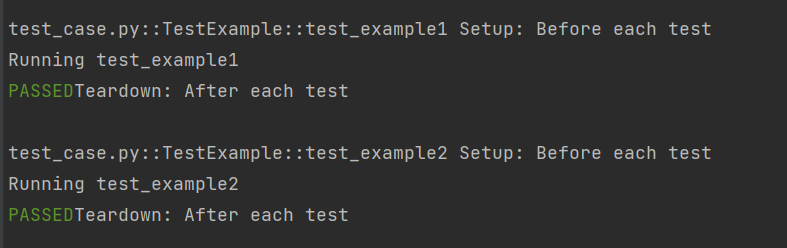
⽰例1: setup_method 和 teardown_method
代码块
import pytest
class TestExample:
def setup_method(self):
print("Setup: Before each test")
def teardown_method(self):
print("Teardown: After each test")
def test_example1(self):
10print("Running test_example1")
def test_example2(self):
print("Running test_example2")
结果:
⽰例2: setup_class 和 teardown_class
代码块
class TestExample:
def setup_class(self):
print("Setup: Before all test")
def teardown_class(self):
print("Teardown: After all test")
def test_example1(self):
print("Running test_example1")
def test_example2(self):
print("Running test_example2")
结果:
2.5.7 断⾔
断⾔( assert )是⼀种调试辅助⼯具,⽤于检查程序的状态是否符合预期。如果断⾔失败(即条件为假),Python解释器将抛出⼀个 AssertionError 异常。断⾔通常⽤于检测程序中的逻辑错误。
pytest 允许你在 Python 测试中使⽤标准的 Python assert 语句来验证预期和值。
基本语法:
代码块
assert 条件, 错误信息
• 条件 :必须是⼀个布尔表达式。
• 错误信息 :当条件为假时显⽰的错误信息,可选。
免费学习API资源:http://jsonplaceholder.typicode.com/
⽰例1:基本数据类型的断⾔
代码块
#断⾔整数
a = 1
b = 2
assert a == b
#断⾔字符串
str = "hello"
assert "hello" == str
⽰例2:数据结构断⾔
代码块
def test():
# 断⾔列表
expect_list = [1, 'apple', 3.14]
actual_list = [1, 'apple', 3.14]
# 断⾔元组
expect_tuple = (1, 'apple', 3.14)
actual_tuple = (1, 'apple', 3.14)
# 断⾔字典
expect_dict = {'name': 'Alice', 'age': 25}
actual_dict = {'name': 'Alice', 'age': 25}
# 断⾔集合
expect_set = {1, 2, 3, 'apple'}
actual_set = {1, 2, 3, 'apple'}
assert expect_list == actual_list
assert expect_tuple == actual_tuple
assert expect_dict == actual_dict
assert expect_set == actual_set
⽰例3:函数断⾔
代码块
def divide(a, b):
assert b != 0, "除数不能为0"
return a / b
# 正常情况
print(divide(10, 2)) # 输出 5.0
# 触发断⾔
print(divide(10, 0)) # 抛出 AssertionError: 除数不能为0
⽰例4:接⼝返回值断⾔
代码块
#断⾔接⼝返回值完整字段和值
def test1():
url = "http://jsonplaceholder.typicode.com/posts/1"
r = requests.get(url=url)
expect_data = {
"userId": 1,
"id": 1,
"title": "sunt aut facere repellat provident occaecati excepturi optio
reprehenderit",
"body": "quia et suscipit\nsuscipit recusandae consequuntur expedita et
cum\nreprehenderit molestiae ut ut quas totam\nnostrum rerum est autem sunt
rem eveniet architecto"
} p
rint(r.json())
assert r.json() == expect_data
assert r.json()['userId'] == 1
#断⾔接⼝返回值重要字段
def test2():
url = "http://jsonplaceholder.typicode.com/comments?postId=1"
r = requests.get(url=url)
print(r.json())
assert r.json()[1]['id'] == 1
#断⾔接⼝html返回值
def test3():
url = "http://jsonplaceholder.typicode.com/"
r = requests.get(url=url)
assert "Use your own data" in r.text
2.5.8 参数化
参数化设计是⾃动化设计中的⼀个重要组成部分,它通过定义设计参数和规则,使得设计过程更加灵
活和可控。
pytest中内置的 pytest.mark.parametrize 装饰器允许对测试函数的参数进⾏参数化。
⽰例1:在⽤例上使⽤参数化
代码块
import pytest
@pytest.mark.parametrize("test_input,expected", [("3+5", 8), ("2+4", 6),
("6*9", 42)])
def test_eval(test_input, expected):
assert eval(test_input) == expected
这⾥, @parametrize 装饰器定义了三个不同的 (test_input,expected) 元组,以便
test_eval 函数将依次使⽤它们运⾏三次。
也可以在类或模块上使⽤ parametrize 标记,这将使⽤参数集调⽤多个函数
⽰例2:在类上使⽤参数化
代码块
import pytest
@pytest.mark.parametrize("n,expected", [(1, 2), (3, 4)])
class TestClass:
def test_simple_case(self, n, expected):
assert n + 1 == expected
def test_weird_simple_case(self, n, expected):
assert (n * 1) + 1 == expected
要对模块中的所有测试进⾏参数化,你可以将 pytestmark 全局变量赋值:
代码块
import pytest
pytestmark = pytest.mark.parametrize("n,expected", [(1, 2), (3, 4)])
class TestClass:
def test_simple_case(self, n, expected):
assert n + 1 == expected
def test_weird_simple_case(self, n, expected):
assert (n * 1) + 1 == expected
除了使⽤ @parametrize 添加参数化外, pytest.fixture() 允许对 fixture 函数进⾏参数
化。
⽰例3:⾃定义参数化数据源
代码块
def data_provider():
return ["a", "b"]
# 定义⼀个测试函数,它依赖于上⾯函数的返回值
@pytest.mark.parametrize("data", data_provider())
def test_data(data):
assert data != None
print(f"Testing with data provider: {data}")
2.5.9 fixture
pytest 中的 fixture 是⼀种强⼤的机制,⽤于提供测试函数所需的资源或上下⽂。它可以⽤于设置测试环境、准备数据等。以下是 fixture 的⼀些核⼼概念和使⽤场景.
2.5.9.1 基本使⽤
⽰例1:使⽤与不使⽤fixture标记
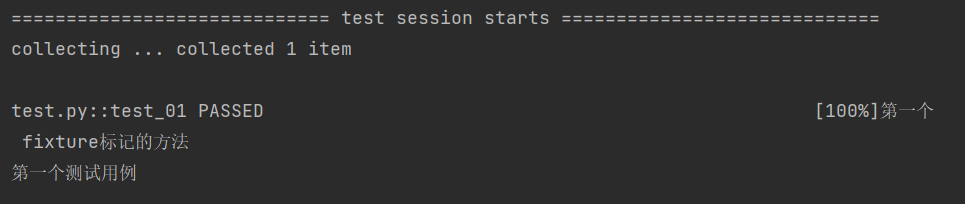
未标记fixture⽅法的调⽤ fixture标记的⽅法调⽤
代码块
def fixture_01():
print("第⼀个fixture标记的⽅法")
def test_01():
fixture_01()
print("第⼀个测试⽤例")
结果:
代码块
import pytest
@pytest.fixture
def fixture_01():
print("第⼀个fixture标记的⽅法")
def test_01(fixture_01):
print("第⼀个测试⽤例")
结果:
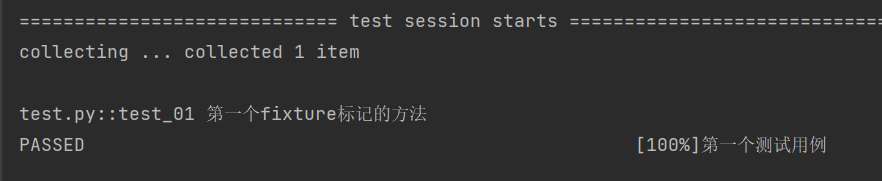
未标记 fixture ⽅法的调⽤与 fixture 标记的⽅法调⽤完全不⼀样,前者需要在⽅法体中调⽤,⽽后者可以将函数名作为参数进⾏调⽤。
测试脚本中存在的很多重复的代码、公共的数据对象时,使⽤ fixture 最为合适
⽰例2:访问列表⻚和详情⻚之前都需要执⾏登录操作
代码块
import pytest
@pytest.fixture
def login():
print("---执⾏登陆操作-----")
def test_list(login):
print("---访问列表⻚")
def test_detail(login):
print("---访问详情⻚")
运⾏结果:
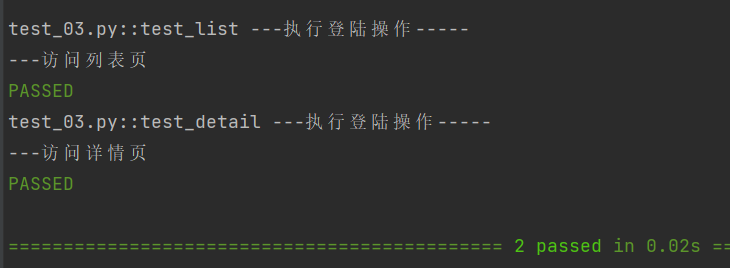
通过使⽤ @pytest.fixture 装饰器来告诉 pytest ⼀个特定函数是⼀个 fixture,通过运⾏结果可⻅,在执⾏列表⻚和详情⻚之前都会先执⾏ login ⽅法。
2.5.9.2 fixture嵌套
代码块
# test_append.py的内容
import pytest
# 安排
@pytest.fixture
def first_entry():
return "a"
# 安排
@pytest.fixture
def order(first_entry):
return [first_entry]
def test_string(order):
# ⾏动
order.append("b")
# 断⾔
assert order == ["a", "b"]
测试不必局限于单个 fixture ,它们可以依赖于您想要的任意数量的 fixture ,并且 fixture 也可以使⽤其他 fixture 。 pytest 最伟⼤的优势之⼀是其极其灵活的 fixture 系统,它允许我们将测试的复杂需求简化为更简单和有组织的函数,我们只需要每个函数描述它们所依
赖的事物
2.5.9.3 请求多个fixture
代码块
im port pytest
class Fruit:
def __init__(self, name):
self.name = name
def __eq__(self, other):
return self.name == other.name
@pytest.fixture
def my_fruit():
return Fruit("apple")
@pytest.fixture
def fruit_basket(my_fruit):
return [Fruit("banana"), my_fruit]
def test_my_fruit_in_basket(my_fruit, fruit_basket):
assert my_fruit in fruit_basket
测试和 fixture 不仅限于⼀次请求单个 fixture ,它们可以请求任意多个。
2.5.9.4 yield fixture
当我们运⾏测试时,我们希望确保它们能够⾃我清理,以便它们不会⼲扰其他测试(同时也避免留下⼤量测试数据来膨胀系统)。pytest中的 fixture 提供了⼀个⾮常有⽤拆卸系统,它允许我们为每个 fixture 定义具体的清理步骤。
“Yield” fixture 使⽤ yield ⽽不是 return 。有了这些 fixture ,我们可以运⾏⼀些代码,并将对象返回给请求的 fixture/test ,就像其他 fixture ⼀样。唯⼀的不同是:
• return 被替换为 yield 。
• 该 fixture 的任何拆卸代码放置在 yield 之后。
⼀旦 pytest 确定了 fixture 的线性顺序,它将运⾏每个 fixture 直到它返回或 yield ,然后继续执⾏列表中的下⼀个 fixture 做同样的事情。
测试完成后, pytest 将逆向遍历 fixture 列表,对于每个 yield 的 fixture ,运⾏ yield语句之后的代码。
⽰例1:
代码块
import pytest
@pytest.fixture
def open_close():
print("前置操作,初始化.....")
yield
print("后置操作,清理数据.....")
def test_01(open_close):
print("第⼀个测试⽤例")
⽰例2:创建⽂件句柄与关闭⽂件
代码块
import pytest
@pytest.fixture
def file_read():
print("打开⽂件句柄")
fo = open("test.txt", "r")
yield fo
print("关闭打开的⽂件")
fo.close()
def file_write():
print("打开⽂件句柄")
fo = open("test.txt","w",encoding="utf-8")
return fo
# yield fo
# #
print("关闭⽂件句柄")
# fo.close()
def test_file(file_write, file_read):
# 写⼊数据
w = file_write
w.write("测试数据")
w.close() # 写⼊后关闭⽂件句柄,以便读取
# 读取数据
r = file_read
str = r.read(10)
print("⽂件内容:", str)
运⾏结果:
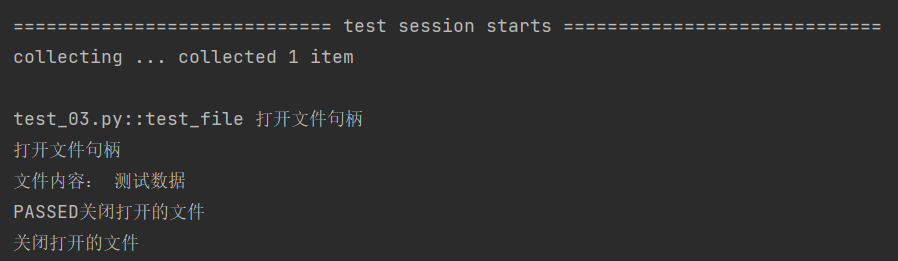
2.5.9.5 带参数的fixture
代码块
pytest.fixture(scope='', params='', autouse='', ids='', name='')
参数详解:
• scope 参数⽤于控制fixture的作⽤范围,决定了fixture的⽣命周期。可选值有:
◦ function (默认):每个测试函数都会调⽤⼀次fixture。
◦ class :在同⼀个测试类中共享这个fixture。
◦ module :在同⼀个测试模块中共享这个fixture。(⼀个⽂件⾥)
◦ session :整个测试会话中共享这个fixture。
• autouse 参数默认为 False 。如果设置为 True ,则每个测试函数都会⾃动调⽤该fixture,⽆需显式传⼊
• params 参数⽤于参数化fixture,⽀持列表传⼊。每个参数值都会使fixture执⾏⼀次,类似于
for循环
• ids 参数与 params 配合使⽤,为每个参数化实例指定可读的标识符(给参数取名字)
• name 参数⽤于为fixture显式设置⼀个名称。如果使⽤了 name ,则在测试函数中需要使⽤这个
名称来引⽤ fixture (给fixture取名字)
⽰例1: scope 的使⽤
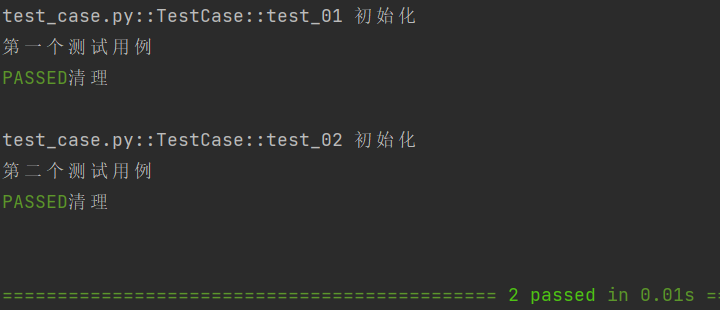
scope=“function”
代码块
import pytest
@pytest.fixture(scope="function")
def fixture_01():
print("初始化")
yield
print("清理")
class TestCase():
def test_01(self,
fixture_01):
print("第⼀个测试⽤例")
def test_02(self,
fixture_01):
print("第⼆个测试⽤例")
结果:
scope=“class”
代码块
import pytest
@pytest.fixture(scope="class")
def fixture_01():
print("初始化")
yield
print("清理")
class TestCase():
def test_01(self,
fixture_01):
print("第⼀个测试⽤例")
def test_02(self,
fixture_01):
print("第⼆个测试⽤例")
结果:
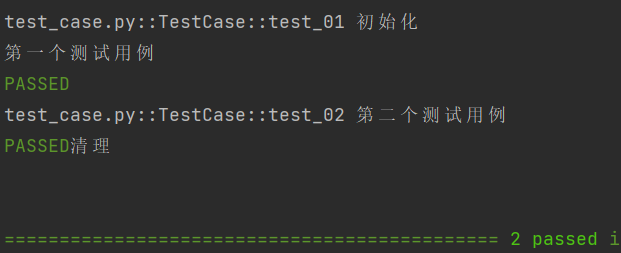
结论:
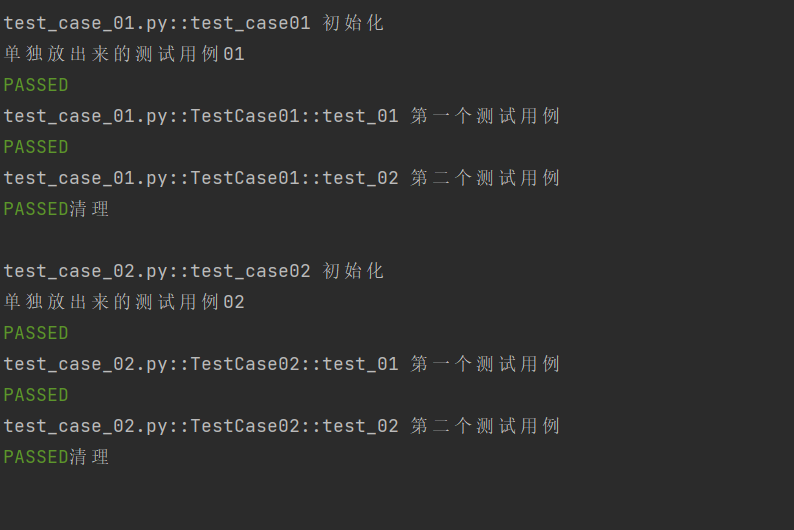
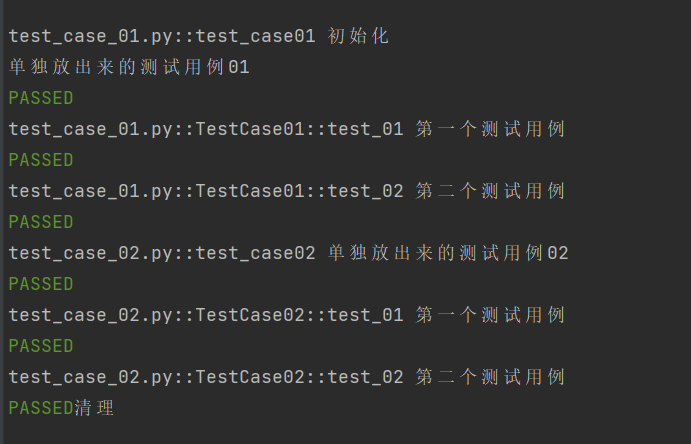
• scope 默认为 function ,这⾥的 function 可以省略不写,当 scope=“function” 时,每个测试函数都会调⽤⼀次 fixture 。 scope=“class” 时,在同⼀个测试类中, fixture只会在类中的第⼀个测试函数开始前执⾏⼀次,并在类中的最后⼀个测试函数结束后执⾏清理。
• 当 scope=“moudle” 、 scope=“session” 时可⽤于实现全局的前后置应⽤,这⾥需要多个⽂件的配合conftest.py 和 @pytest.fixture 结合使⽤实现全局的前后置应⽤@pytest.fixture 与 conftest.py ⽂件结合使⽤,可以实现在多个测试模块( .py )⽂件中共享前后置操作,这种结合的⽅式使得可以在整个测试项⽬中定义和维护通⽤的前后置逻辑,使测试代码更加模块化和可维护。规则:
• conftest.py 是⼀个单独存放的夹具配置⽂件,名称是固定的不能修改
• 你可以在项⽬中的不同⽬录下创建多个 conftest.py ⽂件,每个 conftest.py ⽂件都会对其所在⽬录及其⼦⽬录下的测试模块⽣效
• 在不同模块的测试中需要⽤到 conftest.py 的前后置功能时,不需要做任何的import导⼊操作
• 作⽤:可以在不同的 .py ⽂件中使⽤同⼀个 fixture 函数
⽰例2: scope=“moudle” 、 scope=“session” 实现全局的前后置应⽤
项⽬结构: conftest.py
代码块
import pytest
@pytest.fixture(scope="module",
autouse=True)
def fixture_01():
print("初始化")
yield
print("清理")
test_case_01.py
代码块
def test_case01():
print("单独放出来的测试⽤例01")
class TestCase01():
def test_01(self):
print("第⼀个测试⽤例")
def test_02(self):
print("第⼆个测试⽤例")
test_case_02.py
代码块
def test_case02():
print("单独放出来的测试⽤例02")
class TestCase02():
def test_01(self):
print("第⼀个测试⽤例")
def test_02(self):
print("第⼆个测试⽤例")
运⾏结果:
当 scope=“session” 时:
test_case_01.py
代码块
def test_case01():
print("单独放出来的测试⽤例01")
class TestCase01():
def test_01(self):
print("第⼀个测试⽤例")
def test_02(self):
print("第⼆个测试⽤例")
test_case_02.py
代码块
def test_case02():
print("单独放出来的测试⽤例02")
class TestCase02():
def test_01(self):
print("第⼀个测试⽤例")
def test_02(self):
print("第⼆个测试⽤例")
运⾏结果:
⽰例3: autouse 的使⽤
代码块
import pytest
@pytest.fixture(scope="class", autouse=True)
def fixture_01():
print("初始化")
yield
print("清理")
class TestCase():
def test_01(self):
print("第⼀个测试⽤例")
def test_02(self):
print("第⼆个测试⽤例")
运⾏结果:
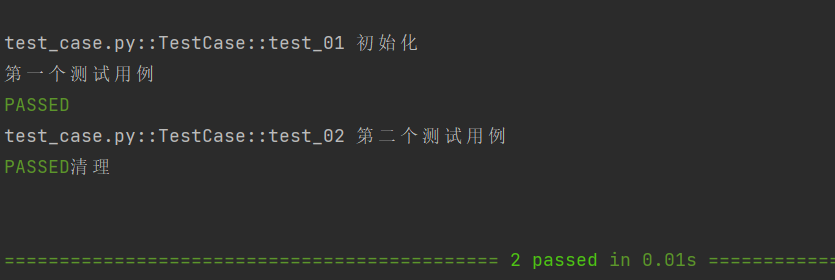
autouse 默认为 False ,即当前的 fixture 需要⼿动显⽰调⽤,在该案例之前我们默认使⽤的都是 autouse=False
当 autouse=True 时, fixture 会在所有测试函数执⾏之前⾃动调⽤,⽆论这些测试函数是否显式地引⽤了该 fixture
⽰例4:通过 params 实现参数化
代码块
# 定义⼀个参数化的 fixture
@pytest.fixture(params=["a", "b"])
def data_provider(request):
return request.param
# 定义⼀个测试函数,它依赖于上⾯的参数化 fixture
def test_data(data_provider):
assert data_provider != None
print(f"Testing with data provider: {data_provider}")
我们已经学过pytest中通过 @pytest.mark.parametrize 实现参数化,通过 fixture 也可以实现参数化,那么到底哪⼀种更好呢?
如果测试场景主要涉及简单的参数传递,且不需要复杂的资源管理,建议使⽤ parametrize,因为它更简单直接;如果测试需要动态加载外部数据,或者需要管理复杂的测试资源(如数据库连接、⽂件操作等),建议使⽤ fixture,在某些情况下,也可以结合使⽤ parametrize 和 fixture,以充分利⽤两者的优点。
总结来说,parametrize 更适合简单场景,⽽ fixture 更适合需要动态数据和资源管理的复杂场景。
2.6 YAML
官⽅⽂档:YAML
YAML是⼀种数据序列化语⾔,⽤于以⼈类可读的形式存储信息。它最初代表“Yet Another Markup Language”,但后来更改为“ YAML Ain’t Markup Language”(YAML不是⼀种标记语⾔),以区别于真正的标记语⾔。
它类似于XML和JSON⽂件,但使⽤更简洁的语法。
特点:
YAML 是⼀种⾮常简单的基于⽂本的⼈类可读的语⾔,⽤于在⼈和计算机之间交换数据。
YAML 是不是⼀种编程语⾔。它主要⽤于存储配置信息。
YAML 的缩进就像 Python 的缩进⼀样优雅。
YAML 还减少了 JSON 和 XML ⽂件中的⼤部分“噪⾳”格式,例如引号、⽅括号和⼤括号。
注意:
• YAML 是区分⼤⼩写。
• YAML 不允许使⽤制表符 Tab 键,(你之所按下 Tab YAML 仍能使⽤,是因为编辑器被配置为按下
Tab 键会导致插⼊适当数量的空格)。
• YAML 是遵循严格缩进的。
2.6.1 YAML介绍
YAML ⽂件的后缀名是 .yaml 或 .yml ,本着能少写不多写的原则,我们常⽤的是 .yml 。
yaml 中⽀持不同数据类型,但在写法上稍有区别,详⻅下表:
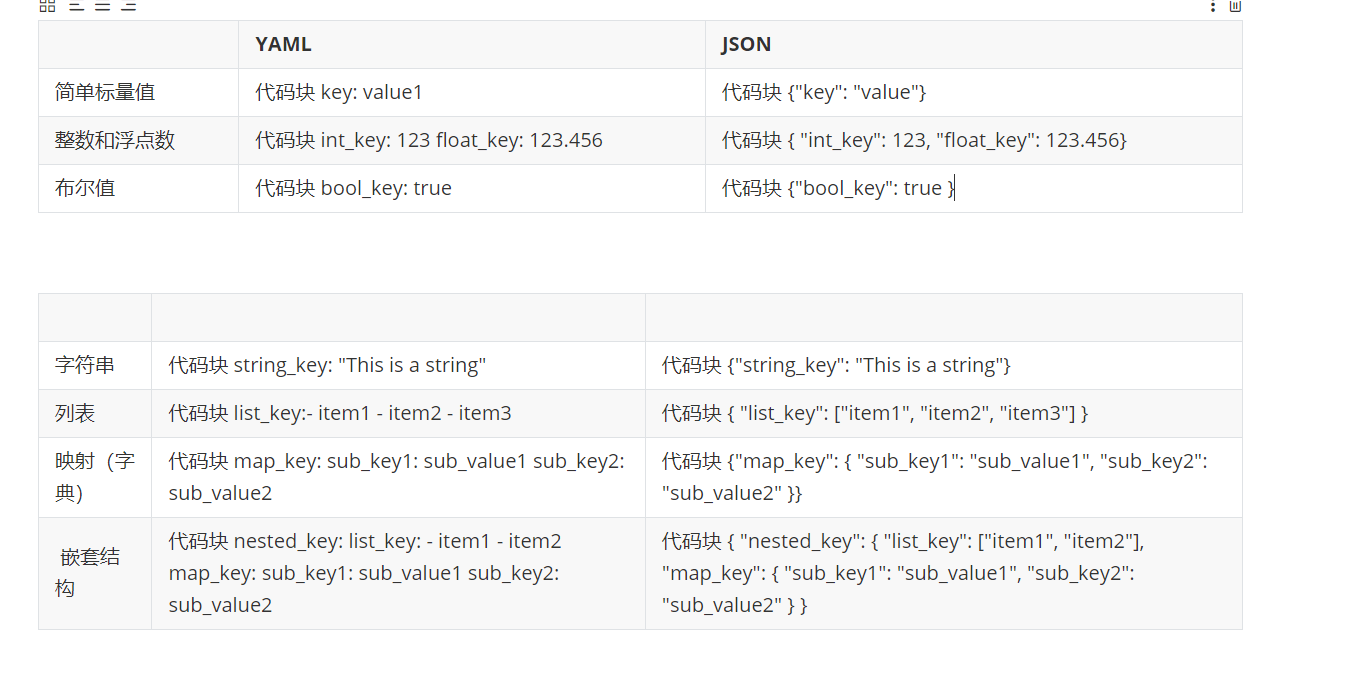
💡 以上语法若短时间内⽆法掌握,我们也有很多⼯具可供使⽤,如json转yaml json转yaml
2.6.2 使⽤
yaml ⽂件通常作为配置⽂件来使⽤,可以使⽤ yaml 库来读取和写⼊ YAML ⽂件
安装yaml库
代码块
pip install PyYAML==6.0.1
#建议统⼀版本,避免因版本不同造成的使⽤差异
创建yaml⽂件
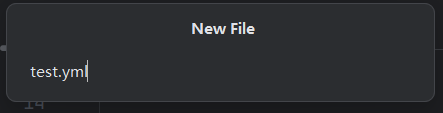
读取和写⼊yaml⽂件
代码块
import yaml
#追加写⼊
def write_yaml(filename, data):
with open(filename, encoding="utf-8", mode="a+") as f:
yaml.safe_dump(data, stream=f)
#读取
def read_yaml(filename, key):
with open(filename, encoding="utf-8", mode="r") as f:
data = yaml.safe_load(f)
return data[key]
#清空
def clear_yaml(filename):
with open(filename, encoding="utf-8", mode="w") as f:
f.truncate()
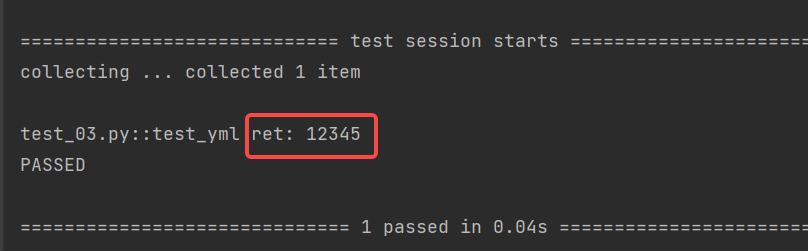
def test_yml():
#写⼊yaml⽂件
data = {"str":"12345"}
write_yaml('test.yml',data)
#读取yaml⽂件
ret = read_yaml('test.yml',"str")
print("ret:", ret)
#清空yaml⽂件
clear_yaml('test.yml')
2.7 JSON Schema
JSON Schema⼀个⽤来定义和校验JSON的web规范,简⽽⾔之,JSON Schema是⽤来校验json是否符合预期。
根据 json 创建 JSON Schema 后,你可以使⽤你选择的语⾔中的验证器将⽰例数据与你的模式进⾏验证。
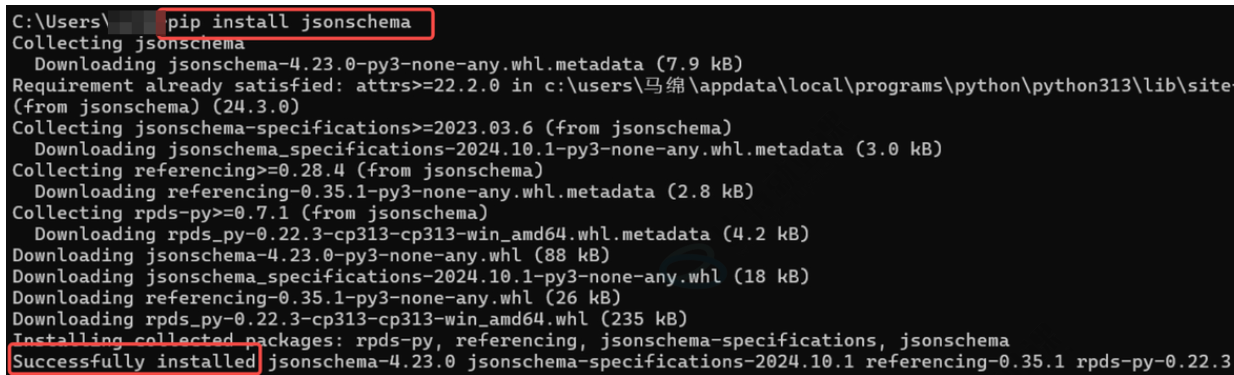
2.7.1 安装
代码块
pip install jsonschema==4.23.0
#建议统⼀版本,避免因版本不同造成的使⽤差异
介绍
Json:
代码块
{
"code": "SUCCESS",
"errMsg": "",
"data": false
}
JSON Schema:
代码块
{
"type": "object",
"required": [],
"properties": {
"code": {
"type": "string"
},
"errMsg": {
"type": "string"
},
"data": {
"type": "string"
}
}
}
通过上⾯的对⽐可⻅, JSON Schema 从多个⽅⾯对 JSON 数据进⾏校验。
如“ type ”、“ required ”、“ properties ”等以确保其正确性和⼀致性。接下来我们来了解 JSON Schema 中的关键词以及作⽤。
💡 json转JSON Schema太⿇烦?使⽤现有⼯具⾃动转换:https://tooltt.com/json2schema/
注意:⼯具不是万能的,结果可能存在错误,要对⾃动⽣成的结果进⾏⼆次检查
⽰例:校验博客列表⻚返回的json数据
代码块
import requests
from jsonschema.validators import validate
def test_json():
schema = {
"type": "object",
"required": [],
"properties": {
"code": {
"type": "string"
},
"errMsg": {
"type": "string"
},
"data": {
"type": "array",
"items": {
"type": "object",
"required": [],
"properties": {
"id": {
"type": "number"
},
"title": {
"type": "string"
},
"content": {
"type": "string"
},
"userId": {
"type": "number"
},
"deleteFlag": {
"type": "number"
},
"createTime": {
"type": "string"
},
"updateTime": {
"type": "string"
},
"loginUser": {
"type": "boolean"
}
}
}
}
}
}
url = "http://8.137.19.140:9090/blog/getList"
header = {
"user_token_header":"eyJhbGciOiJIUzI1NiJ9.eyJpZCI6MSwidXNlck5hbWUiOiJ6aGFuZ3Nhb
iIsImV4cCI6MTc0MDczOTIzOH0.lYiI6-fPBqIyTVItvUQRyD7OKruSXR6I5tNOEmorWw8"
} r
= requests.get(url=url,headers=header)
validate(r.json(),schema)
2.7.2.1 数据类型
type 关键字指定了数据类型。
可以验证 JSON 数据中每个属性的数据类型是否符合预期。常⽤的数据类型包括:
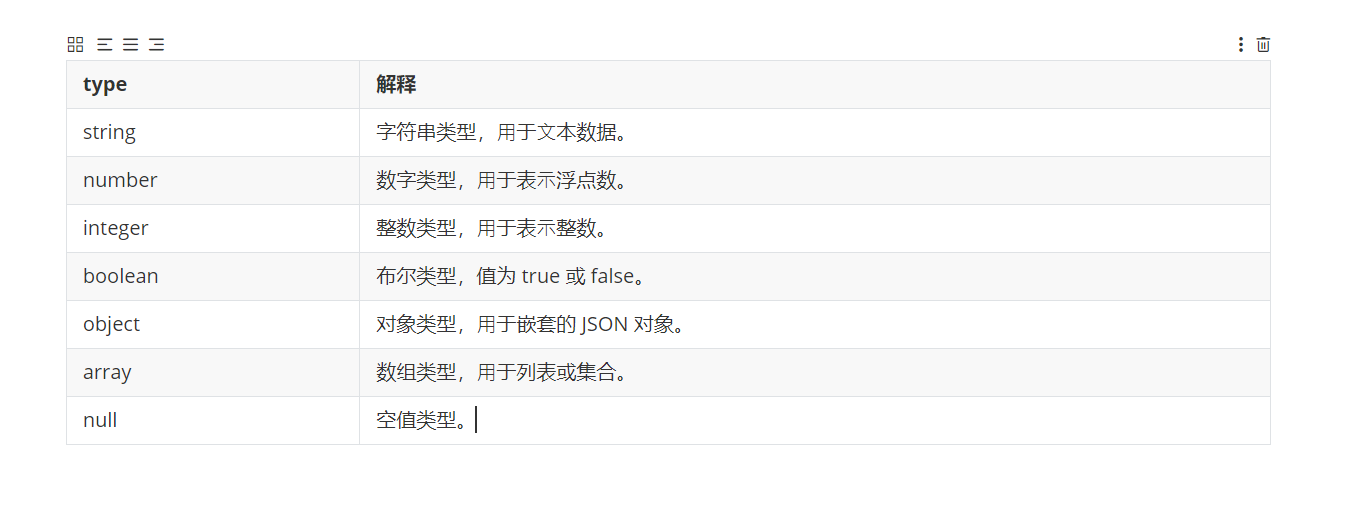
null 空值类型。
⽰例:
代码块
{
"type": "object",
"properties": {
"name": { "type": "string" },
"age": { "type": "integer" }
}
}
💡 properties 是⼀个验证关键字。当你定义 properties 时,你创建了⼀个对象,其
中每个属性代表正在验证的 JSON 数据中的⼀个键。
2.7.2.2 最⼤最⼩值
• minimum 和 maximum :指定数值的最⼩值和最⼤值。
• exclusiveMinimum 和 exclusiveMaximum :指定数值必须严格⼤于或⼩于某个值(不包
含等于)。
⽰例:
代码块
{
"type": "object",
"properties": {
"age": {
"type": "integer",
"minimum": 0,
"maximum": 120
}
}
}
2.7.2.3 字符串特殊校验
• pattern :使⽤正则表达式来验证字符串是否符合特定的模式。
代码块
{
"type": "object",
"properties": {
"email": {
"type": "string"
},
"username": {
"type": "string",
"pattern": "\S+"
}
}
}
2.7.2.4 数组约束
• minItems 和 maxItems :指定数组的最⼩和最⼤⻓度。
• uniqueItems :确保数组中的元素是唯⼀的。
• items :定义数组中每个元素的类型和约束。
代码块
{
"type": "object",
"properties": {
"tags": {
"type": "array",
"items": { "type": "string" },
"minItems": 1,
"uniqueItems": True
}
}
}
2.7.2.5 对象约束
• minProperties 和 maxProperties :指定对象的最⼩和最⼤属性数量。
• additionalProperties :控制是否允许对象中存在未在 properties 中定义的额外属性,默
认为True。
代码块
{
"type": "object",
"properties": {
"name": { "type": "string" }
},
"minProperties": 1,
"additionalProperties": False
}
2.7.2.6 必需属性
通过 required 关键字,JSON Schema 可以指定哪些属性是必需的。如果 JSON 实例中缺少这些必
需属性,验证将失败。
⽰例:
代码块
{
"type": "object",
"properties": {
"name": { "type": "string" },
"email": { "type": "string" }
},
"required": ["name", "email"]
}
2.7.2.7 依赖关系
dependentRequired 可以定义属性之间的依赖关系。例如,如果某个属性存在,则必须存在另⼀个属性。
⽰例:
代码块
{
"type": "object",
"properties": {
"creditCard": { "type": "string" },
"billingAddress": { "type": "string" }
},
"dependentRequired": {
"creditCard": ["billingAddress"]
}
}
2.8 logging⽇志模块
2.8.1 介绍
logging 是 Python 标准库中的⼀个模块,它提供了灵活的⽇志记录功能。通过 logging ,开发者可以⽅便地将⽇志信息输出到控制台、⽂件、⽹络等多种⽬标,同时⽀持不同级别的⽇志记录,以满⾜不同场景下的需求。
2.8.2 使⽤
⽰例1:全局logging
代码块
import logging
logging.basicConfig(level=logging.INFO)
logging.debug('This is a debug message')
logging.info('This is an info message')
logging.warning('This is a warning message')
logging.error('This is an error message')
logging.critical('This is a critical message')
⽰例2:⾃定义logger并输出到控制台
代码块
# 导⼊ logging 模块
import logging
logging.basicConfig(level=logging.INFO)
# 获取⼀个⽇志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)
# 设置⽇志记录器的级别为 DEBUG
# 这意味着所有级别为 DEBUG 及以上的⽇志都会被记录
logger.setLevel(logging.DEBUG)
if __name__ == "__main__":
logger.debug('This is a debug message')
logger.info('This is an info message')
logger.warning('This is a warning message')
logger.error('This is an error message')
logger.critical('This is a critical message')
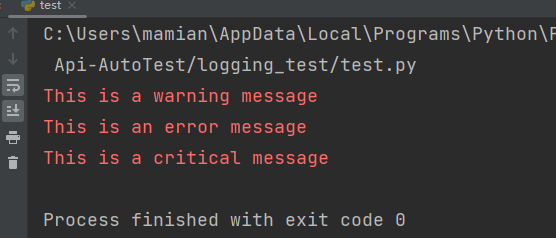
结果:
⽰例3:⾃定义logger并输出到⽇志⽂件
代码块
# 导⼊ logging 模块
import logging
# 获取⼀个⽇志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)
# 设置⽇志记录器的级别为 DEBUG
# 这意味着所有级别为 DEBUG 及以上的⽇志都会被记录
logger.setLevel(logging.DEBUG)
# 创建⼀个 FileHandler 对象,指定⽇志⽂件的名称为 "test.log"
# 这个处理器会将⽇志信息写⼊到指定的⽂件中
handler = logging.FileHandler(filename="test.log")
# 将这个处理器添加到⽇志记录器中
# 这样,⽇志记录器就会使⽤这个处理器来处理⽇志信息
logger.addHandler(handler)
if __name__ == "__main__":
logger.debug('This is a debug message')
logger.info('This is an info message')
logger.warning('This is a warning message')
logger.error('This is an error message')
logger.critical('This is a critical message')
结果:
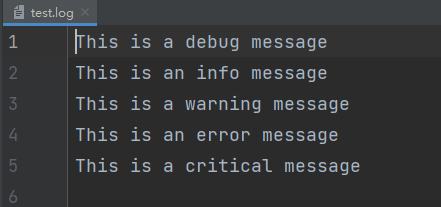
• 获取⽇志记录器: logging.getLogger(name) 获取⼀个⽇志记录器对象, name 是当前模块的名称。使⽤模块名称作为⽇志记录器的名称有助于在⼤型项⽬中区分不同模块的⽇志.
• 设置⽇志级别: logger.setLevel(logging.DEBUG) 将⽇志记录器的级别设置为 DEBUG ,这意味着所有 DEBUG 及以上级别的⽇志都会被记录. ⽇志级别⾦字塔:DEBUG < INFO < WARNING < ERROR < CRITICAL ⾼于设定级别的⽇志才会被处理
• 创建⽂件处理器: logging.FileHandler(filename=“test.log”) 创建⼀个⽂件处理器,将⽇志信息写⼊到名为 test.log 的⽂件中.
• 添加处理器: logger.addHandler(handler) 将⽂件处理器添加到⽇志记录器中,这样⽇志记录器就会使⽤这个处理器来处理⽇志信息.
⽰例4:设置⽇志格式
代码块
# 导⼊ logging 模块
import logging
# 获取⼀个⽇志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)
# 设置⽇志记录器的级别为 DEBUG
# 这意味着所有级别为 DEBUG 及以上的⽇志都会被记录
logger.setLevel(logging.DEBUG)
# 创建⼀个 FileHandler 对象,指定⽇志⽂件的名称为 "test.log"
# 这个处理器会将⽇志信息写⼊到指定的⽂件中
handler = logging.FileHandler(filename="test.log")
# 创建⼀个⽇志格式器对象
formatter = logging.Formatter(
"%(asctime)s %(levelname)s [%(name)s] [%(filename)s (%(funcName)s:%
(lineno)d)] - %(message)s"
) #
将格式器设置到处理器上
handler.setFormatter(formatter)
# 将这个处理器添加到⽇志记录器中
# 这样,⽇志记录器就会使⽤这个处理器来处理⽇志信息
logger.addHandler(handler)
if __name__ == "__main__":
logger.debug('This is a debug message')
logger.info('This is an info message')
logger.warning('This is a warning message')
logger.error('This is an error message')
logger.critical('This is a critical message')
结果:
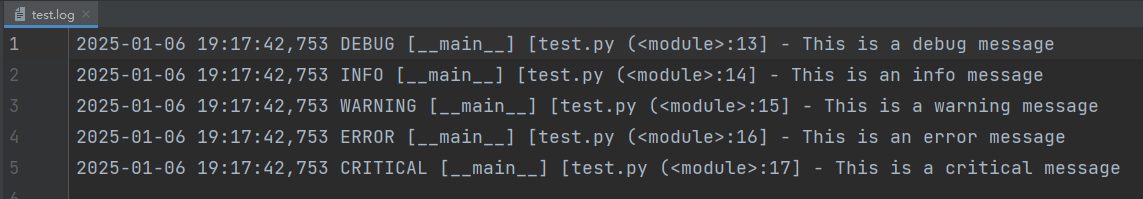
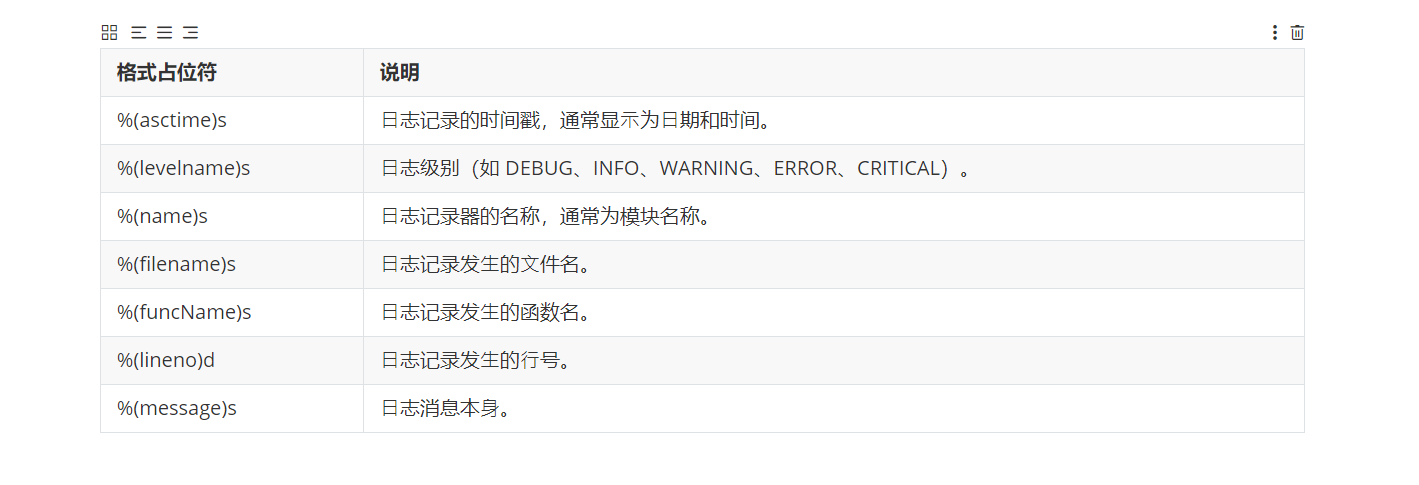
logging.Formatter 是⽤于定义⽇志输出格式的类。在构造函数中,传递了⼀个格式字符串,⽤于指定⽇志信息的格式。格式字符串中使⽤了⼀些特殊的占位符(以 % 开头),这些占位符会被替换为相应的⽇志信息内容
handler.setFormatter(formatter) 将创建的格式器对象设置到处理器上。这意味着处理器在处理⽇志信息时,会使⽤这个格式器来格式化⽇志信息.
通过这种⽅式,你可以控制⽇志信息的输出格式,使其包含你感兴趣的信息,如时间戳、⽇志级别、⽂件名、函数名、⾏号等。
2.9 测试报告allure
官⽅⽂档:https://allurereport.org/docs/pytest-configuration
2.9.1 介绍
Allure Report 由⼀个框架适配器和 allure 命令⾏⼯具组成,是⼀个流⾏的开源⼯具,⽤于可视化测试运⾏的结果。它可以以很少甚⾄零配置的⽅式添加到您的测试⼯作流中。它⽣成的报告可以在任何地⽅打开,并且任何⼈都可以阅读,⽆需深厚的技术知识.
2.9.2 安装
1)下载allure-pytest包
代码块
pip install allure-pytest==2.13.5
#建议统⼀版本,避免因版本不同造成的使⽤差异
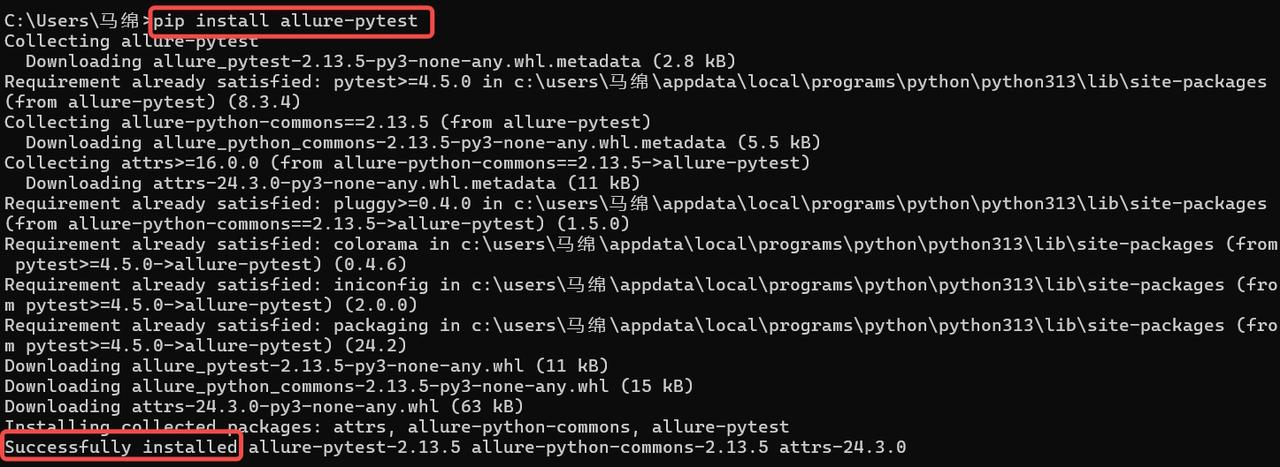
2)下载Windows版Allure报告
• 下载压缩包
下载链接:https://github.com/allure-framework/allure2/releases/download/2.30.0/allure-
2.30.0.zip
• 解压
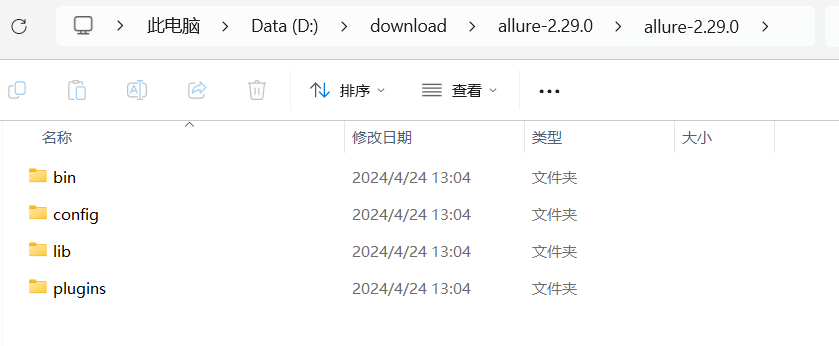
• 添加系统环境变量
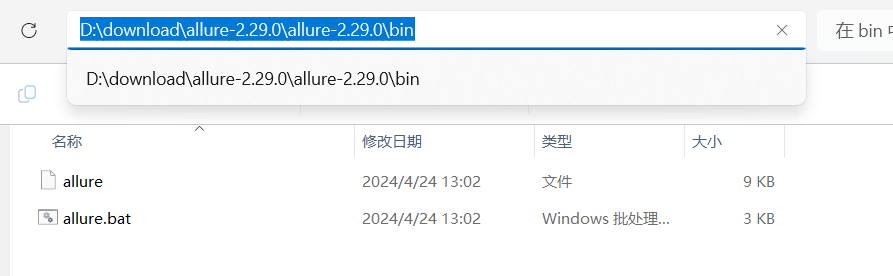
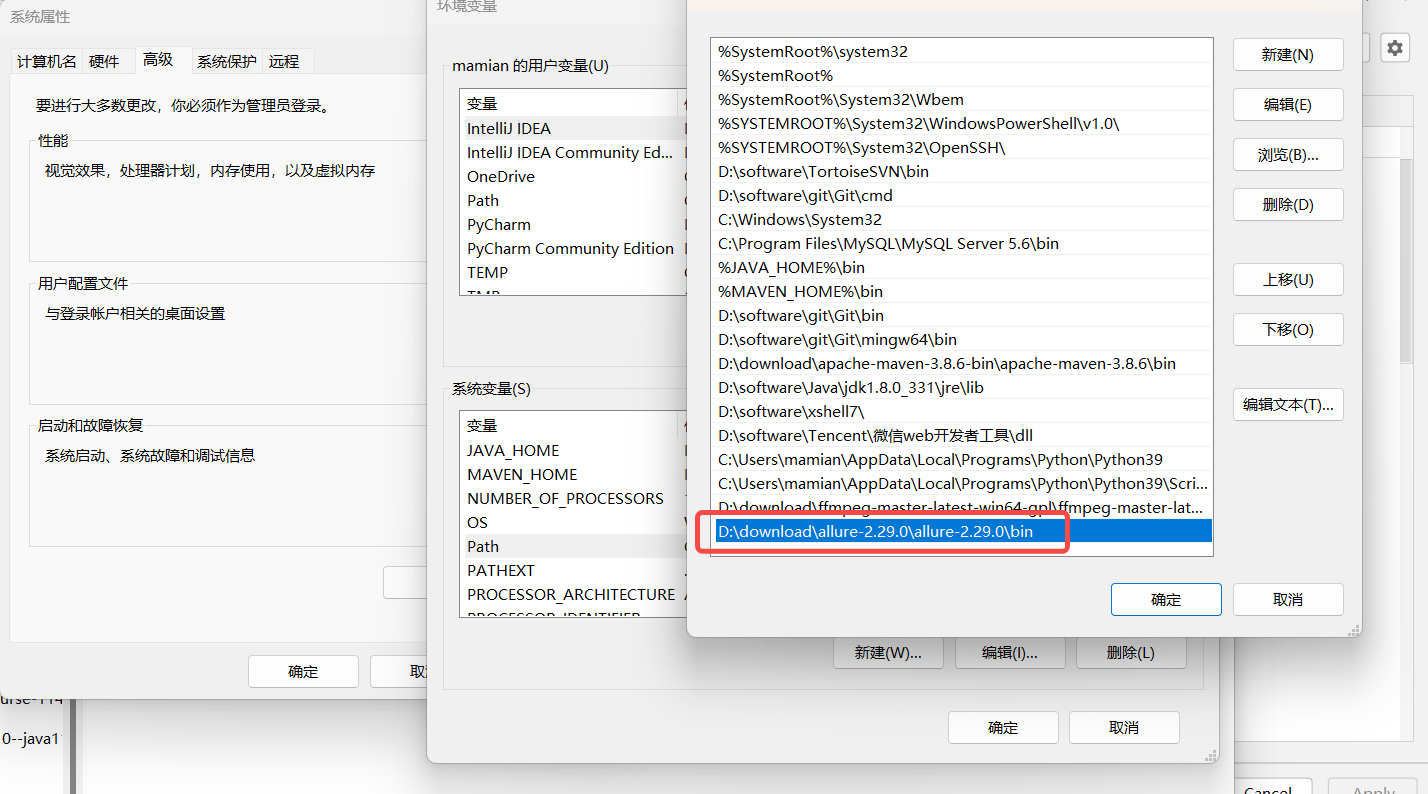
将allure-2.29.0对应bin⽬录添加到系统环境变量中 • 确认结果
打开cmd,查看allure版本
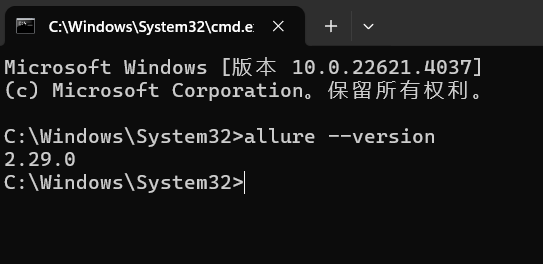
出现 allure 版本则安装成功。
若出现cmd中执⾏ allure --version 可以打印版本,但是pycharm控制台执⾏命令提
⽰命题找不到,则需要修改pycharm中命令⾏环境,如下:
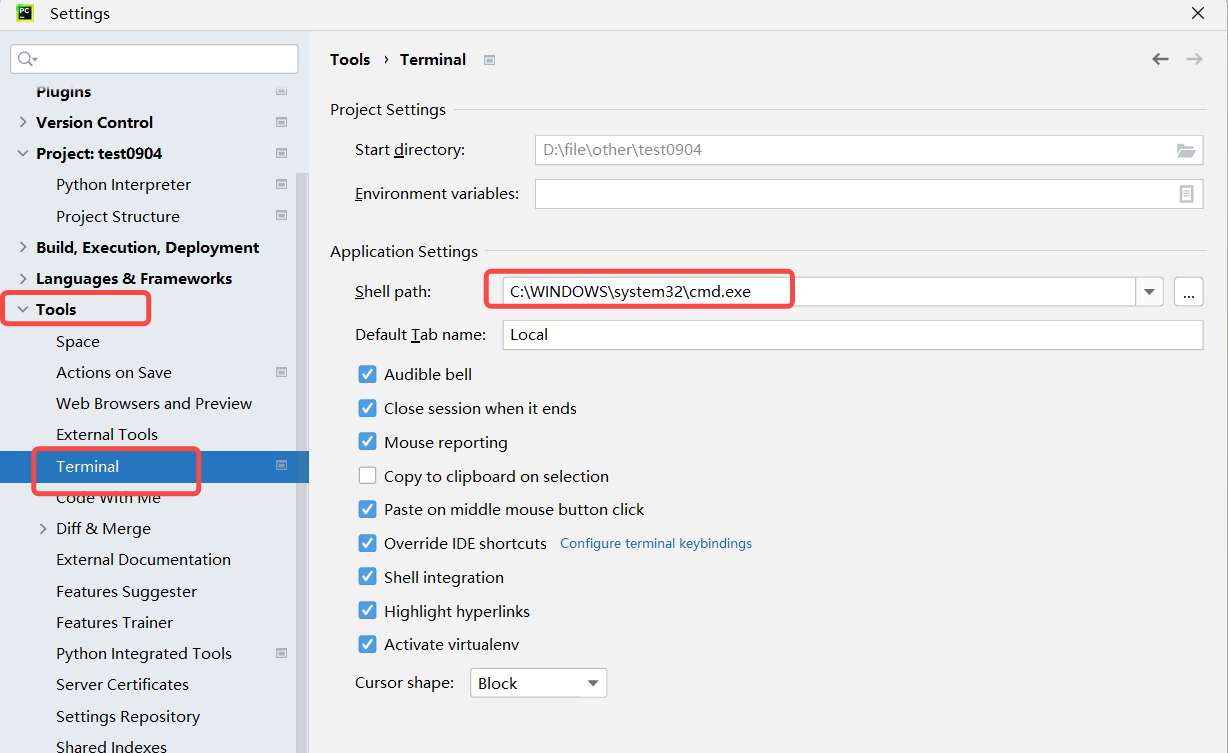
保存后需要重启pycharm!!!!!!
检查pycharm中命令⾏是否可以使⽤allure命令
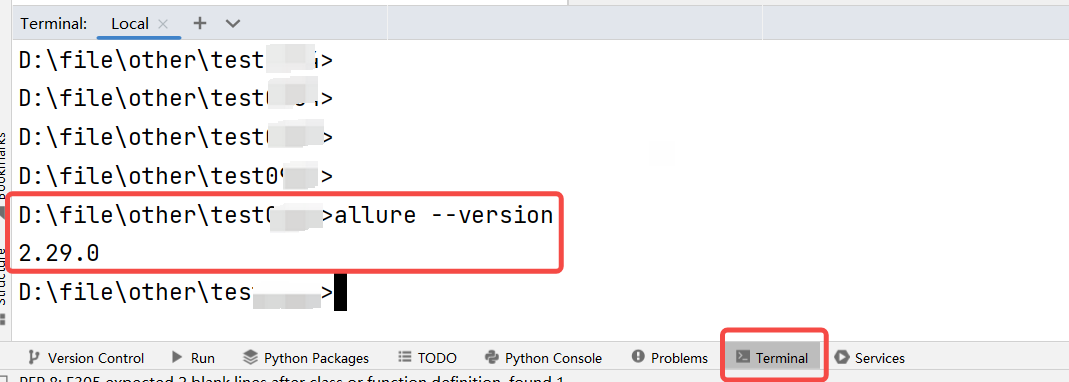
2.9.3 使⽤
• step1:运⾏⾃动化,并指定测试报告放置路径
代码块
pytest --alluredir=results_dir(保存测试报告的路径)
⽰例:pytest --alluredir=allure-results
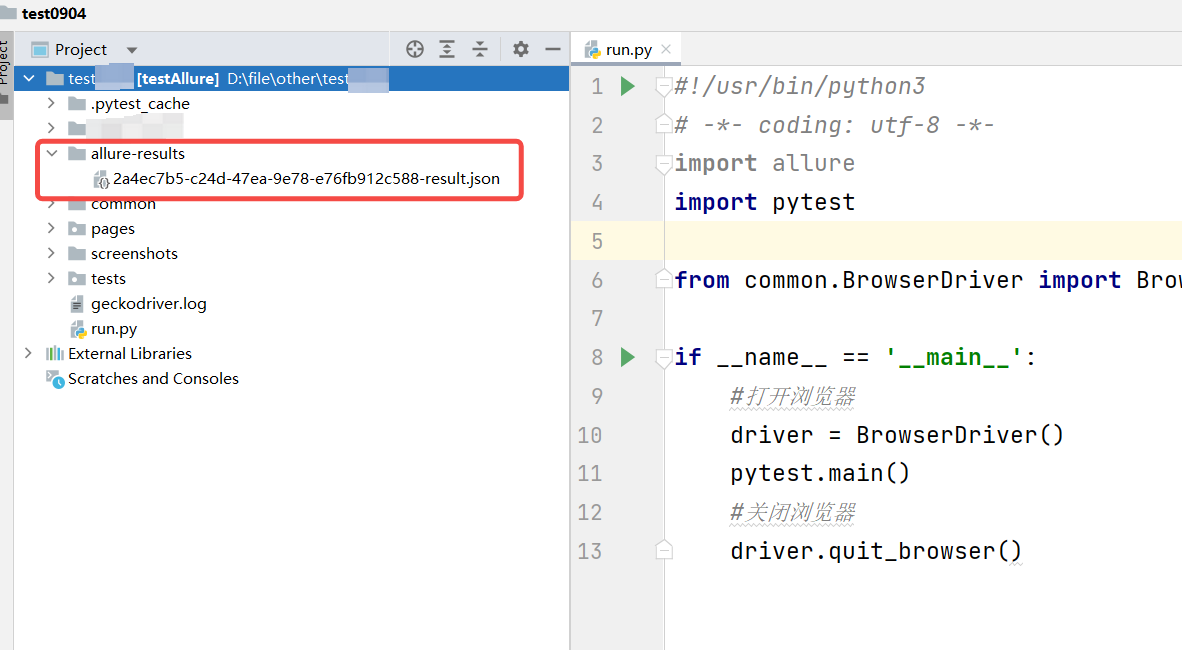
当前项⽬下⾃动⽣成 allre-results ⽂件夹,存放报告相关⽂件
💡 ⽣成测试报告可以在控制台通过命令将结果保存在 allre-results ⽂件夹中,也可以在
pytest.ini⽂件中配置测试报告放置路径
addopts = -vs --alluredir allure-results
• step2:查看测试报告
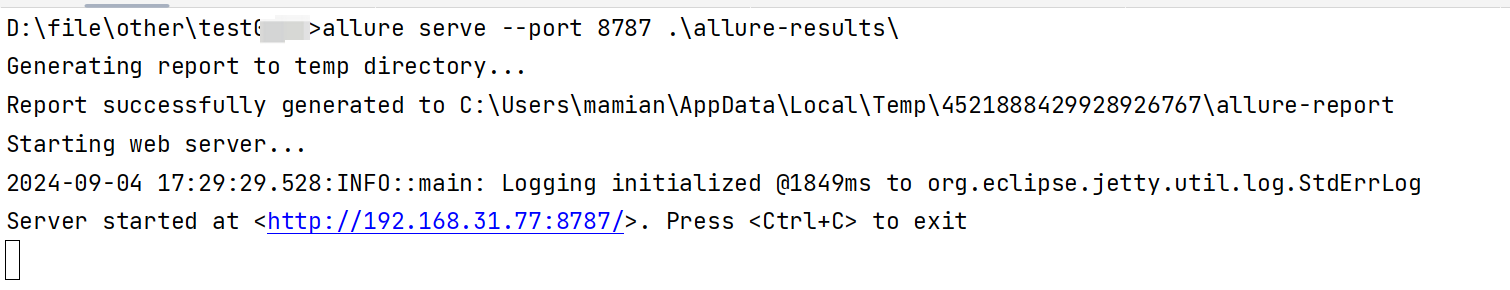
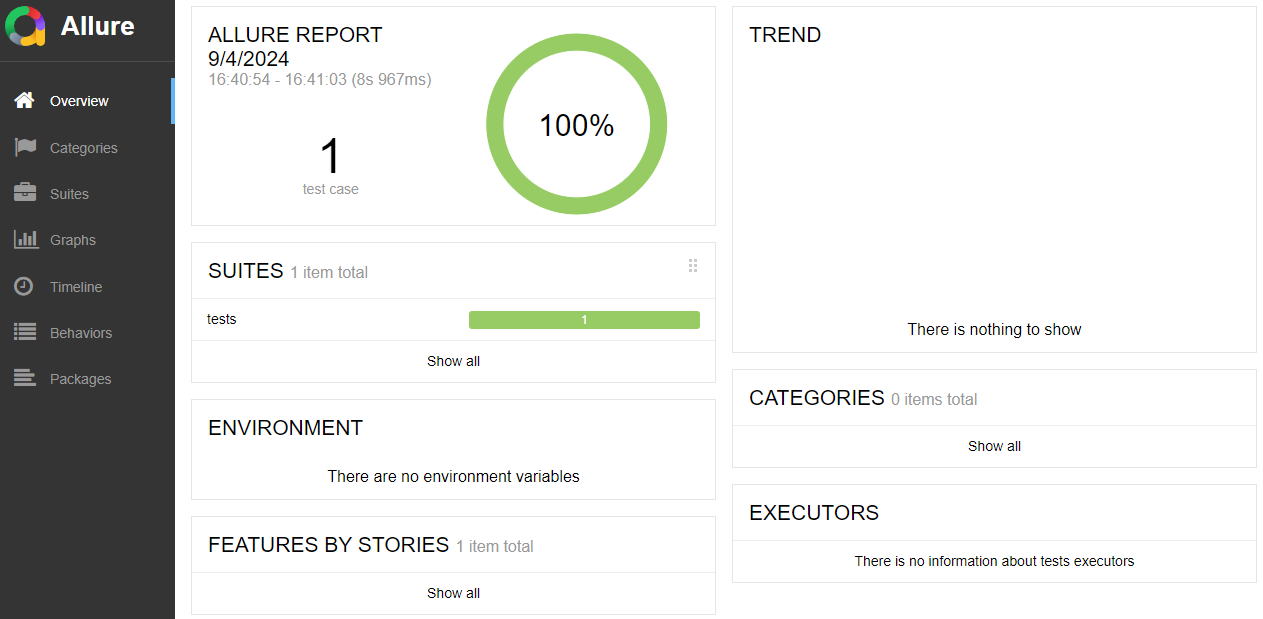
1)⽅法⼀:启动⼀个本地服务器来在浏览器中展⽰测试报告
终端执⾏命令: allure serve [options] ,⾃动在浏览器打开测试
报告
• --host :指定服务器监听的主机地址,默认为 localhost。
• --port :指定服务器监听的端⼝号,默认为 0(⾃动选择空闲端⼝)
• --clean-alluredir :清除上⼀次⽣成的测试报告
⽰例:
代码块
#不指定端⼝号和主机地址
allure serve .\allure-results\
#指定端⼝号
allure serve --port 8787 .\allure-results\
#清除上⼀次⽣成的测试报告
allure serve .\allure-results\ --clean-alluredir
2)⽅法⼆:从测试结果⽣成测试报告
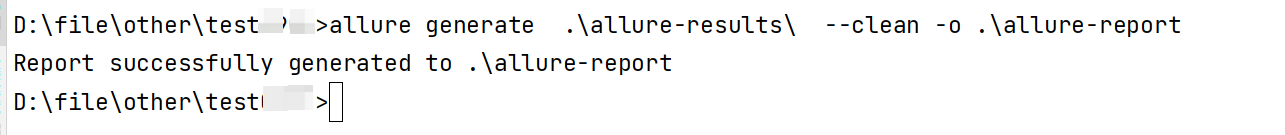
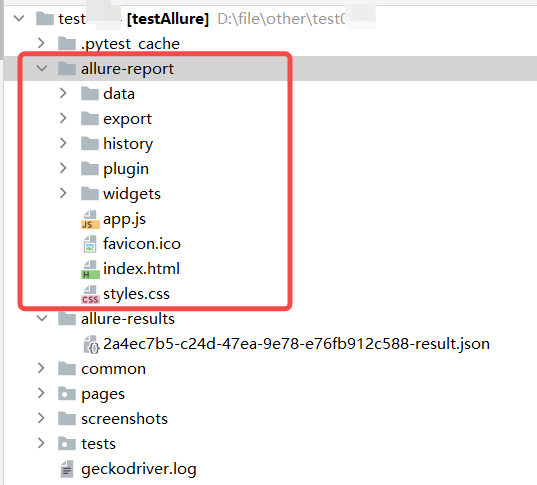
终端执⾏命令: allure generate [options] -o
⽰例:
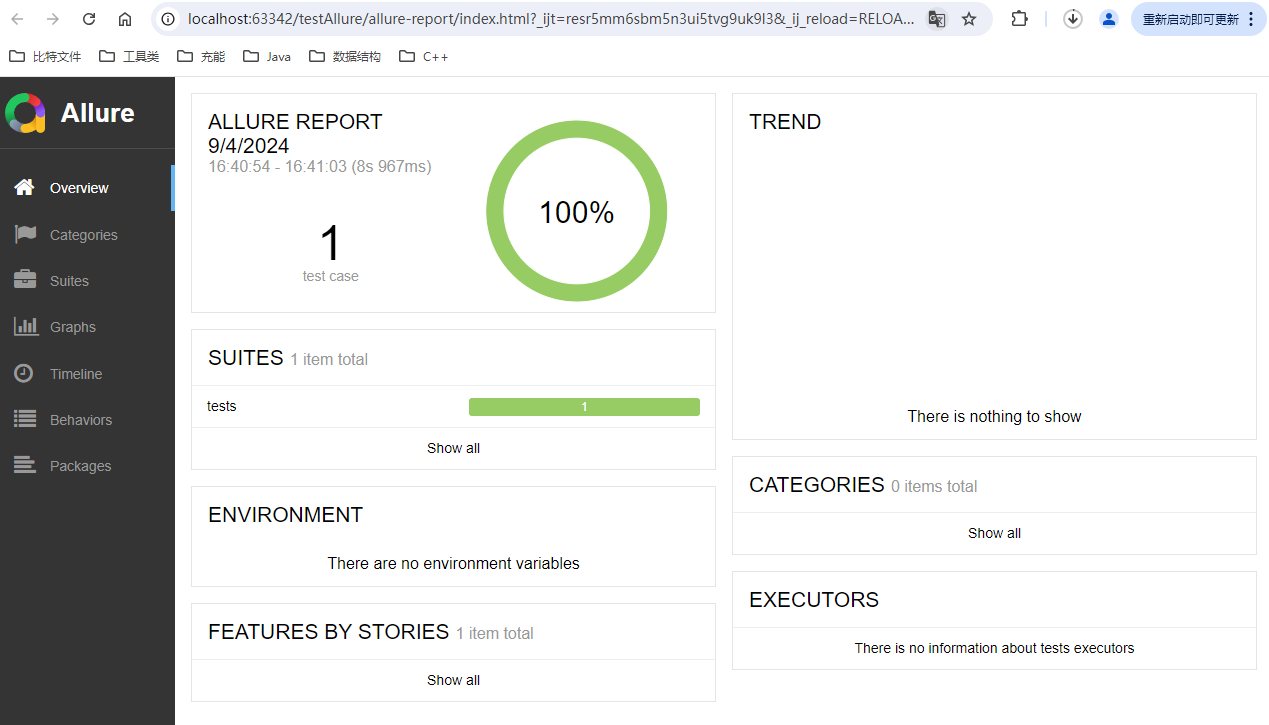
代码块
allure generate .\allure-results\ -o .\allure-report --clean
总结
以上就是接口自动化测试篇的全部内容了,喜欢博主写的内容可以一键三连!!!!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献2条内容

所有评论(0)