2026国产时序数据库新范式:融合架构崛起与专业赛道分化
前言
进入2026年,在“数字中国”与工业物联网浪潮的强劲推动下,国产时序数据库市场持续繁荣,竞争格局日趋清晰。本文将对当前主流的国产时序数据库进行梳理盘点,并特别聚焦于金仓数据库(Kingbase),深入剖析其以融合多模架构为核心的差异化竞争实力,为企业在数字化转型中的时序数据底座选型提供参考。
一、主流国产时序数据库概览
国产时序数据库已形成多元产品矩阵,根据其核心技术路线、商业模式和市场定位,主要代表性产品如下:
| 数据库名称 | 核心厂商/社区 | 主要特点与定位 |
|---|---|---|
| TDengine | 涛思数据 | 高性能、分布式,定位为AI驱动的工业大数据平台,在写入吞吐和存储成本方面优势显著,集群开源、生态开放。 |
| KaiwuDB | 浪潮云弈 | 强调分布式多模融合架构,支持时序、关系、文档等多种数据模型的统一处理,原生集成AI算法。 |
| Apache IoTDB | 清华大学 (Apache基金会) | 专为物联网设计,采用“端-边-云”协同原生架构,数据模型常采用树形结构贴合物理设备层级。 |
| DolphinDB | 浙江智臾科技 | 将数据库与强大的编程语言、流计算引擎融合,在金融量化交易、高频数据分析领域表现突出。 |
| openGemini | 华为云 | 开源的多模态时序数据库,兼容InfluxDB生态,强调高性能与云原生特性。 |
| CnosDB | 诺司时空 | 云原生时序数据库,支持分布式与集中式部署,在监控和物联网场景有应用。 |
| GreptimeDB | 格睿科技 | 云原生分布式时序数据库,主打实时分析能力。 |
| YMatrix, RealHistorian, GoldenData等 | 四维纵横、紫金桥、庚顿数据等 | 在特定工业或监控领域拥有深厚的行业积累和定制化解决方案。 |
| 金仓时序数据库 | 中电科金仓(原人大金仓) | 作为其企业级融合数据库(KES)的时序组件,主打内核级多模(时序/关系/空间)融合与统一事务处理。 |
二、焦点解析:金仓时序数据库的融合多模架构
在众多专注于时序场景极致优化的产品中,金仓数据库的时序组件选择了一条独特的路径:不追求做一个孤立的专用时序引擎,而是作为其强大的融合数据库体系(KES)中的一个版块。这种架构选择带来了以下显著优势:
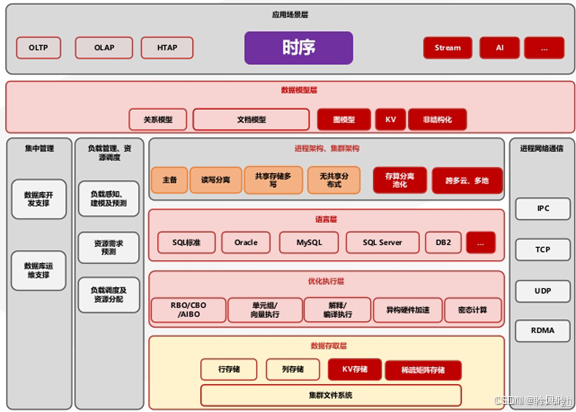
(1)内核级多模态融合,打破数据孤岛
-
统一底座: 金仓时序组件并非独立产品,而是基于成熟的KingbaseES关系型数据库内核进行融合。这意味着企业无需为时序数据单独搭建和维护一套新的数据基础设施。
-
无缝关联查询: 时序数据(如传感器读数)与业务关系数据(如设备台账、生产工单)天然存储在同一数据库中。用户可以使用标准的SQL(支持Oracle/PostgreSQL兼容模式)直接进行跨时序表和关系表的复杂JOIN查询,无需繁琐的数据同步与导出,极大简化了数据分析链路。
-
支持丰富数据类型: 得益于KES内核,它不仅支持时序数据常用的数值、时间戳类型,还原生支持JSON、GIS空间数据、数组等复杂类型,能够满足更广泛的工业数字化场景需求。
(2)复用并强化企业级核心能力
-
极致的事务(ACID)保证: 在金仓的时序表上,数据写入同样享有完整的关系型数据库事务支持,这在要求数据强一致性的金融、电力调度等关键业务场景中是独特优势。
-
企业级高可用与安全: 时序数据可直接受益于KES已构建成熟的读写分离、共享存储、分布式集群等高可用架构,以及行列级权限控制、数据加密等企业级安全特性。
-
成熟的生态与工具链: 可直接复用KES的备份恢复、监控运维、数据迁移(KDTS)等整套运维管理工具,以及与各类BI、ETL工具的连接生态,降低学习与运维成本。
(3)面向复杂场景的综合性能表现
从金仓官方披露的测试报告(如使用TSBS工具对比InfluxDB)来看,其时序组件在特定场景下展现出竞争力:
-
写入性能: 通过优化分区策略、并行插入等手段,在特定配置下可实现单机百万级、集群千万级数据点/秒的写入能力。
-
查询性能: 在涉及多维度聚合、跨表关联等复杂查询场景中,凭借成熟的SQL优化器与执行引擎,性能表现显著优于部分原生时序数据库,尤其适合需要将时序数据与业务数据进行深度整合分析的场景。
三、行业应用与实践
金仓时序组件的融合架构使其在那些既需要处理海量时序数据流,又需要与核心业务系统紧密集成的场景中找到了用武之地,公开案例包括:
- 福建省船舶安全综合管理平台: 处理沿海数十万船舶终端的GPS定位时序数据,基于KES分片(Sharding)方案实现日峰值亿级写入与百亿级历史数据的毫秒级地理空间查询。
- 国家电网智能电网调度系统: 在国产化迁移项目中,支撑高频、可靠的电力数据录入,并实现与大量既有关系型业务数据的混合处理与分析。
- 智慧港口(如厦门港)、智能制造厂区: 记录设备轨迹、工况时序数据,并与生产管理系统、设备管理系统进行实时关联分析。
四、2026年国产时序数据库选型思考
企业在2026年进行时序数据库选型时,应超越对单一峰值性能指标的过度关注,从更宏观的视角评估:
- 数据架构复杂性: 如果业务中时序数据与关系数据、空间数据等紧密耦合,需要频繁关联分析,金仓的融合多模架构将提供极大的便利性和整体性价比。
- 长期运维与总拥有成本(TCO): 考虑引入新产品带来的学习成本、运维复杂度以及生态整合成本。复用现有关系型数据库团队的技能栈和工具链,是金仓方案的另一大隐性优势。
- 开发友好度与学习曲线: 团队是否熟悉SQL?是否需要基于时序数据快速构建复杂业务应用?标准SQL的普适性可以极大提升开发效率和降低门槛。
五、融合多模实战
为了更直观地展示金仓时序数据库的“融合多模”特性,我们以一个智能制造场景为例,展示如何在同一数据库中管理设备元数据、时序数据,并进行关联分析。
假设我们有设备信息表(关系数据)和设备传感器数据表(时序数据)。在金仓KES中,可以这样操作:
-- 1. 创建关系表:存储设备静态信息(设备台账)
CREATE TABLE devices (
    device_id INT PRIMARY KEY,
    device_name VARCHAR(100),
    location VARCHAR(255),
    factory_id INT,
    install_date DATE
);

-- 2. 创建时序表:存储设备运行时传感器数据
-- 使用 `PARTITION BY RANGE` 按时间分区,这是时序场景的典型优化手段
CREATE TABLE sensor_readings (
    ts TIMESTAMP NOT NULL,        -- 时间戳
    device_id INT NOT NULL,       -- 关联设备ID
    temperature DECIMAL(5,2),     -- 温度
    pressure DECIMAL(6,2),        -- 压力
    status_code INT               -- 状态码
) PARTITION BY RANGE (ts);

-- 为时序表创建分区(例如,按月分区)
CREATE TABLE readings_2026_01 PARTITION OF sensor_readings
    FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');
CREATE TABLE readings_2026_02 PARTITION OF sensor_readings
    FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');

-- 3. 插入数据(与普通SQL操作完全一致)
-- 插入设备信息
INSERT INTO devices VALUES
(1, '反应釜A-001', '一车间', 10, '2025-06-01'),
(2, '传送带B-002', '二车间', 10, '2025-07-15');

-- 插入时序数据(模拟传感器写入)
INSERT INTO sensor_readings (ts, device_id, temperature, pressure) VALUES
('2026-01-15 10:00:00', 1, 125.50, 1.23),
('2026-01-15 10:01:00', 1, 126.00, 1.25),
('2026-01-15 10:00:30', 2, 65.30, 0.98);

-- 4. 核心优势展示:无缝关联查询
-- 查询一车间所有设备在过去一小时的平均温度,并显示设备名称
SELECT
    d.device_name,
    d.location,
    AVG(sr.temperature) AS avg_temp,
    MAX(sr.ts) AS last_reading_time
FROM sensor_readings sr
JOIN devices d ON sr.device_id = d.device_id
WHERE d.factory_id = 10  -- 业务逻辑:筛选一车间
  AND sr.ts >= NOW() - INTERVAL '1 hour'  -- 时序逻辑:筛选最近一小时
GROUP BY d.device_id, d.device_name, d.location
ORDER BY avg_temp DESC;

-- 5. 复杂分析示例:找出温度持续超标的设备及其详细信息
-- 这在一个纯时序库中通常需要额外导出数据到业务库才能完成
WITH abnormal_devices AS (
    SELECT DISTINCT device_id
    FROM sensor_readings
    WHERE ts >= NOW() - INTERVAL '24 hour'
      AND temperature > 130.00 -- 阈值
)
SELECT
    d.*,
    (SELECT MAX(ts) FROM sensor_readings sr WHERE sr.device_id = d.device_id) AS last_seen
FROM devices d
WHERE d.device_id IN (SELECT device_id FROM abnormal_devices);
代码解读:
- 统一SQL操作:无论是DDL(建表)还是DML(增删改查),都使用标准SQL语法,学习成本低。
- 时序优化:通过
PARTITION BY RANGE (ts)对时序数据进行分区管理,这在查询特定时间范围时能大幅提升性能,是时序场景的关键优化。 - 核心融合查询:
示例4展示了最典型的优势 —— 在一条SQL内同时完成时序过滤(时间范围)、关系过滤(车间筛选)和表关联(JOIN),直接产出业务所需报表。 - 高级分析能力:
示例5展示了利用公用表表达式(CTE)和子查询进行更复杂的分析,这些功能都是成熟关系型数据库内核的天然能力。
这个例子清晰地表明,金仓的融合架构允许开发者像处理普通业务数据一样处理时序数据,无需学习新的查询语言(如InfluxQL、Flux)或进行复杂的数据搬运,极大简化了开发逻辑。
六、结论
2026年的国产时序数据库赛道已进入“精耕细作”阶段。以TDengine、IoTDB、DolphinDB为代表的专业时序库在各自优势领域持续深化。
金仓时序数据库凭借其独特的融合多模架构,走出了一条差异化道路。它并非“万能钥匙”,但对于那些业务逻辑复杂、数据形态多样、且对事务一致性与系统整合有高要求的企业级用户而言,提供了一个能够将时序数据能力平滑、稳健地嵌入到现有企业数据核心中的优秀选择,体现了国产基础软件在架构设计上的深度思考与务实创新。
未来,随着AI for Data、实时智能分析的普及,时序数据库的“智能”与“融合”能力将愈发关键。如何更好地将时序处理能力与多模数据、AI框架、流批计算无缝结合,将是所有厂商共同面临的下一个课题。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献5条内容

所有评论(0)