doris基础架构与写入原理
一、基础架构
1.1 整体架构
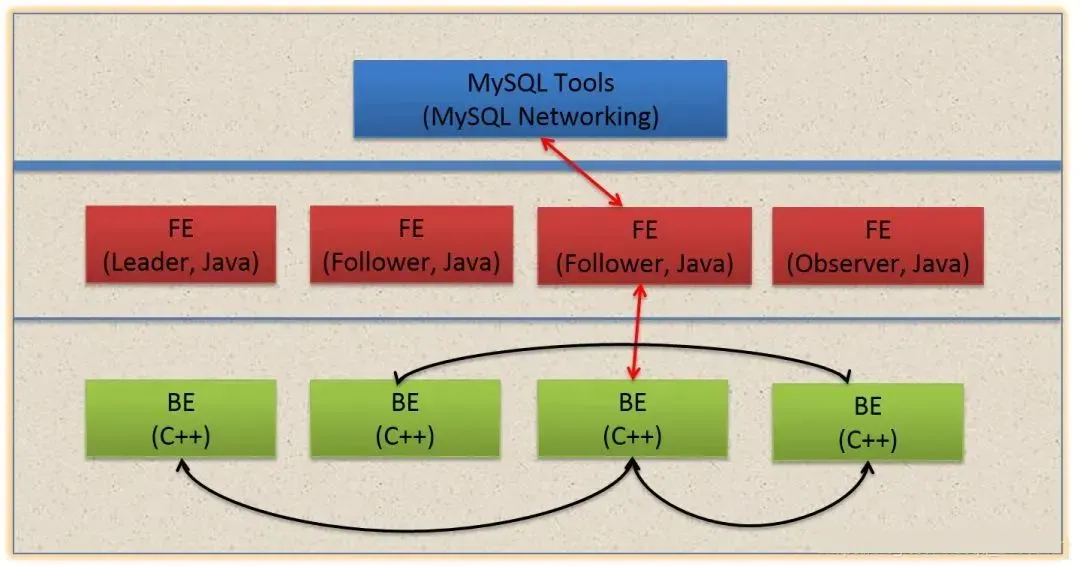
- FE:负责存储和维护元数据、接收查询请求、生成查询计划、调度查询执行、返回查询结果
-
- Leader:从 Follower 中选举产生,负责元数据的写操作
- Follower:参与选举,3 个 Follower 可保证元数据高可用
- Observer:不参与选举,用于扩展查询请求的接收能力
各个FE之间通过BerkeleyDB Java Edition(bdbje)进行leader选举,数据同步等工作。
Follower通过选举,其中一个Follower成为leader节点,负责元数据的写入操作。当leader节点宕机后,其他Follower节点会重新选举出一个leader,保证服务的高可用。
- BE:负责物理数据的存储和计算,依赖FE生成的查询计划,分布式地执行查询
-
- 执行 FE 下发的查询计划
- 数据默认三副本,分布在不同 Host 的 BE 上
- 保证数据可靠性和查询负载均衡
1.2 存储层级结构
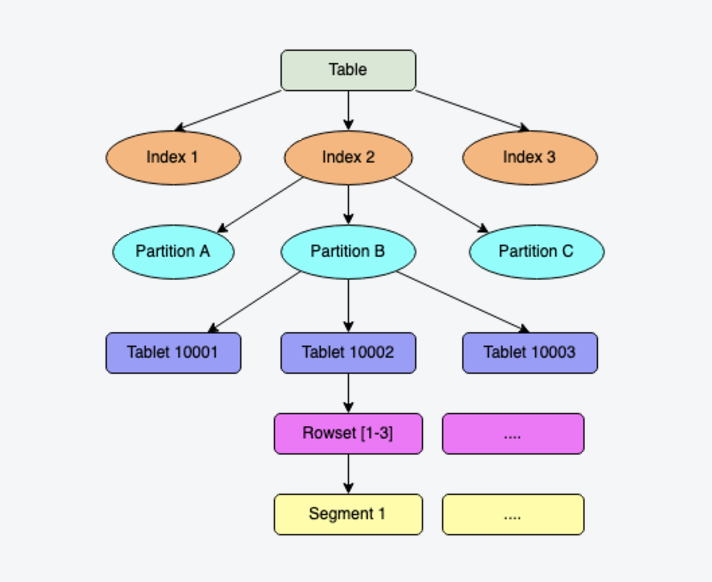
Doris 的数据存储采用多级划分,从上到下依次为:
|
层级 |
说明 |
特点 |
|
Index |
物化视图/RollUp 表 |
与主表同步写入,可用于上卷和调整 Key 顺序 |
|
Partition |
分区,通常按时间划分 |
逻辑最小管理单元,数据导入/删除以此为单位 |
|
Tablet |
分桶,按指定列 Hash 分桶 |
物理最小存储单元,数据移动/复制以此为单位 |
|
Rowset |
单次导入的数据集合 |
采用 Merge-On-Read 方式读取 |
|
Segment |
Rowset 内的文件单元 |
写入完成后保证有序 |
1.3 分区与分桶
分区(Partition)和分桶(Bucket/Tablet)是 Doris 数据分布的核心机制,直接影响查询性能和数据管理。
分区(Partition)
分区是逻辑上的数据划分,通常按时间维度划分:
• 分区方式:Range 分区(按范围)、List 分区(按枚举值)
• 典型场景:按天/月分区,如 p20231201、p20231202
• 管理单元:数据导入、删除、过期清理都以分区为单位
• 查询优化:分区裁剪,查询时只扫描相关分区
示例:按天 Range 分区
PARTITION BY RANGE(event_date) (
PARTITION p20231201 VALUES LESS THAN ('2023-12-02'),
PARTITION p20231202 VALUES LESS THAN ('2023-12-03')
)
分桶(Bucket/Tablet)
分桶是物理上的数据划分,每个分区内按分桶列 Hash 分散数据:
• 分桶方式:Hash 分桶(按指定列)、Random 分桶(随机分布)
• 物理单元:每个 Bucket 对应一个 Tablet,是数据存储、移动、复制的最小单元
• 副本分布:每个 Tablet 默认 3 副本,分布在不同 BE 节点
• 查询优化:分桶裁剪,点查时只访问对应 Tablet
示例:按 user_id Hash 分 16 桶
DISTRIBUTED BY HASH(user_id) BUCKETS 16
数据分布策略
分桶只是决定数据属于哪个tablet。doris均衡策略会把tablet的副本分散到不同的BE。
1. 分桶:数据 → Tablet
─────────────────────────
Hash(分桶键) % 分桶数 = Tablet ID

例:3 个分桶
数据1 → Hash % 3 = 0 → Tablet_0
数据2 → Hash % 3 = 1 → Tablet_1
数据3 → Hash % 3 = 2 → Tablet_2


2. Tablet 分配:Tablet → BE
─────────────────────────
Tablet_0 → BE1, BE2, BE3 (3副本)
Tablet_1 → BE2, BE3, BE4 (3副本)
Tablet_2 → BE3, BE4, BE5 (3副本)

每个 Tablet 的副本会分散到不同 BE
分区分桶选择原则
|
维度 |
选择建议 |
原因 |
|
分区列 |
选择时间列或有明确范围的列 |
便于数据生命周期管理和分区裁剪 |
|
分桶列 |
选择高基数 + 查询高频 + 分布均匀的列 |
兼顾数据均匀和查询优化 |
|
分桶数 |
单个 Tablet 1GB-3GB 为宜 |
太少并发度低,太多元数据开销大 |
分桶策略选择
Doris 支持 Hash 分桶和 Random 分桶,选择时需权衡:
|
分桶方式 |
数据分布 |
分桶裁剪 |
特殊优化 |
|
Random |
均匀 |
❌ 永远无法裁剪 |
❌ 无法 Colocate / 本地去重 |
|
Hash(低基数列) |
倾斜严重 |
✅ 可裁剪但单桶过大 |
热点写入,并行度受限 |
|
Hash(高基数列) |
均匀 |
✅ 可裁剪 |
✅ Colocate Join / 本地去重 |
高基数 vs 低基数
基数(Cardinality) 指一列中唯一值的数量:
• 高基数:user_id、zg_id 等值几乎不重复,分布均匀
• 低基数:event_id、platform 等,值很少,容易倾斜
• 注意:event_id 虽然在某些应用有几千种,但热点事件(如 page_view)占 30%+ 数据,本质是低基数
案例:埋点事件表分桶选择
典型查询:统计某事件的日活/月活
SELECT COUNT(DISTINCT user_id) FROM events
WHERE day BETWEEN ... AND event_name = 'purchase'
|
分桶列 |
问题 |
结果 |
|
HASH(event_id) |
page_view 占 30% 数据 |
❌ 数据倾斜,单桶成瓶颈 |
|
Random |
分布均匀 |
⚠️ COUNT DISTINCT 需全局 Shuffle |
|
HASH(zg_id) ✅ |
分布均匀 + 高基数 |
✅ 本地去重,无需 Shuffle |
结论:埋点场景选 HASH(zg_id) 最优,兼顾分布均匀、本地去重、Colocate Join。
Colocate Join
如果两张表按相同的列、相同的分桶数分桶,并指定相同的 Colocate Group,则 Join 时数据无需 Shuffle。
建表示例:
-- 事件表
CREATE TABLE events (...)
DISTRIBUTED BY HASH(zg_id) BUCKETS 8
PROPERTIES ("colocate_with" = "user_group");
-- 用户表
CREATE TABLE users (...)
DISTRIBUTED BY HASH(zg_id) BUCKETS 8
PROPERTIES ("colocate_with" = "user_group");
Join 对比:
|
Join 方式 |
网络开销 |
说明 |
|
Shuffle Join |
T(左表) + T(右表) |
两表都要按 Join 列重新分发 |
|
Colocate Join |
0 |
数据本地 Join,相同 zg_id一定在同一 BE |
Colocate 使用条件:
• 相同分桶列(都是 HASH(zg_id))
• 相同分桶数(都是 8 个桶)
• 相同 Colocate Group(colocate_with = 同一个组名)
• Random 分桶无法使用 Colocate Join
1.4 表模型与写入原理
Doris 支持三种表模型,核心原理:数据都是追加写入,不会原地更新。
Duplicate(明细模型)
数据原样追加存储,不去重不聚合。写入最快,存储占用最大。
-- Duplicate Key 仅排序,加速范围查询
CREATE TABLE logs (
    timestamp DATETIME,
    user_id INT,
    action STRING
) DUPLICATE KEY(timestamp)
DISTRIBUTED BY HASH(user_id);
Aggregate(聚合模型)
相同 Key 按聚合函数合并(SUM/MAX/MIN 等)。存储最省,但无法查明细。
-- Aggregate Key 排序 + 聚合,pv 自动求和
CREATE TABLE pv_stats (
    date DATE,
    page STRING,
    pv BIGINT SUM,
    uv BIGINT REPLACE
) AGGREGATE KEY(date, page)
DISTRIBUTED BY HASH(page);
Unique(唯一模型)
支持主键更新,有两种实现:
- MoR:查询时排序去重,写快读慢
- MoW(2.0 默认):写入时 Bitmap 标记旧版本,查询时 O(1) 跳过,写稍微慢读快
-- Unique Key 排序 + 去重,相同 user_id 保留最新
CREATE TABLE users (
    user_id INT,
    name STRING,
    age INT
) UNIQUE KEY(user_id)
DISTRIBUTED BY HASH(user_id)
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true"  -- 开启 MoW,默认已开启
);
key对比
|
Key 类型 |
作用 |
说明 |
|
Duplicate Key |
仅排序 |
数据按 Key 排序存储,加速范围查询,不去重 |
|
Aggregate Key |
排序 + 聚合 |
相同 Key 的数据按聚合函数合并 |
|
Unique Key |
排序 + 去重 |
相同 Key 只保留最新一条 |
三种模型对比
|
模型 |
写入行为 |
查询行为 |
适用场景 |
|
Duplicate |
直接追加 |
直接返回 |
日志、明细数据 |
|
Aggregate |
Memtable 预聚合 |
Merge-On-Read 聚合 |
指标汇总、PV/UV |
|
Unique MoR |
追加,保留所有版本 |
排序去重取最新 |
写多读少 |
|
Unique MoW |
追加 + Delete Bitmap 标记 |
跳过标记行 |
写少读多 |
Delete Bitmap 原理示例:
Delete Bitmap 本质是一个bit数组,每个rowset对应一个bigmap,第 N 位表示第 N 行是否被删除,查询时按位检查跳过删除行。bitmap结构如下:
Bitmap 本质是一个 bit 数组,每个 bit 对应一行数据:

Rowset1 有 5 行数据:
┌─────────────────────────────────────┐
│ row0: user_id=1, value=A            │
│ row1: user_id=2, value=X            │
│ row2: user_id=3, value=Y            │
│ row3: user_id=4, value=Z            │
│ row4: user_id=5, value=W            │
└─────────────────────────────────────┘

对应的 Delete Bitmap (每行 1 bit):
┌───┬───┬───┬───┬───┐
│ 0 │ 1 │ 2 │ 3 │ 4 │  ← 行号
├───┼───┼───┼───┼───┤
│ 1 │ 0 │ 0 │ 1 │ 0 │  ← 0=有效, 1=已删除
└───┴───┴───┴───┴───┘

表示: row0 和 row3 被删除

初始状态 - 第一次写入:
═══════════════════════════════════════════════════════
Rowset1: [row0: id=1,v=A] [row1: id=2,v=X] [row2: id=3,v=Y]
Bitmap1: [    0         ] [    0         ] [    0         ]
         (有效)           (有效)           (有效)


第二次写入 - 更新 id=1 和 id=3:
═══════════════════════════════════════════════════════
Rowset1: [row0: id=1,v=A] [row1: id=2,v=X] [row2: id=3,v=Y]
Bitmap1: [    1         ] [    0         ] [    1         ]  ← 标记旧版本
         (删除)           (有效)           (删除)

Rowset2: [row0: id=1,v=B] [row1: id=3,v=Z]  ← 新版本
Bitmap2: [    0         ] [    0         ]
         (有效)           (有效)


查询时:
═══════════════════════════════════════════════════════
扫描 Rowset1:
  row0 → Bitmap1[0]=1 → 跳过
  row1 → Bitmap1[1]=0 → 返回 (id=2, v=X)
  row2 → Bitmap1[2]=1 → 跳过

扫描 Rowset2:
  row0 → Bitmap2[0]=0 → 返回 (id=1, v=B)
  row1 → Bitmap2[1]=0 → 返回 (id=3, v=Z)

最终结果: [(1,B), (2,X), (3,Z)]
二、streamload写入原理
Stream Load 通过 HTTP 协议将本地文件或数据流导入 Doris,是同步导入方式,保证原子性:要么全部成功,要么全部失败。适合 10GB 以下文件导入。
2.1 导入基础流程
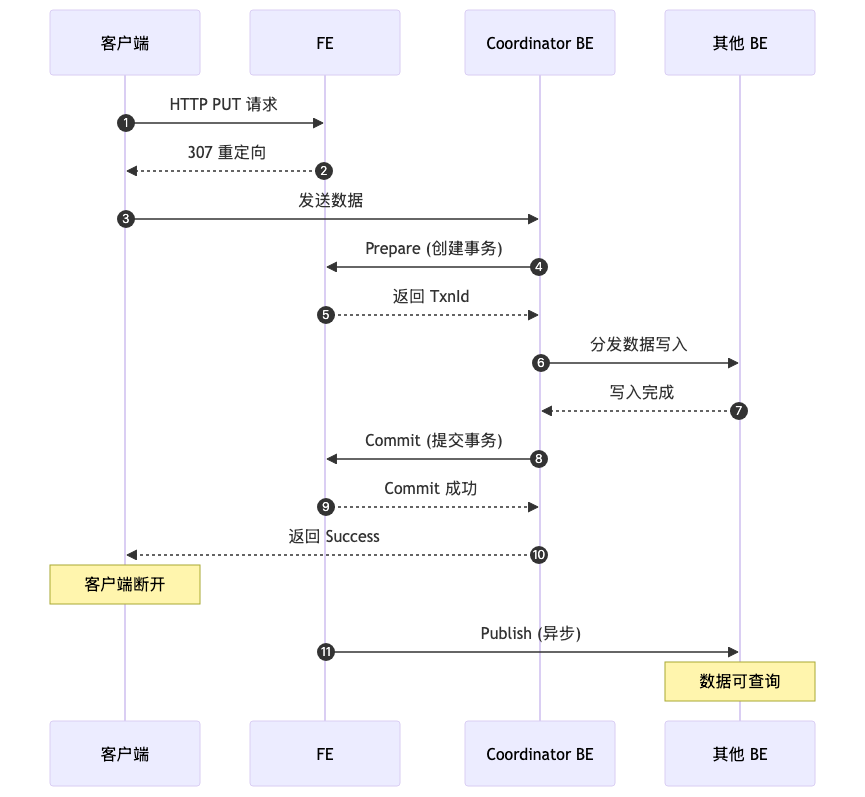
- Client 向 FE 提交 Stream Load 导入作业请求
- FE 会轮询选择一台 BE 作为 Coordinator 节点,负责导入作业调度,然后返回给 Client 一个 HTTP 重定向
- Client 连接 Coordinator BE 节点,提交导入请求
- Coordinator BE 会分发数据给相应 BE 节点,导入完成后会返回导入结果给 Client
- Client 也可以直接通过指定 BE 节点作为 Coordinator,直接分发导入作业
2.2 事务机制(2PC)
Stream Load 采用两阶段提交(2PC)保证原子性:
|
阶段 |
核心动作 |
失败处理 |
|
Prepare |
创建事务,为每个 Tablet 创建 DeltaWriter |
回滚事务 |
|
写入 |
按分桶列分发数据,写入 Memtable,刷盘成 Segment |
超半数副本失败则回滚 |
|
Commit |
创建 Rowset,提交事务,返回客户端成功 |
回滚事务 |
|
Publish |
异步标记 Rowset 可见,数据可查 |
重试直到成功 |
关键点:
- Prepare + 写入:对应 2PC 的第一阶段,数据写入但未提交
- Commit:对应 2PC 的第二阶段,协调者确认所有参与者都准备好后提交
- Publish:Doris 特有,异步让数据可见,不影响事务一致性
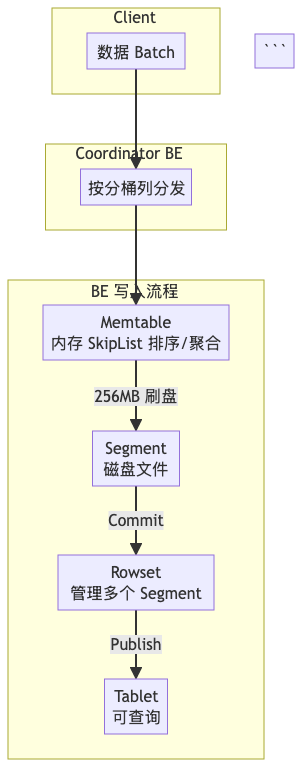
2.3 BE写入细节
|
组件 |
说明 |
|
Memtable |
内存中的 SkipList 结构,负责排序;Aggregate 模型会预聚合,Duplicate 模型仅排序 |
|
Segment |
Memtable 达到 256MB 后刷盘生成的有序文件 |
|
Rowset |
一次导入产生的所有 Segment 集合,Commit 时创建 |
|
Tablet |
数据分片,Publish 后 Rowset 加入 Tablet,数据可查询 |
2.4 写入调优
针对高频导入场景,可通过以下参数优化写入性能:
FE 配置(fe.conf)
|
参数 |
建议值 |
说明 |
|
enable_single_replica_load |
true |
单副本导入,数据只写一个副本,其他副本通过 Clone 同步,减少写入压力 |
|
enable_round_robin_create_tablet |
true |
轮询方式创建 Tablet,使 Tablet 在 BE 间分布更均匀 |
|
tablet_rebalancer_type |
partition |
按分区粒度进行 Tablet 均衡,比默认的 BeLoad 策略更精细 |
|
max_running_txn_num_per_db |
10000 |
单 DB 最大并发事务数,高频导入时需调大 |
|
streaming_label_keep_max_second |
300 |
StreamLoad Label 保留时间(秒),减少 FE 内存占用 |
|
label_clean_interval_second |
300 |
Label 清理间隔(秒),配合上面参数加速清理 |
BE 配置(be.conf)
|
参数 |
建议值 |
说明 |
|
write_buffer_size |
1073741824 |
Memtable 大小(1GB),增大可减少 Flush 次数 |
|
max_tablet_version_num |
20000 |
单 Tablet 最大版本数,防止高频写入触发限流 |
|
max_cumu_compaction_threads |
CPU 核数一半 |
Cumulative Compaction 线程数,加速版本合并 |
|
enable_single_replica_load |
true |
BE 侧单副本导入开关,需与 FE 配合开启 |
|
streaming_load_json_max_mb |
250 |
StreamLoad JSON 格式单次最大数据量(MB) |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献1条内容

所有评论(0)