数据结构 跳表讲解
一. 跳表的定义
跳表,又叫做跳跃表、跳跃列表,在有序链表的基础上增加了“跳跃”的功能
跳表在原来的有序链表上加上了多级索引,通过索引来快速查找;可以支持快速的删除、插入和查找操作。
跳表实际上是一种增加了前向指针的链表,是一种随机化的数据结构
Redis中 的 SortedSet、LevelDB 中的 MemTable 都用到了跳表
对比平衡树, 跳表的实现和维护会更加简单, 跳表的搜索、删除、添加的平均时间复杂度是 O(logn)
二. 跳表的数据结构图型
使用跳表优化链表
对于一个单链表来讲,即使链表中存储的数据是有序的,如果我们想要在其中查找某个数据,也只能从头开到尾的遍历,查询效率低,时间复杂度是O(n)。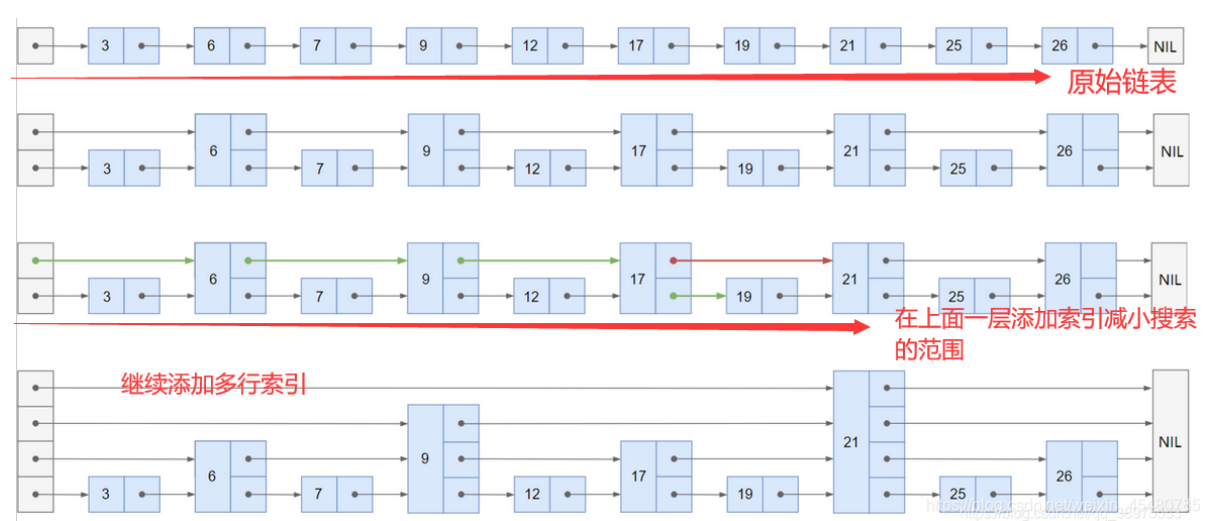
三. 跳表的搜索
跳表查找任意数据的时间复杂度为O(logn)
从顶层链表的首元素开始,从左往右搜索,直至找到一个大于或等于目标的元素,或者到达当前层链表的尾部
如果该元素等于目标元素,则表明该元素已被找到
如果该元素大于目标元素或已到达链表的尾部,则退回到当前层的前一个元素,然后转入下一层进行搜索
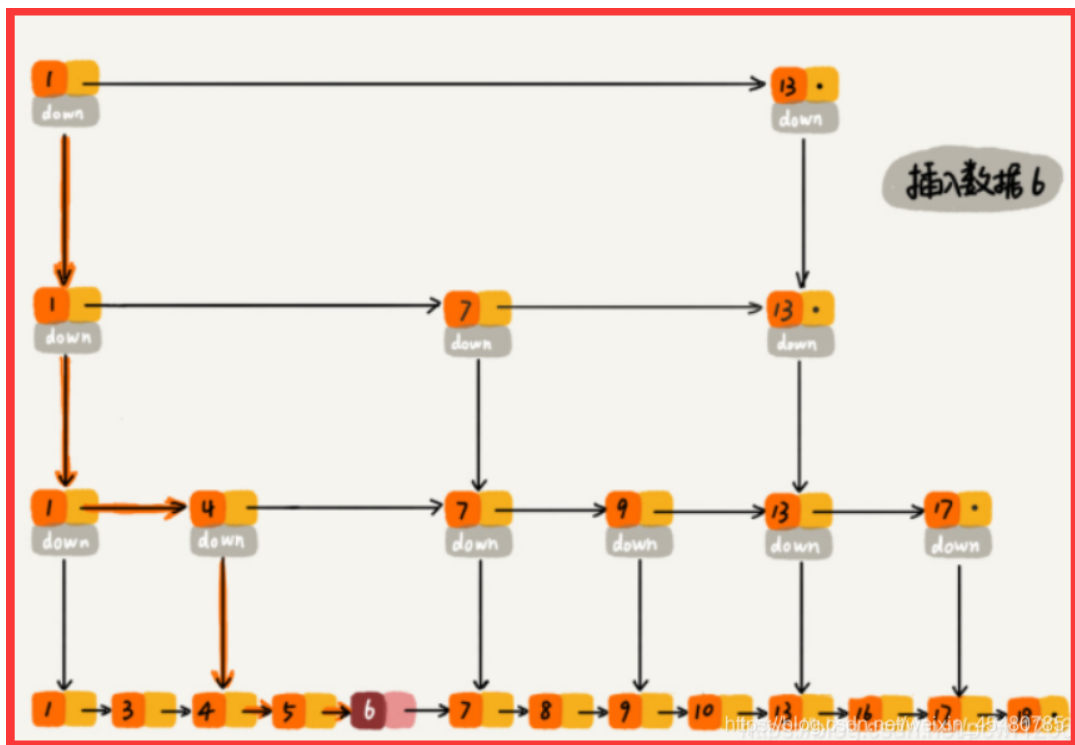
四. 跳表的插入
跳表插入的时间复杂度为:O(logn),支持高效的动态插入。
五. 跳表的删除
跳表的删除操作时间复杂度为:O(logn),支持动态的删除。
在跳表中删除某个结点时,如果这个结点在索引中也出现了,我们除了要删除原始链表中的结点,还要删除索引中的。因为单链表中的删除操作需要拿到删除结点的前驱结点,然后再通过指针操作完成删除。所以在查找要删除的结点的时候,一定要获取前驱结点(双向链表除外)。因此跳表的删除操作时间复杂度即为O(logn)。
六. 跳表索引动态更新
当我们不断地往跳表中插入数据时,我们如果不更新索引,就有可能出现某2个索引节点之间的数据非常多的情况,在极端情况下,跳表还会退化成单链表
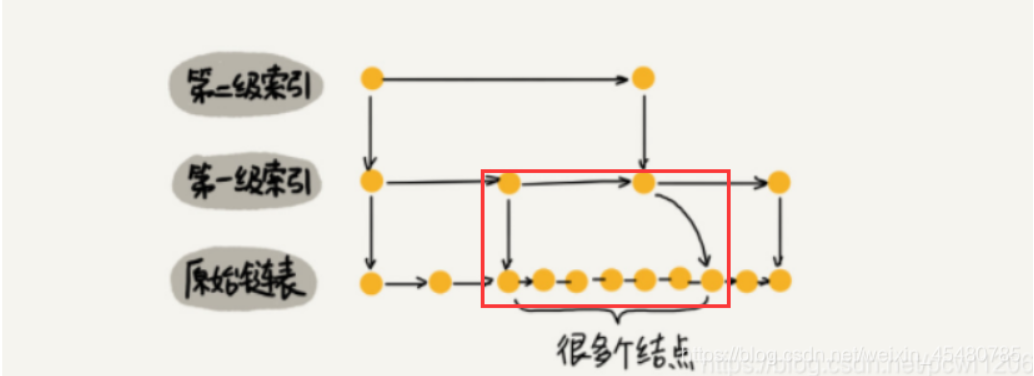
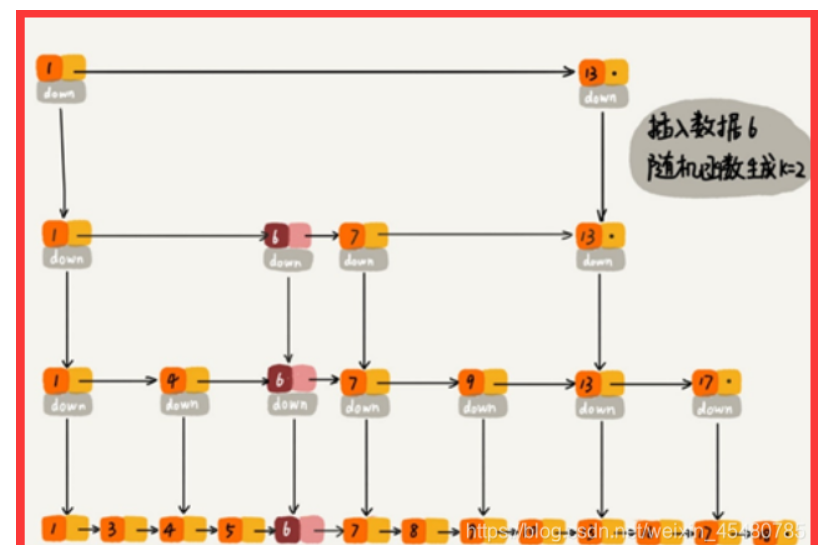
跳表是通过随机函数来维护“平衡性”。
当我们在跳表中插入数据的时候,我们通过选择同时将这个数据插入到部分索引层中,如何选择索引层,可以通过一个随机函数来决定这个节点插入到哪几级索引中,比如随机生成了k,那么就将这个索引加入到,第一级到第k级索引中。
深入理解:随机 vs 固定分配的维护开销差异
核心差异
| 方面 | 固定分配方案 | 随机方案 |
|---|---|---|
| 插入时间复杂度 | O(n) - 需要重建 | O(log n) - 局部更新 |
| 删除时间复杂度 | O(n) - 需要重建 | O(log n) - 局部更新 |
| 并发性 | 需要全局锁 | 支持无锁编程 |
| 实现复杂度 | 复杂,需要维护位置信息 | 简单,每个节点独立 |
| 内存开销 | 需要额外存储位置信息 | 只需要存储自己的层级 |
| 弹性 | 严格,一次插入影响全局 | 灵活,一次插入只影响局部 |
七. 跳表的性质
-
每个节点物理上只存在一个,但逻辑上出现在多个层
-
forward数组:forward[i]指向同一层的下一个节点,不是下一层! -
层数表示:节点的
level=2表示它出现在第0、1、2层 -
查找过程:同一层横向移动,然后降一层继续
-
头节点:总是有最大层数(MAX_LEVEL),确保可以从任何层开始查找
跳表由很多层结构组成,level是通过一定的概率随机产生的;
每一层都是一个有序的链表,默认是升序 ;
最底层(Level 1)的链表包含所有元素;
如果一个元素出现在Level i 的链表中,则它在Level i 之下的链表也都会出现;
每个节点包含两个指针,一个指向同一链表中的下一个元素,一个指向下面一层的元素。
八.跳表的性能分析
时间复杂度(平均情况):
| 操作 | 时间复杂度 | 说明 |
|---|---|---|
| 查找 | O(log n) | 平均情况,最坏 O(n) |
| 插入 | O(log n) | 需要先查找位置 |
| 删除 | O(log n) | 需要先查找位置 |
| 空间复杂度 | O(n log n) | 但实际通常远小于 n² |
与平衡树的对比:
| 特性 | 跳表 | 红黑树 | AVL树 |
|---|---|---|---|
| 实现难度 | 简单 | 复杂 | 复杂 |
| 查找性能 | O(log n) | O(log n) | O(log n) |
| 插入性能 | O(log n) | O(log n) | O(log n) |
| 删除性能 | O(log n) | O(log n) | O(log n) |
| 范围查询 | 方便 | 需要中序遍历 | 需要中序遍历 |
| 并发友好 | 较高 | 较低 | 较低 |
跳表的优缺点
优点:
-
实现简单:相比红黑树、AVL树等平衡树简单得多
-
性能优秀:平均 O(log n) 的时间复杂度
-
支持范围查询:可以高效查找范围内的所有元素
-
并发友好:相比平衡树更容易实现并发控制
-
空间效率:比平衡树节省内存(无需平衡因子等额外信息)
缺点:
-
概率性:性能不是绝对保证的,最坏情况可能退化到 O(n)
-
缓存不友好:节点分散在内存中,可能影响缓存局部性
-
内存开销:每个节点需要存储多个指针
跳表特别适合以下场景:
-
需要有序且频繁查找的数据
-
并发环境下的数据结构
-
内存数据库的索引结构
-
替代平衡树的简单方案
九.代码(c/c++)
#include<stdio.h>
#include<iostream>
#include<assert.h>
#include<stdlib.h>
#include<time.h>
using namespace std;
#define max 16
typedef struct skipnode {
	int val;
	int level;
	struct skipnode** nextarr;
}node;

typedef struct skiplist {
	node* head;
	int max_level;
	int cursize;
}skiplist;
// 1.初始化
skiplist* init_skiplist(skiplist* list) {
	assert(list != nullptr);
	list->head = (node*)malloc(sizeof(node));
	if (list->head == nullptr) {
		cout << "init err" << endl;
		return nullptr;
	}
	list->cursize = 0;
	list->max_level = 0;
	list->head->level = max;
	list->head->val = -1;
	list->head->nextarr = (node**)calloc(max+1,sizeof(node*));
	if (list->head->nextarr == nullptr) {
		cout << "init err" << endl;
		free(list->head);
		return nullptr;
	}
	for (int i = 0; i <= max; i++) {
		list->head->nextarr[i] = nullptr;
	}
	static int seed_initialized = 0;
	if (!seed_initialized) {
		srand((unsigned int)time(NULL));
		seed_initialized = 1;
	}
	return list;
}

// 2.创建节点
node* buynode(int value, int level){
	node* pnode = (node*)malloc(sizeof(node));
	if (pnode == nullptr) {
		cout << "buynode err" << endl;
		return nullptr;
	}
	pnode->level = level;
	pnode->val = value;
	pnode->nextarr = (node**)calloc(level + 1, sizeof(node*));
	if (pnode->nextarr == nullptr) {
		cout << "init err" << endl;
		free(pnode);
		return nullptr;
	}
	for (int i = 0; i <= level; i++) {
		pnode->nextarr[i] = nullptr;
	}
	return pnode;
}

// 3.生成随机层数(决定新节点的层数)
int random_level() {
	int level = 1;
	while ((rand() % 2 == 0) && level < max) {
		level++;
	}
	return level;
}

// 4.判断跳表是否为空
int isempty(skiplist* list) {
	assert(list != nullptr);
	return list->cursize == 0;
}

// 5.获取跳表中节点数量
int getsize(skiplist* list) {
	assert(list != nullptr);
	return list->cursize;
}

// 6.获取跳表当前最大层数
int getmaxlevel(skiplist* list) {
	assert(list != nullptr);
	return list->max_level;
}

// 7.查找值为value的节点,返回节点指针
node* search(skiplist* list, int value) {
	assert(list != nullptr);
	if (isempty(list))return nullptr;
	node* p = list->head;
	for (int i = list->max_level; i >= 0; i--) {
		while (p->nextarr[i] && p->nextarr[i]->val < value) {
			p = p->nextarr[i];
		}
		if (p->nextarr[i] && p->nextarr[i]->val == value) return p->nextarr[i];
	}
	return nullptr;
}

// 8.插入新值到跳表中
void insert(skiplist* list, int value) {
	assert(list != nullptr);
	node* update[max + 1];
	for (int i = 0; i < max + 1; i++)update[i] = list->head;
	node* p = list->head;
	for (int i = list->max_level; i >= 0; i--) {
		while (p->nextarr[i] && p->nextarr[i]->val < value) {
			p = p->nextarr[i];
		}
		update[i] = p;
	}
	if (p->nextarr[0] && p->nextarr[0]->val == value)  return;

	int new_level = random_level();
	if (list->max_level < new_level) {
		for (int i = list->max_level + 1; i <= new_level; i++) {
			update[i] = list->head;
		}
		list->max_level = new_level;
	}
	node* newnode = buynode(value, new_level);
	if (newnode == nullptr)return;
	for (int i = 0; i <= new_level; i++) {
		newnode->nextarr[i] = update[i]->nextarr[i];
		update[i]->nextarr[i] = newnode;
	}
	list->cursize++;
	cout << value << "插入成功在第" << new_level << "层" << endl;
}

// 9.从跳表中删除值为value的节点,返回是否删除成功
int deleteval(skiplist* list, int value) {
	assert(list != nullptr);
	if (isempty(list))return 0;
	node* update[max + 1];
	for (int i = 0; i < max + 1; i++)update[i] = list->head;
	node* p = list->head;
	for (int i = list->max_level; i >= 0; i--) {
		while (p->nextarr[i] && p->nextarr[i]->val < value) {
			p = p->nextarr[i];
		}
		update[i] = p;
	}
    if(!p->nextarr[0])return 0;
	if (p->nextarr[0] && p->nextarr[0]->val != value)  return 0;
	p = p->nextarr[0];
	for (int i = 0; i <= p->level; i++) {
		if (update[i]->nextarr[i] != p) {
			break;
		}
		update[i]->nextarr[i] = p->nextarr[i];
	}
	while (list->max_level > 0 && list->head->nextarr[list->max_level] == nullptr) {
		list->max_level--;
	}
	free(p->nextarr);
	free(p);
	list->cursize--;
	cout << value <<"删除成功" << endl;
	return 1;
}

// 10.打印跳表的完整结构(按行显示各层)
void print_skip_list(skiplist* list) {
	assert(list != nullptr);
	if (isempty(list))return;
	cout << "共" << list->max_level << "层," << list->cursize << "个元素" << endl;
	for (int i = list->max_level; i >= 0; i--) {
		node* level0_node = list->head->nextarr[0];
		node* pnode = list->head->nextarr[i];
		while (level0_node) {
			if (pnode && pnode->val == level0_node->val) {
				printf("%4d", pnode->val);
				pnode = pnode->nextarr[i];
			}
			else cout << "----";
			level0_node = level0_node->nextarr[0];
		}cout << endl;
	}
}

// 11.按层打印跳表(每层单独显示)
void print_by_level(skiplist* list) {
	assert(list != nullptr);
	if (isempty(list))return;
	for (int i = list->max_level; i >= 0; i--) {
		printf("Level %2d: ", i);
		node* pnode = list->head->nextarr[i];
		int count = 0;
		while (pnode) {
			cout << pnode->val;
			pnode = pnode->nextarr[i];
			if (pnode) cout<<"->";
			count++;
		}
		if (count == 0)cout << "NULL";
		cout << endl;
	}
}

// 12.释放整个跳表内存
void free_skiplist(skiplist* list) {
	assert(list != nullptr);
	node* current = list->head->nextarr[0];
	while (current) {
		node* temp = current;
		current = current->nextarr[0];
		free(temp->nextarr);
		free(temp);
	}
	if (list->head) {
		free(list->head->nextarr);
		free(list->head);
	}
	cout << "已释放" << endl;
}
int main() {

	return 0;
}
总结
跳表是一种优雅而实用的数据结构,它通过简单的多层索引机制,实现了对数时间复杂度的操作。虽然它不像平衡树那样提供严格的理论保证,但在实际应用中表现优异,被许多知名系统(如 Redis、LevelDB)采用。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 23
 0
- 0


 已为社区贡献8条内容

所有评论(0)