TPAMI 2025 | StructVPR++:分割引导知识蒸馏,单阶段视觉定位实现精度效率双突破
点击上方“小白学视觉”,选择加"星标"或“置顶”
重磅干货,第一时间送达
在自动驾驶和机器人导航领域,视觉场所识别(VPR)始终是一项极具挑战性的任务。当面对季节更替、光照变化、视角偏移等复杂环境干扰时,传统方法往往在识别精度和实时性之间难以平衡。近期发表于TPAMI 2025的研究论文《StructVPR++: Distill Structural and Semantic Knowledge with Weighting Samples for Visual Place Recognition》提出了一种创新性框架,通过融合结构与语义知识,成功将全局检索性能提升5%-23%,甚至超越了许多两阶段方法。
论文信息
题目:StructVPR++: Distill Structural and Semantic Knowledge with Weighting Samples for Visual Place Recognition
基于样本加权的结构与语义知识蒸馏的视觉定位识别方法StructVPR++
作者:Yanqing Shen, Sanping Zhou, Jingwen Fu, Ruotong Wang, Shitao Chen, Nanning Zheng
视觉定位的核心困境:为何现有方法难以兼顾精度与效率?
现有VPR技术通常采用"全局检索+局部重排序"的两阶段策略:先用全局特征快速筛选候选图像,再通过局部特征精细匹配。然而这种模式存在明显短板:
全局特征缺乏缺乏足够语义信息,易受环境变化干扰
局部重排序虽能利用结构信息提升精度,但耗时严重,难以满足实时需求
不同模态数据(如RGB图像与分割图)的信息难以有效融合
论文通过对比实验揭示:RGB图像擅长捕捉视角变化,而分割(SEG)图像在应对光照和季节变化时表现更优。二者的互补性为解决上述困境提供了新思路(图1)。
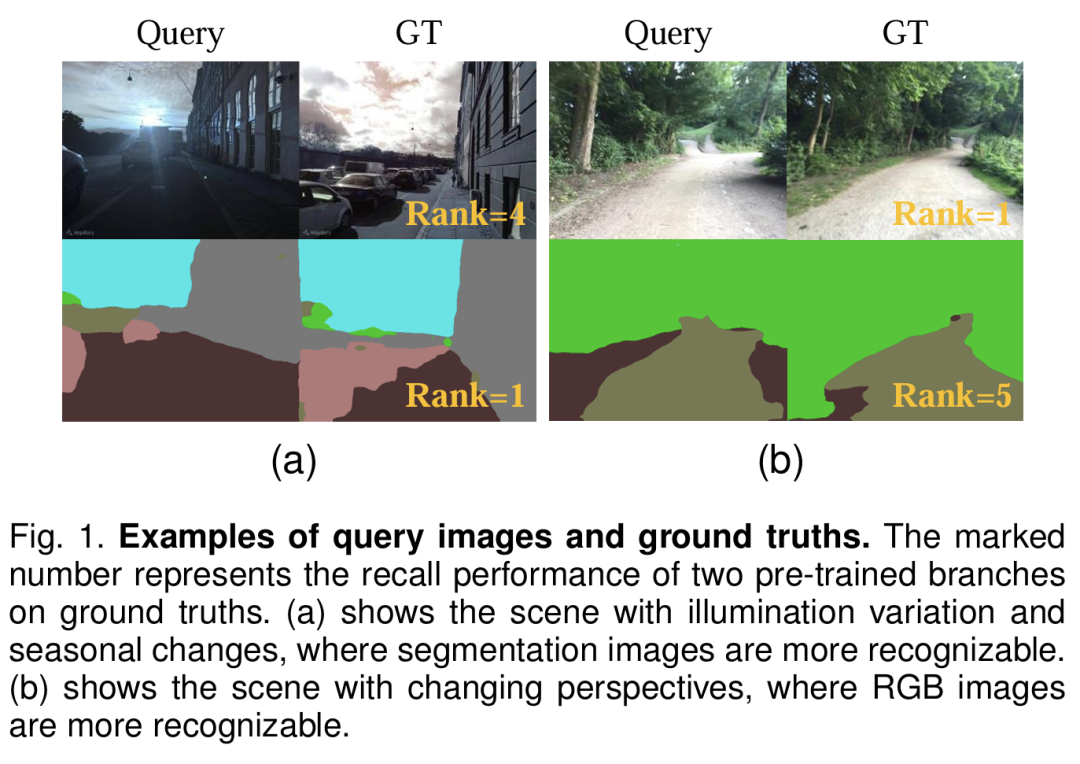 图1:RGB图像(上)与分割图像(下)在不同环境变化下的表现对比
StructVPR++框架:知识蒸馏如何赋能单阶段识别?
StructVPR++的核心创新在于提出了"分割引导的知识蒸馏"框架,将分割图像中的结构与语义知识转移到RGB特征中,实现了单阶段模型的性能跃升。其整体架构分为两个训练阶段(图3):
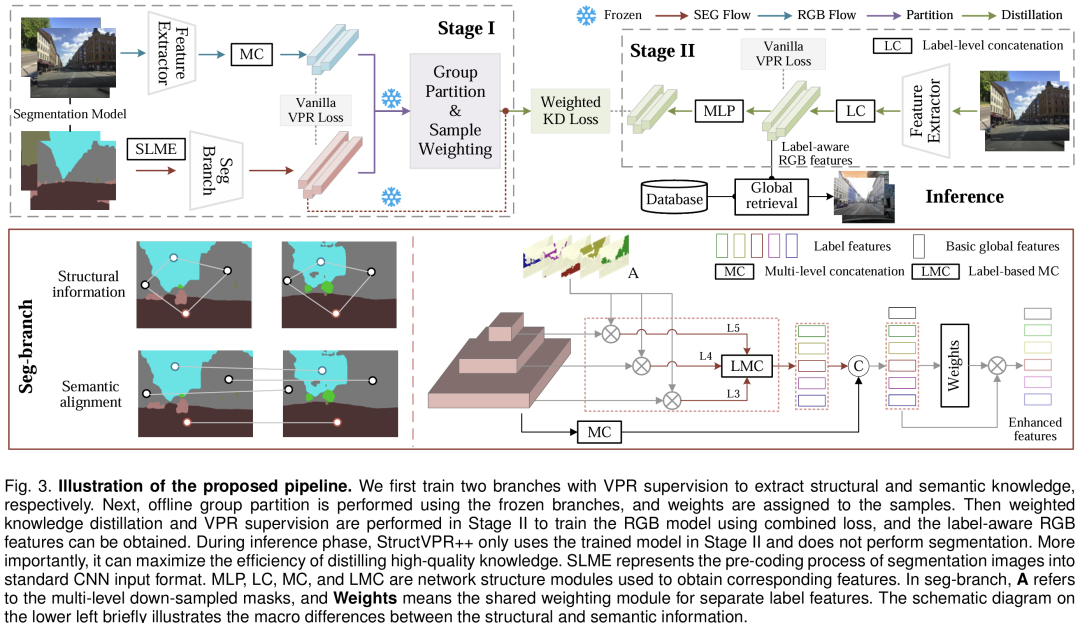 图3:StructVPR++的两阶段训练流程与推理过程
第一阶段:结构知识提取与样本分组
分割标签图编码(SLME):将分割图像转换为可输入神经网络的张量格式,通过三步处理优化语义信息:
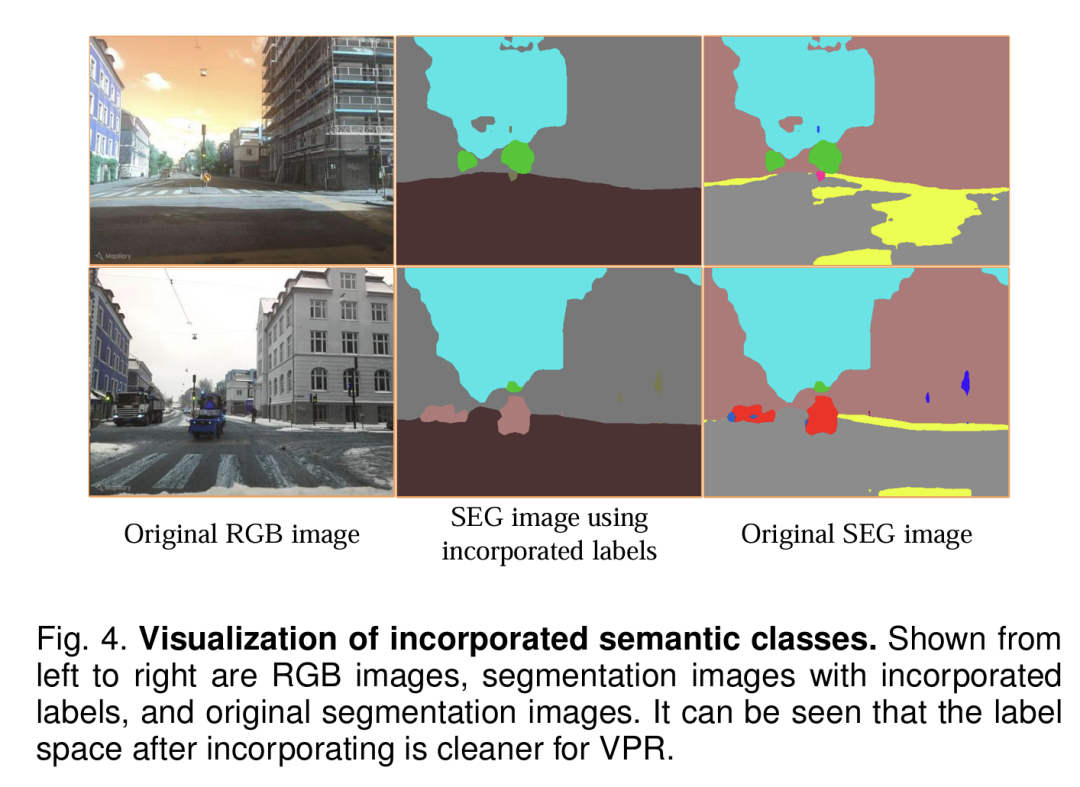 图4:SLME模块对分割图像的编码过程
格式化:将语义类别编码为C×H×W的独热张量
合并:将150个细分类别合并为5个粗分类别(植被、天空、地面、建筑物、其他物体)
加权:为不同类别分配权重(如建筑物权重2,植被权重0.5),突出稳定结构
双分支特征提取:
RGB分支:采用MobileNetV2提取多级特征,通过全局最大池化和特征连接生成基本全局特征
SEG分支:使用轻量化网络,创新性地将特征分解为基本全局特征和加权标签特征,实现语义对齐
样本分组策略:基于双分支的检索性能,将样本分为四类:
D1:SEG分支表现好而RGB分支差(最具蒸馏价值)
D2:两者表现均好
D3:RGB分支表现优于SEG分支
D4:SEG分支表现差(需排除)
第二阶段:加权知识蒸馏
标签感知RGB模型:在RGB特征提取器中新增标签特征生成模块,使模型能学习分割图像的语义结构
动态加权函数:根据样本质量动态调整蒸馏权重(图6),优先学习D1组样本的知识,抑制噪声样本影响
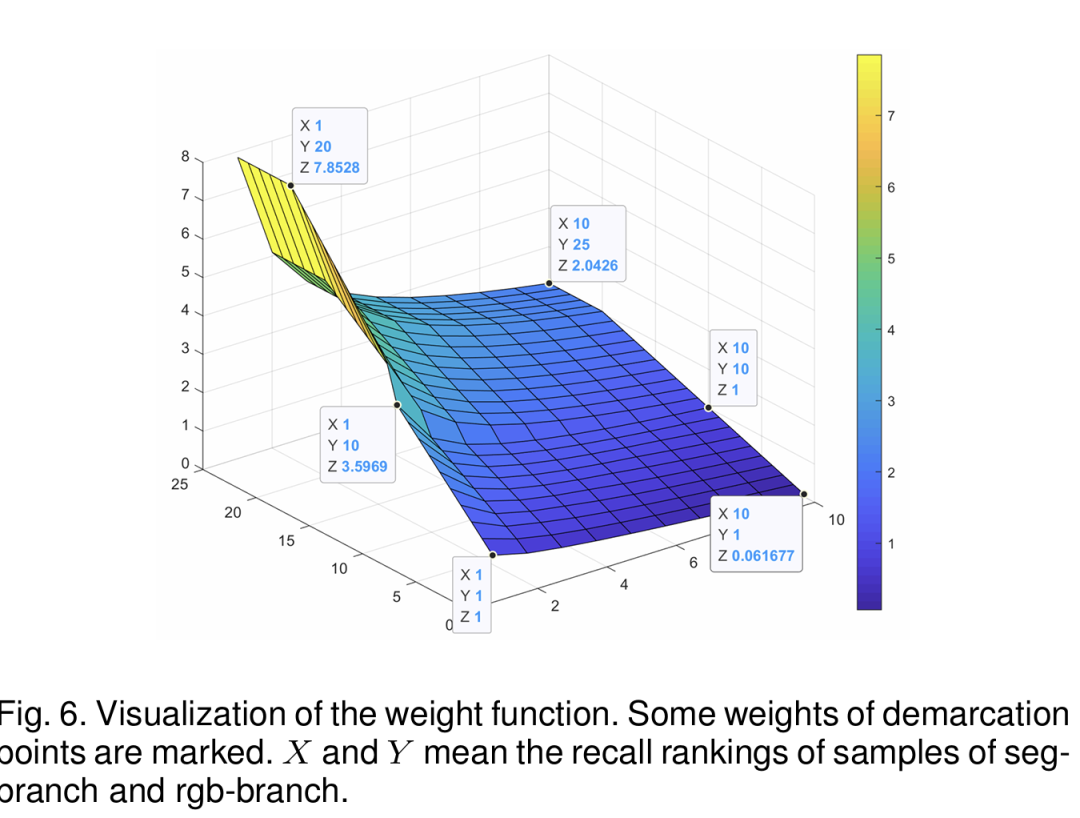 图6:样本加权函数设计,体现不同样本的贡献差异
联合优化:通过VPR损失和蒸馏损失的联合训练,使RGB模型同时学习外观特征和结构语义
关键创新点:如何实现性能突破?
标签特征解耦机制:将全局特征分解为基本特征和标签特征,解决了传统方法的语义对齐问题。实验表明,加权标签特征能使模型专注于场景中稳定的结构元素(表5)
样本加权蒸馏策略:通过量化师生网络的性能差距,设计动态权重函数。 ablation实验显示,该策略比固定权重提升3-5%的召回率(表8)
高效部署设计:训练阶段利用分割图像,推理阶段仅需RGB输入,避免在线分割的计算开销,实现实时性能
实验验证:四大数据集上的全面超越
在MSLS、Pittsburgh、Nordland等四个基准数据集上的实验表明:
相比最优全局方法,Recall@1指标提升5%-23%
性能超越多数两阶段方法,同时保持单阶段的高效性
在极端视角变化和遮挡场景中表现尤为突出(图2)
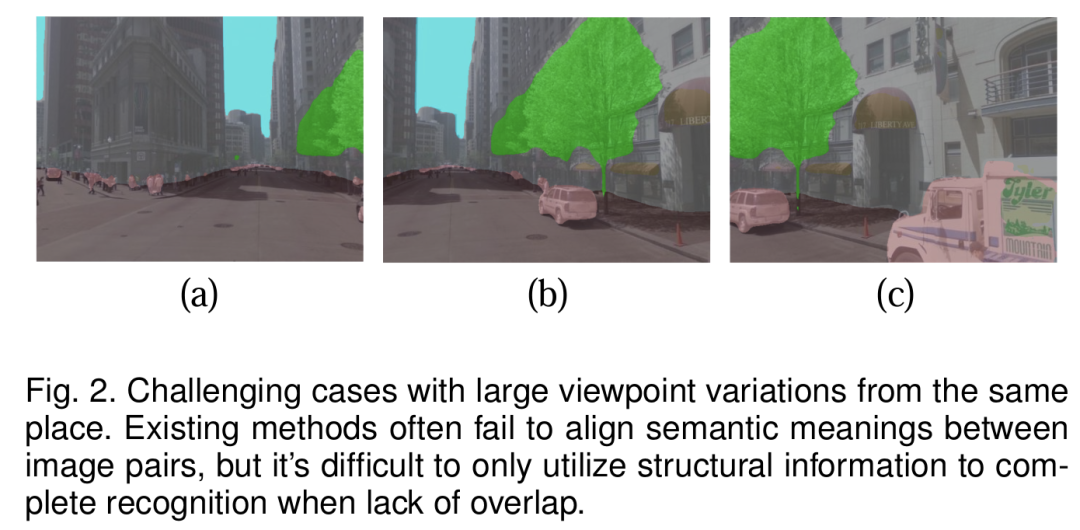 图2:StructVPR++在视角剧烈变化和遮挡情况下的识别效果
消融实验进一步验证了各组件的有效性:
分割图像的引入使性能提升8-12%
标签特征解耦机制贡献4-6%的性能提升
样本分组策略减少15-20%的噪声干扰
结语:重新定义视觉定位的精度-效率边界
StructVPR++通过创新性的知识蒸馏框架,成功将分割图像的结构语义知识融入RGB特征,在保持实时性的同时实现了识别精度的跨越式提升。这项研究不仅为视觉场所识别提供了新的技术范式,也为跨模态知识迁移在计算机视觉中的应用开辟了新路径。
未来,该方法有望应用于自动驾驶、机器人导航、增强现实等领域,特别是在复杂动态环境中实现更稳健的定位识别。
下载1:OpenCV-Contrib扩展模块中文版教程

在「小白学视觉」公众号后台回复:扩展模块中文教程,即可下载全网第一份OpenCV扩展模块教程中文版,涵盖扩展模块安装、SFM算法、立体视觉、目标跟踪、生物视觉、超分辨率处理等二十多章内容。


下载2:Python视觉实战项目52讲
在「小白学视觉」公众号后台回复:Python视觉实战项目,即可下载包括图像分割、口罩检测、车道线检测、车辆计数、添加眼线、车牌识别、字符识别、情绪检测、文本内容提取、面部识别等31个视觉实战项目,助力快速学校计算机视觉。


下载3:人工智能0基础学习攻略手册
在「小白学视觉」公众号后台回复:攻略手册,即可获取《从 0 入门人工智能学习攻略手册》文档,包含视频课件、习题、电子书、代码、数据等人工智能学习相关资源,可以下载离线学习。


交流群

欢迎加入公众号读者群一起和同行交流,目前有SLAM、三维视觉、传感器、自动驾驶、计算摄影、检测、分割、识别、医学影像、GAN、算法竞赛等微信群(以后会逐渐细分),请扫描下面微信号加群,备注:”昵称+学校/公司+研究方向“,例如:”张三 + 上海交大 + 视觉SLAM“。请按照格式备注,否则不予通过。添加成功后会根据研究方向邀请进入相关微信群。请勿在群内发送广告,否则会请出群,谢谢理解~

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献121条内容

所有评论(0)