dify在windows系统安装环境、dify中的检索方式
·
一、环境安装
windows系统:系统安装wsl、docker,在docker中安装dify、ragflow
dify在github下载地址:
https://github.com/langgenius/dify
线上版:要翻墙
https://cloud.dify.ai/
RRAGFlow下载地址:
https://www.github.com/infiniflow/RAGFlow
二、知识库检索
分类:全文检索、语义检索、混合检索三种方式:
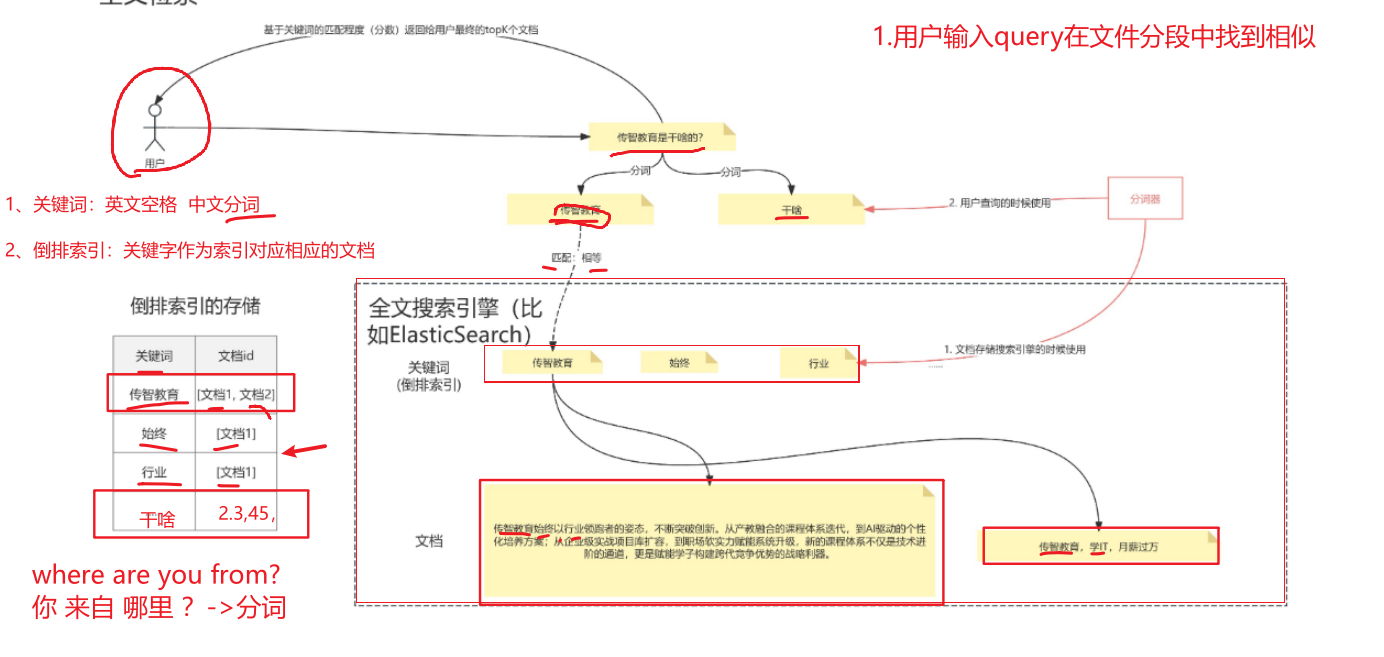
- 全文检索:基于关键词+倒排索引技术。
- 语义检索:基于向量+相似度计算。
- 混合检索:将全文检索和语义检索的结果进行汇总,再次排序,得到最终检索结果
2.1全文检索:目前搜索引擎常用的检索方式(速度快、节省资源)
1、索引构建:(对文本块处理)
关键词:中文通过分词工具获取有意义的词汇,英文通过空格切分有意义的词汇
倒排索引:
建立一个“倒排索引”。这就像一本书的索引表,记录每个词语出现在哪些文档中,以及出现的位置和频率
2、查询索引:(对用户输入处理)
查询处理:用户输入进行分词获取关键词
索引查找:在文档构建的索引表中,用户输入的关键词作为索引查找对应相应的文本块
相关性排序:
使用相关性排序算法(如 BM25)对结果进行评分排序,将最符合用户需求的文档排在前面
2.2 RAG(检索增强生成,Retrieval-Augmented Generation)
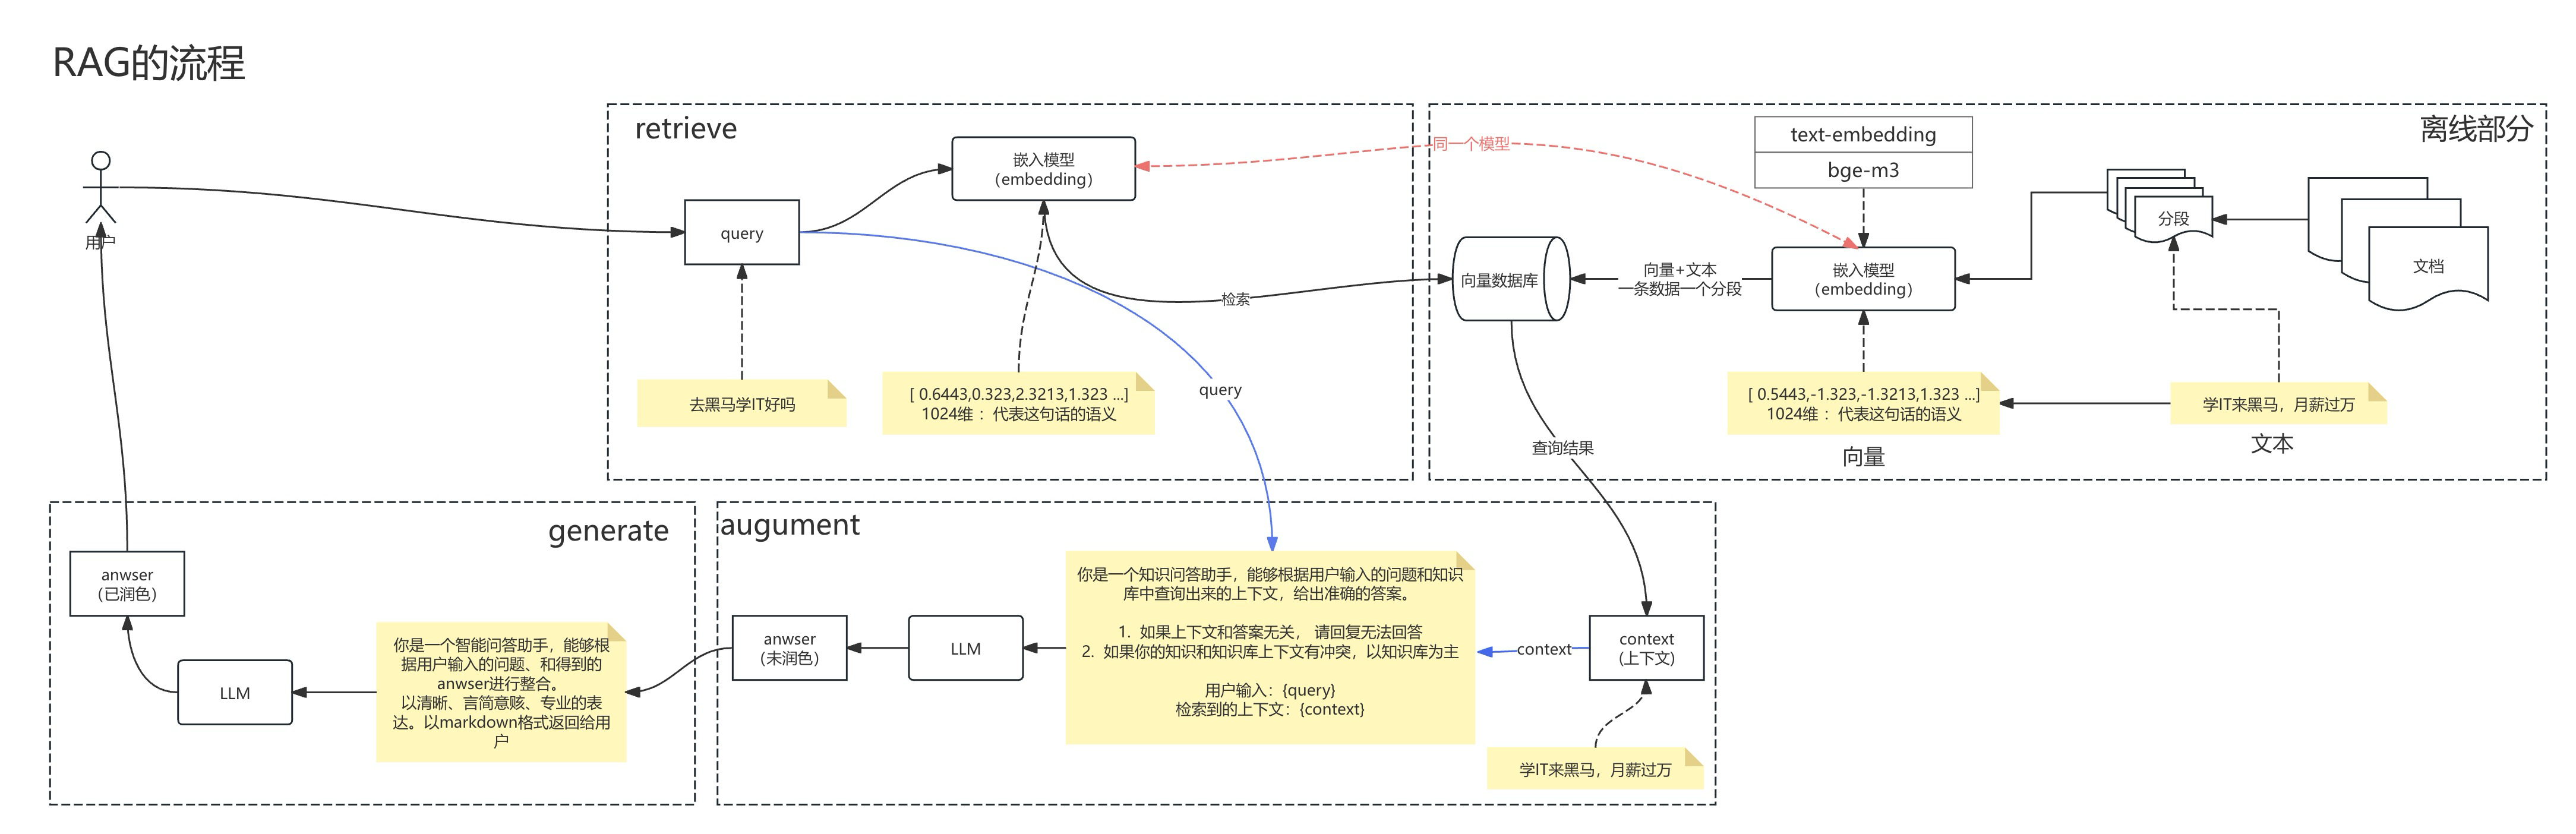
流程:
1、
检索(Retrieval)
离线处理将文本转换为向量表示并建立索引,用户原始问题嵌入向量进行相似度匹配
2、
增强(Augmentation)
将检索到的信息整合为上下文,与原始问题重构提示词,大模型进行回答
3、
生成(Generation)
大语言模型结合上下文与问题生成最终回答,润色过程
注意点:
1、文本区块和用户输入生成向量
必须使用同一个大模型
,本质是embedding大模型去除最后一层输出
2、求相似度:霍夫曼距离(相同维度相减绝对值求和)、
欧氏距离
(相同维度相减平方相加开根)
2.3混合检索
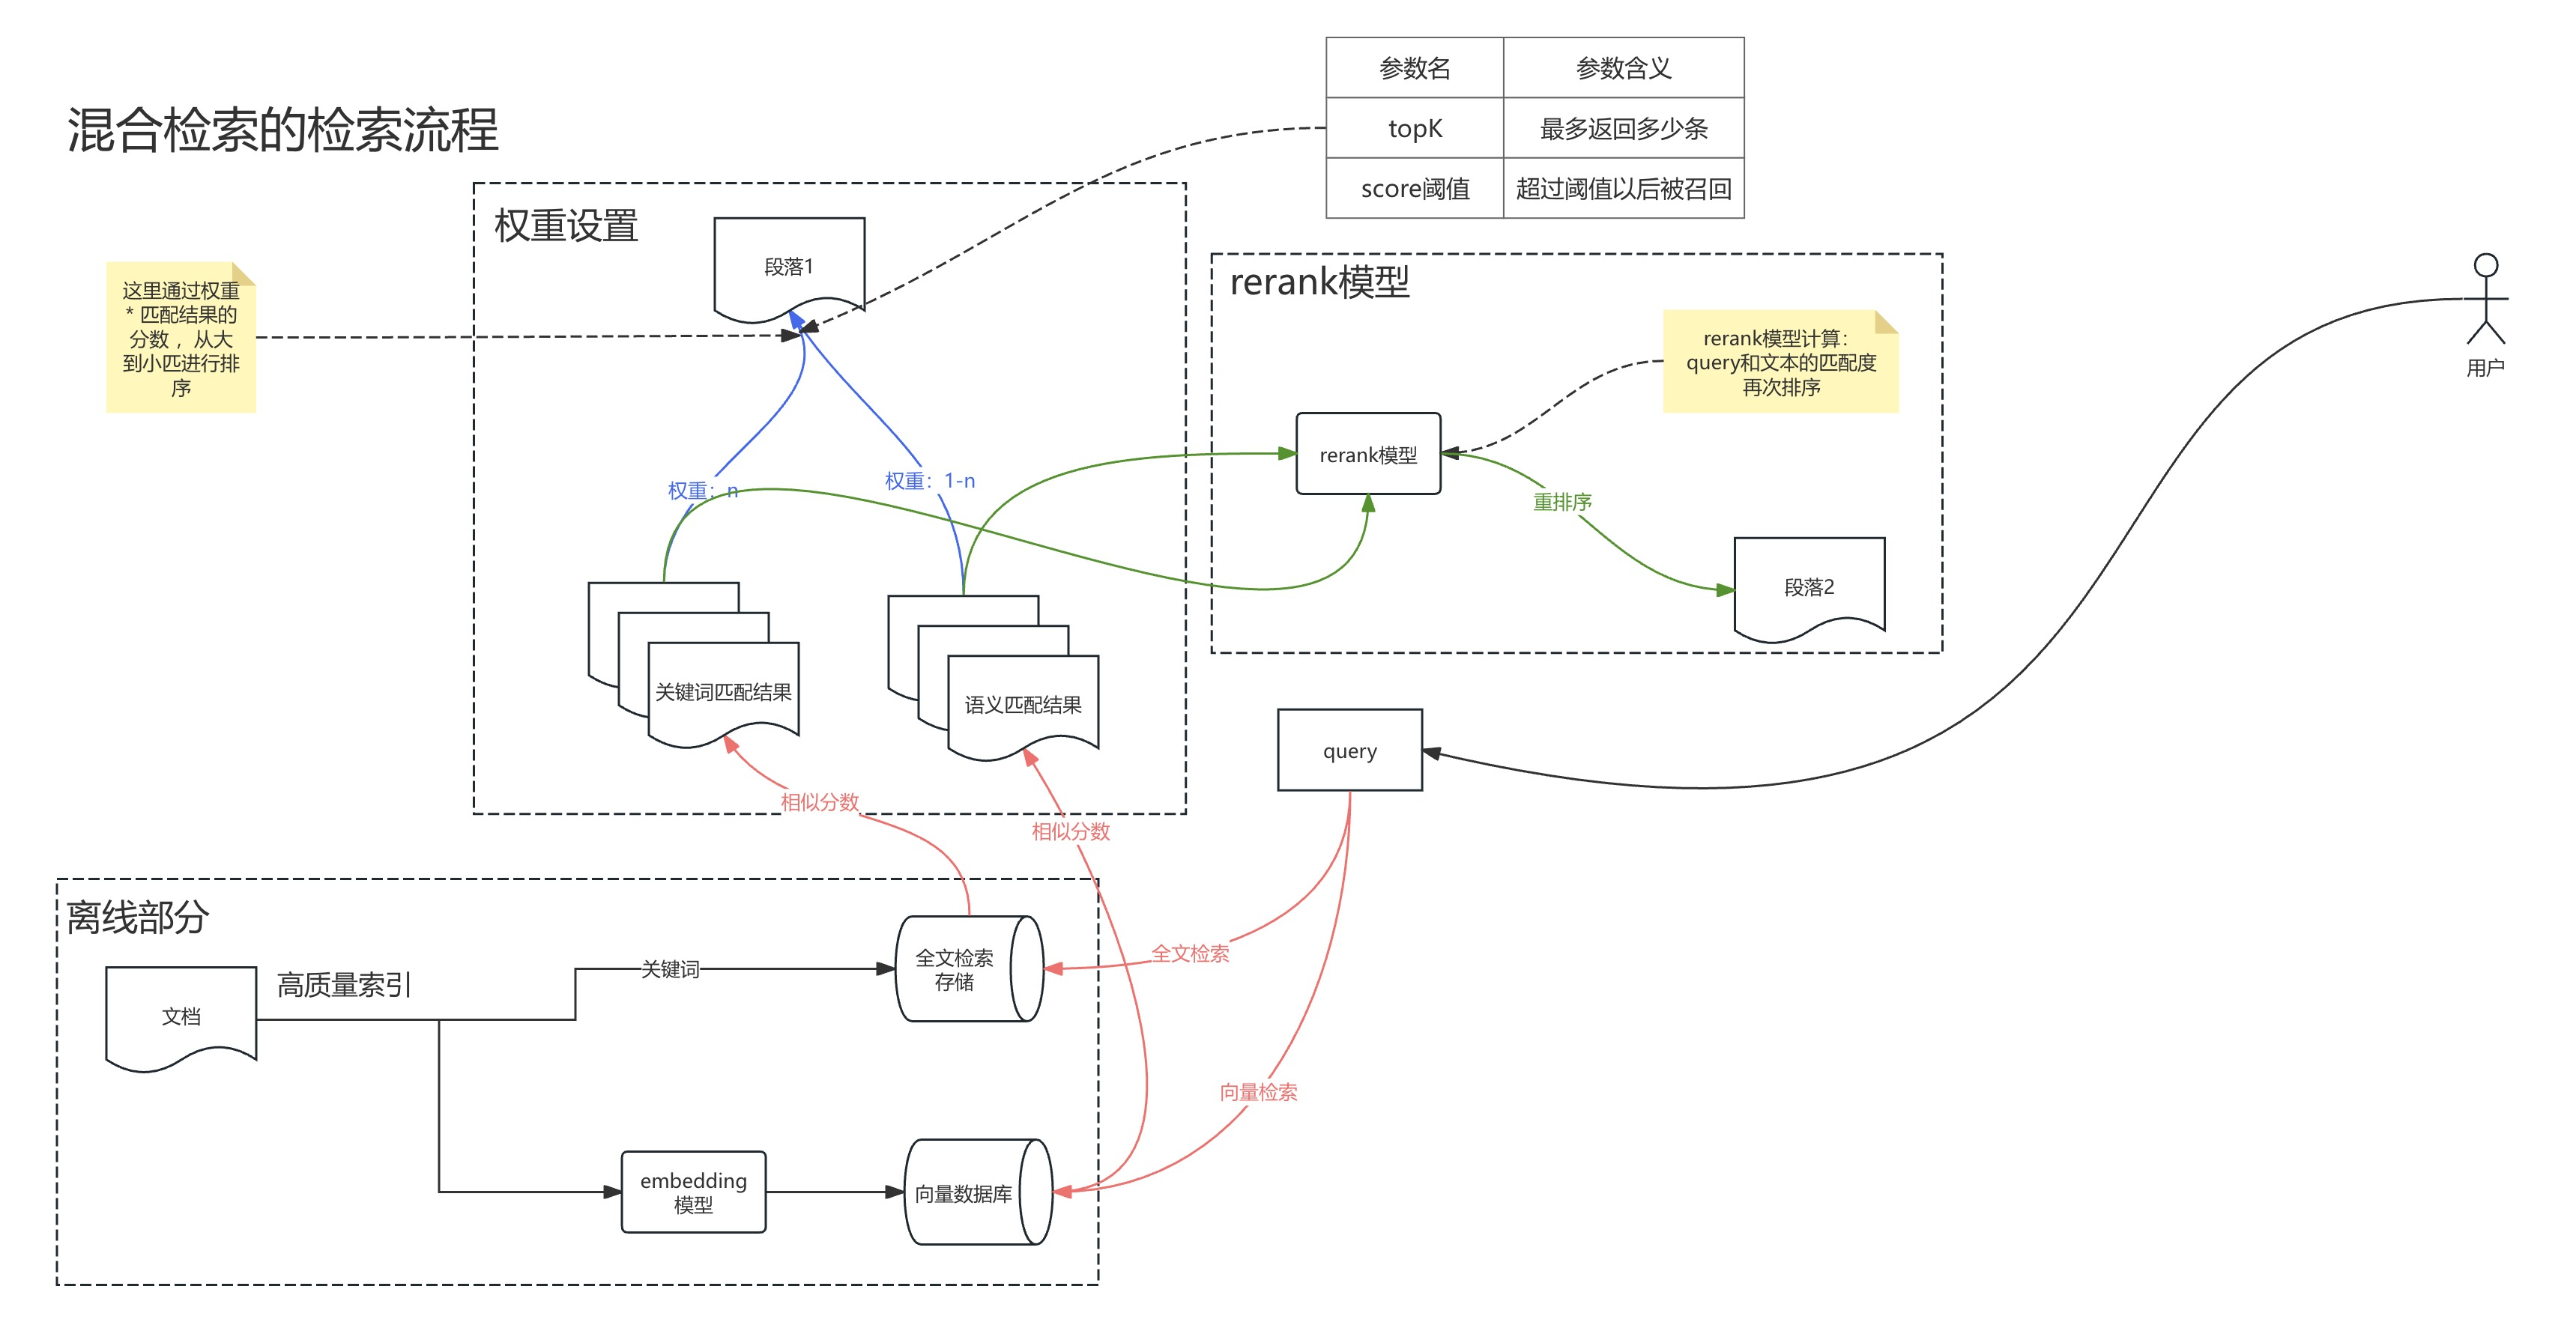
就是同时执行全文检索和向量检索,或 Rerank 模型,从查询结果中选择匹配用户问题的最佳结果。 混合的策略一般分两种:
• 权重:用户自己通过数值设定关键词和语义的比重,在进行一次排序
• rerank:通过rerank模型,把两种检索方法检索到的结果进行混合,再进行一次排序。
流程:用户输入问题-->全文检索和向量检索得到两组匹配结果-->根据权重计算综合匹配度,或rerank模型计算query和文本的匹配度再次排序-->设置topK和score阈值得到检索结果

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)