【小白笔记】二叉树的前序,中序,后序,层序遍历(递归与迭代)
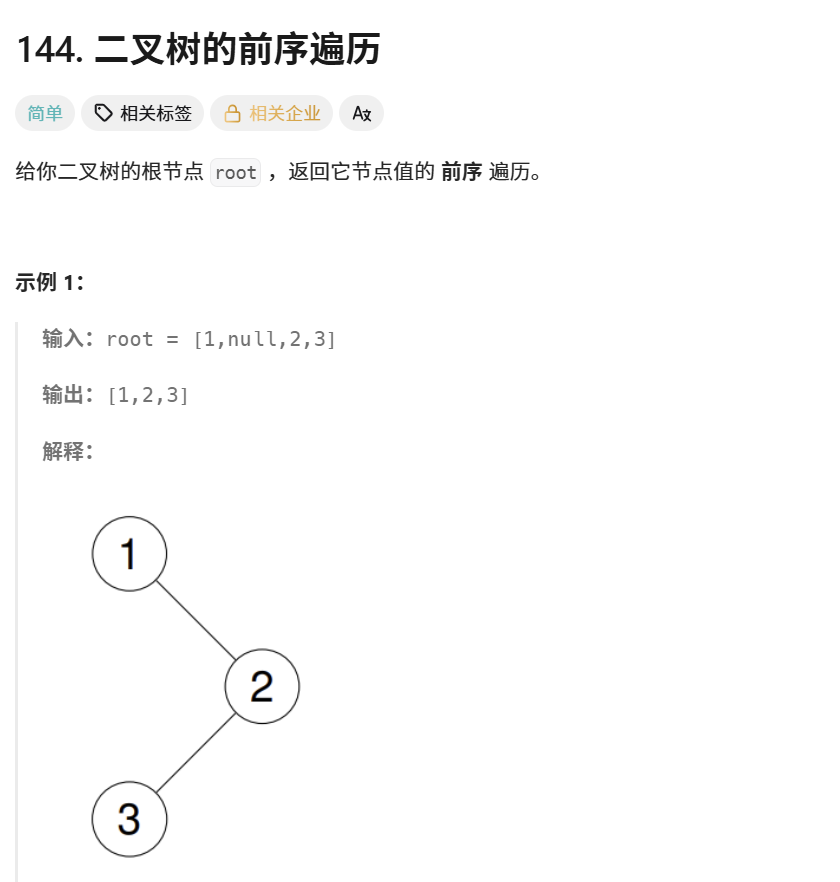
二叉树的遍历是树形结构中最基础的操作。所谓的**“前序遍历”**,其实是指“根节点”相对于左右子树的访问顺序。
1. 记住口诀:根 -> 左 -> 右
前序遍历(Pre-order Traversal)的逻辑非常固定:
- 首先访问 根节点 (Root)。
- 然后递归地访问 左子树 (Left)。
- 最后递归地访问 右子树 (Right)。
2. 解法一:递归法(最直观)
递归是最符合树定义的方法,因为树本身就是递归定义的。
class Solution:
    def preorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
        res = []

        def dfs(node):
            if not node:
                return

            # 1. 根:先记录当前节点的值
            res.append(node.val)
            # 2. 左:递归遍历左子树
            dfs(node.left)
            # 3. 右:递归遍历右子树
            dfs(node.right)

        dfs(root)
        return res
3. 解法二:迭代法(利用栈 Stack)
在面试中,面试官经常会问:“如果不让你用递归,你怎么实现?”
这时我们需要模拟递归的过程。递归本质上是利用了系统的调用栈,所以我们可以手动维护一个栈 (Stack)。
关键点: 栈是“后进先出”的。为了保证“先左后右”的访问顺序,我们在压栈时要先压右子树,再压左子树。
class Solution:
    def preorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
        if not root:
            return []

        stack = [root]
        res = []

        while stack:
            # 弹出栈顶节点(当前的“根”)
            node = stack.pop()
            res.append(node.val)

            # 先把右孩子放进去(后出)
            if node.right:
                stack.append(node.right)
            # 再把左孩子放进去(先出)
            if node.left:
                stack.append(node.left)

        return res
4. 总结与对比
- 前序遍历:根 -> 左 -> 右
- 中序遍历:左 -> 根 -> 右(145 题)
- 后序遍历:左 -> 右 -> 根(94 题)
为什么迭代法里要先压 right?
因为我们想要先处理 left。在栈结构里,最后放进去的东西会最先被弹出来。所以,先把右边的“存着”,处理完左边那一条线后,再回来处理右边。
复杂度分析
- 时间复杂度:O(n)O(n)O(n)。每个节点都被访问且仅访问一次。
- 空间复杂度:O(n)O(n)O(n)。最坏情况下(树呈链状),递归栈或手动栈的深度会达到 nnn。
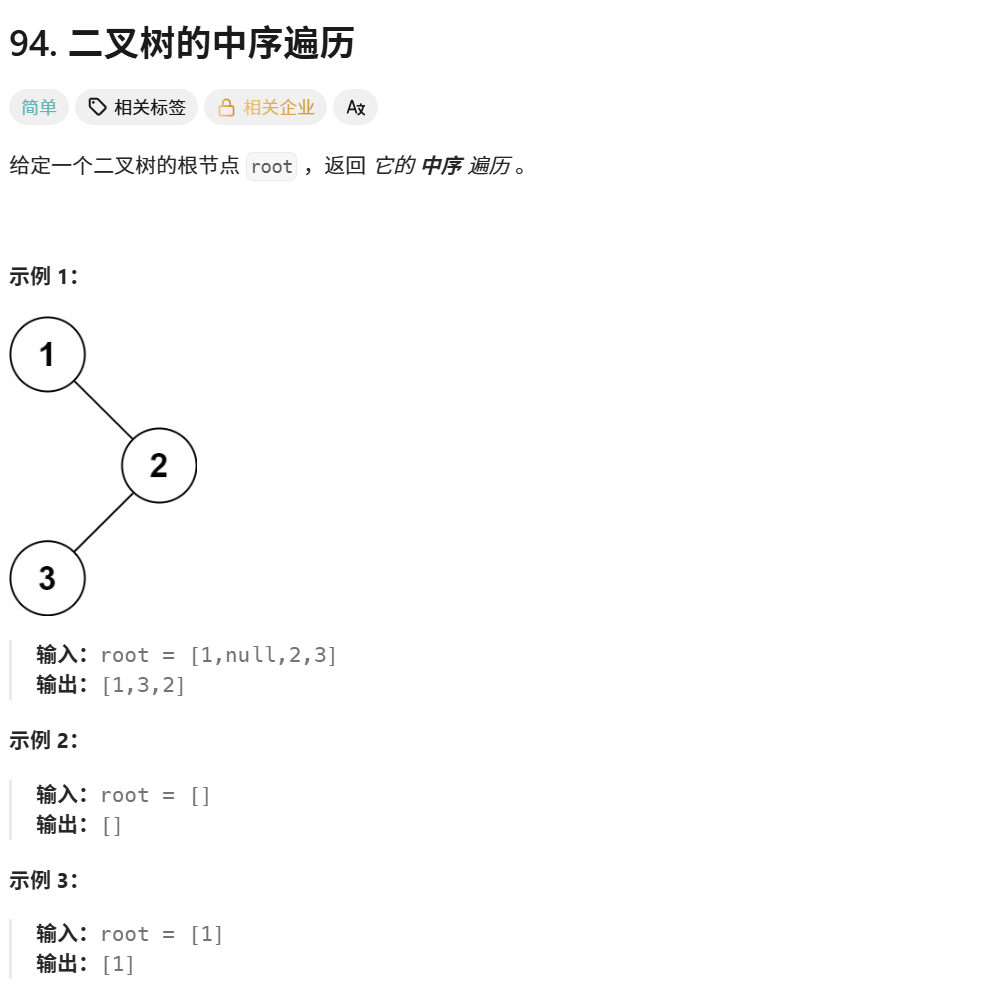
中序遍历(In-order Traversal)是二叉树最常用的遍历方式之一,特别是在**二叉搜索树(BST)**中,中序遍历的结果恰好是升序排列的。
1. 记住口诀:左 -> 根 -> 右
中序遍历的逻辑顺序是:
- 首先递归地访问 左子树 (Left)。
- 然后访问 根节点 (Root)。
- 最后递归地访问 右子树 (Right)。
2. 解法一:递归法(极其简单)
你只需要在“前序遍历”的基础上,把记录值的语句 res.append 挪到两次递归调用中间即可。
class Solution:
    def inorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
        res = []

        def dfs(node):
            if not node:
                return

            # 1. 左:一直往左走
            dfs(node.left)
            # 2. 根:走不动了再记录当前值
            res.append(node.val)
            # 3. 右:最后看右边
            dfs(node.right)

        dfs(root)
        return res
3. 解法二:迭代法(面试重点)
迭代法实现中序遍历比前序遍历稍微复杂一点,因为访问节点的顺序和处理节点的顺序是不一致的。我们需要先“潜入”到最左端的叶子节点。
逻辑:
- 一路向左:只要当前节点不为空,就把它压入栈,并继续往左走。
- 弹出并记录:左边走到底了,从栈中弹出一个节点(这就是当前的“根”),记录它的值。
- 转向右边:处理完根节点后,把指针指向它的右孩子,重复上述过程。
class Solution:
    def inorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
        res = []
        stack = []
        curr = root

        # curr 不为空或者栈不为空,就继续
        while curr or stack:
            # 步骤 1:一路向左扎到底
            while curr:
                stack.append(curr)
                curr = curr.left

            # 步骤 2:弹出栈顶元素(最左或最近的根)
            curr = stack.pop()
            res.append(curr.val)

            # 步骤 3:转向右子树
            curr = curr.right

        return res
4. 为什么中序遍历很重要?
- 排序属性:如果你对一棵“二叉搜索树”进行中序遍历,得到的结果一定是从小到大排好序的数组。
- 验证搜索树:判断一棵树是否是二叉搜索树(LeetCode 98),最简单的方法就是看它的中序遍历是否是递增的。
总结三种遍历的递归区别:
- 前序:
记录-> 左 -> 右(先看到根,再看子树) - 中序:左 ->
记录-> 右(先看完左边,回头看根,再看右边) - 后序:左 -> 右 ->
记录(最后才看根,常用于计算树的高度或删除树)
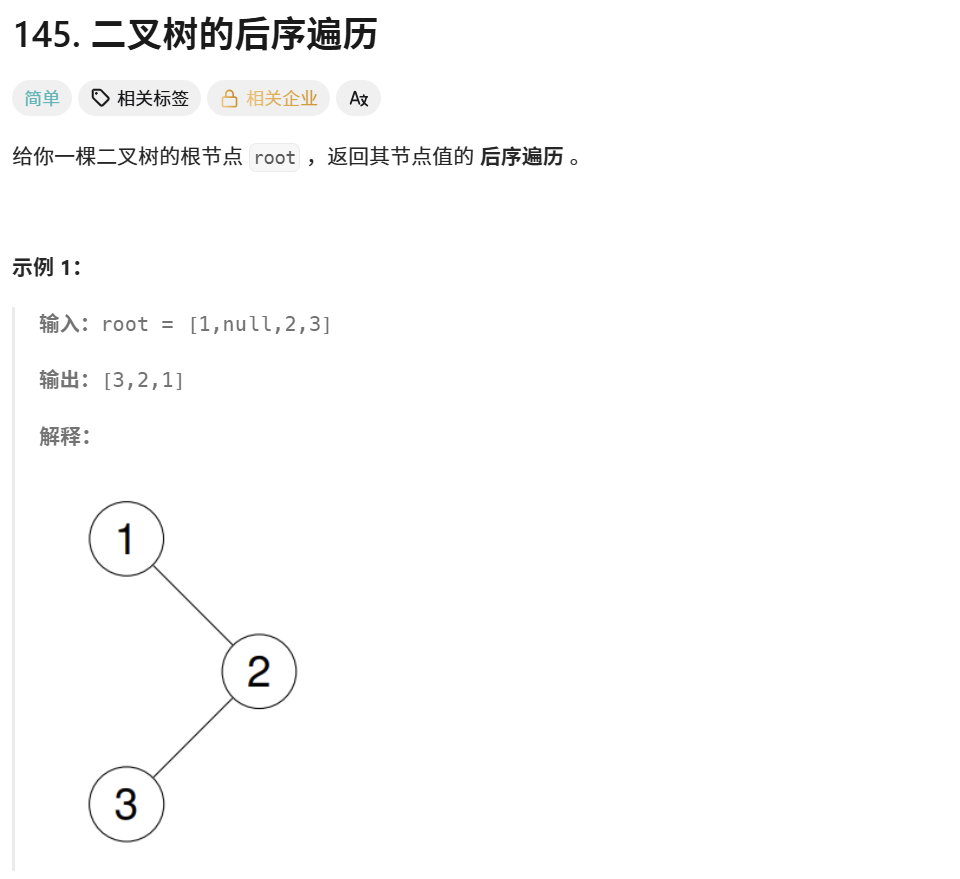
后序遍历(Post-order Traversal)是三种遍历中最“内敛”的一种。它的特点是:必须等左右子树全部处理完,才处理根节点。
1. 记住口诀:左 -> 右 -> 根
后序遍历的逻辑顺序是:
- 首先递归地访问 左子树 (Left)。
- 然后递归地访问 右子树 (Right)。
- 最后访问 根节点 (Root)。
2. 解法一:递归法
依然是那三行核心代码,只是顺序变了。它是计算树的高度(104题)或删除整棵树时的标准做法。
class Solution:
    def postorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
        res = []

        def dfs(node):
            if not node:
                return

            dfs(node.left)    # 1. 左
            dfs(node.right)   # 2. 右
            res.append(node.val) # 3. 根

        dfs(root)
        return res
3. 解法二:迭代法(“偷懒”镜像反转法)
后序遍历的迭代法如果正着写非常复杂,因为你需要判断右子树是否已经访问过。但有一个神级脑筋急转弯:
- 前序遍历 是:
根 -> 左 -> 右 - 如果我们稍微改下顺序,写成:
根 -> 右 -> 左 - 把这个结果 整体反转 (Reverse),就会得到:
左 -> 右 -> 根—— 这正是后序遍历!
class Solution:
    def postorderTraversal(self, root: Optional[TreeNode]) -> List[int]:
        if not root:
            return []

        stack = [root]
        res = []

        # 按照 根 -> 右 -> 左 的顺序入栈
        while stack:
            node = stack.pop()
            res.append(node.val)

            # 因为是栈,先压左,后压右,弹出来的就是先右后左
            if node.left:
                stack.append(node.left)
            if node.right:
                stack.append(node.right)

        # 最后把 [根, 右, 左] 反转成 [左, 右, 根]
        return res[::-1]
4. 为什么后序遍历很有用?
后序遍历体现了**“自底向上”**的思想。
- 计算树的高度:你需要知道左子树多高,右子树多高,然后取最大值加 1(根节点)。
- 计算子树节点和:你必须先算出左右两边的和,才能算出包含当前根的总和。
- 最近公共祖先 (LCA):通过后序遍历向上回溯信息。
三种遍历的直观总结
想象一棵树,你拿着一支笔沿着树的外围轮廓走一圈(从根左侧出发,绕一圈回到根右侧):
- 前序遍历:在经过节点的 左侧 时记录它。
- 中序遍历:在经过节点的 底部 时记录它。
- 后序遍历:在经过节点的 右侧 时记录它。
知识点大串联
到目前为止,我们已经横跨了三个大领域:
- 线性结构:链表(双指针、快慢指针)、数组(滑动窗口、原地翻转)。
- 数学模拟:大数加法(进位处理、补零逻辑)。
- 树形结构:二叉树(前中后序递归与迭代)。
发现**“栈 (Stack)”和“递归”**其实是双胞胎
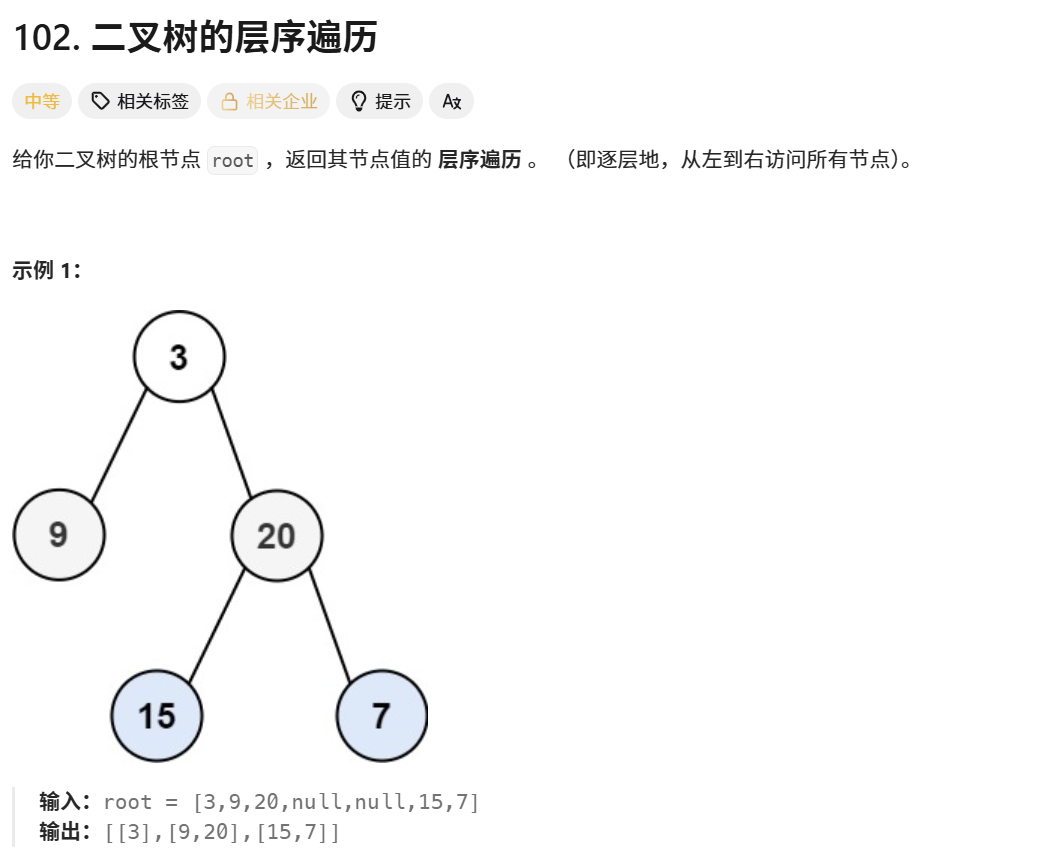
层序遍历(Level-order Traversal)与之前的前、中、后序遍历完全不同。前三种属于深度优先遍历(DFS),而层序遍历属于广度优先遍历(BFS)。
它像剥洋葱一样,从根节点开始,一层一层地由上到下、由左到右访问所有节点。
1. 核心工具:队列(Queue)
实现层序遍历的关键在于使用 “队列” 这种 先进先出(FIFO) 的数据结构:
- 入队:把根节点放进队列。
- 循环:只要队列不为空:
- 记录当前层的节点个数(确定这层有多少人)。
- 依次弹出这些节点。
- 把它们的左、右孩子(如果有)依次加入队列末尾。
2. 代码实现 (Python)
from collections import deque

class Solution:
    def levelOrder(self, root: Optional[TreeNode]) -> List[List[int]]:
        if not root:
            return []

        res = []
        # 使用 deque(双端队列),popleft() 的时间复杂度为 O(1)
        queue = deque([root])

        while queue:
            # 1. 确定当前层有多少个节点
            level_size = len(queue)
            current_level = []

            # 2. 连续处理 level_size 个节点,保证它们属于同一层
            for _ in range(level_size):
                node = queue.popleft()
                current_level.append(node.val)

                # 3. 将下一层的孩子节点加入队列
                if node.left:
                    queue.append(node.left)
                if node.right:
                    queue.append(node.right)

            # 4. 将这一层的结果加入大列表
            res.append(current_level)

        return res
3. 为什么需要 level_size = len(queue)?
这是层序遍历最关键的一步。
- 因为队列在不断地添加新节点(下一层的孩子),如果不提前固定当前层的数量,
while循环就会一直跑下去,你无法区分哪些节点属于第一层,哪些属于第二层。 - 通过
len(queue),我们给当前层画了一个“圈”,保证for循环只处理这一层的节点。
4. 复杂度分析
- 时间复杂度:O(N)O(N)O(N)。每个节点入队和出队各一次。
- 空间复杂度:O(N)O(N)O(N)。在最坏情况下(比如满二叉树),最后一层的节点数大约是 N/2N/2N/2,队列需要存储这些节点。
5. 常见变形题
层序遍历的模版非常强大,稍微改动就能解决很多问题:
- 二叉树的最大深度:层序遍历跑了多少个
while循环,深度就是多少。 - 二叉树的右视图:每一层
for循环结束时的最后一个节点,就是从右边看到的节点。 - 之字形遍历:根据层数的奇偶性,反转
current_level列表。
总结:DFS vs BFS
| 特性 | DFS (前中后序) | BFS (层序) |
|---|---|---|
| 数据结构 | 栈 (Stack) / 递归 | 队列 (Queue) |
| 特点 | 一条路走到黑,再回溯 | 稳扎稳打,层层推进 |
| 适用场景 | 路径搜索、找祖先、树结构更改 | 最短路径、层级统计 |

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献7条内容

所有评论(0)