阿里:多agent推荐系统RecGPT-V2
📖标题:RecGPT-V2 Technical Report
🌐来源:arXiv, 2512.14503
🌟摘要
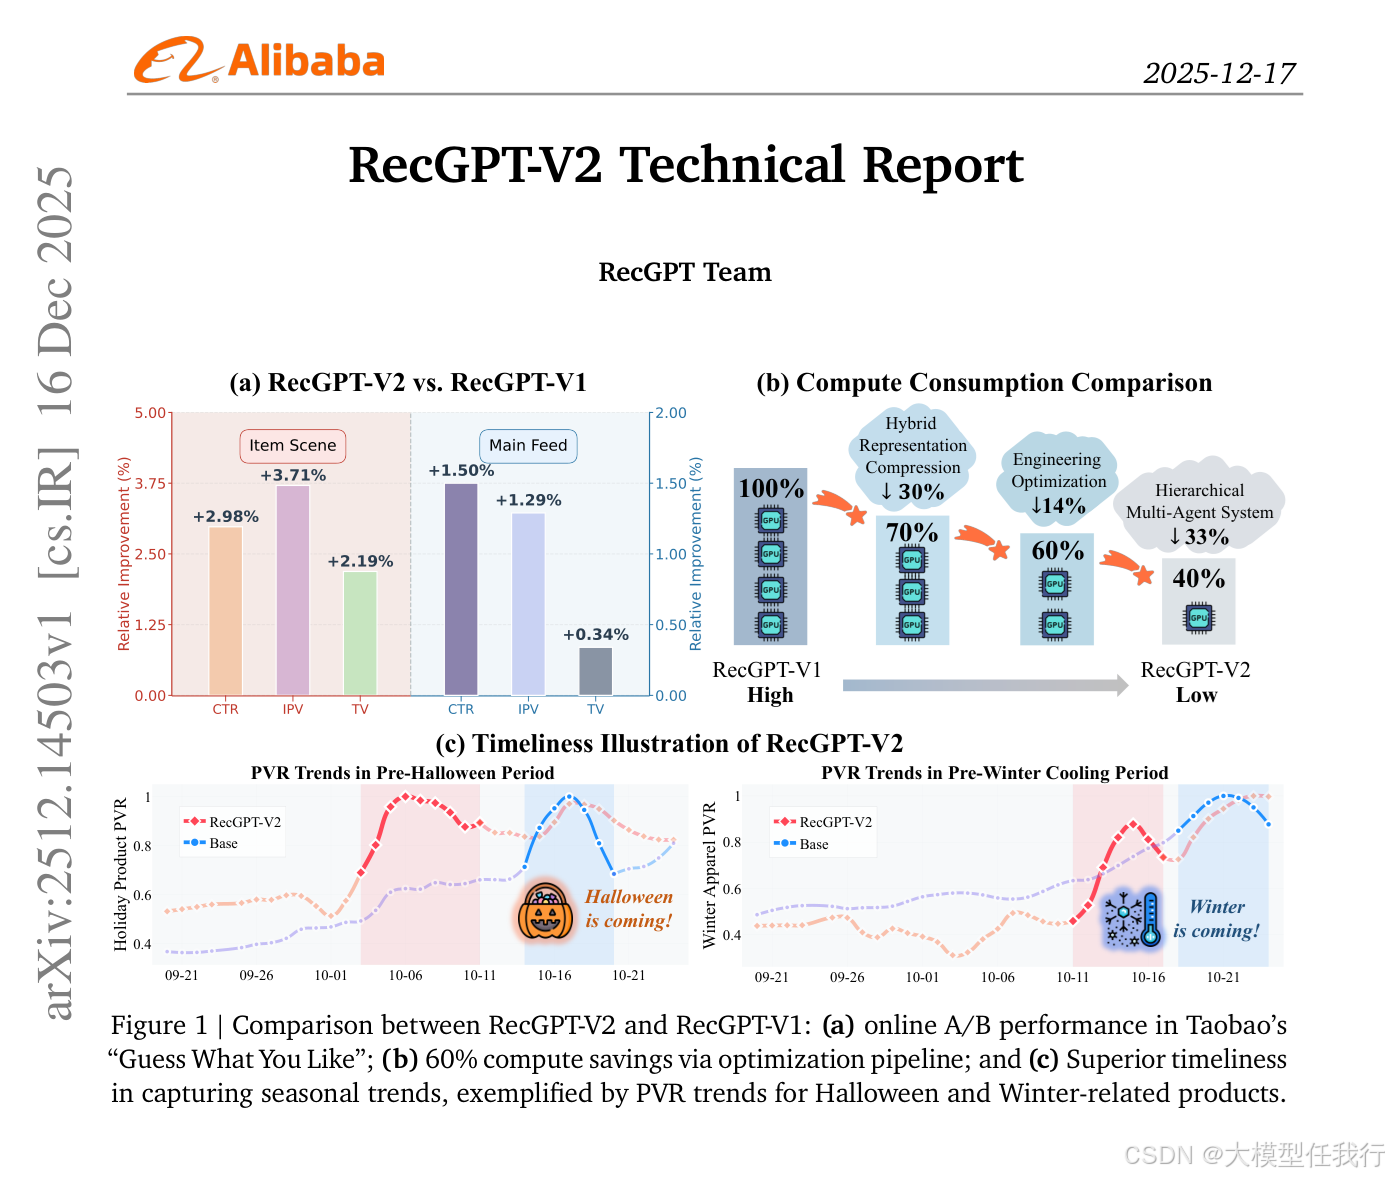
大型语言模型 (LLM) 在将推荐系统从隐式行为模式匹配转换为显式意图推理方面表现出显着的潜力。虽然RecGPT-V1通过将基于llm的推理集成到用户兴趣挖掘和项目标签预测中成功地开创了这一范式,但它有四个基本的局限性:(1)跨多个推理路径的计算效率低下和认知冗余;(2)固定模板生成解释多样性不足;(3)监督学习范式下泛化有限;(4)简单的以结果为中心的评估,无法匹配人类标准。为了应对这些挑战,我们提出了具有四个关键创新的 RecGPT-V2。首先,分层多智能体系统通过协调协作重构意图推理,消除认知重复,同时实现多样化的意图覆盖。结合压缩用户行为上下文的混合表示推理,我们的框架将 GPU 消耗减少了 60%,并将排他性召回率从 9.39% 提高到 10.99%。其次,元提示框架动态生成上下文自适应提示,将解释多样性提高了 +7.3%。第三,约束强化学习减轻了多奖励冲突,标签预测提高了 +24.1%,解释接受提高了 +13.0%。第四,Agent-as-a-Judge 框架将评估分解为多步推理,提高人类偏好对齐。淘宝在线 A/B 测试显示出显着的改进:+2.98% CTR、+3.71% IPV、+2.19% TV 和 +11.46% NER。RecGPT-V2 建立了大规模部署 LLM 驱动的意图推理的技术可行性和商业可行性,弥合认知探索和工业效用之间的差距。
🛎️文章简介
🔸研究问题:如何提高大型推荐系统在计算效率和用户交互中的表现,同时实现动态且个性化的推荐解释?
🔸主要贡献:论文提出了RecGPT-V2框架,通过引入代理意图推理和动态解释生成,显著提升了推荐系统的计算效率和用户满意度。
📝重点思路
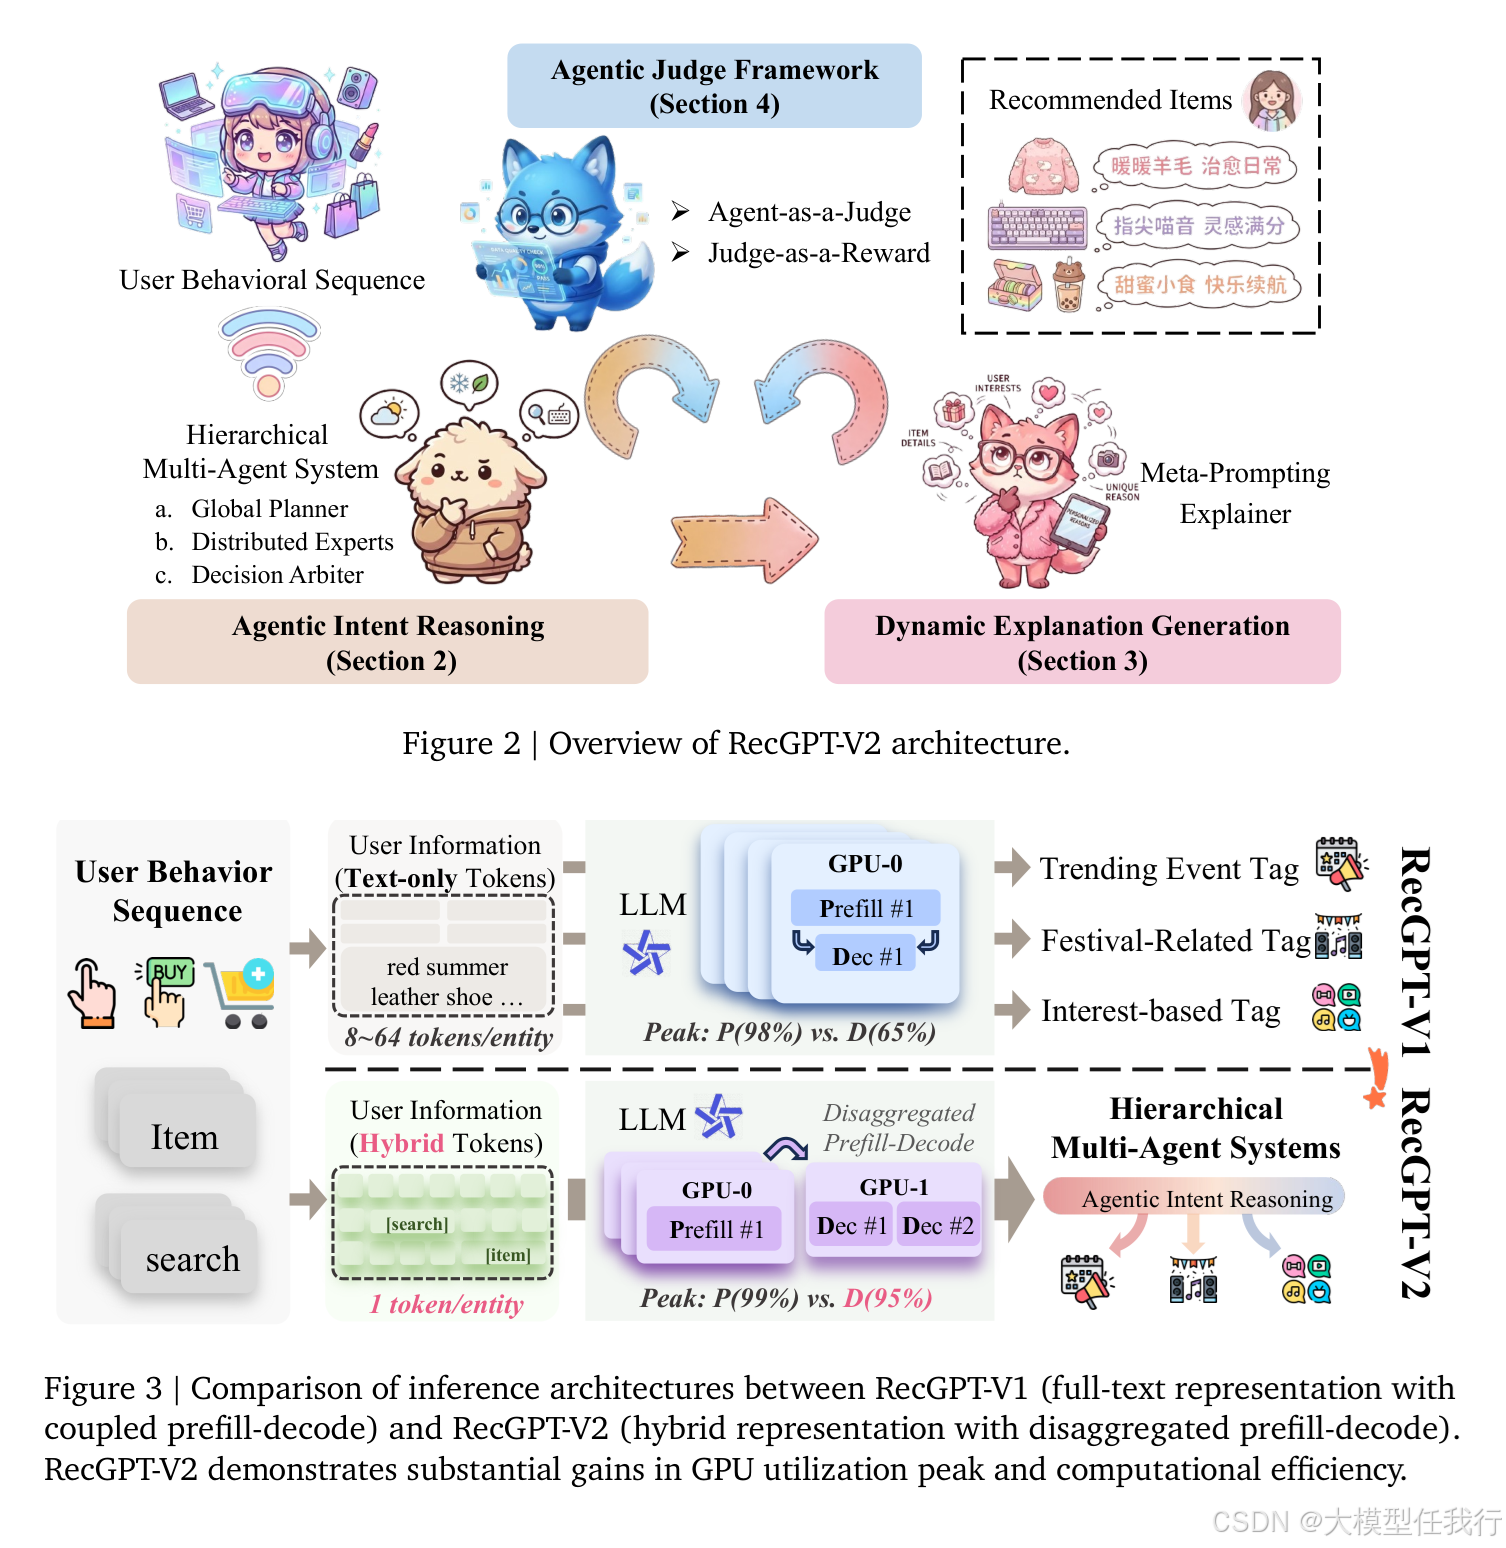
🔸引入混合表示推断(Hybrid Representation Inference),通过压缩用户行为表示,减少输入令牌长度,同时保持上下文完整性。
🔸建立了分层多代理系统(Hierarchical Multi-Agent System),将用户意图分解为专业化的代理进行协作推理,消除冗余计算。
🔸采用元提示(Meta-Prompting)技术,实现动态推荐解释生成,以适应用户的多维度需求。
🔸提出基于约束的强化学习优化框架,旨在提高多目标推荐生成任务的表现。
🔸引入代理作为评审(Agent-as-a-Judge)评价框架,通过逐步评估增强生成任务的质量反馈和优化。
🔎分析总结
🔸实验证明,RecGPT-V2在处理用户意图时有效减少了冗余计算,GPU消耗降低了60%。
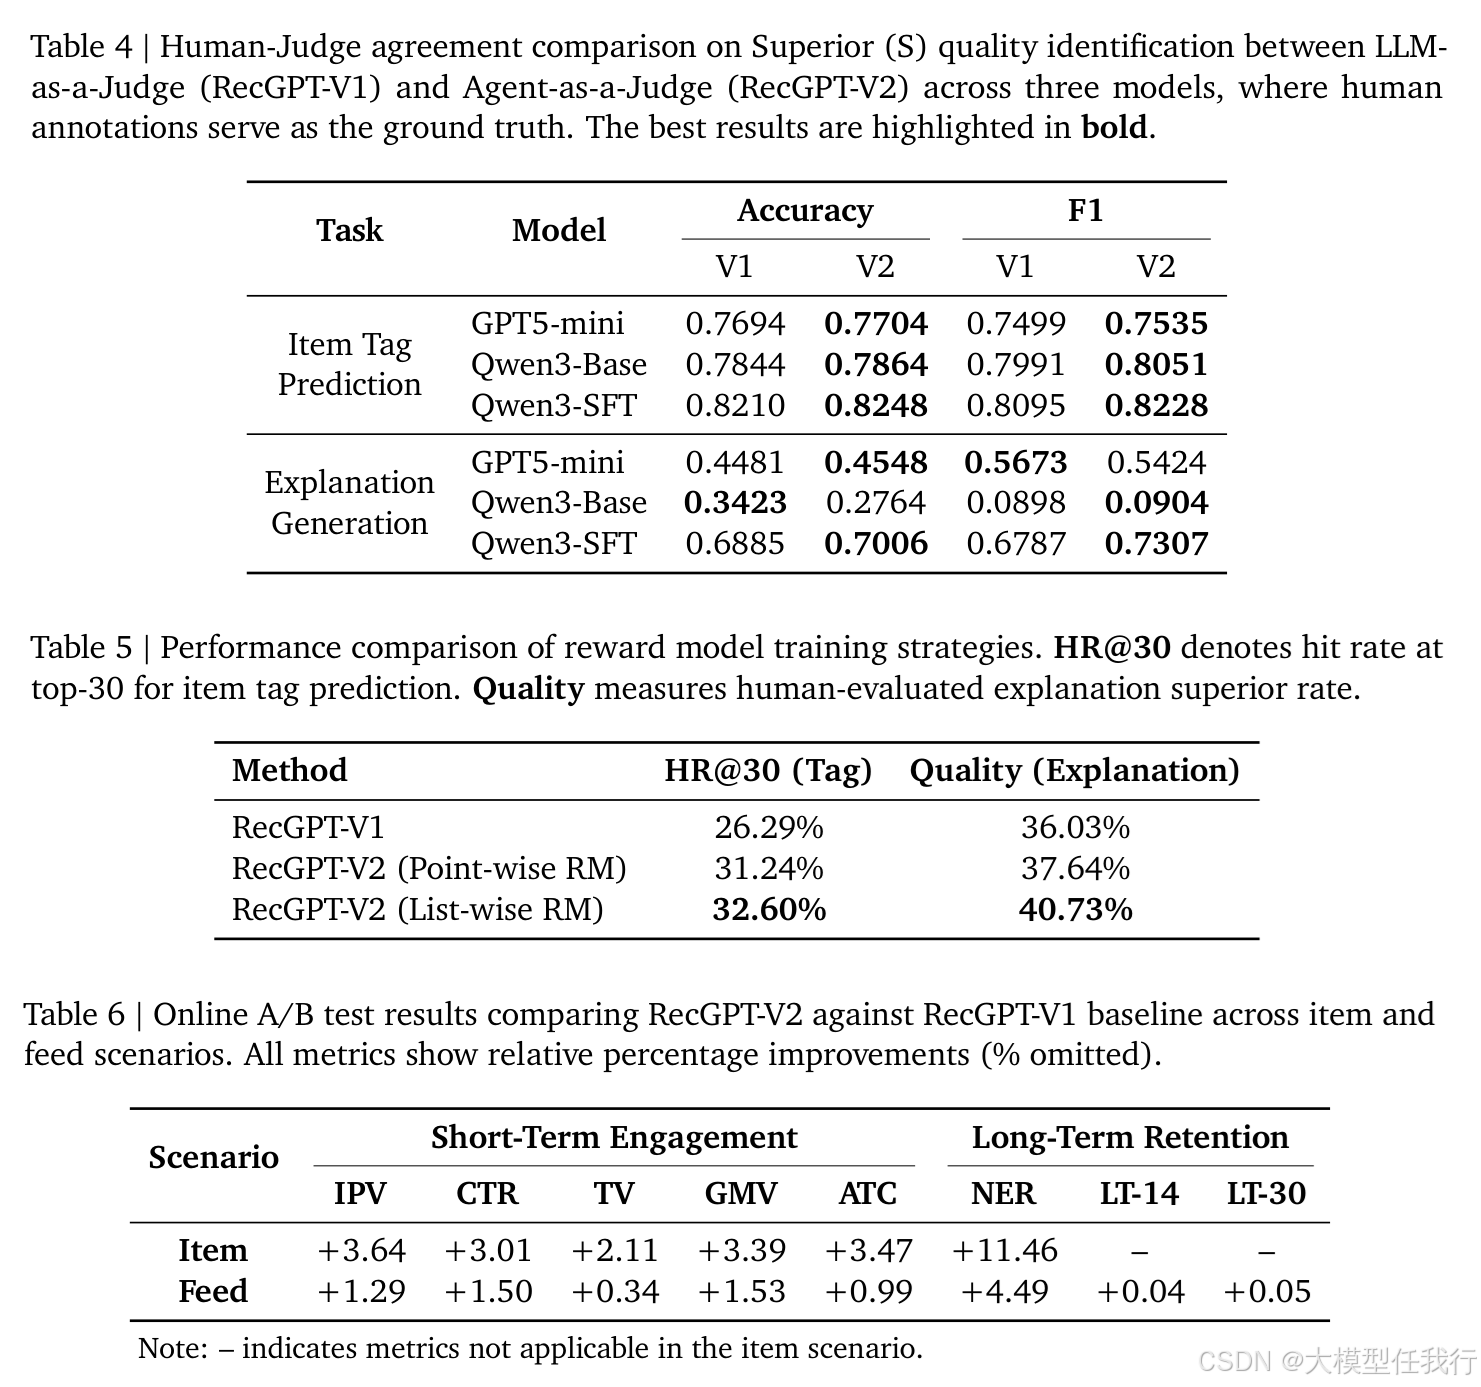
🔸在推荐任务中,RecGPT-V2在物品页面查看次数(IPV)、点击率(CTR)、交易量(TV)和新颖曝光率(NER)等指标上均实现了显著提升。
🔸动态解释生成的多样性提高了7.3%,用户对解释的接受率提高了13.04%。
🔸通过与RecGPT-V1的对比,RecGPT-V2在人类评估的标签质量通过率提高了24.0%。
💡个人观点
论文解决了传统推荐算法中存在的计算冗余和解释多样性不足的问题,引入分层多代理的协作机制和动态生成提示。
🧩附录

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献20条内容

所有评论(0)