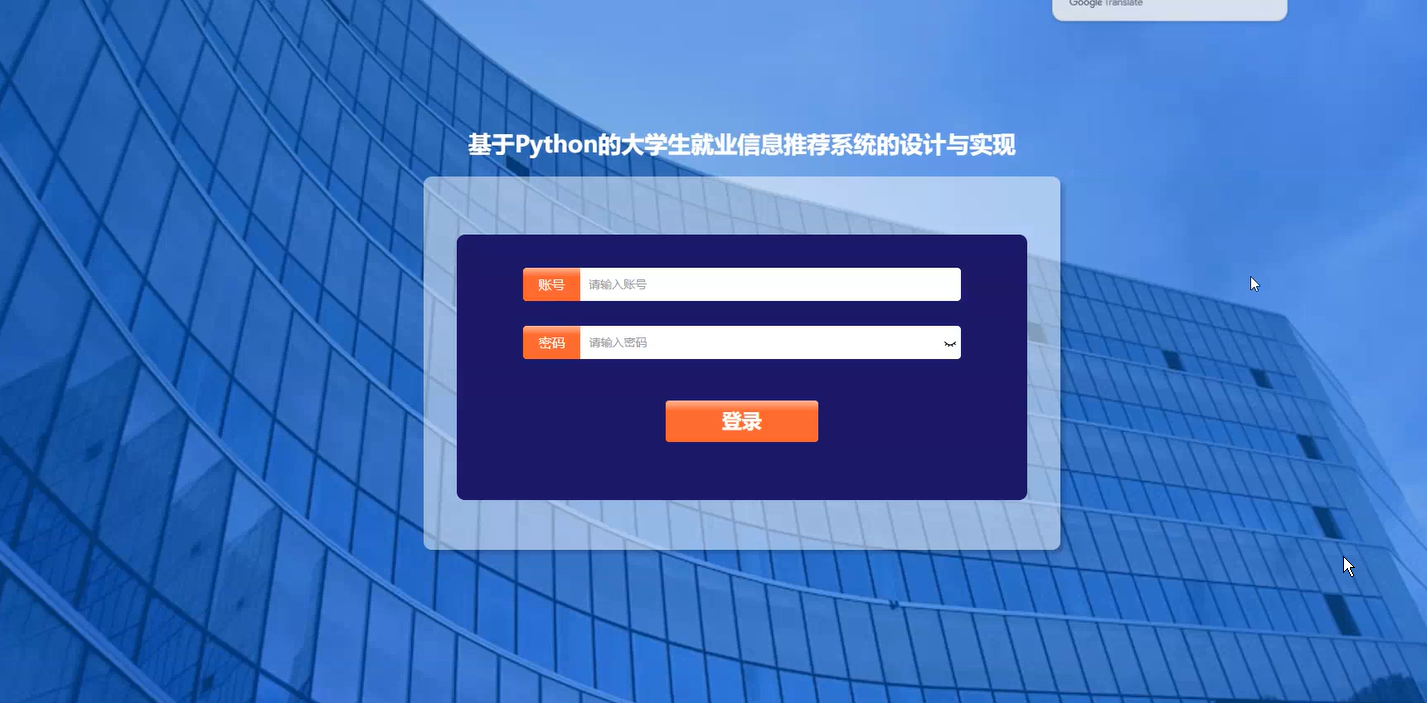
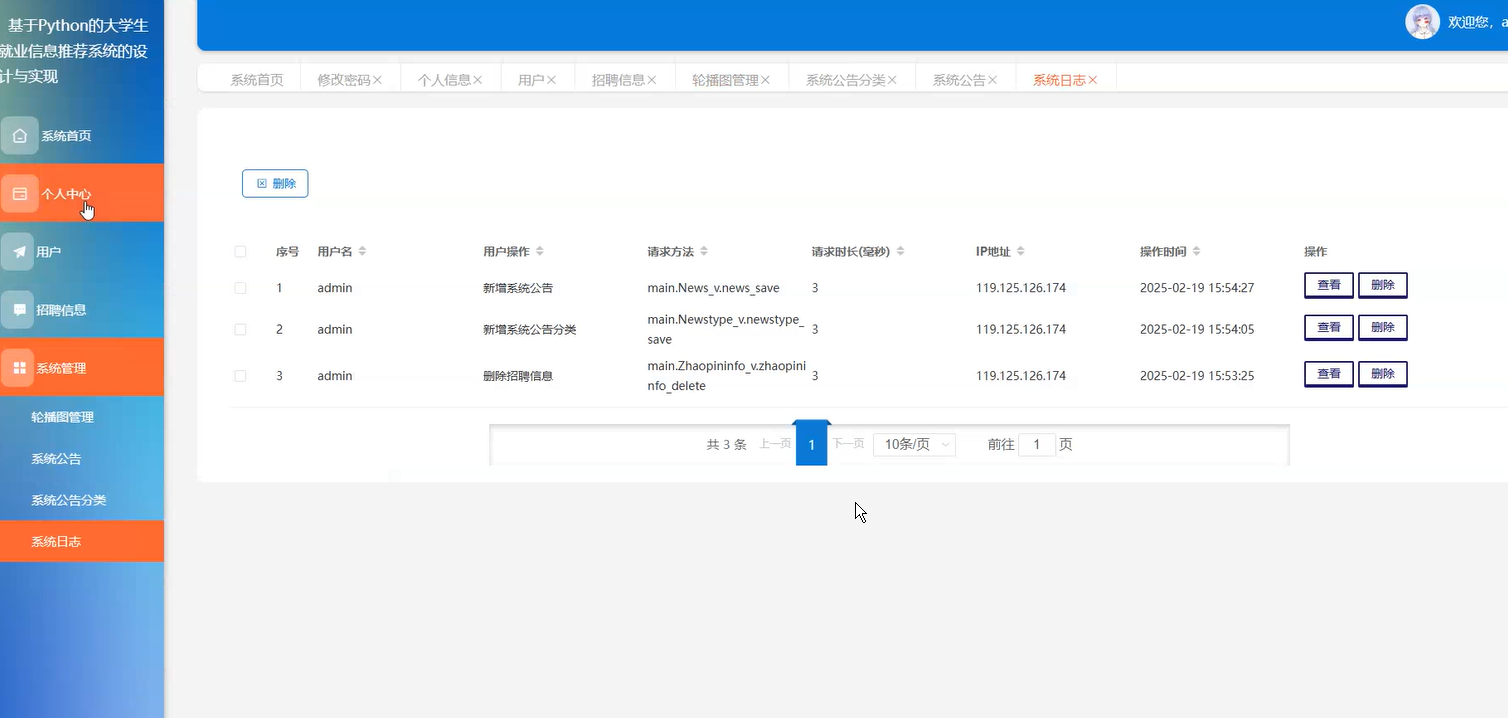
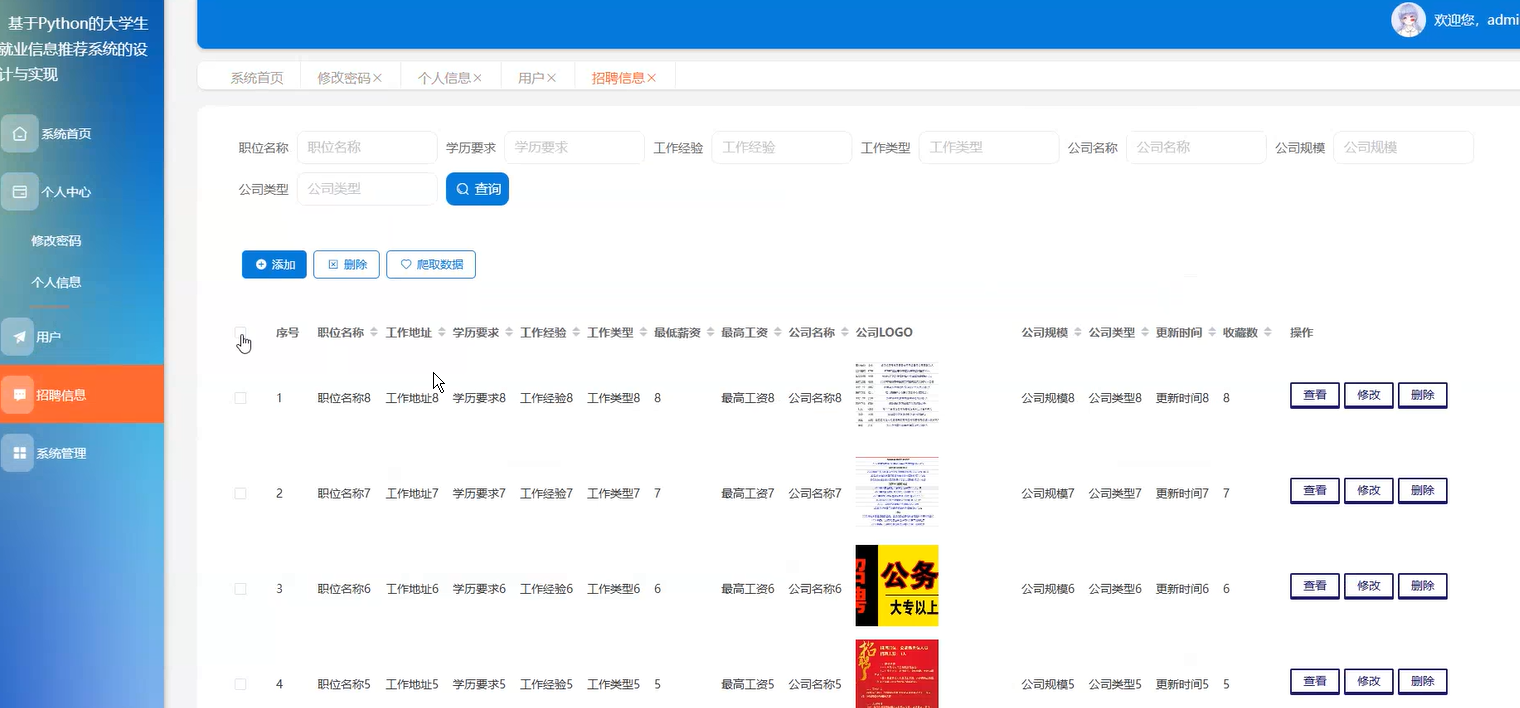
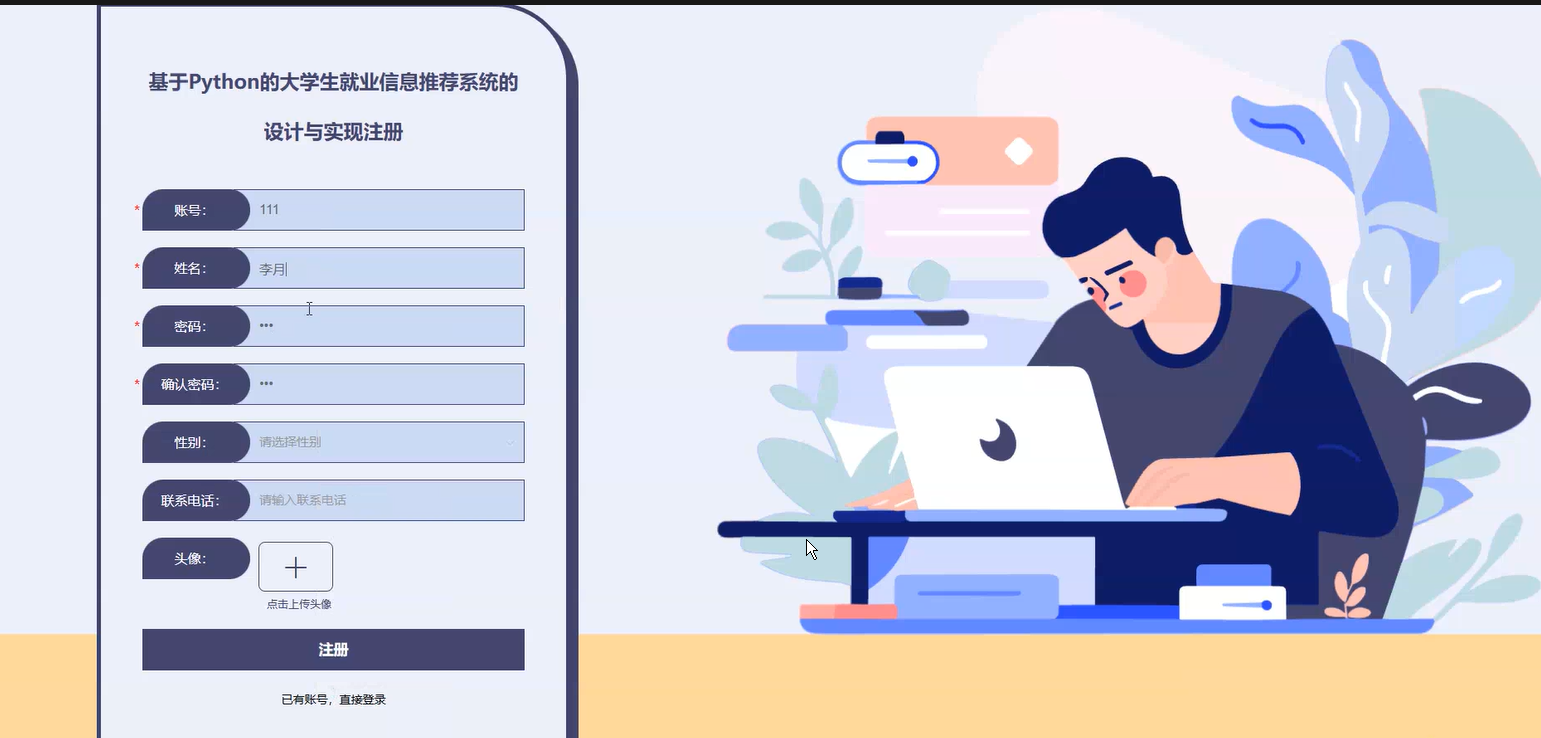
基于Python的大学生就业信息推荐系统的设计与实现
背景分析
当前大学生就业市场竞争激烈,信息过载导致学生难以高效匹配适合的岗位。传统招聘平台依赖关键词匹配,缺乏个性化推荐能力,学生需手动筛选大量信息,效率低下且易错过优质机会。高校就业指导服务受限于资源,难以覆盖全体学生的个性化需求。
技术意义
Python作为主流开发语言,具备丰富的机器学习库(如Scikit-learn、TensorFlow)和数据处理工具(如Pandas),能有效支撑推荐算法开发。基于协同过滤、内容推荐或混合算法,系统可分析学生技能、实习经历等数据,结合企业岗位需求生成精准推荐,降低信息不对称。
社会价值
提升就业市场供需匹配效率,缩短学生求职周期,减少企业招聘成本。通过数据分析反馈,高校可优化专业设置与课程体系,间接推动教育改革。系统可扩展至弱势群体(如残障学生)的就业支持,促进社会公平。
创新方向
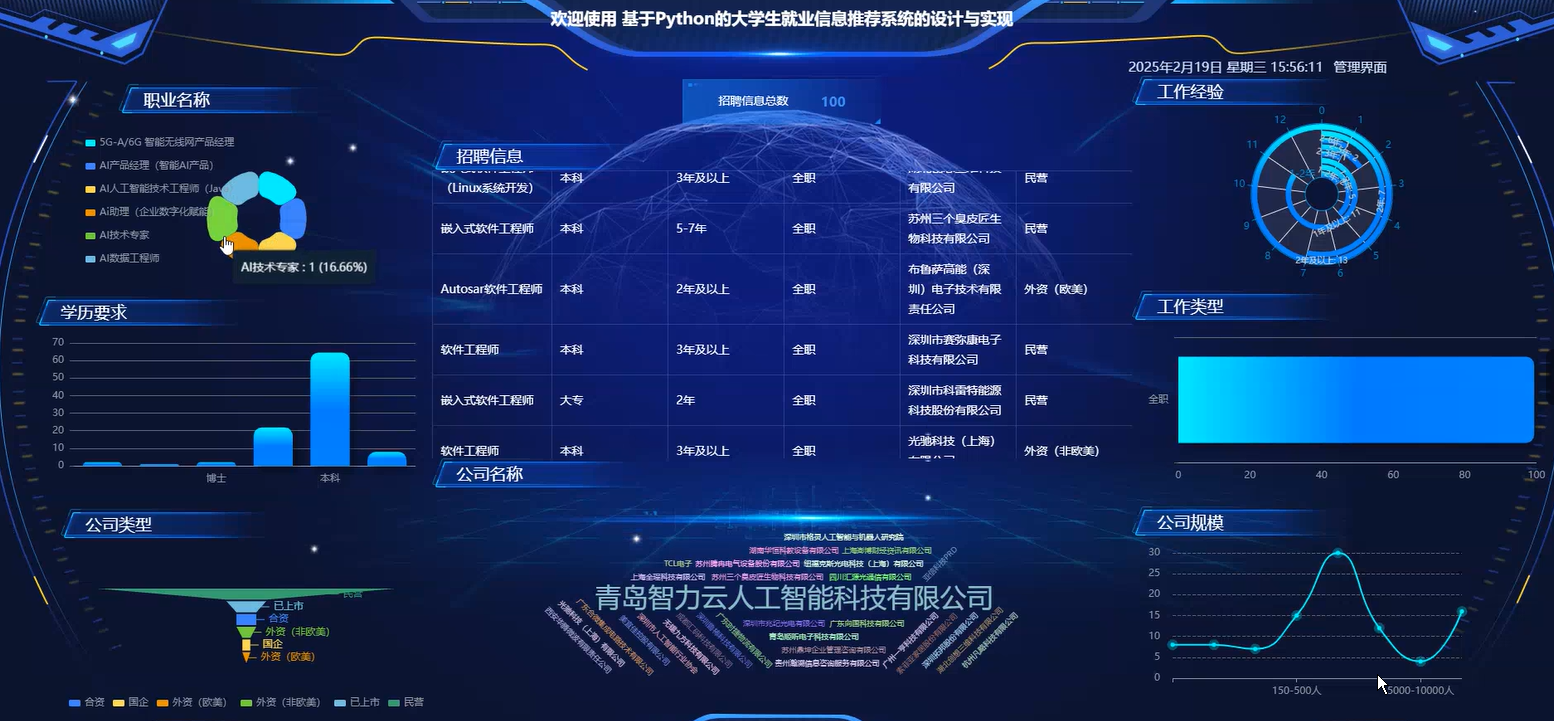
引入实时爬虫技术动态更新岗位信息,结合情感分析评估学生职业倾向。集成可视化仪表盘辅助决策,或嵌入聊天机器人提供交互式指导。长期可探索区块链技术确保简历真实性,构建可信就业生态。
实施挑战
需解决数据隐私保护问题,符合GDPR等法规。冷启动阶段需设计激励机制积累用户行为数据。算法需避免偏见,确保推荐结果公平性。高校与企业数据接口的标准化是系统落地的关键。
技术栈组成
Python大学生就业信息推荐系统通常涉及多个技术模块,涵盖数据处理、算法设计、前后端交互等。以下是典型技术栈的详细分类:
后端开发框架
- Django/Flask:Django适合快速构建全功能应用,内置ORM和Admin后台;Flask更轻量,适合灵活定制。
- FastAPI:高性能异步框架,适合处理实时推荐请求,自动生成API文档。
数据处理与分析
- Pandas:用于清洗、分析就业数据(如薪资、岗位分布)。
- NumPy:支持数值运算,处理特征矩阵。
- Scikit-learn:提供经典推荐算法(协同过滤、内容过滤)的实现。
推荐算法
- 协同过滤:基于用户-岗位交互数据,使用
surprise库实现。 - 内容基于推荐:TF-IDF或Word2Vec处理岗位描述文本,计算相似度。
- 混合推荐:结合用户行为与岗位特征,提升推荐多样性。
代码示例(协同过滤):
from surprise import Dataset, KNNBasic
data = Dataset.load_builtin('ml-100k')
algo = KNNBasic(sim_options={'user_based': True})
algo.fit(data.build_full_trainset())
数据库
- PostgreSQL/MySQL:存储结构化数据(用户信息、岗位详情)。
- MongoDB:处理非结构化数据(如用户行为日志)。
- Redis:缓存热门推荐结果,加速响应。
前端技术
- Vue.js/React:构建动态交互界面,展示推荐列表。
- ECharts:可视化就业趋势(如岗位需求热力图)。
- Bootstrap:快速实现响应式布局。
部署与运维
- Docker:容器化部署,保证环境一致性。
- Nginx:反向代理和负载均衡。
- Celery:异步任务处理(如定时更新推荐模型)。
辅助工具
- Jupyter Notebook:算法原型开发与数据分析。
- Git:版本控制与团队协作。
- Elasticsearch:实现岗位搜索功能(关键词高亮、排序)。
通过合理组合上述技术栈,可构建一个高效、可扩展的大学生就业推荐系统。实际选型需根据团队技术储备和项目需求调整。
数据预处理模块
import pandas as pd
from sklearn.preprocessing import LabelEncoder

def preprocess_data(file_path):
    # 读取就业数据CSV文件
    data = pd.read_csv(file_path)

    # 处理缺失值
    data.fillna('Unknown', inplace=True)

    # 对分类特征进行标签编码
    label_encoders = {}
    categorical_cols = ['major', 'industry', 'position', 'location']
    for col in categorical_cols:
        le = LabelEncoder()
        data[col] = le.fit_transform(data[col])
        label_encoders[col] = le

    # 特征标准化
    numeric_cols = ['gpa', 'salary']
    data[numeric_cols] = (data[numeric_cols] - data[numeric_cols].mean()) / data[numeric_cols].std()

    return data, label_encoders
特征工程模块
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.decomposition import TruncatedSVD

def feature_engineering(data):
    # 文本特征提取(如技能描述)
    tfidf = TfidfVectorizer(max_features=100)
    skill_features = tfidf.fit_transform(data['skills'])

    # 降维处理
    svd = TruncatedSVD(n_components=20)
    reduced_skills = svd.fit_transform(skill_features)

    # 合并所有特征
    other_features = data[['major', 'gpa', 'industry', 'position']].values
    features = np.hstack([other_features, reduced_skills])

    return features, tfidf, svd
推荐算法模块
from sklearn.neighbors import NearestNeighbors
from sklearn.metrics.pairwise import cosine_similarity

class JobRecommender:
    def __init__(self, n_neighbors=5):
        self.model = NearestNeighbors(n_neighbors=n_neighbors, metric='cosine')

    def fit(self, features):
        self.model.fit(features)

    def recommend(self, query_features, data, top_k=3):
        distances, indices = self.model.kneighbors(query_features)

        # 获取推荐结果
        recommendations = data.iloc[indices[0]].copy()
        recommendations['similarity'] = 1 - distances[0]

        # 按相似度排序并返回TopK结果
        return recommendations.sort_values('similarity', ascending=False).head(top_k)
用户接口模块
def get_recommendations(user_profile, data, label_encoders, tfidf, svd, model):
    # 预处理用户输入
    processed_profile = {}
    for col in ['major', 'industry', 'position', 'location']:
        processed_profile[col] = label_encoders[col].transform([user_profile[col]])[0]

    # 处理数值特征
    processed_profile['gpa'] = (user_profile['gpa'] - data['gpa'].mean()) / data['gpa'].std()

    # 处理技能文本
    skill_vec = tfidf.transform([user_profile['skills']])
    reduced_skills = svd.transform(skill_vec)

    # 构建特征向量
    other_features = np.array([
        processed_profile['major'],
        processed_profile['gpa'],
        processed_profile['industry'],
        processed_profile['position']
    ]).reshape(1, -1)

    query_features = np.hstack([other_features, reduced_skills])

    # 获取推荐
    return model.recommend(query_features, data)
系统集成示例
if __name__ == "__main__":
    # 数据加载与预处理
    data, label_encoders = preprocess_data('job_data.csv')

    # 特征工程
    features, tfidf, svd = feature_engineering(data)

    # 模型训练
    recommender = JobRecommender()
    recommender.fit(features)

    # 模拟用户输入
    user_profile = {
        'major': 'Computer Science',
        'gpa': 3.5,
        'industry': 'Technology',
        'position': 'Software Engineer',
        'skills': 'Python, Java, SQL, Machine Learning'
    }

    # 获取推荐
    recommendations = get_recommendations(user_profile, data, label_encoders, tfidf, svd, recommender)
    print(recommendations[['company', 'position', 'location', 'salary', 'similarity']])
系统优化方向
- 添加深度学习模型替代传统机器学习方法
- 集成实时反馈机制更新推荐结果
- 增加多样性保证机制避免推荐结果同质化
- 实现基于用户行为的动态权重调整
核心代码需要根据实际数据结构进行调整,重点在于特征表示和相似度计算模块的设计。系统效果很大程度上取决于数据质量和特征工程的质量。
数据库设计
设计大学生就业信息推荐系统的数据库需要考虑用户信息、职位信息、推荐算法数据存储等核心模块。以下是基于MySQL的数据库表结构设计:
用户表(user)
CREATE TABLE user (
    user_id INT PRIMARY KEY AUTO_INCREMENT,
    username VARCHAR(50) NOT NULL UNIQUE,
    password VARCHAR(100) NOT NULL,
    email VARCHAR(100) NOT NULL UNIQUE,
    phone VARCHAR(20),
    university VARCHAR(100),
    major VARCHAR(100),
    graduation_year INT,
    skills TEXT,
    resume_url VARCHAR(255),
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP
);
职位表(job)
CREATE TABLE job (
    job_id INT PRIMARY KEY AUTO_INCREMENT,
    title VARCHAR(100) NOT NULL,
    company VARCHAR(100) NOT NULL,
    location VARCHAR(100),
    salary_range VARCHAR(50),
    description TEXT,
    requirements TEXT,
    category VARCHAR(50),
    posted_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    expires_at DATE
);
用户行为表(user_behavior)
CREATE TABLE user_behavior (
    behavior_id INT PRIMARY KEY AUTO_INCREMENT,
    user_id INT NOT NULL,
    job_id INT NOT NULL,
    behavior_type ENUM('view', 'apply', 'save') NOT NULL,
    behavior_time TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    FOREIGN KEY (user_id) REFERENCES user(user_id),
    FOREIGN KEY (job_id) REFERENCES job(job_id)
);
推荐结果表(recommendation)
CREATE TABLE recommendation (
    rec_id INT PRIMARY KEY AUTO_INCREMENT,
    user_id INT NOT NULL,
    job_id INT NOT NULL,
    score FLOAT NOT NULL,
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP,
    FOREIGN KEY (user_id) REFERENCES user(user_id),
    FOREIGN KEY (job_id) REFERENCES job(job_id)
);
系统测试方案
单元测试 使用Python的unittest框架对核心功能模块进行测试:
import unittest
from recommendation_algorithm import RecommendationEngine

class TestRecommendationEngine(unittest.TestCase):
    def setUp(self):
        self.engine = RecommendationEngine()
        self.test_user = {"user_id": 1, "major": "计算机科学", "skills": ["Python", "Java"]}
        self.test_jobs = [
            {"job_id": 1, "title": "Python开发", "requirements": "Python, Django"},
            {"job_id": 2, "title": "Java开发", "requirements": "Java, Spring"}
        ]

    def test_calculate_match_score(self):
        scores = self.engine.calculate_match_score(self.test_user, self.test_jobs)
        self.assertEqual(len(scores), 2)
        self.assertGreater(scores[0], scores[1])
集成测试 测试数据库与推荐系统的交互:
class TestDatabaseIntegration(unittest.TestCase):
    def test_user_job_interaction(self):
        db = DatabaseConnector()
        user_id = db.insert_user("test_user", "password123", "test@example.com")
        job_id = db.insert_job("测试职位", "测试公司", "Python开发")

        interaction_id = db.record_behavior(user_id, job_id, "view")
        self.assertIsNotNone(interaction_id)
性能测试 使用Locust进行系统负载测试:
from locust import HttpUser, task

class RecommendationSystemUser(HttpUser):
    @task
    def get_recommendations(self):
        self.client.get("/api/recommendations?user_id=1")

    @task(3)
    def search_jobs(self):
        self.client.get("/api/jobs?keyword=Python")
测试覆盖率 使用pytest-cov确保测试覆盖率:
pytest --cov=recommendation_system tests/
推荐算法实现
基于内容过滤的推荐算法核心逻辑:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

class ContentBasedRecommender:
    def __init__(self):
        self.vectorizer = TfidfVectorizer()

    def train(self, job_descriptions):
        self.job_vectors = self.vectorizer.fit_transform(job_descriptions)

    def recommend(self, user_profile, top_n=5):
        user_vector = self.vectorizer.transform([user_profile])
        similarities = cosine_similarity(user_vector, self.job_vectors)
        top_indices = similarities.argsort()[0][-top_n:][::-1]
        return top_indices
系统部署
使用Docker容器化部署方案:
FROM python:3.9
WORKDIR /app
COPY requirements.txt .
RUN pip install -r requirements.txt
COPY . .
EXPOSE 5000
CMD ["gunicorn", "--bind", "0.0.0.0:5000", "app:app"]
对应的docker-compose.yml配置:
version: '3'
services:
  web:
    build: .
    ports:
      - "5000:5000"
  db:
    image: mysql:5.7
    environment:
      MYSQL_ROOT_PASSWORD: rootpass
      MYSQL_DATABASE: job_recommendation
      MYSQL_USER: dbuser
      MYSQL_PASSWORD: dbpass
    ports:
      - "3306:3306"

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献2条内容

所有评论(0)