有关链表的一些算法思路
一.快慢指针的运用
1.找到链表的中间节点:
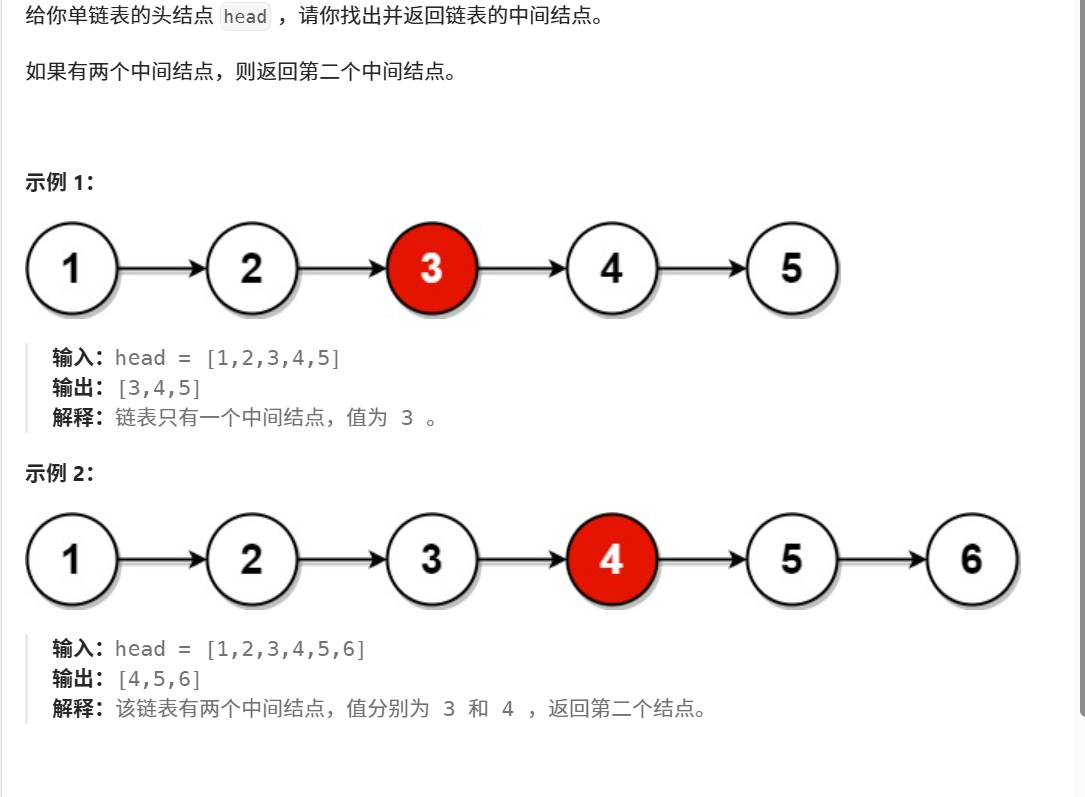
对于这题,我们可以选择创建一个整形c以遍历链表的方式记录链表的长度,然后再让头节点位置的指针向前走c/2次就得到了我们想要的节点。
但它还有一种更简单的做法(快慢指针):
我们可以先定义两个与链表节点同类型的指针slow,fast并让它们都指向头节点(head)。然后为了让这两个指针指向后面的节点,建立一个循环,使fast指针每次向后移动两个节点,slow指针每次向后移动一个节点,这样我们就建立了这两个指针的路程关系:L(fast) = 2 * L(slow)。可以得到当fast指向链表末尾的时候,slow才走它一半的距离,即走到中间节点。
注意 链表长度的奇偶性会影响fast的最终指向:
偶:fast应该指向NULL
奇:fast应该指向最后一个节点
因此我们就可以得到循环条件:while(fast && fast ->next)
struct ListNode* middleNode(struct ListNode* head)
{
    LTN* slow = head;
    LTN* fast = head;
    while(fast && fast ->next)
    {
        slow = slow->next;
        fast = fast->next->next;
    }
    return slow;
}
特别注意: 在while(fast && fast ->next)中,fast和fast->next位置不可颠倒,因为当链表长度为偶数时,fast指向NULL,不能对NULL进行解引用。
题目:https://leetcode-cn.com/problems/middle-of-the-linked-list/description/
2.找到链表的倒数第k个节点
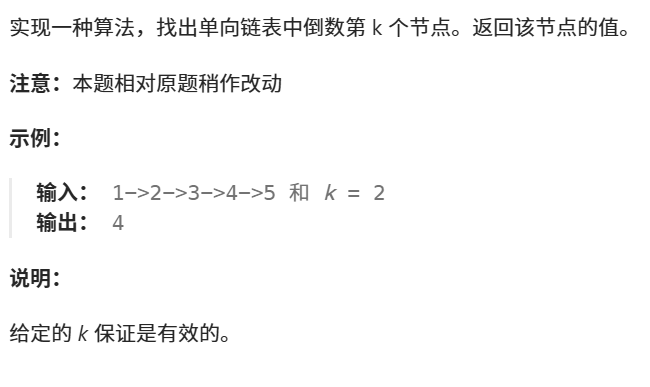
这里也是运用快慢指针,但相比于上面快慢指针的起始位置相同而速度不同,这里的是起始位置不同速度相同。
设置slow、fast指针,先让fast指针走k步,然后再让slow与fast每次一步的速度同时开始向前走。这样保证了两个指针的相对位置保持k不变,当fast为空时,slow指向倒数第k个节点。
int kthToLast(struct ListNode* head, int k)
{
    struct ListNode* fast = head,* slow = head;
    while(k--)
    {
        fast = fast->next;
    }
    while(fast)
    {
        fast = fast->next;
        slow = slow->next;
    }
    return slow->val;

}
题目:https://leetcode.cn/problems/kth-node-from-end-of-list-lcci/
二.链表的回文结构
所谓回文,就是一组数据从前往后读和从后往前读的结果都一样。
如果我们不考虑空间复杂度,可以这样做:
遍历链表,以int c 记录链表的长度;
再创建一个长度为c,元素类型为所要比较的链表中的数据类型;
再遍历链表,将链表中的数据存如数组中;
最后用判断数组是否回文的方法判断该链表是否回文。
大家可以试着写写以上思想的代码,我接下来为大家带来一个十分巧妙的思路。
以原链表为:1->2->3->2->1 为例
第一步:
找到中间节点mid;
第二步:
将mid及其之后的代码倒置:
1->2->1->2->3;
第三步:
设置两个指针,分别指向头节点head和中间节点mid
最后:
让两个指针每走一步比较一下,相等则继续,不等则返回false。
ListNode* get_mid(ListNode* a)//找中间节点
{
    ListNode* slow = a;
    ListNode* fast = a;
    while(fast)
    {
        fast = fast->next;
        slow = slow->next;
        if(!fast)
            break;
        fast = fast->next;
    }
    return slow;
}
ListNode* invert(ListNode* M)//倒置
{
    ListNode* newhead = NULL;
    ListNode* cur = M;
    while(cur)
    {
        ListNode* next = cur->next;
        cur->next = newhead;
        newhead = cur;
        cur = next;
    }
    return newhead;
}
bool chkPalindrome(ListNode* A)
{
        // write code here
        ListNode* mid;
        mid = get_mid(A);
        ListNode* rmid;
        rmid = invert(mid);
        ListNode* pcur = A;
        while(pcur && rmid)
        {
            if(pcur->val != rmid->val)
                return false;
            pcur = pcur->next;
            rmid = rmid->next;
        }
        return true;
}
题目:https://www.nowcoder.com/practice/d281619e4b3e4a60a2cc66ea32855bfa?tpId=49&&tqId=29370&rp=1&ru=/activity/oj&qru=/ta/2016test/question-ranking
三.单链表的相交
判断两条单链表是否相交:
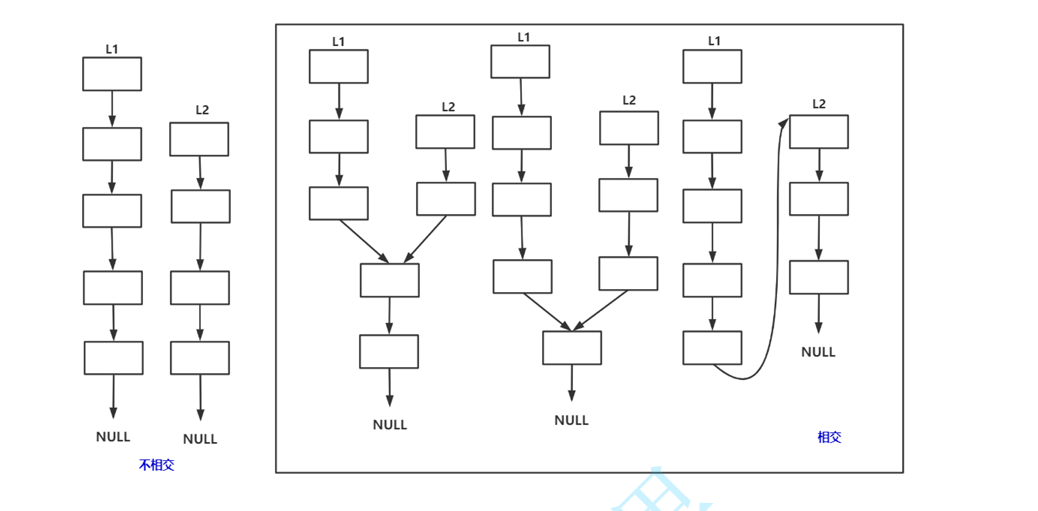
可以看出,如果两条单链表相交,它们的尾节点一定相同。因此我们可以通过判断尾节点是否相同来判断它们是否相交。
我们在加上一个条件:找出链表相交处的节点
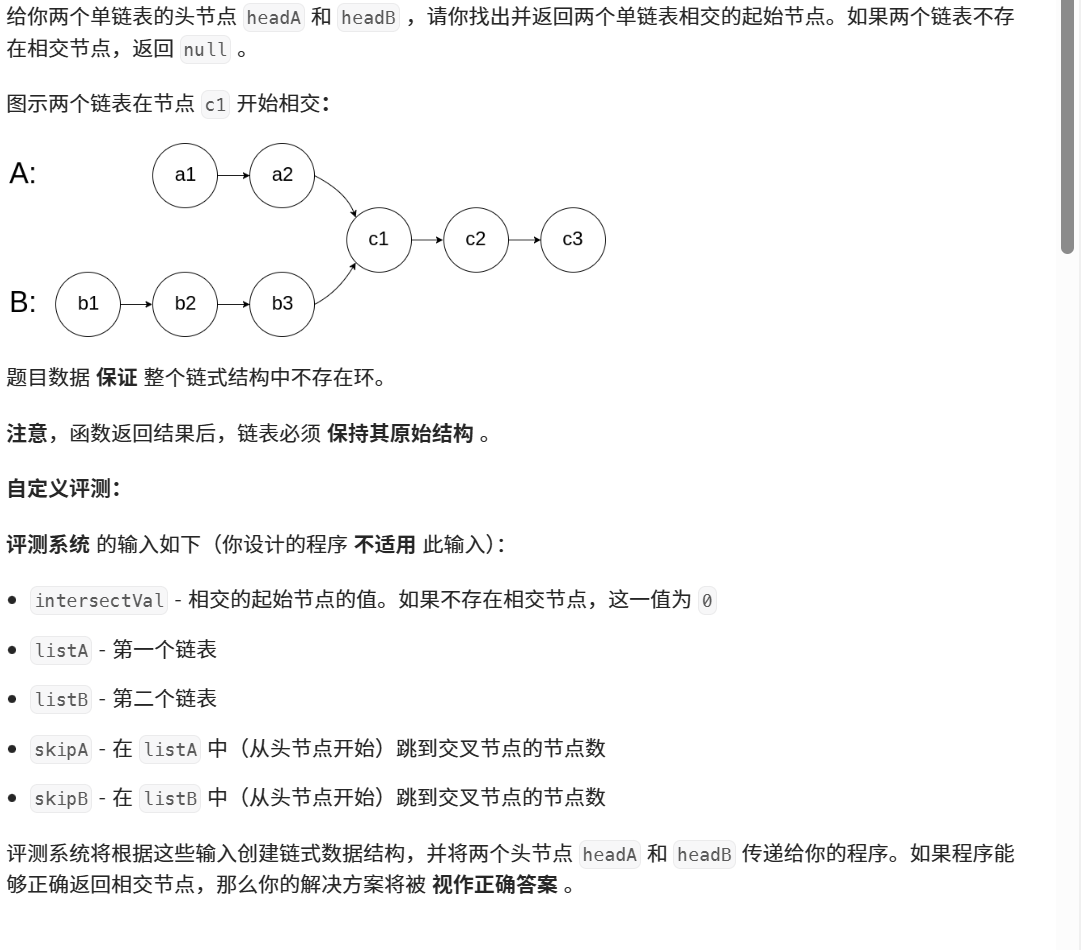
我们先用以上方法判断链表是否相交,如果不相交就返回NULL,相交则继续;
设置两个指针AB分别指向两个链表的头节点。试想,如果这两条链表长度相等,我们同时让AB从头开始遍历它们个自对应的链表,每走一步对AB的地址进行比较,自然可以得到相交的节点。但如果它们长度不一呢?很显然,如果同时从头开始的话,它们会彼此错过,一定找不到相交的节点。所以我们要想办法让AB遍历前距相交节点的距离相等,要怎么做呢?
1.在判断链表是否相交的同时记录下两条链表的长度:
    struct ListNode * A = headA;
    struct ListNode * B = headB;
    int a = 0,b = 0;
    while(A->next)
    {
        A = A->next;
        a++;
    }
    while(B->next)
    {
        B = B->next;
        b++;
    }
    if(A != B)//相交链表的最后一个节点一定相同
    {
        return NULL;
    }
然后我们比较ab,指向更长链表的节点先走(a-b)的绝对值步:
    int len = abs(a - b);//计算两链表的长度差
    struct ListNode *shortlist = headA;
    struct ListNode * longlist = headB;
        //假设法找出长短链表
    if(a > b)
    {
        shortlist = headB;
        longlist = headA;
    }
    while(len--)
    {
        longlist = longlist->next;
    }
这里运用了假设法,先假设链表A更短,B更长,然后再用if得到真正的长短链表。
注: 这里不需要知道AB谁更长了,长链表已经用 longlist表示,短链表已经用shortlist表示。
最后,让两个longlist与shortlist同时开始一步一步的走:
    while(longlist)
    {
        if(longlist == shortlist)
            break;
        longlist = longlist->next;
        shortlist = shortlist->next;
    }
总代码:
struct ListNode *getIntersectionNode(struct ListNode* headA, struct ListNode *headB)
{
    struct ListNode * A = headA;
    struct ListNode * B = headB;
    int a = 0,b = 0;
    while(A->next)
    {
        A = A->next;
        a++;
    }
    while(B->next)
    {
        B = B->next;
        b++;
    }
    if(A != B)//相交链表的最后一个节点一定相同
    {
        return NULL;
    }
    int len = abs(a - b);//计算两链表的长度差
    struct ListNode *shortlist = headA;
    struct ListNode * longlist = headB;
        //假设法找出长短链表
    if(a > b)
    {
        shortlist = headB;
        longlist = headA;
    }
    while(len--)
    {
        longlist = longlist->next;
    }
    while(longlist)
    {
        if(longlist == shortlist)
            break;
        longlist = longlist->next;
        shortlist = shortlist->next;
    }
    return longlist;
}
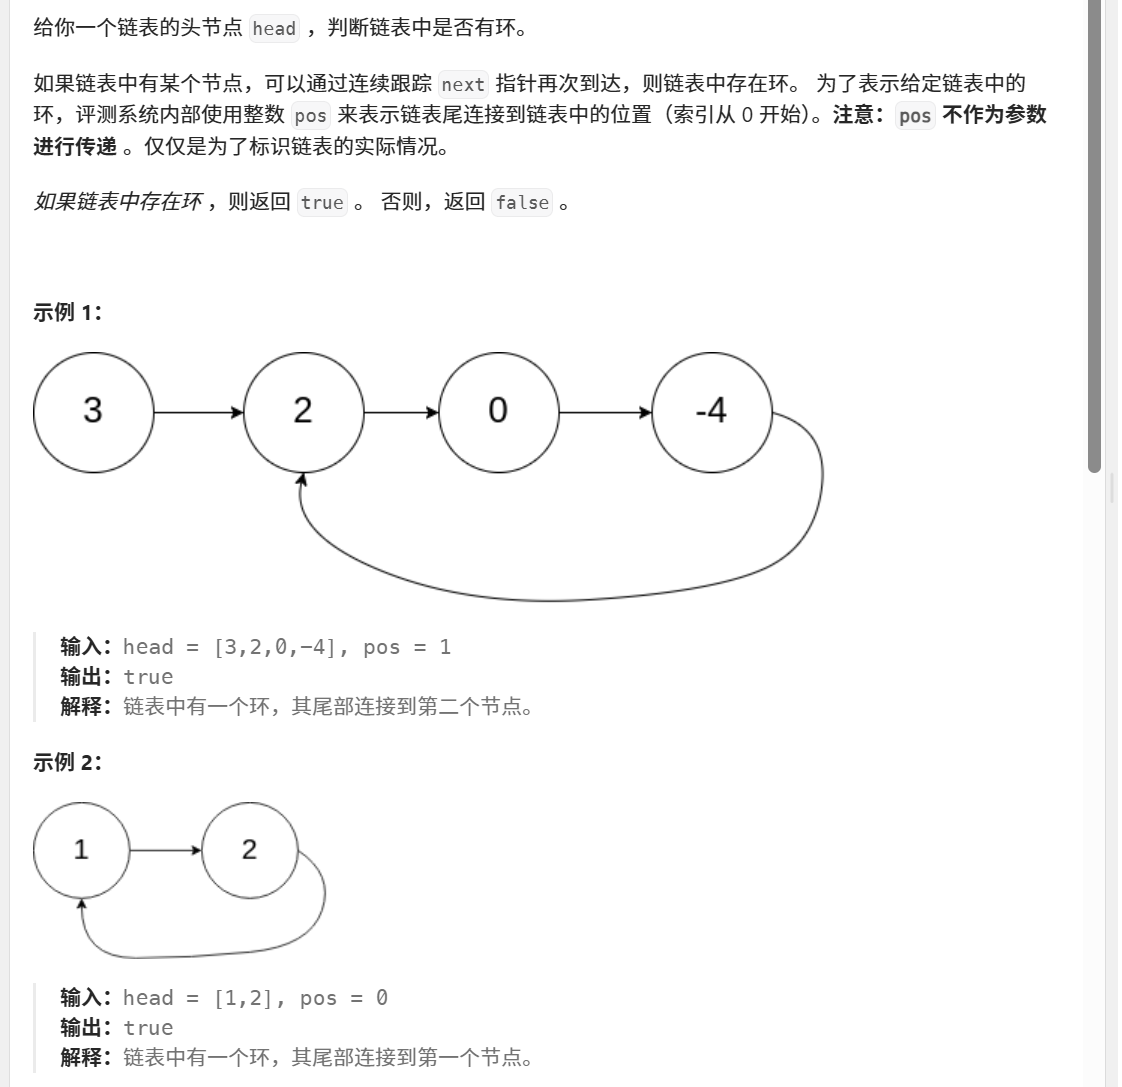
四.判断链表是否成环
关于这个问题我们可以创建一对速度比为1:2的快慢指针,如果该链表不成环,则fast或fast-next最终指向NULL,如果成环,fast会在环内反复运动,当slow进环时,fast开始追赶slow,每一次循环它们的距离会缩小1,因此最终它们一定能相遇。
bool hasCycle(struct ListNode *head)
{
    struct ListNode * slow = head;
    struct ListNode * fast = head;
    while(fast && fast->next)
    {
        slow = slow->next;
        fast = fast->next->next;
        if(slow == fast)
            return true;
    }
    return false;

}
题目:https://leetcode-cn.com/problems/linked-list-cycle/description/
我们不妨大胆猜测一下,fast可以取3,4,5……吗?我们拿三来举例子: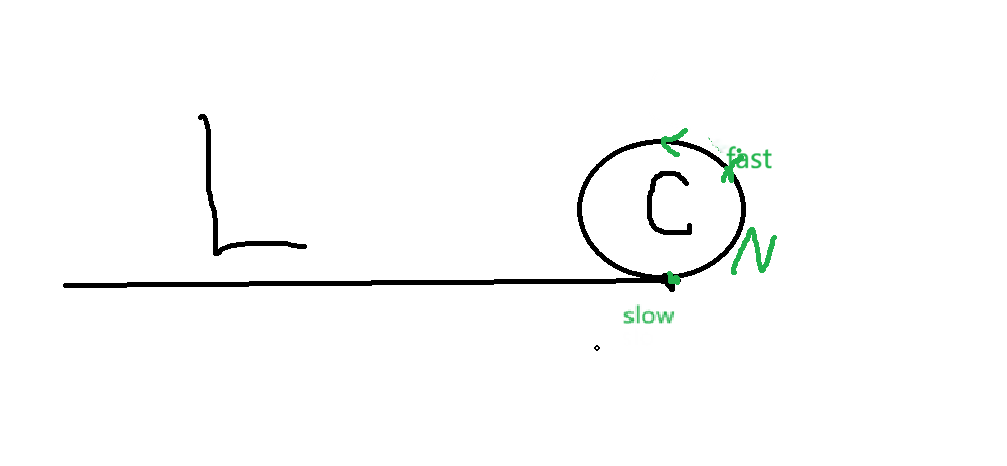
如图,我们令链表不成环部分长L,成环部分长C,当slow准备进环时,slow与fast相距N-C,此时:
slow:L
fast:3L = L + x * C + N,x为fast走的圈数
fast距slow:C - N
fast与slow的相对速度:2
i.如果C-N为偶数,(C - N) % 2 == 0,fast一定能追上slow;
ii.如果C-N为奇数,(C - N) % 2 != 0,fast第一次会超过slow,二者距离变为C-1;
ii.1 如果C-1为偶,fast一定能追上slow;
ii.2 如果C-1为奇,fast会第二次超过slow,距离再次变为C-1,这种情况下fast不可能追上slow。
因此我们可以得到一些小结论:
i. C-N为偶,fast与slow会相遇
ii. C - N为奇:
C-1为偶,会相遇
C-1为奇,不会相遇
等量关系:2L = x * C + N = (x + 1) * C - (C - N)
很显然2L是一个偶数,偶数 = 偶数-偶数 ,偶数 = 奇数 - 奇数,我们可以从这里入手。
1.如果x+1为偶数:
(x+1)*C必为偶,(C - N)为偶,fast会与slow相遇;
2.如果x+1为奇数:
i. C为偶,(C - N)为偶,相遇;
ii.C为奇,(C - N)为奇,相遇;
由此可以推导出,即使fast速度为3,它们依然能够相遇。事实上,当fast >=2时,fast总能追上slow,但我的能力有限,具体证明大家可以自行了解。
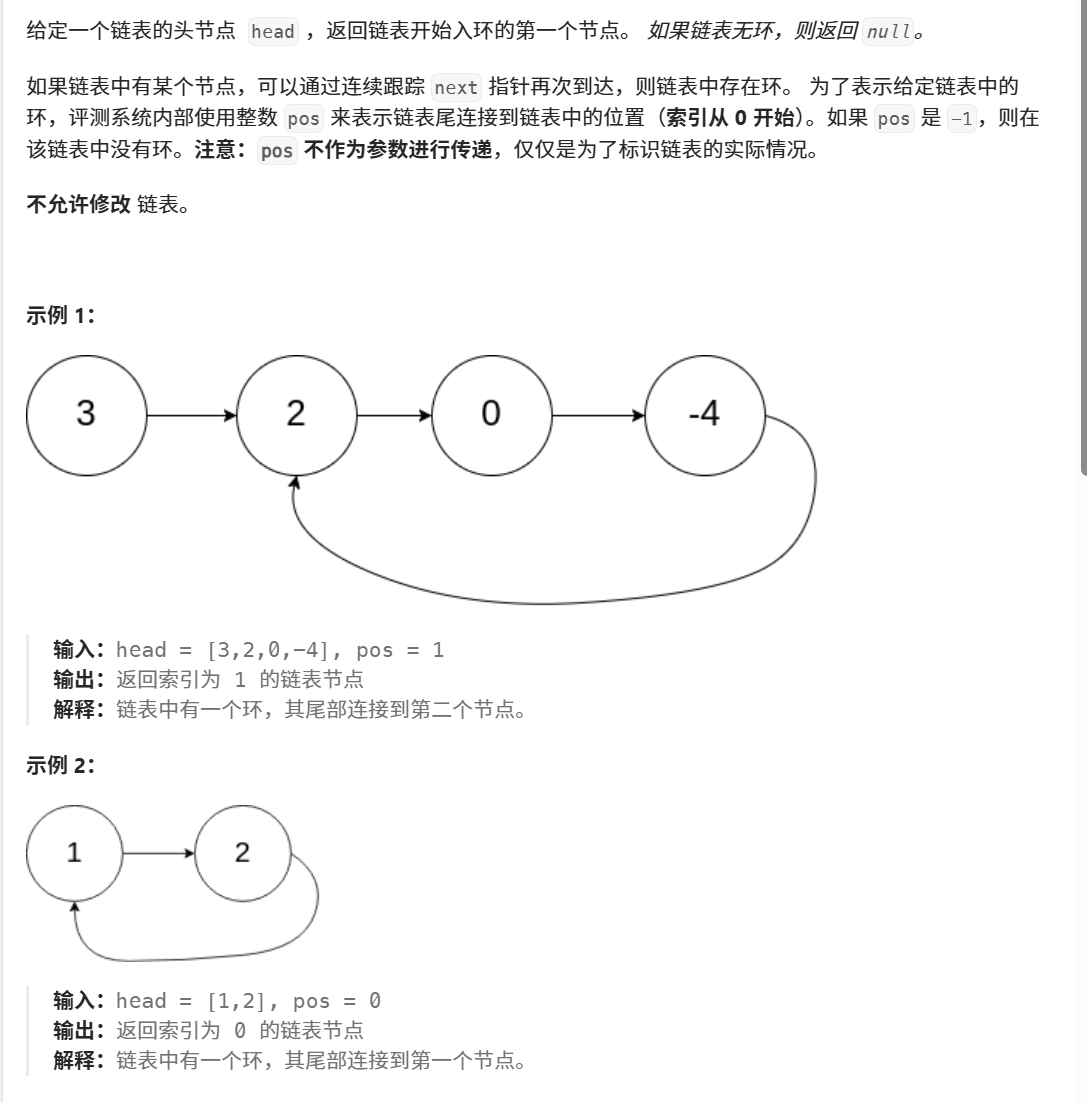
2.我们再提高点难度,如果我们要找到成环的起始点该怎么写?(()里的是速度)
先说结论:slow(1),fast(2),设一个指针meet,它指向slow与fast相遇的那个节点。
然后我们让slow(1)从头开始走,同时meet(1)从相遇点开始走,它们会在成环起始节点相遇。
struct ListNode *detectCycle(struct ListNode *head)
{
    if(!head)
        return NULL;
    struct ListNode *slow = head;
    struct ListNode *fast = head;
    struct ListNode *cur = head;
    while(fast && fast->next)
    {
        slow = slow->next;
        fast = fast->next->next;
        if(slow == fast)
        {
            cur = slow;
            break;
        }
    }
    if(!fast || !fast->next)
        return NULL;
    slow = head;
    while(slow != cur)
    {
        slow = slow->next;
        cur = cur->next;
    }
    return cur;
}
题目:https://leetcode-cn.com/problems/linked-list-cycle-ii/description/
那为什么呢?
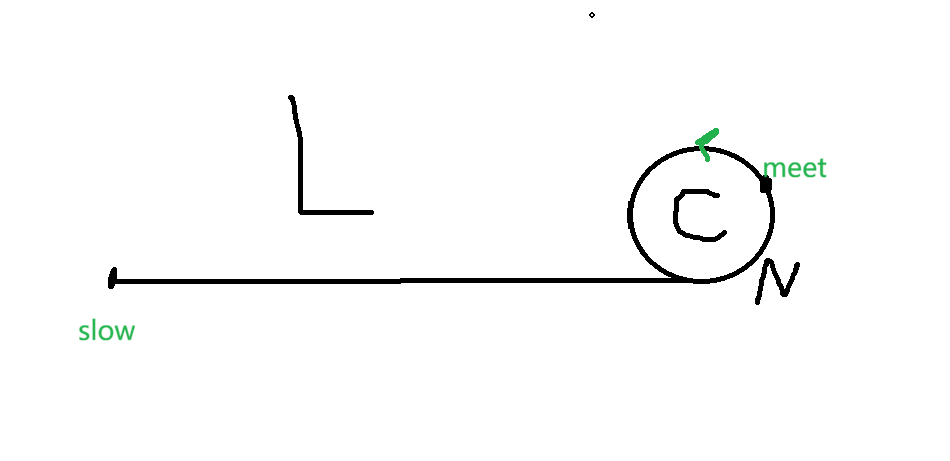
如图,我们设相遇点距成环起始节点(C-N).
从slow与fast开始走到相遇的过程:
注意: slow进环后,在其走一圈之前,fast一定能追上它,因为slow与fast的相对速度为1,它们不可能错过,如果在相遇前slow走了1圈,fast就走了2圈,这显然不可能成立。
slow:L + N
fast:L + xC + N = 2(L + N)
等量关系:L = xC - N = (x - 1)*C + C- N
meet和slow 同时开始走:
S(meet) = S(slow) = L = (x - 1)*C + C- N;
可以看出meet与slow同时到达了成环起始点。
五.链表的深拷贝
题目:https://leetcode-cn.com/problems/copy-list-with-random-pointer/description/
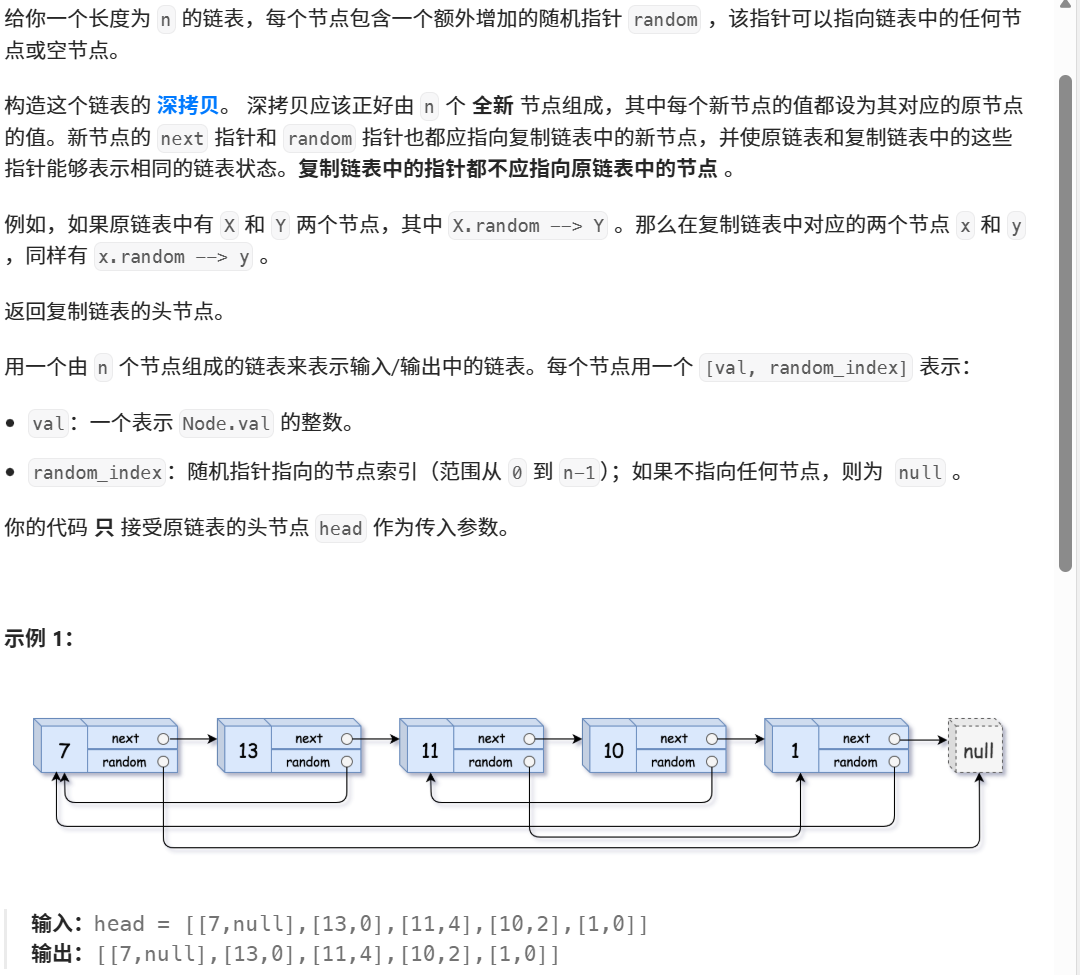
每个节点内有:
/**
 * Definition for a Node.
 * struct Node {
 *     int val;
 *     struct Node *next;
 *     struct Node *random;
 * };
 */
我们可以看出这题的难点在random指向的节点位于链表中的什么位置。这里有一个非常巧妙的思路:
1.我们可以在每个原节点的后面创建一个所含内容(除random外)与其一样的节点,并将random置为NULL。
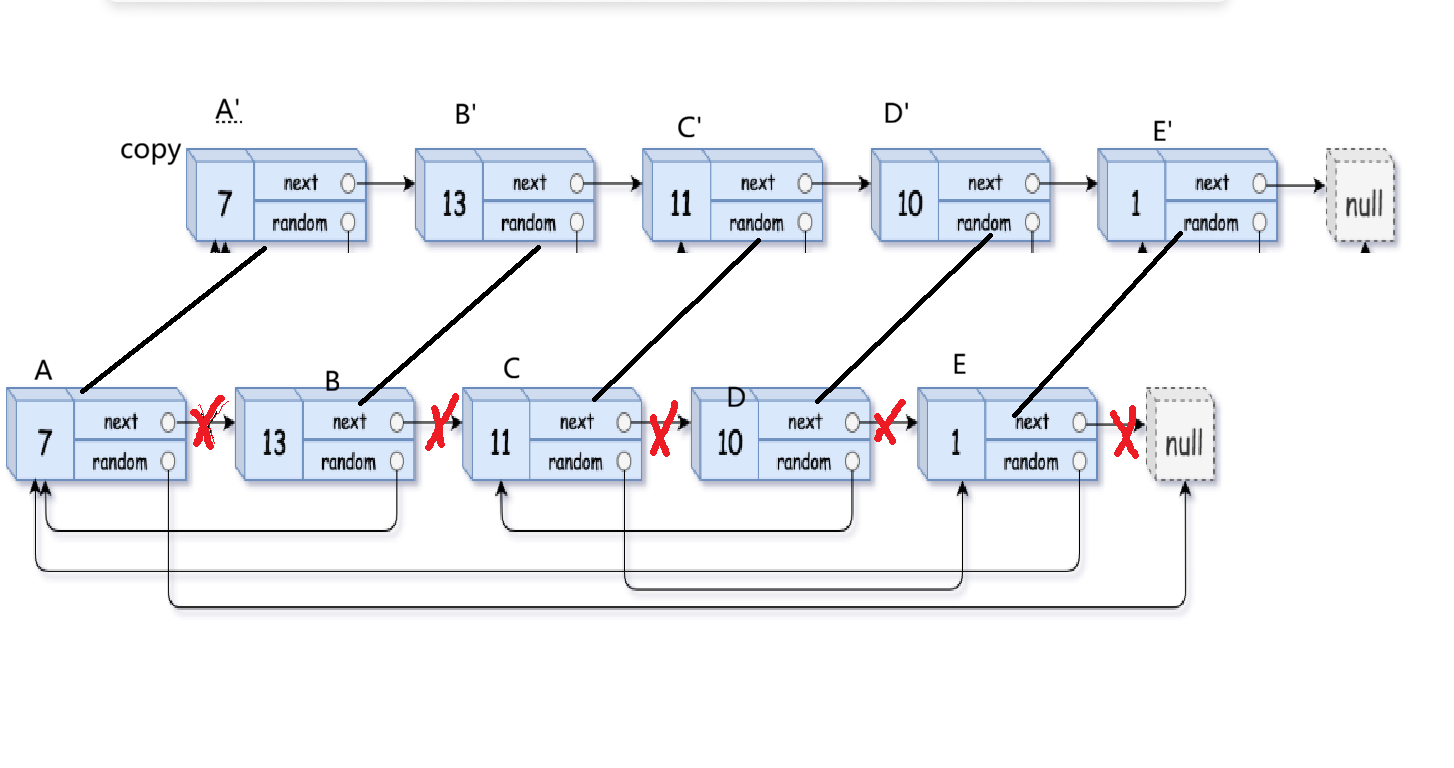
2.对复制的random进行赋值:
i. 如果原链表中的一个节点中的random为NULL,则其对应的复制节点的random也应为NULL;
ii. 如果不为空,如果原节点中的random指向的节点在原链表中是第pos(相对与头节点)个,那么该节点所对于的复制节点中的random应该指向复制链表中的第pos个。
例如上图中:
B->random == A, 那么B’->random == A’;
这时候,我们将复制节点放在原节点后面的行为就极大的便利了这一步:
B’->random == A’等价于B->next->random = B->random->next
    //处理复制节点的random
    cur = head;//指向原链表的头节点
    struct Node* newhead = cur->next;
    struct Node* newcur = newhead;//指向复制链表的头节点
    while(cur)
    {
        if(cur->random)
            newcur->random = cur->random->next;
        else
            newcur->random = NULL;
        cur = newcur->next;
        if(cur)
            newcur = cur->next;
    }
3.最后,复制节点中只有next需要修改,也就是说我们这里需要把复制链表分离出来
    //分离两个链表
    cur = head;
    newcur = newhead;
    while(cur)
    {
        cur->next = newcur->next;
        cur = cur->next;
        if(cur)
        {
            newcur->next = cur->next;
            newcur = newcur->next;
        }
        else
            newcur->next = NULL;
    }
总代码:
struct Node* copyRandomList(struct Node* head)
{
    if(!head)
        return NULL;
    struct Node* cur = head;
    while(cur)//将原链表节点的复制节点放在原链表节点后,这样找到random后可迅速找到复制后对应的random
    {
        struct Node* newnode = (struct Node*)malloc(sizeof(struct Node));
        newnode->next = cur->next;
        newnode->val = cur->val;
        newnode->random = NULL;
        cur->next = newnode;
        cur = newnode->next;
    }
    //处理复制节点的random
    cur = head;//指向原链表的头节点
    struct Node* newhead = cur->next;
    struct Node* newcur = newhead;//指向复制链表的头节点
    while(cur)
    {
        if(cur->random)
            newcur->random = cur->random->next;
        else
            newcur->random = NULL;
        cur = newcur->next;
        if(cur)
            newcur = cur->next;
    }
    //分离两个链表
    cur = head;
    newcur = newhead;
    while(cur)
    {
        cur->next = newcur->next;
        cur = cur->next;
        if(cur)
        {
            newcur->next = cur->next;
            newcur = newcur->next;
        }
        else
            newcur->next = NULL;
    }
    return newhead;

}

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)