数据结构 —— 树
一、树中的基本概念
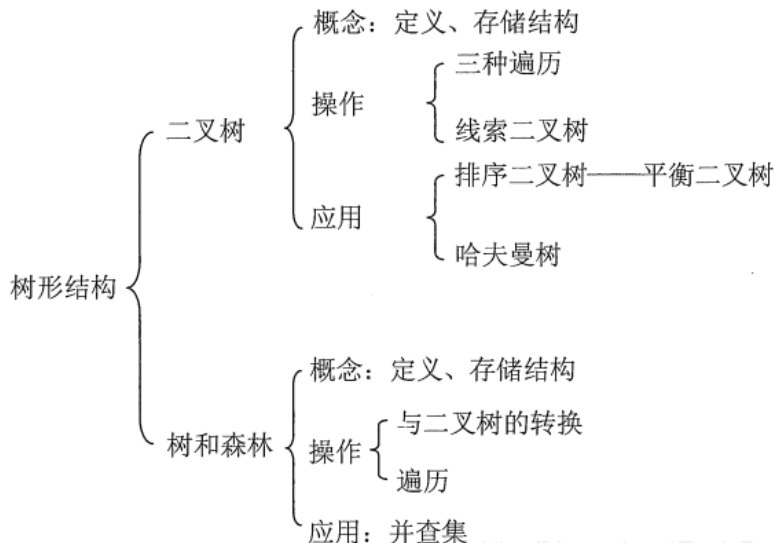
1.树的基本定义
树是有 n(n>=0)个结点的有限集。当n = 0时,称为空树。在任意一棵非空树中应满足:
- 有且仅有一个特定的称为根的结点。
- 当n>1时,其余节点可分为m(m>0)个互不相交的有限集T1,T2,…,Tm,其中每个集合本身又是一棵树,并且称为根的子树。
由于树在定义时又用到了树的定义,所以树是一种递归的数据结构。
树作为一种逻辑结构,同时也是一种分层结构,具有以下两个特点:
- 树的根结点没有前驱,除根结点外的所有结点有且只有一个前驱。
- 树中所有结点可以有零个或多个后继。
对于含有 n 个结点的树,有 n-1 条边。
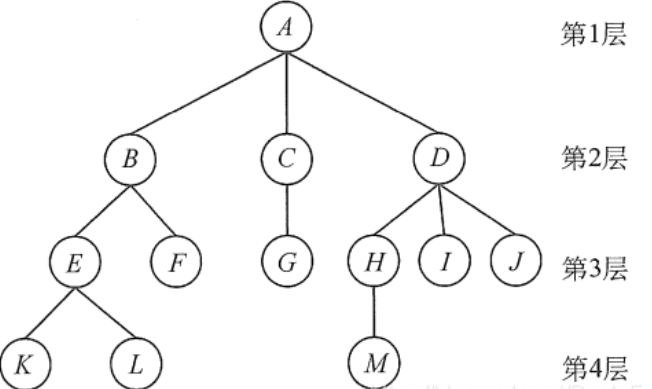
2.树中的术语
- 如根A到结点K的唯一路径上的任意结点,称为结点K的祖先。如结点B是结点K的祖先,而结点K是结点B的子孙。路径上最接近结点K的结点E称为K的双亲,而K为结点E的孩子。根A是树中唯一没有双亲的结点。有相同双亲的结点称为兄弟,如结点K和结点L有相同的双亲E,即K和L为兄弟。
- 度(Degree):树中一个结点的孩子个数称为该结点的度,树中结点的最大度数称为树的度。如结点B的度为2,结点D的度为3,树的度为3。
- 度大于0的结点称为分支结点(又称非终端结点);度为0(没有子女结点)的结点称为叶子结点(又称终端结点)。在分支结点中,每个结点的分支数就是该结点的度。
- 结点的层次从树根开始定义,根结点为第1层,它的子结点为第2层,以此类推。双亲在同一层的结点互为堂兄弟。图中结点G与E,F,H,I,J互为堂兄弟。
- 深度(Depth):从根结点开始自顶向下逐层累加的边数。
- 高度(Height):从叶结点开始自底向上逐层累加的边数。
- 树的高度(或深度)是树中结点的最大层数。图中树的高度为4。
- 节点(Node):树的基本单位,包含数据和指向子节点的引用。
- 根节点(Root):树的顶层节点,没有父节点。
- 叶子节点(Leaf):没有子节点的节点。
- 父节点(Parent):具有子节点的节点。
- 子节点(Child):被父节点指向的节点。
- 兄弟节点(Sibling):具有相同父节点的节点。
- 子树(Subtree):以某个节点为根的树。
- 有序树和无序树:树中结点的各子树从左到右是有次序的,不能互换,称该树为有序树,否则称为无序树。假设图为有序树,若将子结点位置互换,则变成一棵不同的树。
- 路径和路径长度:树中两个结点之间的路径是由这两个结点之间所经过的结点序列构成的,而路径长度是路径上所经过的边的个数。
注意:由于树中的分支是有向的,即从双亲指向孩子,所以树中的路径是从上向下的,同一双亲的两个孩子之间不存在路径。 - 森林:森林是m (m≥0)棵互不相交的树的集合。森林的概念与树的概念十分相近,因为只要把树的根结点删去就成了森林。反之,只要给m棵独立的树加上一个结点,并把这m棵树作为该结点的子树,则森林就变成了树。
3.树的基本性质
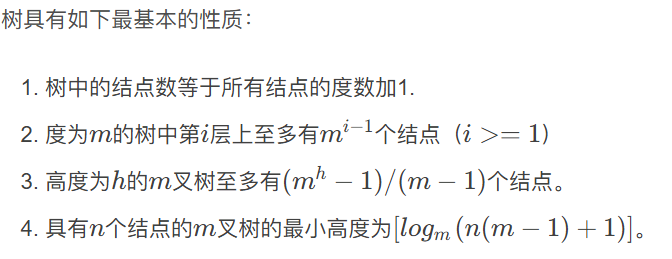
二叉树的性质:
1.二叉树第 i 层至多有 2^i(i>=0) 个节点
2.深度为 k 的二叉树至多有 2^(k+1) - 1 个节点(k ≥ -1,空树深度为-1)
3.对于任何非空的二叉树,叶子节点数总比度为2的节点数多1。即:
n0 = n2 + 1
4.具有 n 个节点的完全二叉树的深度为 ⌊log₂n⌋(向下取整符)。
二、树的存储结构
一、双亲表示法(Parent Representation)
我们假设用一组连续空间存储树的结点,同时在每个结点中,附设一个指示器指示其双亲结点在链表中的位置。也就是说,每个结点除了知道自已是谁以外,还知道它的双亲在哪里。
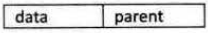
其中data是数据域,存储结点的数据信息。而parent是指针域,存储该结点的双亲在数组中的下标。
1. 代码实现:
import java.util.ArrayList;
import java.util.List;

/**
 * 树的双亲表示法实现
 * @param <T> 节点数据类型
 */
        public class ParentTree<T> {
            // 节点类:存储数据和父节点索引
            private static class Node<T> {
                T data;       // 节点数据
                int parent;   // 父节点索引,根节点为-1

                public Node(T data, int parent) {
                    this.data = data;
                    this.parent = parent;
                }

                @Override
                public String toString() {
                    return data + "(" + parent + ")";
                }
            }

            private List<Node<T>> nodes;  // 存储所有节点的数组
            private int root;             // 根节点索引
            private int size;             // 节点数量

            // 初始化树,指定根节点数据
            public ParentTree(T rootData) {
                nodes = new ArrayList<>();
                // 添加根节点,其父索引为-1
                nodes.add(new Node<>(rootData, -1));
                root = 0;
                size = 1;
            }

            // 添加节点:指定数据和父节点索引
            public void addNode(T data, int parentIndex) {
                if (parentIndex < 0 || parentIndex >= size) {
                    throw new IndexOutOfBoundsException("父节点索引无效");
                }
                nodes.add(new Node<>(data, parentIndex));
                size++;
            }

            // 获取节点数据
            public T getNodeData(int index) {
                if (index < 0 || index >= size) {
                    throw new IndexOutOfBoundsException("节点索引无效");
                }
                return nodes.get(index).data;
            }

            // 查找指定节点的父节点索引
            public int findParent(int index) {
                if (index < 0 || index >= size) {
                    throw new IndexOutOfBoundsException("节点索引无效");
                }
                return nodes.get(index).parent;
            }

            // 查找指定节点的所有子节点索引
            public List<Integer> findChildren(int parentIndex) {
                if (parentIndex < 0 || parentIndex >= size) {
                    throw new IndexOutOfBoundsException("父节点索引无效");
                }

                List<Integer> children = new ArrayList<>();
                // 遍历所有节点,找到父索引为parentIndex的节点
                for (int i = 0; i < size; i++) {
                    if (nodes.get(i).parent == parentIndex) {
                        children.add(i);
                    }
                }
                return children;
            }

            // 获取树的大小
            public int size() {
                return size;
            }

            // 打印树结构
            public void printTree() {
                System.out.println("双亲表示法树结构(索引: 数据(父索引)):");
                for (int i = 0; i < size; i++) {
                    System.out.println(i + ": " + nodes.get(i));
                }

                // 打印层级关系
                System.out.println("\n树的层级结构:");
                printSubTree(root, 0);
            }

            // 递归打印子树
            private void printSubTree(int index, int depth) {
                // 打印缩进
                for (int i = 0; i < depth; i++) {
                    System.out.print("  ");
                }
                System.out.println("|-- " + nodes.get(index).data);

                // 递归打印所有子节点
                List<Integer> children = findChildren(index);
                for (int child : children) {
                    printSubTree(child, depth + 1);
                }
            }

            // 测试
            public static void main(String[] args) {
                // 创建树,根节点为"根"
                ParentTree<String> tree = new ParentTree<>("根");

                // 添加节点:子节点1(父索引0)
                tree.addNode("子节点1", 0);
                // 添加节点:子节点2(父索引0)
                tree.addNode("子节点2", 0);
                // 添加节点:子节点1-1(父索引1)
                tree.addNode("子节点1-1", 1);
                // 添加节点:子节点1-2(父索引1)
                tree.addNode("子节点1-2", 1);
                // 添加节点:子节点2-1(父索引2)
                tree.addNode("子节点2-1", 2);

                // 打印树
                tree.printTree();

                // 查找子节点1的所有子节点
                System.out.println("\n子节点1的子节点索引:" + tree.findChildren(1));
                // 查找子节点1-1的父节点
                System.out.println("子节点1-1的父节点索引:" + tree.findParent(3));
            }
        }
2.代码分析:
- 用一个数组存储所有节点,每个节点包含数据和父节点的索引;
- 根节点的父索引为 - 1(表示无父节点);
- 优点:查找父节点效率高(O (1));
- 缺点:查找子节点效率低(O (n)),适合频繁查找父节点的场景。
- 适合场景:频繁查找父节点,如并查集(Union-Find)数据结构。
二、孩子表示法(Children Representation)
把每个节点的孩子节点排列起来,以单链表作存储结构,则n个结点有n个孩子链表,如果是叶子结点则此单链表为空。然后n个头指针又组成一个线性表,采用顺序存储结构,存放进一个一维数组中,如图所示。
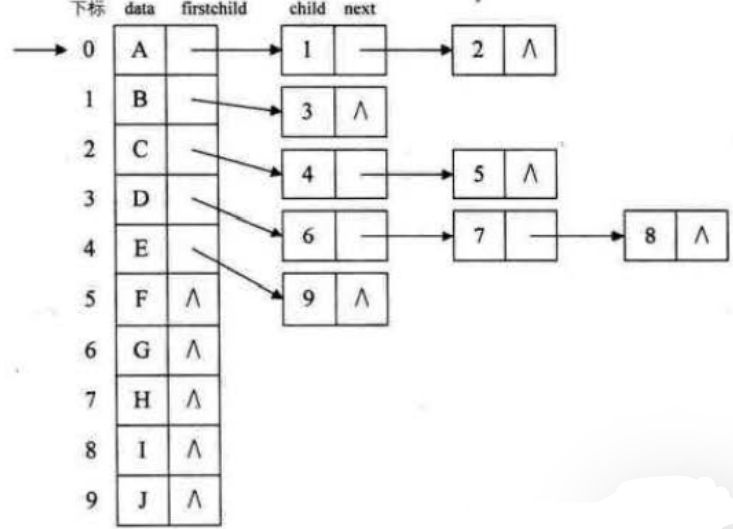
这里可以有两种节点的设计方式:
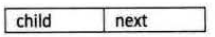
其中child是数据域,用来存储某个结点在表头数组中的下标。next 是指针域,用来存储指向某结点的下一个孩子结点的指针。
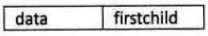
其中data是数据域,存储某结点的数据信息。firstchild 是头指针域,存储该结点的孩子链表的头指针。
在下面的代码中用的是第二种方法
1.代码实现:
import java.util.ArrayList;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;

/**
 * 树的孩子表示法实现
 * @param <T> 节点数据类型
 */
        public class ChildrenTree<T> {
            // 节点类:存储数据和子节点链表
            private static class Node<T> {
                T data;                      // 节点数据
                List<Integer> children;      // 子节点索引列表

                public Node(T data) {
                    this.data = data;
                    this.children = new LinkedList<>();  // 链表存储子节点索引
                }

                @Override
                public String toString() {
                    return data.toString();
                }
            }

            private List<Node<T>> nodes;  // 存储所有节点的数组
            private int root;             // 根节点索引
            private int size;             // 节点数量

            // 初始化树,指定根节点数据
            public ChildrenTree(T rootData) {
                nodes = new ArrayList<>();
                nodes.add(new Node<>(rootData));
                root = 0;
                size = 1;
            }

            // 添加节点:返回新节点的索引
            public int addNode(T data) {
                nodes.add(new Node<>(data));
                size++;
                return size - 1;  // 返回新节点的索引
            }

            // 为指定父节点添加子节点
            public void addChild(int parentIndex, int childIndex) {
                if (parentIndex < 0 || parentIndex >= size ||
                        childIndex < 0 || childIndex >= size ||
                        parentIndex == childIndex) {
                    throw new IndexOutOfBoundsException("节点索引无效");
                }
                // 将子节点索引添加到父节点的子节点列表
                nodes.get(parentIndex).children.add(childIndex);
            }

            // 获取节点数据
            public T getNodeData(int index) {
                if (index < 0 || index >= size) {
                    throw new IndexOutOfBoundsException("节点索引无效");
                }
                return nodes.get(index).data;
            }

            // 查找指定节点的所有子节点索引
            public List<Integer> findChildren(int parentIndex) {
                if (parentIndex < 0 || parentIndex >= size) {
                    throw new IndexOutOfBoundsException("节点索引无效");
                }
                return new ArrayList<>(nodes.get(parentIndex).children);
            }

            // 查找指定节点的父节点索引
            public int findParent(int childIndex) {
                if (childIndex < 0 || childIndex >= size) {
                    throw new IndexOutOfBoundsException("节点索引无效");
                }
                if (childIndex == root) {
                    return -1;  // 根节点无父节点
                }

                // 遍历所有节点,查找包含childIndex的父节点
                for (int i = 0; i < size; i++) {
                    if (nodes.get(i).children.contains(childIndex)) {
                        return i;
                    }
                }
                return -1;  // 未找到(理论上不会发生)
            }

            // 获取树的大小
            public int size() {
                return size;
            }

            // 打印树结构
            public void printTree() {
                System.out.println("孩子表示法树结构:");
                for (int i = 0; i < size; i++) {
                    Node<T> node = nodes.get(i);
                    System.out.print(i + ": " + node.data + " -> 子节点:");
                    if (node.children.isEmpty()) {
                        System.out.println("无");
                    } else {
                        for (int child : node.children) {
                            System.out.print(child + "(" + nodes.get(child).data + ") ");
                        }
                        System.out.println();
                    }
                }

                // 打印层级结构
                System.out.println("\n树的层级结构:");
                printSubTree(root, 0);
            }

            // 递归打印子树
            private void printSubTree(int index, int depth) {
                // 打印缩进
                for (int i = 0; i < depth; i++) {
                    System.out.print("  ");
                }
                System.out.println("|-- " + nodes.get(index).data);

                // 递归打印所有子节点
                List<Integer> children = findChildren(index);
                for (int child : children) {
                    printSubTree(child, depth + 1);
                }
            }

            // 测试
            public static void main(String[] args) {
                // 创建树,根节点为"根"
                ChildrenTree<String> tree = new ChildrenTree<>("根");

                // 添加节点并获取索引
                int child1 = tree.addNode("子节点1");
                int child2 = tree.addNode("子节点2");
                int child11 = tree.addNode("子节点1-1");
                int child12 = tree.addNode("子节点1-2");
                int child21 = tree.addNode("子节点2-1");

                // 建立父子关系
                tree.addChild(0, child1);    // 根 -> 子节点1
                tree.addChild(0, child2);    // 根 -> 子节点2
                tree.addChild(child1, child11);  // 子节点1 -> 子节点1-1
                tree.addChild(child1, child12);  // 子节点1 -> 子节点1-2
                tree.addChild(child2, child21);  // 子节点2 -> 子节点2-1

                // 打印树
                tree.printTree();

                // 查找子节点1的所有子节点
                System.out.println("\n子节点1的子节点索引:" + tree.findChildren(child1));
                // 查找子节点1-1的父节点
                System.out.println("子节点1-1的父节点索引:" + tree.findParent(child11));
            }
        }
2.代码分析:
- 用数组存储所有节点,每个节点包含数据和指向子节点链表的引用;
- 每个节点的子节点通过链表连接,便于添加和删除子节点;
- 优点:查找子节点效率高(直接访问链表);
- 缺点:查找父节点效率低(需遍历所有节点的子节点链表),适合频繁操作子节点的场景。
- 适合场景:频繁操作子节点,如多叉树的遍历、菜单结构等。
三、孩子兄弟表示法(Children-Sibling Representation)
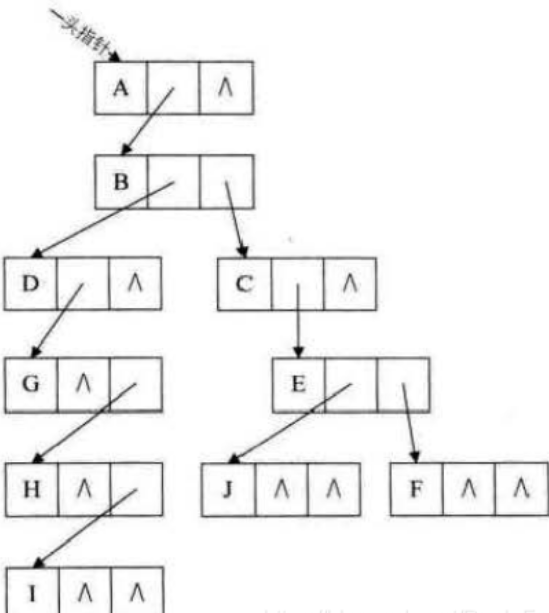
对于树这样的层级结构来说,只研究结点的兄弟是不行的,我们观察后发现,任意一棵树, 它的结点的第一个孩子如果存在就是唯一的,它的右兄弟如果存在也是唯一的。 因此,我们设置两个指针,分别指向该结点的第一个孩子和此结点的右兄弟。
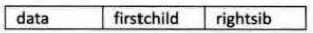
data是数据域,firstchild 为指针域,存储该结点的第一个孩子结点的存储地址,rightsib 是指针域,存储该结点的右兄弟结点的存储地址。
下图为变换结构:
1.代码实现
package 正则表达式.Exercise;

import java.util.ArrayList;
import java.util.List;

/**
 * 树的孩子兄弟表示法实现(左孩子右兄弟)
 * @param <T> 节点数据类型
 */
public class ChildSiblingTree<T> {
    // 节点类:左孩子右兄弟表示
    private static class Node<T> {
        T data;               // 节点数据
        Node<T> firstChild;   // 指向第一个子节点
        Node<T> nextSibling;  // 指向右兄弟节点

        public Node(T data) {
            this.data = data;
            this.firstChild = null;
            this.nextSibling = null;
        }

        @Override
        public String toString() {
            return data.toString();
        }
    }

    private Node<T> root;  // 根节点
    private int size;      // 节点数量

    // 初始化树,指定根节点数据
    public ChildSiblingTree(T rootData) {
        this.root = new Node<>(rootData);
        this.size = 1;
    }

    // 获取根节点
    public Node<T> getRoot() {
        return root;
    }

    // 为指定父节点添加子节点
    public Node<T> addChild(Node<T> parent, T data) {
        if (parent == null) {
            throw new IllegalArgumentException("父节点不能为空");
        }

        Node<T> newNode = new Node<>(data);
        size++;

        // 如果父节点没有子节点,直接作为第一个子节点
        if (parent.firstChild == null) {
            parent.firstChild = newNode;
        } else {
            // 否则找到最后一个子节点,添加为其右兄弟
            Node<T> lastChild = parent.firstChild;
            while (lastChild.nextSibling != null) {
                lastChild = lastChild.nextSibling;
            }
            lastChild.nextSibling = newNode;
        }

        return newNode;
    }

    // 获取节点数据
    public T getNodeData(Node<T> node) {
        if (node == null) {
            return null;
        }
        return node.data;
    }

    // 查找指定节点的所有子节点
    public List<Node<T>> findChildren(Node<T> parent) {
        List<Node<T>> children = new ArrayList<>();
        if (parent == null) {
            return children;
        }

        Node<T> child = parent.firstChild;
        while (child != null) {
            children.add(child);
            child = child.nextSibling;  // 遍历所有兄弟节点
        }
        return children;
    }

    // 获取树的大小
    public int size() {
        return size;
    }

    // 前序遍历:根 -> 子节点(递归)
    public List<T> preOrderTraversal() {
        List<T> result = new ArrayList<>();
        preOrder(root, result);
        return result;
    }

    private void preOrder(Node<T> node, List<T> result) {
        if (node == null) {
            return;
        }
        result.add(node.data);  // 访问当前节点
        preOrder(node.firstChild, result);  // 遍历子节点
        preOrder(node.nextSibling, result);  // 遍历兄弟节点
    }

    // 层次遍历
    public List<T> levelOrderTraversal() {
        List<T> result = new ArrayList<>();
        if (root == null) {
            return result;
        }

        // 使用队列存储每一层的节点
        java.util.Queue<Node<T>> queue = new java.util.LinkedList<>();
        queue.add(root);

        while (!queue.isEmpty()) {
            Node<T> node = queue.poll();
            result.add(node.data);

            // 将所有子节点加入队列(通过firstChild和nextSibling遍历)
            Node<T> child = node.firstChild;
            while (child != null) {
                queue.add(child);
                child = child.nextSibling;
            }
        }

        return result;
    }

    // 打印树结构
    public void printTree() {
        System.out.println("孩子兄弟表示法树结构:");
        printSubTree(root, 0);
    }

    // 递归打印子树
    private void printSubTree(Node<T> node, int depth) {
        if (node == null) {
            return;
        }

        // 打印缩进
        for (int i = 0; i < depth; i++) {
            System.out.print("  ");
        }
        System.out.println("|-- " + node.data);

        // 先打印子节点(深度+1),再打印兄弟节点(深度不变)
        printSubTree(node.firstChild, depth + 1);
        printSubTree(node.nextSibling, depth);
    }

    // 测试
    public static void main(String[] args) {
        // 创建树,根节点为"根"
        ChildSiblingTree<String> tree = new ChildSiblingTree<>("根");

        // 获取根节点
        ChildSiblingTree.Node<String> root = tree.getRoot();

        // 为根节点添加子节点
        ChildSiblingTree.Node<String> child1 = tree.addChild(root, "子节点1");
        ChildSiblingTree.Node<String> child2 = tree.addChild(root, "子节点2");

        // 为子节点1添加子节点
        tree.addChild(child1, "子节点1-1");
        tree.addChild(child1, "子节点1-2");

        // 为子节点2添加子节点
        ChildSiblingTree.Node<String> child21 = tree.addChild(child2, "子节点2-1");
        tree.addChild(child21, "子节点2-1-1");

        // 打印树
        tree.printTree();

        // 遍历树
        System.out.println("\n前序遍历:" + tree.preOrderTraversal());
        System.out.println("层次遍历:" + tree.levelOrderTraversal());

        // 查找子节点1的所有子节点
        List<ChildSiblingTree.Node<String>> children = tree.findChildren(child1);
        System.out.println("\n子节点1的子节点:" + children);
    }
}
2.代码分析:
- 每个节点包含三个部分:数据、指向第一个子节点的引用、指向右兄弟节点的引用;
- 左指针(firstChild)指向该节点的第一个子节点;
- 右指针(nextSibling)指向该节点的右兄弟节点;
- 优点:将多叉树转换为二叉树,可复用二叉树的算法(如遍历);
- 缺点:理解稍复杂,适合需要高效遍历和操作的场景。
- 适合场景:多叉树与二叉树的转换、表达式树、语法树等复杂结构。
三、二叉树(Binary Tree)
一、二叉树的概念
二叉树是另一种树形结构,其特点是每个结点至多只有两棵子树( 即二叉树中不存在度大于2的结点),并且二叉树的子树有左右之分,其次序不能任意颠倒。
与树相似,二叉树也以递归的形式定义。二叉树是n (n≥0) 个结点的有限集合:
或者为空二叉树,即n=0。
或者由一个根结点和两个互不相交的被称为根的左子树和右子树组成。左子树和右子树又分别是一棵二叉树。
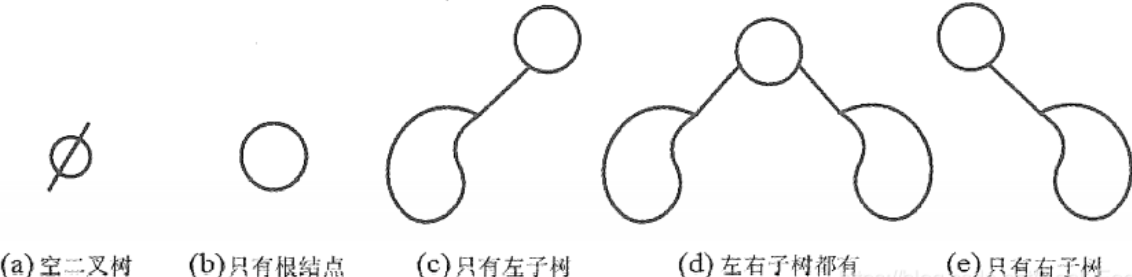
二叉树是有序树,若将其左、右子树颠倒,则成为另一棵不同的二叉树。即使树中结点只有一棵子树,也要区分它是左子树还是右子树。二叉树的5种基本形态如图所示。
二、特殊的二叉树
(1)斜树
所有的结点都只有左子树的二叉树叫左斜树。所有结点都是只有右子树的二叉树叫右斜树。这两者统称为斜树。
(2)满二叉树
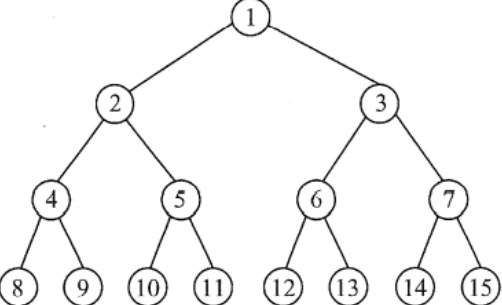
一棵高度为 h 且含有 2^h - 1 个结点的二叉树称为满二叉树,即树中的每层都含有最多的结点。满二叉树的叶子结点都集中在二叉树的最下一层,并且除叶子结点之外的每个结点度数均为 2。可以对满二叉树按层序编号:约定编号从根结点(根结点编号为 1)起,自上而下,自左向右。这样,每个结点对应一个编号,对于编号为i的结点,若有双亲,则其双亲为 i/2 ,若有左孩子,则左孩子为 2i ;若有右孩子,则右孩子为 2i + 1。
(3)完全二叉树
高度为 h、有 n 个结点的二叉树,当且仅当其每个结点都与高度为 h 的满二叉树中编号为1~n 的结点一一对应时,称为完全二叉树,如图所示。其特点如下:
1. 若 i ≤ n/2, 则结点 i 为分支结点,否则为叶子结点。
2. 叶子结点只可能在层次最大的两层上出现。对于最大层次中的叶子结点,都依次排列在该层最左边的位置上。
3. 若有度为1的结点,则只可能有一个,且该结点只有左孩子而无右孩子(重要特征)。
4. 按层序编号后,一旦出现某结点(编号为i)为叶子结点或只有左孩子,则编号大于i的结点均为叶子结点。
5. 若 n 为奇数,则每个分支结点都有左孩子和右孩子;若 n 为偶数,则编号最大的分支结点(编号为 n/2 )只有左孩子,没有右孩子,其余分支结点左、右孩子都有。
(4)二叉排序树
左子树上所有结点的关键字(数值)均小于根结点的关键字(数值);右子树上的所有结点的关键字(数值)均大于根结点的关键字(数值);左子树和右子树又各是一棵二叉排序树。
(5)平衡二叉树(最优二叉树)
树上任一结点的左子树和右子树的深度之差不超过1。
三、二叉树的性质
1. 任意一棵树,若结点数量为 n ,则边的数量为 n − 1。
2. 非空二叉树上的叶子结点数等于度为 2 的结点数加 1 ,即 no = n2 +1。
3. 非空二叉树上第 k 层上至多有 2^(k−1)个结点(k ≥ 1)。
4. 高度为 h 的二叉树至多有 2^h − 1个结点 (h ≥ 1)。
5. 对完全二叉树按从上到下、从左到右的顺序依次编号1, 2,...... , n ,则有以下关系:
i > 1 时,结点 i 的双亲的编号为 i/2,即当 i 为偶数时, 它是双亲的左孩子;当 i 为奇数时,它是双亲的右孩子。
当 2i ≤ n 时,结点 i 的左孩子编号为 2i , 否则无左孩子。
当 2i+1 ≤ n时,结点 i 的右孩子编号为 2i + 1,否则无右孩子。
结点 i 所在层次(深度)为 ⌊log₂i⌋ + 1。
6. 具有 n 个(n > 0) 结点的完全二叉树的高度为 ⌊log₂n⌋ + 1。
四、二叉树的存储结构
1.顺序存储结构
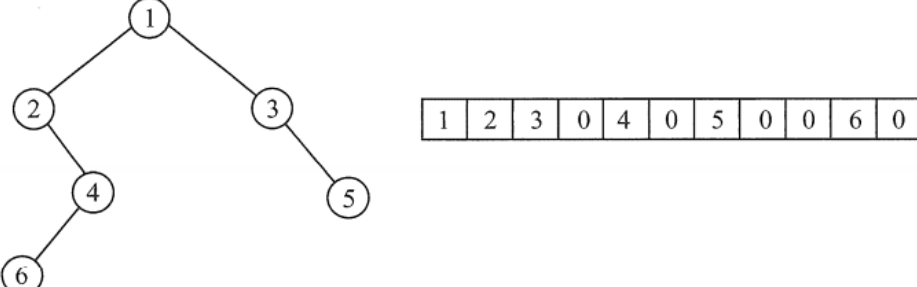
二叉树的顺序存储是指用一组地址连续的存储单元依次自上而下、自左至右存储完全二叉树上的结点元素,即将完全二叉树上编号为 i 的结点元素存储在一维数组下标为 i−1 的分量中。
依据二叉树的性质,完全二叉树和满二叉树采用顺序存储比较合适,树中结点的序号可以唯一地反映结点之间的逻辑关系,这样既能最大可能地节省存储空间,又能利用数组元素的下标值确定结点在二叉树中的位置,以及结点之间的关系。
但对于一般的二叉树,为了让数组下标能反映二叉树中结点之间的逻辑关系,只能添加一些并不存在的空结点,让其每个结点与完全二叉树上的结点相对照,再存储到一维数组的相应分量中。然而,在最坏情况下,一个高度为 h 且只有 h 个结点的单支树却需要占据近 2h − 1 个存储单元。二叉树的顺序存储结构如图所示,其中0表示并不存在的空结点。
代码实现:
import java.util.ArrayList;
import java.util.List;

/**
 * 二叉树的顺序存储结构(数组实现)
 * 适合完全二叉树,非完全二叉树会浪费空间
 */
public class SequentialBinaryTree<T> {
    // 用ArrayList存储节点,支持动态扩容(避免数组固定长度的局限)
    private List<T> tree;

    // 1. 初始化:空二叉树
    public SequentialBinaryTree() {
        this.tree = new ArrayList<>();
    }

    // 2. 插入节点(按层序插入,从左到右填充)
    public void insert(T data) {
        if (data == null) {
            throw new IllegalArgumentException("节点数据不能为null");
        }
        tree.add(data); // 直接添加到数组末尾,对应二叉树的最后一个位置
    }

    // 3. 获取根节点
    public T getRoot() {
        return tree.isEmpty() ? null : tree.get(0);
    }

    // 4. 根据父节点下标,获取左孩子节点
    public T getLeftChild(int parentIndex) {
        int leftChildIndex = 2 * parentIndex + 1;
        return (leftChildIndex < tree.size()) ? tree.get(leftChildIndex) : null;
    }

    // 5. 根据父节点下标,获取右孩子节点
    public T getRightChild(int parentIndex) {
        int rightChildIndex = 2 * parentIndex + 2;
        return (rightChildIndex < tree.size()) ? tree.get(rightChildIndex) : null;
    }

    // 6. 根据孩子节点下标,获取父节点
    public T getParent(int childIndex) {
        if (childIndex == 0) { // 根节点没有父节点
            return null;
        }
        int parentIndex = (childIndex - 1) / 2;
        return tree.get(parentIndex);
    }

    // 7. 层序遍历(直接遍历数组)
    public void levelOrderTraversal() {
        if (tree.isEmpty()) {
            System.out.println("二叉树为空");
            return;
        }
        System.out.print("层序遍历结果:");
        for (T data : tree) {
            System.out.print(data + " ");
        }
        System.out.println();
    }

    // 测试方法
    public static void main(String[] args) {
        SequentialBinaryTree<Integer> tree = new SequentialBinaryTree<>();
        // 插入节点:对应完全二叉树 [1,2,3,4,5,6]
        tree.insert(1);
        tree.insert(2);
        tree.insert(3);
        tree.insert(4);
        tree.insert(5);
        tree.insert(6);

        tree.levelOrderTraversal(); // 输出:1 2 3 4 5 6
        System.out.println("根节点:" + tree.getRoot()); // 1
        System.out.println("下标0(1)的左孩子:" + tree.getLeftChild(0)); // 2
        System.out.println("下标1(2)的父节点:" + tree.getParent(1)); // 1
        System.out.println("下标2(3)的右孩子:" + tree.getRightChild(2)); // 6
    }
}
结构分析:
- 用数组存储节点数据,根节点存在下标
0处。 - 对非完全二叉树,缺失的节点用
null(引用类型)或特殊值(基本类型)占位。 - 实现基础操作:初始化、插入节点、获取父 / 子节点、遍历(层序)。
2.链式存储结构
二叉树每个结点最多有两个孩子,所以为它设计一个数据域和两个指针域是比较自然的想法,我们称这样的链表叫做二叉链表。
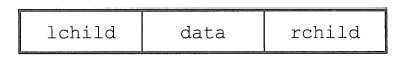
节点结构定义
typedef struct BiTNode{
TElemType data; //结点数据
struct BiTNode *lchild, *rchild;    //左右孩子指针
} BiTNode, *BiTree;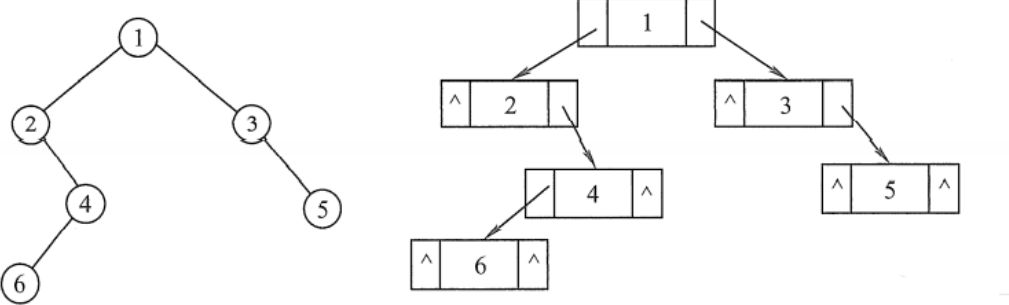
在含有 n 个结点的二叉链表中,含有 n + 1个空链域。
五、二叉树的遍历
二叉树的遍历( traversing binary tree )是指从根结点出发,按照某种次序依次访问二叉树中所有结点,使得每个结点被访问一次且仅被访问一次。
遍历测试代码
// 测试用例
public static void main(String[] args) {
    // 构建测试二叉树:
    //       1
    //      / \
    //     2   3
    //    / \   \
    //   4   5   6
    TreeNode root = new TreeNode(1);
    root.left = new TreeNode(2);
    root.right = new TreeNode(3);
    root.left.left = new TreeNode(4);
    root.left.right = new TreeNode(5);
    root.right.right = new TreeNode(6);

    BinaryTreeTraversal traversal = new BinaryTreeTraversal();

    System.out.println("递归前序遍历:");
    traversal.preOrderRecursive(root); // 1 2 4 5 3 6
    System.out.println("\n非递归前序遍历:");
    traversal.preOrderIterative(root);

    System.out.println("\n\n递归中序遍历:");
    traversal.inOrderRecursive(root); // 4 2 5 1 3 6
    System.out.println("\n非递归中序遍历:");
    traversal.inOrderIterative(root);

    System.out.println("\n\n递归后序遍历:");
    traversal.postOrderRecursive(root); // 4 5 2 6 3 1
    System.out.println("\n非递归后序遍历(双栈):");
    traversal.postOrderIterative1(root);
    System.out.println("\n非递归后序遍历(单栈):");
    traversal.postOrderIterative2(root);
}
}
1.先序遍历(中左右)
先序遍历(PreOrder) 的操作过程如下:
若二叉树为空,则什么也不做,否则,
1)访问根结点;
2)先序遍历左子树;
3)先序遍历右子树。
递归代码实现
// 1. 递归先序遍历
public void preOrderRecursive(TreeNode node) {
if (node == null) return;
System.out.print(node.val + " ");
preOrderRecursive(node.left);
preOrderRecursive(node.right);
}
非递归代码实现
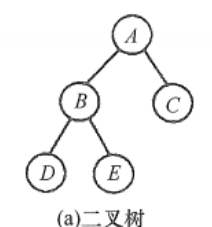
由此可得先序遍历的序列:ABDEC
// 4. 非递归先序遍历
public void preOrderIterative(TreeNode root) {
if (root == null) return;

Stack<TreeNode> stack = new Stack<>();
stack.push(root);

while (!stack.isEmpty()) {
    TreeNode node = stack.pop();
    System.out.print(node.val + " ");

    // 注意:先压右孩子,再压左孩子,保证左孩子先出栈
    if (node.right != null) {
        stack.push(node.right);
    }
    if (node.left != null) {
        stack.push(node.left);
    }
}
}
2.中序遍历(左中右)
中序遍历( InOrder)的操作过程如下:
若二叉树为空,则什么也不做,否则,
1)中序遍历左子树;
2)访问根结点;
3)中序遍历右子树。
递归代码实现
// 2. 递归中序遍历
public void inOrderRecursive(TreeNode node) {
if (node == null) return;
inOrderRecursive(node.left);
System.out.print(node.val + " ");
inOrderRecursive(node.right);
}
非递归代码实现
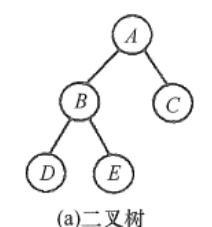
沿着根的左孩子,依次入栈,直到左孩子为空,说明已找到可以输出的结点,此时栈内元素依次为ABD。
栈顶元素出栈并访问:若其右孩子为空,继续执行步骤2;若其右孩子不为空,右子树执行步骤1。
栈顶D出栈并访问,它是中序序列的第一个结点; D右孩子为空,栈顶B出栈并访问; B右孩子不空,将其右孩子E入栈,E左孩子为空,栈顶E出栈并访问; E右孩子为空,栈顶A出栈并访问; A右孩子不空,将其右孩子C入栈,C左孩子为空,栈顶C出栈并访问。由此得到中序序列DBEAC。
// 5. 非递归中序遍历
public void inOrderIterative(TreeNode root) {
if (root == null) return;

Stack<TreeNode> stack = new Stack<>();
TreeNode current = root;

while (current != null || !stack.isEmpty()) {
    // 将所有左孩子入栈
    while (current != null) {
        stack.push(current);
        current = current.left;
    }

    current = stack.pop();
    System.out.print(current.val + " ");

    // 处理右子树
    current = current.right;
}
}
3.后序遍历(左右中)
后序遍历(PostOrder) 的操作过程如下:
若二叉树为空,则什么也不做,否则,
1)后序遍历左子树;
2)后序遍历右子树;
3)访问根结点。
递归代码实现
// 3. 递归后序遍历
public void postOrderRecursive(TreeNode node) {
if (node == null) return;
postOrderRecursive(node.left);
postOrderRecursive(node.right);
System.out.print(node.val + " ");
}
非递归代码实现
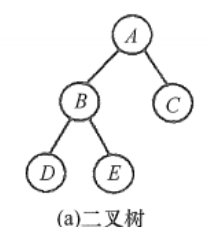
算法思想:后序非递归遍历二叉树是先访问左子树,再访问右子树,最后访问根结点。
- 沿着根的左孩子,依次入栈,直到左孩子为空。此时栈内元素依次为ABD。
- 读栈顶元素:若其右孩子不空且未被访问过,将右子树转执行①;否则,栈顶元素出栈并访问。
栈顶D的右孩子为空,出栈并访问,它是后序序列的第一个结点;栈顶B的右孩子不空且未被访问过,E入栈,栈顶E的左右孩子均为空,出栈并访问;栈顶B的右孩子不空但已被访问,B出栈并访问;栈项A的右孩子不空且未被访问过,C入栈,栈项C的左右孩子均为空,出栈并访问;栈顶A的右孩子不空但已被访问,A出栈并访问。由此得到后序序列DEBCA。
// 6. 非递归后序遍历(使用两个栈)
public void postOrderIterative1(TreeNode root) {
if (root == null) return;

Stack<TreeNode> stack1 = new Stack<>();
Stack<TreeNode> stack2 = new Stack<>();

stack1.push(root);

// 第一个栈弹出的节点压入第二个栈
while (!stack1.isEmpty()) {
    TreeNode node = stack1.pop();
    stack2.push(node);

    // 先压左孩子,再压右孩子
    if (node.left != null) {
        stack1.push(node.left);
    }
    if (node.right != null) {
        stack1.push(node.right);
    }
}

// 从第二个栈弹出即为后序遍历
while (!stack2.isEmpty()) {
    System.out.print(stack2.pop().val + " ");
}
}


// 7. 非递归后序遍历(使用一个栈)
public void postOrderIterative2(TreeNode root) {
    if (root == null) return;

    Stack<TreeNode> stack = new Stack<>();
    TreeNode current = root;
    TreeNode lastVisited = null;

    while (current != null || !stack.isEmpty()) {
        // 遍历到最左节点
        while (current != null) {
            stack.push(current);
            current = current.left;
        }

        current = stack.peek();

        // 如果右孩子为空或已被访问,则访问当前节点
        if (current.right == null || current.right == lastVisited) {
            System.out.print(current.val + " ");
            stack.pop();
            lastVisited = current;
            current = null;
        } else {
            // 否则处理右子树
            current = current.right;
        }
    }
}
4.层次遍历
层次遍历(也称广度优先遍历)按 “从上到下、从左到右” 的顺序遍历二叉树,核心是用队列存储待访问节点,确保节点按层级顺序处理。以下是递归和非递归两种实现的核心代码(基于之前定义的 TreeNode 类)。
递归实现
递归本质是 “按层级收集节点”:先确定二叉树的总层数,再递归遍历每一层的节点并输出。需额外实现 “获取树的深度” 和 “遍历指定层级节点” 两个辅助方法,逻辑稍复杂,适合理解递归思想,实际开发中较少用。
/**
 * 递归实现层次遍历(入口方法)
 * @param root 二叉树根节点
 */
public void levelOrderRecursive(TreeNode root) {
    if (root == null) {
        return;
    }
    // 1. 获取二叉树的总深度(最大层级)
    int depth = getTreeDepth(root);
    // 2. 从第1层(根节点层)开始,递归遍历每一层
    for (int level = 1; level <= depth; level++) {
        printLevelNodes(root, level);
    }
}

/**
 * 辅助方法1:获取二叉树的深度
 * @param node 当前节点
 * @return 以当前节点为根的子树深度
 */
private int getTreeDepth(TreeNode node) {
    if (node == null) {
        return 0; // 空节点深度为0
    }
    // 左子树深度和右子树深度的最大值 + 1(当前节点层)
    int leftDepth = getTreeDepth(node.left);
    int rightDepth = getTreeDepth(node.right);
    return Math.max(leftDepth, rightDepth) + 1;
}

/**
 * 辅助方法2:遍历并输出指定层级的所有节点
 * @param node 当前节点
 * @param targetLevel 目标层级(1为根节点层)
 */
private void printLevelNodes(TreeNode node, int targetLevel) {
    if (node == null) {
        return;
    }
    // 达到目标层级,输出当前节点值
    if (targetLevel == 1) {
        System.out.print(node.val + " ");
    } else {
        // 未到目标层级,递归遍历左、右子树(层级-1)
        printLevelNodes(node.left, targetLevel - 1);
        printLevelNodes(node.right, targetLevel - 1);
    }
}
非递归实现
利用队列的 “先进先出” 特性,依次将当前节点的左、右孩子入队,直到队列为空。这是层次遍历最常用的方式,时间复杂度 O(n)(每个节点访问一次),空间复杂度 O(n)(队列最多存储一层节点,最坏为完全二叉树的最后一层)。
import java.util.LinkedList;
import java.util.Queue;

/**
 * 非递归实现层次遍历
 * @param root 二叉树根节点
 */
public void levelOrderIterative(TreeNode root) {
    if (root == null) {
        return; // 空树直接返回
    }

    Queue<TreeNode> queue = new LinkedList<>(); // 用LinkedList实现队列
    queue.offer(root); // 根节点入队

    while (!queue.isEmpty()) {
        TreeNode current = queue.poll(); // 出队当前节点并访问
        System.out.print(current.val + " ");

        // 左孩子非空则入队(保证左到右的顺序)
        if (current.left != null) {
            queue.offer(current.left);
        }
        // 右孩子非空则入队
        if (current.right != null) {
            queue.offer(current.right);
        }
    }
}
5.遍历确定二叉树
由二叉树的先序序列和中序序列可以唯一地确定一棵二叉树。
由二叉树的后序序列和中序序列也可以唯一地确定一棵二叉树。
由二叉树的层序序列和中序序列也可以唯一地确定一棵二叉树。
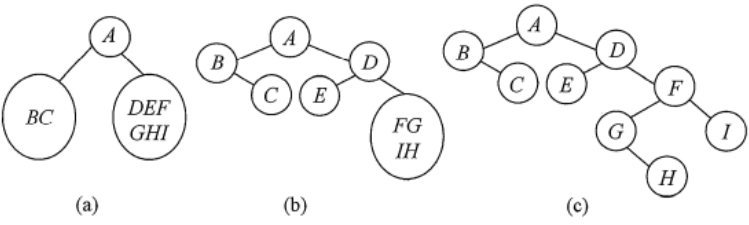
例如,求先序序列( ABCDEFGHI)和中序序列( BCAEDGHFI)所确定的二叉树。
解决这种问题:对于先序遍历:它的首节点为这棵树的根节点;对于后续遍历:它的位节点为这棵树的根节点;对于中序遍历:主要看序列中的根节点位置,根节点左边的所有节点为此根节点的左子树节点,右边的所有节点为此根节点的右子树节点。
首先,由先序序列可知A为二叉树的根结点。中序序列中A之前的BC为左子树的中序序列,EDGHFI为右子树的中序序列。然后由先序序列可知B是左子树的根结点,D是右子树的根结点。以此类推,就能将剩下的结点继续分解下去,最后得到的二叉树如图(c)所示。
六、线索二叉树
1.线索二叉树原理
遍历二叉树是以一定的规则将二叉树中的结点排列成一个线性序列,从而得到几种遍历序列,使得该序列中的每个结点(第一个和最后一个结点除外)都有一个直接前驱和直接后继。传统的二叉链表存储仅能体现一种父子关系,不能直接得到结点在遍历中的前驱或后继。
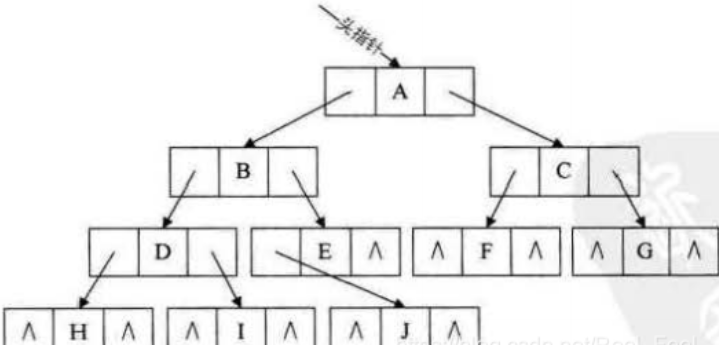
对于一个有n个结点的二叉链表,每个结点有指向左右孩子的两个指针域,所以一共是2n个指针域。而n个结点的二叉树一共有n-1 条分支线数,也就是说,其实是存在2n- (n-1) =n+1个空指针域。
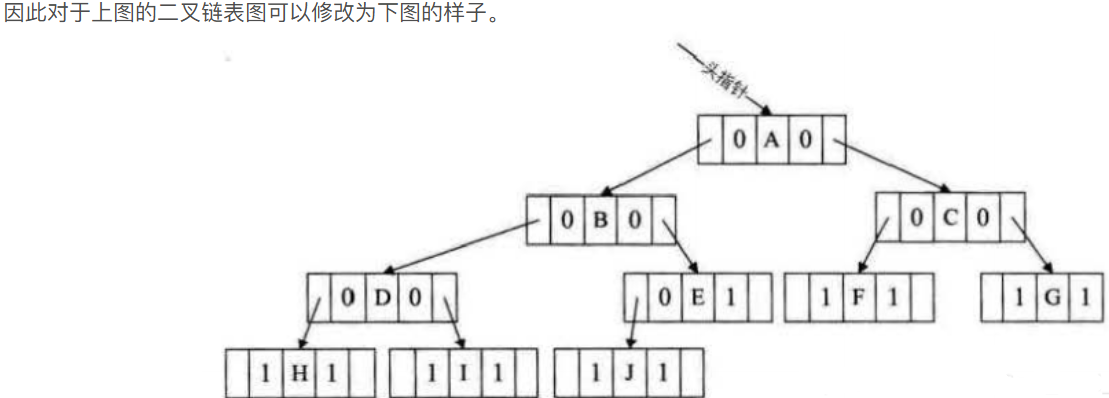
线索二叉树正是为了加快查找结点前驱和后继的速度。我们把这种指向前驱和后继的指针称为线索,加上线索的二叉链表称为线索链表,相应的二叉树就称为线索二叉树(Threaded Binary Tree)。
节点结构如下:
- ltag为0时指向该结点的左孩子,为1时指向该结点的前驱。
- rtag为0时指向该结点的右孩子,为1时指向该结点的后继。

- 代码实现
/**
 * 线索二叉树节点
 * 增加ltag和rtag标记:0表示指向孩子,1表示指向线索(前驱/后继)
 */
class ThreadedNode {
    int val;
    ThreadedNode left;  // 左孩子或前驱线索
    ThreadedNode right; // 右孩子或后继线索
    int ltag; // 左标记:0-左孩子,1-前驱线索
    int rtag; // 右标记:0-右孩子,1-后继线索

    public ThreadedNode(int val) {
        this.val = val;
        this.left = null;
        this.right = null;
        this.ltag = 0; // 初始为孩子指针
        this.rtag = 0;
    }
}
2.二叉树的线索化
二叉树的线索化是将二叉链表中的空指针改为指向前驱或后继的线索。而前驱或后继的信息只有在遍历时才能得到,因此线索化的实质就是遍历一次二叉树,线索化的过程就是在遍历的过程中修改空指针的过程。
一、中序线索二叉树
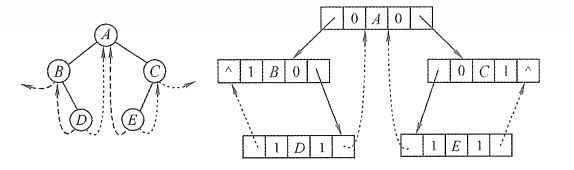
以中序线索二叉树的建立为例。附设指针pre指向刚刚访问过的结点,指针p指向正在访问的结点,即pre指向p的前驱。在中序遍历的过程中,检查p的左指针是否为空,若为空就将它指向pre;检查pre的右指针是否为空,若为空就将它指向p,如下图所示。
代码实现:
/**
 * 中序线索化二叉树及线索遍历实现
 */
public class ThreadedBinaryTree {
    private ThreadedNode root; // 根节点
    private ThreadedNode pre;  // 线索化时记录前驱节点

    // 构造方法:初始化根节点
    public ThreadedBinaryTree(ThreadedNode root) {
        this.root = root;
        this.pre = null;
    }

    /**
     * 中序线索化二叉树(递归实现)
     * @param node 当前需要线索化的节点
     */
    public void inOrderThreading(ThreadedNode node) {
        if (node == null) {
            return; // 空节点无需处理
        }

        // 1. 线索化左子树
        inOrderThreading(node.left);

        // 2. 处理当前节点的前驱线索
        if (node.left == null) {
            node.left = pre; // 左空指针指向前驱
            node.ltag = 1;   // 标记为前驱线索
        }

        // 3. 处理前驱节点的后继线索(若前驱存在且右空)
        if (pre != null && pre.right == null) {
            pre.right = node; // 前驱右空指针指向当前节点(后继)
            pre.rtag = 1;     // 标记为后继线索
        }

        // 4. 更新前驱节点为当前节点
        pre = node;

        // 5. 线索化右子树
        inOrderThreading(node.right);
    }

    /**
     * 利用线索遍历中序序列(无需递归/栈)
     */
    public void inOrderTraversal() {
        if (root == null) {
            System.out.println("线索二叉树为空");
            return;
        }

        ThreadedNode current = root;

        // 找到中序遍历的起始节点(最左节点)
        while (current != null && current.ltag == 0) {
            current = current.left;
        }

        while (current != null) {
            // 访问当前节点
            System.out.print(current.val + " ");

            // 若右指针是线索,直接跳转到后继节点
            if (current.rtag == 1) {
                current = current.right;
            } else {
                // 若右指针是孩子,找右子树的最左节点(下一个访问节点)
                current = current.right;
                while (current != null && current.ltag == 0) {
                    current = current.left;
                }
            }
        }
    }


    // 测试代码
    public static void main(String[] args) {
        // 构建示例二叉树:
        //       1
        //      / \
        //     2   3
        //    / \
        //   4   5
        ThreadedNode node1 = new ThreadedNode(1);
        ThreadedNode node2 = new ThreadedNode(2);
        ThreadedNode node3 = new ThreadedNode(3);
        ThreadedNode node4 = new ThreadedNode(4);
        ThreadedNode node5 = new ThreadedNode(5);

        // 建立树结构
        node1.left = node2;
        node1.right = node3;
        node2.left = node4;
        node2.right = node5;

        // 线索化二叉树
        ThreadedBinaryTree tree = new ThreadedBinaryTree(node1);
        tree.inOrderThreading(node1);

        // 线索遍历(中序序列应为:4 2 5 1 3)
        System.out.print("中序线索遍历结果:");
        tree.inOrderTraversal(); // 输出:4 2 5 1 3
    }
}
代码分析:
- 节点设计:通过
ltag和rtag区分指针类型(孩子 / 线索),解决空指针浪费问题。 - 线索化过程:
-
- 递归遍历左子树,处理当前节点的前驱线索(左空指针指向
pre)。 - 处理前驱节点的后继线索(前驱右空指针指向当前节点)。
- 更新
pre为当前节点,继续递归右子树。
- 递归遍历左子树,处理当前节点的前驱线索(左空指针指向
- 线索遍历优势:
-
- 无需递归或栈,直接通过线索指针跳转,时间复杂度
O(n),空间复杂度O(1)。 - 遍历逻辑:从最左节点开始,若右指针是线索则直接跳转,否则进入右子树找最左节点。
- 无需递归或栈,直接通过线索指针跳转,时间复杂度
- 若需要前序或后序线索化,只需调整线索化时处理当前节点的时机(前序:先处理当前节点再遍历左右子树;后序:遍历完左右子树再处理当前节点)。
- 线索二叉树适合频繁遍历但修改较少的场景,修改操作(如插入 / 删除节点)需同步维护线索指针,实现较复杂。
结构改进:
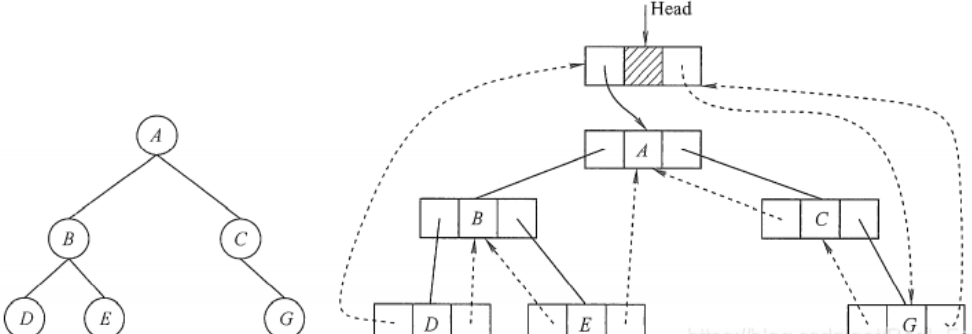
为了方便,可以在二叉树的线索链表上也添加一个头结点,令其lchild域的指针指向二叉树的根结点,其rchild域的指针指向中序遍历时访问的最后一个结点;令二叉树中序序列中的第一个结点的lchild域指针和最后一个结点的rchild域指针均指向头结点。这好比为二叉树建立了一个双向线索链表,方便从前往后或从后往前对线索二叉树进行遍历,如下图所示。
二、先序和后序线索二叉树
建立先序线索二叉树和后序线索二叉树的代码类似,只需变动线索化改造的代码段与调用线索化左右子树递归函数的位置。
以图(a)的二叉树为例,其先序序列为ABCDF,后序序列为CDBFA,可得出其先序和后序线索二叉树分别如图(b)和(c)所示:
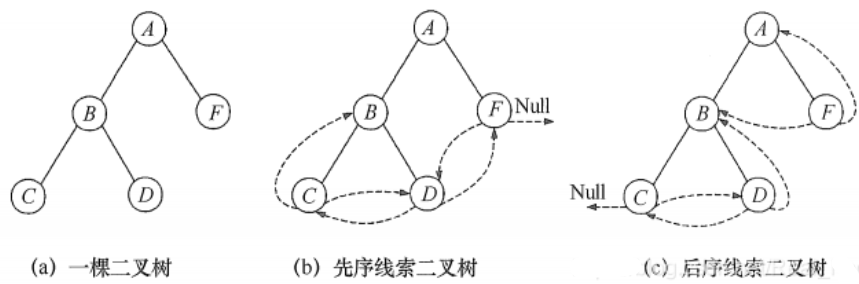
如何在先序线索二叉树中找结点的后继?如果有左孩子,则左孩子就是其后继;如果无左孩子但有右孩子,则右孩子就是其后继;如果为叶结点,则右链域直接指示了结点的后继。
在后序线索二叉树中找结点的后继较为复杂,可分3种情况:①若结点x是二叉树的根,则其后继为空;②若结点x是其双亲的右孩子,或是其双亲的左孩子且其双亲没有右子树,则其后继即为双亲;③若结点x是其双亲的左孩子,且其双亲有右子树,则其后继为双亲的右子树上按后序遍历列出的第一个结点。图( c)中找结点B的后继无法通过链域找到,可见在后序线索二叉树上找后继时需知道结点双亲,即需采用带标志域的三叉链表作为存储结构。
3.树、森林与二叉树的转换
在讲树的存储结构时,我们提到了树的孩子兄弟法可以将一棵树用二叉链表进行存储,所以借助二叉链表,树和二叉树可以相互进行转换。从物理结构来看,它们的二叉链表也是相同的,只是解释不太一样而已。 因此,只要我们设定一定的规则,用二叉树来表示树,甚至表示森林都是可以的,森林与二叉树也可以互相进行转换。
一、树转换为二叉树
规则:
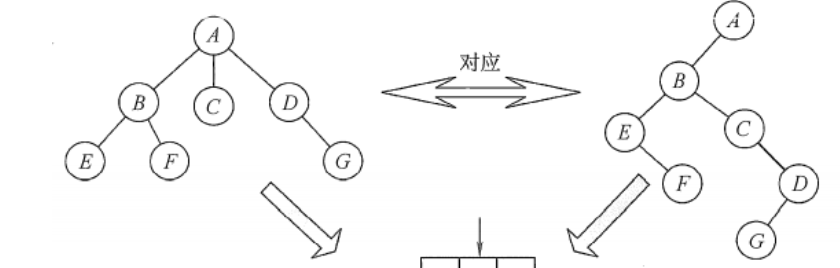
树转换为二叉树的规则:每个结点左指针指向它的第一个孩子,右指针指向它在树中的相邻右兄弟,这个规则又称“左孩子右兄弟”。由于根结点没有兄弟,所以对应的二叉树没有右子树。
树转换成二叉树的画法:
- 在兄弟结点之间加一连线;
- 对每个结点,只保留它与第一个孩子的连线,而与其他孩子的连线全部抹掉;
- 以树根为轴心,顺时针旋转45°。
二、 森林转换为二叉树
森林是由若干棵树组成的,所以完全可以理解为,森林中的每一棵树都是兄弟,可以按照兄弟的处理办法来操作。
森林转换成二叉树的画法:
- 将森林中的每棵树转换成相应的二叉树;
- 每棵树的根也可视为兄弟关系,在每棵树的根之间加一根连线;
- 以第一棵树的根为轴心顺时针旋转45°。
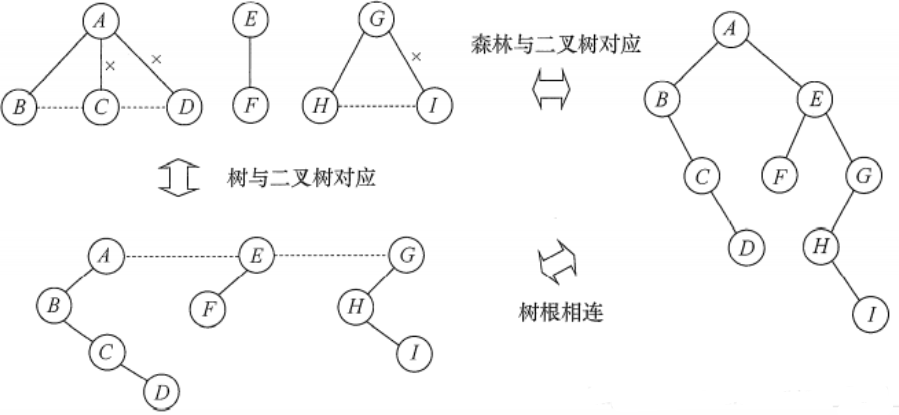
二叉树转换为树或森林是上面过程的逆过程。
四、树和森林的遍历
一、树的遍历
树的遍历是指用某种方式访问树中的每个结点,且仅访问一次。主要有两种方式:
- 先根遍历。若树非空,先访问根结点,再依次遍历根结点的每棵子树,遍历子树时仍遵循先根后子树的规则。其遍历序列与这棵树相应二叉树的先序序列相同。
- 后根遍历。若树非空,先依次遍历根结点的每棵子树,再访问根结点,遍历子树时仍遵循先子树后根的规则。其遍历序列与这棵树相应二叉树的中序序列相同。
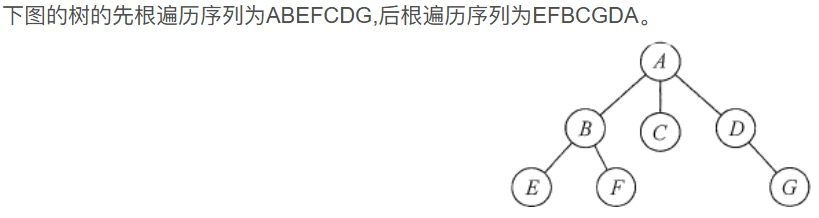
树也有层次遍历,与二叉树的层次遍历思想基本相同,即按层序依次访问各结点。
二、森林的遍历
按照森林和树相互递归的定义,可得到森林的两种遍历方法。
1. 先序遍历森林。若森林为非空,则按如下规则进行遍历:
●访问森林中第一棵树的根结点。
●先序遍历第一棵树中根结点的子树森林。
●先序遍历除去第一棵树之后剩余的树构成的森林。
2. 后序遍历森林。森林为非空时,按如下规则进行遍历:
●后序遍历森林中第一棵树的根结点的子树森林。
●访问第一棵树的根结点。
●后序遍历除去第一棵树之后剩余的树构成的森林。
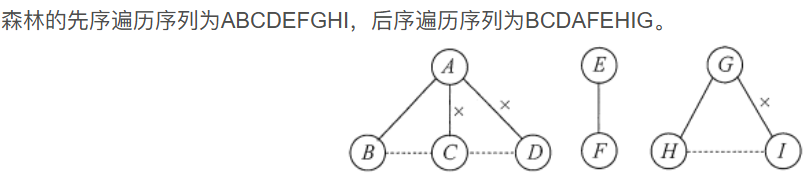
当森林转换成二叉树时,第一棵子树转换成二叉树的左子树,剩余子树转换成右子树,可知森林的先序和后序遍历即为其对应二叉树的先序和中序遍历。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 18
 0
- 0


 已为社区贡献2条内容

所有评论(0)