正则表达式(三)20种文本替换应用:连续空格、单个空格、换行符、回车符、逗号、特殊字符、字母、数字、中文、敏感词、自定义、纯文字、手机号、身份证号、脱敏、中间 4 位、中间 8 位、空白字符、全角字符
·
正则表达式语法与文本替换指南
正则表达式基础语法
常用元字符
.- 匹配除换行符外的任意字符\d- 匹配数字,等价于[0-9]\w- 匹配字母、数字、下划线\s- 匹配空白字符(空格、制表符、换行符)\b- 匹配单词边界^- 匹配字符串开始$- 匹配字符串结束
量词
*- 0次或多次+- 1次或多次?- 0次或1次{n}- 恰好n次{n,}- 至少n次{n,m}- n到m次
字符类
[abc]- 匹配a、b或c中的任意一个[^abc]- 匹配除a、b、c外的任意字符[a-z]- 匹配a到z范围内的字符
文本替换类用法要避免的坑
1. 贪婪匹配问题
// 错误:可能匹配过多内容
const regex = /<.*>/;

// 正确:使用非贪婪匹配
const regex = /<.*?>/;
2. 分组引用错误
// 错误:忘记使用分组引用
"2025/11/22".replace(/(\d{4})\/(\d{2})\/(\d{2})/, "$1-$2-$3");

// 注意:分组编号从 $1 开始
3. 特殊字符转义
// 错误:未转义特殊字符
const regex = /\d.\d/; // 可能匹配 "1x2"

// 正确:转义点号
const regex = /\d\.\d/; // 只匹配 "1.2"
4. Unicode字符处理
// 中文范围:\u4e00-\u9fa5
// 全角字符范围:\uff00-\uffef
5. 边界情况考虑
- 空字符串匹配
- 多行文本处理
- 性能考虑(避免回溯灾难)
文本替换/清洗类正则表达式查询表
| ID | 标题 | 正则表达式 | 替换内容 | 描述 | 示例 |
|---|---|---|---|---|---|
| 41 | 把文本中多个连续空格替换为单个空格 | \s+ | 空格 | 将文本中多个连续的空格(包括空格、制表符)替换为单个空格 | 这是 测试 文本 → 这是 测试 文本 |
| 42 | 把文本中所有换行符/回车符替换为逗号 | \r?\n | , | 将文本中的换行符(\n)、回车符(\r)或回车换行(\r\n)替换为逗号 | 第一行\n第二行\r第三行 → 第一行,第二行,第三行 |
| 43 | 清洗文本中的特殊字符(仅保留字母/数字/中文) | [^a-zA-Z0-9\u4e00-\u9fa5] | 空字符串 | 过滤文本中的所有特殊字符,仅保留字母、数字、中文字符 | 这是@测试123!abc → 这是测试123abc |
| 44 | 批量替换文本中的敏感词(如脏话→*) | (脏话1|脏话2|脏话3) | *** | 批量替换文本中的指定敏感词为*(需自定义敏感词列表) | 这是脏话1内容 → 这是***内容 |
| 45 | 去除HTML文本中的所有标签(保留纯文字内容) | <[^>]+> | 空字符串 | 移除HTML文本中的所有标签,仅保留标签内的纯文字内容 | <p>这是<b>测试</b>文本</p> → 这是测试文本 |
| 46 | 手机号脱敏:替换中间4位为* | (1[3-9]\d)\d{4}(\d{4}) | $1****$2 | 将手机号中间4位替换为*,保留前3位和后4位 | 13800138000 → 138****8000 |
| 47 | 身份证号脱敏:替换中间8位为* | (\d{6})\d{8}(\d{4}) | $1********$2 | 将18位身份证号中间8位(出生日期)替换为*,保留前6位和后4位 | 11010119900307789X → 110101********789X |
| 48 | 去除文本开头/结尾的空格(模拟trim函数) | ^\s+|\s+$ | 空字符串 | 移除文本开头和结尾的所有空格、制表符、换行符等空白字符 | 这是测试文本 → 这是测试文本 |
| 49 | 把全角字符转为半角 | [\uff00-\uffef] | 函数转换 | 将全角字符(数字、字母、符号)转换为对应的半角字符 | 0123abc,。 → 0123abc,. |
| 50 | 把半角字符转为全角 | [\x20-\x7e] | 函数转换 | 将半角字符(数字、字母、符号)转换为对应的全角字符 | 0123abc,. → 0123abc,。 |
| 51 | 清洗日志中的乱码/不可见字符 | [\x00-\x1f\x7f-\x9f\ufffd] | 空字符串 | 移除日志中的不可见字符、乱码字符(如空字符、替换字符) | 测试\x00文本\ufffd → 测试文本 |
| 52 | 批量替换URL中的分页参数 | (\?|&)page=\d+ | $1page=2 | 将URL中的page参数值替换为指定数值(示例替换为2) | https://example.com?page=1&size=10 → https://example.com?page=2&size=10 |
| 53 | 去除文本中的所有数字 | \d+ | 空字符串 | 移除文本中的所有数字字符,仅保留文字内容 | 这是123测试456文本 → 这是测试文本 |
| 54 | 去除文本中的所有字母 | [a-zA-Z]+ | 空字符串 | 移除文本中的所有英文字母,保留中文和数字 | 这是abc测试123文本def → 这是测试123文本 |
| 55 | 转换日期格式(YYYY/MM/DD→YYYY-MM-DD) | (\d{4})/(\d{2})/(\d{2}) | $1-$2-$3 | 将YYYY/MM/DD格式的日期转换为YYYY-MM-DD格式 | 2025/11/22 → 2025-11-22 |
| 56 | 把文本中的英文单词统一转为小写 | [A-Z]+ | 函数转换 | 将文本中的所有大写英文字母转换为小写 | Hello World → hello world |
| 57 | 把文本中的英文单词统一转为大写 | [a-z]+ | 函数转换 | 将文本中的所有小写英文字母转换为大写 | Hello World → HELLO WORLD |
| 58 | 去除文本中的重复行 | (^.*$)(\r?\n\1)+ | $1 | 移除文本中的连续重复行,仅保留唯一行(需开启m修饰符) | 第一行\n第一行\n第二行 → 第一行\n第二行 |
| 59 | 移除数字中的千分位分隔符 | (\d),(\d) | $1$2 | 移除数字中的千分位逗号分隔符,保留小数部分 | 1,234.56 → 1234.56 |
| 60 | 给数字添加千分位分隔符 | (\d)(?=(\d{3})+(?!\d)) | $1, | 为整数或小数的整数部分添加千分位逗号分隔符 | 1234567 → 1,234,567 |
使用提示
- 测试正则表达式:在实际使用前,先用测试工具验证正则表达式
- 考虑边界情况:确保正则表达式能处理各种边界情况
- 性能优化:对于大量文本处理,注意正则表达式的性能
- 转义处理:在代码中使用时注意正确的转义字符
- 多语言支持:根据实际需求调整字符范围以支持多语言
我用代码做了一个正则表达式查询库,可以查询100种典型应用,也可以验证和测试你的代码,可以点击直接下载:
正则表达式查询库 覆盖数据验证、文本提取/清洗、开发调试、日志分析、网络安全等数十个领域的100种正则表达式应用场景
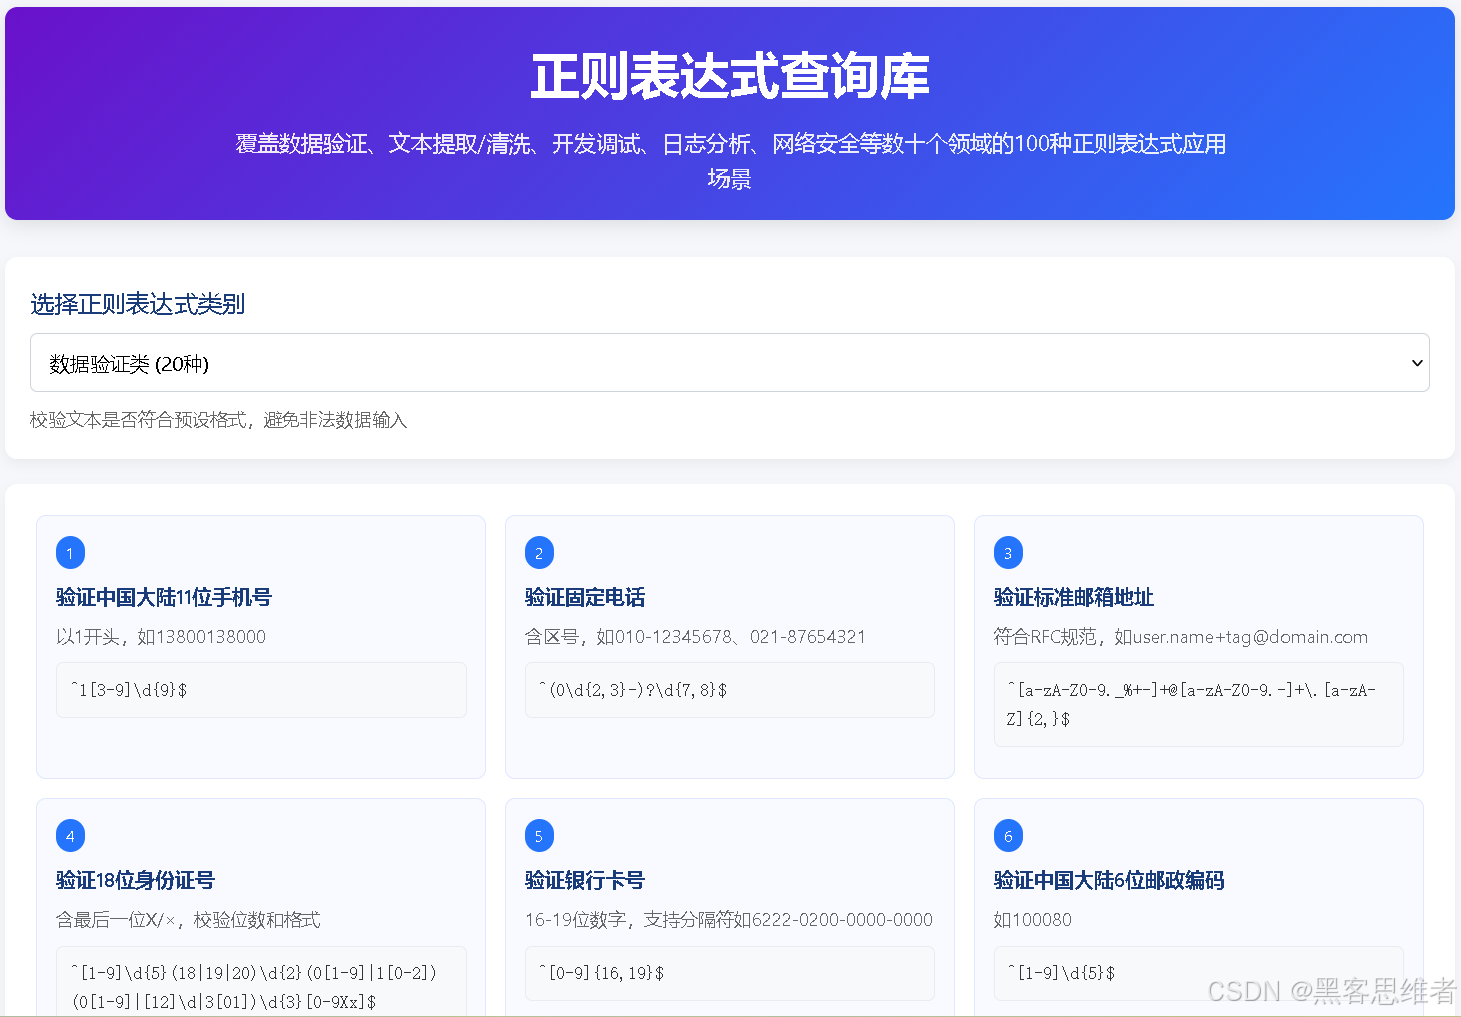
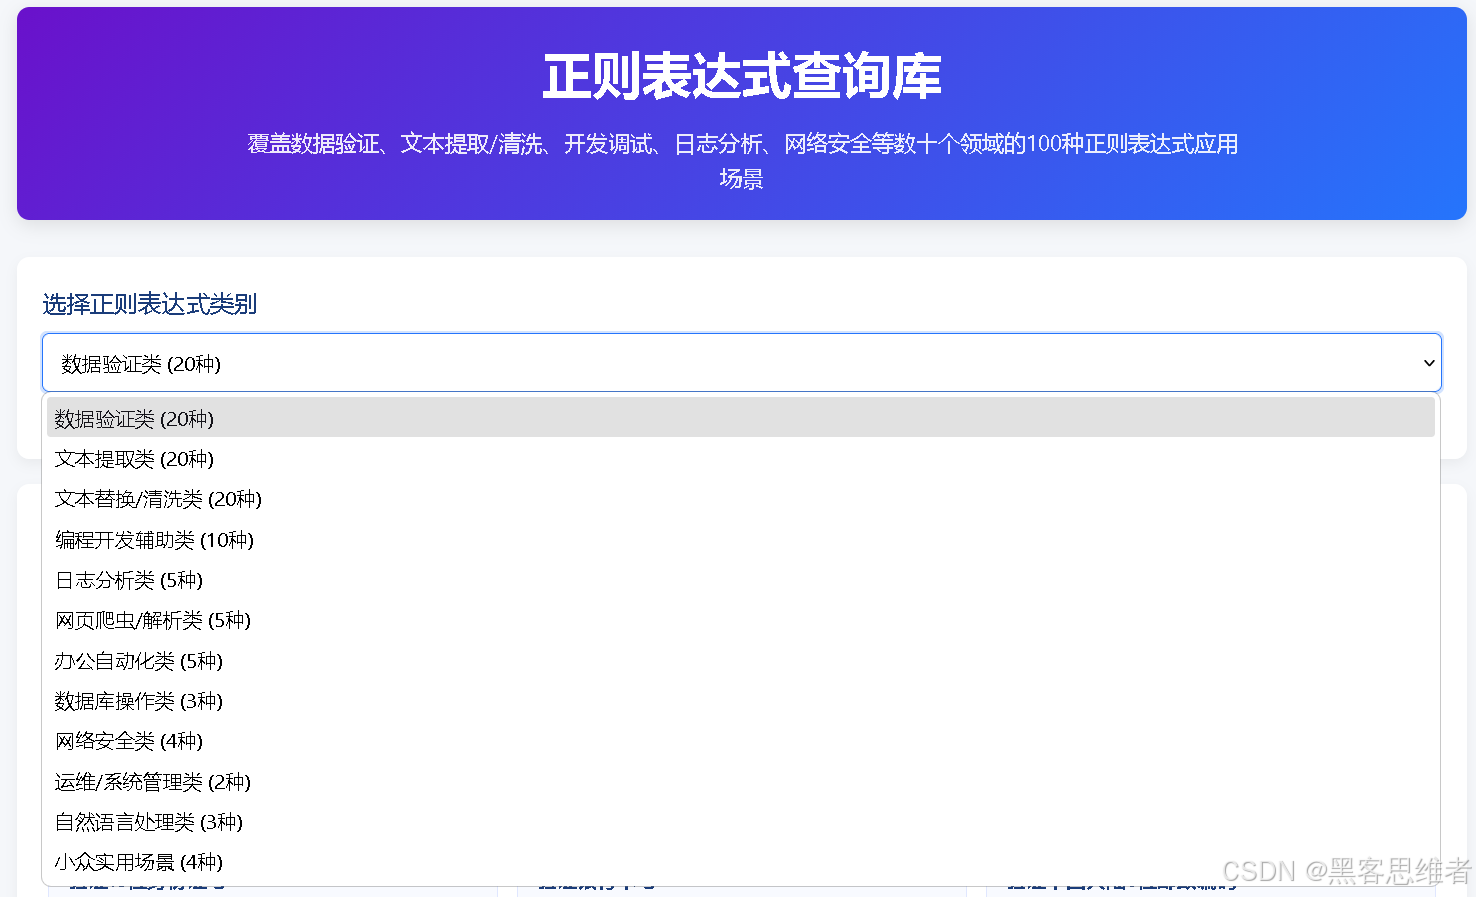
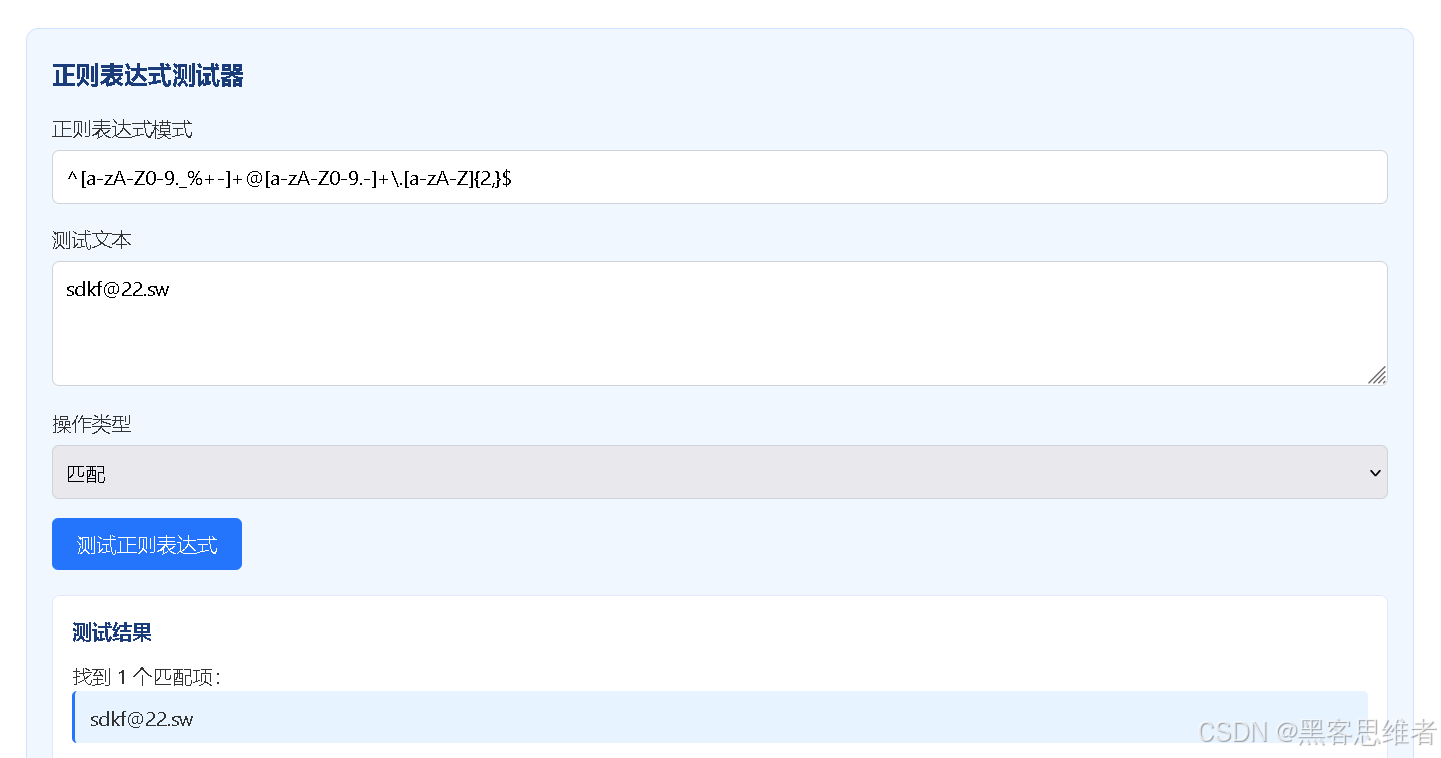
正则表达式查询库 覆盖数据验证、文本提取/清洗、开发调试、日志分析、网络安全等数十个领域的100种正则表达式应用场景

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 25
 0
- 0


 已为社区贡献12条内容

所有评论(0)