数据结构之排序-选择排序&交换排序
目录
前言
在上一篇文章数据结构之排序-插入排序中我们讲解了插入排序中的直接插入排序和希尔排序,在这篇文章中我们将继续讲解选择排序以及交换排序,虽然是两个大分类的排序,但选择排序中的堆排序和交换排序中的冒泡排序在前面的学习中我们已经讲解了,所以本篇文章主要讲解的是直接选择排序和快速排序。
选择排序
选择排序的基本思想:每一次从待排序的数据元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的数据元素排完。
一、直接选择排序
1、直接选择排序的逻辑以及动态展示
(1)在元素集合 array [ i ] ~ array [ n-1 ] 中选择关键码最大(小)的数据元素
(2)若它不是这组元素中的最后一个(第一个)元素,则将它与这组元素中的最后一个(第一个)元素交换
(3)在剩余的 array [ i ] ~ array [ n-2 ] ( array [ i+1 ] ~ array [ n-1 ] )集合中,重复上述步
骤,直到集合剩余1个元素
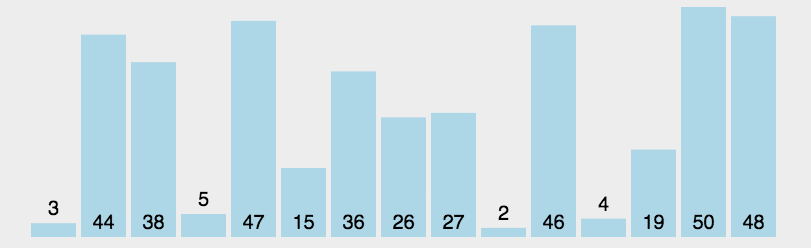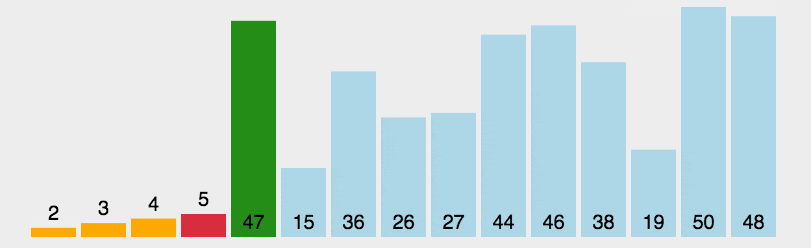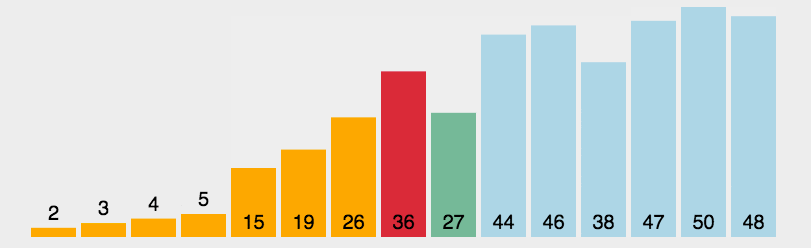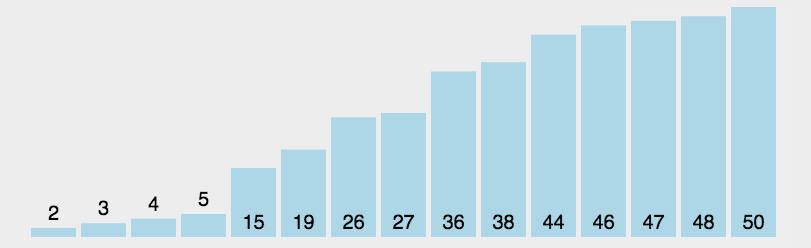
上面的图就是以每次找最小数为例。
但是我们可以在这个逻辑的基础上进行优化:我们可以每次同时找出最大和最小的数,如果不是最后一个和第一个,则同时进行交换,这样的话循环次数就可以减半,效率也就变高了。
2、直接插入排序的代码实现
2.1 错误示范
//Sort.h
//打印数组
void PrintArray(int* arr, int n);
//直接选择排序
void SelectSort(int* arr, int n);

//Sort.c
#include "Sort.h"

//交换数据
void Swap(int* a, int* b)
{
	int tmp = *a;
	*a = *b;
	*b = tmp;
}

//打印数组
void PrintArray(int* arr, int n)
{
	for (int i = 0; i < n; i++)
	{
		printf("%d ", arr[i]);
	}
	printf("\n");
}

//直接选择排序
void SelectSort(int* arr, int n)
{
	int began = 0;
	int end = n - 1;
	while (began < end)
	{
		int mini = began;
		int maxi = began;
		for (int i = began + 1; i <= end; i++)
		{
			if (arr[i] > arr[maxi])
			{
				maxi = i;
			}
			if (arr[i] < arr[mini])
			{
				mini = i;
			}
		}
		Swap(&arr[began], &arr[mini]);
		Swap(&arr[end], &arr[maxi]);
		began++;
		end--;
	}
}

//Test.c
#include "Sort.h"

void Test1()
{
	int arr[] = { 2, 4, 1, 7, 8, 3, 9, 2 };

	SelectSort(arr, sizeof(arr) / sizeof(arr[0]));
	PrintArray(arr, sizeof(arr) / sizeof(arr[0]));
}

int main()
{
	Test1();
	return 0;
}
这个排序的代码逻辑就是:先定义两个变量 mini 和 maxi 来记录每次遍历的最小和最大值的下标并且初始化为 began,然后进行遍历数组,当遇到 arr [ i ] > arr [ maxi ] 则说明最大值需要修改,将 maxi 改为当前值的下标 i;当遇到 arr [ i ] < arr [ mini ] 则说明最小值需要修改,将 mini 改为当前值的下标。直到遍历完整个数组后则整个数组中的最大值和最小值下标就找到了,则将其与对应的数组开头和结尾数进行交换,然后将数组的范围进行缩小(began++;end--;),继续上述操作。
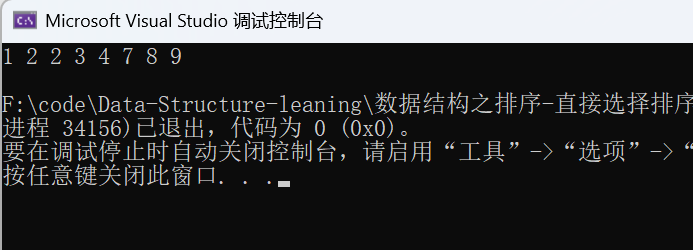
而且通过打印的结果我们发现排序也没有问题,可是为什么我会说这是错误示范呢?
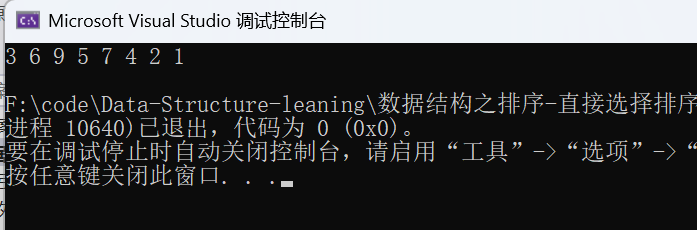
因为对于这个数组例子而言排序的确没有问题,但如果是下面这个数组例子排序后就不是我们所预期的:
//Test.c
void Test1()
{
	int arr[] = { 9, 1, 2, 5, 7, 4, 6, 3 };

	SelectSort(arr, sizeof(arr) / sizeof(arr[0]));
	PrintArray(arr, sizeof(arr) / sizeof(arr[0]));
}

int main()
{
	Test1();
	return 0;
}
2.2 调试发现问题并改进
看到这个结果看到有些人一下子就懵了,这是为什么?同样的代码竟然有些数组可以排序成功,有些数组却会出问题,并且我们会发现这个数组的确发生了改变,那错误就应该是我们的逻辑有些问题,我们观察代码和结果发现不了问题就需要借助调试功能了:
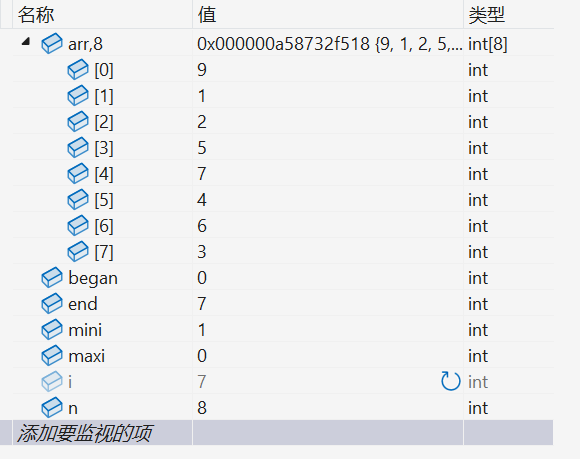
当第一次循环遍历完后我们发现此时数组的最大值下标maxi为0,最小值下标mini为1,也符合当前数组的情况,则进行交换:
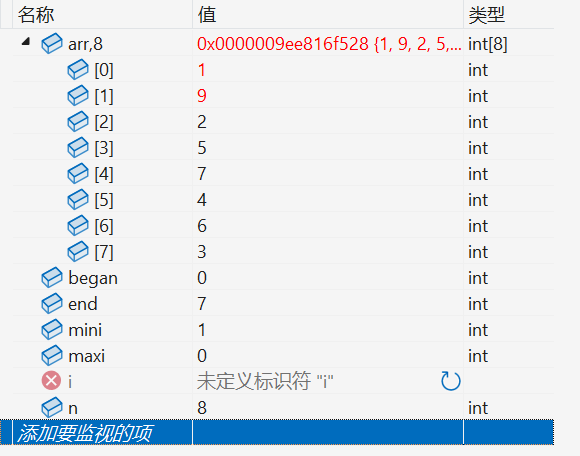
其实当最小值与数组开头进行交换后我们就会发现问题所在了:当我们把数组开头与最小值进行交换后,原本在数组开头的最大值则被调到下标为1的位置,但是maxi仍然指向的是下标为0的位置,也就是说当我们将下标为maxi与最后一个位置交换时并不是真正意义上的交换了数组的最大值。
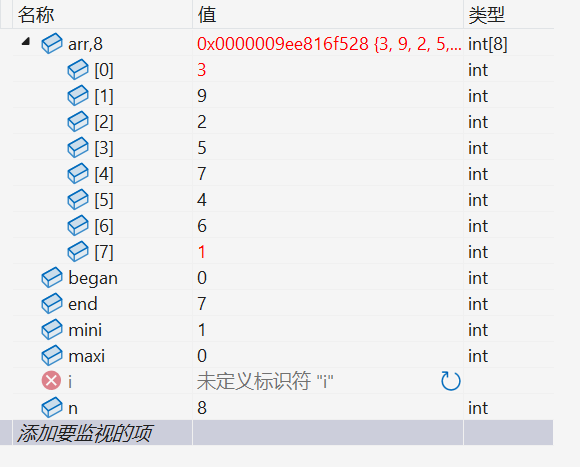
所以我们会发现之所以会出现这个问题就是因为数组的最大值在当前数组的开头而导致的,所以我们要解决这个问题的话:就需要在交换数组开头与下标为mini的值后对maxi的值进行重置。
//Sort.c
//直接选择排序
void SelectSort(int* arr, int n)
{
	int began = 0;
	int end = n - 1;
	while (began < end)
	{
		int mini = began;
		int maxi = began;
		for (int i = began + 1; i <= end; i++)
		{
			if (arr[i] > arr[maxi])
			{
				maxi = i;
			}
			if (arr[i] < arr[mini])
			{
				mini = i;
			}
		}

		Swap(&arr[began], &arr[mini]);
		if (began == maxi)
		{
			maxi = mini;
		}
		Swap(&arr[end], &arr[maxi]);
		began++;
		end--;
	}
}

//Test.c
void Test1()
{
	int arr[] = { 9, 1, 2, 5, 7, 4, 6, 3 };

	SelectSort(arr, sizeof(arr) / sizeof(arr[0]));
	PrintArray(arr, sizeof(arr) / sizeof(arr[0]));
}

int main()
{
	Test1();
	return 0;
}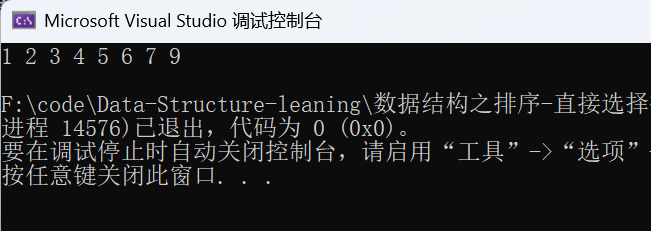
这样我们就完成了直接插入排序的代码实现。
二、堆排序
在数据结构之二叉树-堆这篇文章中我对堆排序已经进行了详细的讲解,详细讲解了堆排序的原理以及代码实现,感兴趣的可以去看看,在这里就不过多赘述了,本篇文章主要是讲解交换排序中的快速排序。
交换排序
三、冒泡排序
由于冒泡排序是在C语言中我们所接触的第一个排序,也是最简单的排序,在C语言的学习中我们已经学习了这个排序,所以这里我们就不过多花时间进行讲解,直接给出代码实现:
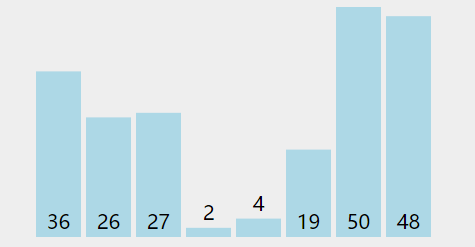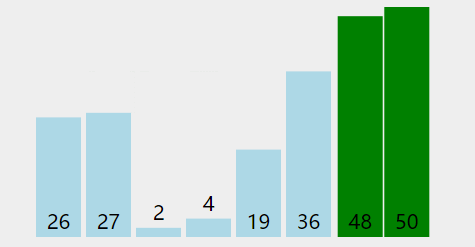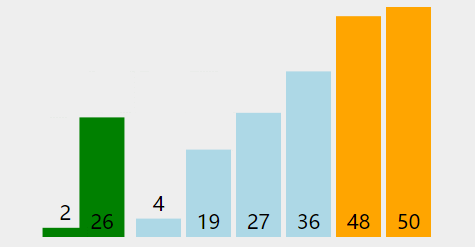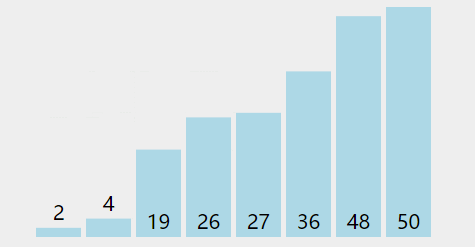
//Sort.h
//冒泡排序
void BubbleSort(int* arr, int n);

//Sort.c
//冒泡排序
void BubbleSort(int* arr, int n)
{
	int end = n - 1;
	while (end > 0)
	{
		for (int i = 0; i < end; i++)
		{
			if (arr[i] > arr[i + 1])
			{
				Swap(&arr[i], &arr[i + 1]);
			}
		}
		end--;
	}
}

//Test.c
void Test1()
{
	int arr[] = { 9, 1, 2, 5, 7, 4, 6, 3 };
	//冒泡排序
	BubbleSort(arr, sizeof(arr) / sizeof(arr[0]));
	PrintArray(arr, sizeof(arr) / sizeof(arr[0]));
}

int main()
{
	Test1();
	return 0;
}
四、快速排序
1、快速排序的由来和思想
快速排序是Hoare于1962年提出的一种二叉树结构的交换排序方法,其基本思想为:任取待排序元素序列中的某元素作为基准值,按照该排序码将待排序集合分割成两子序列,左子序列中所有元素均小于基准值,右子序列中所有元素均大于基准值,然后最左右子序列重复该过程,直到所有元素都排列在相应位置上为止。
2、hoare版本
2.1 算法思路及动图展示
算法思路:
1)创建左右指针,确定基准值
2)从右向左找出比基准值小的数据,从左向右找出比基准值大的数据,左右指针数据交换,进入下次循环
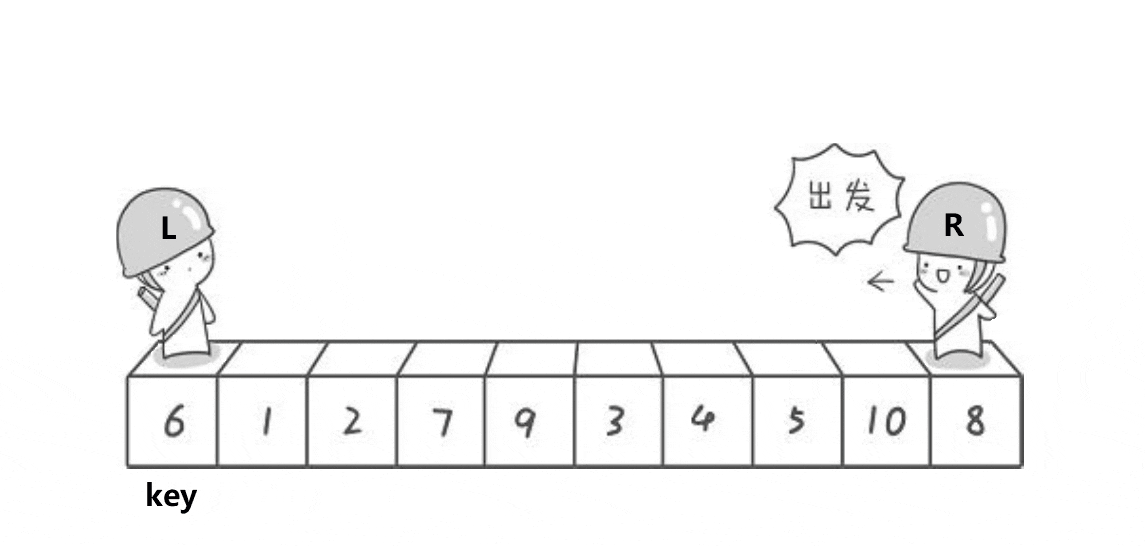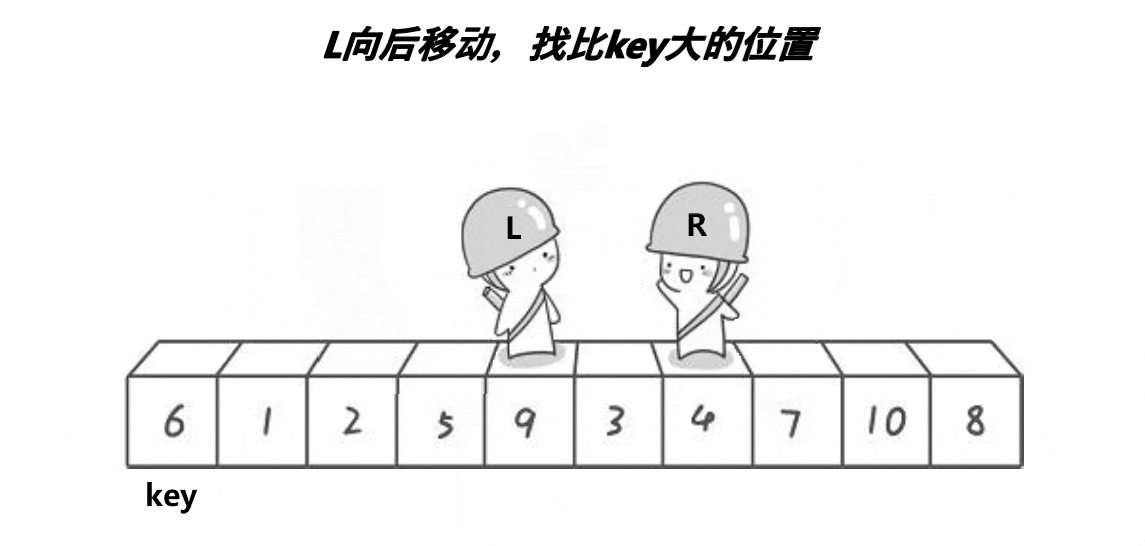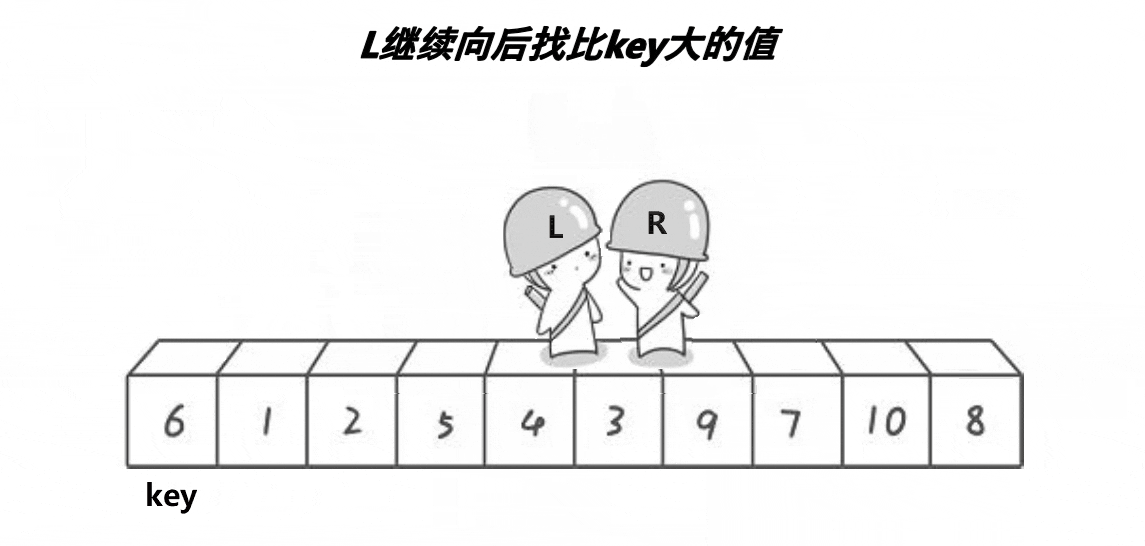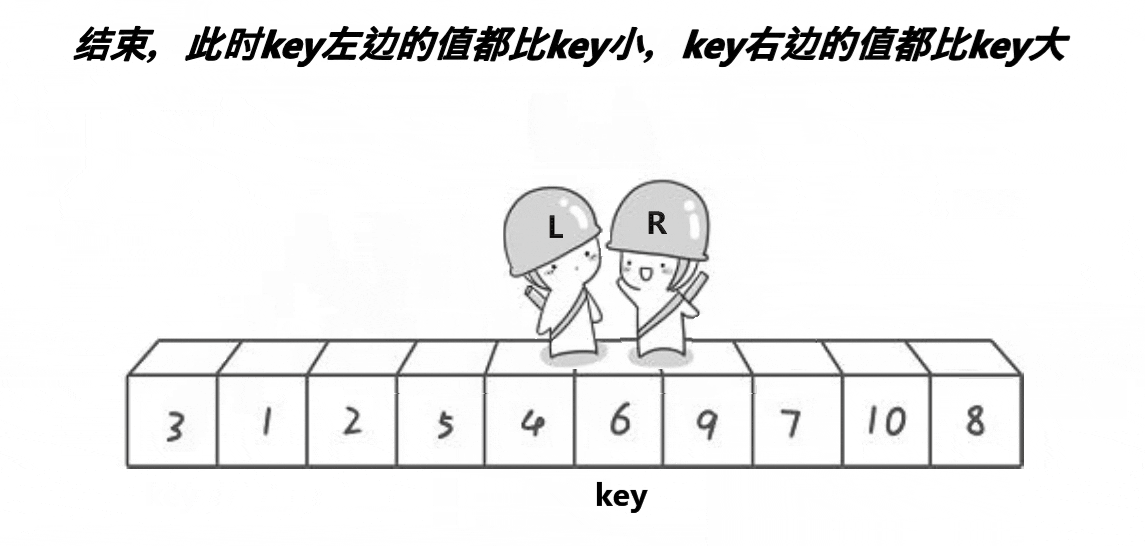
2.2 单趟逻辑及代码实现
由于快速排序的逻辑比较复杂,在写多趟代码实现之前先实现单趟的代码。
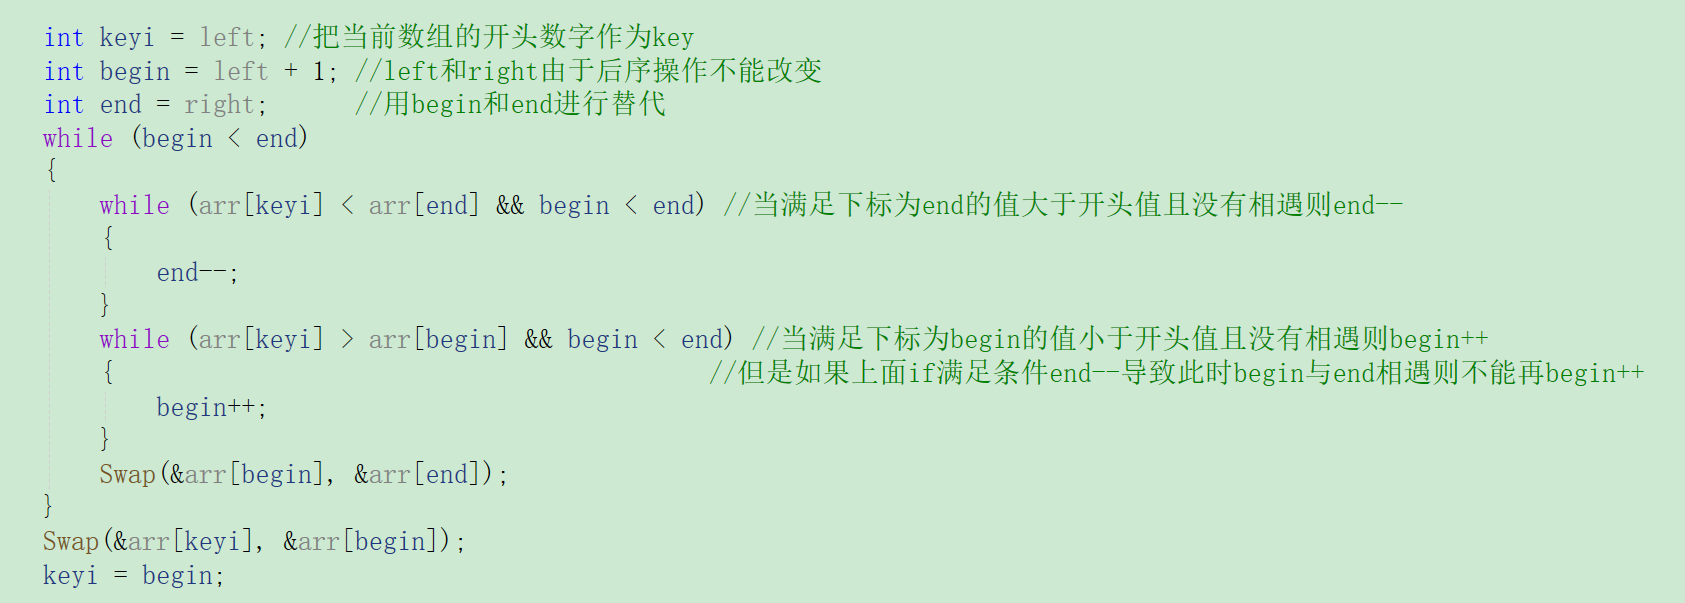
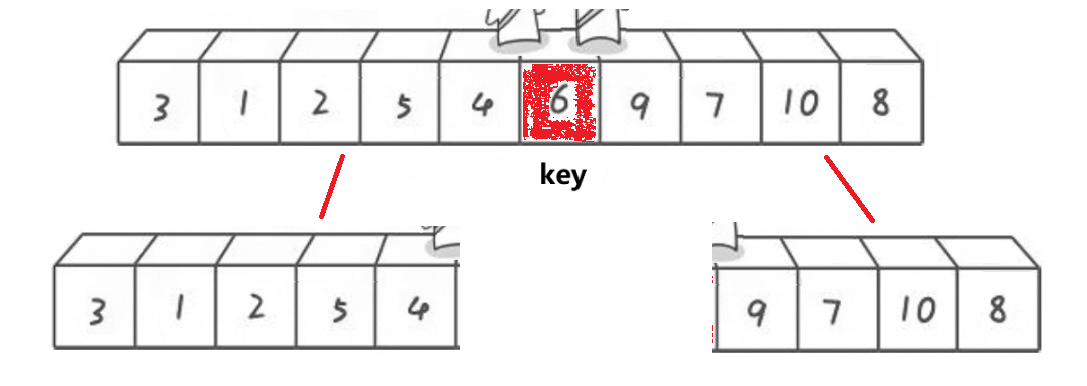
上面的代码就是一趟实现左子序列中所有元素均小于基准值key,右子序列中所有元素均大于基准值key。如下图所示:
2.3 多趟的逻辑(递归)及代码实现
当我们完成第一趟的代码后,6的左边就是全部小于等于本身的值,右边就是全部大于等于本身的值,我们将左边和右边单独分为两个数组,假设这两个数组是有序的话是不是就说明整个数组是有序的了。
那我们怎么让下面的这两个数组有序呢?没错把之前的代码分别在这两个数组中执行一次:
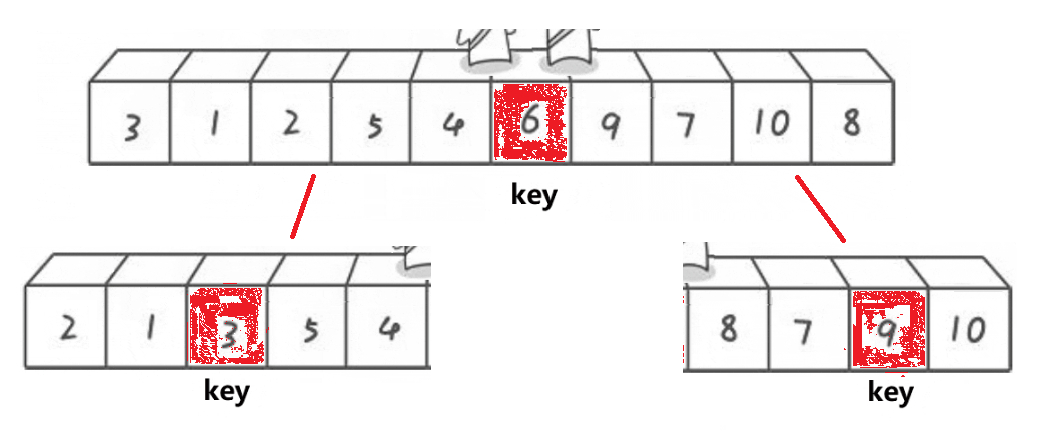
看到这如果学习了之前讲解的二叉树的应该就会感到非常熟悉,因为这个结构就非常类似二叉树的样子。
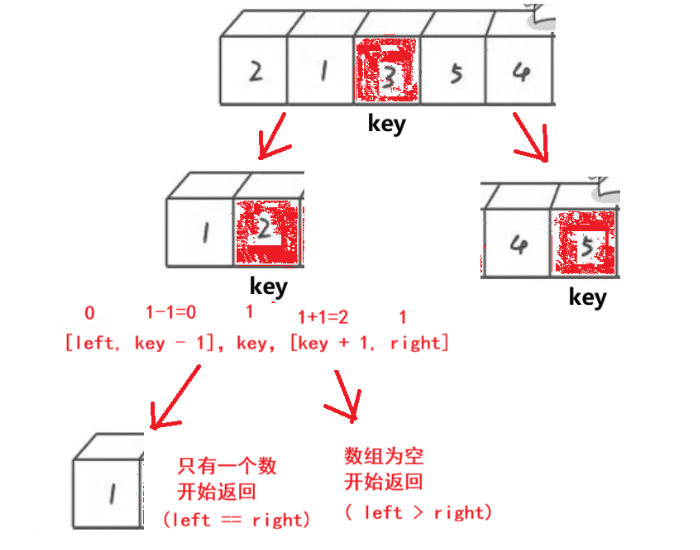
所以我们要把这个数组排成有序的话就需要借助递归的思想了,将一趟完成的数组分成三个部分:[left, key - 1],key,[key + 1, right]。这样的话每次递归的两个数组的左右范围我们就得到了。
但是我们想一下递归肯定是有结束条件的,那这个的结束条件是什么呢?
1)当递归到只剩下一个数时则不需要排序了,此时相当于函数的形参left == right时进行返回;
2)当其中一个部分为空时,如下图所示:
这样我们的递归思路就出来了,具体代码如下:
//Sort.c
//快速排序
void QuickSort(int* arr, int left, int right)
{
	if (left >= right)//满足条件则开始递归返回:等于的情况就是只剩一个数则不需要排序
    //大于的情况是相当于空,如果keyi正好就是left或者right位置,则就会出现这种情况
	{
		return;
	}

	int keyi = left; //把当前数组的开头数字作为key
	int begin = left + 1; //left和right由于后序操作不能改变
	int end = right;      //用begin和end进行替代
	while (begin < end)
	{
		while (arr[keyi] < arr[end] && begin < end)
        //当满足下标为end的值大于开头值且没有相遇则end--
		{
			end--;
		}
		while (arr[keyi] > arr[begin] && begin < end)
        //当满足下标为begin的值小于开头值且没有相遇则begin++
        //但是如果上面if满足条件end--导致此时begin与end相遇则不能再begin++
		{
			begin++;
		}
		Swap(&arr[begin], &arr[end]);
	}
	Swap(&arr[keyi], &arr[begin]);
	keyi = begin;

	//形似二叉树的递归逻辑:[left, keyi - 1] keyi [keyi + 1, right]
	QuickSort(arr, left, keyi - 1);
	QuickSort(arr, keyi + 1, right);
}

//Test.c
void Test1()
{
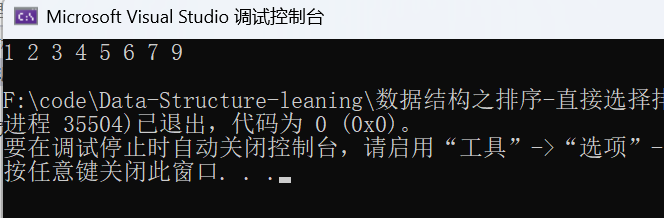
	int arr[] = { 9, 1, 2, 5, 7, 4, 6, 3 };
	//快速排序
	QuickSort(arr, 0, sizeof(arr) / sizeof(arr[0]) - 1);
    //由于快速排序传的是下标所以要减1,需要注意
	PrintArray(arr, sizeof(arr) / sizeof(arr[0]));
}

int main()
{
	Test1();
	return 0;
}
2.4 key的取法
2.4.1 错误的取法
我们会发现前面实现快速排序的代码中基准值key始终取的是数组的开头,而在介绍快速排序时我们讲到了:任取待排序元素序列中的某元素作为基准值。那这样会不会有问题呢?的确是会有的,而且出现问题的情况是当数组接近有序的时候。
这里就有人不理解了,前面我们学到的排序都是当数组有序的时候效率更高,可为什么到了快速排序当数组有序反而会出现问题呢?我们通过一个代码来看一下:
//Test.c
void Test2()
{
	srand((unsigned int)time(NULL));
	const int N = 50000;
	int* a1 = (int*)malloc(sizeof(int) * N);

	for (int i = 0; i < N; i++)
	{
		a1[i] = rand() + i;
	}

	int begin1 = clock();
	QuickSort(a1, 0, N - 1);
	int end1 = clock();

	int begin2 = clock();
	QuickSort(a1, 0, N - 1);
	int end2 = clock();

	printf("QuickSort(无序):%d\n", end1 - begin1);
	printf("QuickSort(有序):%d\n", end2 - begin2);

	free(a1);
}

int main()
{
	//Test1();
	Test2();
	return 0;
}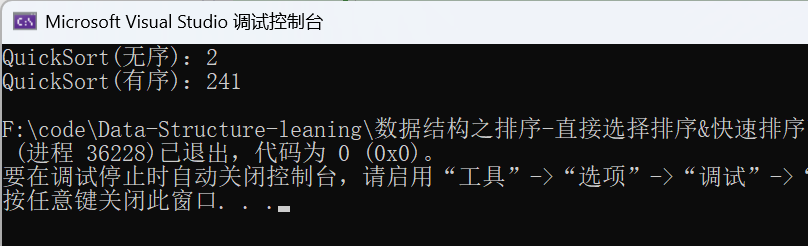
这个代码就是上一篇文章我们对不同排序之间的排序效率进行比较的代码,打印的结果就是通过这个排序所消耗的时间(单位:毫秒),我们会发现第一次对数组排序时数组是无序的,所消耗时间为2,但当数组排成有序后再一次用快速排序我们会发现所消耗的时间竟然变成了241之多,这是为什么呢?
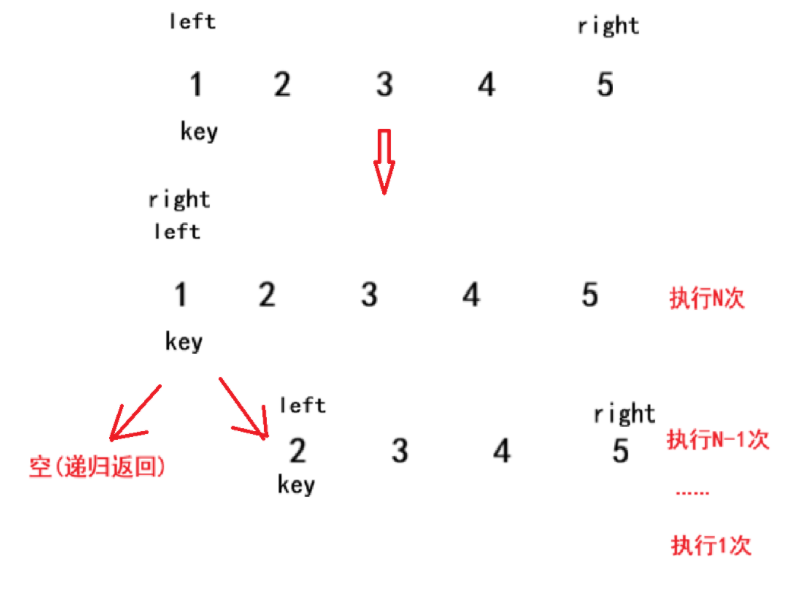
我们以一个五个数的有序数组为例:由于数组是有序的,所以基准值key所在位置的值就是数组中最小的,则right需要一直right--直到与left相遇,此时将数组分成三个部分的话就会导致一个情况:始终左边为空而右边是剩余部分。
第一趟所消耗的循环次数为5次,第二趟所消耗的循环次数为4次,则如果数组个数为N的话通过递归执行所消耗的总次数为:1 + 2 + … + N,则时间复杂度为
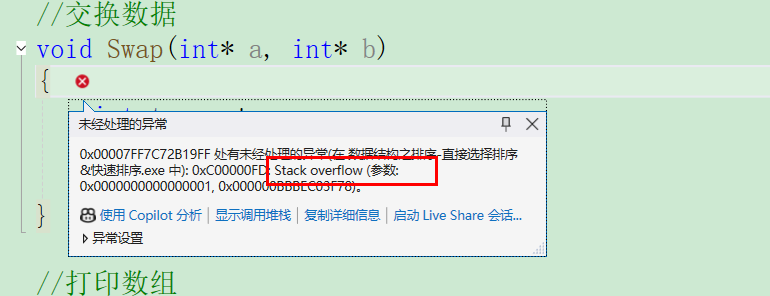
而且这还不是最致命的问题,我们知道递归是需要额外开辟新的栈空间,而栈空间是有限的,当我们递归过深而大量开辟栈空间可能就会导致栈溢出的严重问题。当我们上述代码的N改为100000时导致栈溢出问题:
2.4.2 三数取中
之所以会出现这种情况的原因就在于基准值key所处位置的值在数组中非常小或者非常大,导致left或者right需要一直移动,当left与right相遇时数组的三个部分就会呈现上图的情况。
我们如果要解决这个问题就需要让key所在位置的值是折中的,不能太大也不能太小,所以就用到了三数取中这个方法:
首先我们需要创建一个新变量mid = (left + right) / 2,然后比较 arr [ left ],arr [ right ] 以及 arr [ mid ]三者之间的大小关系,将中间大小的值进行返回来作为mid。然后我们将开头与中间值进行交换,这样我们就能基本保证每次key所在位置的值不会太大或者太小。具体代码如下:
//Sort.c
//三数取中
int GetMid(int* arr, int left, int right)
{
	int midi = (left + right) / 2;
	if (arr[midi] < arr[right])
	{
		if (arr[left] < arr[midi]) //arr[left] < arr[midi] < arr[right]
		{
			return midi; //中间值作为key
		}
		else //arr[right] > arr[midi] 且 arr[left] > arr[midi] ->arr[midi]最小
		{
			if (arr[left] > arr[right])//arr[left] > arr[right] > arr[midi]
			{
				return right;
			}
			else //arr[right] > arr[left] > arr[midi]
			{
				return left;
			}
		}
	}
	else //arr[midi] > arr[right]
	{
		if (arr[left] > arr[midi]) //arr[left] > arr[midi] > arr[right]
		{
			return midi;
		}
		else //arr[right] < arr[midi] 且 arr[left] < arr[midi] ->arr[midi]最大
		{
			if (arr[right] > arr[left])//arr[left] < arr[right] < arr[midi]
			{
				return right;
			}
			else //arr[right] < arr[left] < arr[midi]
			{
				return left;
			}
		}
	}
}

//快速排序
void QuickSort(int* arr, int left, int right)
{
	if (left >= right)
	{
		return;
	}

	int midi = GetMid(arr, left, right); //三数取中
    Swap(&arr[left], &arr[midi]);//将中间值与开头进行交换来作为key

    int keyi = left;
	int begin = left;
	int end = right;
	while (begin < end)
	{
		while (arr[keyi] <= arr[end] && begin < end)
		{
			end--;
		}
		while (arr[keyi] >= arr[begin] && begin < end)
		{
			begin++;
		}
		Swap(&arr[begin], &arr[end]);
	}
	Swap(&arr[keyi], &arr[begin]);
	keyi = begin;

	QuickSort(arr, left, keyi - 1);
	QuickSort(arr, keyi + 1, right);
}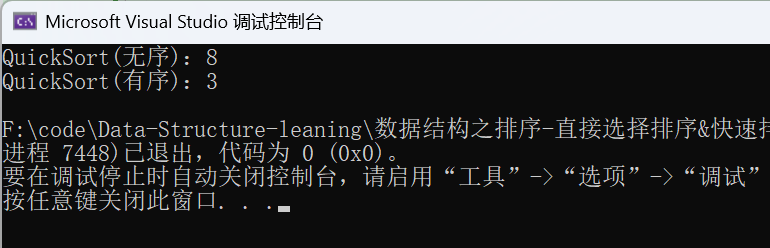
利用三数取中的方法获取key,通过有序数组排序所消耗的时间我们发现的确是可行的。
2.5 小区间优化
当我们利用三数取中的方法解决了key取法的问题后,快速排序的效率对于比较有序的数组来说就更加高效了,但还能不能继续优化呢?其实是可以的。
上面的讲解中我们就知道了了快速排序的逻辑就是基于二叉树的递归的逻辑实现的,那我们想一下当递归到数组只有五六个数据的时候还没必要继续递归吗?
我们知道当一个数组数据量非常大时,如果结构为二叉树则最后一层的数据量占总数的50%,倒数第二层占总数的25%,以此类推如果我们让最后三、四层不进行递归则递归总次数能减少80%~90%,这样由于递归建立新的栈空间就会少很多,消耗也就非常少了。
不进行递归的数组则可以直接使用插入排序即可,这就叫做小区间优化。
//Sort.c
//快速排序
void QuickSort(int* arr, int left, int right)
{
	if (left >= right)
	{
		return;
	}

	if ((right - left + 1) < 10) //当递归到数组中数据量过少时则无需进行递归而过多消耗
	{
		InsertSort(arr + left, right - left + 1);
		//直接插入排序的数组开头为arr + left,数据个数为right - left + 1
	}
	else
	{
		int midi = GetMid(arr, left, right); //三数取中
		Swap(&arr[left], &arr[midi]);//将中间值与开头进行交换来作为key

		int keyi = left;
		int begin = left;
		int end = right;=
		while (begin < end)
		{
			while (arr[keyi] <= arr[end] && begin < end)
			{
				end--;
			}
			while (arr[keyi] >= arr[begin] && begin < end)
			{
				begin++;
			}
			Swap(&arr[begin], &arr[end]);
		}
		Swap(&arr[keyi], &arr[begin]);
		keyi = begin;

		//形似二叉树的递归逻辑:[left, keyi - 1] keyi [keyi + 1, right]
		QuickSort(arr, left, keyi - 1);
		QuickSort(arr, keyi + 1, right);
	}
}
3、lomuto前后指针版本
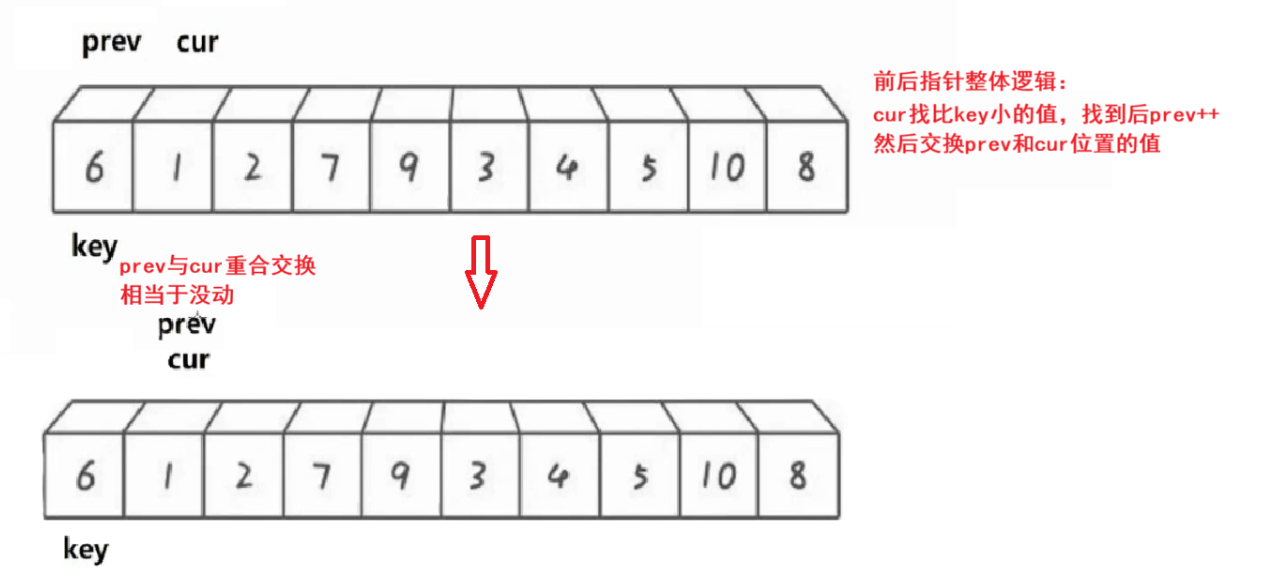
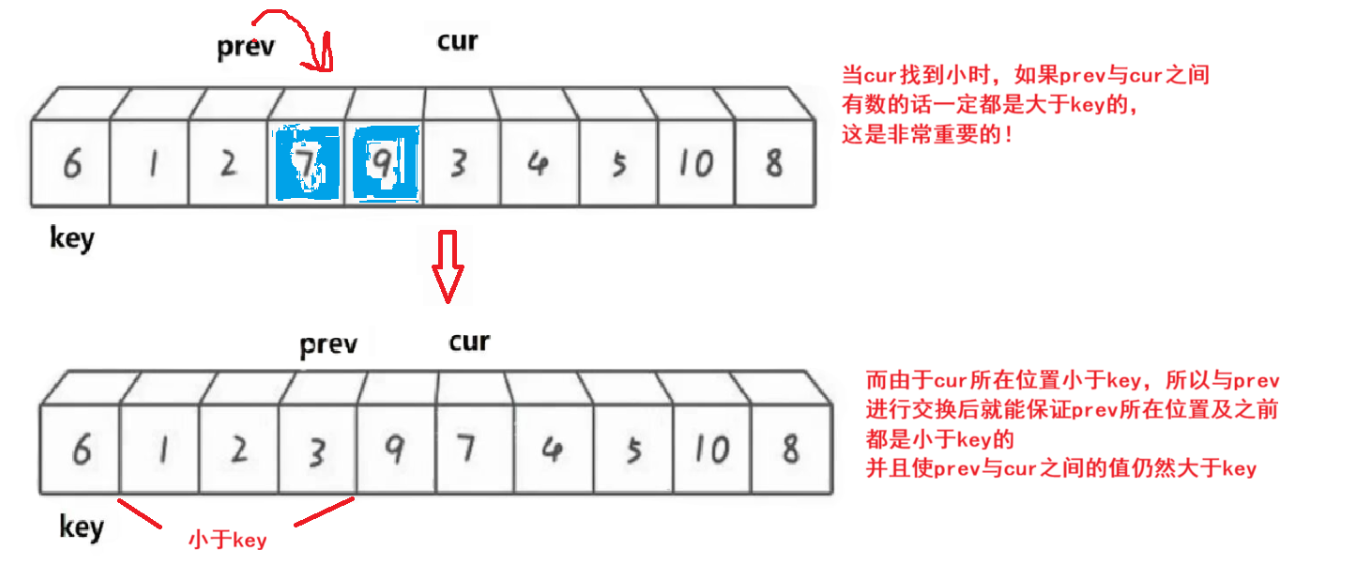
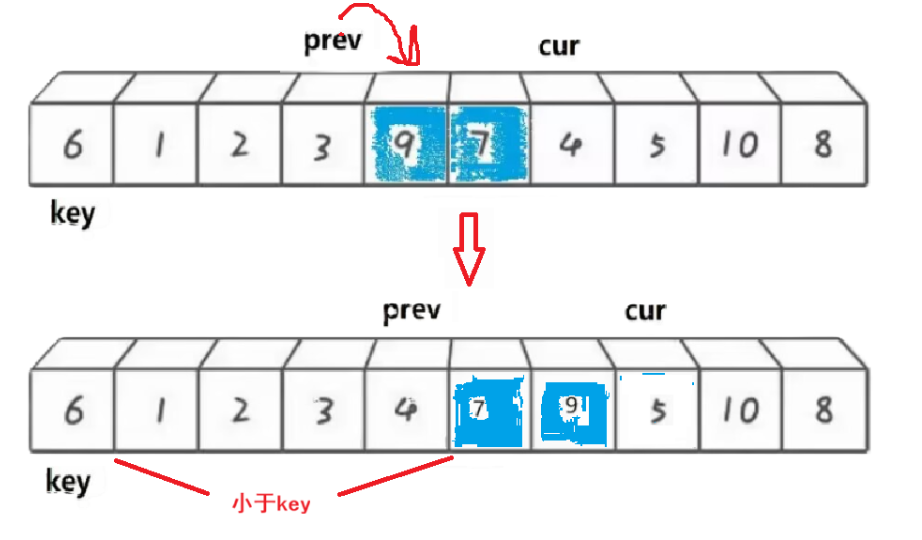
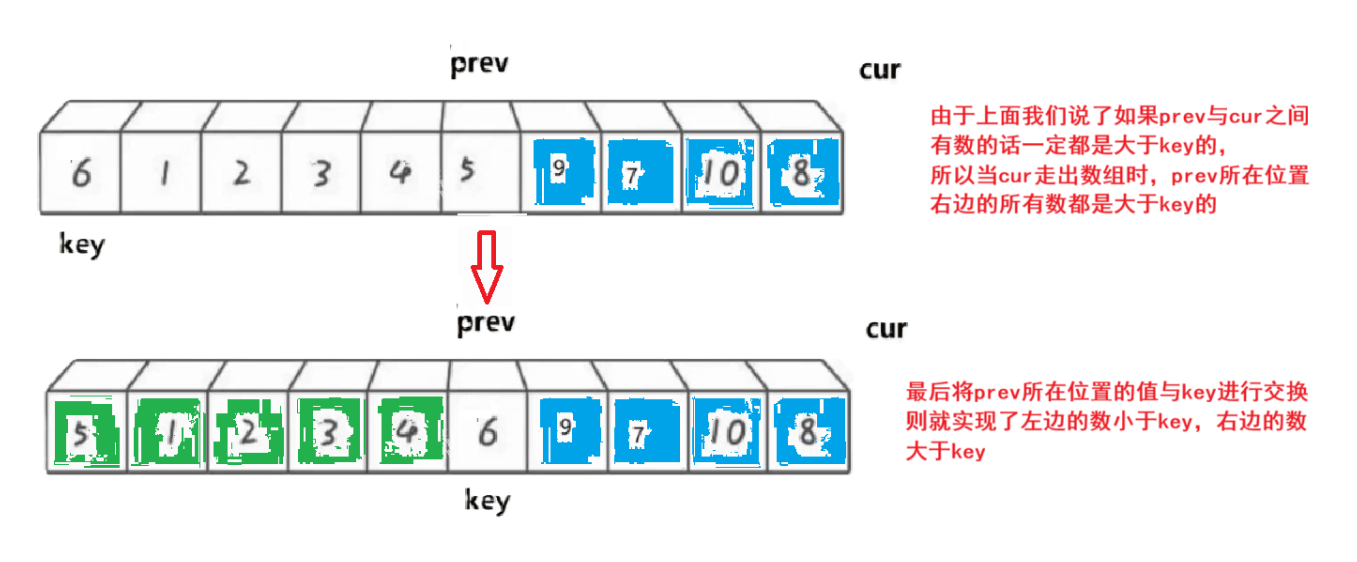
由于hoare版本就是hoare当时提出快速排序时想出的方法,到现在过了很长时间了,所以就有人提出了一个新的方法解决快速排序就是前后指针。但需要注意的是这个方法只是对快速排序的单趟进行了修改,多趟还是基于二叉树的递归思想解决的。
3.1 动图展示及逻辑分析
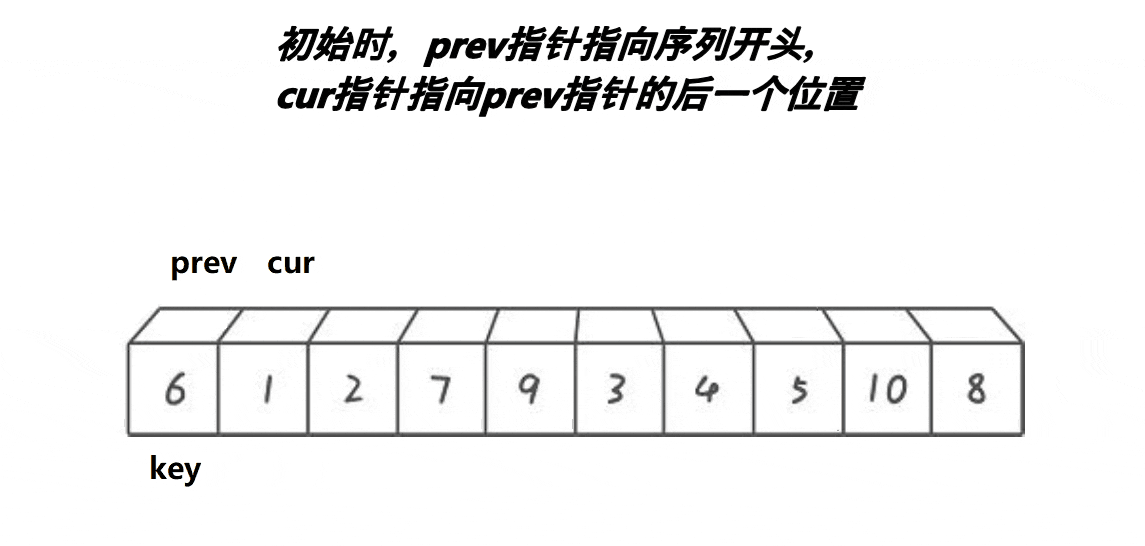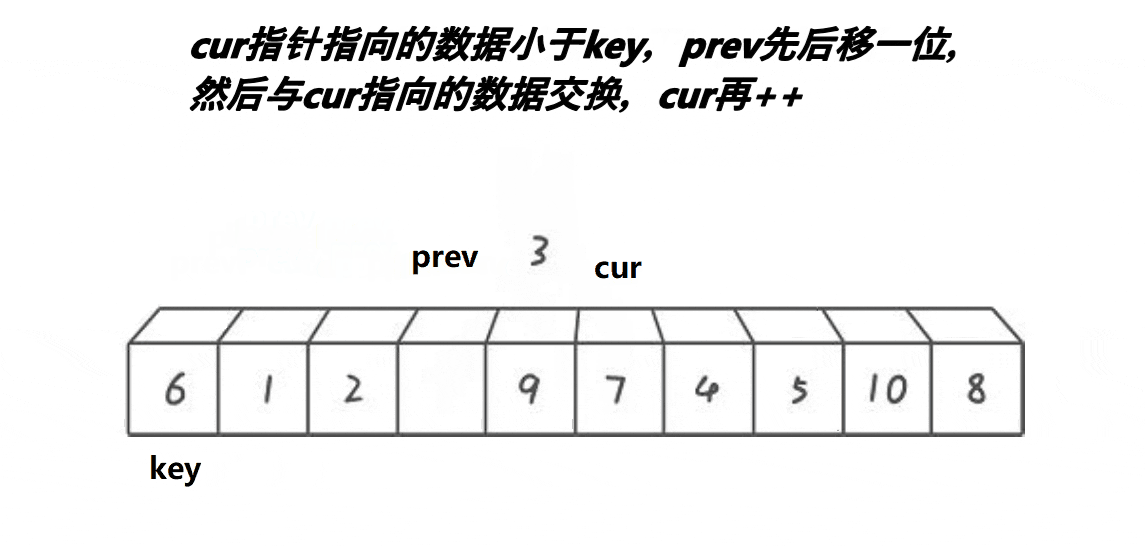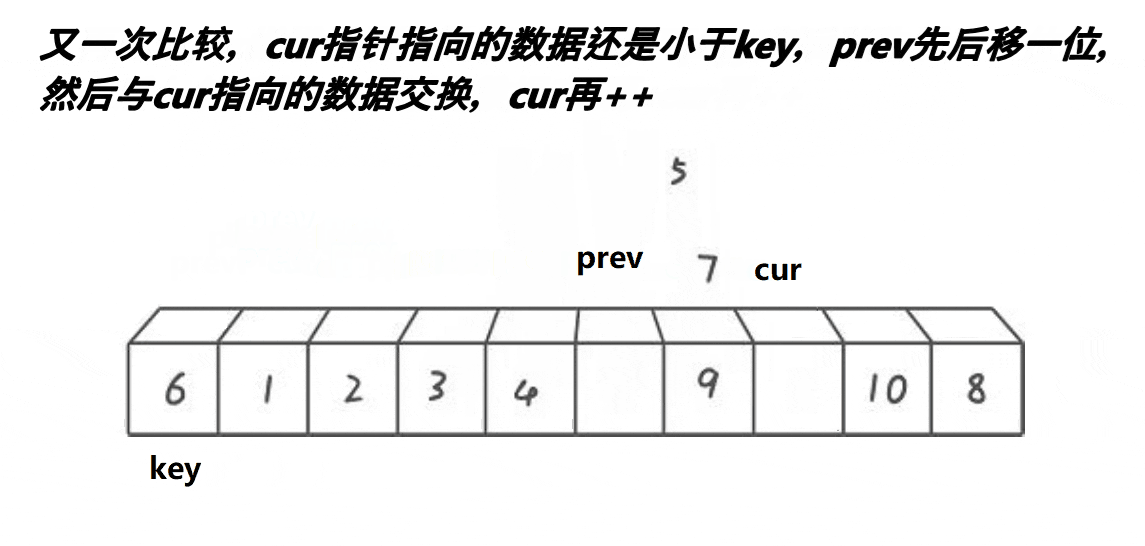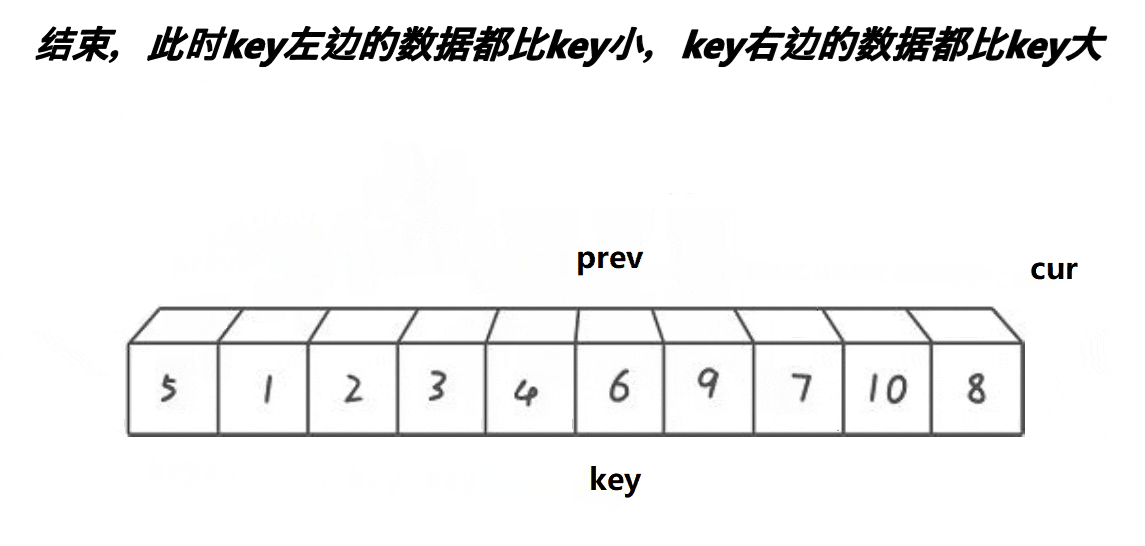
看这个动图可能有些人一开始会不了解前后这两个指针在干什么,接下来我就将图拆分进行讲解:
3.2 前后指针的代码实现
//Sort.h
//快速排序(lomuto前后指针)
void QuickSort2(int* arr, int left, int right);

//Sort.c
//快速排序(lomuto前后指针)
void QuickSort2(int* arr, int left, int right)
{
	if (left >= right)
	{
		return;
	}

	if ((right - left + 1) < 10)
	{
		InsertSort(arr + left, right - left + 1);
	}
	else
	{
		int midi = GetMid(arr, left, right); //三数取中
		Swap(&arr[left], &arr[midi]);//将中间值与开头进行交换来作为key
		int keyi = left;

		//lomuto前后指针(单趟)
		int prev = left;
		int cur = left + 1;
		while (cur <= right)
		{
			if (arr[cur] < arr[keyi])
			{
				prev++;
				Swap(&arr[prev], &arr[cur]);
			}
			cur++;
		}
		Swap(&arr[keyi], &arr[prev]);
		keyi = prev;

		//形似二叉树的递归逻辑:[left, keyi - 1] keyi [keyi + 1, right]
		QuickSort(arr, left, keyi - 1);
		QuickSort(arr, keyi + 1, right);
	}
}
4、非递归版本
但我们想一个问题:上面不管是hoare版本还是lomuto版本都需要借助递归的思想,但我们提到过递归是需要开辟栈空间的,但栈空间是非常有限的,所以哪怕我们进行了各种优化,如果递归深度比较深也不可避免会出现栈溢出的风险。所以我们考虑用非递归的方法取实现快速排序。
这里我们需要借助之前我们学习到的一个数据结构:栈。
首先我们为什么用栈来实现递归逻辑,因为栈是在堆区开辟空间,而堆区的空间是远远大于栈区的,所以就基本不会出现空间溢出的情况。
其次我们用栈怎么去实现快速排序的逻辑呢?
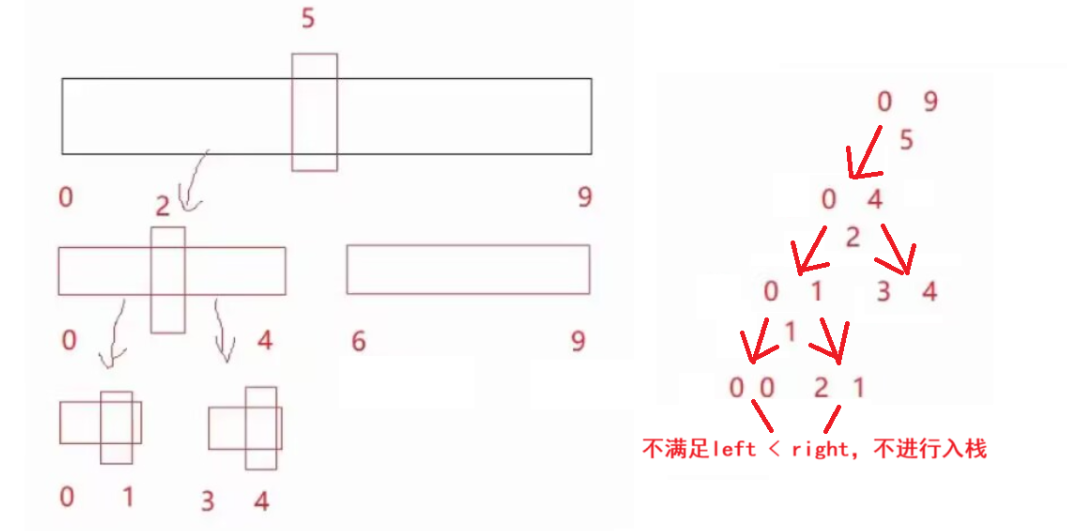
这就需要利用栈的特点:先进后出、后进先出的逻辑。
以上图为例:我们以数组的左右区间 left 和 right 为一组入栈,然后按组取出栈顶数据进行单趟排序;此时 key 就会把数组分成三个部分:[left, key - 1] key [key + 1, right],我们就先后把右子区间和左子区间如果满足条件则进行入栈,这样我们的非递归逻辑就完成了。
可能有些人还是不清楚到底是什么样子的,所以我用栈的图让大家更好理解怎么操作的:
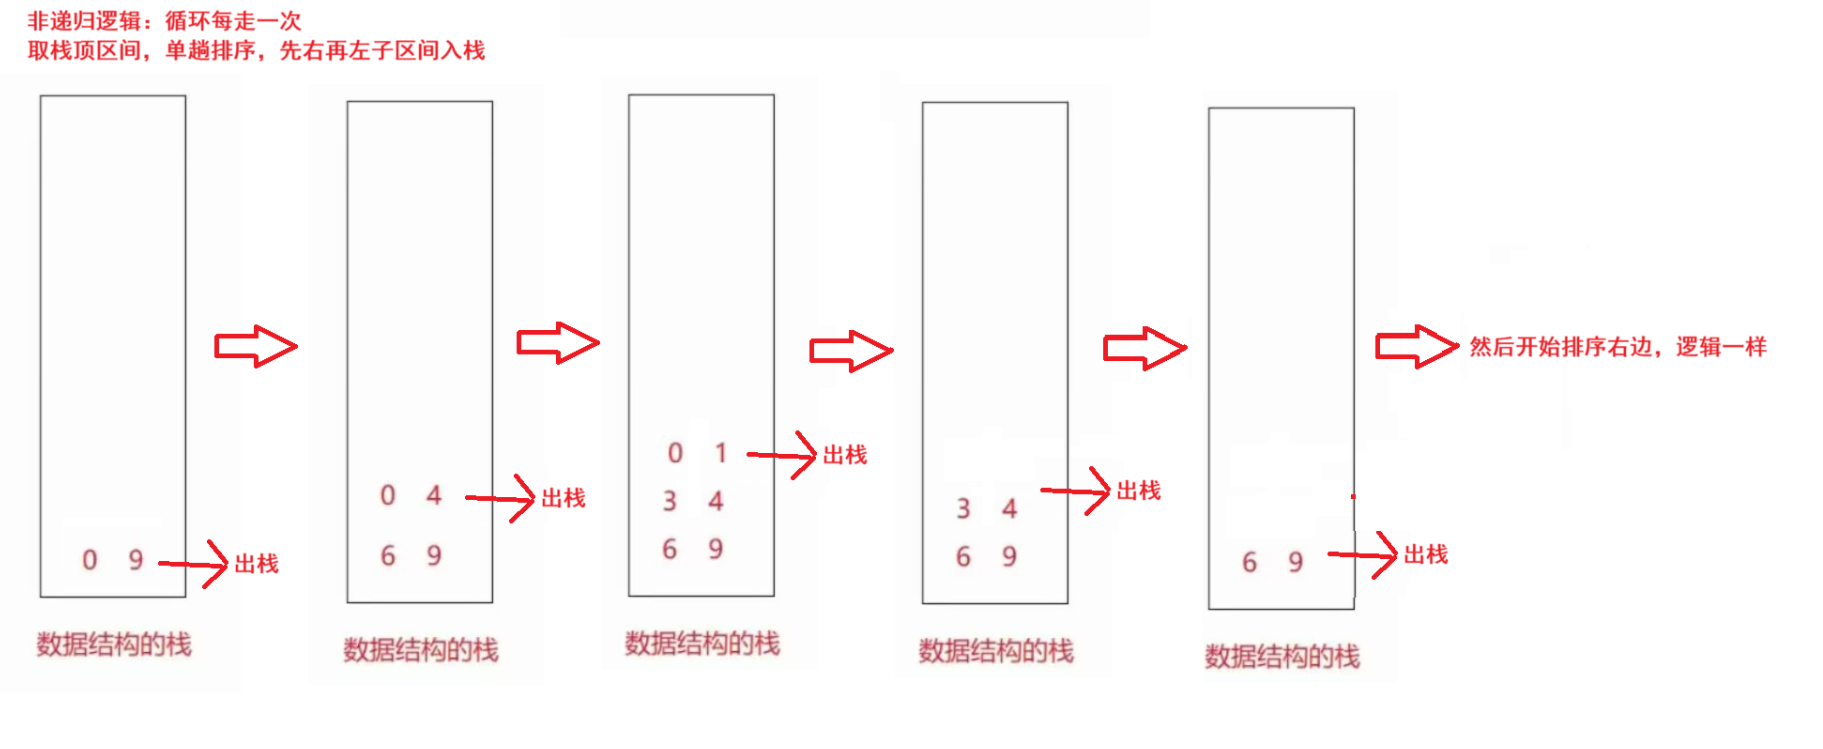
我们把栈的图与上面的递归图进行对比就知道为什么我们要先入栈右子区间再入栈左子区间了,就是为了模拟实现递归的思想,递归是先进左子区间,完后再进右子区间,而由于栈是后进先出,所以后进的左子区间就可以先取出来进行单趟排序了。
由于我们是用栈来实现非递归的快速排序,所以需要利用栈的相关方法实现,如果没印象的或者不熟悉的可以回顾一下我们前面的文章数据结构之栈和队列-栈,具体代码如下:
//Sort.h
//非递归版本(建栈)
void QuickSortNonR(int* arr, int left, int right);

//Sort.c
#include "Stack.h"
//非递归版本(建栈)
void QuickSortNonR(int* arr, int left, int right)
{
	ST st; //建栈
	STInit(&st); //初始化栈

	STPush(&st, left); //同时存放left和right相当于是一组
	STPush(&st, right);

	while (STSize(&st))
	{
		int end = STTop(&st); //注意栈是后进先出,所以后放入right要先取出来,相当于是end
		STPop(&st);
		int begin = STTop(&st); //先放入left相当于begin
		STPop(&st);

		//单趟排序(前后指针)
		int midi = GetMid(arr, begin, end); //三数取中
		Swap(&arr[begin], &arr[midi]);//将中间值与开头进行交换来作为key
		int keyi = begin;

		int prev = begin;
		int cur = begin + 1;
		while (cur <= end)
		{
			if (arr[cur] < arr[keyi])
			{
				prev++;
				Swap(&arr[prev], &arr[cur]);
			}
			cur++;
		}
		Swap(&arr[keyi], &arr[prev]);
		keyi = prev;

		//[begin, keyi - 1] keyi [keyi + 1, end]
		if (keyi + 1 < end)
		{
			STPush(&st, keyi + 1);
			STPush(&st, end);
		}
		if (begin < keyi - 1)
		{
			STPush(&st, begin);
			STPush(&st, keyi - 1);
		}
	}
	STDestroy(&st);
}
当我们用栈实现完非递归代码后可能就有些人会问:那与栈逻辑相反的队列是否能实现非递归的快速排序呢?其实是可以实现的,但逻辑上就不是模拟递归的思想了。
我们要知道队列的特点是:先进先出、后进后出。当我们取出一组区间后进行单趟排序,则需要将左右子区间进行入队列;然后取出左子区间后进行单趟排序,将其左右子区间进行入队列;到这就是关键的点了:由于队列先进先出的逻辑,此时我们再取出栈的数据应该是上一个区间的右子区间然后进行单趟排序。
到这里其实我们就会发现这个逻辑不就是前面我们学习的层序遍历的逻辑吗?并且我们二叉树的层序遍历也是利用队列来实现的,所以这样就联系起来了。这就是为什么我说队列也能实现非递归的快速排序,但并不是模拟递归的逻辑,而是层序遍历的逻辑。
结束语
到此我们选择排序中的直接插入排序以及交换排序中的快速排序就讲解完了,最重要的其实就是快速排序,本质原因就是快排的效率很高,平常用的基本也是快速排序,所以本篇文章我对快速排序讲解的非常详细了。到现在我们就只剩下一个归并排序了,下篇文章我们就会对归并排序进行讲解。希望这篇文章对大家学习排序能有所收获!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 36
 0
- 0


 已为社区贡献2条内容

所有评论(0)