接口自动化测试
接口测试就是通过测试不同情况下的入参与之对应的出参信息来判断接口是否符合或满足相应的功能性、安全性要求
接口文档一般包含以下内容:
- 接口说明
- 调用url
- 请求方法(get/post)
- 请求参数、参数类型、请求参数说明
- 返回参数说明
部分接口有请求头(是服务器以HTTP协议传HTML资料到浏览器前所送出的字符串
HTTP状态码:
- 200:2开头的都表示这个请求发送成功,最常见的也是200,代表请求成功
- 300:3开头的代表重定向,最常见的是302,把这个请求重定向到别的地方了
- 400:4开头代表客户端发送的请求有语法错误,401代表访问的页面没有授权,403表示没有权限访问这个页面,404代表没有这个页面
- 500:5开头代表服务器有异常,500代表服务器内部异常,504代表服务器端超时,没返回结果
一、接口用例的编写
1. 通过性验证
正常的通过性测试,按照接口文档上的参数正常传入,是否可以返回正确的结果
2. 参数组合
3. 接口安全
绕过验证、身份授权等,参数是否加密
4. 异常验证
不按照接口文档上的要求输入参数,来验证接口对异常情况的校验
5. 结合具体的业务逻辑
二、接口自动化测试
1. 概念
接口自动化是通过对接口进行测试和模拟,以确保软件系统内部的各个组件能够正确的相互通信和交换数据
2. 接口自动化流程
2.1 需求分析
分析请求:明确接口的URL、请求方法、请求头、请求参数和请求体等信息
分析响应:确定接口返回的数据格式、状态码以及看你的错误信息
2.2 挑选自动化接口
功能复杂度:优先选择功能复杂、逻辑分支多的接口进行自动化测试
高风险功能:选择对业务影响大、风险高的接口进行自动化测试
重复性高:对于需要频繁执行的测试任务,如回归测试
2.3 设计自动化测试用例
如果在功能测试阶段已经设计了测试用例,可以直接使用
根据接口需求和功能,设计正向测试用例和反向测试用例,包括边界值测试、参数组合测试等
2.4 搭建自动化测试环境
以python为例,安装必要的依赖库,如requests用于发送HTTP请求,pytest用于测试框架
2.5 设计自动化执行框架
设计一个框架来执行测试用例
2.6 编写代码
根据设计好的测试用例和框架,编写自动化测试脚本
2.7 执行用例
使用测试框架来执行编写的测试用例
2.8 生成测试报告
3. requests模块
requests库是一个非常流行的 HTTP客户端库,用于发送HTTP请求,requests.get方法用于发送一个HTTP get请求到指定的URL,返回一个Response对象,这个对象包含了服务器返回的所有信息
4. 自动化框架pytest
4.1 用例运行规则
- 文件名必须以test_开头或者_test结尾
- 测试类必须以Test开头,并且不能有__init__方法
- 测试方法必须以test开头
当满足以上要求后,可通过命令行参数pytest直接运行符合条件的用例
4.2 pytest命令参数
pytest -v:增加输出的详细程度
pytest -s:显示测试中的print语句
pytest 包名/文件名:指定文件
pytest 包名/文件名/::类名::方法名:指定测试用例
当我们需要手动输入多条命令时,可以将需要的相关配置参数统一放到pytest配置文件中
4.3 pytest配置文件
addopts:指定在命令行中默认包含的选项
testpaths:指定搜索测试的目录
python_files:指定发现测试模块时使用的文件匹配模式
python_classes:指定发现测试类时使用的类名前缀或模式
配置好pytest.ini文件后,命令行执行pytest命令即可,无需再额外指定其他参数
4.4 前后置
在测试框架中,前后置是指在执行测试用例前和测试用例后执行一些额外的操作,这些操作可以用于设置测试环境、准备测试数据等,以确保测试的可靠性
pytest框架提供三种方法做前后置的操作:
- setup_method和teardown_method:这两个方法用于类中的每个测试方法的前置和后置操作
- setup_class和teardown_class:这两个方法用于整个测试类的前置和后置操作
- fixture:是pytest推荐的方式
4.5 断言
断言是一种调试辅助工具,用于检查程序的状态是否符合预期。如果断言失败(即条件为假),Python解释器将抛出一个AssertionError异常。断言通常用于检测程序中的逻辑错误。pytest允许在Python测试中使用标准的Python assert语句来验证预期的值
assert 条件, 错误信息
条件:必须是一个布尔表达式
错误信息:当条件为假时显示的错误信息,可选
#断⾔整数
a = 1
b = 2
assert a == b
#断⾔字符串
str = "hello"
assert "hello" == str
def test():
# 断⾔列表
expect_list = [1, 'apple', 3.14]
actual_list = [1, 'apple', 3.14]
# 断⾔元组
expect_tuple = (1, 'apple', 3.14)
actual_tuple = (1, 'apple', 3.14)
# 断⾔字典
expect_dict = {'name': 'Alice', 'age': 25}
actual_dict = {'name': 'Alice', 'age': 25}
# 断⾔集合
expect_set = {1, 2, 3, 'apple'}
actual_set = {1, 2, 3, 'apple'}

assert expect_list == actual_list
assert expect_tuple == actual_tuple
assert expect_dict == actual_dict
assert expect_set == actual_set
def divide(a, b):
assert b != 0, "除数不能为0"
return a / b
# 正常情况
print(divide(10, 2)) # 输出 5.0
# 触发断⾔
print(divide(10, 0)) # 抛出 AssertionError: 除数不能为0
#断⾔接⼝返回值完整字段和值
def test1():
url = "http://jsonplaceholder.typicode.com/posts/1"
r = requests.get(url=url)
expect_data = {
"userId": 1,
"id": 1,
"title": "sunt aut facere repellat provident occaecati excepturi optio
reprehenderit",
"body": "quia et suscipit\nsuscipit recusandae consequuntur expedita et
cum\nreprehenderit molestiae ut ut quas totam\nnostrum rerum est autem sunt
rem eveniet architecto"
}
print(r.json())
assert r.json() == expect_data
assert r.json()['userId'] == 1
#断⾔接⼝返回值重要字段
def test2():
url = "http://jsonplaceholder.typicode.com/comments?postId=1"
r = requests.get(url=url)
print(r.json())
assert r.json()[1]['id'] == 1
#断⾔接⼝html返回值
def test3():
url = "http://jsonplaceholder.typicode.com/"
r = requests.get(url=url)
assert "Use your own data" in r.text
4.6 参数化
参数化设计是自动化设计中的一个重要组成部分,通过定义设计参数和规则,使得设计过程更加灵活和可控
pytest中内置的pytest.mark.parametrize装饰器允许对测试函数的参数进行参数化
#在用例上使用参数化
import pytest
@pytest.mark.parametrize("test_input,expected", [("3+5", 8), ("2+4", 6),
("6*9", 42)])
def test_eval(test_input, expected):
assert eval(test_input) == expected
#在类上使用参数化
import pytest
@pytest.mark.parametrize("n,expected", [(1, 2), (3, 4)])
class TestClass:
def test_simple_case(self, n, expected):
assert n + 1 == expected
def test_weird_simple_case(self, n, expected):
assert (n * 1) + 1 == expected
要对模块中的所有测试进行参数化,可以将pytestmark全局变量赋值:
import pytest
pytestmark = pytest.mark.parametrize("n,expected", [(1, 2), (3, 4)])
class TestClass:
def test_simple_case(self, n, expected):
assert n + 1 == expected
def test_weird_simple_case(self, n, expected):
assert (n * 1) + 1 == expected
除了使用parametrize添加参数化外,pytest.fixture()允许对fixture函数进行参数化
def data_provider():
return ["a", "b"]
# 定义⼀个测试函数,它依赖于上⾯函数的返回值
@pytest.mark.parametrize("data", data_provider())
def test_data(data):
assert data != None
print(f"Testing with data provider: {data}")
4.7 fixture
pytest中的fixture是一种强大的机制,用于提供测试函数所需的资源或上下文,可以用于设置测试环境、准备数据等
4.7.1 基本使用
未标记fixture方法的调用
def fixture_01():
  print("第⼀个fixture标记的⽅法")
def test_01():
  fixture_01()
  print("第⼀个测试⽤例")
fixture标记的方法调用
import pytest

@pytest.fixture
def fixture_01():
  print("第⼀个fixture标记的⽅法")
def test_01(fixture_01):
  print("第⼀个测试⽤例")
前者需要在方法体中调用,后者可以将函数名作为参数进行调用
示例:访问列表页和详情页之前都需要执行登陆操作
import pytest

@pytest.fixture
def login():
  print("---执⾏登陆操作-----")
def test_list(login):
  print("---访问列表⻚")
def test_detail(login):
  print("---访问详情⻚")
通过使用@pytest.fixture装饰器来告诉pytest一个特定函数是一个fixture,通过运行结果可见,在执行列表页和i详情页之前都会先执行login方法
4.7.2 fixture嵌套
# test_append.py的内容
import pytest

# 安排
@pytest.fixture
def first_entry():
  return "a"

# 安排
@pytest.fixture
def order(first_entry):
  return [first_entry]

def test_string(order):
  # ⾏动
  order.append("b")

  # 断⾔
  assert order == ["a", "b"]
测试不必局限于单个 fixture,可以有任意数量的fixture,并且fixture也可以使用其他的fixture
4.7.3 请求多个fixture
import pytest

class Fruit:
  def __init__(self, name):
    self.name = name

  def __eq__(self, other):
    return self.name == other.name

@pytest.fixture
def my_fruit():
  return Fruit("apple")

@pytest.fixture
def fruit_basket(my_fruit):
  return [Fruit("banana"), my_fruit]

def test_my_fruit_in_basket(my_fruit, fruit_basket):
  assert my_fruit in fruit_basket
测试和fixture不仅限于一次请求单个fixture,可以请求任意多个
4.7.4 yield fixture
fixture提供了一个非常有用的拆卸系统,可以运行一些代码,并将对象返回给请求的fixture/test,和其他的fixture一样,唯一不同的是:
- return被替换为yield
- 该fixture的任何拆卸代码被放置在yield之后
测试函数执行完成后,自动执行yield之后的代码,清理yield之前创建的资源
4.7.5 带参数的fixture
pytest.fixture(scope='', params='', autouse='', ids='', name='')
- scope参数用于控制fixture的作用范围,决定了fixture的生命周期,可选值有:
- function(默认):每个测试函数都会调用一次fixture
- class:在同一个测试类中共享这个fixture
- module:在同一个测试模块中共享这个fixture(一个文件)
- session:整个测试会话中共享这个fixture
- autouse参数默认为False,如果设置为True,则每个测试函数都会自动调用该fixture,无需显示传入
- params参数由于参数化fixture,支持列表传入。每个参数值都会使fixture执行一次,类似于for循环
- ids参数与params配合使用,为每个参数化实例指定可读的标识符(给参数取名字)
- name参数用于为fixture显示设置一个名称,如果使用了name,则在测试函数中需要使用这个名称来引用fixture(给fixture取名字)
scope默认为function,这里的function可以省略不写,当scope=“function”时,每个测试函数都会调用一次fixture。scope=“class”时,在同一个测试类中,吗,fixture只会在类中的第一个测试函数开始前执行一次,并在类中的最后一个测试函数结束后执行清理
conftest.py和@pytest.fixture结合使用实现全局的前后置应用,规则如下:
- conftest.py是一个单独存放的夹具配置文件,名称是固定的不能修改
- 可以在不同目录下创建多个conftest.py文件,每个文件都会对其所在目录及其子目录下的测试模块生效
- 在不同模块的测试中需要用到conftest.py的前后置功能时,不需要做任何的导入操作
- 作用:可以在不同的.py文件中使用同一个fixture函数
5. YAML
YAML是一种数据序列化语言,用于以人类可读的形式存储信息,特点:
- 主要用于存储配置信息
- 是一种简单的基于文本的人类可读的语言
- 减少了JSON和XML文件中的大部分“噪音”格式
注意:
- 区分大小写
- 不允许使用制表符Tab键
- 遵循严格缩进
5.1 YAML介绍
YAML文件的后缀名是.yml
不同的数据类型在写法上稍有区别
如若短时间内无法掌握语法,可以使用JSON转YAML工具:https://www.jashtool.com/json/to-yaml
5.2 使用
yaml文件通常作为配置文件来使用,可以使用yaml库来读取和写入YAML文件
- 安装yaml库
- 创建yaml文件
- 读取和写入yaml文件
6. JSON Schema
JSON Schema是一个用来定义和校验JSON的web规范
可以使用工具将JSON数据转为JSON Schema:https://tooltt.com/json2schema/
要对自动生成的结果进行二次检查
6.1 数据类型
type关键字制定了数据类型,可以验证JSON数据中每个属性的数据类型是否符合预期,常用的数据类型包括:
- string:字符串类型,用于文本数据
- number:数字类型,由于表示浮点数
- integer:整数类型,用于表示整数
- boolean:布尔类型,值为true或false
- object:对象类型,用于嵌套的JSON对象
- array:数组类型,由于列表或集合
- null:空值类型
{
"type": "object",
"properties": {
"name": { "type": "string" },
"age": { "type": "integer" }
}
}
properties是一个验证关键字,当定义它时,创建了一个对象,其中每个属性代表正在验证的JSON数据中的一个键
6.2 最大最小值
- minimum和maximum:指定数值的最小值和最大值
- exclusiveMinimum和exclusiveMaximum:指定数值必须严格大于或小于某个值
{
"type": "object",
"properties": {
"age": {
"type": "integer",
"minimum": 0,
"maximum": 120
}
}
}
6.3 字符串特殊校验
- pattern:使用正则表达式来验证字符串是否符合特定的模式
{
"type": "object",
"properties": {
"email": {
"type": "string"
},
"username": {
"type": "string",
"pattern": "\S+"
}
}
}
6.4 数组约束
- minItems和maxItems:指定数组的最小和最大长度
- uniqueItems:确保数组中的元素是唯一的
- items:定义数组中每个元素的类型和约束
"type": "object",
"properties": {
"tags": {
"type": "array",
"items": { "type": "string" },
"minItems": 1,
"uniqueItems": True
}
}
}
6.5 对象约束
- minProperties和maxProperties:指定对象的最小和最大属性数量
- additionalProperties:控制是否允许对象中存在未在properties中定义的额外属性,默认为true
{
"type": "object",
"properties": {
"name": { "type": "string" }
},
"minProperties": 1,
"additionalProperties": False
}
6.6 必需属性
通过required关键字,JSON Schema可以指定哪些属性是必需的,如果JSON实例中却少了这些必需属性,将验证失败
{
"type": "object",
"properties": {
"name": { "type": "string" },
"email": { "type": "string" }
},
"required": ["name", "email"]
}
6.7 依赖关系
dependentRequired可以定义属性之间的依赖关系,例如:如果某个属性存在,则必须存在另一个属性
{
"type": "object",
"properties": {
"creditCard": { "type": "string" },
"billingAddress": { "type": "string" }
},
"dependentRequired": {
"creditCard": ["billingAddress"]
}
}
7. logging日志模块
logging是Python标准库中一个模块,提供了灵活的日志记录功能,通过logging,可以方便的将日志信息输出到控制台、文件、网络等多种目标,同时支持不同级别的日志记录
7.1 全局logging
import logging
logging.basicConfig(level=logging.INFO)
logging.debug('This is a debug message')
logging.info('This is an info message')
logging.warning('This is a warning message')
logging.error('This is an error message')
logging.critical('This is a critical message')
7.2 自定义logger并输出到控制台
# 导⼊ logging 模块
import logging

logging.basicConfig(level=logging.INFO)

# 获取⼀个⽇志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)

# 设置⽇志记录器的级别为 DEBUG
# 这意味着所有级别为 DEBUG 及以上的⽇志都会被记录
logger.setLevel(logging.DEBUG)

if __name__ == "__main__":
  logger.debug('This is a debug message')
  logger.info('This is an info message')
  logger.warning('This is a warning message')
  logger.error('This is an error message')
  logger.critical('This is a critical message')
7.3 自定义logger并输出到日志文件
# 导⼊ logging 模块
import logging

# 获取⼀个⽇志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)

# 设置⽇志记录器的级别为 DEBUG
# 这意味着所有级别为 DEBUG 及以上的⽇志都会被记录
logger.setLevel(logging.DEBUG)

# 创建⼀个 FileHandler 对象,指定⽇志⽂件的名称为 "test.log"
# 这个处理器会将⽇志信息写⼊到指定的⽂件中
handler = logging.FileHandler(filename="test.log")

# 将这个处理器添加到⽇志记录器中
# 这样,⽇志记录器就会使⽤这个处理器来处理⽇志信息
logger.addHandler(handler)

if __name__ == "__main__":
  logger.debug('This is a debug message')
  logger.info('This is an info message')
  logger.warning('This is a warning message')
  logger.error('This is an error message')
  logger.critical('This is a critical message')
- 获取日志记录器:logging.getLogger(__name__)获取一个日志记录器对象,name是当前模块的名称。使用模块名称作为日志记录器的名称有助于在大型项目中区分不同模块的日志
- 设置日志级别:logger.setLevel(logging.DEBUG)将日志记录器的级别设置为DEBUG,意味着所有DEBUG及以上的级别的日志会被记录(DEBUG < INFO < WARNING < ERROR < CRITICAL)
- 创建文件处理器:logging.FileHandler(filename = "test.log")创建一个文件处理器,将日志信息写入到名为test.log文件中
- 添加处理器:logger.addHandler(handler)将文件处理器添加到日志记录器中,这样日志记录器就会使用这个处理器来处理日志信息
7.4 设置日志格式
# 导⼊ logging 模块
import logging

# 获取⼀个⽇志记录器对象,名称为当前模块的名称
logger = logging.getLogger(__name__)

# 设置⽇志记录器的级别为 DEBUG
# 这意味着所有级别为 DEBUG 及以上的⽇志都会被记录
logger.setLevel(logging.DEBUG)

# 创建⼀个 FileHandler 对象,指定⽇志⽂件的名称为 "test.log"
# 这个处理器会将⽇志信息写⼊到指定的⽂件中
handler = logging.FileHandler(filename="test.log")

# 创建⼀个⽇志格式器对象
formatter = logging.Formatter(
"%(asctime)s %(levelname)s [%(name)s] [%(filename)s (%(funcName)s:%
(lineno)d)] - %(message)s"
)

# 将格式器设置到处理器上
handler.setFormatter(formatter)

# 将这个处理器添加到⽇志记录器中
# 这样,⽇志记录器就会使⽤这个处理器来处理⽇志信息
logger.addHandler(handler)

if __name__ == "__main__":
  logger.debug('This is a debug message')
  logger.info('This is an info message')
  logger.warning('This is a warning message')
  logger.error('This is an error message')
  logger.critical('This is a critical message')
logging.Formatter是用于定义日志输出格式的类。在构造函数中,传递了一个格式字符串,用于指定日志信息的格式。格式字符串中使用了一些特殊的占位符(%),这些占位符会被替换成相应的日志信息内容
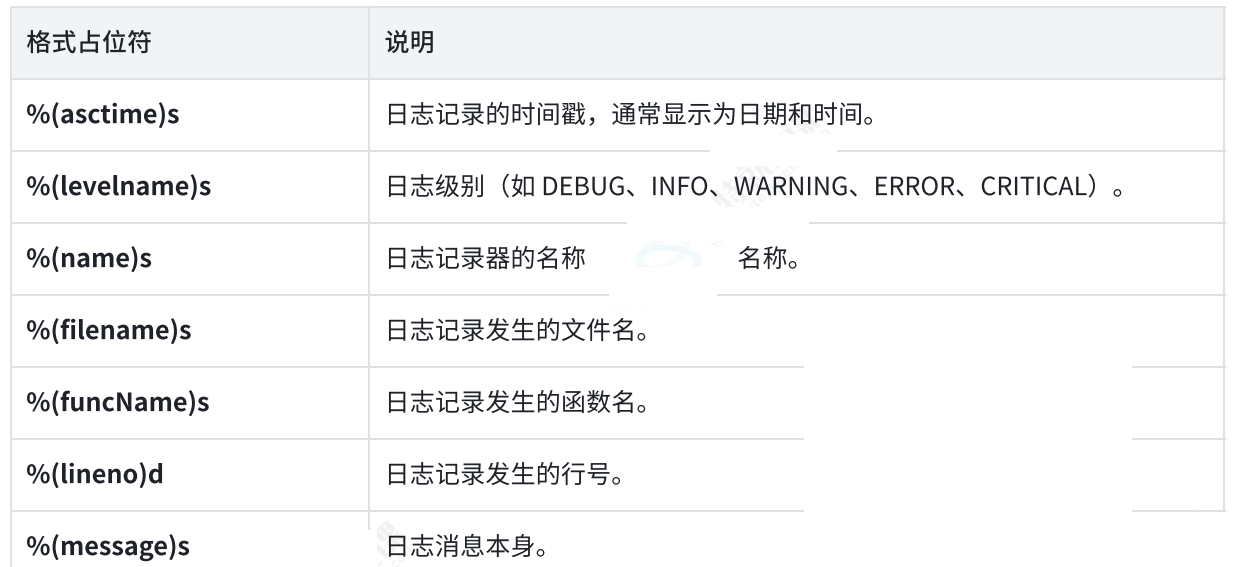
handler.setFormatter(formatter)将创建的格式器对象设置到处理器上,这意味着处理器在处理日志信息时,会使用这个格式器来格式化日志信息
8. 测试报告allure
用于可视化测试运行的结果,使用如下:
pytest --alluredir=results_dir(保存测试报告的路径)
当前项目下自动生成allure-results文件夹,存放报告相关文件
方法一:启动一个本地服务器来在浏览器中展示测试报告,终端执行::allure serve [options] <allure-results>,自动在浏览器中打开测试报告
#不指定端⼝号和主机地址
allure serve .\allure-results\

#指定端⼝号
allure serve --port 8787 .\allure-results\

#清除上⼀次⽣成的测试报告
allure serve .\allure-results\ --clean-alluredir
方法二:从测试结果生成测试报告,终端执行:allure generate [options] <allure-results> -o <reports>

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)