一篇文章掌握“单链表”
目录
一、单链表核心概念与结构
(一)核心概念
1、链表
单链表是线性表的一种,逻辑结构呈线性,但物理结构非连续。
逻辑结构呈线性,即数据间存在明确先后关系,如1→2→3→4→NULL。
物理结构非连续即结点地址非连续,通过指针域关联。如节点 1 地址为0x0012FFB0,节点 2 地址为0x0012FFA0(非连续),但通过节点 1 的next指针指向节点 2,实现逻辑上的线性顺序。
2、结点
链表的基本组成单元,包含两部分:
(1)数据域:存储实际数据,如整型、字符型等。可通过 typedef 实现泛型,方便后续修改数据类型。
(2)指针域:存储下一个节点的地址,类型为节点结构体指针,形成链式关联。
3、头指针、头结点、尾结点
链表分为有头结点与无头结点。
我们对于链表的第一步操作都是初始化,初始化链表的核心是为链表设置 “初始状态”,而这个初始状态通常就是 “空链表”
对于无头结点的单链表,初始化操作为 phead = NULL,即将phead指向 NULL(头指针指向空),表示链表为空。
对于有头结点的单链表,初始化后会创建一个头结点,并将里面的数据赋值为NULL。头指针phead指向该头结点,此时链表逻辑上仍为空(没有有效数据节点)。
而尾结点为链表最后一个节点,其 next 指针为 NULL,标识链表结束。
理论上,只有拥有头结点的链表,第一个结点才可以被成为头结点。
但是我们在后面实现链表的函数时,使用的都是无头结点的链表,所以为了方便表述,我们也将第一个结点成为头结点。
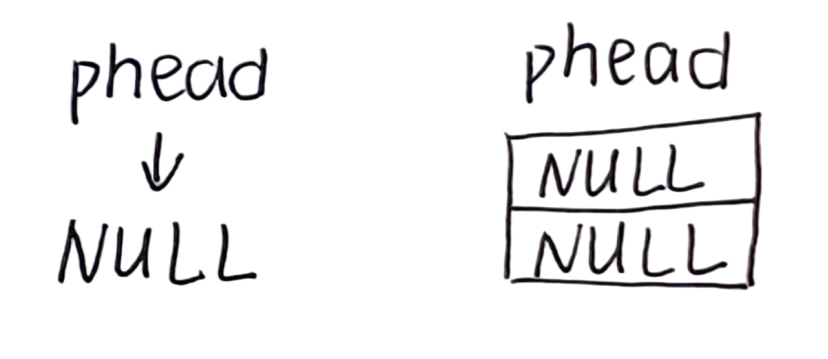
(二)结点结构体定义
// 数据类型别名,便于后续修改存储类型
typedef int SLTDataType;
// 节点结构体定义
typedef struct SListNode {
    SLTDataType data;          // 数据域
    struct SListNode* next;    // 指针域,指向下一个节点
} SLTNode;

//typedef struct ListNode LTNode;也可以要注意,链表的结点以结构体的形式定义,但是链表并不是嵌套结构体,而是结构体中包含指向同类型结构体的指针。
不是结构体中包含了另一个结构体,而是 “结构体中包含指向另一个结构体的指针”。
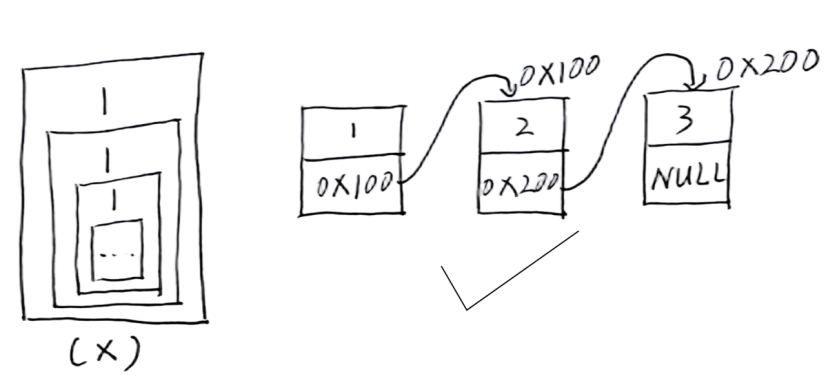
嵌套结构体像 “俄罗斯套娃”:一个娃娃完全包含在另一个娃娃内部。
单链表像 “串珠子”:每个珠子(结点)是独立的,通过绳子(指针)依次串起来,珠子之间没有包含关系。
二、单链表项目搭建
(一)文件结构
1、SList.h —— 头文件
(1)包含依赖头文件(stdio.h、stdlib.h、assert.h);
(2)定义结点结构体与数据类型别名;
(3)声明所有链表操作函数(如插入、删除、打印、销毁等)。
2、SList.c —— 源文件
实现 SList.h 中声明的函数,编写链表操作的核心逻辑(如结点申请、插入删除的指针修改等)。
3、test.c —— 测试文件
(1)构造测试用例(如手动创建链表、调用插入删除函数);
(2)验证链表功能正确性(通过打印、调试观察结果)。
(二)头文件SList.h完整代码
#pragma once  // 防止头文件重复包含
#include<stdio.h>   // 输入输出函数(如printf)
#include<stdlib.h>  // 动态内存管理(如malloc、free)
#include<assert.h>  // 断言(用于参数合法性检查)

// 1. 数据类型别名(泛型)
typedef int SLTDataType;

// 2. 节点结构体定义
typedef struct SListNode {
    SLTDataType data;
    struct SListNode* next;
} SLTNode;

// 3. 函数声明
// 打印链表
void SLTPrint(SLTNode* phead);

(1)增加数据
// 申请新结点(封装,避免重复代码)
SLTNode* SLTBuyNode(SLTDataType x);
// 尾部插入
void SLTPushBack(SLTNode** pphead, SLTDataType x);
// 头部插入
void SLTPushFront(SLTNode** pphead, SLTDataType x);
// 在指定结点pos之前插入
void SLTInsert(SLTNode** pphead, SLTNode* pos, SLTDataType x);
// 在指定节点pos之后插入
void SLTInsertAfter(SLTNode* pos, SLTDataType x);
(2)删除数据
// 尾部删除
void SLTPopBack(SLTNode** pphead);
// 头部删除
void SLTPopFront(SLTNode** pphead);
// 删除指定结点pos
void SLTErase(SLTNode** pphead, SLTNode* pos);
// 删除指定结点pos之后的结点
void SLTEraseAfter(SLTNode* pos);
(3)修改数据
//void SListModify(SLTNode* pos, int newData);
(4)查找数据
// 查找结点(返回值为目标结点指针,未找到返回NULL)
SLTNode* SLTFind(SLTNode* phead, SLTDataType x);

// 销毁链表(释放所有节点内存)
void SListDestroy(SLTNode** pphead);对于数据的操作无非就是增、删、查、改。然后操作数据前,要先初始化链表;操作完成后,要销毁链表。以及一个打印链表的函数方便调试。
然后对于函数中的参数,我们要理解传值调用与传参调用的区别。
我们将具体数据传递过去,供函数使用,本质上是先制造了一份复印件,然后函数使用的其实是这份复印件,并不是原本的数据。
如果我们使用传值调用,表面上函数操作的值,与原本的值一模一样,但是改函数对该值的修改,并不会影响原本的值,因为操作的是复印件。
但是如果我们传址调用,虽然传过去的地址是复印件,但是地址指向的数据是原件。我们可以根据这个地址,找到原本的数据,所以在函数中的操作就可以修改原本的数据。
所以在链表中,因为我们使用结构体指针定义链表结点,所以如果对于一些头结点需要产生变动的函数,我们需要传递二级指针。
那为什么需要使用结构体指针定义链表结点呢?不可以使用结构体吗?
当然是不可以的。
第一:使用结构体定义指针,可以避免定义链表时的无限递归。就单单这一点,就已经注定了,链表结点只可以使用结构体指针定义,不然链表都无法正常存在。
struct Node {
    int data;
    struct Node next;  // 错误!结构体内部包含自身类型,会无限嵌套
};第二:假设你的链表用结构体理论上做出来了,但是你动态开辟内存创建新结点才能构成联链表:struct Node* newnode = (struct Node*)malloc(sizeof(struct Node));。
但是你根本无法计算出sizeof(struct Node)有多大,你连一个结点要多大内存都不知道,结点都出不来,那就不要说链表了。
如果这个时候,如果你想到了间接定义的方法:
struct Wrapper {  // 包装一层
    struct Node node;
};
struct Node {
    int data;
    struct Wrapper next;  // 用Wrapper间接包含下一个Node
};
通过这个方法,计算出了 sizeof(struct Node) 的具体大小,因为 Wrapper 里的 node 是固定大小,所以你以为是可以计算出来的,但是这个只是假象。
在分配结点时,你以为只分配了 “一个结点”,但是你要知道 struct Wrapper 里面装的是 struct Node node。也就是说,你这里盒子里面,放了一个数据和一个盒子,这个盒子打开又有一个数据和一个盒子,永无止境。
此时你申请了第一个结点,就会申请第二个结点、第三个结点,直至内存完全消耗。
也就是说计算 sizeof(struct Node) 时,需要加上 sizeof(struct Wrapper);再计算 sizeof(struct Wrapper) 时,又需要加上 sizeof(struct Node),根本算不完。实际编译时,编译器会直接报错,因为这种定义在语法上就不允许 “无限递归的结构体大小”。
这是最主要的两个原因,无法执行动态规划,就没有结点,没有结点就没有链表;假设你有结点了,那么由于定义链表时的无限递归,你也不会有链表。
即使用结构体定义链表结点,而不使用结构体指针,那么链表结点和链表都无法创建。只有使用结构体指针定义链表结点,才可以创建链表结点和链表。
然后剩下的就不是理由了,而是使用结构体指针定义链表结点的具体好处了。
首先是节省内存与提高效率。指针仅存储下一个节点的地址,仅占少量固定内存。每个结点的内存可以独立分配(分散在堆中),通过指针串联,大幅降低内存浪费,且操作更灵活。
其次是支持动态操作。链表的核心操作(如插入、删除)需要修改结点间的连接关系。通过指针可以直接修改 “下一个节点的地址”,实现高效的结点重连。
(三)测试代码的结构
#define _CRT_SECURE_NO_WARNINGS

#include"SList.h"

void test01()
{
    // 无结点的单链表初始化,不需要额外的方法定义
    // 这样赋值就可以了
    SLTNode* plist = NULL;


    //具体的方法调用
    .........
}


int main()
{
    test01();
    return 0;
}
三、单链表核心操作实现
(一)验证操作 —— 打印链表
void SLTPrint(SLTNode* phead)
{
    SLTNode* pcur = phead; // 临时指针,避免修改原头指针
    while (pcur != NULL) {
        printf("%d -> ", pcur->data); // 打印当前节点数据
        pcur = pcur->next;            // 移动到下一个节点
    }
    printf("NULL\n"); // 打印链表结束标识
}
(二)增加数据
辅助操作:申请新结点
所有插入操作(头插、尾插、指定位置插入)都需要先申请新结点,因此封装为独立函数,避免代码冗余:
SLTNode* SLTBuyNode(SLTDataType x)
{
    // 1. 向操作系统申请节点大小的内存(malloc返回void*,需强转)
    SLTNode* newnode = (SLTNode*)malloc(sizeof(SLTNode));

    // 2. 检查内存申请是否成功(内存不足时malloc返回NULL)
    if (newnode == NULL) {
        perror("malloc fail!");  // 打印错误原因(如“malloc fail!: Not enough space”)
        exit(1);                 // 终止程序(非0退出码表示异常)
    }

    // 3. 初始化节点:数据域为x,指针域为NULL(避免野指针)
    newnode->data = x;
    newnode->next = NULL;

    return newnode;  // 返回新节点指针
}
1、尾部插入(SLTPushBack)
在链表末尾添加结点,需区分 “链表为空” 和 “链表非空” 两种场景,且必须传二级指针(空链表插入时需修改头指针本身):
void SLTPushBack(SLTNode** pphead, SLTDataType x)
{
    assert(pphead);  // 断言:二级指针必须有效(避免传入NULL)

    SLTNode* newnode = SLTBuyNode(x);  // 申请新节点

    // 场景1:链表为空(头指针指向NULL)
    if (*pphead == NULL) {
        *pphead = newnode;  // 新节点直接作为首节点
    }

    // 场景2:链表非空,先找到尾节点
    else {
        SLTNode* ptail = *pphead;  // 从首节点开始找尾
        // 尾节点特征:next为NULL,循环条件为“ptail->next != NULL”
        while (ptail->next) {
            ptail = ptail->next;
        }
        ptail->next = newnode;  // 尾节点的next指向新节点
    }
}
关键逻辑:找尾结点时,循环条件是ptail->next != NULL(而非ptail != NULL),确保最终ptail指向尾结点(而非NULL)。
2、头部插入(SLTPushFront)
在链表头部添加结点,无需遍历,直接修改指针指向,时间复杂度O(1)。比顺序表头部插入高效:
void SLTPushFront(SLTNode** pphead, SLTDataType x)
{
    assert(pphead);  // 断言:二级指针有效
    SLTNode* newnode = SLTBuyNode(x);  // 申请新节点

    // 1. 新节点的next指向原首节点
    newnode->next = *pphead;
    // 2. 头指针指向新节点(新节点成为新首节点)
    *pphead = newnode;
}
示例:原链表为1→2→3→NULL,头插0后,链表变为0→1→2→3→NULL。
3、指定位置前插入(SLTInsert)
在给定节点 pos 前插入新节点,需先找到pos的前驱节点(pos的前一个节点),且需区分 “pos是首节点” 和 “pos是中间 / 尾节点”:
void SLTInsert(SLTNode** pphead, SLTNode* pos, SLTDataType x)
{
    // 断言:二级指针有效 + pos节点有效(避免传入NULL)
    assert(pphead && pos);
    SLTNode* newnode = SLTBuyNode(x);  // 申请新节点

    // 场景1:pos是首节点(直接复用头插逻辑)
    if (pos == *pphead) {
        SLTPushFront(pphead, x);
    }
    // 场景2:pos是中间/尾节点,找pos的前驱节点
    else {
        //使用临时变量prev保护头结点
        SLTNode* prev = *pphead;  // 从首节点开始找前驱
        // 循环条件:prev的next不是pos(找到前驱时退出)
        while (prev->next != pos) {
            prev = prev->next;
            // 若pos不在链表中,循环会一直执行,需避免死循环(可选:添加断言)
            assert(prev != NULL);  // 若prev为NULL,说明pos无效
        }
        // 建立新链接:prev → newnode → pos
        newnode->next = pos;
        prev->next = newnode;
    }
}关键点:这里的 pos 参数的传递,是后面通过查找对应结点得到的。我们找到对应的结点,并且返回它的地址,这个地址就可以作为 pos 参数传递进去。
所以这里不用判断链表为空,有结点不可能为空。
4、指定位置后插入(SLTInsertAfter)
在给定节点 pos 后插入新结点,无需找前驱,逻辑更简单,只需修改 pos 和新节点的 next 指针:
void SLTInsertAfter(SLTNode* pos, SLTDataType x)
{
    assert(pos);  // 断言:pos节点有效(避免传入NULL)
    SLTNode* newnode = SLTBuyNode(x);  // 申请新节点

    // 建立新链接:pos → newnode → pos->next
    newnode->next = pos->next;
    pos->next = newnode;
}
这里我们要注意一个十分容易犯错的点,最后的两行代码不能调换顺序。
如果你先让 pos->next = newnode;,就是说左边的结点先与新结点牵手,那么此时你就无法找到右边的结点了,那你怎么让新结点与下一个结点牵手呢?
此时newnode->next = pos->next;中,pos->next 就变成了newnode,变成新结点自己指向自己了,就无法建立连接了。
所以我们牵手的方向一般是从右到左。
如果要说得本质一点,那就是先让新结点与“已知地址结点”指向的结点牵手,再让它与“已知地址结点”牵手。因为如果你先让“已知地址结点”与新结点连接,那么它的next指针一改变,那么此时它指向的结点就无法找到了。
这里 pos 就是已知结点,所以我们对于 pos->next 的修改肯定是放到最后的,如果这个值先被修改,那么后面的结点就找不到了。所以我们的新结点先与 pos 结点指向的下一个结点牵手,然后 pos 结点再与新结点牵手。
(三)删除数据
删除链表中某一节点的核心逻辑是:
① 必须先保证链表的连接性不受破坏,即通过调整指针关系维持剩余节点的正确串联;② 再释放该节点的内存(free)并将指向它的指针置为NULL(避免野指针)。
具体来说:
① 删除尾结点时,需先将其前驱节点的 next 指针置为 NULL(确保链表末尾正确终止),再释放尾节点并置空指针;
② 删除头结点时,需先记录头结点的下一个结点位置,再释放原头结点;最后将下一结点位置设为新的头结点;
③ 删除中间结点时,需先让该结点的前驱结点直接指向其后继结点(维持链表连续链接),再释放中间结点并置空指针。
1、尾部删除(SLTPopBack)
删除链表末尾节点,需区分 “链表仅一个结点” 和 “链表多个结点”,且需避免空链表删除(通过断言检查):
void SLTPopBack(SLTNode** pphead)
{
    // 断言:二级指针有效 + 链表非空(空链表无法删除)
    assert(pphead && *pphead);

    // 场景1:链表仅一个结点(首节点的next为NULL)
    if ((*pphead)->next == NULL)
    {
        free(*pphead);   // 释放首节点内存
        *pphead = NULL;  // 头指针置空(避免野指针)
    }

    // 场景2:链表多个结点,找尾结点及其前驱
    else
    {
        // 定义前驱结点指针(初始为NULL);用于记录遍历到最后时,前一个结点的指针
        SLTNode* prev = NULL;

        // 尾结点指针(初始为首结点);用于从头结点开始遍历
        SLTNode* ptail = *pphead;


        // 遍历至尾结点(ptail->next为NULL时退出)
        // 先让prev = ptail,然后ptail在往前走一步探路,
        // 这时下一轮循环,如果ptail->next为空,则说明ptail为尾结点,
        // 此时前去前驱结点的位置就找到了。
        while (ptail->next) {
            prev = ptail;        // 先移动前驱指针
            ptail = ptail->next; // 再移动尾结点指针
        }

        // 一定要先断开连接,再删除尾结点,即释放ptail
        // 因为先释放 ptail 会导致 prev->next 短暂成为 “无效链接”,
        // 而链表操作的核心原则是 “任何时刻都要保证链表结构的有效性”,
        // 即指针要么指向有效节点,要么指向 NULL。
        prev->next = NULL;  // 前驱节点的next置空(断开与尾结点的链接)
        free(ptail);        // 释放尾结点内存
        ptail = NULL;       // 尾结点指针置空(避免野指针)
    }
}
2、头部删除(SLTPopFront)
删除链表头部结点,需先保存原首结点的下一个结点(避免删除后丢失后续链表):
void SLTPopFront(SLTNode** pphead)
{
    // 断言:二级指针有效 + 链表非空
    assert(pphead && *pphead);
    // 即使只有一个结点,也是可以满足的
    SLTNode* next = (*pphead)->next;  // 保存原首节点的下一个结点
    free(*pphead);                    // 释放原首节点内存
    *pphead = next;                   // 头指针指向新首结点
}示例:原链表为0→1→2→3→NULL,头删后变为1→2→3→NULL;这个比较简单。
3、删除指定结点(SLTErase)
删除给定结点pos,需区分 “pos是首结点” 和 “pos是中间 / 尾结点”:
void SLTErase(SLTNode** pphead, SLTNode* pos)
{
    // 断言:二级指针和pos均有效
    assert(pphead && pos);

    // 情况1:pos是首结点,复用头删逻辑
    if (pos == *pphead)
        SLTPopFront(pphead);

    // 情况2:pos是中间/尾结点,找pos的前驱
    else
    {
        // 遍历找到pos的前驱结点
        SLTNode* prev = *pphead;
        while (prev->next != pos)
            prev = prev->next;

        // 前驱直接链接到pos的下一个节点,跳过pos
        prev->next = pos->next;
        free(pos); // 释放pos节点
        pos = NULL; // 避免野指针
    }
}
4、删除指定节点后结点(SLTEraseAfter)
删除 pos 的下一个结点,无需找前驱,但需确保 pos 的下一个结点非空,避免删除不存在的结点:
void SLTEraseAfter(SLTNode* pos)
{
    // 断言:pos有效 + pos的下一个节点非空(无节点可删时断言失败)
    assert(pos && pos->next);

    SLTNode* del = pos->next;  // 保存要删除的节点
    pos->next = del->next;     // pos直接链接到del的下一个节点
    free(del);                 // 释放del节点内存
    del = NULL;                 // 避免野指针
}
示例:原链表为1→2→4→3→NULL,删除pos=2(值为 2 的节点)后的节点,链表变为1→2→3→NULL。(这个也比较简单)
(四)修改数据
1、修改pos结点的数据(简单)
直接替换pos结点的数据域即可:
void SListModify(SLTNode* pos, int newData)
{
    // 检查pos是否为无效指针(避免空指针访问)
    if (pos == NULL) {
        printf("错误:要修改的结点位置无效(空指针)\n");
        return;
    }
    // 修改结点的数据域
    pos->data = newData;
}
(五)查找数据
1、查找结点(SLTFind)
遍历链表,查找数据域等于x的节点,返回结点指针(未找到返回NULL),可用于后续插入、删除指定位置的操作:
SLTNode* SLTFind(SLTNode* phead, SLTDataType x)
{
    SLTNode* pcur = phead;  // 临时指针遍历链表

    while (pcur) {          // 循环条件:当前结点不为空(未遍历完链表)
        if (pcur->data == x) {
            return pcur;     // 找到目标节点,返回指针
        }
        pcur = pcur->next;  // 未找到,移动到下一个节点
    }
    return NULL;  // 遍历结束未找到,返回NULL
}
(六)销毁链表
遍历链表,逐个释放所有结点内存,避免内存泄漏;必须传入二级指针,销毁后需将头指针置为空:
void SListDestroy(SLTNode** pphead)
{
    assert(pphead);  // 断言:二级指针有效
    SLTNode* pcur = *pphead;  // 从首节点开始释放

    //不停地头删
    while (pcur) {
        SLTNode* next = pcur->next;  // 先保存下一个节点(避免释放后丢失)
        free(pcur);                  // 释放当前节点内存
        pcur = next;                 // 移动到下一个节点
    }

    *pphead = NULL;  // 头指针置空(避免野指针,标识链表已销毁)
}
四、单链表与顺序表对比
| 比维度 | 顺序表(底层为数组) | 单链表 |
| 存储空间 | 物理上一定连续(数组特性) | 物理上非连续,逻辑上连续 |
| 随机访问 | 支持; 通过下标访问,时间复杂度O(1) | 不支持; 需从首结点遍历,时间复杂度为O(n) |
| 插入 / 删除 | (1)中间 / 头部插入删除:需搬移数据,时间复杂度O(n); (2)尾部插入(无增容):O(1)。 | (1)头部 / 指定位置后插入删除:仅修改指针,时间复杂度O(1); (2)尾部删除:需找尾结点前驱,O(n)。 |
| 内存管理 | (1)动态增容:需申请新空间、拷贝数据、释放旧空间,有性能消耗; (2)增容后可能存在空间浪费(如容量 200 仅用 5 个数据)。 | (1)无需增容:按需申请 / 释放节点,无空间浪费; (2)每次插入需malloc,删除需free(内存操作频繁)。 |
| 应用场景 | 适合频繁访问数据; 如:数组遍历、随机查询 | 适合频繁插入 / 删除数据; 如:链表头部操作、中间插入 |
五、关键注意事项
(一)避免野指针
malloc后必须检查是否成功,返回NULL时需处理;free后必须将指针置空,否则指针仍指向已释放的内存,成为野指针;链表为空时,头指针必须为NULL,避免误操作空链表。
(二)彻底理解 free,与野指针置为NULL后的内存变化
我们使用完动态开辟的空间后,需要先 free(ptr);,再 ptr=NULL;。这些语句执行之后,内存空间的变化到底是怎么样的呢?
1、free(ptr)
(1)操作对象:针对程序中单个动态分配的内存块(如 malloc/calloc 申请的内存)。
(2)作用时机:程序运行过程中,由开发者主动调用。
(3)核心行为
仅释放该内存块的 “使用权”,归还给内存管理系统;而非直接还给操作系统,具体取决于内存管理策略。
不改变指针变量本身的值,指针仍指向原地址,需手动置为 NULL 避免野指针。不主动清空内存中的数据,可能残留旧数据,直到被重新分配后覆盖。
目的是在程序运行中回收不再使用的内存,避免内存泄漏,以便程序长期运行。
2、程序关闭(进程终止)的影响
(1)操作对象:进程占用的所有资源(包括动态内存、栈内存、文件描述符等)。
(2)作用时机:程序正常退出(如 main 函数返回)或异常终止(如信号终止)时,由操作系统触发。
(3)核心行为
操作系统强制回收进程的全部内存(无论是否被 free 过),标记为 “系统空闲内存”,供其他进程使用。
进程的所有数据(包括指针变量、内存中的残留数据)逻辑上失效,进程地址空间被销毁。
通常不主动清空内存数据,物理上可能残留,但已无进程可访问,直到被新进程覆盖。
是操作系统的 “兜底机制”,确保程序结束后不会残留资源占用,但不能替代 free,因为无法解决运行中内存泄漏问题。
3、总结
也就是说 free 也好,关闭程序也好,你都没有销毁内存中的内容,而是把这块空间标记为空闲状态。
① 那这样内存不是堆满了吗?
其实并不是这样的,① 内存的 “可用” 与 “占用”,看的是 “标记” 而非 “数据是否存在”。
当你 free 一块内存时,操作系统或内存管理库会将其标记为 “空闲可用”,此时这块空间就可以被再次分配给新的变量 / 对象,即使里面还残留着旧数据。
程序结束后,操作系统将进程的所有内存标记为 “系统空闲”,这些空间会被纳入系统的内存池,供其他程序申请使用。
所以内存是否 “可用” 只看标记,不看数据。只要标记为 “空闲”,就算里面有旧数据,也会被视为 “可分配的空内存”,不会导致 “内存被堆满”。
同时② 数据残留不影响内存的复用。
内存是 “可覆盖” 的存储空间。当新程序 / 新变量申请到一块残留旧数据的内存时,会直接在上面写入新数据 —— 旧数据会被覆盖,不会占用额外空间。例如:
你 free 了一块存储着 123 的内存,它被标记为空闲。后续代码 malloc 申请到这块内存,写入 456—— 此时内存中存储的是 456,123 被覆盖,不会占用额外空间。
内存的总大小是固定的(如 8GB、16GB),但通过 “标记可用 - 重新分配 - 覆盖数据” 的循环,实现了空间的重复利用,无需每次清空也能保证内存不会被 “堆满”。
那 ③ 为什么不主动清空?—— 为了效率
如果每次 free 或程序结束时都主动清空内存(比如填充 0),会消耗额外的 CPU 时间(尤其是大块内存)。
而实际上,只要通过 “标记” 管理好使用权,新数据自然会覆盖旧数据,完全没必要提前清空。这是操作系统和内存管理库为了效率做出的设计选择。
内存是否 “够用” 取决于空间是否被正确标记为 “可用” 并重新分配,而非数据是否被清空。
数据残留只是物理上的暂时留存,既不占用额外空间,也不影响新数据的写入,因此不会导致 “内存被堆满”。这种设计既保证了内存的高效复用,又避免了不必要的性能损耗。
所以为什么不可以越界访问,因为你不知道那里的内容是什么?可能是上次写入的数据,但是可能由于两次对于数据的解读方式不同,你读出来的就是一个很奇怪的数字,这才是底层。
④ 那对于野指针,怎样操作才合规?
首先,绝对不可以访问野指针所指向的内存。
因为野指针指向的空间要么已被释放,不再属于当前程序;要么从未分配给当前程序,其使用权完全不受当前程序控制。此时访问该内存属于非法操作,可能导致程序崩溃、数据错乱等不可预期的后果。
合规的操作是修改野指针本身的值。
可以将其指向一块由当前程序合法分配的有效内存,如动态申请的内存或已存在的变量,使其成为有效指针;也可以直接将其置为 NULL,明确表示它不再指向任何有效内存。这样就能避免野指针带来的风险。
4、ptr = NULL
有的人会产生这样的一个疑问?NULL 不就是 0 吗?这么多指针的值都为0,那不是有点奇怪吗?其实并不是这样的。
在数值层面:NULL 几乎总是等于 0(无论是 0 还是 (void*)0,最终地址值都是 0)。
在语义和类型层面:NULL 永远不等于 0 —— NULL 是指针的 “空状态标记”,0 是整数,二者用途和语境完全不同。
因此 NULL 只是指针的 “无指向” 标记,多个指针置为 NULL 只是共同表达 “当前不指向任何有效内存”,仅此而已,并不是说多个指针变量都指向地址 0。
(三)二级指针的使用场景
1、当需要修改头指针本身时,如空链表尾插、头插、头删、销毁链表,必须传二级指针。
2、若仅修改链表内部节点,如中间插入、指定位置后插入,传一级指针即可。
即:要修改传进去的值,使用传址调用;传进去的值仅作为使用,使用传值调用。
以上即为 一篇文章掌握“单链表” 的全部内容,创作不易,麻烦三连支持一下呗~


北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 56
 0
- 0


 已为社区贡献1条内容

所有评论(0)