算法知识-并查集
一.并查集的作用
集合合并问题,联通问题
二.什么是并查集
英文:Disjoint Set, 即"不相交集合"
问题描述:将编号分别为1....N的N个对象划分为不相交集合,在每个集合中,选择其中某个元素代表所在集合
常见两种操作:
合并两个集合
查找某元素属于哪个集合
二.并查集的实现
并查集操作均摊下来是O(1)
(1)实现方法一
用编号最小的元素代表所在集合
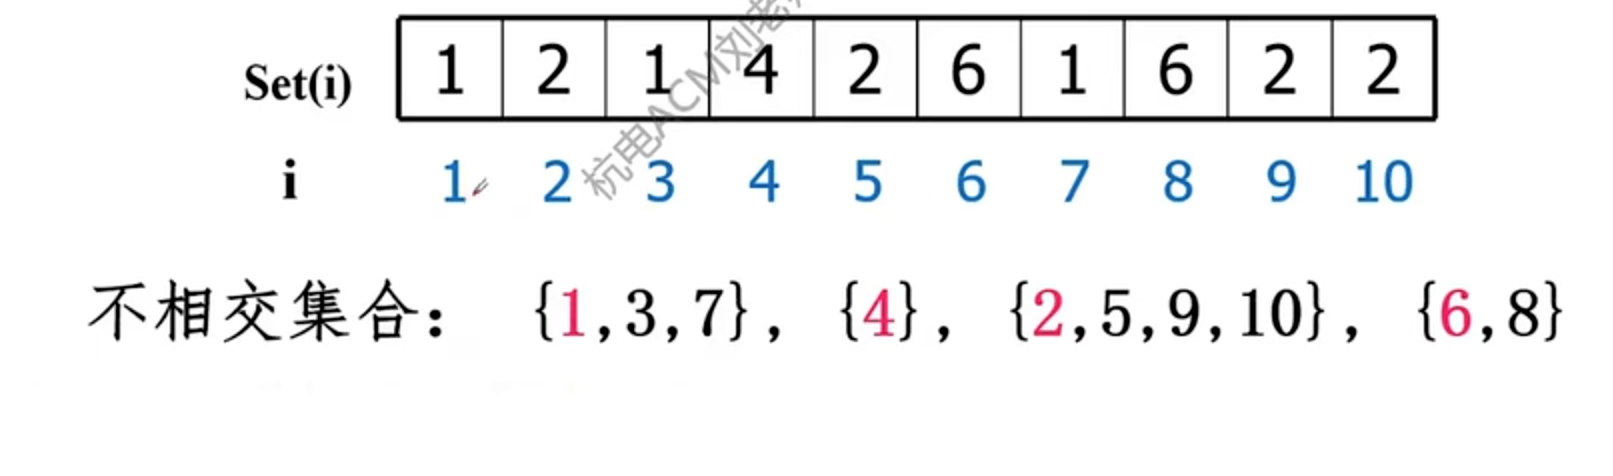
定义一个数组Set[1...n],其中Set[i]表示元素i所在的集合
1.方法一效率分析
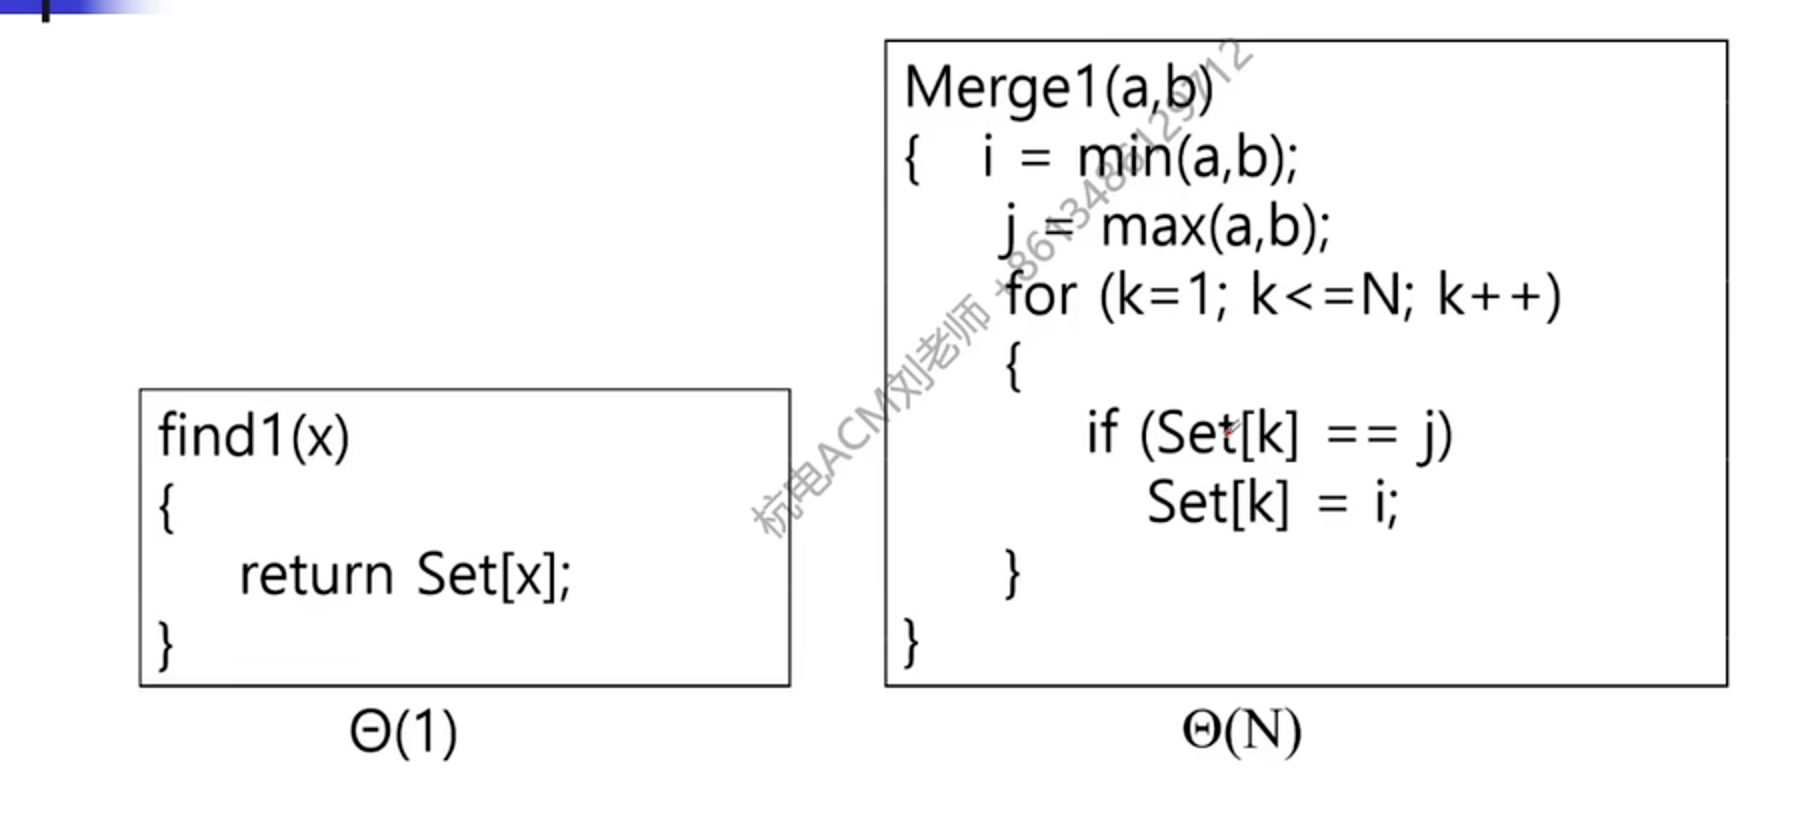
查找操作是O(1),直接返回Set[x]就行,合并操作,需要将两个集合的所有元素都设置为两个老大中较小的那个,需要遍历整个数组,时间复杂度为O(n)
有待改进:合并操作,必须遍历所有元素,判断是否为合并的两个集合中的元素
(2)实现方法二
每个集合用一棵 “有根树” 表示
- 定义数组 father [1..n]
- father [i] = i,则 i 表示本集合,并是集合对应树的根
- father [i] = j,若 j 不等于 i,则 j 是 i 的父节点
UnionFind(int n) : father(n + 1)
  {
    for (int i = 0; i <= n; i++)
      father[i] = i;
  };
1.find函数
查找集合的代表元素
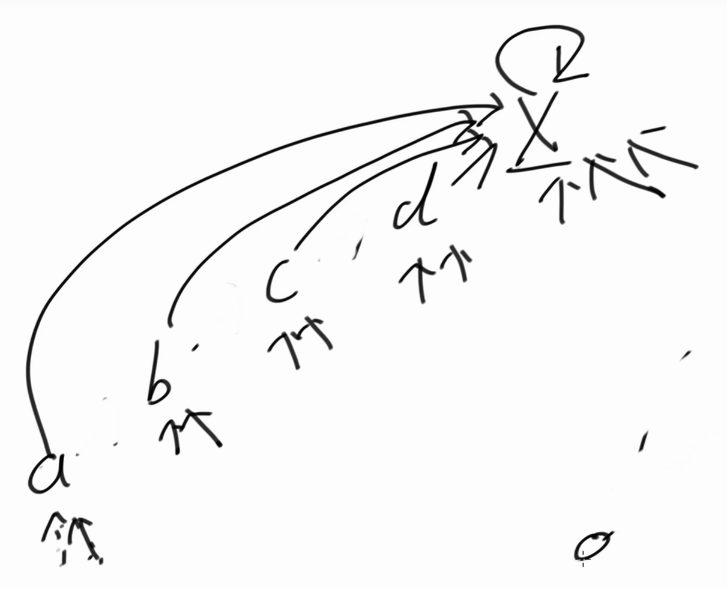
路径压缩:再查找的过程中,我们直接把查找过程中经过的所有的点直接挂在代表节点上(扁平化,必须要做)
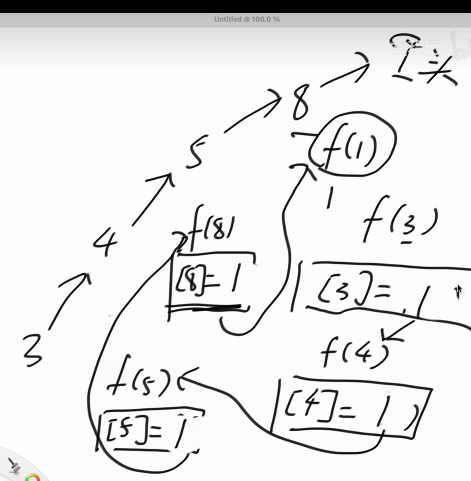
对于每个元素,如果当前元素编号指向不为自己,则需要往上找,并且我们给father[i]赋值为这个代表元素,如果相等则不需要往上找了,返回father[i]
int find(int i)
  {
    if (i != father[i])
    {
      father[i] = find(father[i]);
    }
    return father[i];
  }
2.isSameSet
bool isSameSet(int x, int y)
  {
    return find(x) == find(y);
  }
判断x与y的代表元素是否相等
3.Union
void Union(int x, int y)
  {
    father[find(x)] = find(y);
  }
将x的代表元素指向y的代表元素
板子
class UnionFind
{
private:
  vector<int> father;

public:
  UnionFind(int n) : father(n + 1)
  {
    for (int i = 0; i <= n; i++)
      father[i] = i;
  };
  int find(int i)
  {
    if (i != father[i])
    {
      father[i] = find(father[i]);
    }
    return father[i];
  }
  bool isSameSet(int x, int y)
  {
    return find(x) == find(y);
  }

  void Union(int x, int y)
  {
    father[find(x)] = find(y);
  }
};
三.并查集的时间复杂度的说明
均摊O(1),如果有一个比较长的链,你只会忍受一次遍历很长的链,因为find一次后就扁平化了。
四.例题
1.例题1765. 情侣牵手 - 力扣(LeetCode)
该题我们的思路是给每对情侣进行编号,(0~1)编号为0,(2~3)编号为1以此类推,n在第n/2对情侣之中,之后我们遍历原数组,每两个两个进行遍历,之后把他们的编号进行合并,假如一个集合中有k对情侣混在一起,那么它需要交换k-1次,因为每次交换都可以成全一对情侣,那么我们假设集合被分成了三组,第一组有a对,第二组有b对,第三组有c对,那么需要交换(a-1+b-1+c-1),之后a+b+c是一共有多少对,就是n/2对,之后-3其实就是减去被分成了多少组,一开始有n/2组,之后每次合并就是减少一组。
class UnionFind{
    public:
    vector<int>father;
    int sets;
    public:
    UnionFind(int n):father(n){
        for(int i=0;i<n;i++)father[i]=i;
        sets=n;
    }
    int find(int i){
        if(i!=father[i]){
            father[i]=find(father[i]);
        }
        return father[i];
    }
    bool isSameSet(int x,int y){
        return find(x)==find(y);
    }
    void Union(int x,int y){
        int fx=find(x);
        int fy=find(y);
        if(fx!=fy){
            father[fx]=father[fy];
            sets--;
        }

    }
};
class Solution {
public:
    int minSwapsCouples(vector<int>& row) {
        int n=row.size();
        UnionFind uf(n/2);
        for(int i=0;i<n-1;i+=2){
            uf.Union(row[i]/2,row[i+1]/2);
        }
        return n/2-uf.sets;

    }
};
839. 相似字符串组 - 力扣(LeetCode)
分析题目:题目的意思是让我们对字符串分组之后相似的在一组,问有多少组,分组问题,我们使用并查集,所以我们就是遍历任意两个字符串判断他们是否相似,如果相似就放在一组,合并,判断两个字符串是否相似,题目中给的都是异构词,所以我们想判断两个字符串是否是通过交换一次得到的,我们可以一一对比两个字符串的每个位置,如果有超过两个位置不一样的那么一定是不相似的。
class UnionFind{
    public:
    vector<int>father;
    int sets;
    UnionFind(int n):sets(n),father(n,0){

    }
    void build(){
        int n=father.size();
        for(int i=0;i<n;i++){
            father[i]=i;
        }
    }
    int find(int x){
        if(father[x]!=x){
            father[x]=find(father[x]);
        }
        return father[x];
    }
    void Union(int x,int y){
        int fx=find(x);
        int fy=find(y);
        if(fx!=fy){
            father[fx]=fy;
        }
        --sets;
    }
};
class Solution {
public:
    bool isSimilar(string &s1,string &s2){
        int n=s1.size();
        int diff=0;
        for(int i=0;i<n;i++){
            if(s1[i]!=s2[i]){
                diff++;
            }
            if(diff>2)return false;
        }
        return true;
    }
    int numSimilarGroups(vector<string>& strs) {
        int n=strs.size();
        UnionFind uf(n);
        uf.build();
        for(int i=0;i<n;i++){
            for(int j=i+1;j<n;j++){
                if(uf.find(i)==uf.find(j))continue;
                if(isSimilar(strs[i],strs[j])){
                    uf.Union(i,j);
                }
            }
        }
        return uf.sets;
    }
};
947. 移除最多的同行或同列石头 - 力扣(LeetCode)
分析题目:相同行相同列的石头可以视为在同一个集合中,我们只需要通过并查集,最后得到一共有多少个石头集合fathers,每个集合最终只能留一个石头,那么就会移除n-fathers个石头。
优化:我们可以记录每一行每一列的第一次出现的石头,之后再有这一行/列的石头出现时,直接将这次的石头与第一次出现的石头合并即可
class UnionFind{
    public:
    int fathers;
    vector<int>father;
    UnionFind(int n):fathers(n),father(n,0){
        for(int i=0;i<n;i++){
            father[i]=i;
        }
    }
    void Union(int x,int y){
        int fx=find(x);
        int fy=find(y);
        if(fx!=fy){
            father[fx]=fy;
            --fathers;
        }
    }
    int find(int x){
        if(father[x]!=x){
            father[x]=find(father[x]);
        }
        return father[x];
    }


};
class Solution {
public:
    int removeStones(vector<vector<int>>& stones) {
        int n=stones.size();
        UnionFind uf(n);
        int row=0,col=0;
        unordered_map<int,int>rowFirst;
        unordered_map<int,int>colFirst;
        for(int i=0;i<n;i++){
            row=stones[i][0],col=stones[i][1];
           if(!rowFirst.count(row)){
            rowFirst[row]=i;
           }else{
            uf.Union(i,rowFirst[row]);
           }
           if(!colFirst.count(col)){
            colFirst[col]=i;
           }else{
            uf.Union(i,colFirst[col]);
           }
        }
        return n-uf.fathers;
    }
};
2421. 好路径的数目 - 力扣(LeetCode)
题目分析:我们首先根据每个边的两个点的最大值进行从小到大排序,也就相当于我们给每个边进行编号,之后依次处理每个边,由于该图是树,所以未处理的边的两个点一定分属于两个集合,我们会对每个集合打上标记,集合的最大值(不用额外存储我们直接让最大值的节点作为代表节点),以及最大值的个数
{
如果两个集合的最大值不同,那么两个集合不会产生好路径,并且让最大值作为代表节点
如果两个集合的最大值相同,那么集合1中最大值的节点都能到达集合2中最大值地节点组成好路径,也就是好路径的个数,1集合的最大值的个数*2集合的最大值的个数
}
为什么我们需要按照边的两个点的最大值,进行排序?
排序能确保 “在处理以 v 为 max 的边时,所有参与合并的集合,其内部的最大值都 ≤ v,这样我们只需要看两个集合的最大值是否相同,能否产生好路径即可。
class UnionFind{
public:
//默认让代表节点直接作为最大值
vector<int>father;
vector<int>maxCnt;
UnionFind(int n):father(n),maxCnt(n){
    for(int i=0;i<n;i++){
        father[i]=i;
        maxCnt[i]=1;
    }
}
int find(int x){
    if(father[x]!=x){
        father[x]=find(father[x]);
    }
    return father[x];
}

int Union(int x,int y,vector<int>&vals){
    int fx=find(x);
    int fy=find(y);
    int path=0;
    if(fx!=fy){
        if(vals[fx]<vals[fy]){
            father[fx]=fy;
        }else if(vals[fx]>vals[fy]){
            father[fy]=fx;
        }else{
            father[fy]=fx;
            path=maxCnt[fx]*maxCnt[fy];
            maxCnt[fx]+=maxCnt[fy];
        }
    }
    return path;
}
};
class Solution {
public:
    int numberOfGoodPaths(vector<int>& vals, vector<vector<int>>& edges) {
        auto cmp=[&](vector<int>&a,vector<int>&b)->bool{
            return max(vals[a[0]],vals[a[1]])<max(vals[b[0]],vals[b[1]]);
        };
        sort(edges.begin(),edges.end(),cmp);
        int n=vals.size();
        int ans=0;
        UnionFind uf(n);
        int m=edges.size();
        for(int i=0;i<m;i++){
            ans+=uf.Union(edges[i][0],edges[i][1],vals);
        }
        return ans+n;
    }
};
北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献3条内容

所有评论(0)