树莓派集群上的3D小波变换并行实现
三维快速小波变换的并行实现
摘要
当前,由于低成本通用单板计算(SDC)设备具有极佳的成本/性能比和低能耗,其在科研计算领域正受到越来越多的关注。在当今可用的各类SDC中,树莓派设备或许是最具代表性的。另一方面,小波变换在现代图像压缩标准(如JPEG‐2000)和视频压缩标准(MPEG‐4)中起着重要作用。在本研究中,我们提出并评估了在树莓派2单板计算机集群上实现三维快速小波变换(3D‐FWT)的三种并行化策略。每种并行化策略均使用POSIX线程(共享内存)和MPI(消息传递)两种方式实现。基于POSIX线程的实现在单块主板上运行,而MPI版本则可跨多个主板运行。我们发现,当所有MPI进程或POSIX线程在单个树莓派2 SDC的处理器核心上运行时,可以获得显著的加速比。然而,对于MPI版本,当所有MPI进程分布到多个主板上时,性能急剧下降。其原因是板载局域网端口提供的带宽有限,无法满足所研究的并行化策略对细粒度、高数据量通信的需求。最后,我们还在高性能但高功耗的四核英特尔至强E5606处理器上运行了POSIX线程和MPI版本的程序,获得了相应的结果。
树莓派2 SDC 可以以低得多的总能耗(高达4倍)完成该任务。
关键词 通用单板计算(SDC) · 树莓派2 · 三维快速小波变换(3D‐FWT) · 并行化策略 · MPI · POSIX线程 · 加速比
1 引言
用于构建计算机的技术不断进步,最近使得制造极低成本的通用单板计算设备成为可能。如今,人们只需几美元就能购买一台这样的tiny计算机,并使其运行 Windows 10 或 Ubuntu‐Linux 操作系统 [1]。目前,这类单板计算机中最著名的例子之一就是树莓派设备。尽管这些设备最初的目的是为了促进学校[2]和发展中国家[3],的基础计算机科学教学,但近年来配备多核中央处理器芯片的单板计算机(SBC)的出现,因其极低的能耗和高性价比(例如在数据中心[4]中的应用),已引起众多项目的关注。
树莓派单板计算机的价格介于20至35美元之间。1树莓派SDC的开发经历了几代产品。第一代(树莓派1)于2012年2月发布,包括基础型号A和更高配置的型号B。A+和B+型号于一年后推出。所有这些树莓派均采用单核 ARM架构的中央处理器芯片,限制了其仅适用于玩具计算机。树莓派2代B型于2015年2月发布,其主要创新在于引入了四核ARM架构的中央处理器芯片,相比前代性能提升了六倍。该系列的最新成员,树莓派3代B型,于2016年2月发布,增加了无线连接功能(2.4 GHz WiFi 802.11n 和蓝牙4.1)。
近年来,一个非常有吸引力的研究领域涉及提出和评估不同的变换函数,以克服MPEG‐2所采用的离散余弦变换(DCT)在某些特定类型视频上的局限性。小波技术最近在应用领域引起了广泛关注,小波变换主要应用于图像。
已经开发出几种使用二维小波变换[5–7]的编码器。最新的图像压缩标准 JPEG‐2000[8,9],也基于二维小波变换,并采用二进制母小波变换。三维小波变换也被用于视频压缩。由于三个空间维度中的一个可以被视为类似于时间,Chen和Pearlman开发了一种三维子带编码方法来编码视频序列[10],,随后通过使用三维分层树集合分割(SPHIT)的嵌入式小波视频编码器进行了改进[11]。如今,MPEG‐4[12,13]标准支持一种即席工具,用于编码纹理和静态
2015年11月发布了尺寸更小、IO(GPIO)功能有限的Pi Zero,售价为5美元。
三维快速小波变换的并行实现…
图像,该工具基于小波算法。在之前的一项工作中[14],,我们提出了基于三维快速小波变换的医学视频有损编码器的实现。该编码器既能实现高压缩比,又能保证极佳的质量,以至于医生无法再发现原始视频与重建视频之间的差异。此外,该编码器达到的执行时间允许实现实时视频压缩和传输。在并行化二维或三维快速小波变换的情况下,我们此前已表明,现代通用图形处理器(GPGPUs)可实现显著的加速比[15–18]。然而,自动并行化方法带来的效益不足,而手动并行化方法则给软件开发带来了相当大的负担[19]。
在本研究中,我们探讨了在树莓派2单板计算机集群上实现三维快速小波变换(3D‐FWT)的并行化。具体而言,我们采用POSIX线程[20]和MPI [21],实现了三种不同的三维快速小波变换并行化策略(即按行分解、按行和列分解以及按视频序列分解),并在由4个树莓派2 SDC组成的集群上对这些策略进行了评估。POSIX线程版本仅限于在单个主板上运行,而MPI版本则可跨多个树莓派2 SDC运行。我们的结果表明,当所有MPI进程或POSIX线程在单个树莓派2 SDC的处理器核心上运行时,可以获得显著的加速比。然而,对于MPI版本,当所有MPI进程分布到多个主板上时,性能急剧下降。其原因是板载局域网端口(标称为10/100快速以太网,并通过板载USB 2.0总线驱动)所提供的带宽有限,无法满足并行化策略所需的细粒度、高容量通信需求。
我们还考虑了在高性能但高功耗的四核英特尔至强E5606处理器上执行 POSIX线程和MPI版本的情况,结果表明,树莓派2单板计算机完成该任务的总能耗显著更低(最多可低至4倍)。总体而言,我们的结果证明,树莓派2单板计算机是一个有吸引力的平台,能够以低成本和高能效支持基于三维快速小波变换的应用。作为一个应用案例,我们认为树莓派2单板计算机可用于在发展中国家的农村地区开发基于三维快速小波变换的不同远程医疗专业系统。
本文的其余部分组织如下。第2节介绍了小波变换的重要背景知识。我们在本文中实现并评估的并行化策略在第3节中进行说明。在第4节中,我们给出了用于评估的Raspberry Pi 2 SDC集群的详细信息,然后展示了结果。最后,第5节对全文进行总结,并提出了未来工作方向。
2 小波变换基础
小波变换的基本思想是将任意函数f表示为被称为小波的函数的加权和。每个小波都是通过对母小波函数进行适当的缩放和平移得到的。结果是
相当于将f分解为不同的尺度层级(或层次),其中每个层级再根据该层级的分辨率进行进一步分解。
在多分辨率分析中,存在两个函数:母小波及其相关的尺度函数。因此,小波变换可以通过正交镜像滤波器(QMF) G=g(n)和 H= h(n),nεZ.H对应于低通滤波器,而 G是高通滤波器。有关小波与QMF之间关系的更详细分析,请参见滤波[2器6]。H和G对应于小波分解的一个步骤。给定一个长度为 2n的离散信号s,在小波变换的每一阶段,将G和H滤波器应用于该信号,并对滤波器输出下采样两倍,从而生成两个频带G和H。然后在H频带上重复此过程以生成下一级分解,依此类推。此过程称为一维快速小波变换(1D‐FWT)。
将一维小波变换推广到多维情况并不困难[26]。图像的小波表示f(x, y)可以通过金字塔算法获得。首先对图像的每一行应用一维小波变换,然后对每一列应用该变换即可实现,即在水平和垂直方向上分别应用G和H滤波器。
此过程像在一维情况下一样重复多次。该方法称为二维快速小波变换 (2D‐FWT)。
与二维情况类似,我们可以将一维小波变换推广到三维情况。此时不再是单个图像,而是一个图像序列。因此出现了一个新的维度——时间(t)。通过在每个维度上依次对像素值应用一维小波变换,可以计算出三维快速小波变换。
基于之前的工作[27],,我们选择Daubechie的W4母小波[28]作为合适的基线函数。该选择决定了整个三维快速小波变换过程的内存访问模式。假设输入视频序列包含若干帧(第三维),每帧由一定数量的行和列(第一维和第二维)组成。
对每一行和每一列在第三维上执行一维小波变换,即在第三维上沿行和列的方向分别进行rows × cols次一维小波变换。第一个一维小波变换实例需要四个元素来计算参考视频和细节视频的第一个输出元素,这些元素为前四帧中属于第一个像素的值。参考视频和细节视频的第二个输出元素则使用第三、第四、第五和第六视频帧的第一个像素进行计算。我们以此方式继续,直到计算出完整的参考视频和细节视频,这些数据将用作下一阶段的输入。
二维小波变换执行 f rames次,即每帧一次。该变换首先在图像的每一行 (水平滤波)上应用一维小波变换,然后在每一列(垂直滤波)上应用一维小波变换。由于垂直滤波在进入下一列之前会完全计算完每一列,这导致属于前几行的缓存行在算法进入下一列之前就被替换。Meerwald 等人 [29]提出了两种技术来解决此问题:行扩展和聚合或分块。
其他研究[30,31]也报告了在2D‐FWT算法上应用分块技术时的显著改进。我们在中央处理器上实现顺序二维小波变换算法的经验表明,性能提升了近一个数量级
三维快速小波变换的并行实现…
与基线版本相比,在整体执行时间上的提升。此进程可直接应用于三维情况,已有报告显示执行时间也取得了显著的缩短,缩短倍数范围为 3×到 7×倍[14]。
在之前的研究中[16,17], ,我们提出了一种在中央处理器上运行的二维小波变换的CUDA实现,其执行时间比串行C版本快20倍以上,比在四核中央处理器上实现的优化OpenMP和PThreads版本也快两倍以上。我们将分析扩展到了三维快速小波变换场景[15,18],,在此场景中,通过使用一组新的优化技术进一步提高了加速比。我们提出了多种替代方案和编程技术,以在多核中央处理器和众核图形处理器上高效地实现三维快速小波变换的并行化。在中央处理器上采用 OpenMP和PThreads构建了不同的实现以最大化并行性,而在图形处理器上则选用CUDA和OpenCL来利用数据并行,并结合显式内存管理。基于费米架构的CUDA版本获得了最高的加速比,对于不同图像尺寸,其执行时间比中央处理器提升了5.3×到7.4×倍,在忽略通信开销的情况下最高可达 81×倍。与此同时, OpenCL在小帧大小时获得的加速比约为 2×,在大帧大小时达到 3×,表现出稳定的性能提升。
3 在树莓派集群上的并行化
在本节中,我们介绍了本研究中考虑的三种并行化策略。每种策略均使用 MPI [21]和POSIX线程(POSIX Threads)[20]实现。对于POSIX线程版本,所有线程必须在同一SDC上执行,因为集群的不同节点之间不存在物理共享内存。相反,MPI进程既可以在同一节点上运行,也可以在不同节点上运行。
3.1 按行分解
我们的第一种并行化策略试图利用视频序列中每一帧的各行计算可以并行执行的特点。为此,在该方法中,将视频序列每一帧的不同行块分配给各个参与的MPI进程。然后,每个进程对其所分配的行在时间和x维度上执行一维小波变换。下一步,每个进程将其结果发送到第一个进程(在本例中为ID为0的进程),由该进程负责对整个帧的所有列应用一维小波变换。三维快速小波变换的低通输出由第一个进程发送给其余进程,以进行三维快速小波变换的第二次迭代,依此类推。图1以图形方式描述了该第一种并行化策略在使用 MPI实现时的执行过程。
POSIX线程版本中采用的并行化过程完全相同:每个线程负责计算视频序列中每一帧的行块,随后仅由一个线程(ID为0的线程)对帧的所有列应用一维小波变换。这两个阶段通过屏障同步进行分隔。一旦ID为0的线程完成,三维快速小波变换的第二次迭代便可继续进行。同样,通过屏障同步来保证

n 帧 x r 行 x c 列
| R0:行 1‐(r/4) | R0:行 1‐(r/4) |
| R1:行 (r/4)+1‐(r/2) | R1:行 (r/4)+1‐(r/2) |
| R2:行 (r/2)+1‐(r/2)+(r/4) | R2:行 (r/2)+1‐(r/2)+(r/4) |
| R3:行 (r/2)+(r/4)+1‐r | R3:行 (r/2)+(r/4)+1‐r |
进程 1 n 帧 x R1 行 x c 列
将结果发送到进程 0
进程 0 n 帧 x r 行 x c 列
按列进行一维小波变换
Next Iteration No Yes
n=n/2; r=r/2; c=c/2;
进程 0 n 帧 x R0行x c 列
进程 2 n 帧 x c 列
进程 2 n 帧 x c 列
进程 2 n 帧 x c 列
将结果发送到进程
R2 行 x
进程 3 n 帧 x
R3 行 x
c 列
按帧进行一维小波变换
按行进行一维小波变换
第二次迭代必须等到线程0遍历完所有列后才能开始。最后需要指出的是,在 MPI版本中通信必须显式定义,而在POSIX线程版本中,由于不同线程对共享内存进行读写,通信是隐式发生的。这使得POSIX线程实现更易于编码。
3.2 按行和列分解
为了尝试增加并行工作的量,我们还考虑了按行和列分解的并行化策略。这是对
三维快速小波变换的并行实现…
先前的分解策略。特别是,当每个进程在时间和x维度上应用一维小波变换后,不是将结果发送到特定进程,而是在这种替代方案中,所有参与的进程之间交换结果。完成此操作后,每个进程对一列数据块应用一维小波变换。然后,三维快速小波变换的低通输出也在所有进程之间进行交换,以执行三维快速小波变换的第二次迭代,依此类推。图2以图形方式描述了这种第二种并行化策略的执行过程。
显然,在这种情况下,更多的工作被并行执行,但代价是增加了通信需求。
与按行分解版本一样,POSIX线程的实现将视频序列的不同行块分配给所有可用的线程。每个线程对其分配到的行集在时间和x维度上应用一维小波变换(第一阶段)。当所有线程完成后,它们再对其分配到的列块应用一维小波变换(第二阶段)。同样,使用屏障同步来分隔第一和第二阶段,并且在第二阶段之后也插入一个屏障同步,以确保在第一次迭代完成之前,第二次迭代(应用于低通输出)不会开始。使用MPI开发这种并行化策略需要程序员定义大量的通信,导致相比按行分解版本复杂性增加。然而,在POSIX线程版本中,由于所有通信都是隐式的,因此在这种情况下不会带来额外的编程负担。
3.3 按视频序列分解
为了尽量减少通信,这种并行化策略将视频流划分为多个序列,并随后分配给各个可用的MPI进程或线程。这样,每个MPI进程或线程都可以独立执行若干次三维快速小波变换迭代,而无需与其他进程或线程进行通信。在这种情况下,MPI版本与POSIX线程版本在复杂性方面没有显著差异,因为两者几乎采用相同的方式进行。图3以图形方式描述了这种第三种并行化策略的工作原理。
按帧进行一维小波变换
按行进行一维小波变换
C0: cols 1 -(c/ 4)
C1: cols( c/4 )+1 -(c/ 2)
n 帧 x r 行 x c 列
| R0: 行 1‐(r/4) | R0: 行 1‐(r/4) | R0: 行 1‐(r/4) | R0: 行 1‐(r/4) | R0: 行 1‐(r/4) |
| R1: 行 (r/4)+1‐(r/2) | R1: 行 (r/4)+1‐(r/2) | R1: 行 (r/4)+1‐(r/2) | R1: 行 (r/4)+1‐(r/2) | R1: 行 (r/4)+1‐(r/2) |
| R2:行 (r/2)+1‐(r/2)+(r/4) | R2:行 (r/2)+1‐(r/2)+(r/4) | R2:行 (r/2)+1‐(r/2)+(r/4) | R2:行 (r/2)+1‐(r/2)+(r/4) | R2:行 (r/2)+1‐(r/2)+(r/4) |
| R3: 行 (r/2)+(r/4)+1‐r | R3: 行 (r/2)+(r/4)+1‐r | R3: 行 (r/2)+(r/4)+1‐r | R3: 行 (r/2)+(r/4)+1‐r | R3: 行 (r/2)+(r/4)+1‐r |
进程 1 n 帧 x R1 行 x
进程 0 n 帧 x R0行x
c 列 c 列
将结果发送到进程
将结果发送到进程
将结果发送到进程
将结果发送到进程
将结果发送到进程
将结果发送到进程
将结果发送到进程
将结果发送到进程
将结果发送到进程
进程 2 n 帧 x r 行 x C2
进程 2 n 帧 x r 行 x C2
进程 2 n 帧 x r 行 x C2
进程 2 n 帧 x r 行 x C2
进程 3 n 帧 x r 行 x C3
Yes
进程 0 n 帧 x r 行 x C0 列
Next Iteration No
进程 1 n 帧 x r 行 x C1 列
n=n/2; r=r/2; c=c/2;
将结果发送到进程
C2: cols( c/2 )+1 -(c/ 2)+ (c/4 )
C3: cols( c/2 )+(c /4) +1-c
按列进行一维小波变换
进程 1 N1帧 x r 行 x
进程 2 N2帧 x r 行 x
进程 3 N3帧 x r 行 x
按帧进行一维小波变换
按行进行一维小波变换
按列进行一维小波变换
进程 0 N0 帧 x r 行 x
n 帧 x r 行 x c 列
N0: 帧 1‐(n/4)
N1:帧 (n/4)+1‐(n/2) N2:帧 (n/2)+1‐(n/2)+(n/4)
N3: 帧 (n/2)+(n/4)+1‐n
Yes c 列
Next Iteration
No n=n/2;r=r/2;c=c/2;
c 列 c 列
4 实验
我们构建了一个由四个树莓派2代B型节点组成的集群。每个节点包含一个 900MHz的四核ARM Cortex‐A7中央处理器和1GB的RAM内存。该集群的互连网络为100兆比特每秒的以太网。操作系统为Raspbian Wheezy。在我们的集群中,我们安装了MPICH2(版本1.4.1)作为之前所述并行化策略的MPI版本的 MPI库实现。此外,我们还使用PThreads(POSIX线程)实现了共享内存版本 [20]。
4.1 性能结果
我们在树莓派2上执行并测量了之前在[15,18]中使用的优化版三维快速小波变换串行版本,进行了2次迭代的三维快速小波变换。
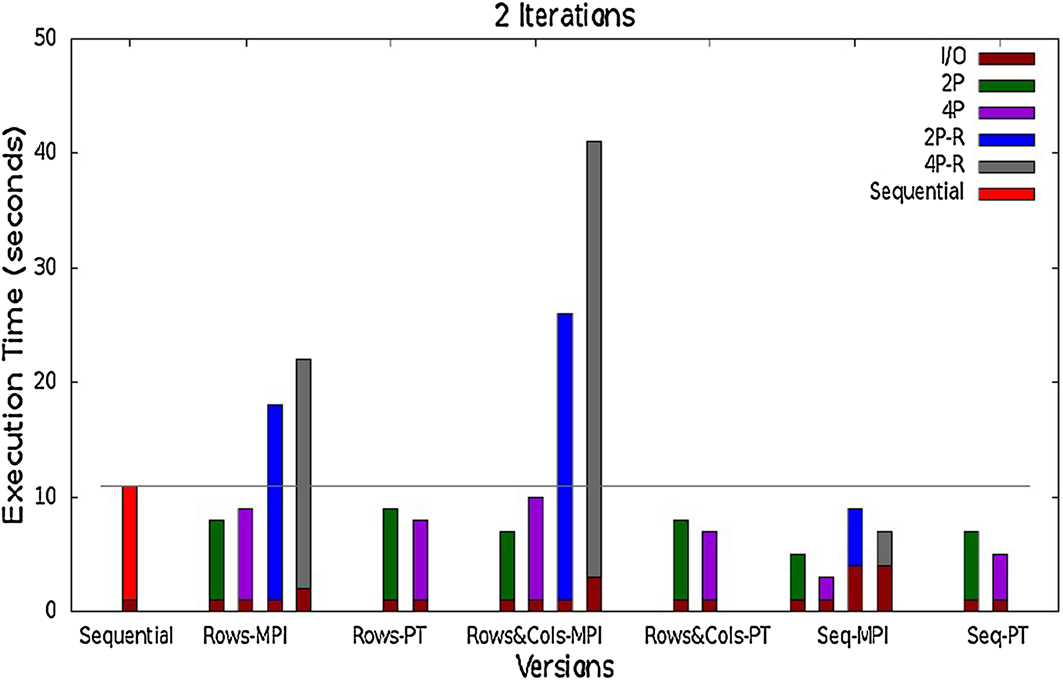
从左到右,我们首先展示顺序版本(Sequential)的结果,然后展示按行并行化策略使用MPI(按行‐MPI)和PThreads(按行‐PT)实现的结果,按行和列并行化策略使用MPI(按行和列‐MPI)和PThreads(按行和列‐PT)实现的结果,以及按视频序列并行化分解策略
使用MPI(Seq‐MPI)和PThreads(Seq‐PT)分别实现。对于每种并行化策略,我们考虑在一台树莓派2上运行2和4个MPI进程或PThreads(分别为 2P和4P),并且仅针对MPI版本,在2或4台树莓派2上运行(分别为2P‐R和 4P‐R),每种情况下每块板上仅有一个MPI进程。
从结果可以看出,与优化的顺序版本相比,三维快速小波变换提出的三种并行化策略在单个树莓派2上执行时均获得了显著的加速比。无论并行化过程中采用的是MPI还是POSIX线程,这一情况都成立。然而,对于MPI版本在不同树莓派2上的执行情况,除了按视频序列并行化分解策略外,性能方面均表现出不利的结果。造成差异的原因在于:第一种情况(所有进程或线程在同一中央处理器上运行)中,所有通信均在同一块电路板上进行,因此可以实现低延迟;而当通信发生在多个树莓派之间时则相反,此时所有通信必须通过低带宽的板载LAN端口,这抵消了并行执行可能带来的任何性能优势。
按视频序列分解策略由于不存在通信开销,因此在2和4个MPI进程情况下分别实现了1.25和1.59的加速比;尽管如图4所示,当所有MPI进程在同一 SDC上运行时,该情况下的加速比甚至更高。
仔细查看单块Raspberry Pi板的结果,我们发现按行并行化策略在2和 4个MPI进程下的加速比分别为1.44和1.24。类似地,按行和列并行化策略在 2和4个MPI进程下的加速比分别为1.50和1.16。因此,在这两种情况下,MPI进程数越少,进程间的通信量也就越少,从而获得更好的结果。由于随着进程数量的增加,这两种并行版本表现出的计算/通信比下降,因此无法实现良好的扩展性。比较两种并行化策略的结果,我们观察到按行和列分解策略所表现出的更高潜在并行性,只有在参与进程数较少(2个)时才能被有效利用。在这种情况下,每个进程执行的大量浮点运算可以显著摊销其所带来的通信开销。然而,当核心数为4时,更大的通信需求无法得到补偿,与按行分解策略相比,获得的加速比较低。
关于使用PThreads的实现,按行并行化策略在2和4个PThread下的加速比分别为1.26和1.37。类似地,按行和列并行化策略在2和4个PThread下的加速比分别为1.40和1.63。在这两种情况下,更多的PThreads数量带来了更好的结果。我们观察到,对于POSIX线程版本,通信的扩展性比MPI情况更加平滑,因此在增加这两个并行版本的线程数时不会像MPI版本那样带来性能惩罚。在这种情况下,通信通过共享内存进行,因为每个线程读取其他线程先前写入的数据块。这使得可以高效利用按行和列分解策略所具有的更高并行潜力,从而在2或4个PThread情况下,相比按行分解策略实现了更高的加速比。此外,将这些加速比与MPI版本获得的结果进行比较,我们发现最高的加速比出现在4个PThread下按行和列分解的PThreads实现(1.63)。
最后,我们考虑在同一个SDC上运行所有PThreads或MPI进程时,按视频序列并行化分解策略的结果。在这种情况下,2和4个MPI进程分别获得了 1.90和2.84的加速比。同样地,2和4个PThread的加速比分别为1.51和2.10。因此,在此情况下,对于两种实现方式而言,更多的MPI进程或PThreads数量均能带来更好的结果。需要注意的是,按视频序列分解的并行化策略的主要目标是通过让MPI进程或PThreads在不同的帧上操作,从而消除它们之间的通信。这样,该策略在加速比和可扩展性方面能够取得优于按行分解以及按行和列分解并行化策略的结果。
总体而言,在树莓派内部获得的加速结果保持在预期范围内,适用于诸如三维快速小波变换这类具有低计算强度、伪规则访问模式和复杂循环遍历的算法。在这些情况下,尽可能降低通信需求是获得显著性能提升的关键因素。
4.2 能效结果
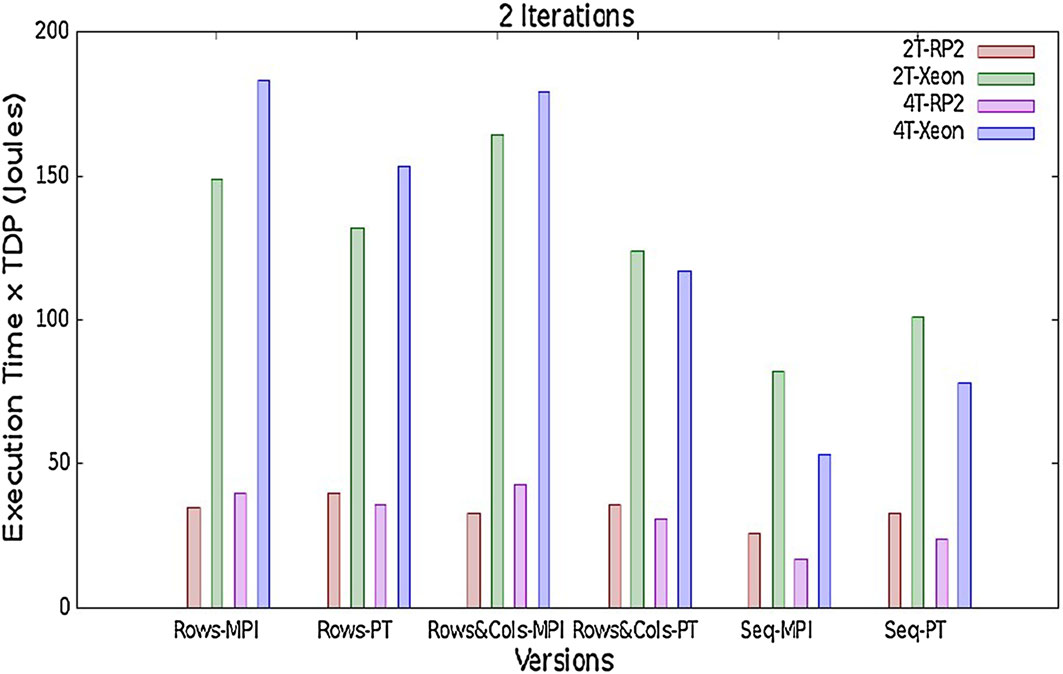
我们将树莓派2 SDC上运行的POSIX线程和MPI版本的结果与传统高性能多核处理器获得的结果进行了比较。具体而言,我们考虑了运行频率为2.13 GHz的Intel®Xeon®CPU E5606的情况。为此,我们测量了每个版本在各个平台上的执行时间,并将其乘以报告的热设计功耗(TDP)在每种情况下进行测量(树莓派2为 4 瓦,Intel Xeon 处理器为 80 瓦)。在所有情况下,我们对包含 64帧、每帧 512 × 512像素的输入视频进行 2次迭代 的三维快速小波变换。结果如图 5 所示。
从左到右,我们首先展示了按行并行化策略的实现结果,该策略分别使用MPI (按行‐MPI)和PThreads(按行‐PT)实现;按行和列并行化策略的实现结果,该策略分别使用MPI(按行和列‐MPI)和PThreads(按行和列‐PT)实现;以及按视频序列并行化分解策略的实现结果,该策略分别使用MPI(序列‐MPI)和 PThreads(序列‐PThreads)实现。对于每种并行化策略,我们考虑在一台树莓派 2上运行2和4个MPI进程或PThreads(分别为2T‐RP2和4T‐RP2),以及在Intel Xeon上运行2和4个MPI进程或PThreads(分别为2T‐Xeon和4T‐Xeon)。
如图所示,树莓派2的结果比Intel Xeon低3到4倍。这意味着该平台(树莓派2)与性能更高的对手相比,能够以低得多的总能耗完成任务。总体而言,我们的结果证明,树莓派2 SDC是一个有吸引力的平台,可为基于三维快速小波变换的应用提供低成本和高能效的支持。
5 结论与未来工作
当前,低成本通用单板计算(SDC)设备因其极佳的成本/性能比和低能耗,在科研计算领域正受到越来越多的关注。在本研究中,我们分析了基于Raspberry Pi 2 SDC设备构建的集群作为加速三维快速小波变换执行的可行平台的潜力。为此,我们采用了MPI和POSIX线程两种方法,实现了针对三维快速小波变换的三种并行化策略。研究发现,尽管该集群从成本角度来看可能是一种极具吸引力的解决方案,但从性能角度看,当使用多个主板时,其性能无法超越仅使用单个树莓派2 SDC时所达到的水平。也就是说,当所有MPI进程或PThreads在单个树莓派 2 SDC的处理器核心上运行时,可以获得明显的加速比;但当它们扩展到多个主板时,性能急剧下降。造成这一现象的原因是板载局域网端口(标称为 10/100快速以太网,并通过板载USB 2.0总线驱动)所提供的带宽有限,不足以满足两种并行化策略对细粒度、高容量通信的需求。最后,我们还对比了在高性能但高功耗的四核英特尔至强E5606处理器上运行POSIX线程和 MPI版本的情况,结果表明,树莓派2 SDC完成相同任务的总能耗要低得多(最高可达4倍)。
我们对未来的计划包括考虑使用除树莓派之外的其他SDC来构建集群。特别是,我们发现Odroid C2 SDC可能是一个值得考虑的替代方案,因为它提供了千兆以太网局域网端口等特性,有助于缓解当前集群配置中的带宽限制。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 16
 0
- 0


 已为社区贡献9条内容

所有评论(0)