Large-Scale-DRL-Exploration 代码阅读(二)
🔹 1. f'...' 是什么?
f'...' 是 Python 的 格式化字符串 (f-string),用来在字符串中直接插入变量。
name = "drl"
path = f"train/{name}"
print(path)
: train/drl
unsqueeze(dim) 在 PyTorch 中的作用是 在指定位置增加一个维度。
具体到 .unsqueeze(2):
-
假设原张量
logp的 shape 是[batch_size, k_size]-
batch_size:状态的数量 -
k_size:每个状态对应的动作数量(邻居节点数量)
-
-
logp.unsqueeze(2)会在 第 2 个维度(从 0 开始计数)插入一个长度为 1 的维度-
原 shape
[batch_size, k_size]→[batch_size, k_size, 1]
-
-
这样做的目的通常是为了 和其他张量进行广播运算
我们用一个小例子把你的三者形状和内容具体化说明。假设:
-
batch size = 2(两个状态)
-
每个状态有 3 个可选动作(邻居节点)
1️⃣ logp
这是策略网络对动作的 log 概率 输出:
logp = tensor([
  [-1.2, -0.5, -0.3],   # 状态 0 对应 3 个动作的 log prob
  [-0.8, -1.0, -0.2]    # 状态 1 对应 3 个动作的 log prob
])  # shape: [2, 3]
logp.unsqueeze(2)
-
在第 2 维(dim=2, starting from 0)增加一个长度为 1 的维度:
logp.unsqueeze(2) = tensor([
  [[-1.2], [-0.5], [-0.3]],
  [[-0.8], [-1.0], [-0.2]]
])  # shape: [2, 3, 1]
This method make element take into list
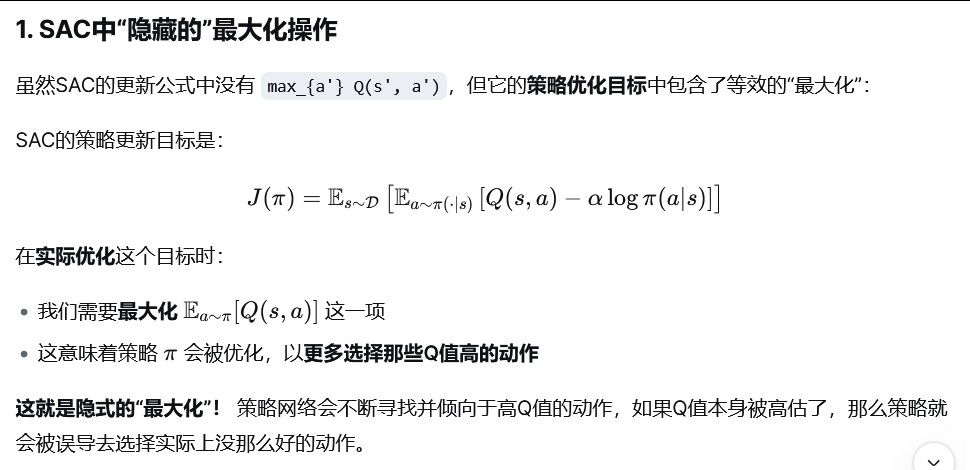
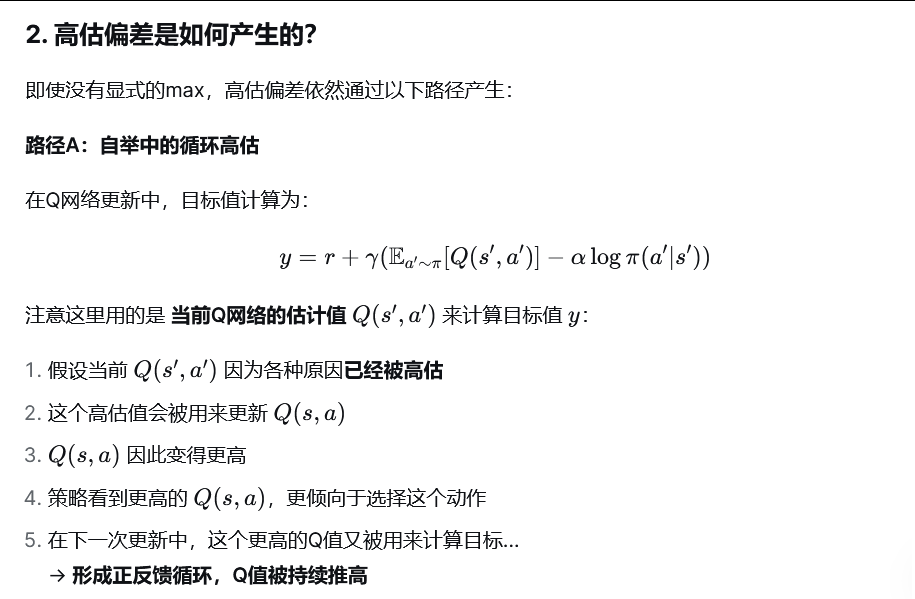
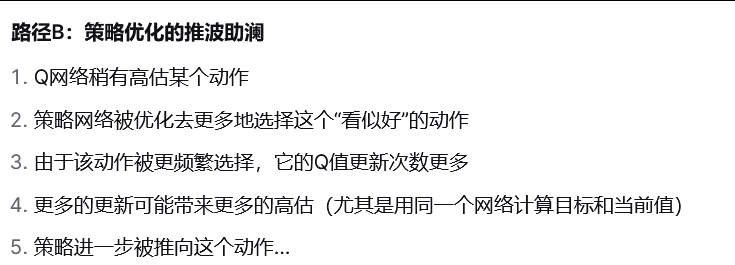
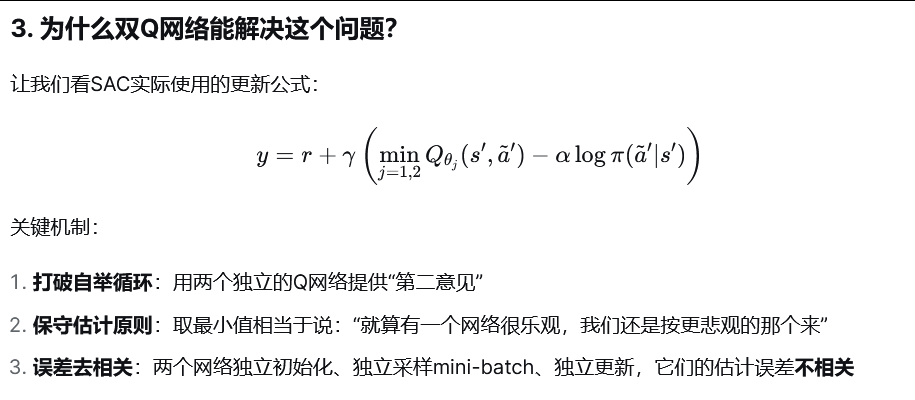
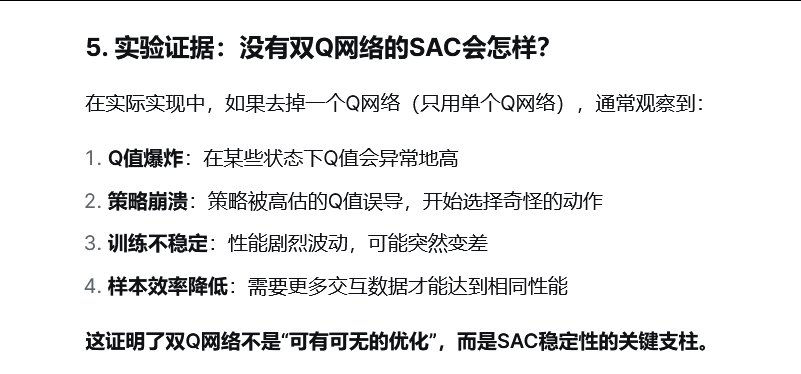
为什么强化学习算法SAC 也存在过估问题,他没有Q-learning 的max Q 操作?
主要原因是 maxJ() 和自举
🧠 .detach() 是干什么的?
🧩 一、基本概念
在 PyTorch 里,所有带有 requires_grad=True 的张量 都会被计算图(computational graph)跟踪。
也就是说,当你做反向传播 loss.backward() 时,梯度会沿着这张图一直传播。
👉 .detach() 会创建一个 新的张量,
它 共享原始张量的数据,
但 从计算图中分离出来,不再参与反向传播。
换句话说:
.detach()表示“我只要这个值,但不要它的梯度”。
🧮 二、回到你的 SAC 代码
在这段代码中
q_values1 = dp_q_net1(*critic_observation)
q_values2 = dp_q_net2(*critic_observation)
q_values = torch.min(q_values1, q_values2)

logp = dp_policy(*observation)
policy_loss = torch.sum(
    (logp.exp().unsqueeze(2) * (log_alpha.exp().detach() * logp.unsqueeze(2) - q_values.detach())),
    dim=1).mean()
关键是这里的两个 .detach():
1️⃣ log_alpha.exp().detach()
-
α是温度参数(entropy temperature)。 -
它有自己的优化目标,不属于当前 policy 网络的梯度更新。
-
所以在更新 policy 时,需要 固定 α 的值,不让梯度传过去。
2️⃣ q_values.detach()
-
q_values是从 critic 网络(QNet) 得到的输出。 -
在更新 policy 网络时,只希望 Q 值作为一个 常数监督信号 使用。
-
不希望 policy 的反向传播影响 critic 网络的参数。
-
所以要 detach 掉 Q 值,让它的梯度不再反传。
⚙️ 三、直觉解释
| 变量 | 是否需要梯度 | 为什么 |
|---|---|---|
logp (来自 policy) | ✅ 需要 | 更新策略 |
q_values (来自 critic) | ❌ 不需要 | 防止反向传播影响 critic |
log_alpha | ❌ 不需要(在 policy 更新阶段) | 它在单独的 α 优化器中更新 |
✅ 总结一句话
.detach()的作用是“断开梯度传播”,
在 SAC 里,它让 policy 更新时只影响策略网络,不影响 Q 网络和 α。
torch.sum(..., dim=1)
非常好 👍,你问的 dim=1 是 PyTorch 里一个非常关键的参数。
它表示沿哪个维度(axis)进行运算。
下面我结合你的 SAC 代码里的 torch.sum(..., dim=1) 详细解释。
policy_loss = torch.sum(
    (logp.exp().unsqueeze(2) * (log_alpha.exp().detach() * logp.unsqueeze(2) - q_values.detach())),
    dim=1).mean()
二、理解维度 (dim)
PyTorch 的张量类似于 NumPy 的多维数组。
dim 指的是你要对哪个维度做操作。
例如一个张量形状是:
x.shape = [batch_size, num_actions, 1]
那:
-
dim=0表示对所有 batch 求和(跨样本)E_S[V_pi(S)] -
dim=1表示对每个样本的所有动作求和 E_A[Q(S,A)], Q(s,a)-->V(s) -
dim=2表示对每个动作向量的最后一维求和
三、结合你的 SAC 示例推理维度
在你的代码里:
| 名称 | 形状 (可能) | 含义 |
|---|---|---|
logp | [batch_size, num_actions] | 每个状态下所有动作的 log 概率 |
q_values | [batch_size, num_actions, 1] | 每个状态下所有动作的 Q 值 |
logp.unsqueeze(2) | [batch_size, num_actions, 1] | 给 logp 增加一个维度,用于广播计算 |
logp.exp().unsqueeze(2) | [batch_size, num_actions, 1] | 动作概率分布 π(a |
经过 (logp.exp().unsqueeze(2) * (...)) 之后:
得到一个 [batch_size, num_actions, 1] 的张量。
最后这一步:
torch.sum(..., dim=1)
表示对 每个状态 的 所有动作维度 求期望: 对每个状态 s,计算所有动作的加权期望损失。
∑aπ(a∣s)[αlogπ(a∣s)−Q(s,a)]\sum_a \pi(a|s) [\alpha \log \pi(a|s) - Q(s,a)]∑aπ(a∣s)[αlogπ(a∣s)−Q(s,a)]
得到结果形状:
[batch_size, 1]
然后再 .mean():就是对所有样本求平均,得到一个标量作为 loss。
policy_loss 这个变量是怎么和global_policy_optimizer 联系在一起的
🧠 一、简短回答
policy_loss 之所以能和 global_policy_optimizer 关联起来,
是因为:
policy_loss是由global_policy_net的输出计算出来的,
而global_policy_optimizer是用来更新global_policy_net的参数的。
当执行:
policy_loss.backward()
时,PyTorch 会自动沿着计算图找到所有参与生成 policy_loss 的张量(包括 global_policy_net 的参数),并在这些参数的 .grad 属性里存入梯度。
接着:
global_policy_optimizer.step()
就会用这些梯度更新这些参数。
torch.nn.utils.clip_grad_norm_()
这行代码涉及到 梯度裁剪(gradient clipping),是深度强化学习(尤其是 SAC、PPO、DDPG 等)里常见的一步,用来防止梯度爆炸。
我们来逐行、直观地解释一下。
policy_grad_norm = torch.nn.utils.clip_grad_norm_(
    global_policy_net.parameters(),
    max_norm=100,
    norm_type=2
)
意思是:
在
global_policy_net的所有参数的梯度计算完(即.backward()执行后),
把它们的梯度向量的整体 L2 范数(norm_type=2) 限制在 100 以内。
🔹二、它解决了什么问题?
在训练强化学习的网络时,梯度可能因为目标函数的不稳定(尤其是 Q 值波动很大)而突然变得极大。
结果是参数更新过度,训练不稳定,甚至“炸掉”(loss = NaN)。
梯度裁剪的作用就是:
当梯度的整体幅度超过某个阈值(比如 100)时,
就按比例缩小所有梯度,保持方向不变,但控制长度。
🔹三、工作原理(数学视角)
假设所有参数的梯度拼起来是一个大向量 ggg。
它的 2 范数是:
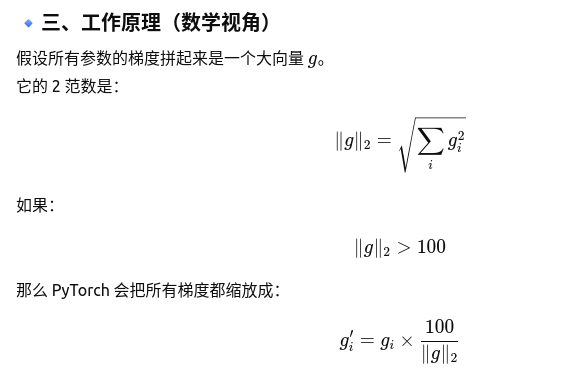
缩放梯度,然后让缩放后的梯度拼起来的大向量的2范数正好等于100
🧩 一、.item() 是什么?
表示将一个 只有单个元素的 tensor 转换为一个 Python 的标量数值(float 或 int)。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 14
 0
- 0


 已为社区贡献6条内容

所有评论(0)