从规律到代码:单链表重排(L0→Ln→L1→Ln-1…)的实现解析
文章目录
从规律到代码:单链表重排(L0→Ln→L1→Ln-1…)的实现解析
很多人面对链表重排问题时会觉得无从下手,但只要先观察 “原链表” 与 “目标链表” 的结构差异,找到规律,再拆解成可落地的代码步骤,问题就能迎刃而解。本文会先从规律分析入手,再结合代码逐步讲解实现逻辑。
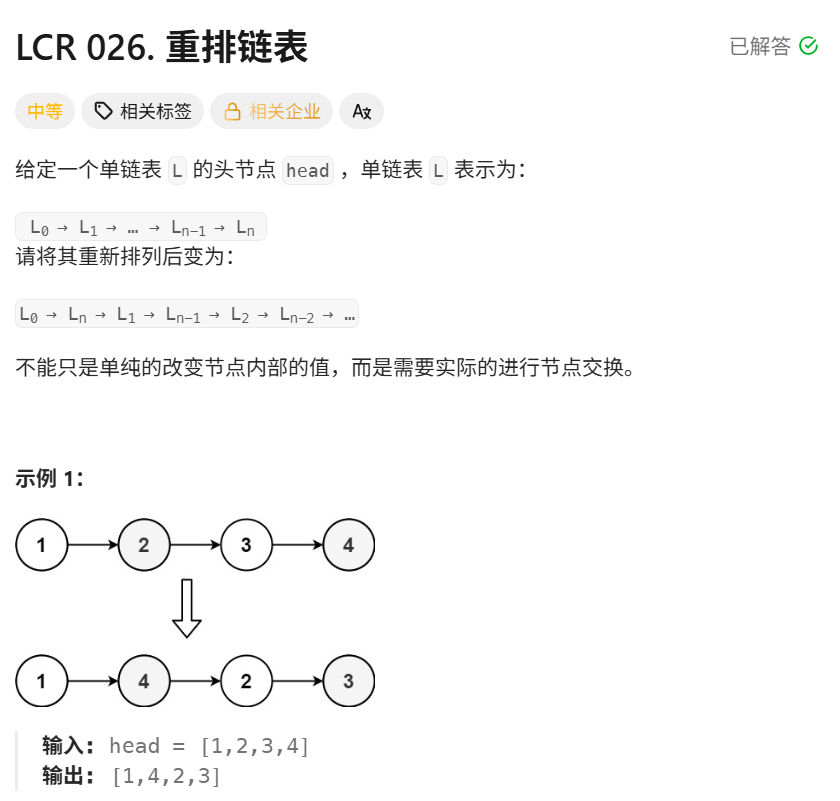
重排链表力扣链接
一、第一步:观察规律 —— 拆分 “顺序” 与 “倒序” 部分
要重排链表,首先得明确 “目标链表的节点来源”。我们以通用形式对比原链表和目标链表:
| 原链表(L0→L1→L2→…→Ln-2→Ln-1→Ln) | 目标链表(L0→Ln→L1→Ln-1→L2→Ln-2→…) |
|---|---|
| 节点 L0(无 n) | 第 1 位:L0(来自原链表的 “无 n 部分”) |
| 节点 L1(无 n) | 第 3 位:L1(来自原链表的 “无 n 部分”) |
| 节点 L2(无 n) | 第 5 位:L2(来自原链表的 “无 n 部分”) |
| … | … |
| 节点 Ln-2(带 n) | 第 6 位:Ln-2(来自原链表的 “带 n 部分”) |
| 节点 Ln-1(带 n) | 第 4 位:Ln-1(来自原链表的 “带 n 部分”) |
| 节点 Ln(带 n) | 第 2 位:Ln(来自原链表的 “带 n 部分”) |
通过对比能清晰发现两个核心规律:
-
目标链表的 “奇数位节点”(第 1、3、5… 位):完全来自原链表的 “前半段无 n 节点”,且保持原有的顺序(L0→L1→L2…);
-
目标链表的 “偶数位节点”(第 2、4、6… 位):完全来自原链表的 “后半段带 n 节点”,但需要反转成倒序(Ln→Ln-1→Ln-2…)。
简单说:目标链表 = 原链表前半段(顺序) + 原链表后半段(倒序),再交替拼接而成。这就是我们解题的核心依据。
二、第二步:基于规律拆分解题步骤(附代码实现)
既然规律是 “顺序前半段 + 倒序后半段 + 交替合并”,那解题就可以拆成 3 个可落地的步骤,每个步骤对应一段核心代码,我们结合开头的Solution类逐步讲解。
步骤 1:拆分原链表 —— 分离 “顺序前半段” 和 “待倒序后半段”
要得到 “顺序前半段” 和 “后半段”,首先需要找到链表的中点(前半段的尾节点),这样才能将原链表从中间断开。
核心逻辑:用 “快慢指针” 找中点
-
慢指针(slow):每次走 1 步,最终停在 “前半段尾节点”;
-
快指针(fast):每次走 2 步,作为终止条件(当 fast 或 fast->next 为 null 时,slow 就到中点);
-
关键:快指针初始要从head->next开始,确保 “前半段长度 ≥ 后半段长度”(避免合并时前半段提前用完)。
对应代码实现(findMid 函数)
// 快慢指针找中点(返回前半段的尾节点)
ListNode* findMid(ListNode* head) {
    ListNode* slow = head;       // 慢指针从head开始
    ListNode* fast = head->next; // 快指针从head->next开始(关键)
    // 当快指针能继续走时,慢指针同步移动
    while (fast && fast->next) {
        slow = slow->next;       // 慢指针走1步
        fast = fast->next->next; // 快指针走2步
    }
    return slow; // 循环结束后,slow就是前半段尾节点
}
拆分操作(在 reorderList 主函数中)
if (!head || !head->next) return; // 边界:空链表或只有1个节点,无需操作

// 1. 找中点,分离前半段和后半段
ListNode* mid = findMid(head);    // mid是前半段尾节点
ListNode* l1 = head;              // l1:顺序前半段(L0→L1→…)
ListNode* l2 = mid->next;         // l2:待倒序的后半段(Ln-1→Ln…)
mid->next = nullptr;              // 断开前半段和后半段(避免合并时成环)
示例:原链表L0→L1→L2→L3→L4,拆分后l1=L0→L1→L2(顺序),l2=L3→L4(待倒序)。
步骤 2:反转后半段 —— 将 “待倒序后半段” 变成 “倒序后半段”
根据规律,目标链表的偶数位需要 “倒序的后半段”,所以要把步骤 1 得到的l2反转(比如L3→L4反转成L4→L3)。
核心逻辑:用 “迭代法” 反转链表
-
定义前驱节点pre(初始为 null,作为反转后链表的尾节点);
-
遍历l2,每次将当前节点的next指向pre,再更新pre和当前节点;
-
遍历结束后,pre就是反转后的链表头节点。
对应代码实现(reverse 函数)
// 反转链表(返回反转后的头节点)
ListNode* reverse(ListNode* head) {
    ListNode* pre = nullptr; // 前驱节点(初始为null)
    ListNode* curr = head;   // 当前节点(从head开始)
    while (curr) {
        ListNode* nextTemp = curr->next; // 临时保存当前节点的下一个节点(避免丢失)
        curr->next = pre;                // 反转:当前节点指向前驱
        pre = curr;                      // 前驱节点后移(变成当前节点)
        curr = nextTemp;                 // 当前节点后移(变成之前保存的下一个节点)
    }
    return pre; // 循环结束后,pre是反转后的头节点
}
反转操作(在 reorderList 主函数中)
// 2. 反转后半段l2,得到倒序的后半段
l2 = reverse(l2);
示例:l2=L3→L4反转后,l2=L4→L3(倒序,符合目标链表的偶数位需求)。
步骤 3:交替合并 —— 将 “顺序前半段 l1” 和 “倒序后半段 l2” 拼起来
现在我们有了l1(顺序:L0→L1→L2)和l2(倒序:L4→L3),接下来要按 “l1 取一个→l2 取一个” 的顺序合并,得到目标链表。
核心逻辑:用 “临时指针保存下一个节点”
-
每次合并前,用n1保存l1的下一个节点,用n2保存l2的下一个节点(避免修改next后丢失后续节点);
-
先让l1的next指向l2(完成 “l1 节点→l2 节点” 的拼接);
-
再让l2的next指向n1(完成 “l2 节点→l1 下一个节点” 的拼接);
-
最后更新l1和l2为n1和n2,进入下一轮循环,直到其中一段链表为空。
对应代码实现(merge 函数)
// 交替合并l1(顺序前半段)和l2(倒序后半段)
void merge(ListNode* l1, ListNode* l2) {
    while (l1 && l2) { // 只要l1和l2都不为空,就继续合并
        // 1. 保存l1和l2的下一个节点(避免后续修改next后丢失)
        ListNode* n1 = l1->next;
        ListNode* n2 = l2->next;

        // 2. 拼接:l1 → l2
        l1->next = l2;
        // 3. 拼接:l2 → l1的下一个节点(n1),但要先判断n1是否为空(避免l1已用完)
        if (!n1) break; // 若n1为空,说明l1已遍历完,直接跳出(l2剩余节点无需处理)
        l2->next = n1;

        // 4. 更新l1和l2,准备下一轮合并
        l1 = n1;
        l2 = n2;
    }
}
合并操作(在 reorderList 主函数中)
// 3. 交替合并l1和l2,得到目标链表
merge(l1, l2);
示例:合并l1=L0→L1→L2和l2=L4→L3的过程:
-
第一轮:L0→L4,L4→L1 → 此时链表为L0→L4→L1→L2,l1 更新为 L1,l2 更新为 L3;
-
第二轮:L1→L3,L3→L2 → 此时链表为L0→L4→L1→L3→L2,l1 更新为 L2,l2 更新为 null;
-
循环结束,最终得到目标链表。
三、完整代码梳理与边界测试
将上述步骤整合,就是开头的完整Solution类,我们再梳理一遍核心流程,并测试边界情况:
完整代码回顾
class Solution {
public:
    void reorderList(ListNode* head) {
        if (!head || !head->next) return; // 边界处理

        // 步骤1:拆分前半段(l1)和后半段(l2)
        ListNode* mid = findMid(head);
        ListNode* l1 = head;
        ListNode* l2 = mid->next;
        mid->next = nullptr;

        // 步骤2:反转后半段l2
        l2 = reverse(l2);

        // 步骤3:交替合并l1和l2
        merge(l1, l2);
    }

    // 找前半段尾节点(快慢指针)
    ListNode* findMid(ListNode* head) {
        ListNode* slow = head;
        ListNode* fast = head->next;
        while (fast && fast->next) {
            slow = slow->next;
            fast = fast->next->next;
        }
        return slow;
    }

    // 反转链表(迭代法)
    ListNode* reverse(ListNode* head) {
        ListNode* pre = nullptr;
        ListNode* curr = head;
        while (curr) {
            ListNode* nextTemp = curr->next;
            curr->next = pre;
            pre = curr;
            curr = nextTemp;
        }
        return pre;
    }

    // 交替合并两个链表
    void merge(ListNode* l1, ListNode* l2) {
        while (l1 && l2) {
            ListNode* n1 = l1->next;
            ListNode* n2 = l2->next;

            l1->next = l2;
            if (!n1) break;
            l2->next = n1;

            l1 = n1;
            l2 = n2;
        }
    }
};
边界测试验证
-
空链表(head=null):直接返回,无操作;
-
1 个节点(L0):直接返回,无操作;
-
2 个节点(L0→L1):拆分后 l1=L0,l2=L1;反转 l2 仍为 L1;合并后 L0→L1(符合目标);
-
3 个节点(L0→L1→L2):拆分后 l1=L0→L1,l2=L2;反转 l2 仍为 L2;合并后 L0→L2→L1(符合目标)。
四、总结:规律先行,代码落地
解决链表重排问题的关键,是先通过对比 “原链表” 和 “目标链表”,发现 “顺序前半段 + 倒序后半段” 的核心规律,再将规律拆成 “拆分→反转→合并” 三个基础步骤。每个步骤都用成熟的链表操作(快慢指针找中点、迭代反转、临时指针合并)实现,既降低了思维难度,也保证了代码的可读性和效率。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 19
 0
- 0


 已为社区贡献4条内容

所有评论(0)