GAN 生成对抗网络 (Generative Adversarial Network)
一、GAN 的全称和基本概念
1. GAN 是什么?
GAN 的全称是 Generative Adversarial Network,中文叫:
生成对抗网络
我们来拆开这个词,一个字一个字理解:
- 生成(Generative):意思是“创造”、“产生”。比如,你能画一幅画,那这幅画就是你“生成”的。
- 对抗(Adversarial):意思是“对抗的”、“敌对的”。就像两个拳击手在擂台上比赛,互相较量。
- 网络(Network):这里指的是“神经网络”,是一种模仿人脑工作方式的计算机程序,能学习数据中的规律。
所以,GAN 就是一个由两个互相“对抗”的神经网络组成的系统,其中一个负责“生成”东西,另一个负责“判断”真假。他的核心只有一个目标 ——让 AI 学会 “模仿” 真实数据,生成和真实数据几乎一样的 “假数据”。
你可以把它想象成:
一个“造假者”和一个“警察”在玩一场永无止境的“猫捉老鼠”游戏。
二、用一个生活中的比喻来理解 GAN
为了让你更容易理解,我们先讲一个故事。
故事:假币制造者 vs 警察
假设世界上有两个人:
- 小明:一个想制造假币的造假者。
- 老王:一个负责检查钞票真假的警察。
他们的目标分别是:
- 小明的目标:造出越来越逼真的假币,让警察看不出来是假的。
- 老王的目标:练出火眼金睛,能准确分辨出哪些是真钱,哪些是假钱。
一开始:
- 小明造的假币很粗糙,老王一眼就看出是假的。
- 但小明不服气,回去改进技术,造出第二版假币。
- 老王拿到后,再判断,发现这次有点难分辨了,但还是能认出来。
- 小明又改进……老王又学习……
- 这个过程不断重复。
慢慢地:
- 小明造的假币越来越像真币。
- 老王的判断能力也越来越强。
最终,理想情况下:
小明造出的假币已经和真币一模一样,连老王都分不出来了!
这时候,我们就说:小明成功了!他学会了如何“生成”逼真的钞票。
把这个故事对应到 GAN
| 故事角色 | 对应 GAN 中的角色 | 在 GAN 中叫什么 |
|---|---|---|
| 小明(造假者) | 生成假币的人 | 生成器(Generator) |
| 老王(警察) | 判断真假的人 | 判别器(Discriminator) |
| 真币 | 真实的数据 | 真实样本(Real Data) |
| 假币 | 生成器造出来的东西 | 生成样本(Fake Data) |
所以,GAN 就是让这两个“人”——生成器和判别器——不断对抗、互相学习,最终让生成器学会创造出和真实数据一模一样的新数据。
三、GAN 的结构:到底长什么样?
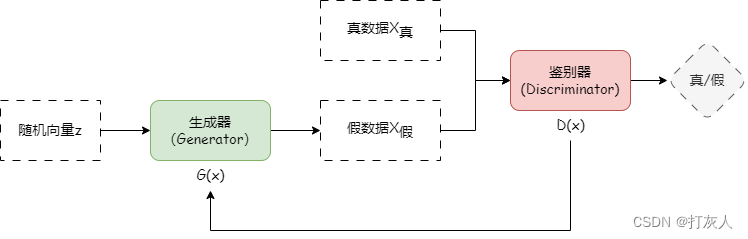

我们现在来看看 GAN 的“内部结构”。GAN 不是一个单一的网络,而是由两个完全独立的神经网络组成,它们的任务和结构都不一样,就像 “小偷” 和 “警察” 的职责完全不同。
1. 两个神经网络
GAN 由两个神经网络组成:
(1)生成器(Generator)
- 输入:一个随机数(通常是一堆乱七八糟的数字,比如从 -1 到 1 的随机数组成的向量)。
- 输出:一个看起来像真实数据的东西,比如一张人脸图片、一段音乐、一段文字等。
比如:输入一堆随机数 → 输出一张“假”的人脸照片。
- 核心任务:从 “随机噪声”(可以理解为一堆毫无意义的随机数字)出发,生成 “看起来像真实数据” 的假数据。比如:输入一堆随机数 → 生成一张假人脸;输入一堆随机数 → 生成一段假的新闻文本。
- 形象类比:就像小偷的 “造假工厂”,原材料是 “废纸”(随机噪声),产出是 “假钞”(假数据)。
- 结构特点:通常用 “反卷积网络”(处理图像时)或 “循环神经网络(如 GRU/LSTM)”(处理文本时),目的是把 “低维度的随机噪声” 转换成 “高维度的逼真数据”(比如把 100 维的随机数,变成 28×28 像素的手写数字图片)。
(2)判别器(Discriminator)
- 输入:一张图片(可能是真实的,也可能是生成器造出来的)。
- 输出:一个概率值,表示这张图是“真实”的可能性有多大。
- 如果输出接近 1(比如 0.9),说明判别器认为这是真图。
- 如果输出接近 0(比如 0.1),说明判别器认为这是假图。
- 核心任务:接收 “真实数据”(比如真实的人脸照片、真实的新闻)和 “生成器造的假数据”,输出一个 “0~1 之间的概率”,判断输入数据是 “真的” 还是 “假的”。比如:输入一张真实人脸 → 输出 0.9(认为 90% 是真的);输入一张生成的假人脸 → 输出 0.2(认为 20% 是真的,80% 是假的)。
- 形象类比:就像警察的 “鉴钞仪”,输入 “钞票”(数据),输出 “这张钞票是真的概率”。
- 结构特点:本质是一个 “二分类器”,通常用 “卷积网络”(处理图像时)或 “全连接网络”,目的是从数据中提取特征,区分 “真实特征” 和 “伪造特征”。
2. 它们是怎么工作的?(训练过程)
GAN 的训练不是 “先训练生成器,再训练判别器”,而是让两者 “同时训练、互相对抗”,每一轮训练都分 4 步,像打游戏一样不断升级。
我们以 “生成手写数字(比如 MNIST 数据集,真实数据是 28×28 的手写 0~9 图片)” 为例,拆解训练过程:
步骤 1:准备 “真实数据” 和 “随机噪声”
- 真实数据:从 MNIST 数据集中取出一批真实的手写数字图片(比如 100 张,作为 “真钞”);
- 随机噪声:生成一批低维度的随机数(比如 100 个 100 维的随机向量,作为 “废纸”,给生成器造假用)。
步骤 2:训练判别器(让警察先 “学习鉴假”)
判别器要先 “学习区分真假”,分两步:
- 输入真实数据给判别器:把真实的手写数字图片输入判别器,希望判别器输出 “接近 1 的概率”(比如 0.9、0.85),表示 “这是真的”。如果输出偏低(比如 0.5),就调整判别器的参数,让它下次能更准确地识别真实数据。
- 输入假数据给判别器:把 “随机噪声输入生成器” 得到的假手写数字图片(一开始可能很模糊,像乱涂的)输入判别器,希望判别器输出 “接近 0 的概率”(比如 0.1、0.05),表示 “这是假的”。如果输出偏高(比如 0.4),也调整判别器的参数,让它下次能更准确地识别假数据。
- 目标:让判别器对 “真实数据输出 1,假数据输出 0” 的能力越来越强。
步骤 3:训练生成器(让小偷 “学习造假”)
生成器的目标是 “让自己造的假数据,能骗过判别器”,所以训练时要 “隐藏判别器的更新”(只改生成器的参数,不改判别器的):
- 把随机噪声输入生成器,得到假手写数字图片;
- 把这些假图片输入判别器,希望判别器输出 “接近 1 的概率”(比如 0.8、0.9)—— 意思是 “让判别器误以为这些假图片是真的”。
- 如果判别器输出偏低(比如 0.3,说明假图片太假),就调整生成器的参数,让它下次生成的假图片更像真的(比如让数字的轮廓更清晰、笔画更自然)。
- 目标:让生成器造的假数据,能越来越多地骗过判别器。
步骤 4:重复迭代,直到 “平衡”
把步骤 1~3 重复成千上万次(比如 10000 轮):
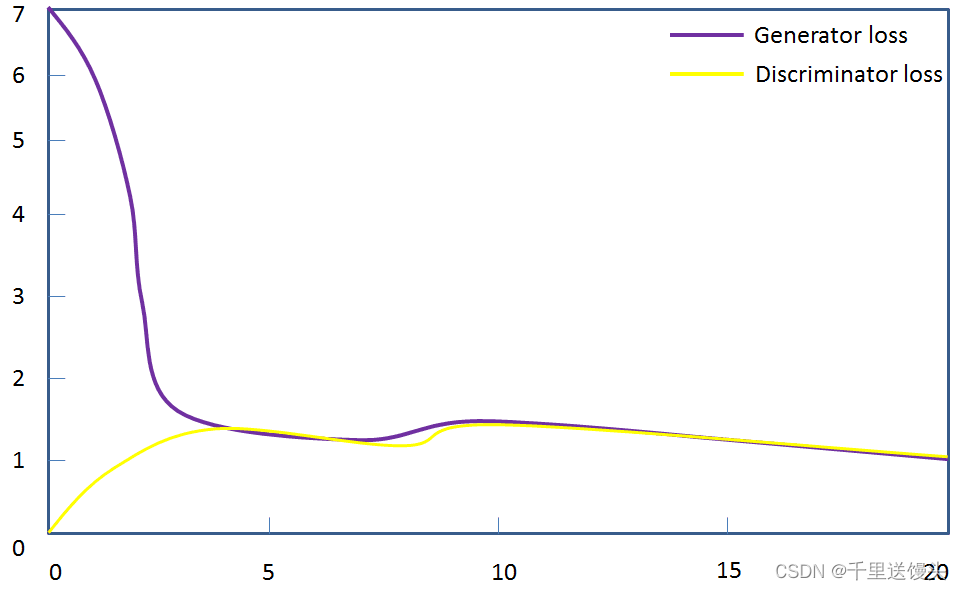
- 一开始:生成器造的假数据很假(像乱涂),判别器轻松区分(真实数据输出 0.9,假数据输出 0.1);
- 中期:生成器造的假数据有点像真的(轮廓能看出是数字,但细节粗糙),判别器区分难度变大(真实数据输出 0.8,假数据输出 0.4);
- 后期:生成器造的假数据和真实数据几乎一样(笔画、细节都逼真),判别器的输出接近 0.5(像抛硬币一样,分不清真假)—— 这时 GAN 训练完成,生成器可以用来生成新的逼真数据了。
最终目标:
生成器生成的图片,让判别器判断为“50% 是真的”,也就是说,判别器已经无法判断真假,相当于抛硬币猜。
这时候我们就说:GAN 训练成功了!
四、数学上简单解释(可跳过,不影响理解)
如果你害怕数学,可以跳过这一节。但如果想稍微深入一点,我们简单看看。
1. GAN 的目标函数(核心公式)
GAN 的整个思想可以用一个公式表示:
min_G max_D V(D, G)
看不懂没关系,我们解释一下:
- D:判别器(Discriminator)
- G:生成器(Generator)
- V:一个衡量“对抗效果”的函数
这个公式的意思是:
- 我们要让 D 尽可能大(判别器尽量能分清真假)
- 同时让 G 尽可能小(生成器尽量让 D 难以分辨)
这就像一个“零和游戏”:一方赢,另一方就输。
2. 判别器的目标
判别器希望做到:
- 看到真实图片时,输出尽可能接近 1。
- 看到生成图片时,输出尽可能接近 0。
它的损失函数(Loss Function)是:
L_D = - [ log(D(x)) + log(1 - D(G(z))) ]
- x:真实图片
- z:随机噪声(输入给生成器)
- G(z):生成器生成的假图
- D(x):判别器对真图的判断
- D(G(z)):判别器对假图的判断
这个公式的意思是:判别器要最大化这个损失,让自己更准确。
3. 生成器的目标
生成器希望:
- 让判别器对它的假图判断为“是真的”,也就是 D(G(z)) 接近 1。
它的损失函数是:
L_G = - log(D(G(z)))
或者有时候写成:
L_G = log(1 - D(G(z))) # 最小化这个值
生成器要最小化这个损失,也就是让判别器“上当”。
五、GAN 能干什么?(实际应用)
GAN 不只是理论,它有很多酷炫的应用:
1. 生成人脸
- 比如网站 thispersondoesnotexist.com 上的所有人脸,都是 GAN 生成的,没有一个是真人!
2. 图片修复(Inpainting)
- 把老照片破损的地方自动补全。
- 或者去掉照片里不想出现的东西(比如电线、路人)。
3. 风格迁移(Style Transfer)
- 把一张照片变成梵高风格、水墨风格等。
4. 超分辨率(Super-Resolution)
- 把模糊的低清图片变成高清图片。
5. 数据增强
- 医疗领域:生成更多的病灶图像,帮助医生训练 AI 诊断模型。
6. 文字生成图片(Text-to-Image)
- 输入一句话,比如“一只穿西装的猫在弹钢琴”,GAN 就能生成对应的图片。
六、GAN 的优缺点
优点:
- 能生成非常逼真的数据(尤其是图像)。
- 不需要对数据分布做复杂假设。
- 可以用于无监督学习(不需要标签)。
缺点:
- 训练不稳定:两个网络互相博弈,容易“一个太强,一个太弱”,导致失败。
- 模式崩溃(Mode Collapse):生成器偷懒,只生成同一种类型的图(比如所有人脸都长一个样)。
- 计算资源消耗大:需要很强的 GPU,训练时间很长。
七、常见的 GAN 变种(了解一下名字就行)
随着研究发展,人们提出了很多改进版的 GAN:
- DCGAN:用卷积神经网络的 GAN,适合处理图像。
- WGAN:改进了训练稳定性。
- CycleGAN:可以在没有配对数据的情况下进行图像风格转换(比如马变斑马)。
- StyleGAN:能生成超高分辨率、高度可控的人脸(NVIDIA 出的)。
- Pix2Pix:用于图像到图像的翻译,比如素描变彩色图。
八、GAN 的关键特点:为什么它能生成 “以假乱真” 的数据?
- 对抗性训练:没有固定的 “标准答案”(比如不像分类任务有 “这张图是猫” 的标签),而是通过两个网络的博弈,让生成器 “主动学习” 真实数据的特征(比如手写数字的笔画粗细、倾斜角度),比传统生成模型(如自编码器)更灵活。
- 不依赖显式数据分布:传统生成模型需要先 “假设真实数据的分布”(比如假设数据符合正态分布),但 GAN 不用 —— 它通过对抗直接 “学习” 真实数据的分布,更适合复杂数据(如人脸、文本)。
- 生成质量高:只要训练充分,GAN 能生成细节非常逼真的数据(比如 StyleGAN 生成的假人脸,普通人几乎看不出是 AI 造的)。
九、总结:GAN 的核心思想(一句话)
GAN 是通过让一个“造假者”(生成器)和一个“警察”(判别器)不断对抗,最终让造假者学会生成以假乱真的数据。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 22
 0
- 0


 已为社区贡献2条内容

所有评论(0)