dify应用教程---创建一个简单的RAG项目
·
模块介绍
主页面面板有四个table: 探索,工作室,知识库,工具
探索: 使用这些模板或根据模板自定义您自己的应用程序。
工作室: 可以创建自己的应用,包括聊天助手, 智能体,工作流
知识库: 上传自己的数据作为上下文,构建RAG应用
工具: Dify本身集成第三方工具,用户也可自定义工具。
这次主要用到的是工作室和知识库
基础准备: 安装插件并配置模型
先 安装模型插件,然后在设置中配置密钥和api;密钥需要去平台申请,要花钱的;
模型最好使用通义千问, 比较全,如果配置有问题,切换一下插件版本
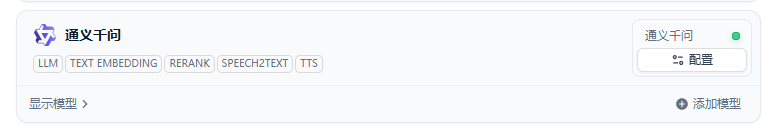
本地模型安装Ollama和vllm, 还是花钱省事,安装大模型特别费劲
安装插件如果报错,看一下docker_api_1和docker_plugin_daemon_1的日志,应该比较容易解决
我们做一个简答的产品介绍RAG问答系统
1.创建知识库
基础操作.文件上传
分段设置:
通用分段设置,
父子分段设置:  检索子块,返回父块
索引方式: 高质量 和 经济
经济: 就是省钱,效果会差点
高质量需要用到嵌入模型,可以自己找模型,也可以直接用通义千问的模型
不同的嵌入模型效果会有些差异
检索设置
向量检索:     问题向量化后, 对比知识库和问题的向量距离,找接近的
全文检索:    类似搜索引擎中的明文检索。通过明文关键词匹配知识库内对应的文本片段,返回符合关键词的文本片段;
混合检索:     同时执行全文检索和向量检索

Rerank 模型: 使用模型会再次重排序由检索召回的内容分段,以优化排序结果。可以辅助其提升输出的质量;
TopK:  用于筛选与用户问题相似度最高的文本片段。数值越高,预期被召回的文本分段数量越多。
Score 阈值: 用于设置文本片段筛选的相似度阈值,只召回超过设置分数的文本片段,默认值为 0.5。数值越高说明对于文本与问题要求的相似度越高,预期被召回的文本数量也越少。
- 创建应用
工作室中 创建空白应用 选择chatflow, 然后进入流程编辑
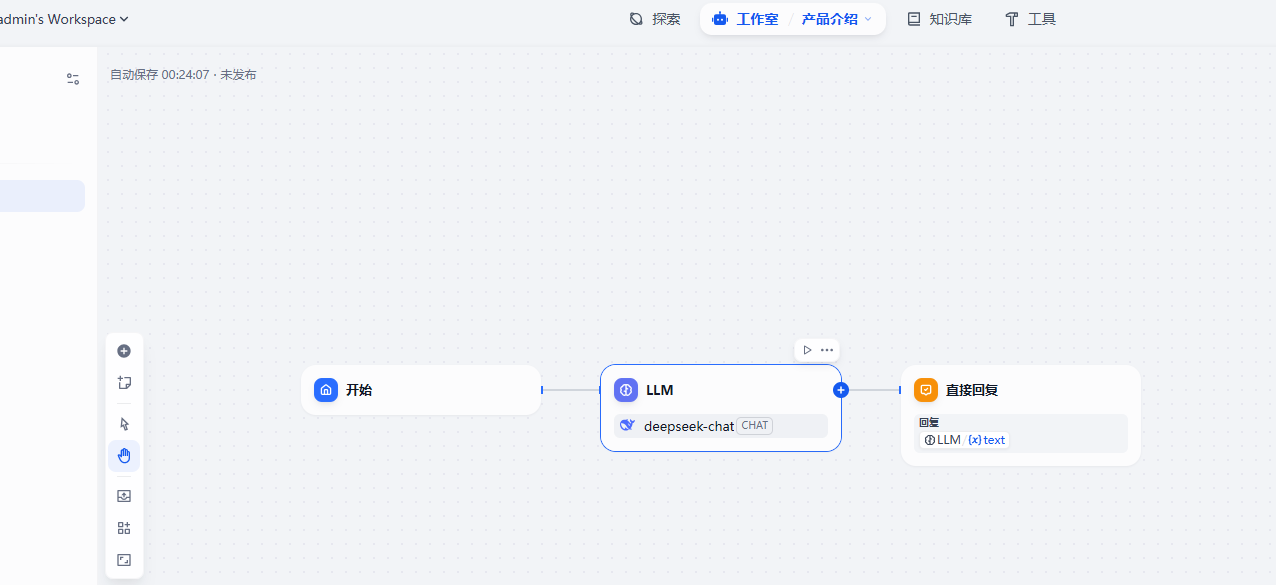
先分解一下流程
问题 —> 检索 —>根据检索内容回答
(但是人千奇百怪,问题五花八门,最好是把问题提取一下关键词)
所以流程变为
问题 —> 关键词 —> 检索 —> 根据检索内容回答
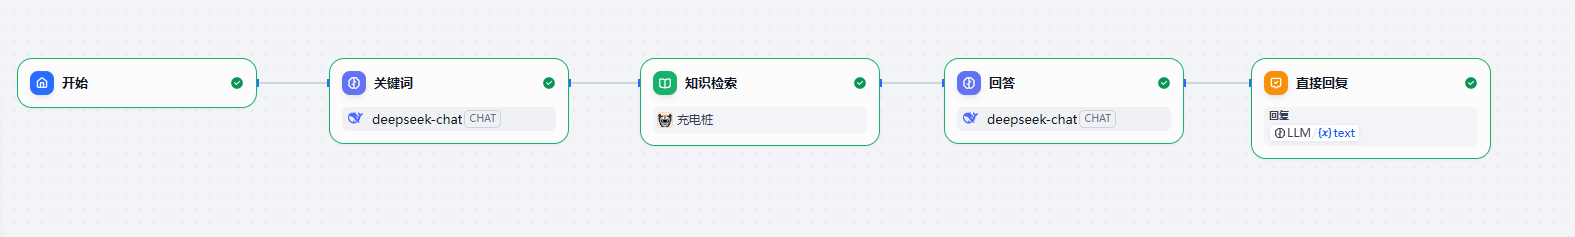
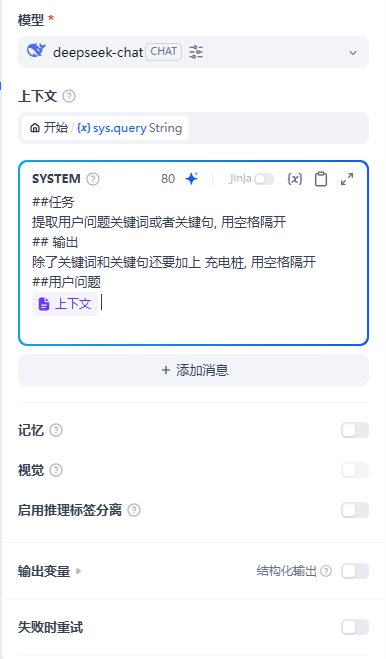
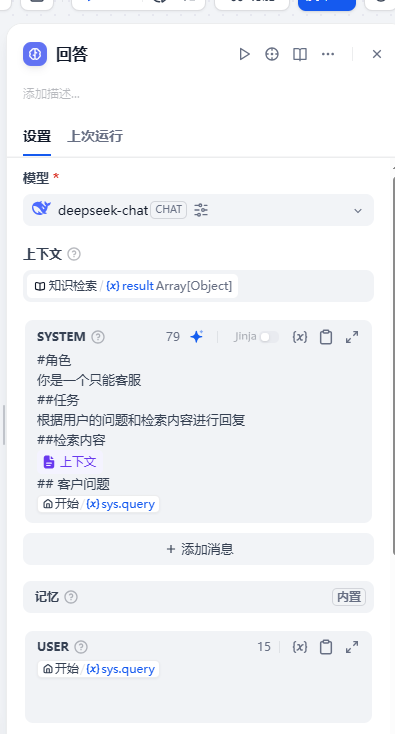
关键字: 是一个大模型节点,用来提取关键字在SYSTEM中填入prompt(prompt很重要,通过合适的prompt使大模型输出我们想要的结果)
如果没找到sys.query,你是不是选成workflow了
知识检索节点, 记住上一个节点的输出是本节点的输入
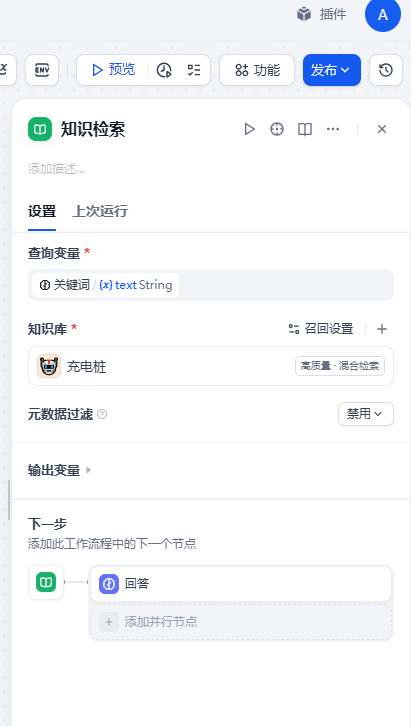
回答节点
最后点击预览 ,调试
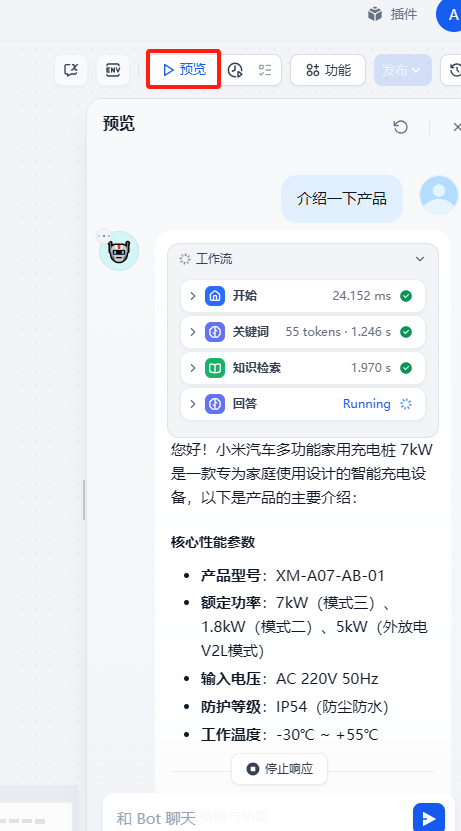
我们可以看到每一个流程
如果输出的不是我们想要的调整方案:
①关键词节点和回答节点:prompt调整一下,看一下输出内容是不是我们想要的
②查看知识检索节点,召回的内容是不是我们想要的,调整一下召回设置
③ 如果流程都通了,但是回答不是我们想要的,那就是知识库内容质量的问题
这是一个演示项目;
网上说, 这个可以做成一个agent更简单,我还不会,下一篇就学一下怎么弄agent

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献5条内容

所有评论(0)