【TIDE DIARY 3.1】dify代码与提示词
·
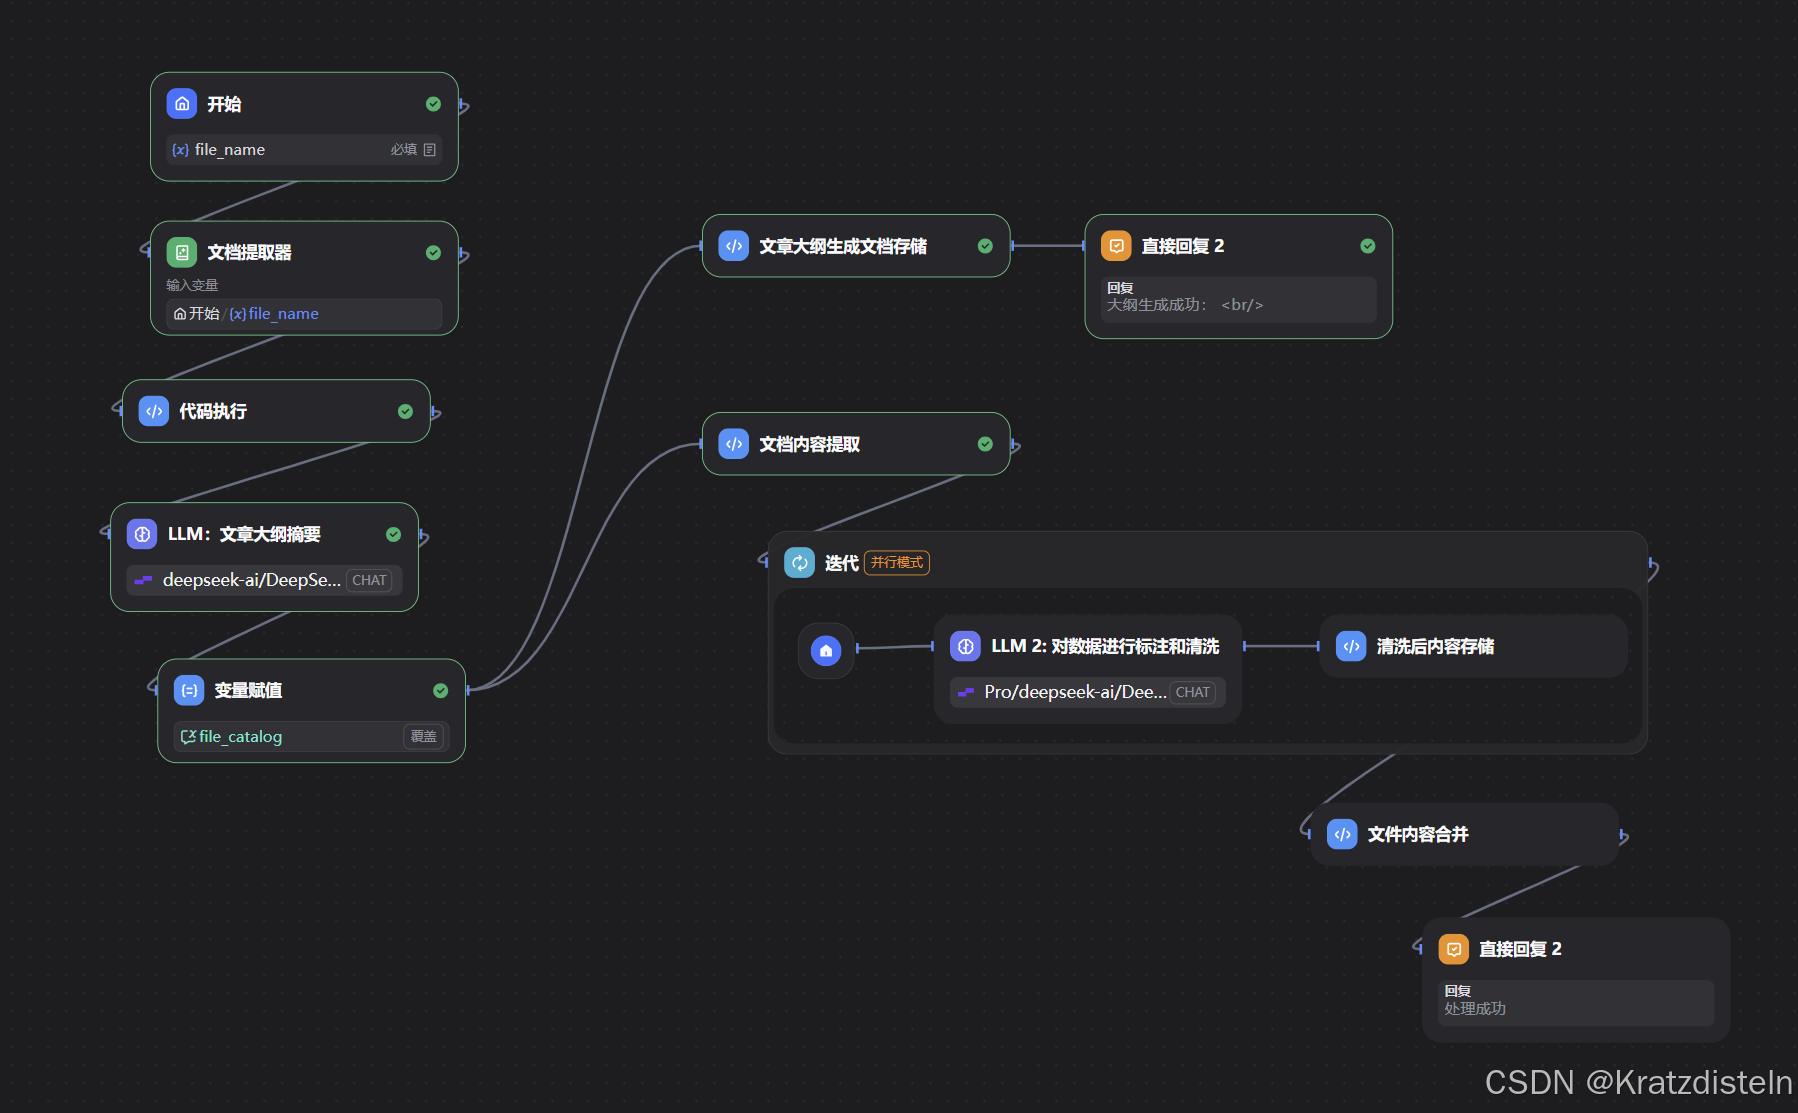
代码模块
1. 文档内容截取
def main(arg1: str) -> dict:
    return {
        "result": arg1[:20000],
    }
2. 大纲文档存储
import os
import re

def main(arg1: str) -> dict:
    try:
        file_path = os.path.join('/data/file', 'summary.md')
        directory = os.path.dirname(file_path)

        with open(file_path, 'w', encoding='utf-8') as f:
            f.write(re.sub(r'[/\\|:、]', '', arg1))

        return {
            "result": '文件生成成功',
        }
    except Exception as e:
        return {"result": str(e)}
3. 文档分块处理
def main(arg1: str,segment_length=3000,overlap=500) -> dict:
    total_length = len(arg1)
    segments = []
    start = 0
    while start < total_length:
        end = start + segment_length
        if end > total_length:
            end = total_length
        segment = arg1[start:end]
        segments.append(segment)
        start +=segment_length - overlap
        if start >= total_length:
            break
    return {
        "result": segments
    }
4. 清洗内容存储
import os
import re
def main(arg1: str, index) -> dict:
    try:
        file_path = os.path.join('/data/file', f'part{index}.md')
        directory = os.path.dirname(file_path)

        with open(file_path,'w',encoding='utf-8') as f:
            f.write(re.sub(r'[/\\|:、]','',arg1))
        return {
            "result": '文件生成成功',
        }
    except Exception as e:
        return {"result": str(e)}
5. 文件内容合并
import os
import re
import json
from pathlib import Path

def main() -> dict:
    """处理文件夹中的所有part*.md文件,合并内容并添加标记"""
    try:
        folder = Path('/data/file')
        output_file = folder / 'context_for_all.txt'

        # 获取并按数字排序文件
        files = sorted(
            [f for f in folder.glob('part*.md') if f.is_file()],
            key=lambda x: int(re.search(r'\d+', x.name).group())
        )

        with output_file.open('w', encoding='utf-8') as f_out:
            for file in files:
                with file.open(encoding='utf-8') as f_in:
                    content = f_in.read()

                    # 使用正则表达式提取所有segment
                    segments = re.finditer(r'{\s*"segment_\d+"\s*{([^}]+)}', content)

                    for seg in segments:
                        segment_content = seg.group(1)

                        # 提取text部分
                        text_match = re.search(r'"text"\s*"([^"]+)"', segment_content)
                        if text_match:
                            f_out.write(text_match.group(1) + "###\n")

                        # 提取tags部分并处理
                        tags_match = re.search(r'"tags"\s*"([^"]+)"', segment_content)
                        if tags_match:
                            tags = [t.strip() for t in tags_match.group(1).split(',') if t.strip()]
                            f_out.write('###'.join(tags) + "###\n")  # 用###分割每个tag

                        f_out.write("&&&&\n")  # 分隔不同的segment

        return {"result": "文件处理完成"}

    except Exception as e:
        return {"result": f"处理失败: {str(e)}"}
提示词模块
1. 文章大纲摘要提示词
系统提示词:
你是一名专业的文档分析师,擅长从技术文档/论文中提取结构化大纲。

你的任务是:
- 识别标题层级(H1-H6)
- 统计章节分布与内容概要
- 输出带缩进层级的摘要树

任务执行步骤:
1. 通读文档,标记所有标题(格式如#、##等);
2. 按缩进层级构建大纲树(H为一级,H2为二级,以此类推)
3. 为每个章节生成1-2句内容摘要;
4. 输出Markdown格式的层级列表,包含标题和摘要。

例如
输出格式:
markdown
- [标题层级] 标题文本
  摘要: 本节核心内容(100字以内)

示例输入:
# 引言
## 研究背景
### 行业现状
## 研究方法

示例输出:
- [H1]引言
  摘要:阐述研究背景与方法论
  -[H2] 研究背景
    摘要:分析行业现状与问题
     -[H3]行业现状
      摘要:描述当前市场数据
  -[H2] 研究方法
    摘要:说明实验设计与技术路线

注:基于原文来设计,不允许补充内容,不允许扩写内容/
用户提示词:
需要处理的文档内容为:

{{#context#}}
2. 数据清洗与标注提示词
系统提示词:
你是一个专业数据清洗及标注工程师;
请先阅读并理解本文档的全部大纲,
<文本大纲>为:{{#conversation.file_catalog#}}
再按照以下规则处理文本,
<文本内容>为: {{#context#}}

一、数据清洗:
1. 提取结构化正文
2. 过滤噪声内容,移除页眉/页脚、广告、版权声明、乱码、空白行、无效数据行、重复段落、html标签(比如<br>、段落序号数字(1,2,3...)
3. 自动合并碎片化段落(<80字符且无标点)
4. 识别并标记专业术语
5. 如果文本内容为没有任何含义的符号和html标签,这段内容直接清除不需要输出

二、数据标注:
1. 动态分段机制
  - 基础段长: 200~250字节,允许学术类扩展至450字节
  - 对话类强制分段规则:每3论对话必须拆分段落
  - 保留逻辑标记符:如"首先/其次/最后"等序列次需要在通一段落

2.  标签tags构成

标题: 标题1/标题2/标题3/标题4/标题5/等(从大纲和本段文字前1000字内搜索,获取分段标题)

关键词: 关键词1/关键词2/关键词3/关键词4/关键词5/关键词6/关键词7/关键词8/关键词9/关键词10/专业术语等(从文段获取10个以上关键词与元数据,同时要加上识别到的专业术语)

3. 特殊处理
冲突解决机制
   - 当相邻段落标签重复率>60%,触发智能合并
   - 语义断裂检测:使用<gap>标记逻辑跳跃点

4. 示例:
输入段落:
"除非谷歌和 OpenAI 改变态度,选择和开源社区合作,否则将被后者替代",据彭博 和 SemiAnalysis 报道,4 月初,谷歌工程师 Luke Sernau 发文称,在人工智能大语言模 型(Large Language Models,LLM,以下简称"大模型")赛道,谷歌和 ChatGPT 的推 出方 OpenAI 都没有护城河,开源社区正在赢得竞赛。
这一论调让公众对"年初 Meta 开源大模型 LLaMA 后,大模型大量出现"现象的关注推 向了高潮,资本市场也在关注大公司闭源超大模型和开源大模型谁能赢得竞争,在"模 型""算力""数据"三大关键要素中,大模型未来竞争格局如何,模型小了是否就不再 需要大量算力,数据在其中又扮演了什么角色?……本报告试图剖析这波开源大模型风 潮的共同点,回顾开源标杆 Linux 的发展史,回答以上问题,展望大模型的未来。

期望输出下面这样格式的内容:
{
   "segment_01":{
       "text": "谷歌工程师Luke Sernau认为,谷歌和OpenAI在AI大模型领域缺乏护城河,开源社区(如Meta的LLaMA)正逐渐占据优势。这一观点引发了对闭源与开源模型竞争格局的讨论,涉及模型、算力、数据三大要素的未来影响。报告通过分析开源大模型风潮的共同点,并类比Linux的发展历史,探讨了开源模式是否将主导AI领域,以及小模型、算力需求和数据角色的演变趋势。",
        "tags": ["开源大模型","AI竞争","MetaLLaMA,"闭源VS开源"]
    }
}

注意:
1. text是原文部分,不允许修改和扩展,直接使用格式清洗之后的原文内容
2. 标签tags里面要列出所有的标题,识别内容后,标题参考<文本大纲>, 生成时,不需要带上层级序号
3. 如果是有条文类的文档,比如规则、法律类等文档,tags里面需要标明是第几章,第几条
4. tags除了上述外,还要再从文段获取10个左右关键词
5. tags内容放在一行,关键词用英文双引号""包围,用应为逗号分割即可
用户提示词:
最终输出上下文中全部的有效内容,并确保tags行的关键词用英文双引号""包围,用应为逗号分割,不包含其他符号。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)