AI知识自动化:程序员必学的Obsidian+n8n集成教程,建议收藏学习!
前言
你是否有这样的体验?
Obsidian 知识库里积累了大量笔记,也装了不少自动化插件。但当你想要实现一些特定的自动化需求时——比如定时抓取某个专栏的文章,或者把会议纪要自动分类整理。总会发现现有插件要么功能不够灵活,要么根本找不到合适的。
虽然某些工具能帮你导入内容,但它们都是固定的流程。如果你想要完全自定义的自动化方案呢?
想象一下这样的场景:
- 每天早上自动生成包含今日天气、待办事项的日记模板
- 小报童专栏更新后,自动抓取并按你的格式整理成笔记
- 重要邮件自动转存,并根据关键词分类到不同文件夹
这些都不是现成插件能做到的。
但是,通过 n8n 配合 Obsidian 的 Local REST API 插件,我们可以把 Obsidian 变成一个可以被任意程序操作的智能工作台,实现完全自定义的自动化流程。
今天这篇文章,我将带你从零开始,一步步实现:
- a.搭建 Obsidian 与 n8n 的连接通道
- b.验证可行性:读取和创建笔记
- c.实战案例:自动抓取小报童并写入知识库
一、第一步:安装 Local REST API 插件
一)什么是 Local REST API?
Local REST API 是 Obsidian 社区中的一个强大插件,它的核心作用是:对外暴露 HTTP 接口,让外部程序可以通过标准的 REST API 来操作你的知识库。
简单来说,它就像是在 Obsidian 和外部世界之间架起了一座桥梁。
二)安装步骤
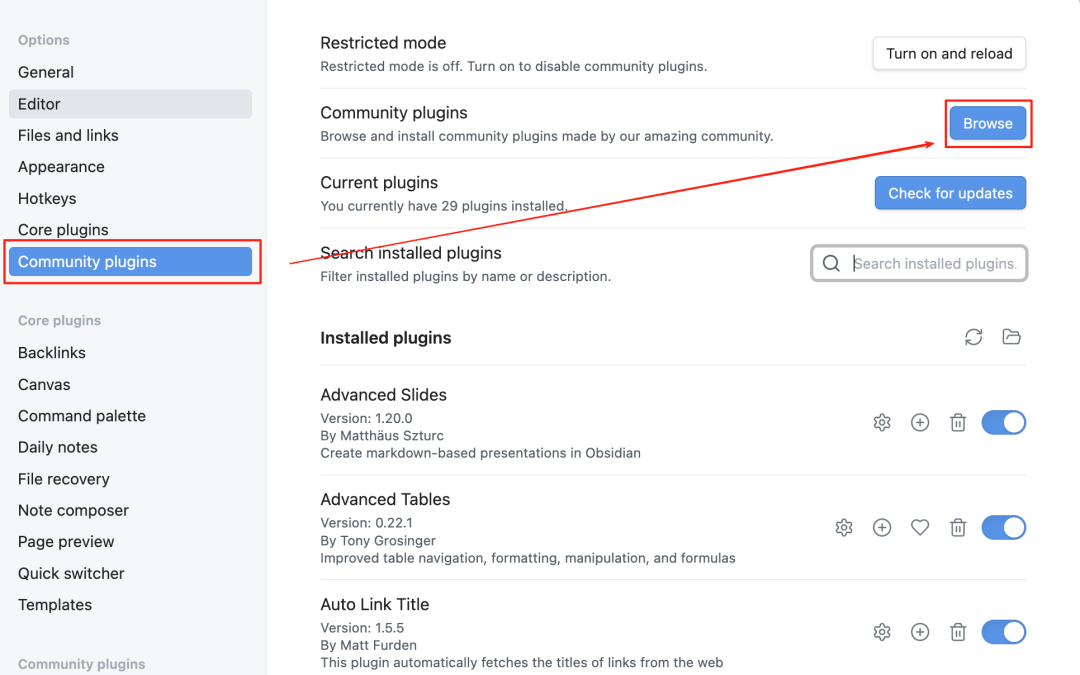
1、打开 Obsidian 设置 → 社区插件 → 浏览
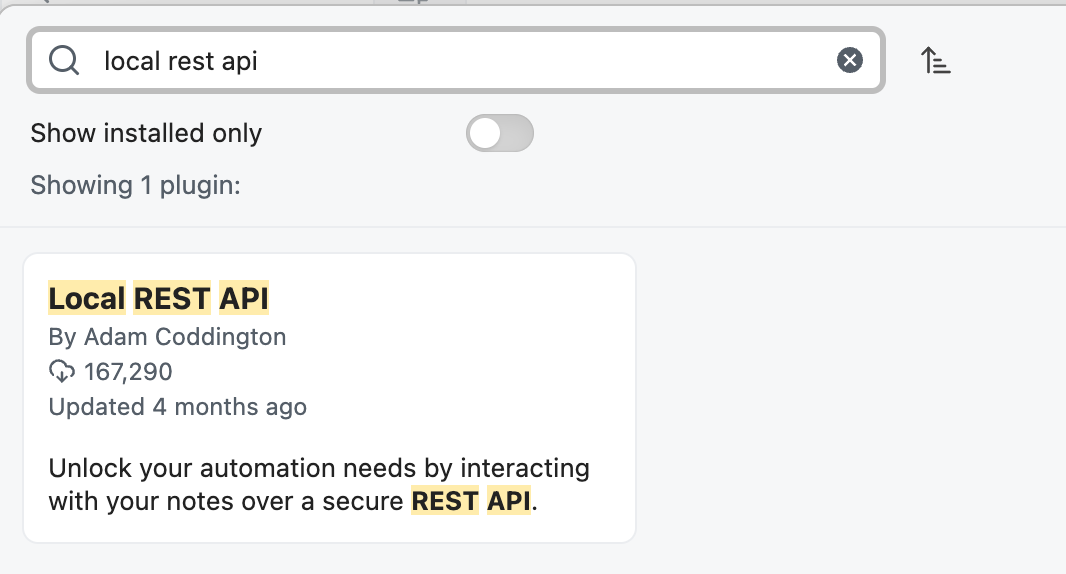
2、搜索Local REST API
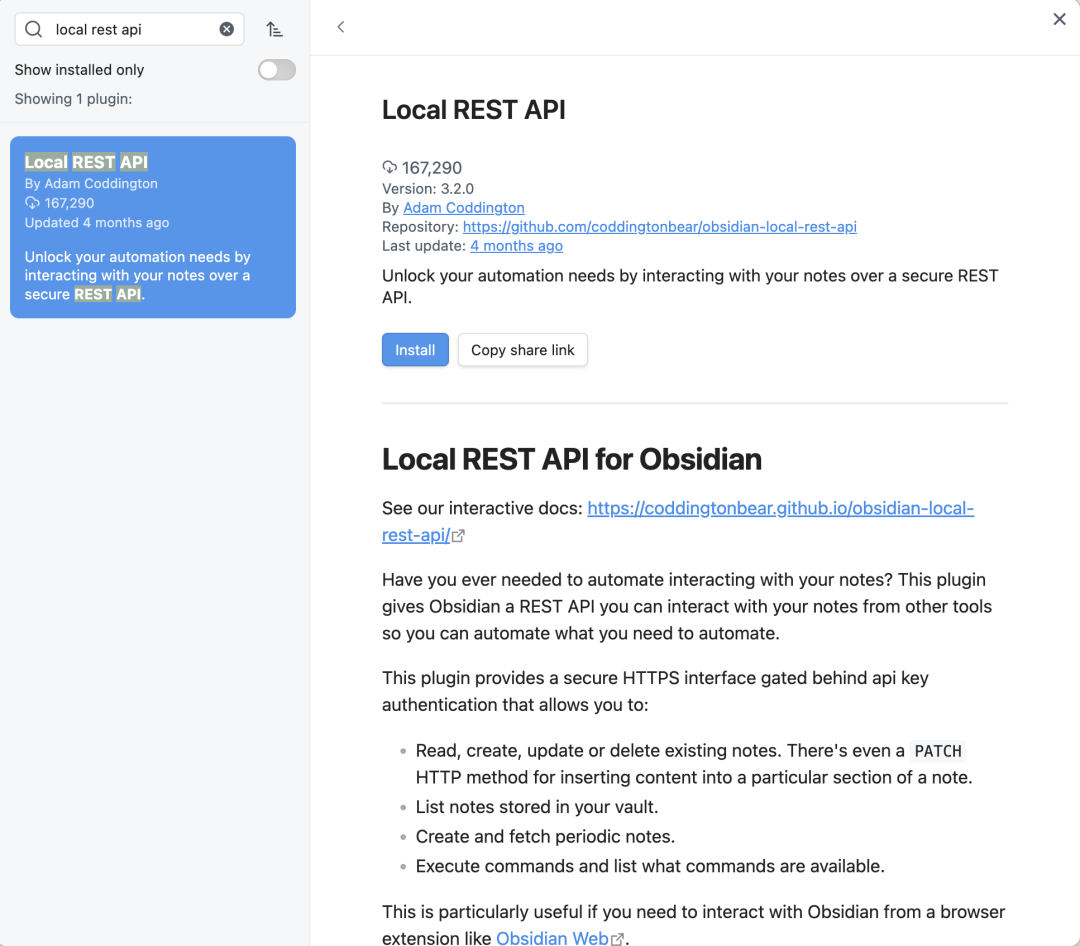
3、点击安装插件
三)配置插件
安装完成后,我们需要进行一些关键配置
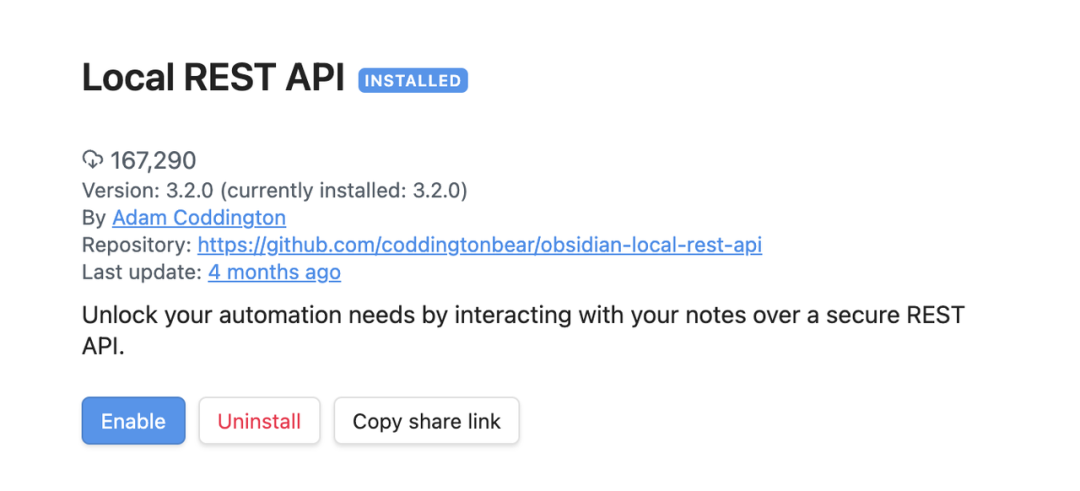
1、启用插件
点击 Enable 按钮
2、打开插件选项
点击 Options 进入设置页面
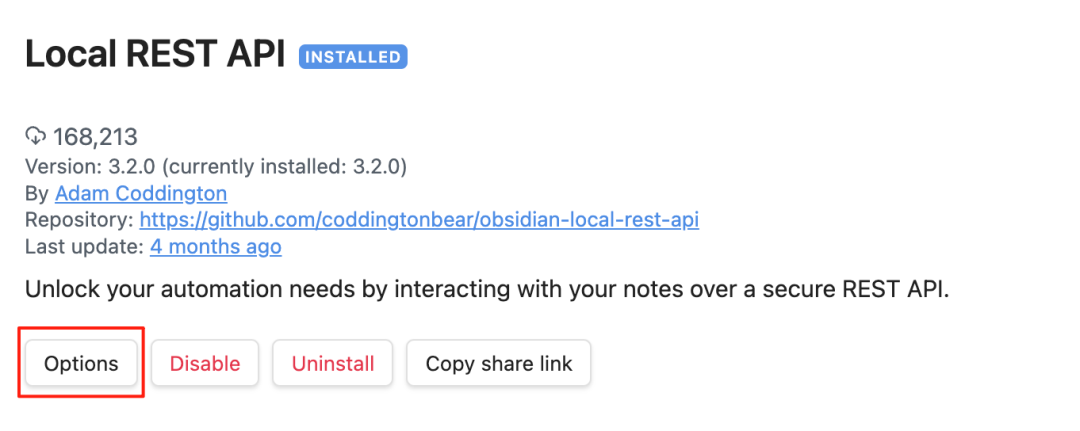
3、启用 HTTP 服务器
找到 Enable Non-encrypted(HTTP) Server 选项并打开
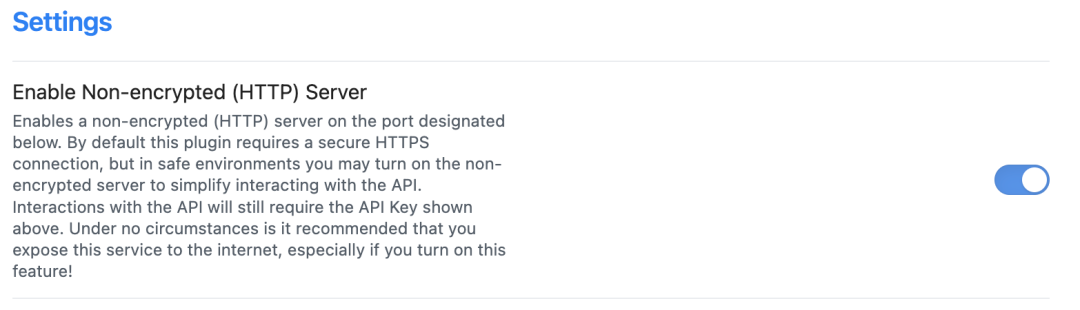
📌
重要信息记录:
- API Key: 在设置页面顶部,复制你的 API Key(后续会用到)
- API Endpoint: 默认地址是 http://127.0.0.1:27123/
⚠️ 安全提示: Local REST API 只监听本地回环地址(127.0.0.1),这意味着只有你本机的程序才能访问,外部网络无法直接访问你的知识库,相对安全。
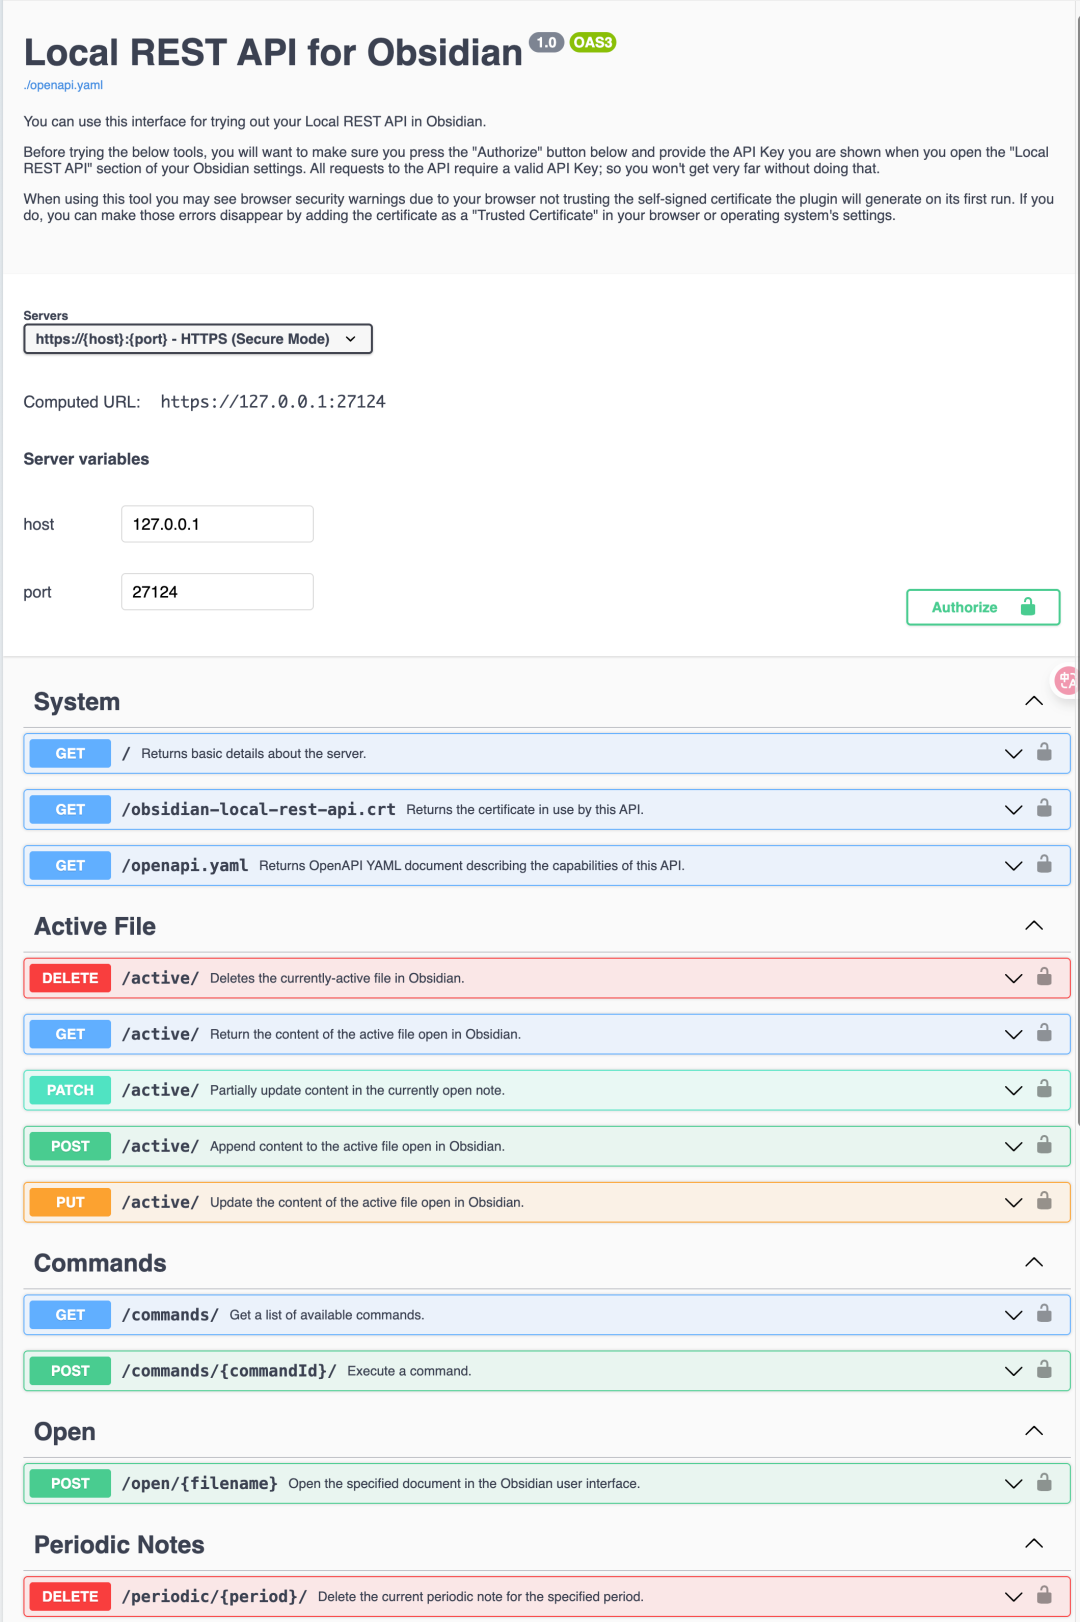
四)API 能力一览
安装完成后,你可以访问官方文档查看完整的 API 列表: 👉 https://coddingtonbear.github.io/obsidian-local-rest-api/
这个插件支持的操作包括但不限于:
- 📖 读取笔记内容
- ✍️ 创建新笔记
- 🔄 更新现有笔记
- 🗑️ 删除笔记
- 📁 管理文件夹
- 🔍 搜索笔记
二、第二步:在 n8n 中建立连接
一)创建 Bearer Token 凭证
在 n8n 中使用 Obsidian API 之前,我们需要先配置认证凭证。
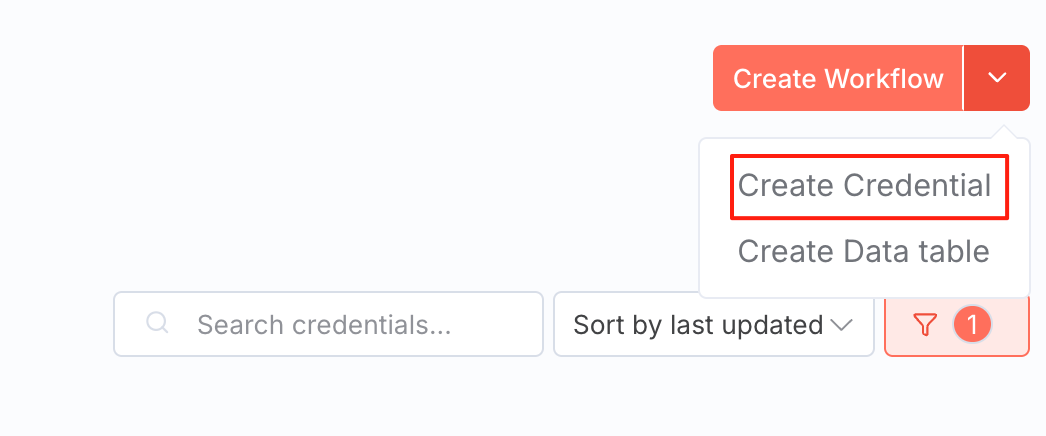
1、在 n8n 界面中,点击右上角 CreateCredential
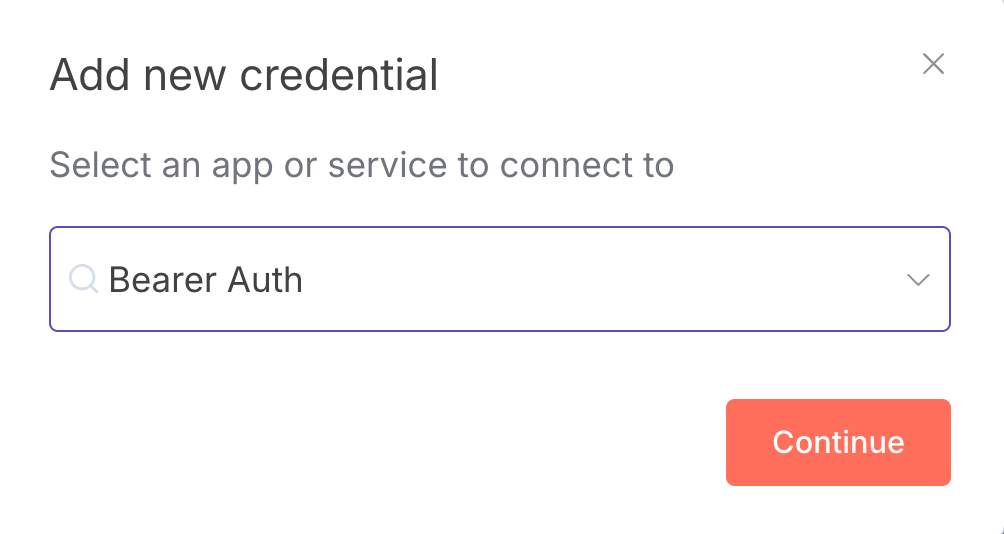
2、创建新凭证,选择 Bearer Auth
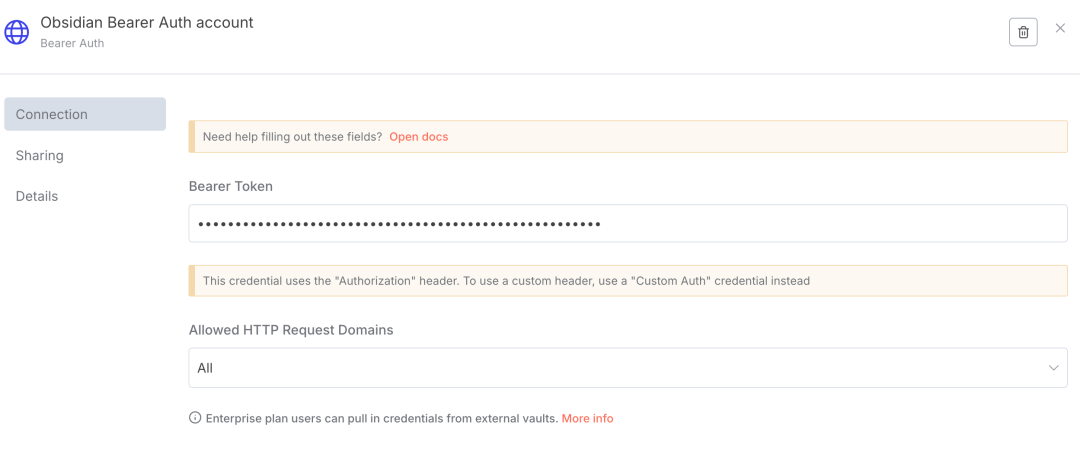
3、配置参数
Bearer Token: YOUR_API_KEY(替换为你从 Obsidian 复制的 API Key)
二)测试连接:读取知识库列表
现在让我们创建第一个节点来验证连接:
1、创建 HTTP Request 节点
命名成“读取知识库列表”
2、配置参数:
Method: GET
URL: http://host.docker.internal:27123/vault/
Authentication: 选择刚才创建的 Obsidian API 凭证
💡
关于地址的说明:
- 如果 n8n 是通过 Docker 部署的,使用 host.docker.internal 代替 127.0.0.1
- 如果 n8n 是本地安装,直接使用 http://127.0.0.1:27123/
3、点击执行
点击右上角的 Execute step 按钮
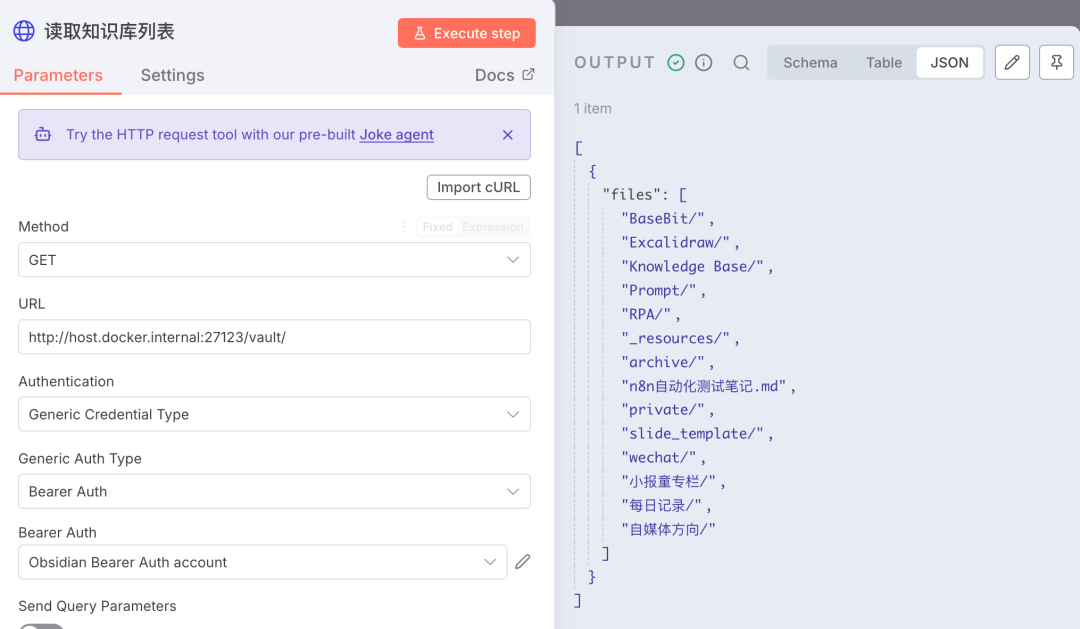
如果配置正确,你应该能看到返回的 JSON 数据,其中包含了你 Obsidian 知识库中所有笔记的列表信息!
恭喜!这意味着 n8n 已经成功连接到你的 Obsidian 知识库了!
三、第三步:创建你的第一篇自动笔记
读取成功只是开始,现在让我们尝试通过 n8n 自动创建一篇笔记。
一)配置创建笔记节点
在 n8n 中新建一个 HTTP Request 节点,这次我们要用它来写入内容。
请求方法选择 POST,URL 填写 http://host.docker.internal:27123/vault/n8n自动化测试笔记.md。
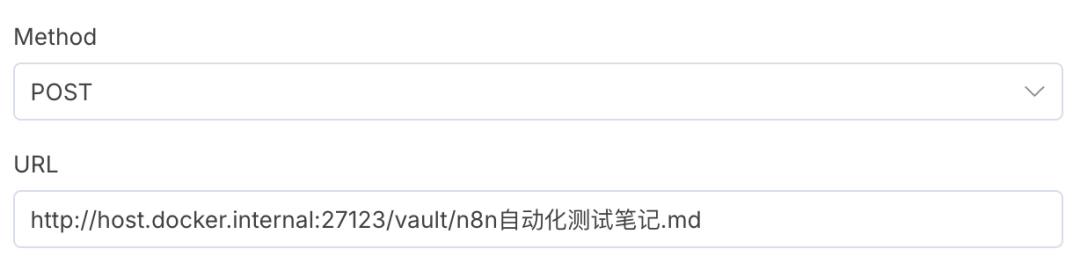
别忘了选择我们之前创建的 Obsidian API 认证凭证。
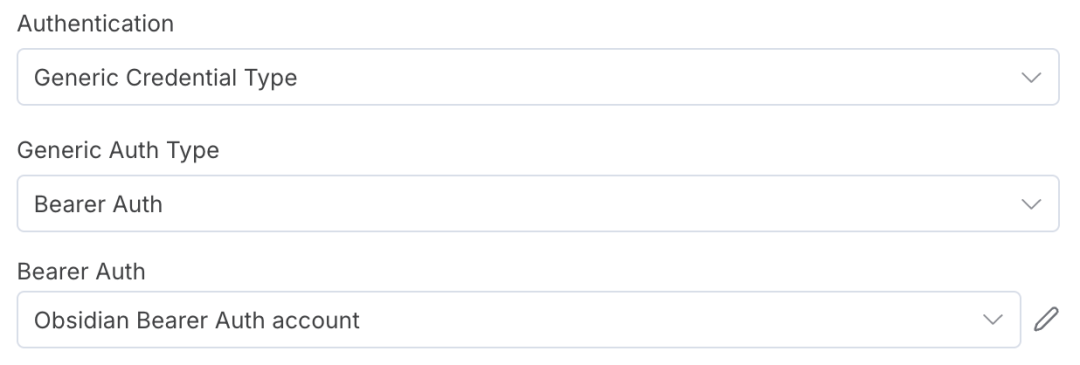
然后是 Body 配置。
打开 Send Body 开关,Body Content Type 选 Raw,Content Type 填 text/plain。
最关键的是 Body 内容,这里切换到表达式模式。
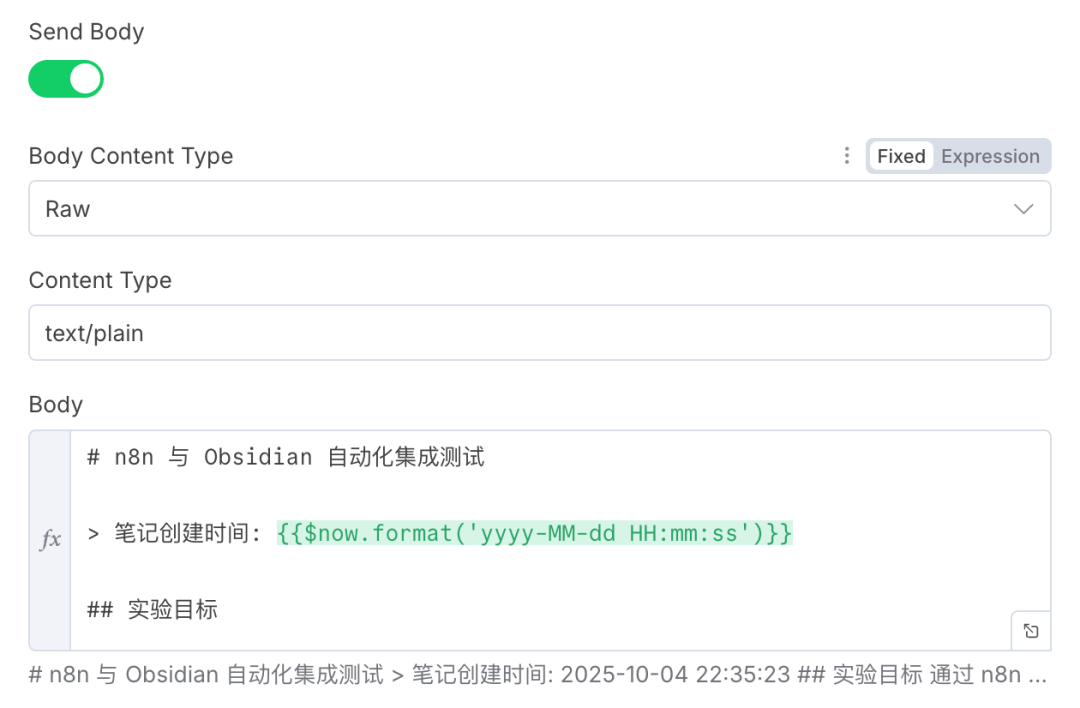
输入我们要创建的笔记内容:
# n8n 与 Obsidian 自动化集成测试> 笔记创建时间: {{$now.format('yyyy-MM-dd HH:mm:ss')}}## 实验目标通过 n8n 工作流验证 Local REST API 插件的写入能力,为后续构建自动化知识管理系统打下基础。## 待实现功能清单- [ ] 探索更多 Obsidian API 功能- [ ] 实现小报童文章自动抓取到 Obsidian- [ ] 测试批量笔记创建性能## 技术要点1.**认证方式**: Bearer Token2.**内容格式**: Markdown3.**编码设置**: UTF-84.**API 端点**: http://127.0.0.1:27123/## 后续规划接下来将测试更复杂的场景,包括文件夹管理、笔记更新、搜索功能等,最终目标是打造一个完整的自动化知识管理工作流。
配置完成后,点击右上角的 Execute step 执行这个节点。
二)验证结果
现在切换到 Obsidian,你会发现一篇名为 n8n自动化测试笔记.md 的新笔记已经出现在你的知识库中了!
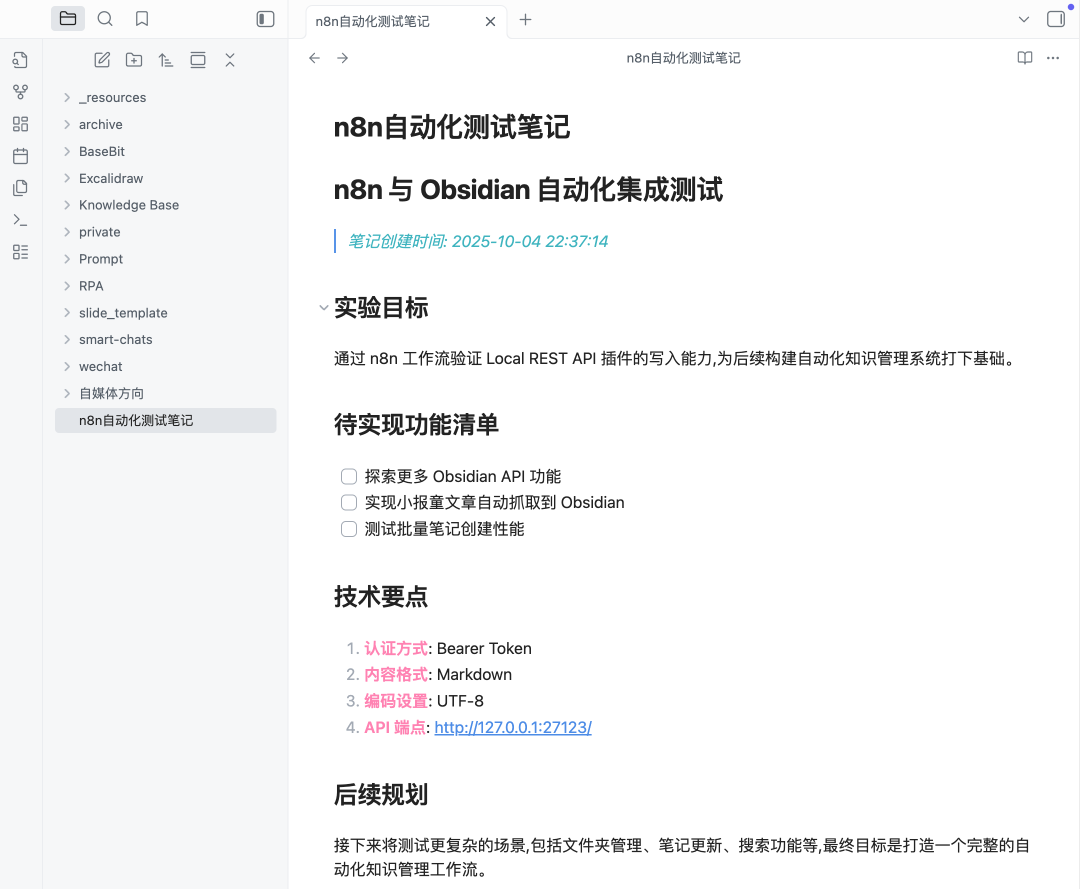
三)进阶:定时生成当日记录框架
掌握了手动创建笔记后,我们再进一步——让 n8n 每天早上自动为你生成当日的记录框架,甚至还能加上实时天气信息。
1、基础版:纯记录框架
如果你只需要一个简单的每日记录框架,配置很简单:
新建一个工作流,添加 Schedule Trigger 节点:
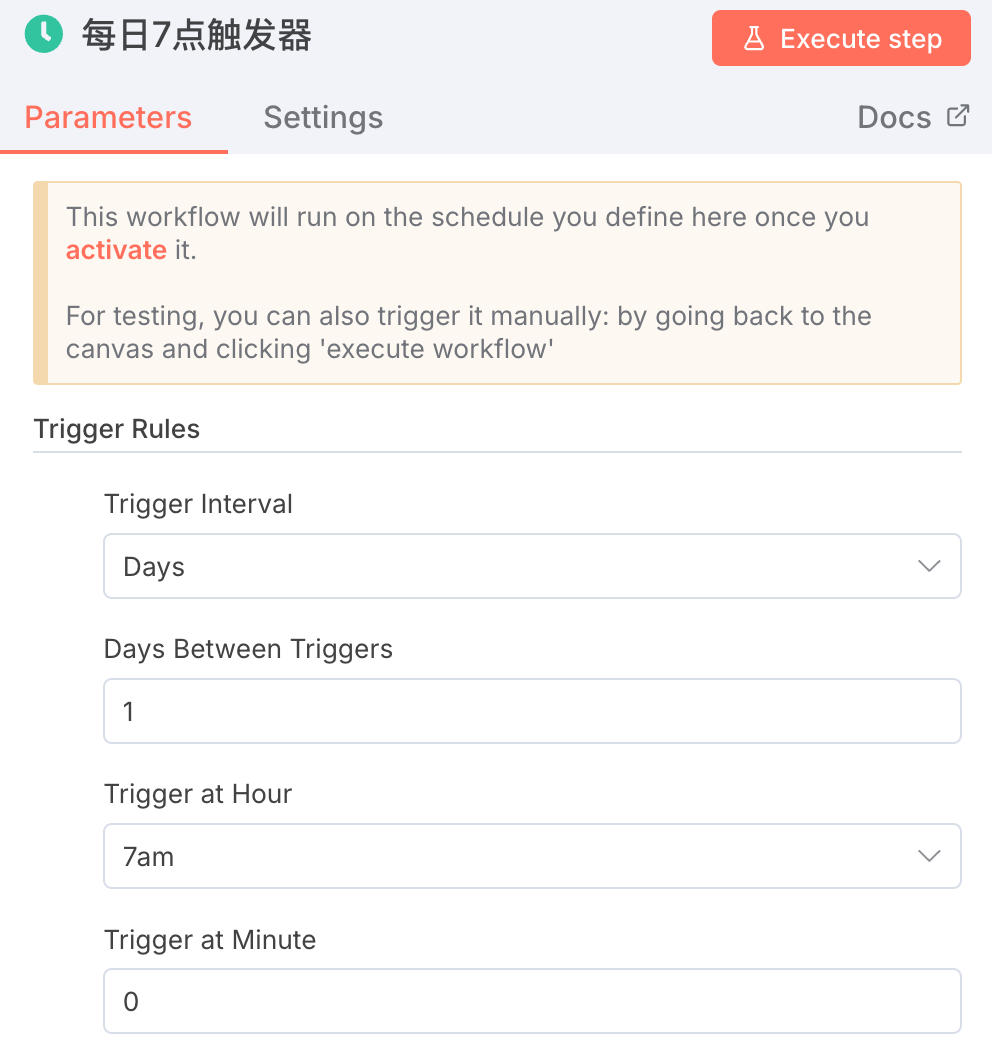
然后添加 HTTP Request 节点,这次 URL 需要动态生成日期:
http://host.docker.internal:27123/vault/每日记录/{{$now.format('yyyy')}}/{{$now.format('MM')}}/{{$now.format('yyyy-MM-dd')}} 每日记录.md
这样会自动按年份创建文件夹,比如 每日记录/2025/10/2025-10-05 每日记录.md。
Body 内容可以这样写:
---date: {{$now.format('yyyy-MM-dd')}}tags: - 每日记录created: {{ $now.format('yyyy-MM-dd hh:mm:ssa') }}---> 📅 {{$now.format('yyyy年MM月dd日 EEEE', 'zh-CN')}}## 🌅 今日计划- [ ] ## 📚 学习笔记## 💼 工作记录## 🌙 每日总结---**自动生成于 {{$now.format('HH:mm:ss')}}**
2、进阶版:加入天气信息
如果想让每日记录更智能,可以加入实时天气信息。这需要在工作流中增加几个节点:
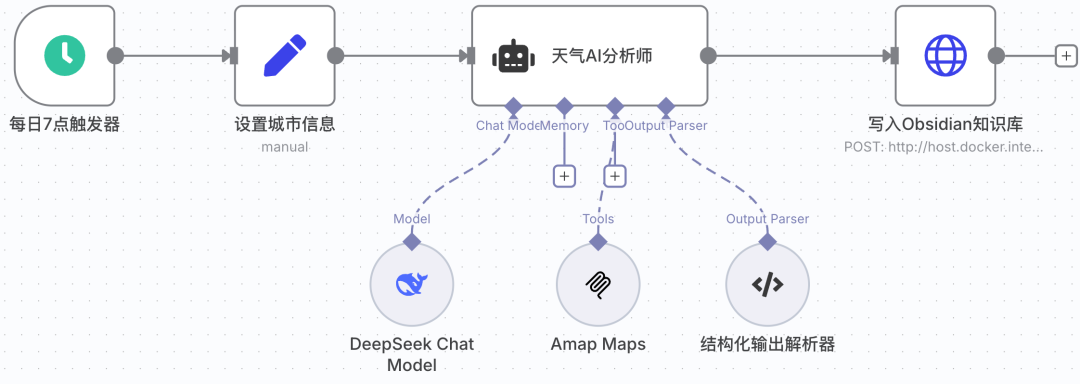
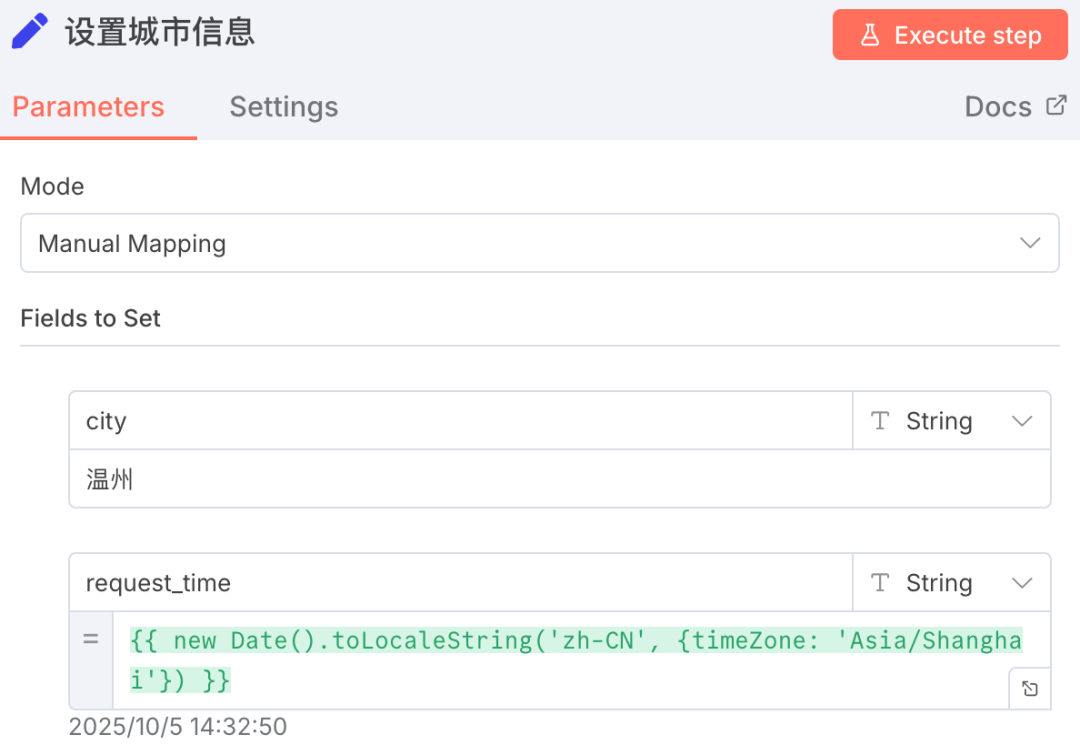
1) 在触发器后添加 Set 节点,设置你的城市
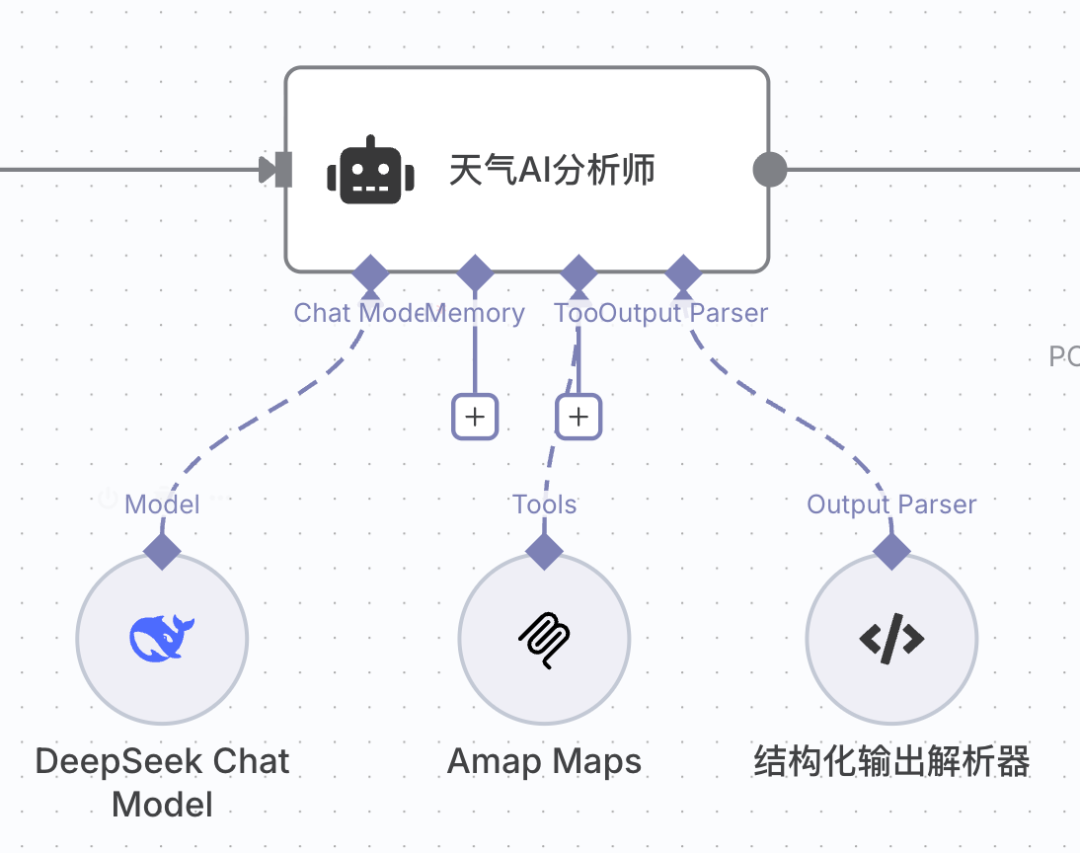
2) 添加 AI Agent 节点
连接以下子节点:
- DeepSeek Chat Model: 作为 AI 语言模型
- 高德地图 MCP: 作为天气数据源
- 结构化输出解析器: 格式化天气预报
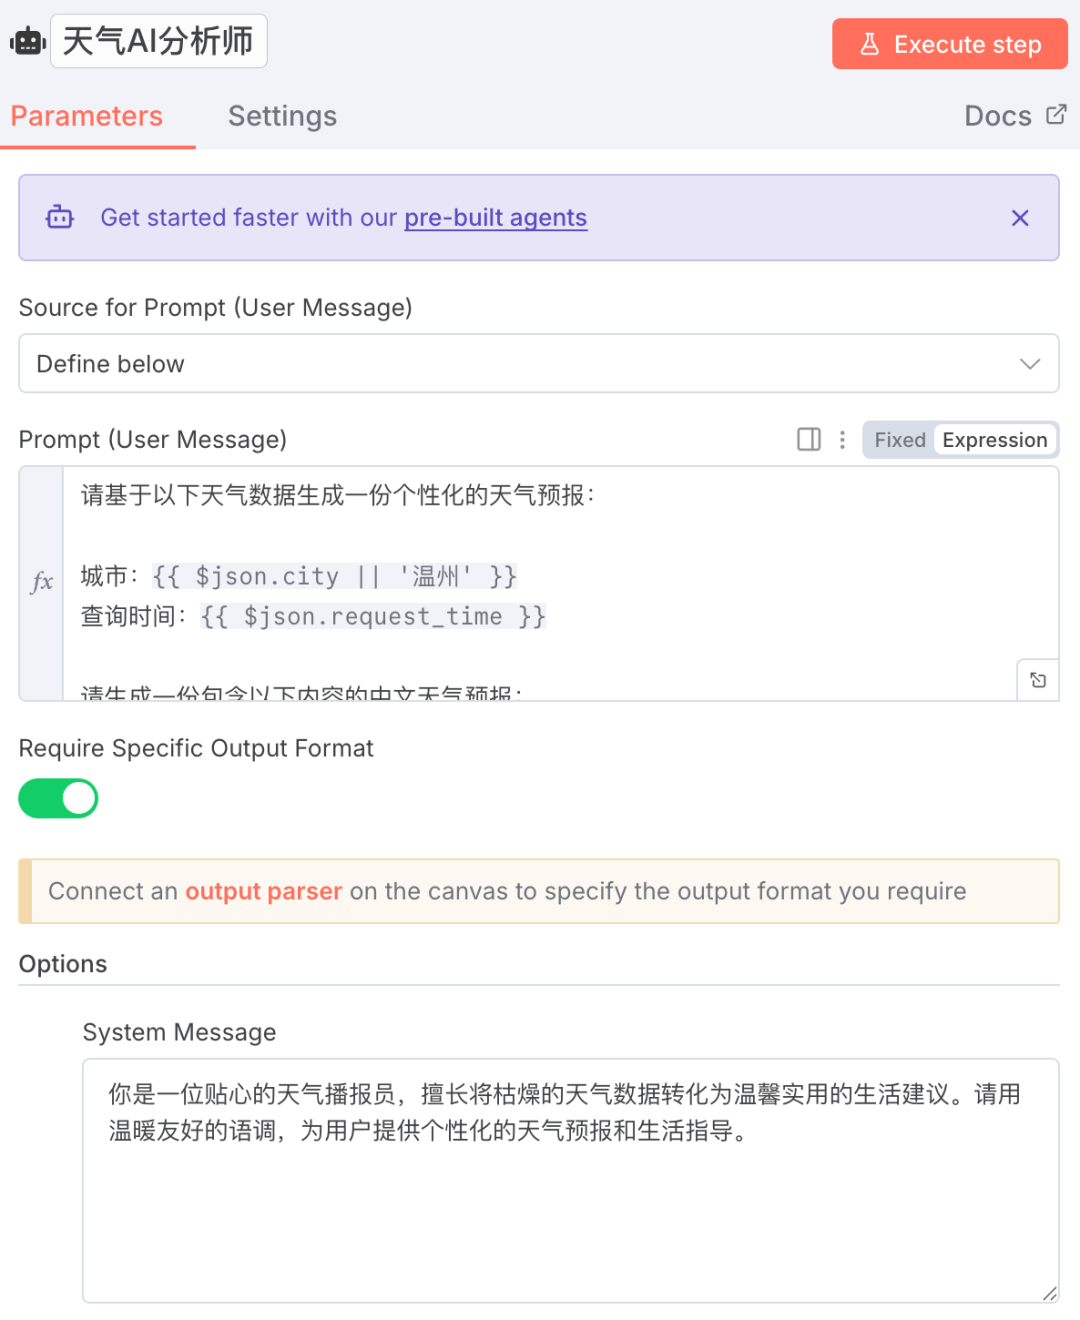
AI Agent 的 User Prompt 可以这样写:
请基于以下天气数据生成一份个性化的天气预报:城市:{{ $json.city || '温州' }}查询时间:{{ $json.request_time }}请生成一份包含以下内容的中文天气预报:1. 🌤️ 今日天气概况2. 🌡️ 温度和体感温度3. 👔 穿衣建议4. 🚗 出行提醒5. 💡 生活小贴士要求:- 语言生动友好,适合日常阅读- 包含实用的生活建议- 使用emoji增加可读性- 总长度控制在200-300字
System Prompt 可以这样写
你是一位贴心的天气播报员,擅长将枯燥的天气数据转化为温馨实用的生活建议。请用温暖友好的语调,为用户提供个性化的天气预报和生活指导。
3)最后在写入 Obsidian 的 Body 中引用天气数据:
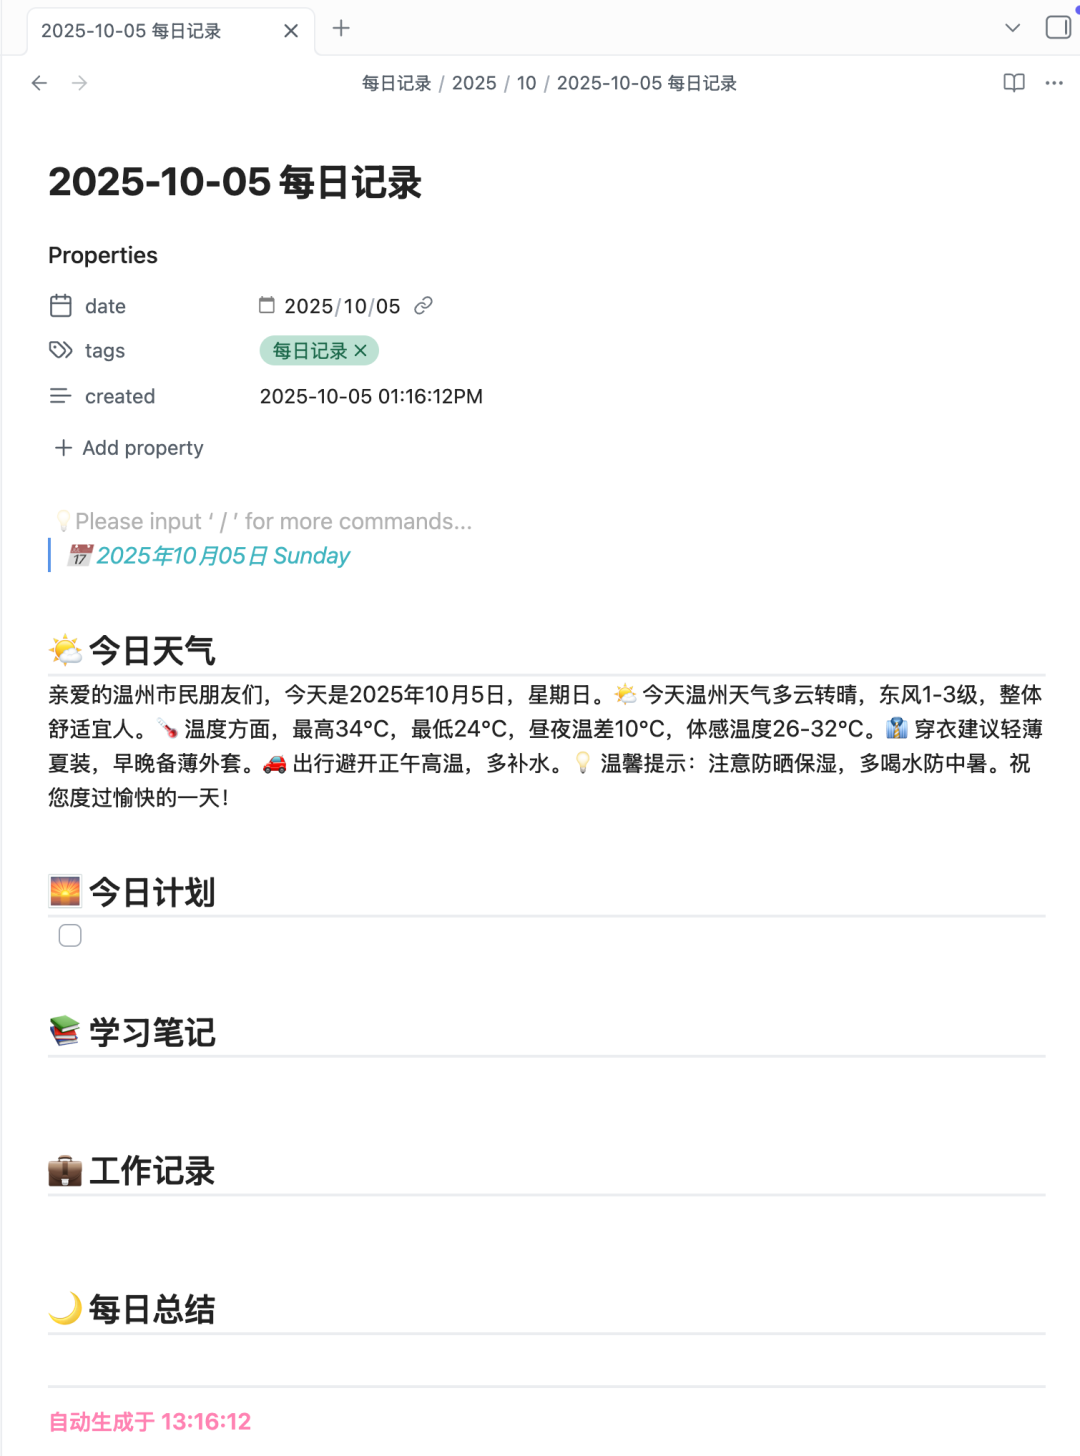
---date: {{$now.format('yyyy-MM-dd')}}tags:-每日记录created: {{ $now.format('yyyy-MM-ddhh:mm:ssa') }}--->📅 {{$now.format('yyyy年MM月dd日EEEE', 'zh-CN')}}## 🌤️ 今日天气{{ $json.output.formatted_report }}## 🌅 今日计划- [ ] ## 📚 学习笔记## 💼 工作记录## 🌙 每日总结---**自动生成于 {{$now.format('HH:mm:ss')}}**
配置完成后,点击工作流右上角的 Active 开关激活它。从此每天早上 7 点,Obsidian 就会自动出现一篇已填好日期、天气和基础结构的当日记录框架,你只需要往里面填写内容即可。
你也可以根据自己的习惯继续扩展,比如加上健康打卡、习惯追踪、今日金句等模块。关键是掌握了这套方法后,任何信息都能自动集成进来。
这就是自动化的魅力 — 你可以让 n8n 在任何时间、基于任何触发条件、从任何数据源自动创建笔记!
四、实战案例:自动采集小报童文章到知识库
前面我们已经验证了 n8n 可以成功读取和创建 Obsidian 笔记。现在让我们来做一个真正实用的自动化工作流:将小报童专栏的文章自动抓取并保存到知识库中。
一)工作流设计思路
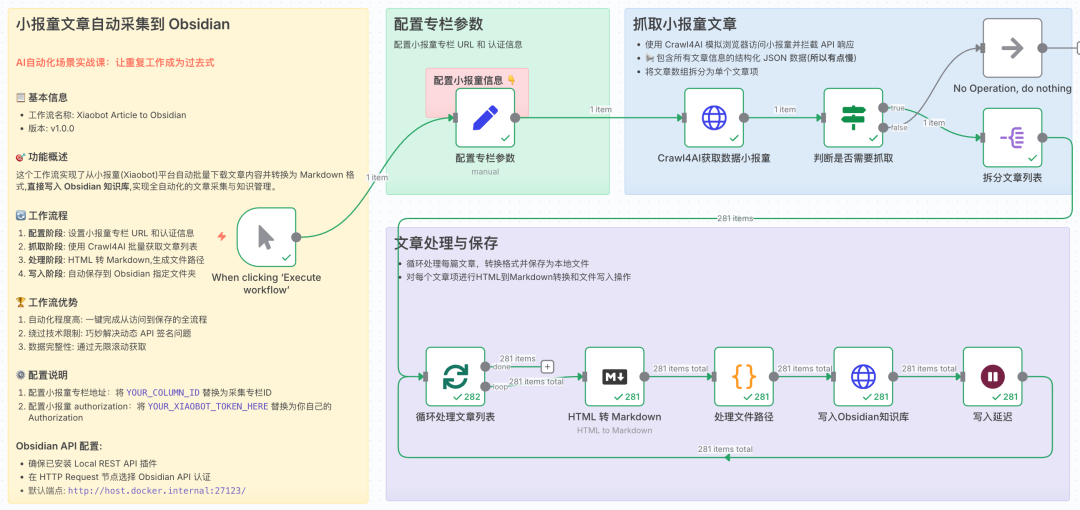
这次我们要做的是: 在原有工作流的基础上,将抓取到的文章直接写入 Obsidian,而不是保存到本地文件。
💡
整个流程可以分为三个部分:
- a.配置与抓取(绿色区域):配置小报童专栏参数,使用 Crawl4AI 批量抓取文章
- b.文章处理(蓝色区域):拆分文章列表,判断是否需要抓取
- c.写入 Obsidian(紫色区域):将 HTML 转换为 Markdown,直接保存到知识库
二)改造原有工作流
如果你已经有了小报童文章抓取的工作流,现在只需要做一个简单的改造: 把原来"保存到本地文件"的部分,替换成"写入 Obsidian"。
关键节点是"HTML 转 Markdown"之后。在这个节点后面,我们需要添加新的逻辑来对接 Obsidian API。
三)处理文件信息节点
在 HTML 转 Markdown 节点之后,添加一个 Code 节点来处理文件信息。这个节点的作用是构建符合 Obsidian 的文件路径和文件名。
// 获取文章标题和内容let title = $input.first().json.title;// 处理 title 为 null 或 undefined 的情况if (!title) {const articleId = $input.first().json.id; title = articleId ? `文章_${articleId}` : `未命名文章_${Date.now()}`;}// 清理标题中的非法字符const safeTitle = title.replace(/[\/\\?%*:|"<>]/g, '_');const markdown = $input.first().json.data;// 从 target_url 提取专栏标识符functionextractColumnId(targetUrl) {const match = targetUrl.match(/\/p\/([^\/]+)\/?$/);return match ? match[1] : 'unknown';}// 获取专栏标识符const targetUrl = $('配置专栏参数').first().json.target_url;const outputBasePath = $('配置专栏参数').first().json.output_base_path;const columnId = extractColumnId(targetUrl);// 构建文件路径(可以根据需要调整文件夹结构)const filePath = `${outputBasePath}/${columnId}/${safeTitle}.md`;return {json: { title: safeTitle, markdown: markdown, filePath: filePath }};
这段代码做了三件事:
- 获取文章标题和 Markdown 内容
- 清理标题中的特殊字符,生成安全的文件名
- 构建完整的文件路径(这里我把文章统一保存到 小报童专栏 文件夹下)
四)写入 Obsidian 节点
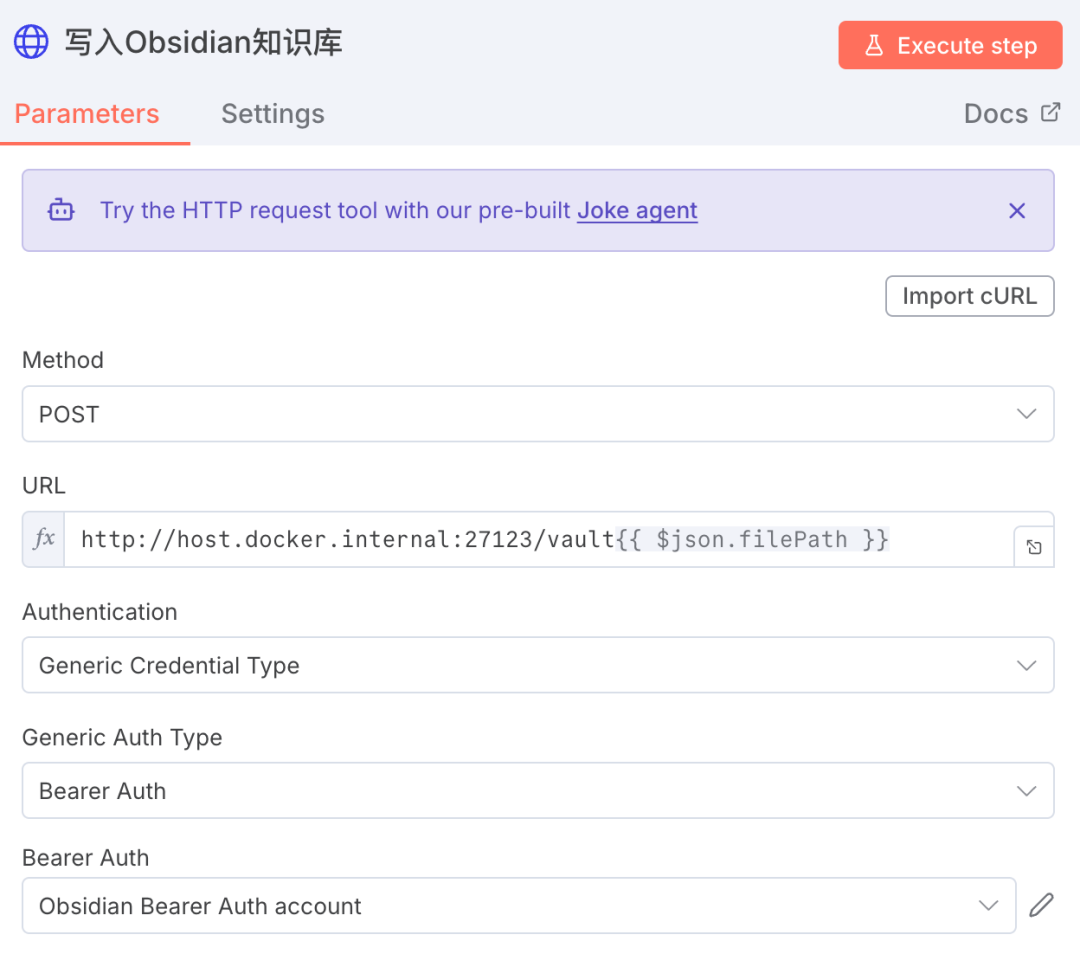
最后一步,添加 HTTP Request 节点将内容写入 Obsidian。
请求方法选择 POST,URL 这里要用表达式: http://host.docker.internal:27123/vault/{{$json.filePath}},这样可以动态使用前面节点生成的文件路径。
Body 配置也很简单。
打开 Send Body 开关,Body Content Type 选 Raw,Content Type 填 text/plain。Body 内容用表达式 {{$json.markdown}},这样就能读取前面节点处理好的 Markdown 内容了。
配置完成后,整个工作流就搭建完毕了。
五)执行与验证
一切配置完成后,点击 Execute Workflow 按钮运行整个工作流。
工作流会自动完成以下操作:
- a.从 Crawl4AI 获取小报童专栏的文章列表
- b.循环处理每一篇文章
- c.将 HTML 转换为 Markdown 格式
- d.自动写入到 Obsidian 的 小报童专栏 文件夹
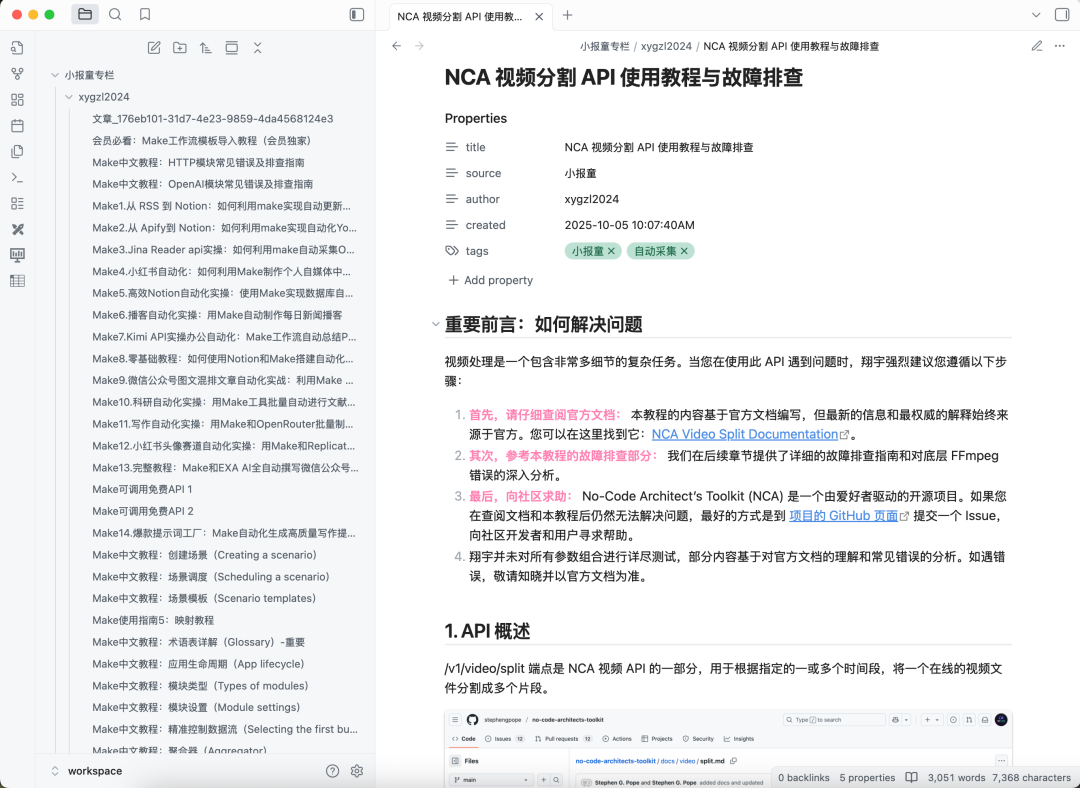
几秒钟后,切换到 Obsidian,你会发现 小报童专栏 文件夹中已经出现了所有抓取的文章!
每篇文章都是标准的 Markdown 格式,可以直接阅读、编辑,也能享受 Obsidian 的双向链接、标签等强大功能。
六)进阶优化建议
完成基础流程后,你还可以继续优化:
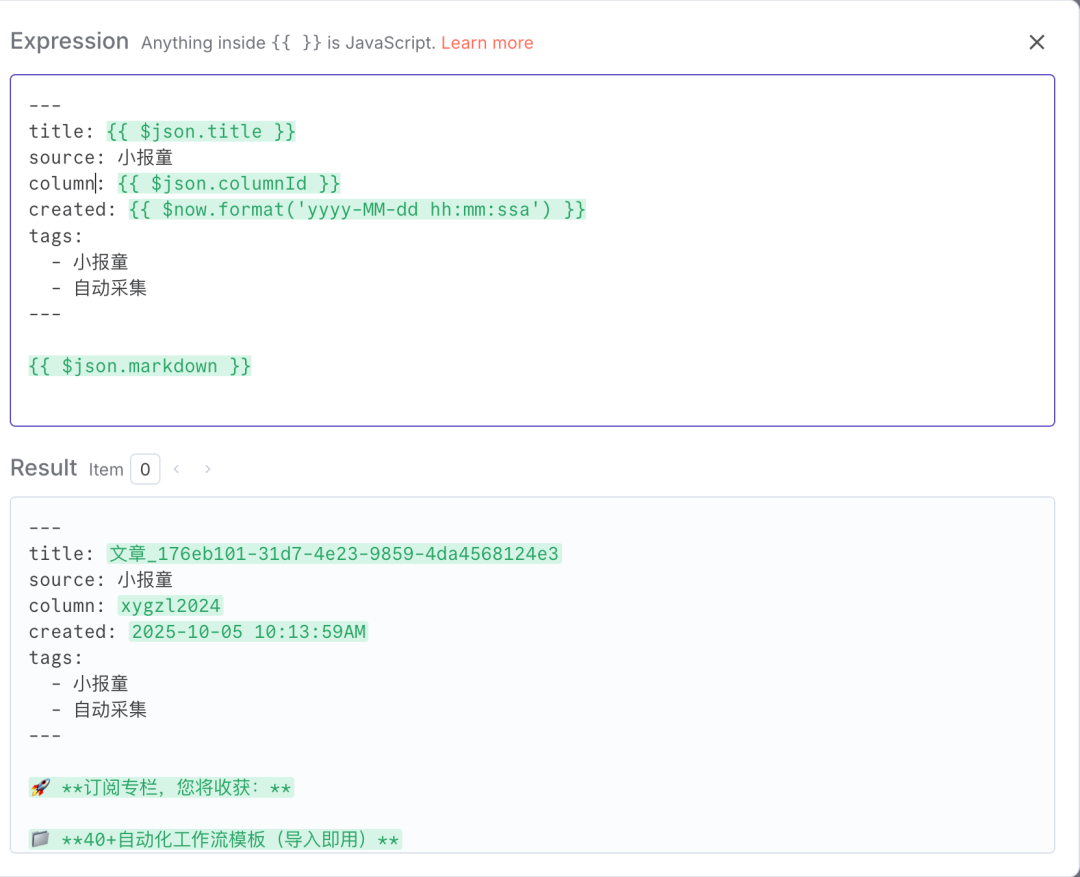
1、添加文章元数据
在写入 Obsidian 前,可以为每篇文章添加 YAML Front Matter:
---title: {{文章标题}}source: 小报童column: {{专栏名称}}created: {{抓取时间}}tags: - 小报童 - 自动采集---{{文章内容}}
2、避免重复抓取
在写入前,先用 GET 请求检查文件是否已存在:
GET http://host.docker.internal:27123/vault/{{$json.filePath}}
如果返回 404,说明文件不存在,可以创建;如果返回 200,说明已存在,可以跳过或更新。
3、定时自动执行
在工作流开头添加 Schedule Trigger 节点,设置每天自动执行一次,实现完全自动化的文章采集。
五、写在最后
从安装插件到验证连接,再到实现小报童文章的自动采集,我们用 n8n 让 Obsidian 真正"活"了起来。
回头看整个过程,其实核心就做了三件事:
-
用 Local REST API 插件打开了 Obsidian 的大门
-
在 n8n 中配置好认证,建立起连接通道
-
改造现有工作流,把数据写入知识库而不是本地文件
但更重要的是思路。一旦理解了这套玩法,你就能把 Obsidian 连接到任何数据源:
- 每天早上自动生成日记模板和待办清单
- RSS 订阅的文章自动整理归档
- 会议纪要通过 API 直接入库
- 重要邮件一键转存为笔记
- 数据库定期导出生成报告
小报童只是一个例子。微信公众号、知乎专栏、Medium、甚至是你自己的数据库,只要能拿到数据,就能自动写入 Obsidian。
掌握了这套方法后,你可以根据自己的需求组合出无数种可能性。你的知识库不再是一个需要手动维护的仓库,而是一个会自动生长的知识系统。
最后
为什么要学AI大模型
当下,⼈⼯智能市场迎来了爆发期,并逐渐进⼊以⼈⼯通⽤智能(AGI)为主导的新时代。企业纷纷官宣“ AI+ ”战略,为新兴技术⼈才创造丰富的就业机会,⼈才缺⼝将达 400 万!
DeepSeek问世以来,生成式AI和大模型技术爆发式增长,让很多岗位重新成了炙手可热的新星,岗位薪资远超很多后端岗位,在程序员中稳居前列。
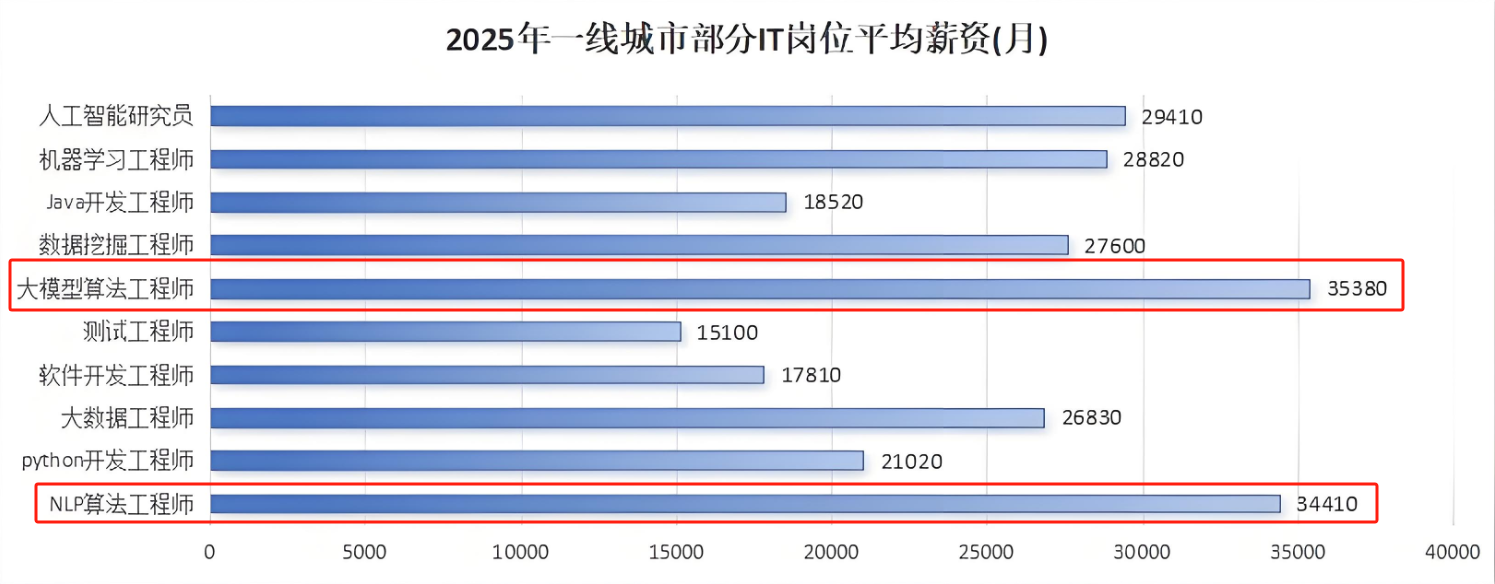
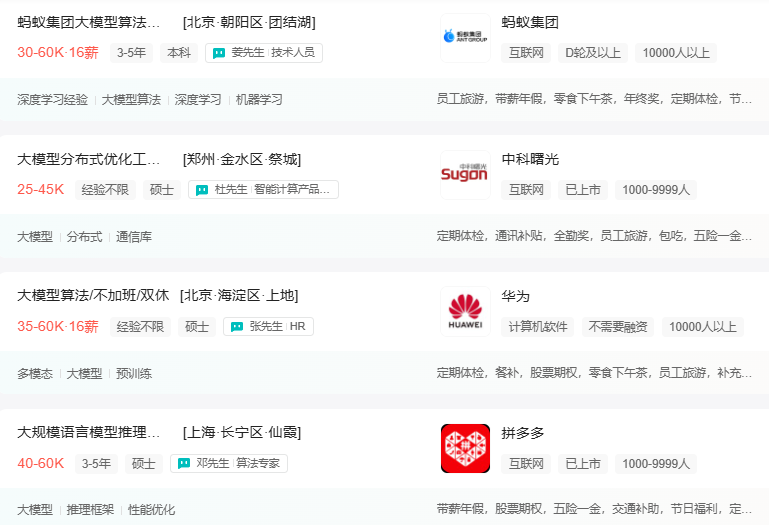
与此同时AI与各行各业深度融合,飞速发展,成为炙手可热的新风口,企业非常需要了解AI、懂AI、会用AI的员工,纷纷开出高薪招聘AI大模型相关岗位。
最近很多程序员朋友都已经学习或者准备学习 AI 大模型,后台也经常会有小伙伴咨询学习路线和学习资料,我特别拜托北京清华大学学士和美国加州理工学院博士学位的鲁为民老师给大家这里给大家准备了一份涵盖了AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频 全系列的学习资料,这些学习资料不仅深入浅出,而且非常实用,让大家系统而高效地掌握AI大模型的各个知识点。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
AI大模型系统学习路线
在面对AI大模型开发领域的复杂与深入,精准学习显得尤为重要。一份系统的技术路线图,不仅能够帮助开发者清晰地了解从入门到精通所需掌握的知识点,还能提供一条高效、有序的学习路径。
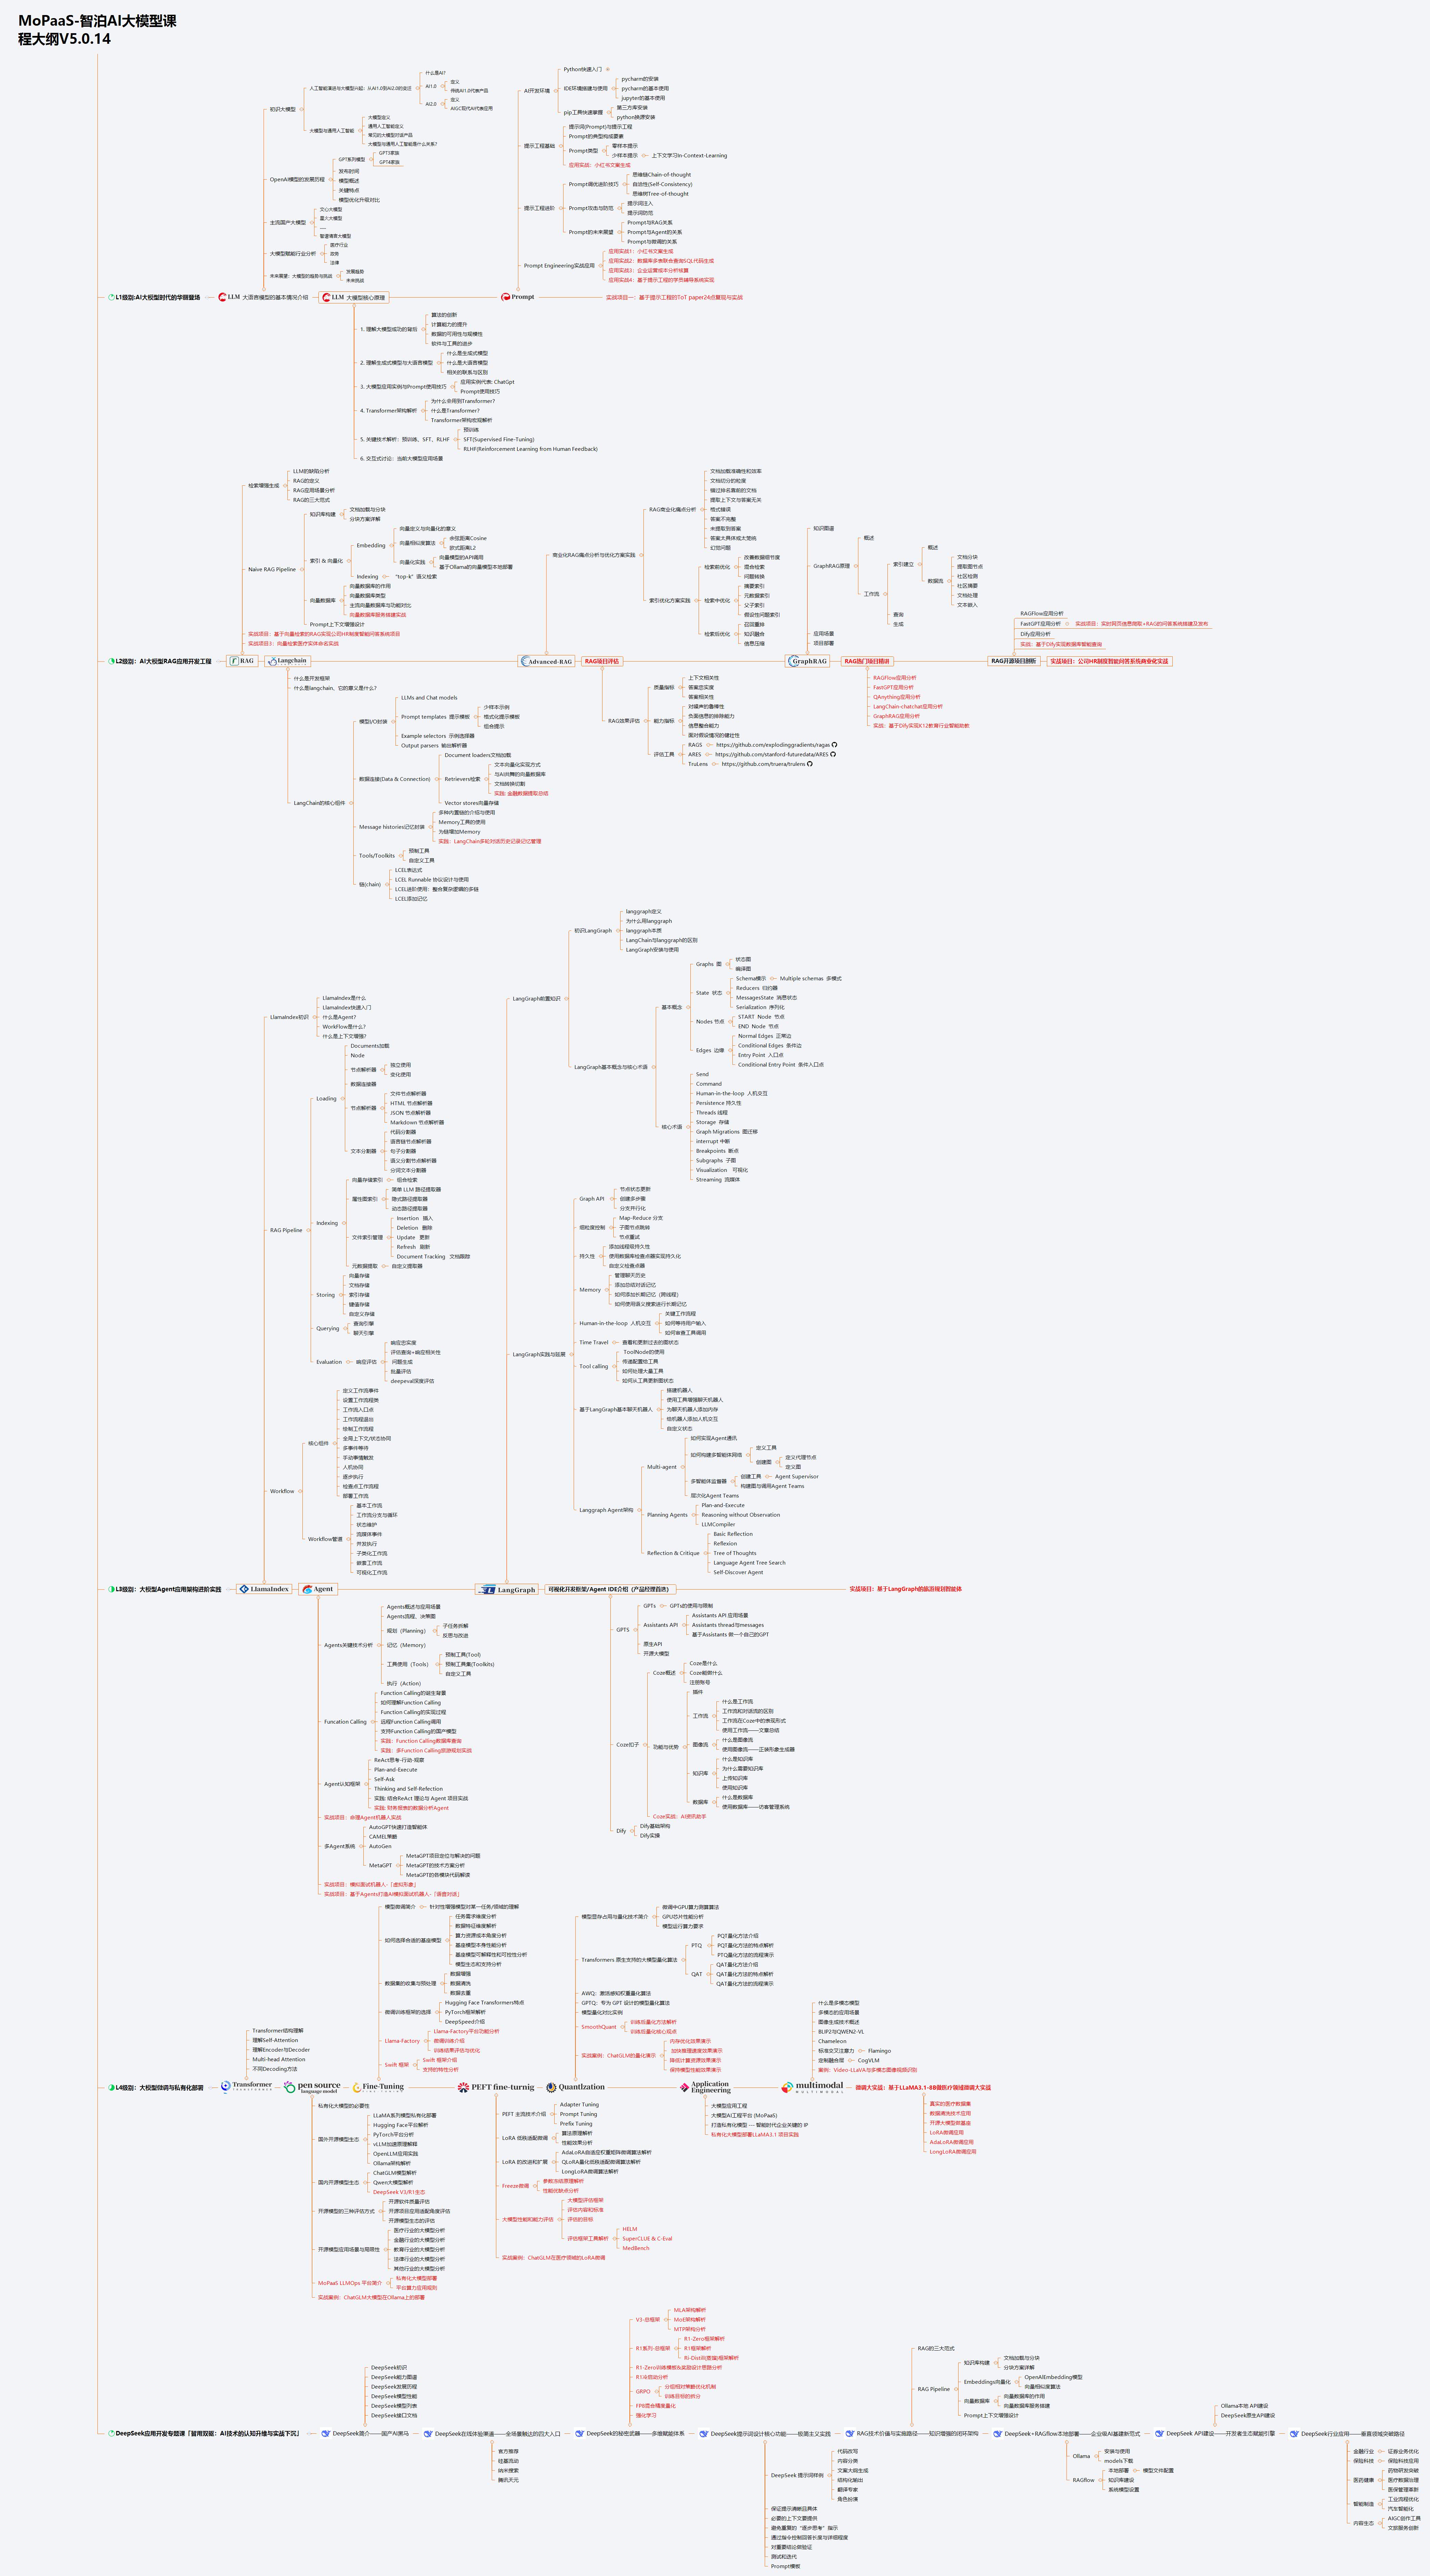
但知道是一回事,做又是另一回事,初学者最常遇到的问题主要是理论知识缺乏、资源和工具的限制、模型理解和调试的复杂性,在这基础上,找到高质量的学习资源,不浪费时间、不走弯路,又是重中之重。
AI大模型入门到实战的视频教程+项目包
看视频学习是一种高效、直观、灵活且富有吸引力的学习方式,可以更直观地展示过程,能有效提升学习兴趣和理解力,是现在获取知识的重要途径
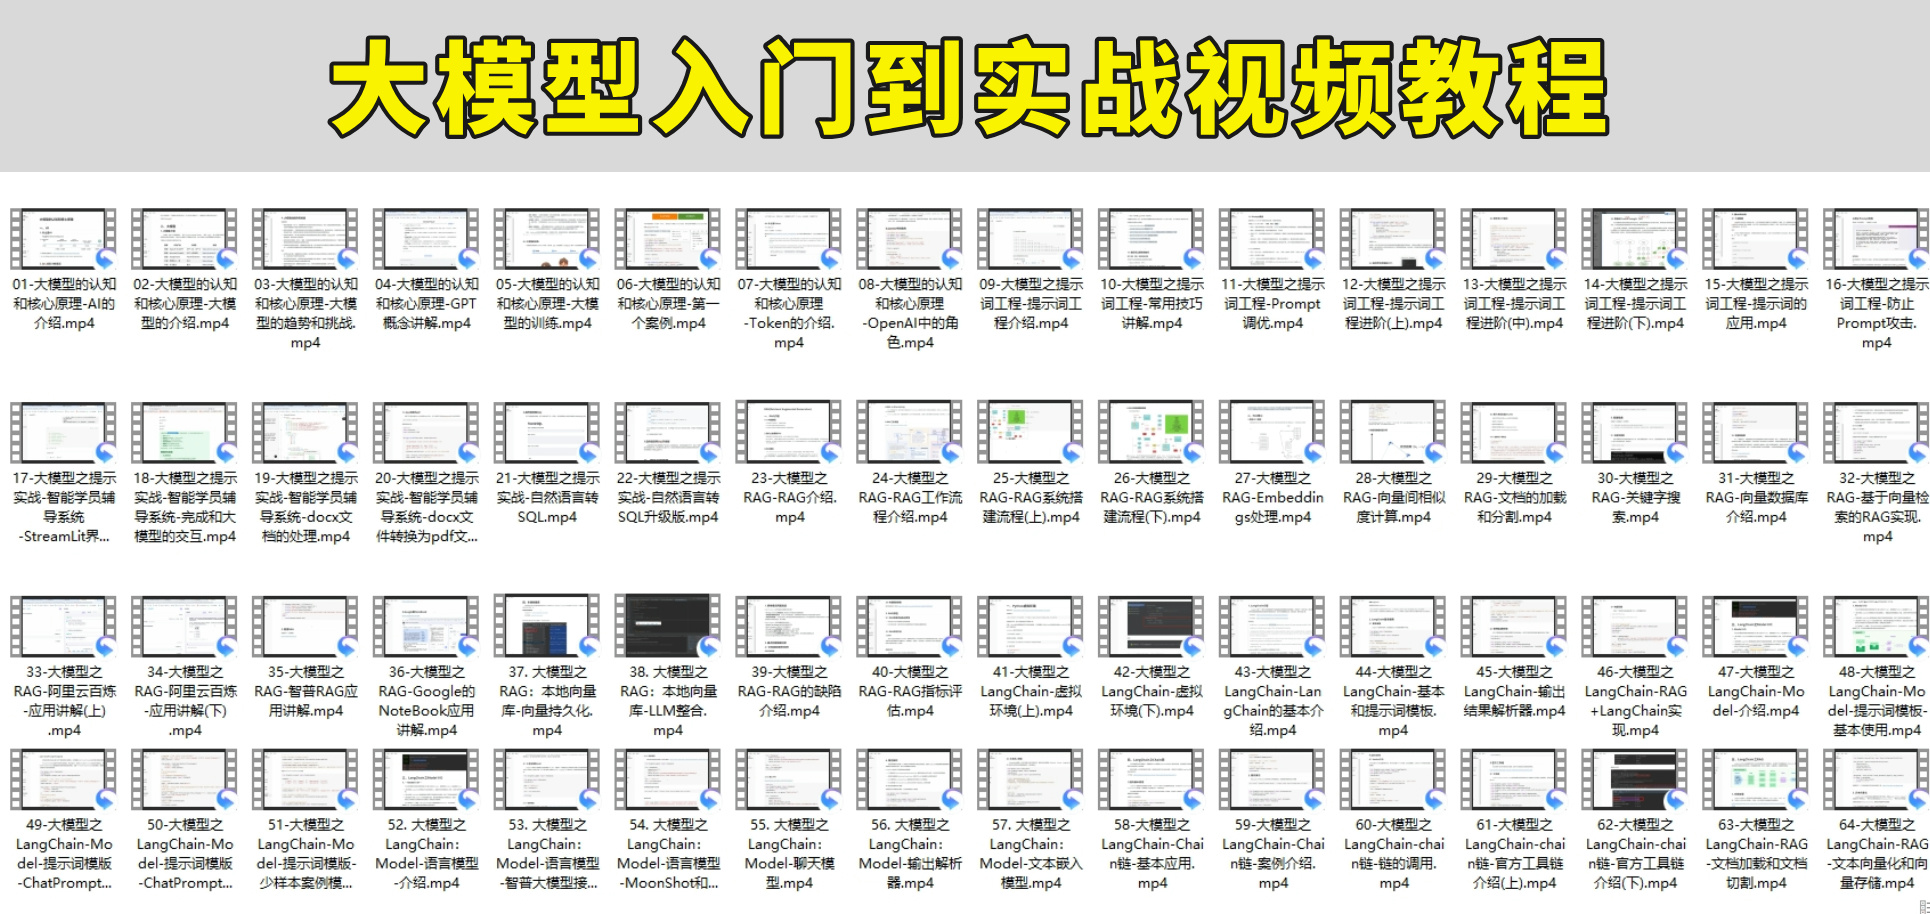
光学理论是没用的,要学会跟着一起敲,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。
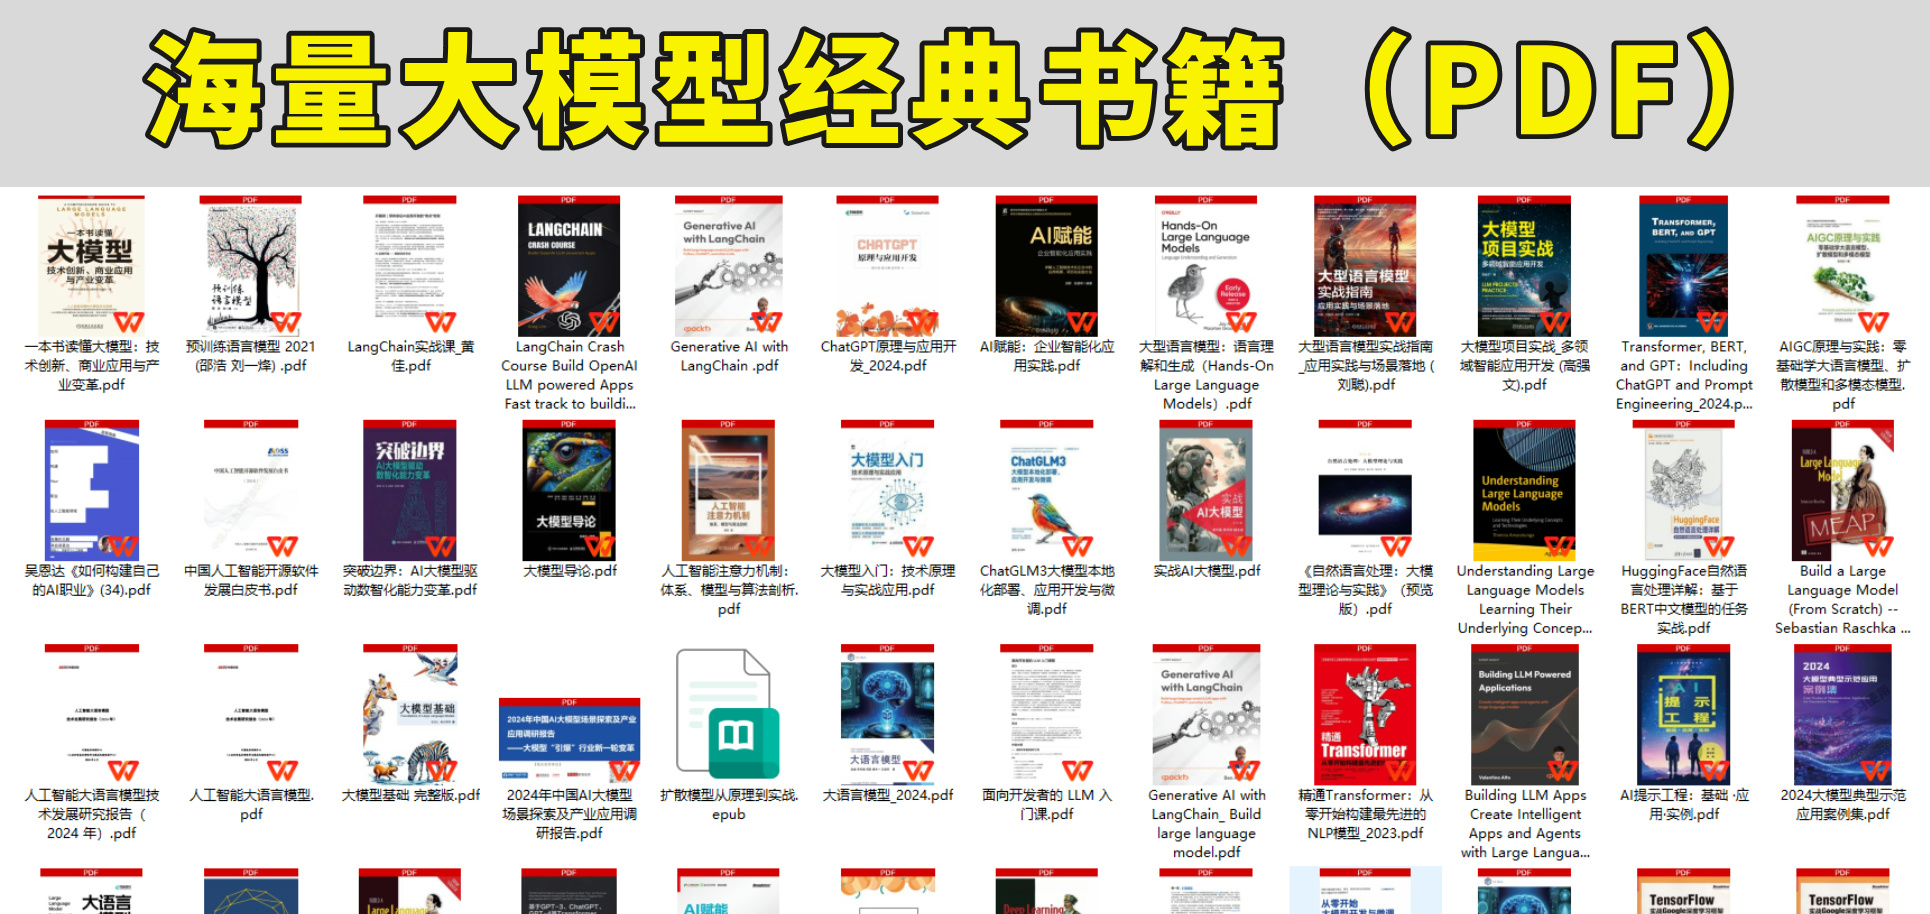
海量AI大模型必读的经典书籍(PDF)
阅读AI大模型经典书籍可以帮助读者提高技术水平,开拓视野,掌握核心技术,提高解决问题的能力,同时也可以借鉴他人的经验。对于想要深入学习AI大模型开发的读者来说,阅读经典书籍是非常有必要的。
600+AI大模型报告(实时更新)
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
AI大模型面试真题+答案解析
我们学习AI大模型必然是想找到高薪的工作,下面这些面试题都是总结当前最新、最热、最高频的面试题,并且每道题都有详细的答案,面试前刷完这套面试题资料,小小offer,不在话下
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 21
 0
- 0


 已为社区贡献25条内容

所有评论(0)