4.UE-探索GetName的加密算法(二)GName(GName在代码中是什么和Blocks字符串存放地)
免责声明:内容仅供学习参考,请合法利用知识,禁止进行违法犯罪活动!
本次游戏没法给
内容参考于:微尘网络安全
上一个内容:3.UE-探索GetName的加密算法(一)-GName(FName和UObjectBase结构)
上一个内容中可以找到FName了,也就是通过得到UObjectBase类的地址,使用UObjectBase类的地址+十六进制数18,就可以得到了,然后接下来是FName里的ToString()函数,也就是下图红框的函数,然后按着CTRL鼠标左键单击下图红框位置
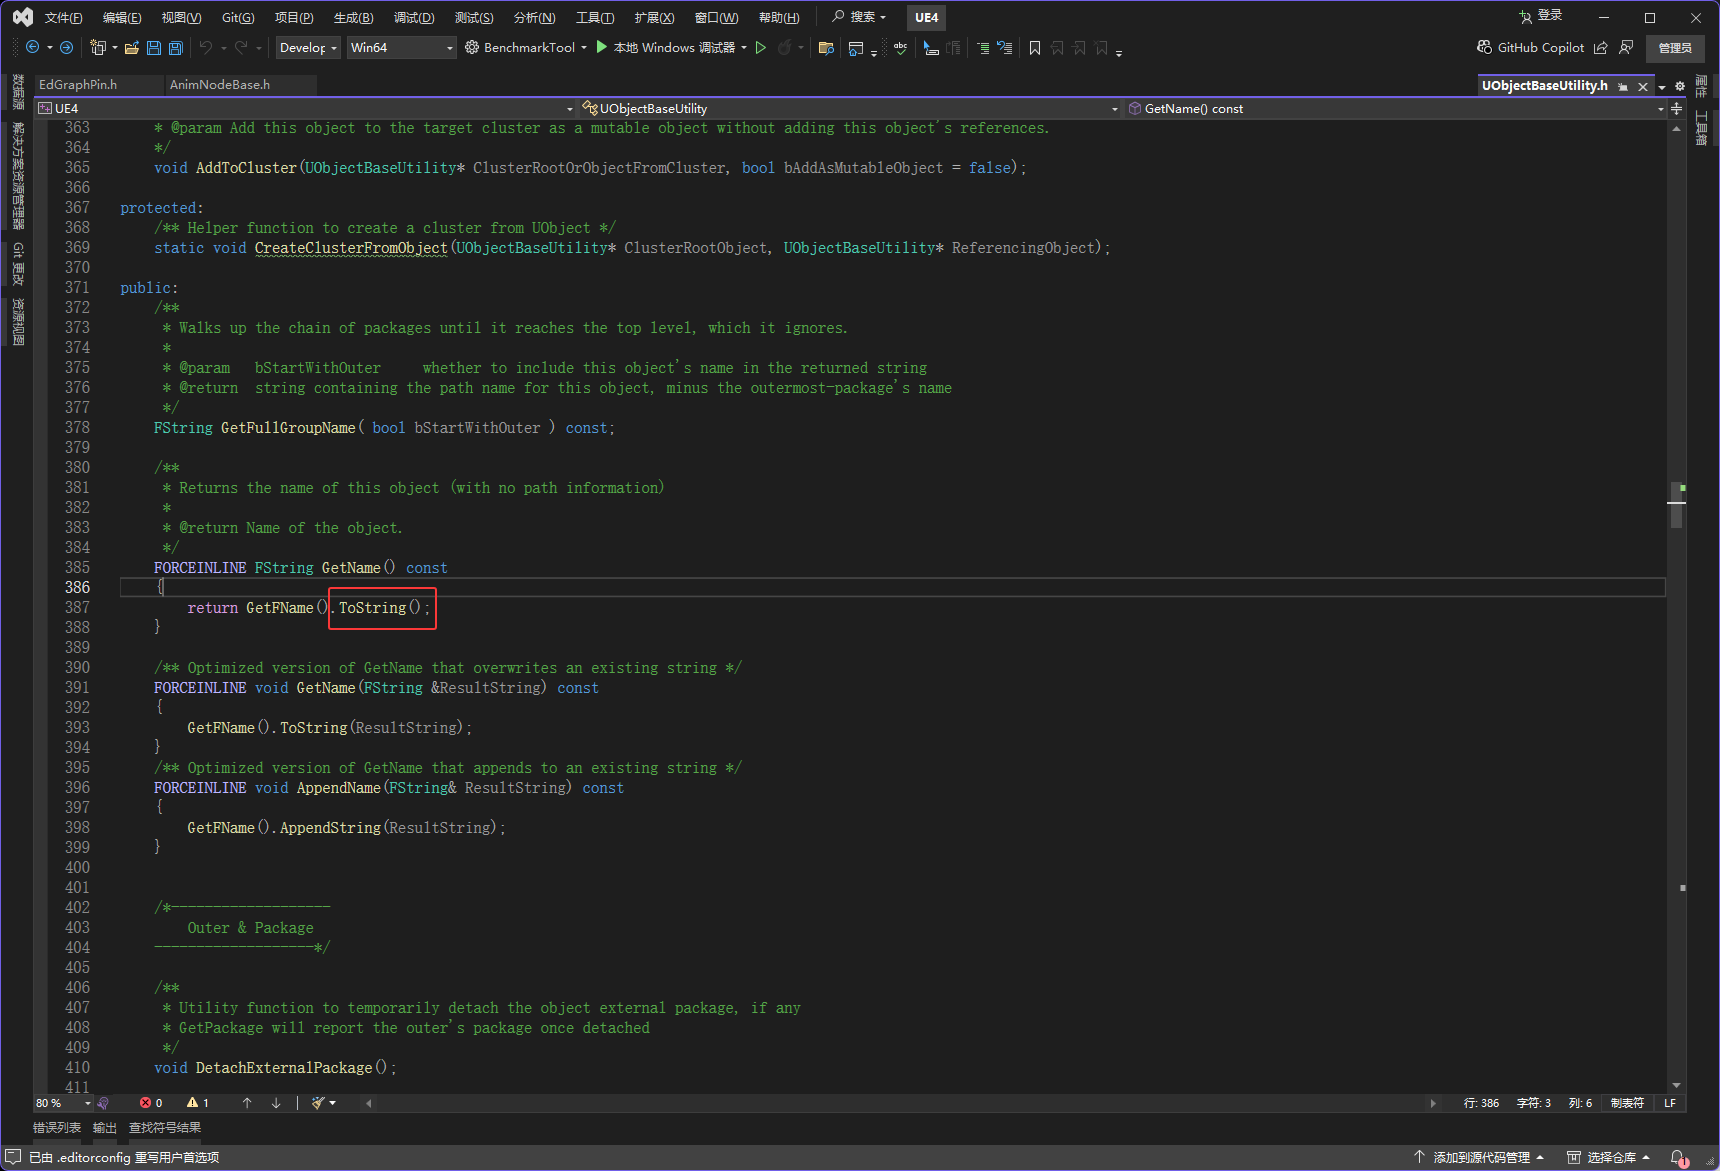
进入ToString函数

然后NAME_NO_NUMBER_INTERNAL的值是0
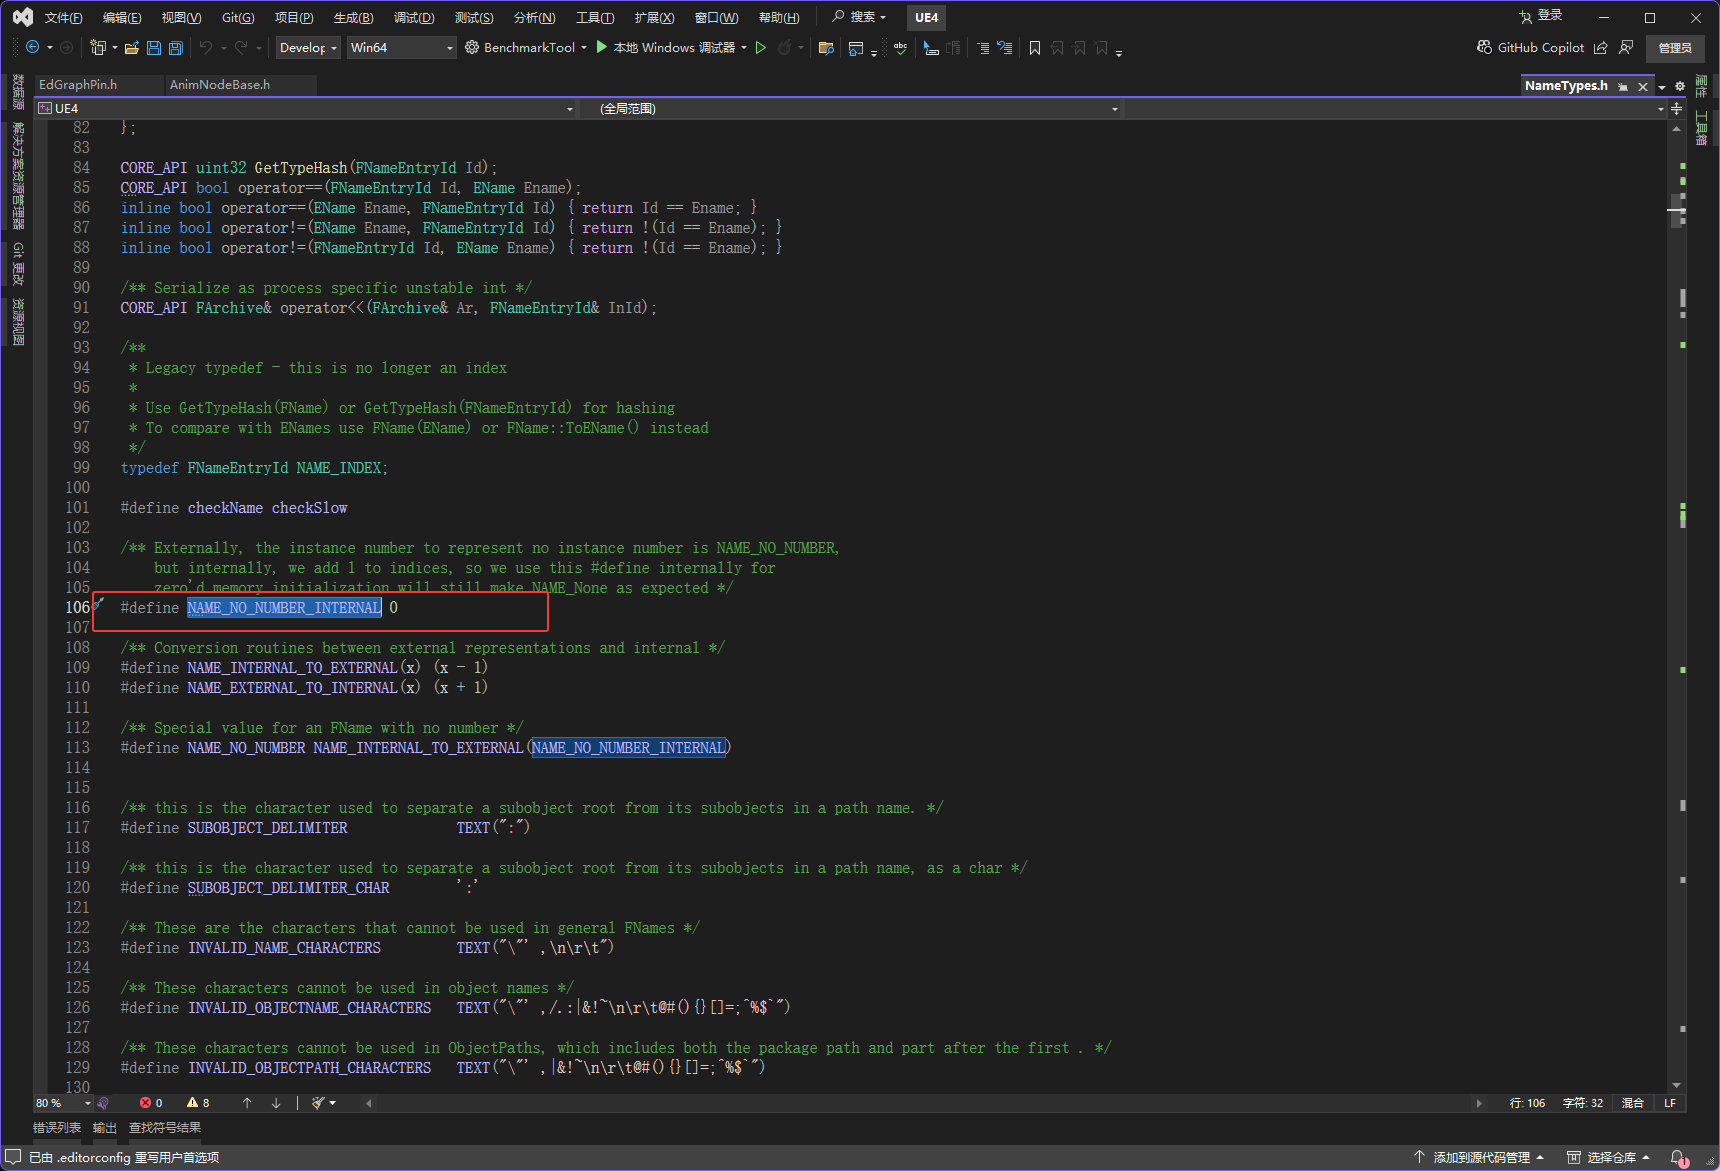
也就是说GetNumber函数返回0才会执行if里面的代码
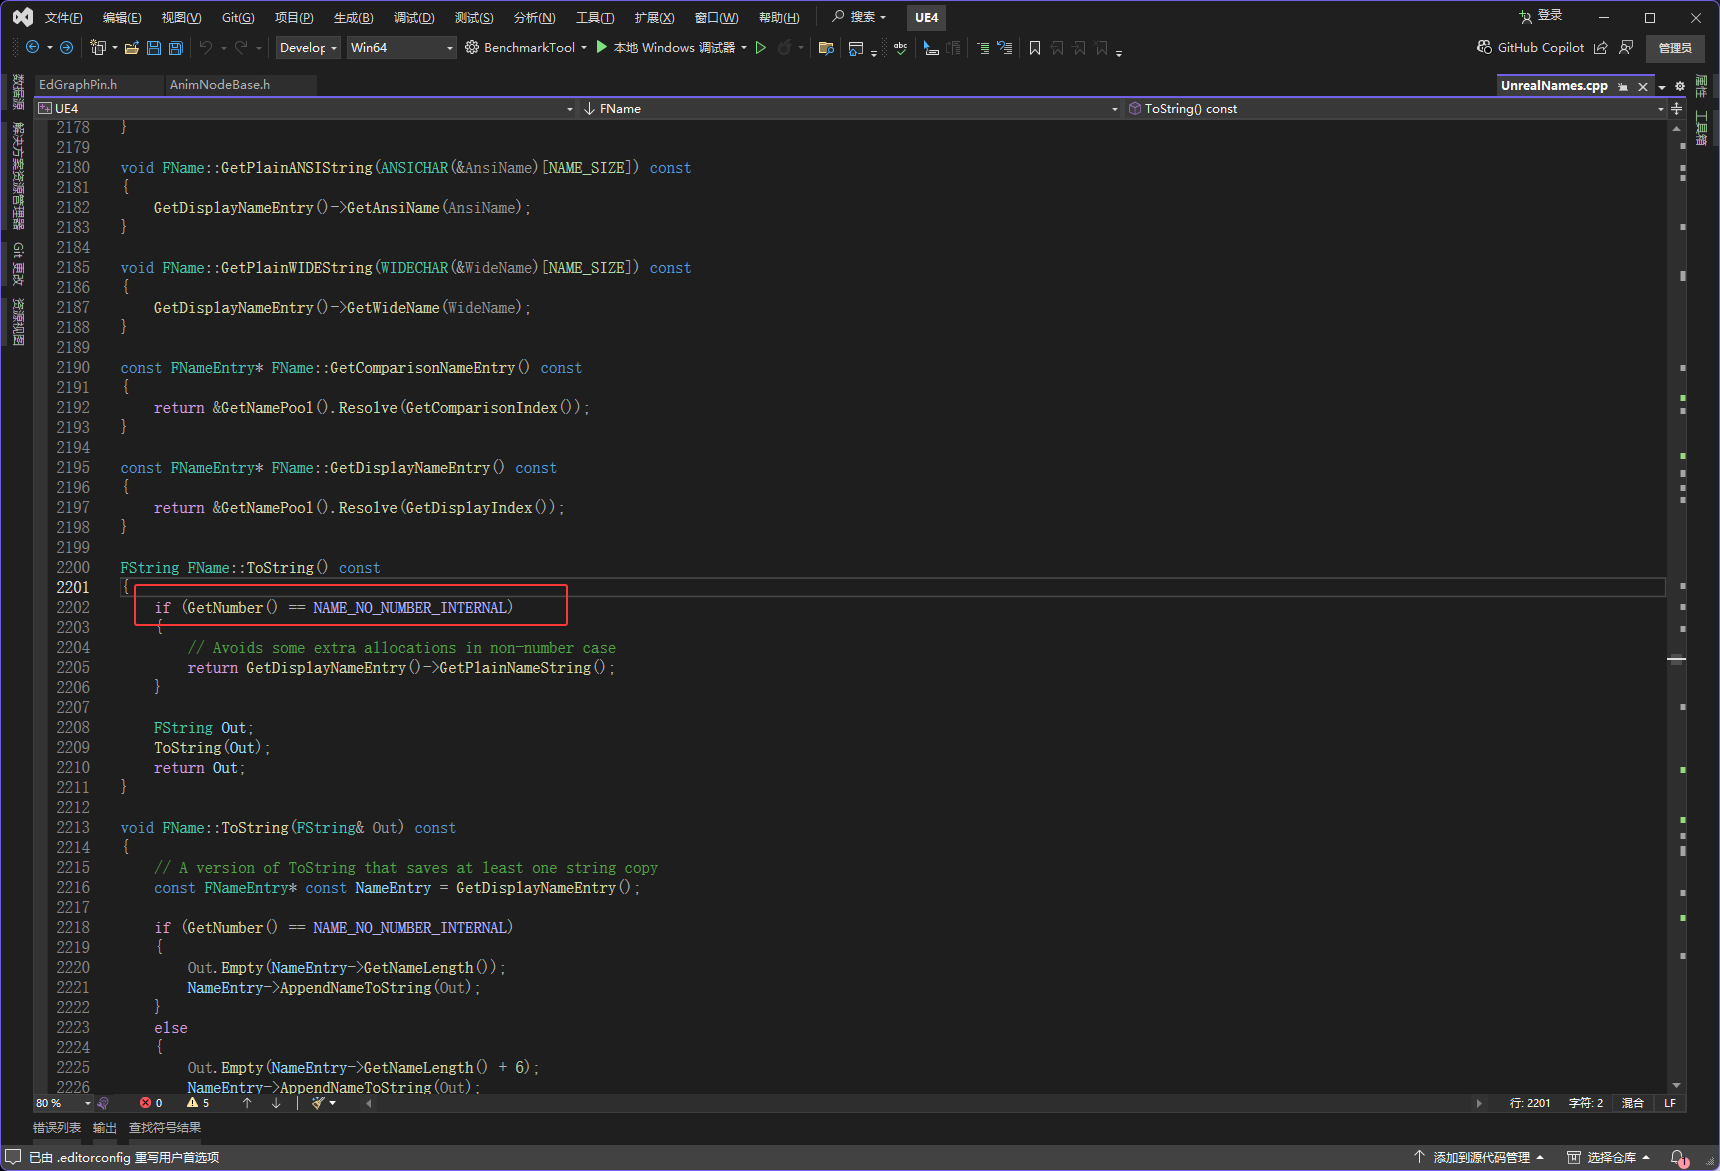
也就是执行下图红框的代码
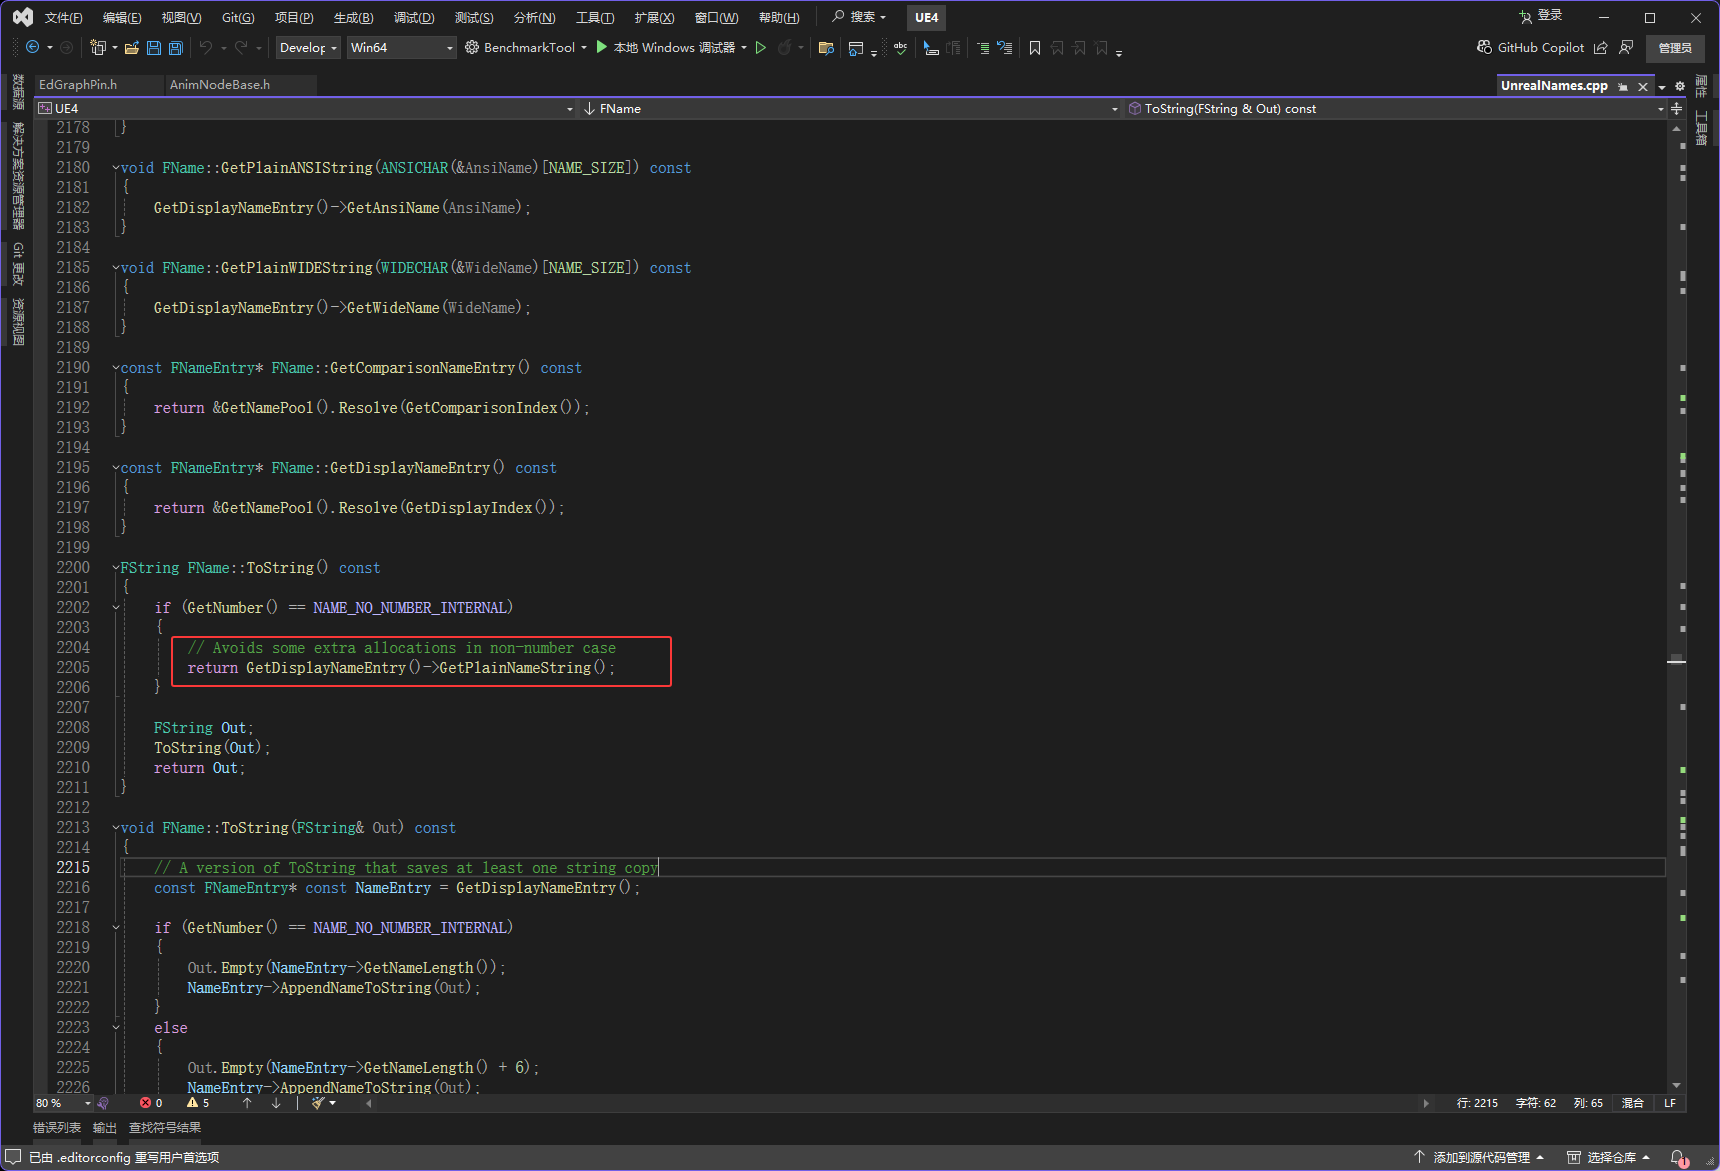
代码说明(ai生成)
// 将FName转换为FString(可读字符串)
// FName是UE中高效存储和比较的字符串类型(通过全局字符串表+索引实现),ToString()用于获取其人类可读的字符串形式
FString FName::ToString() const
{
	// 判断FName是否包含数字后缀(FName支持同名带数字区分,如"Mesh_1"、"Mesh_2")
	// NAME_NO_NUMBER_INTERNAL是内部常量,表示"没有数字后缀"
	if (GetNumber() == NAME_NO_NUMBER_INTERNAL)
	{
		// 无数字后缀的优化路径:直接返回名称条目中的纯字符串
		// 为什么这样优化?
		// - 避免创建临时FString再拼接(无数字时无需额外处理)
		// - GetDisplayNameEntry()获取FName在全局字符串表中的条目(存储原始字符串)
		// - GetPlainNameString()返回条目中的基础字符串(不含数字后缀)
		return GetDisplayNameEntry()->GetPlainNameString();
	}

	// 有数字后缀的情况:需要拼接基础字符串和数字
	FString Out;	// 用于存储结果的空FString
	ToString(Out);	// 调用重载版本,将基础字符串和数字拼接后存入Out
	return Out;		// 返回拼接后的结果
}
接下来先看GetDisplayNameEntry函数,如下图
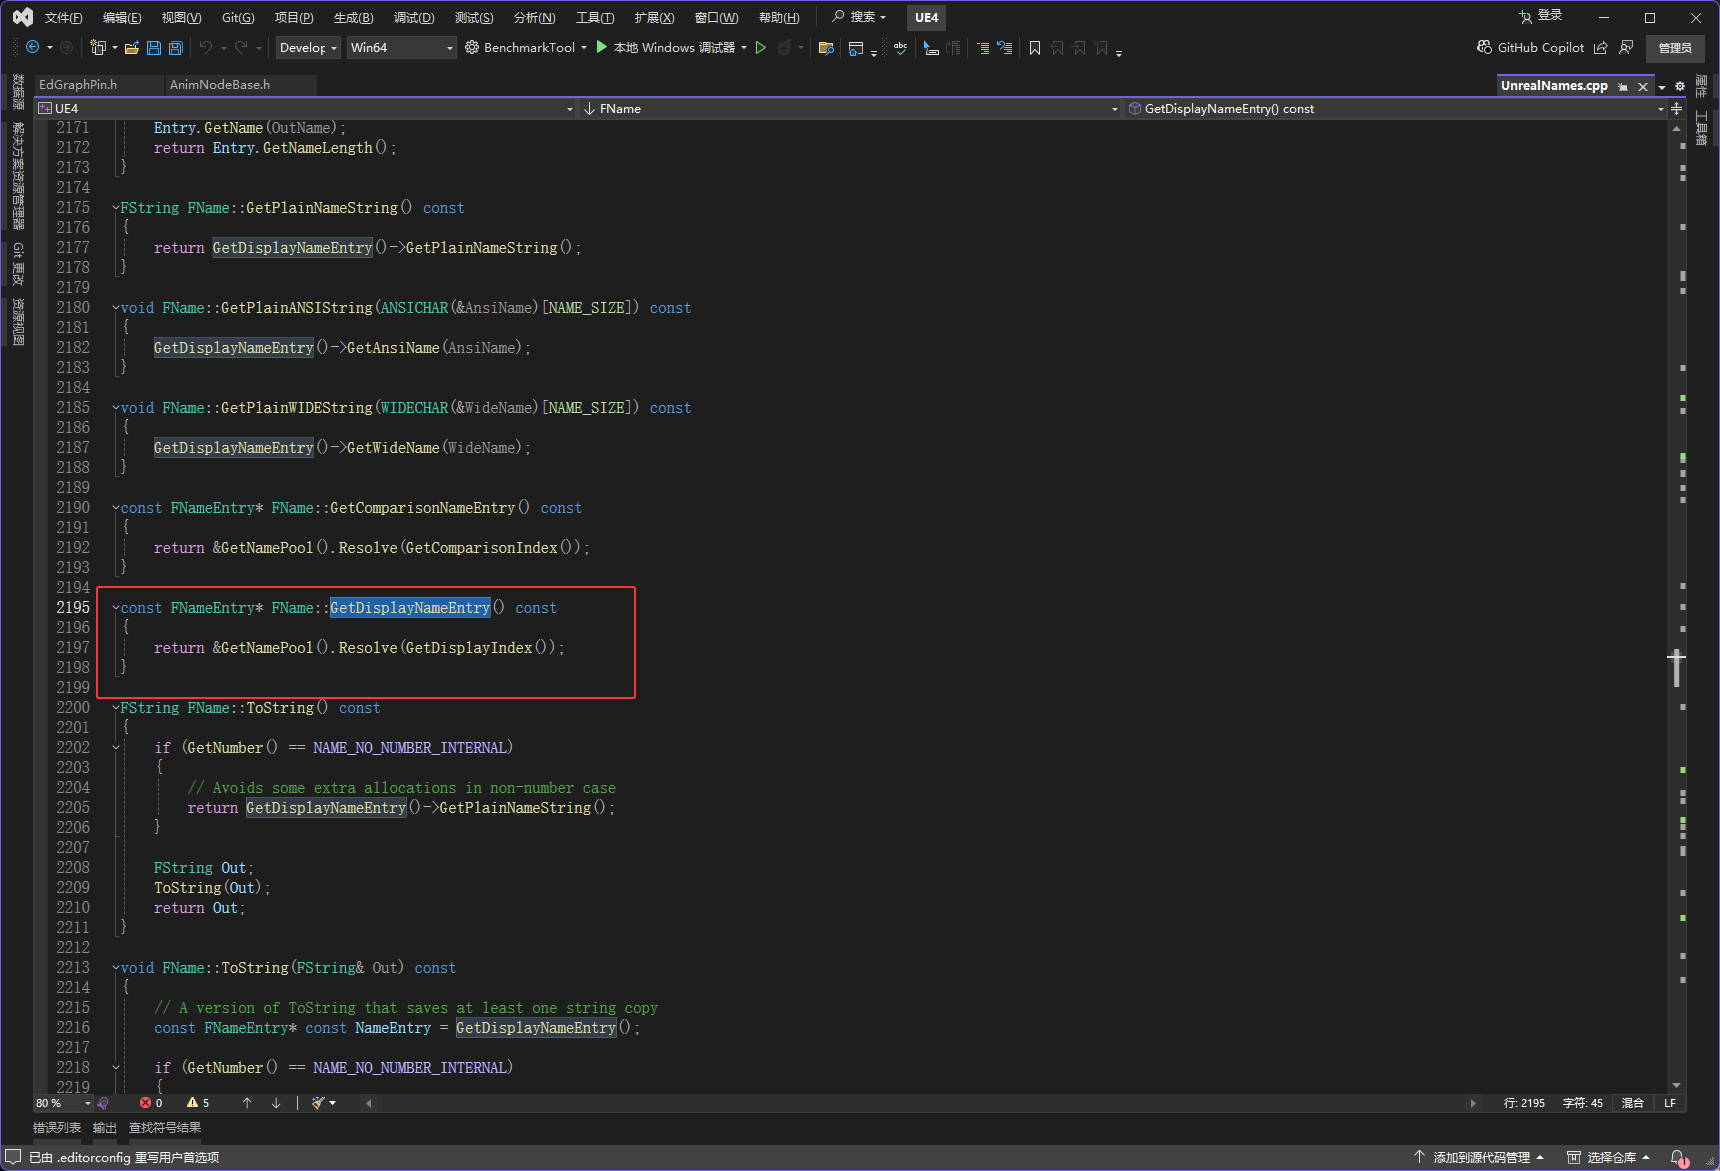
代码说明
// 获取当前FName在全局名字池中的显示条目(包含实际字符串数据)
// FNameEntry:存储字符串原始数据的结构体(如"Player"、"Mesh"等基础字符串)
// 作用:通过该条目可获取FName对应的可读字符串(用于ToString()等场景)
const FNameEntry* FName::GetDisplayNameEntry() const
{
	// 步骤拆解:
	// 1. GetNamePool():获取UE全局的名字池(FNamePool单例)
	//    - 名字池是所有FName共享字符串的中央仓库,确保相同字符串只存储一次(节省内存)
	// 2. GetDisplayIndex():获取当前FName用于显示的索引(指向名字池中的具体条目)
	//    - FName内部通过索引关联名字池,而非直接存储字符串,这是其高效性的核心(快速比较、低内存占用)
	// 3. Resolve(Index):名字池的方法,通过索引查找并返回对应的FNameEntry引用
	// 4. &取地址:将引用转换为指针,作为函数返回值
	return &GetNamePool().Resolve(GetDisplayIndex());
}
然后先看GetNamePool函数,它的作用就是为了返回NamePoolData
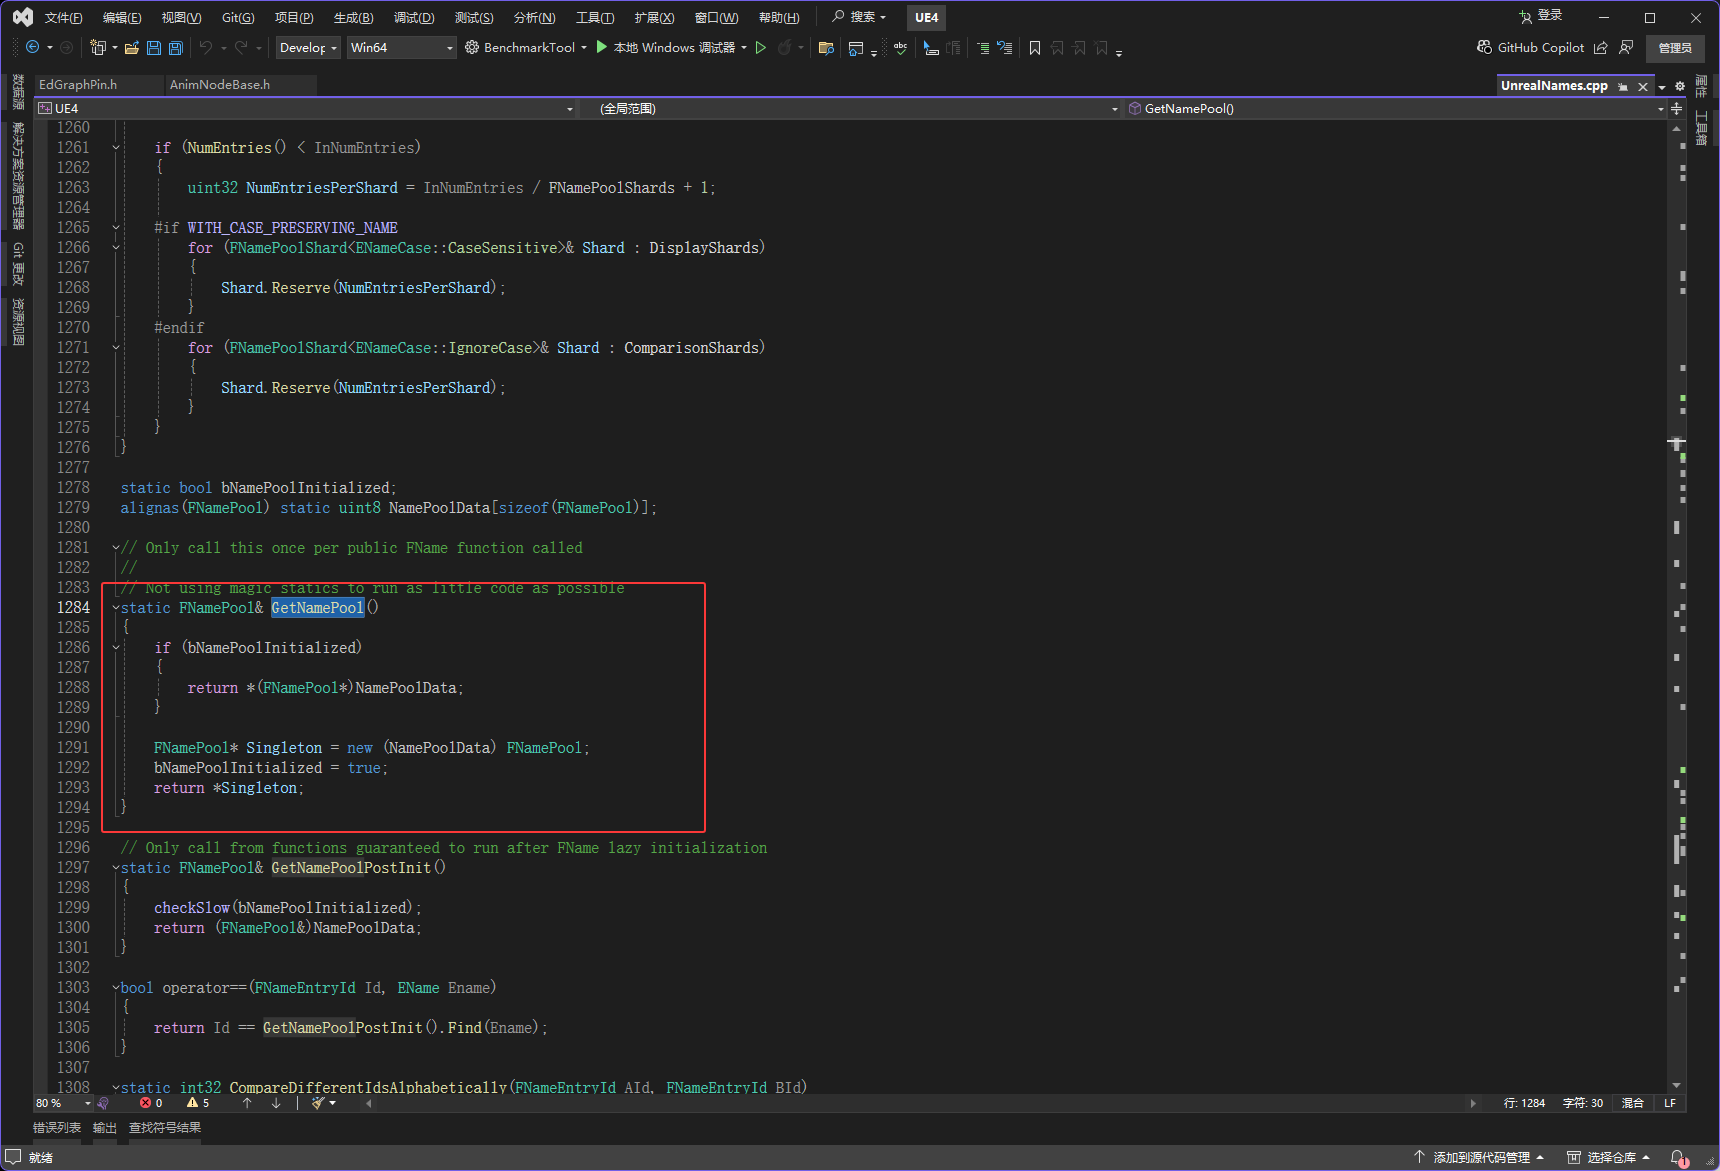
代码说明,这个NamePoolData就是所谓的GName,说白了GName就是一个FNamePool类型的全局变量,具体代码的实现就是NamePoolData
// 获取全局唯一的名字池(FNamePool)实例
// FNamePool是UE管理所有FName字符串的"中央仓库",所有FName的基础字符串都存在这里,确保不重复存储
static FNamePool& GetNamePool()
{
    // 第一步:检查名字池是否已经初始化过
    if (bNamePoolInitialized)  // bNamePoolInitialized是个全局标志,true表示已经创建过名字池
    {
        // 如果已经初始化,直接返回已有的名字池实例
        // NamePoolData是存储名字池的内存地址,把它转成FNamePool指针后,返回它的引用
        return *(FNamePool*)NamePoolData;
    }

    // 第二步:如果没初始化,创建名字池实例
    // 这里用了特殊的new(placement new):不在新地址创建对象,而是在NamePoolData预分配的内存里创建
    // 为什么这么做?避免动态分配内存的开销,确保名字池在固定地址,更高效、安全
    FNamePool* Singleton = new (NamePoolData) FNamePool;  // 在指定内存创建FNamePool对象

    bNamePoolInitialized = true;  // 标记为已初始化,下次调用直接返回已有实例
    return *Singleton;  // 返回新创建的名字池实例的引用
}
它的定义

代码说明,这个GName的内存地址找法后面会写
// 为全局名字池(FNamePool)预分配的静态内存缓冲区
// 作用:给GName(全局唯一的FNamePool实例)提供固定的存储位置,避免动态内存分配的开销和风险
// 逐部分解析:
// 1. alignas(FNamePool):
//    - 强制内存对齐,确保NamePoolData的起始地址符合FNamePool类的对齐要求(如8字节、16字节对齐)
//    - 为什么需要对齐?CPU访问内存时,对特定地址(如8的倍数)的访问效率更高,不对齐可能导致性能下降或崩溃
//    - FNamePool内部有指针、大数组等成员,必须对齐才能正确构造和使用
//
// 2. static uint8:
//    - static:静态变量,意味着这块内存从程序启动到退出一直存在,不会被中途释放(适合全局唯一的名字池)
//    - uint8:无符号字节类型,这里用于表示"原始内存块"(类似一堆连续的字节容器)
//
// 3. NamePoolData[sizeof(FNamePool)]:
//    - NamePoolData:数组名,标识这块内存是专门给名字池用的
//    - [sizeof(FNamePool)]:数组大小正好等于FNamePool类的字节大小(用sizeof计算)
//    - 确保内存块能完整容纳一个FNamePool对象(不多不少,刚好够用)
//
// 关联逻辑:
// 当GetNamePool()第一次调用时,会用"placement new"在这块内存中构造FNamePool实例(GName)
// 这种方式比普通new更高效:无需动态申请内存,地址固定,且避免内存碎片
alignas(FNamePool) static uint8 NamePoolData[sizeof(FNamePool)];
然后GetNamePool函数就看完了,接下来是&GetNamePool().Resolve(GetDisplayIndex())中的GetDisplayIndex函数,如下图它返回了一个Index,Index的值来自于GetDisplayIndexFast函数
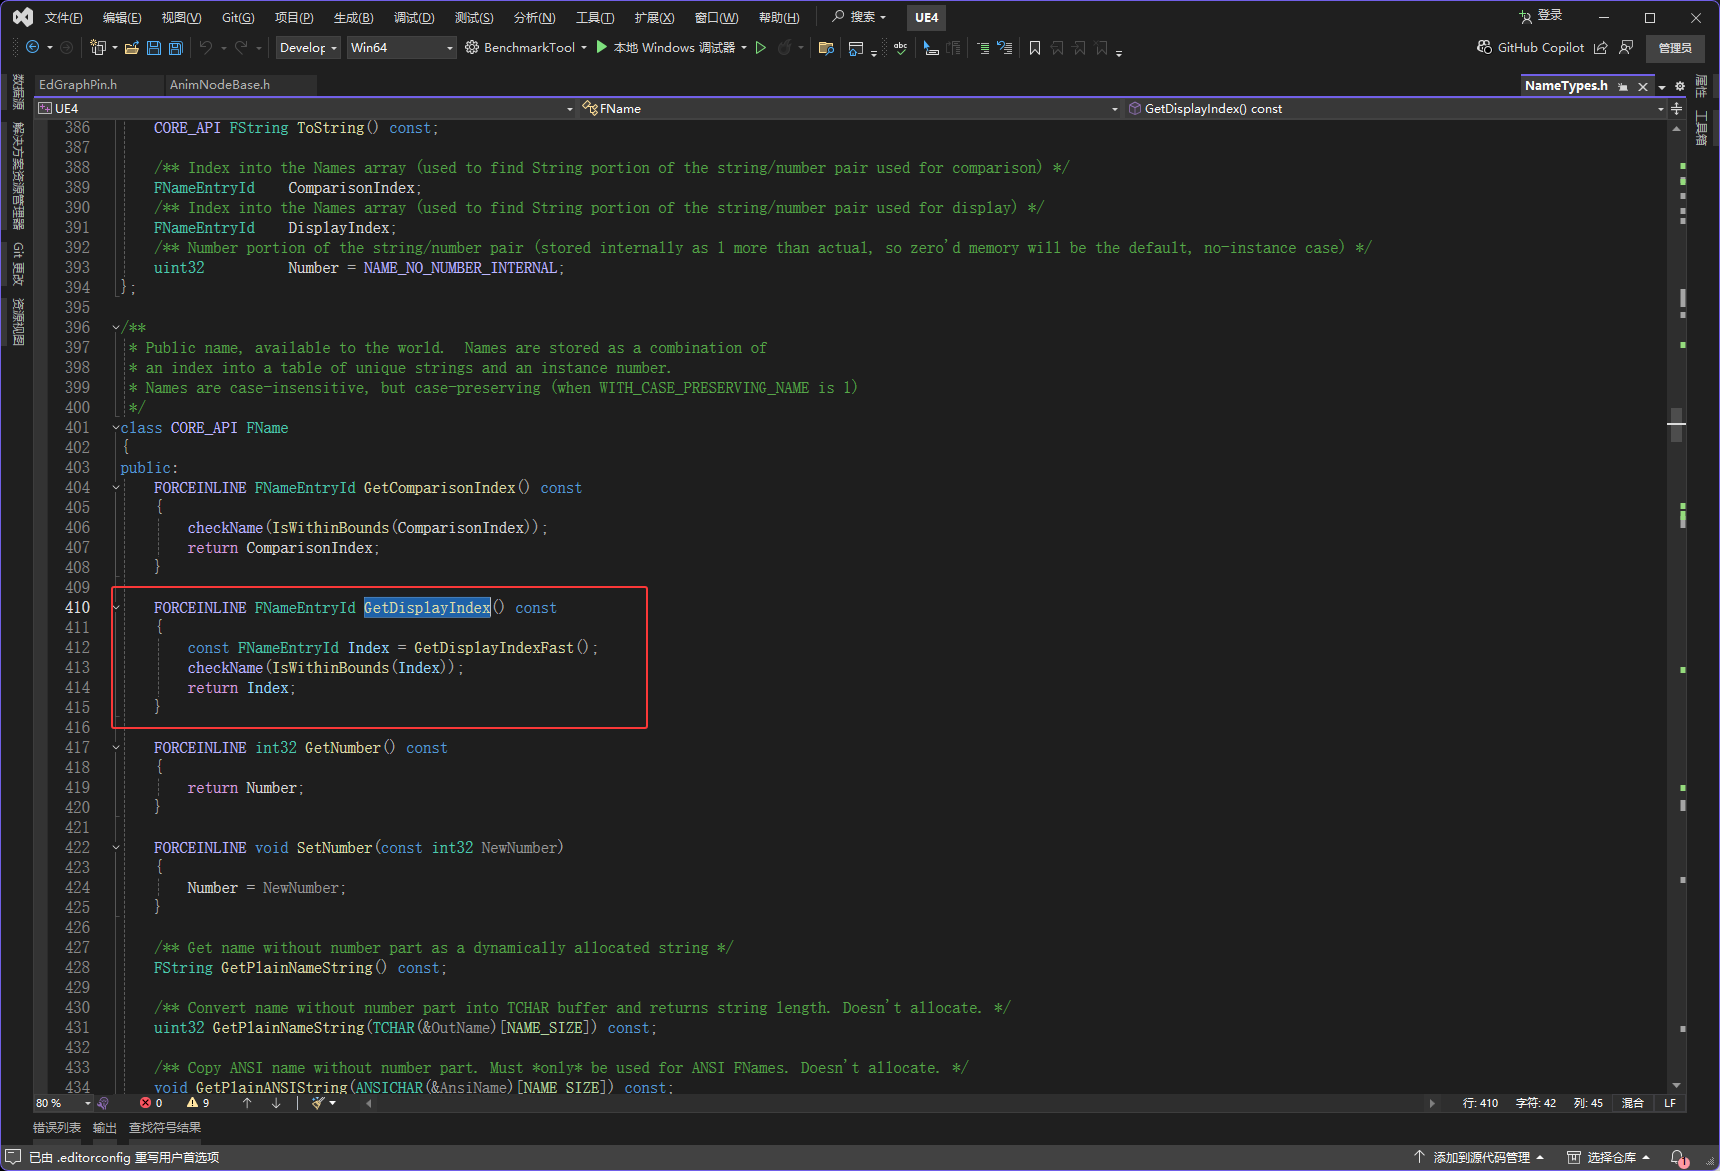
代码说明
// 获取当前FName在名字池中的"显示索引"(带有效性检查)
// FNameEntryId:用于标识名字池中FNameEntry的ID类型(本质是索引,类似数组下标)
// 作用:返回FName对应的全局名字池条目索引,确保该索引有效(避免访问无效内存)
FORCEINLINE FNameEntryId GetDisplayIndex() const
{
    // 1. 快速获取索引:调用GetDisplayIndexFast()直接返回内部存储的索引值
    //    为什么叫"Fast"?因为这个函数不做有效性检查,单纯返回值,速度更快
    const FNameEntryId Index = GetDisplayIndexFast();

    // 2. 验证索引有效性:
    //    - IsWithinBounds(Index):检查索引是否在名字池的有效范围内(比如不超过当前最大条目数)
    //    - checkName():UE的断言宏(仅在调试模式生效),如果索引无效会触发错误并中断程序
    //    作用:确保返回的索引能正确指向名字池中的FNameEntry(避免访问空指针或越界)
    checkName(IsWithinBounds(Index));

    // 3. 返回经过验证的有效索引
    return Index;
}
然后进入GetDisplayIndexFast函数
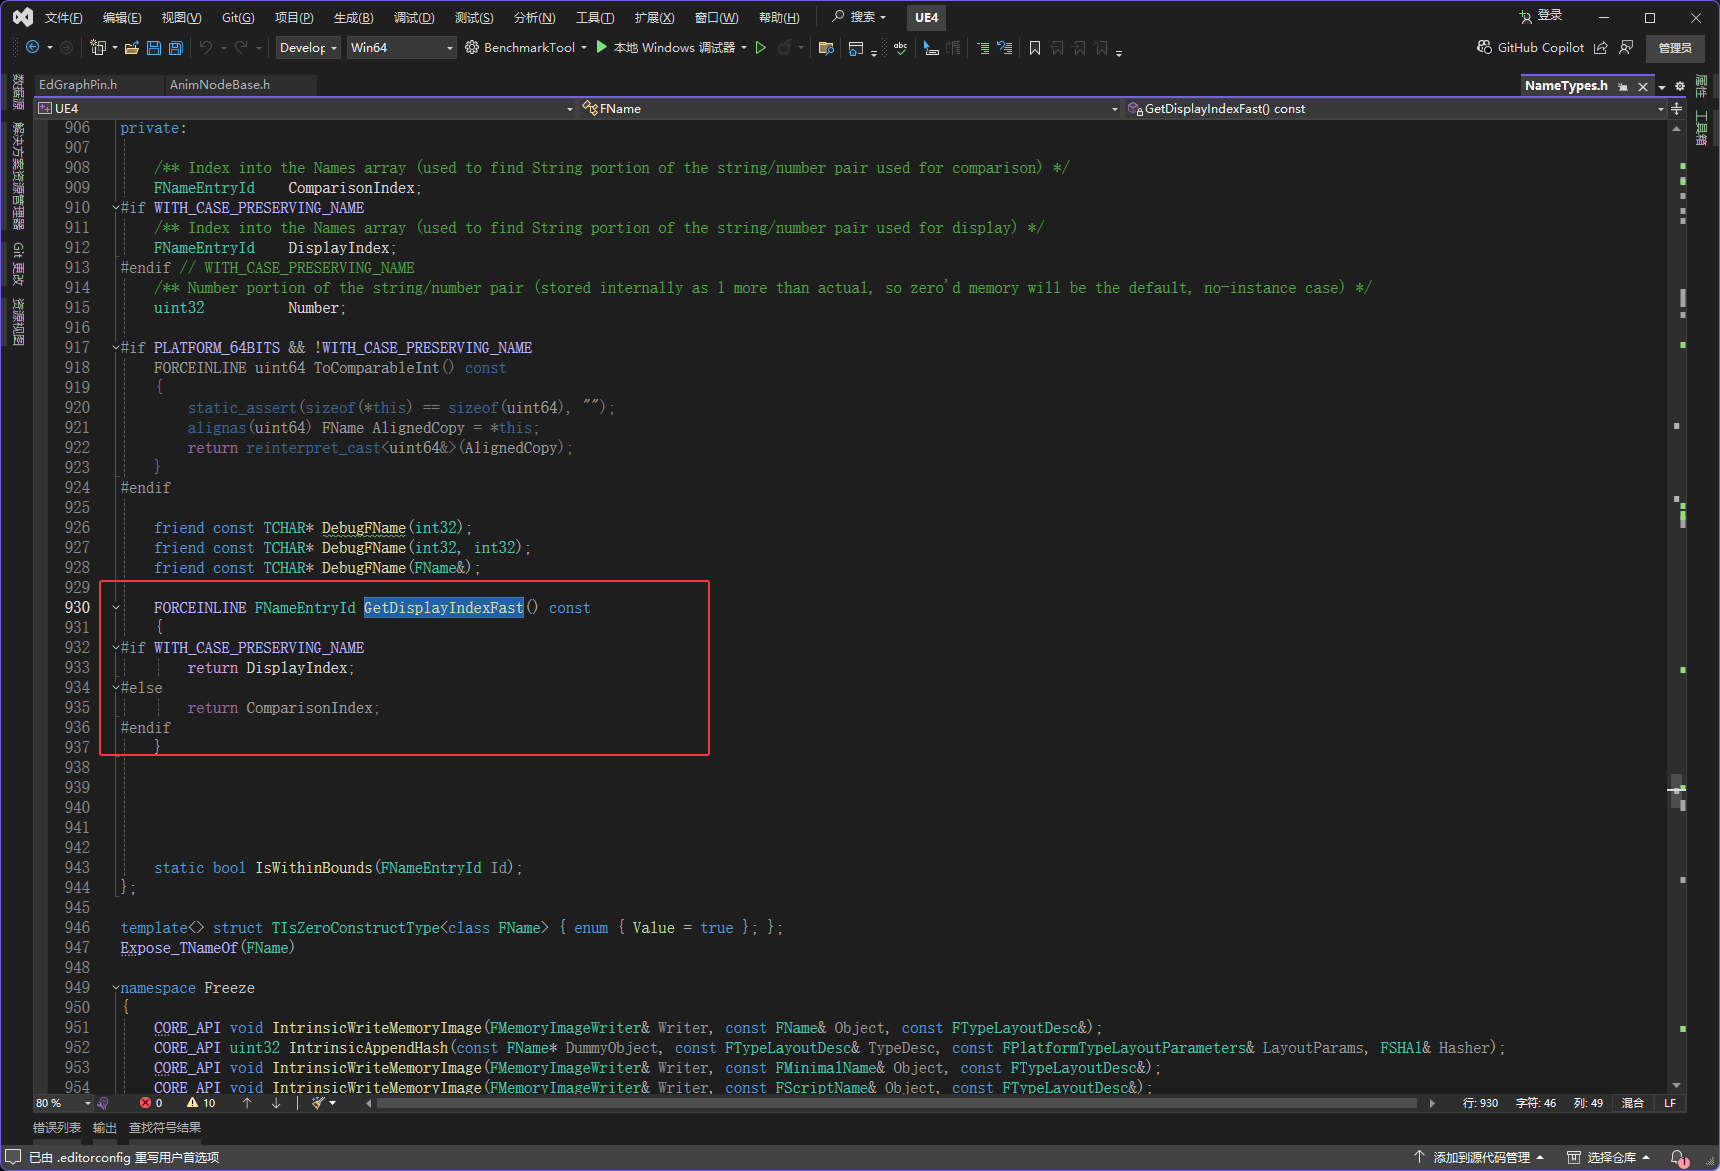
代码说明:开发的时候会使用DisplayIndex,因为开发时不需要区分大小写,区分大小写后反而会麻烦,游戏开发完后发布时会使用ComparisonIndex
// 快速获取FName的"显示索引"(不做有效性检查,仅返回内部存储的索引值)
// FNameEntryId:名字池中条目的唯一标识(类似数组下标)
// 作用:在性能敏感场景下,直接返回FName内部存储的索引,跳过检查以提升速度
FORCEINLINE FNameEntryId GetDisplayIndexFast() const
{
    // 条件编译:会根据引擎是否开启"大小写保留"功能,返回不同的索引
#if WITH_CASE_PRESERVING_NAME
    // 当开启大小写保留(WITH_CASE_PRESERVING_NAME为真)时:
    // 返回DisplayIndex(对应原始大小写的字符串条目索引,如"Player"和"player"是不同条目)
    return DisplayIndex;
#else
    // 当不开启大小写保留(默认情况)时:
    // 返回ComparisonIndex(对应大小写不敏感的字符串条目索引,如"Player"和"player"会映射到同一个条目)
    return ComparisonIndex;
#endif
}
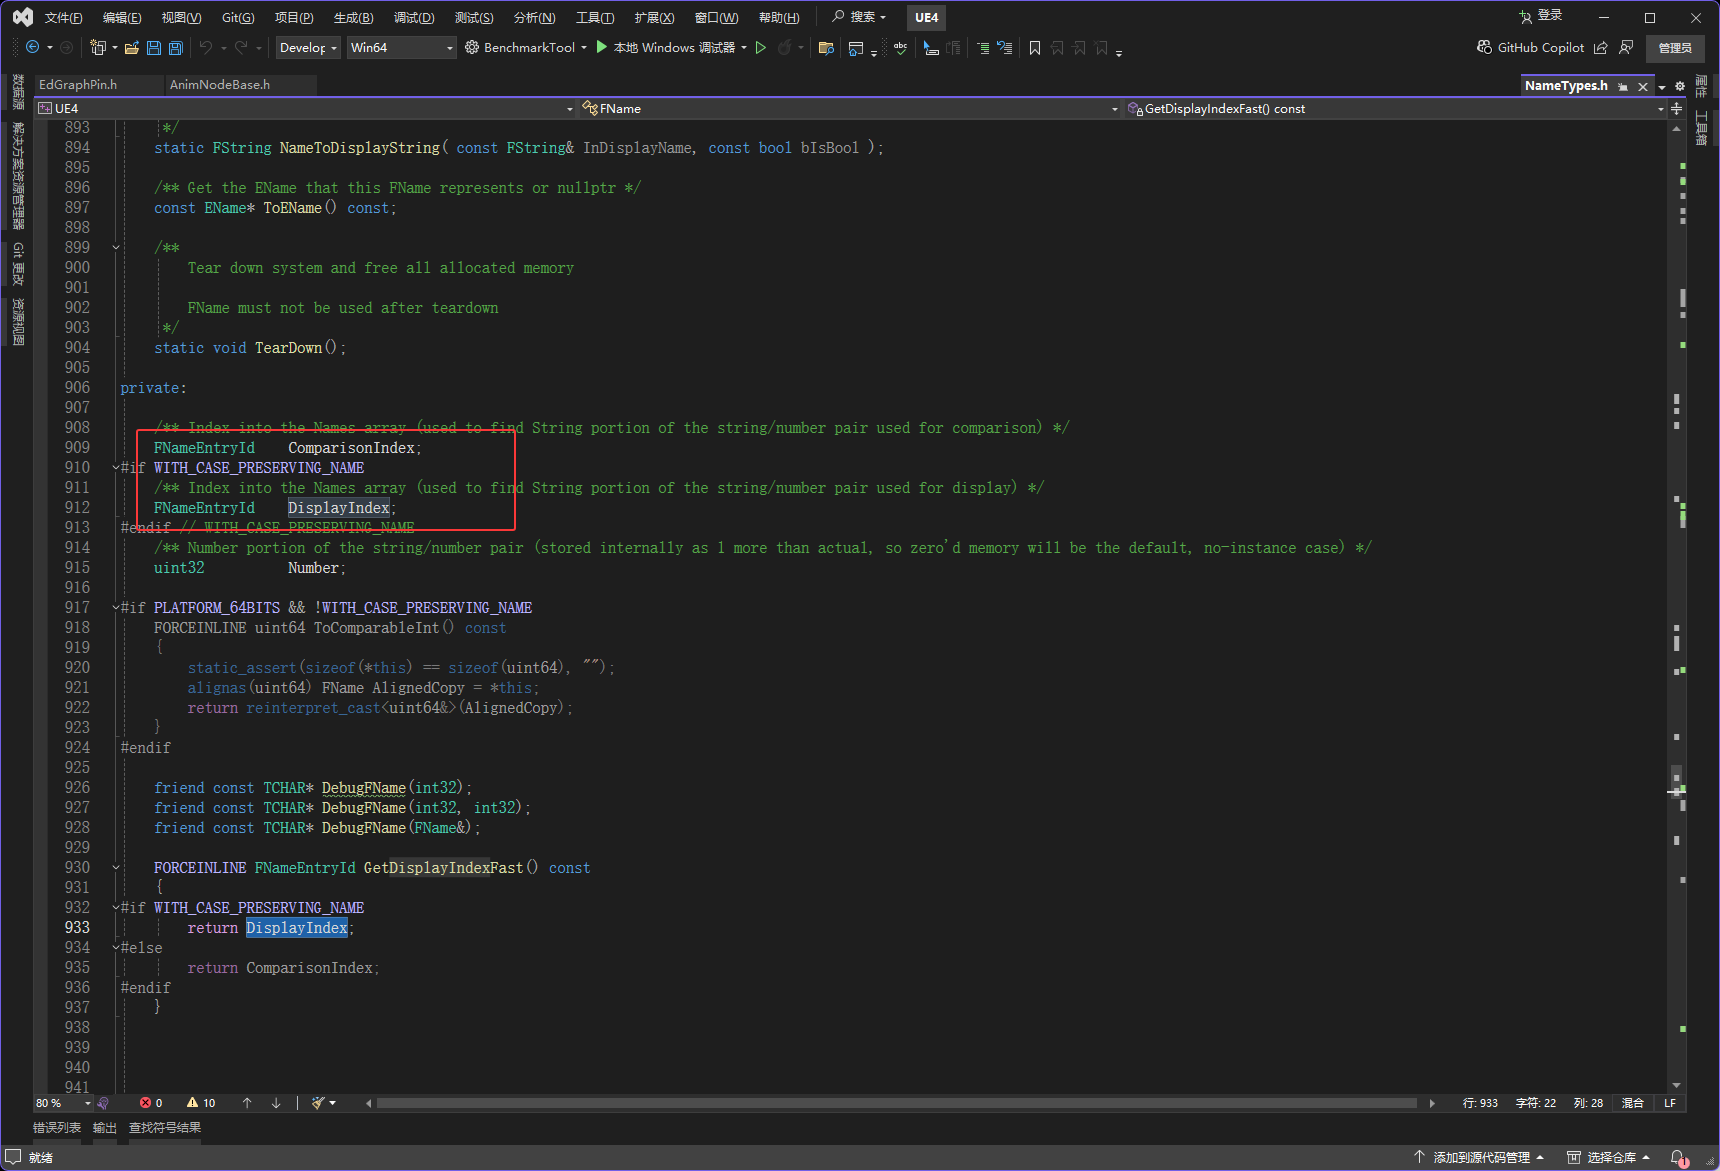
然后注意按着CTRL鼠标单击下图红框时
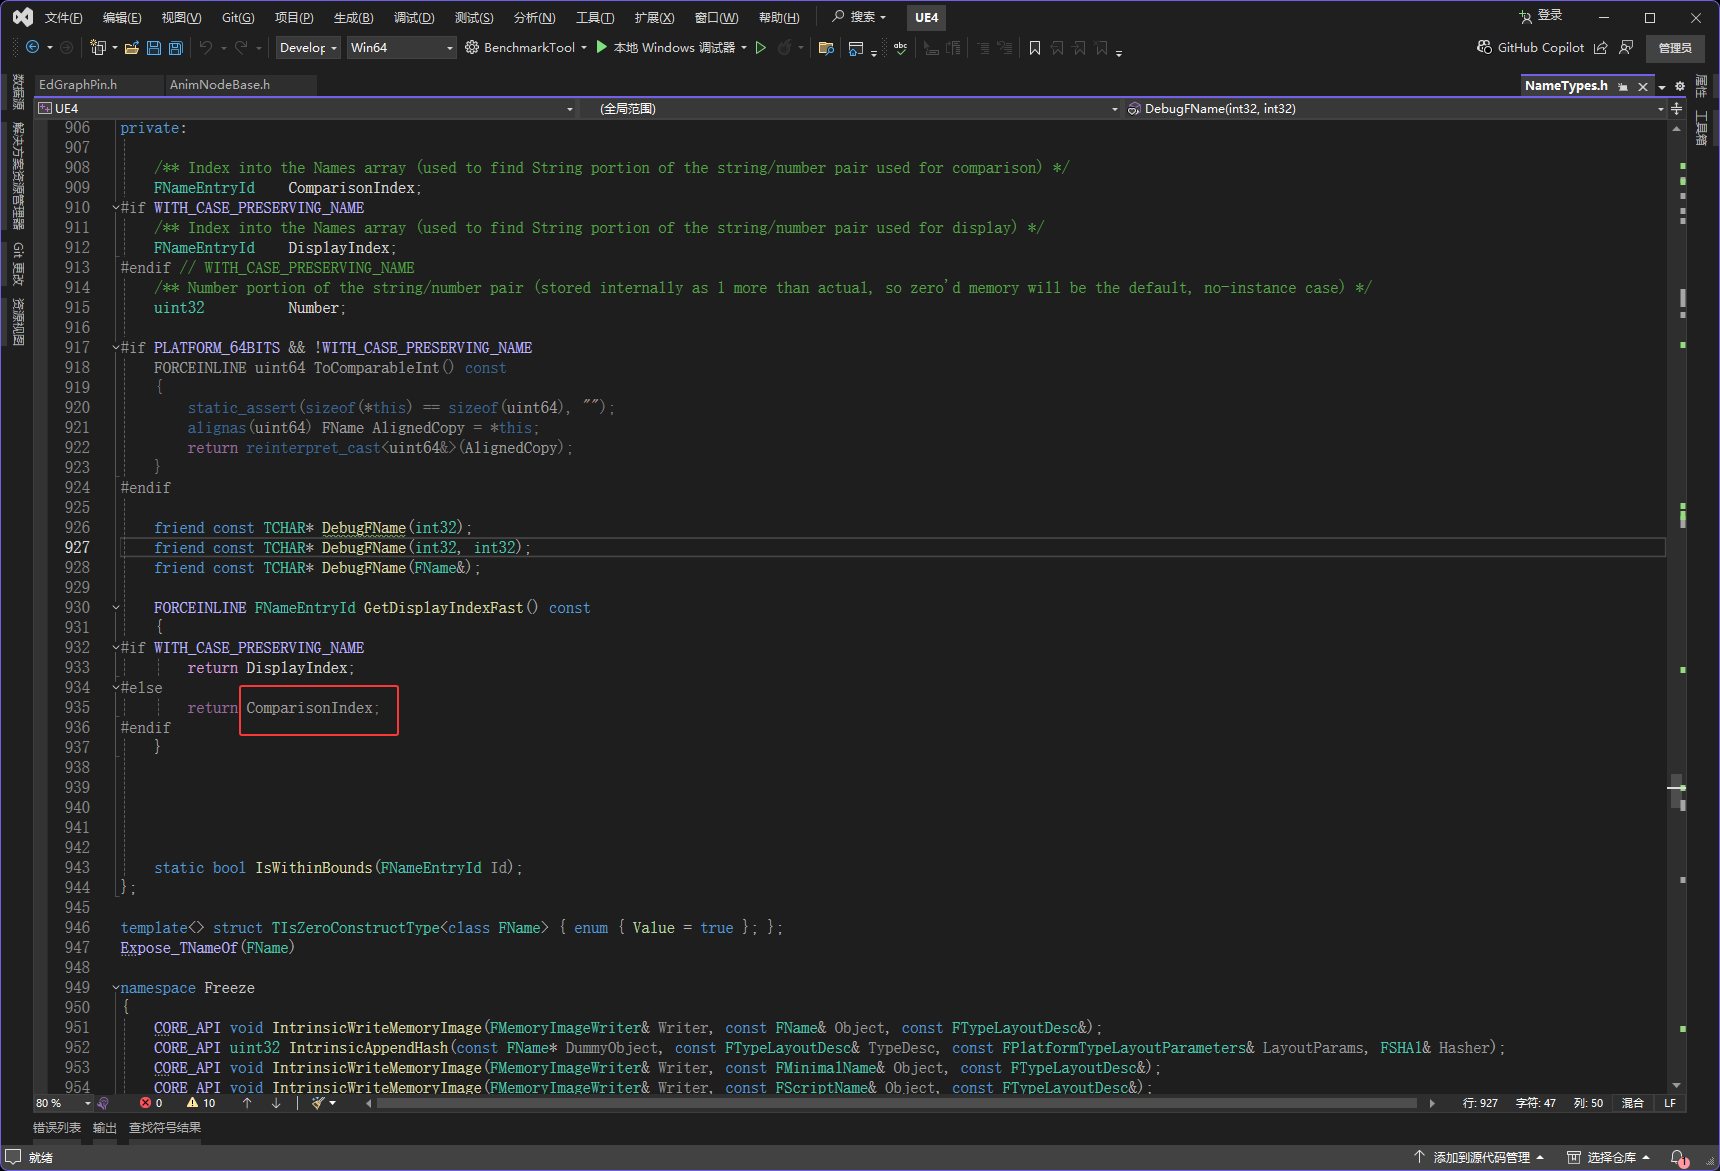
会出现两个选择
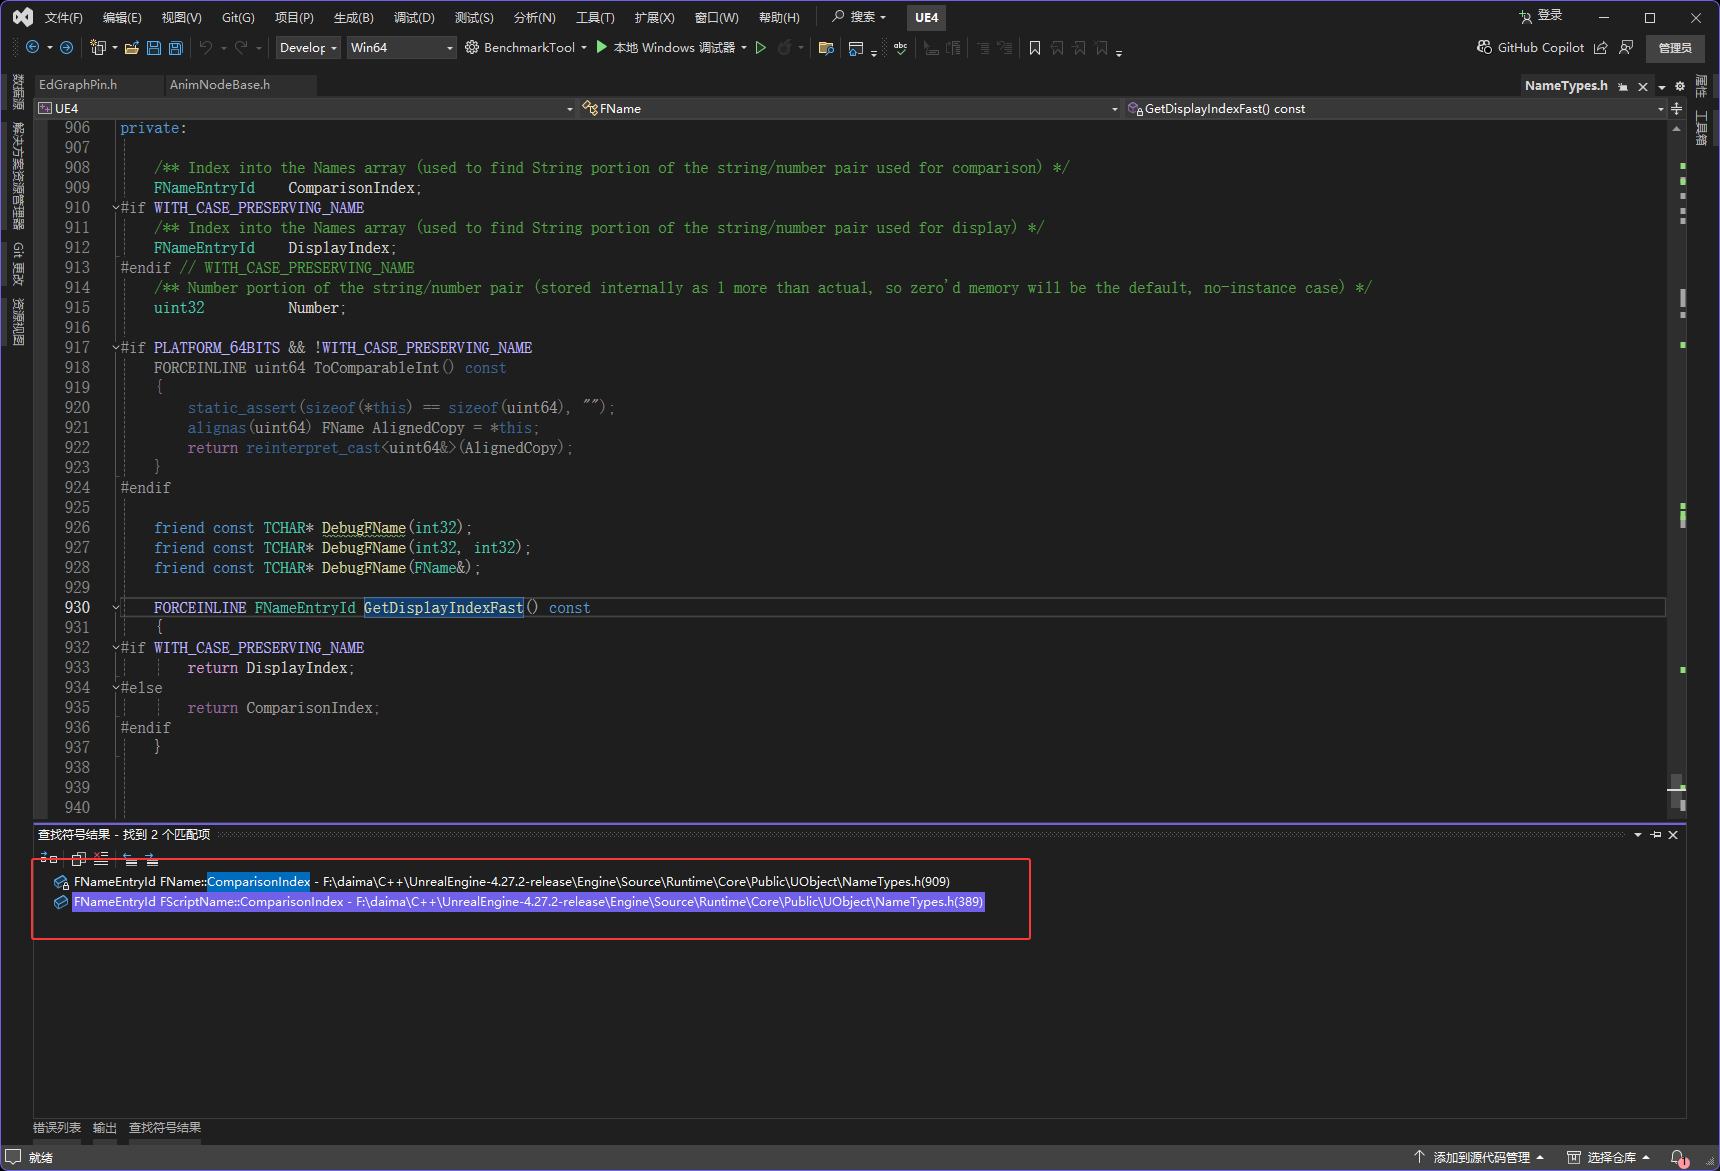
我们要看的是909这一行的
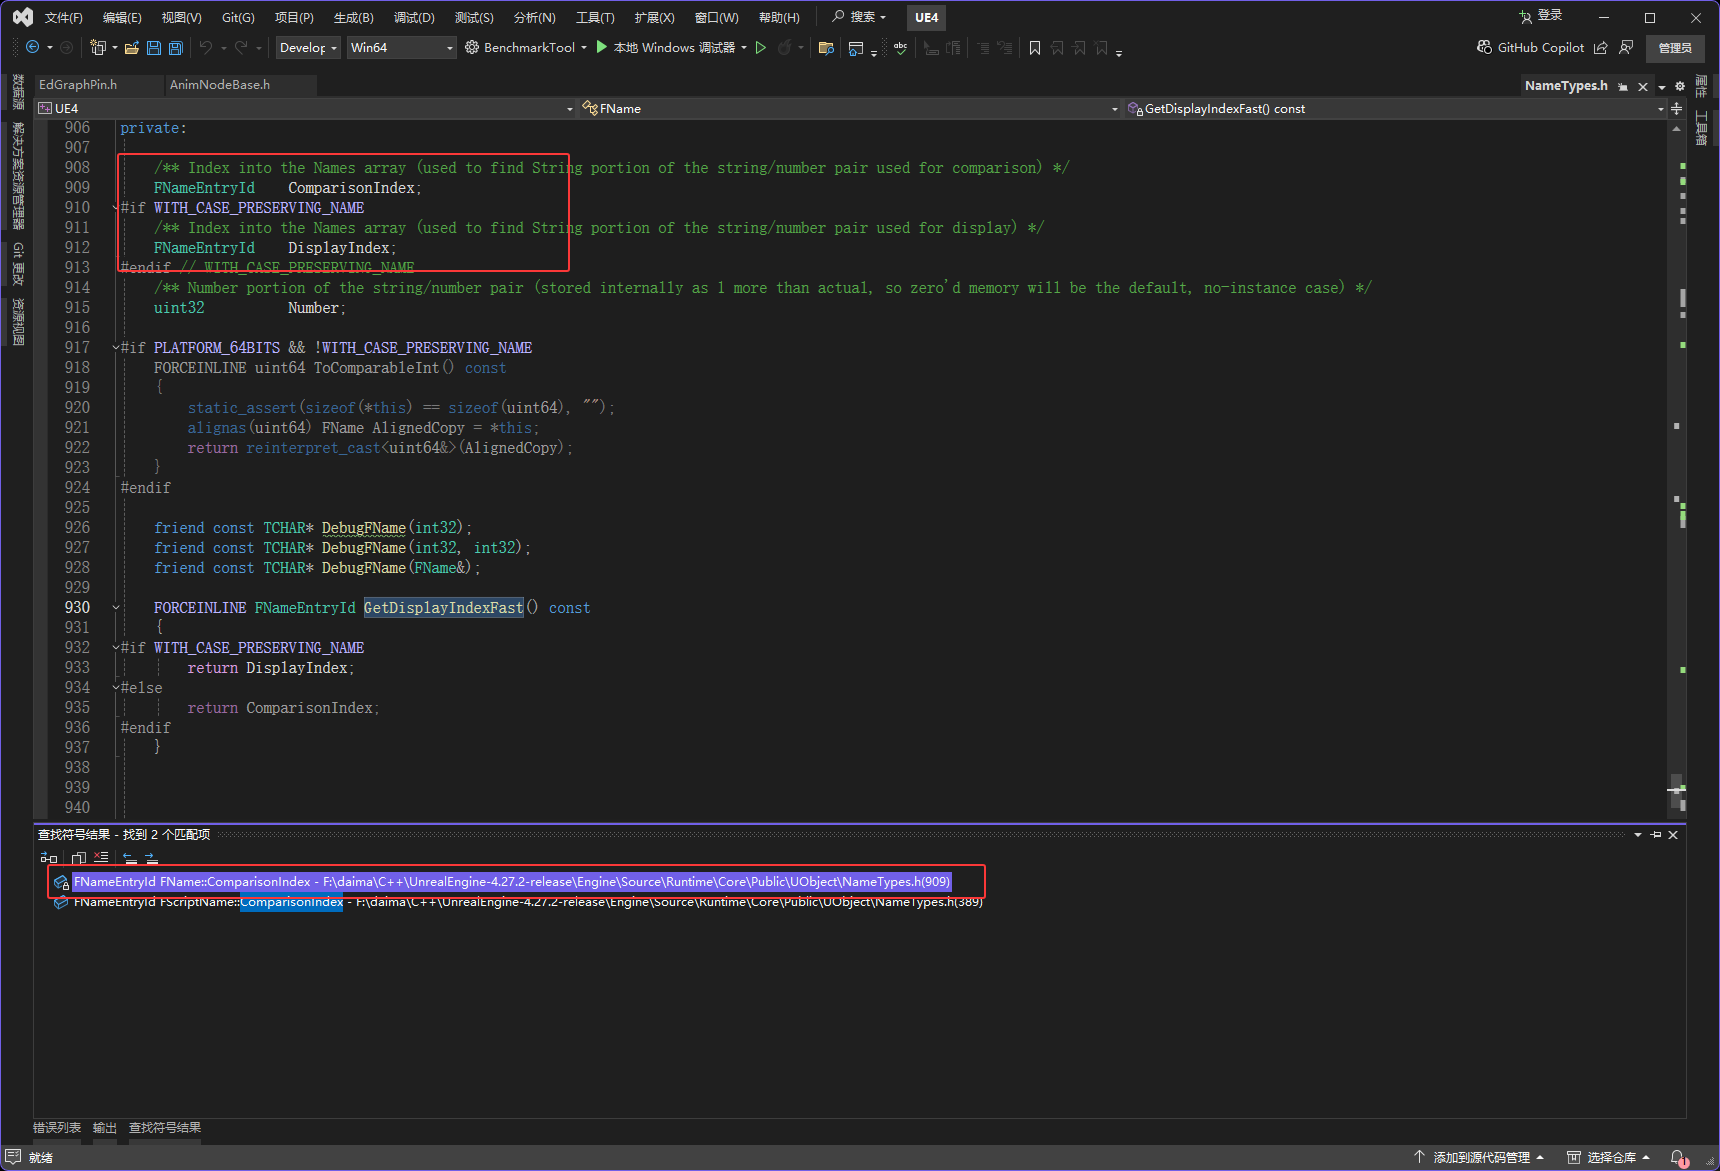
因为909这一行离着我们找到的GetDisplayIndexFast函数最近
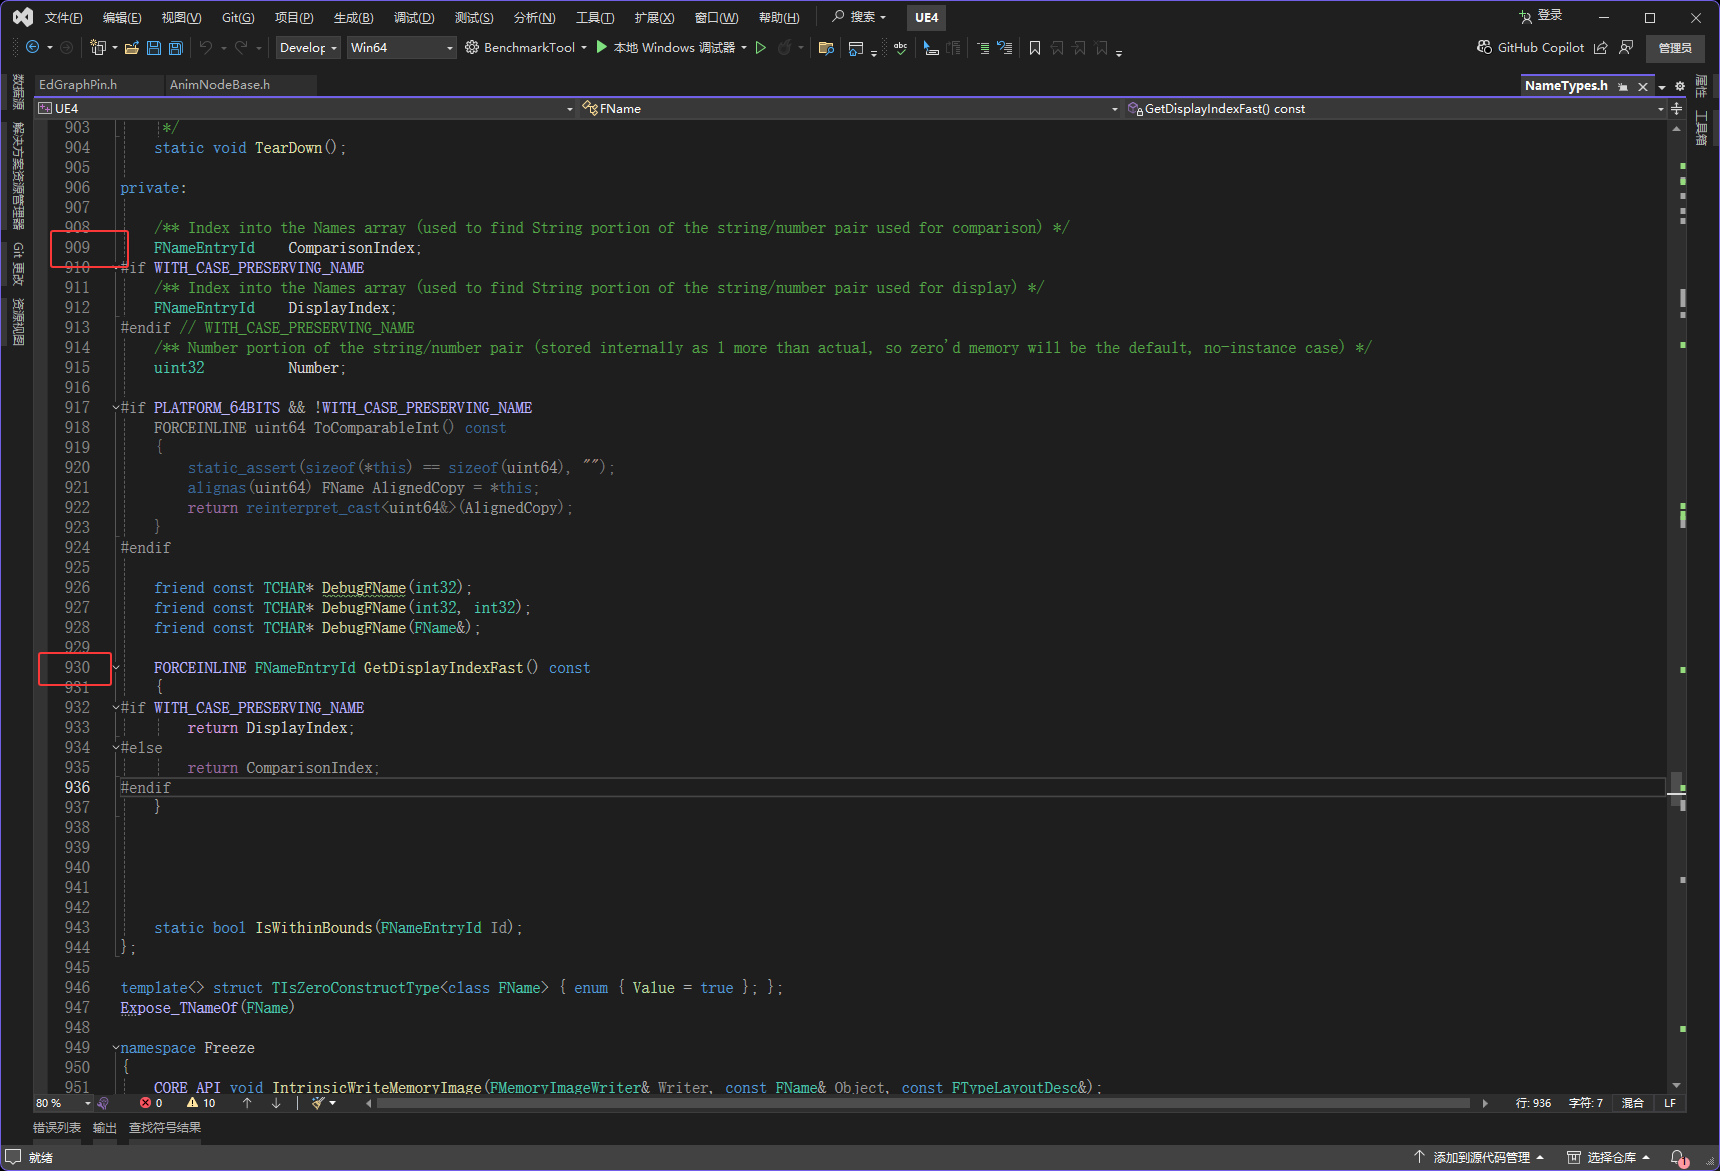
然后ComparisonIndex和DisplayIndex它们的声明都一样的,这俩看哪一个应该都可以,这里看ComparisonIndex
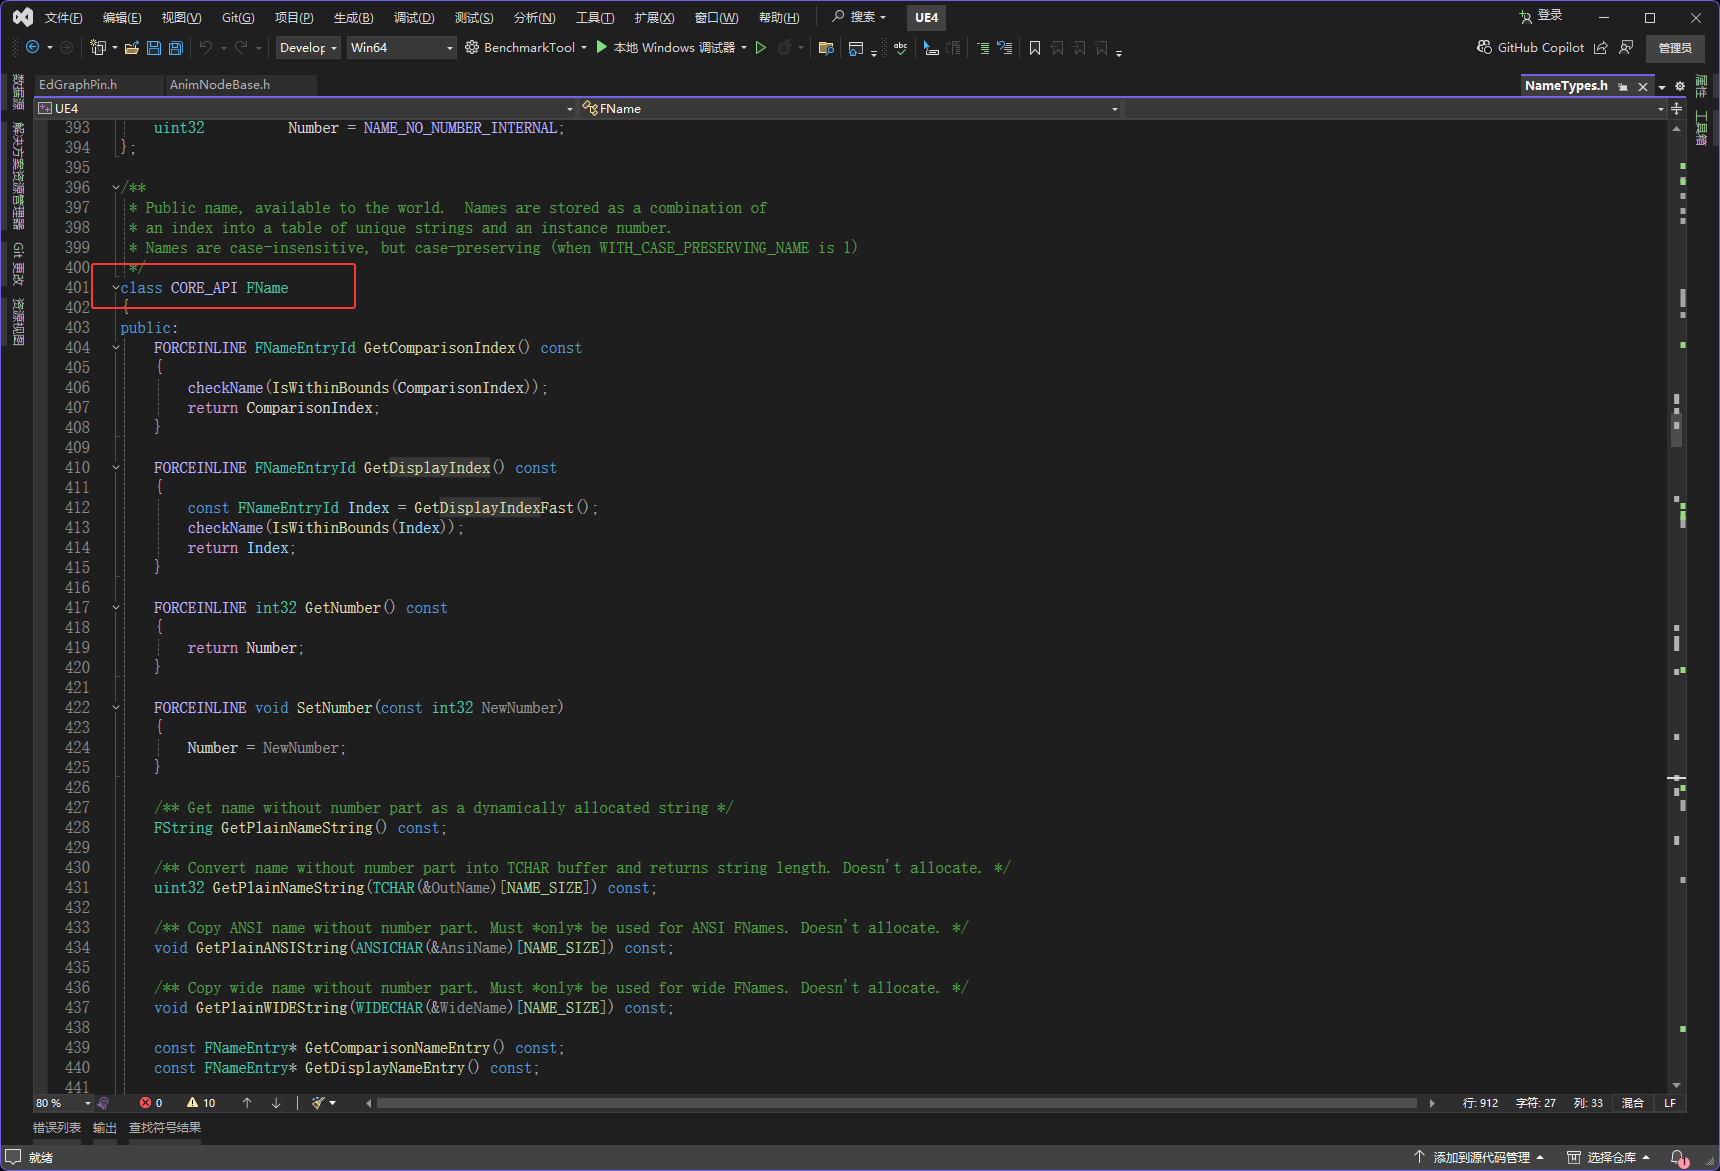
然后ComparisonIndex在FName类里,FName里的代码很长,从下图中可以看到FName在401行,距离ComparisonIndex相差500多行,然后FName里面没有虚函数,ComparisonIndex是FName的第一个成员变量,这就是FName+0x0位置是ComparisonIndex
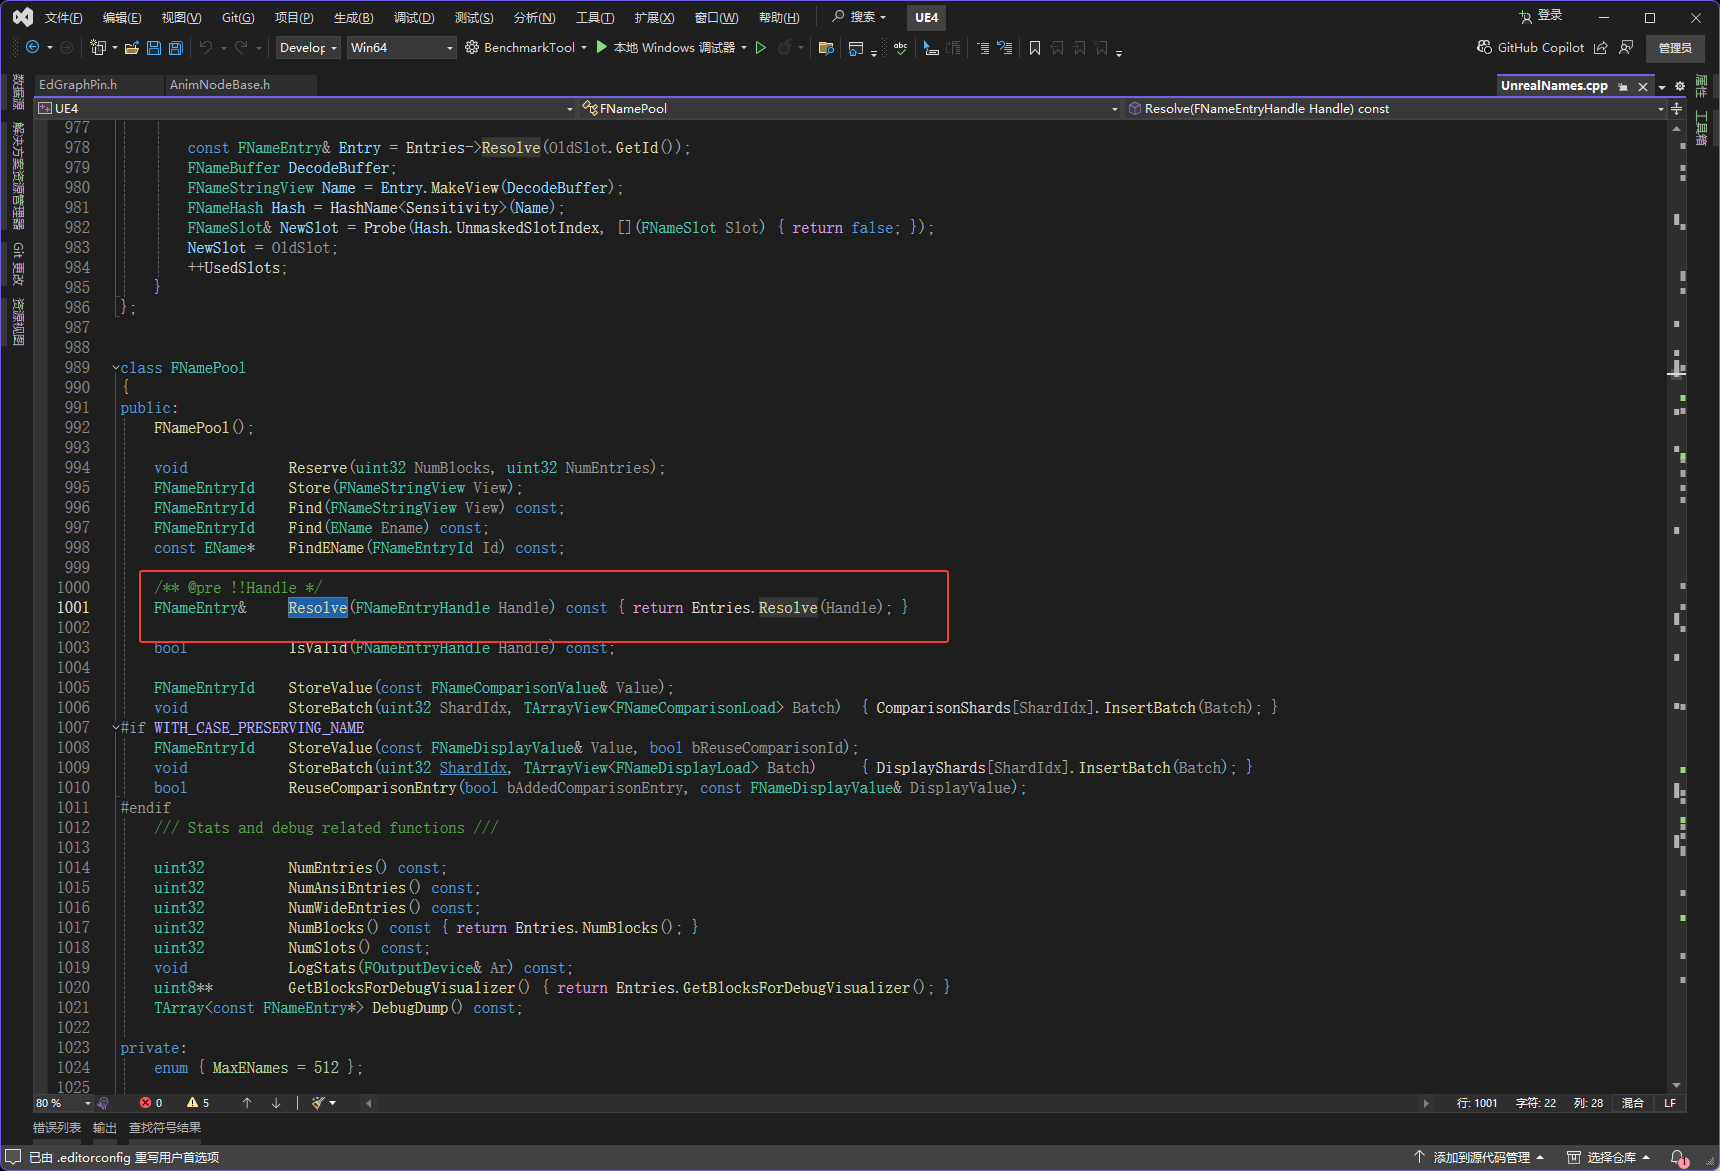
然后GetDisplayIndex就看完了,然后是&GetNamePool().Resolve(GetDisplayIndex())里面的Resolve函数
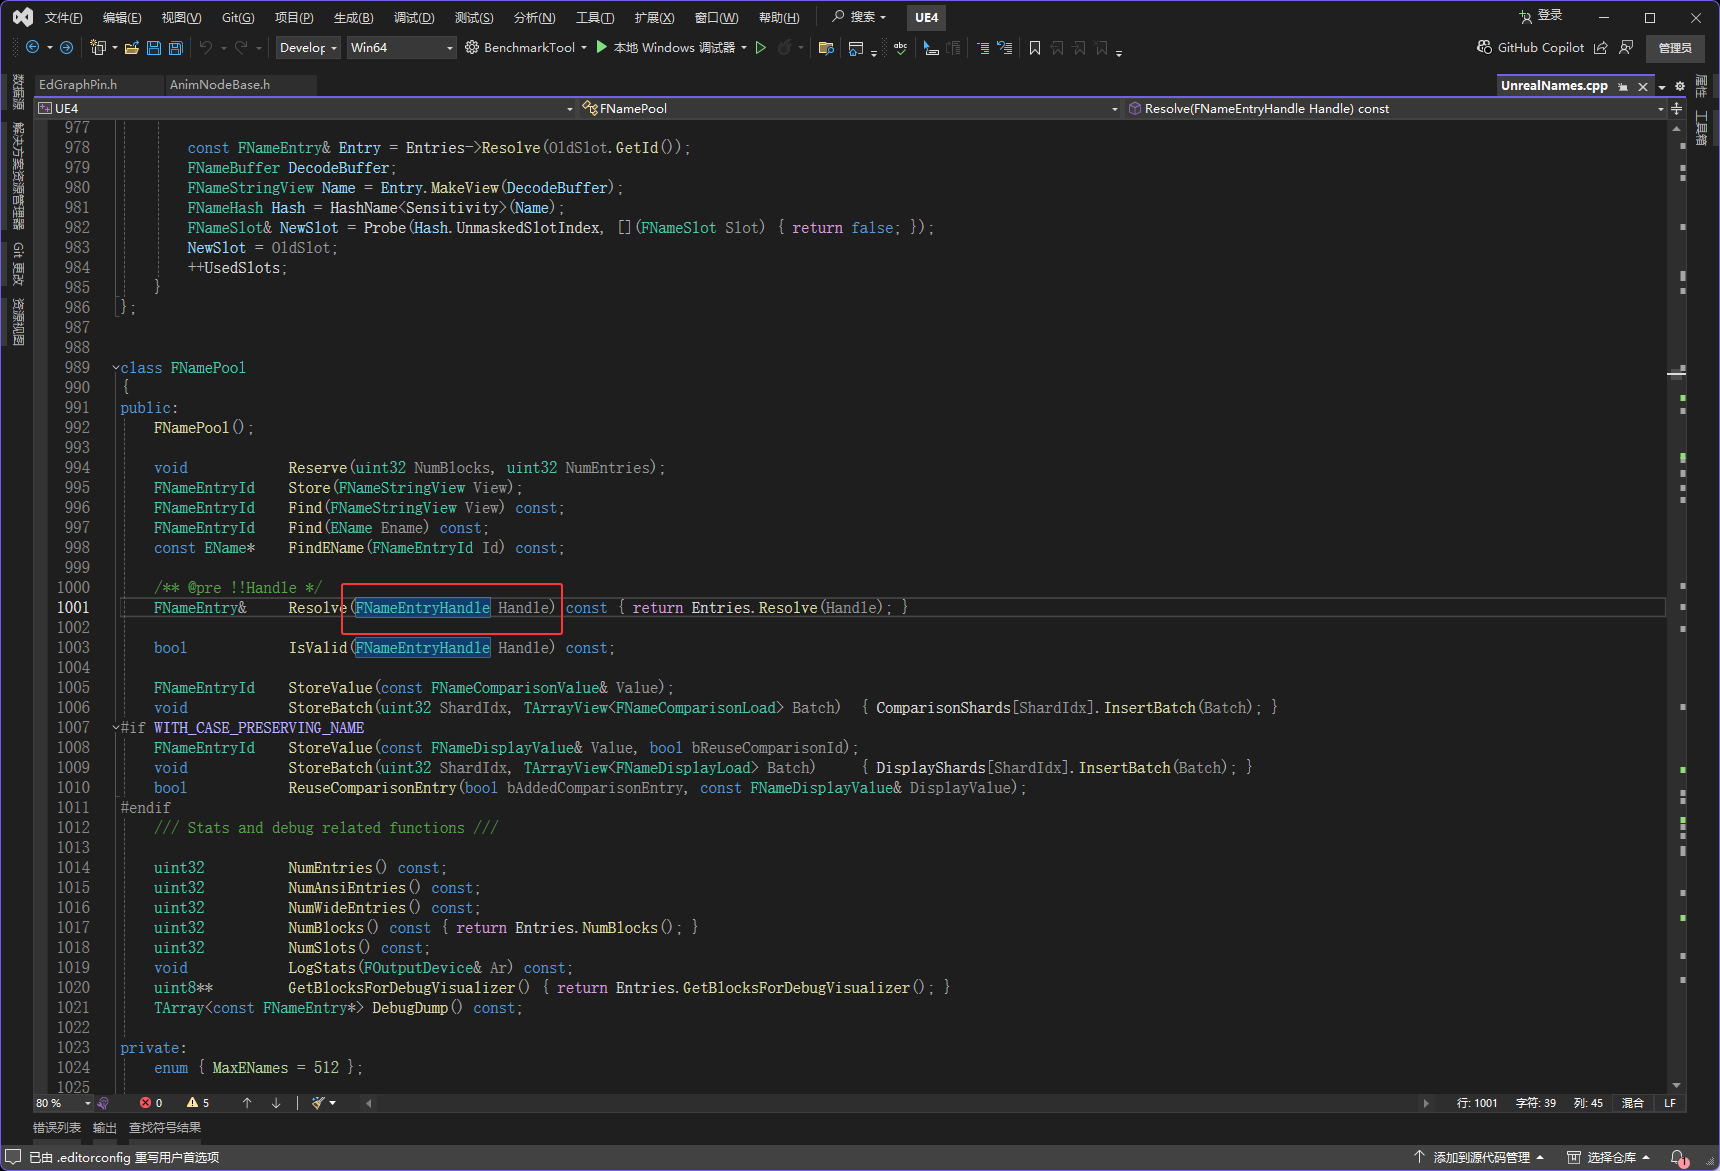
然后它的入参是FNameEntryHandle类型,但是我们给它传的是FNameEntryId类型
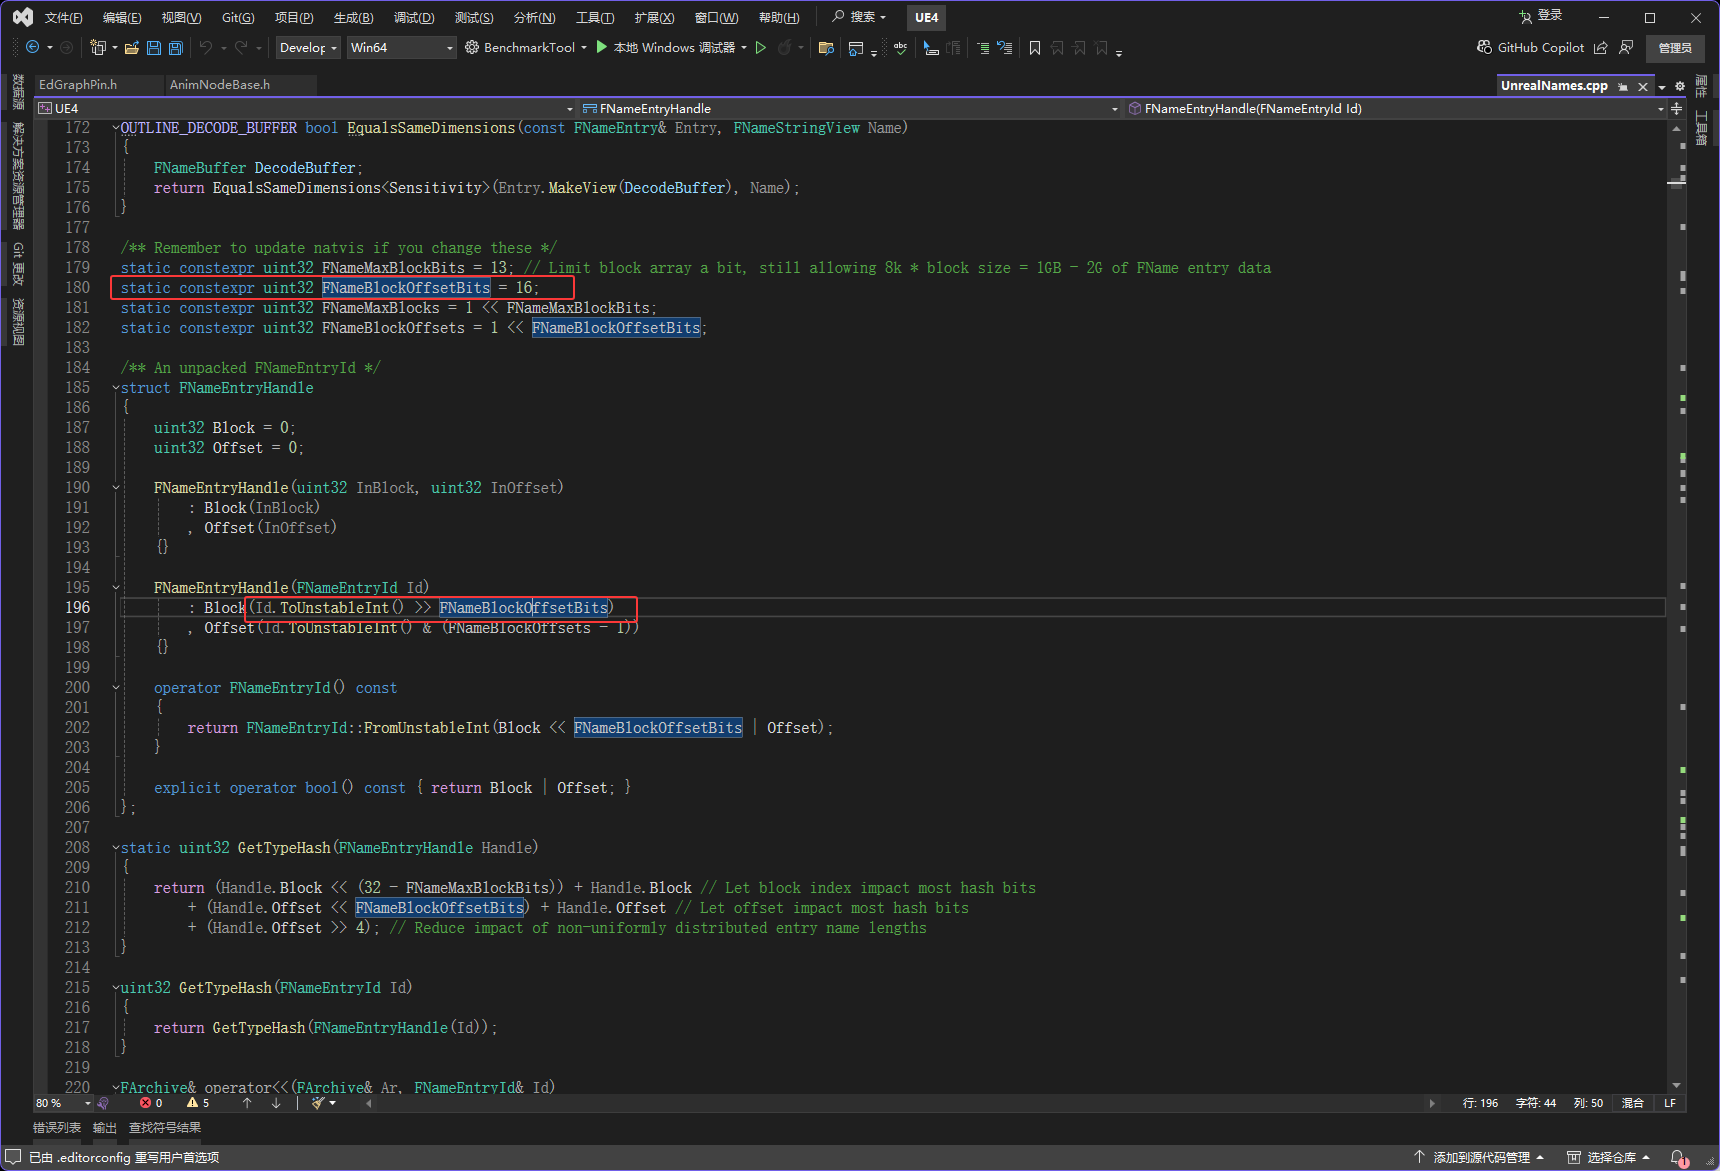
这个类型的转换是在FNameEntryHandle里,通过下图红框FNameEntryHandle的构造函数里转换的
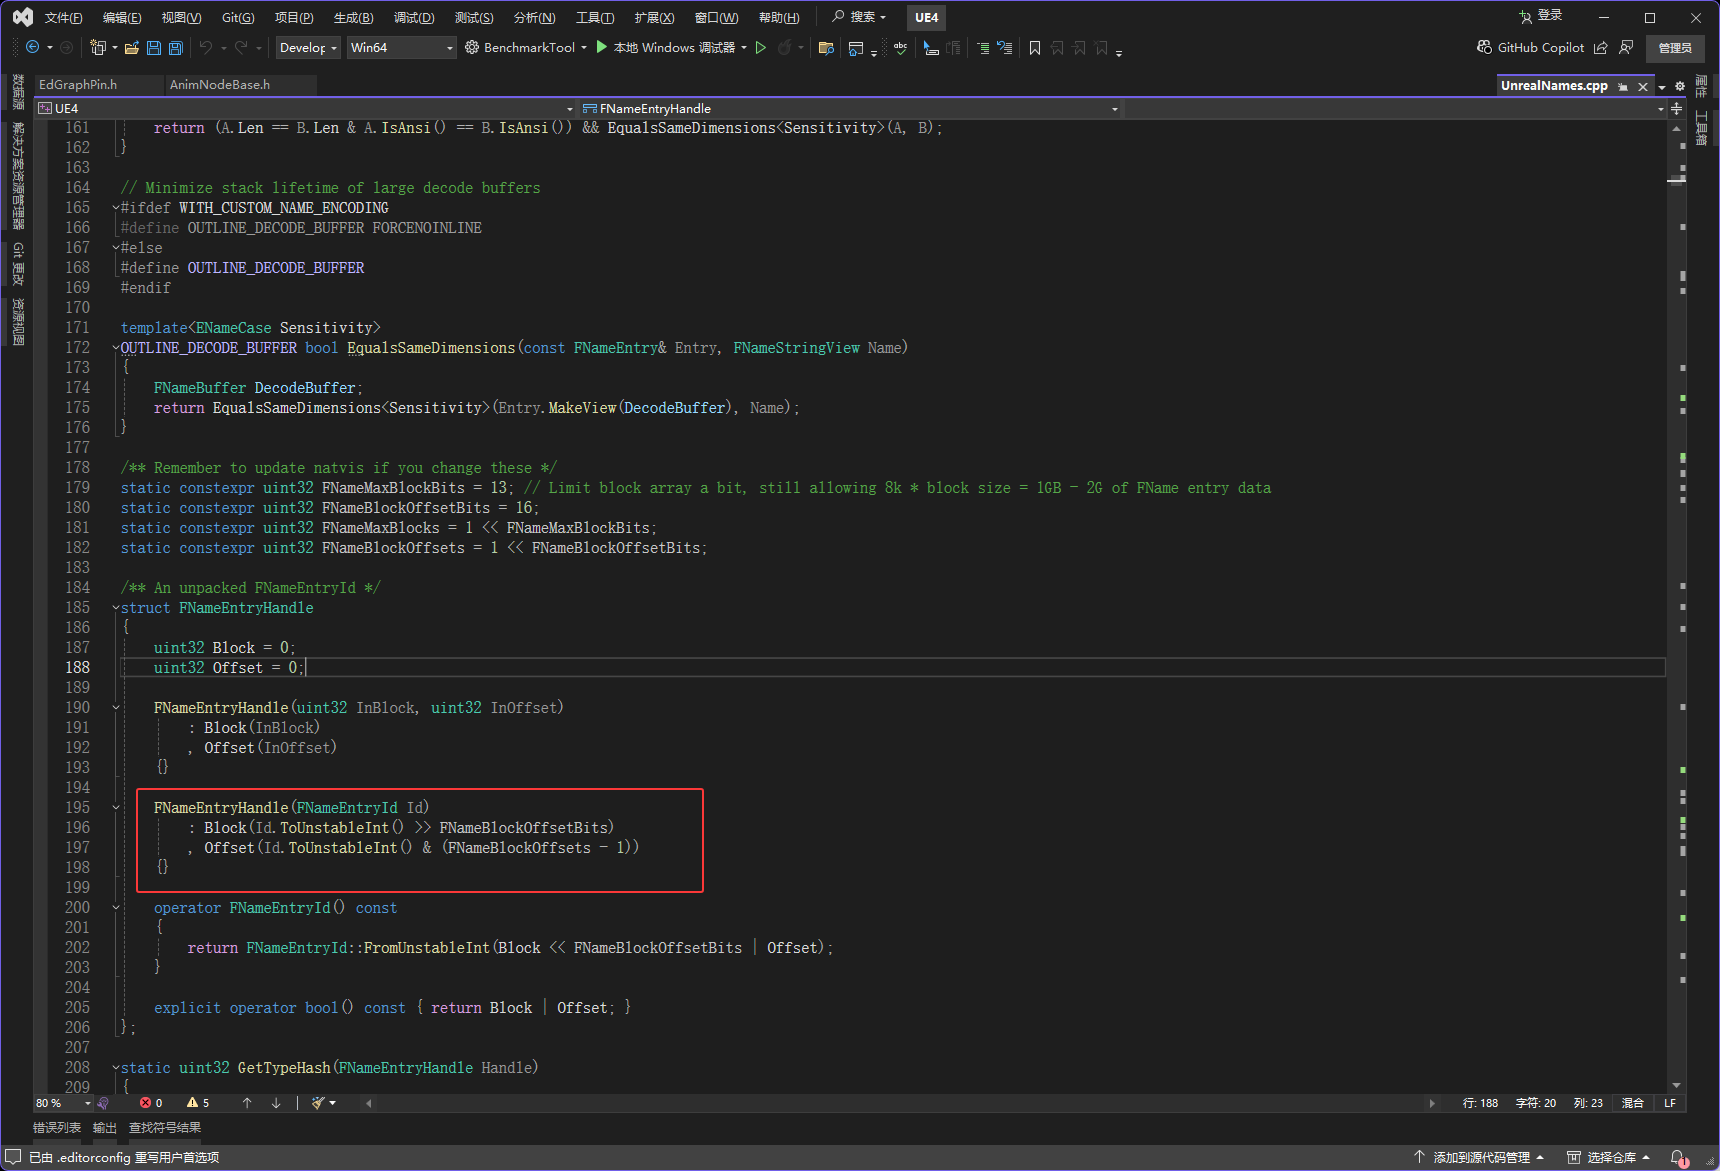
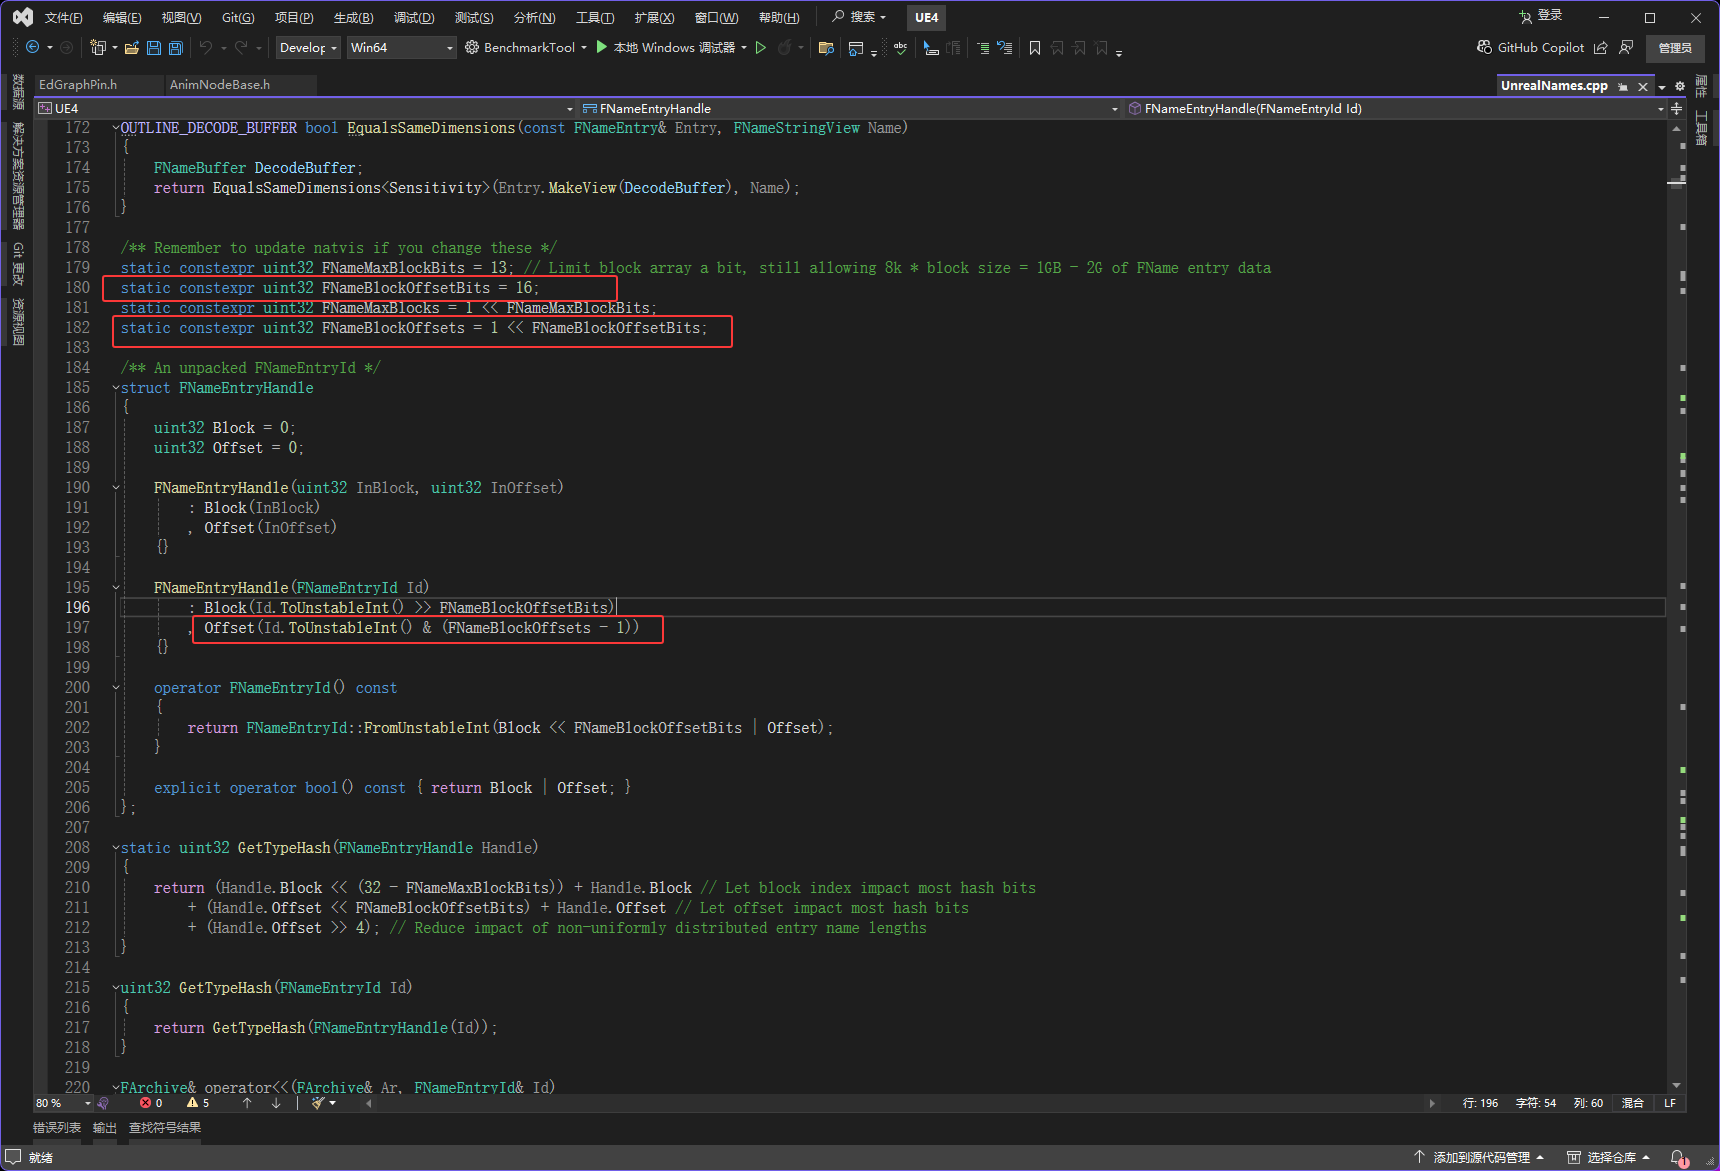
通过Block(Id.ToUnstableInt() >> FNameBlockOffsetBits)这样的写法把值赋值给Block变量,也就是赋值给下图红框的变量
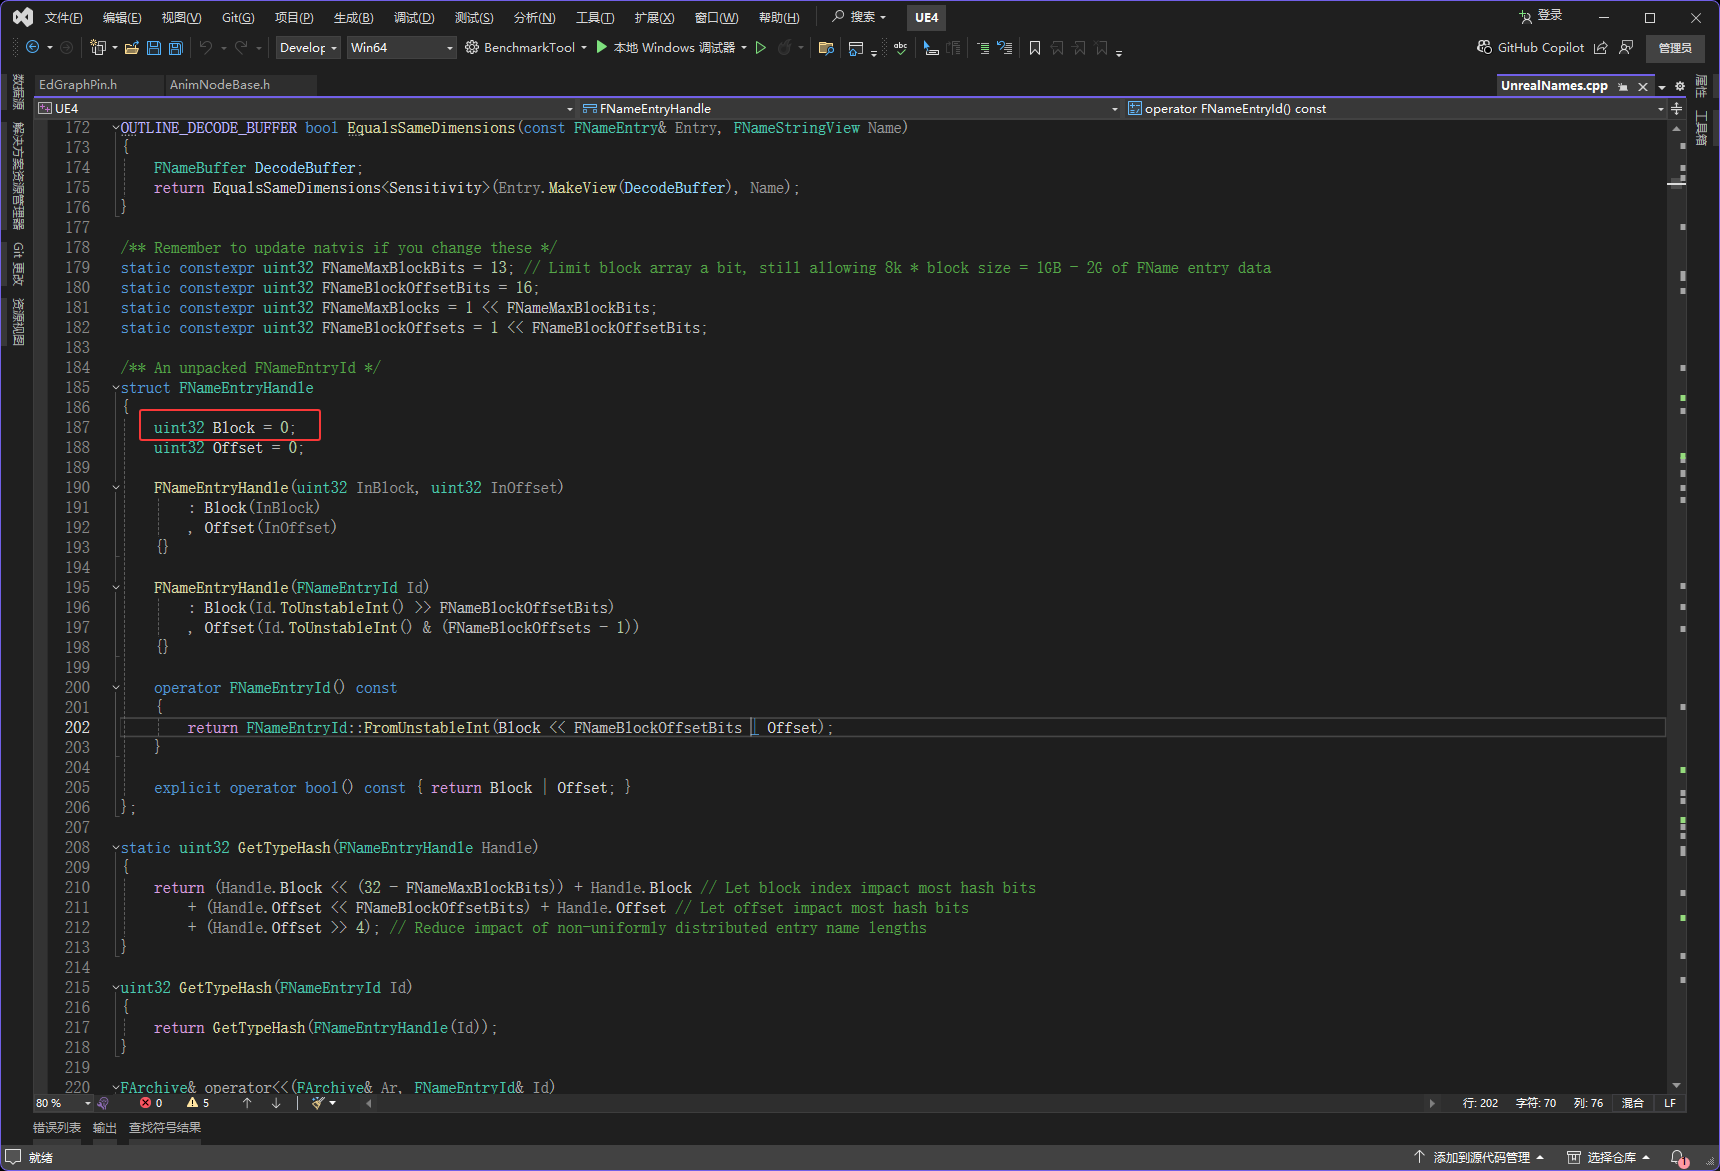
然后通过Offset(Id.ToUnstableInt() & (FNameBlockOffsets - 1))这样的方式赋值给Offset变量,也就是下图红框的变量
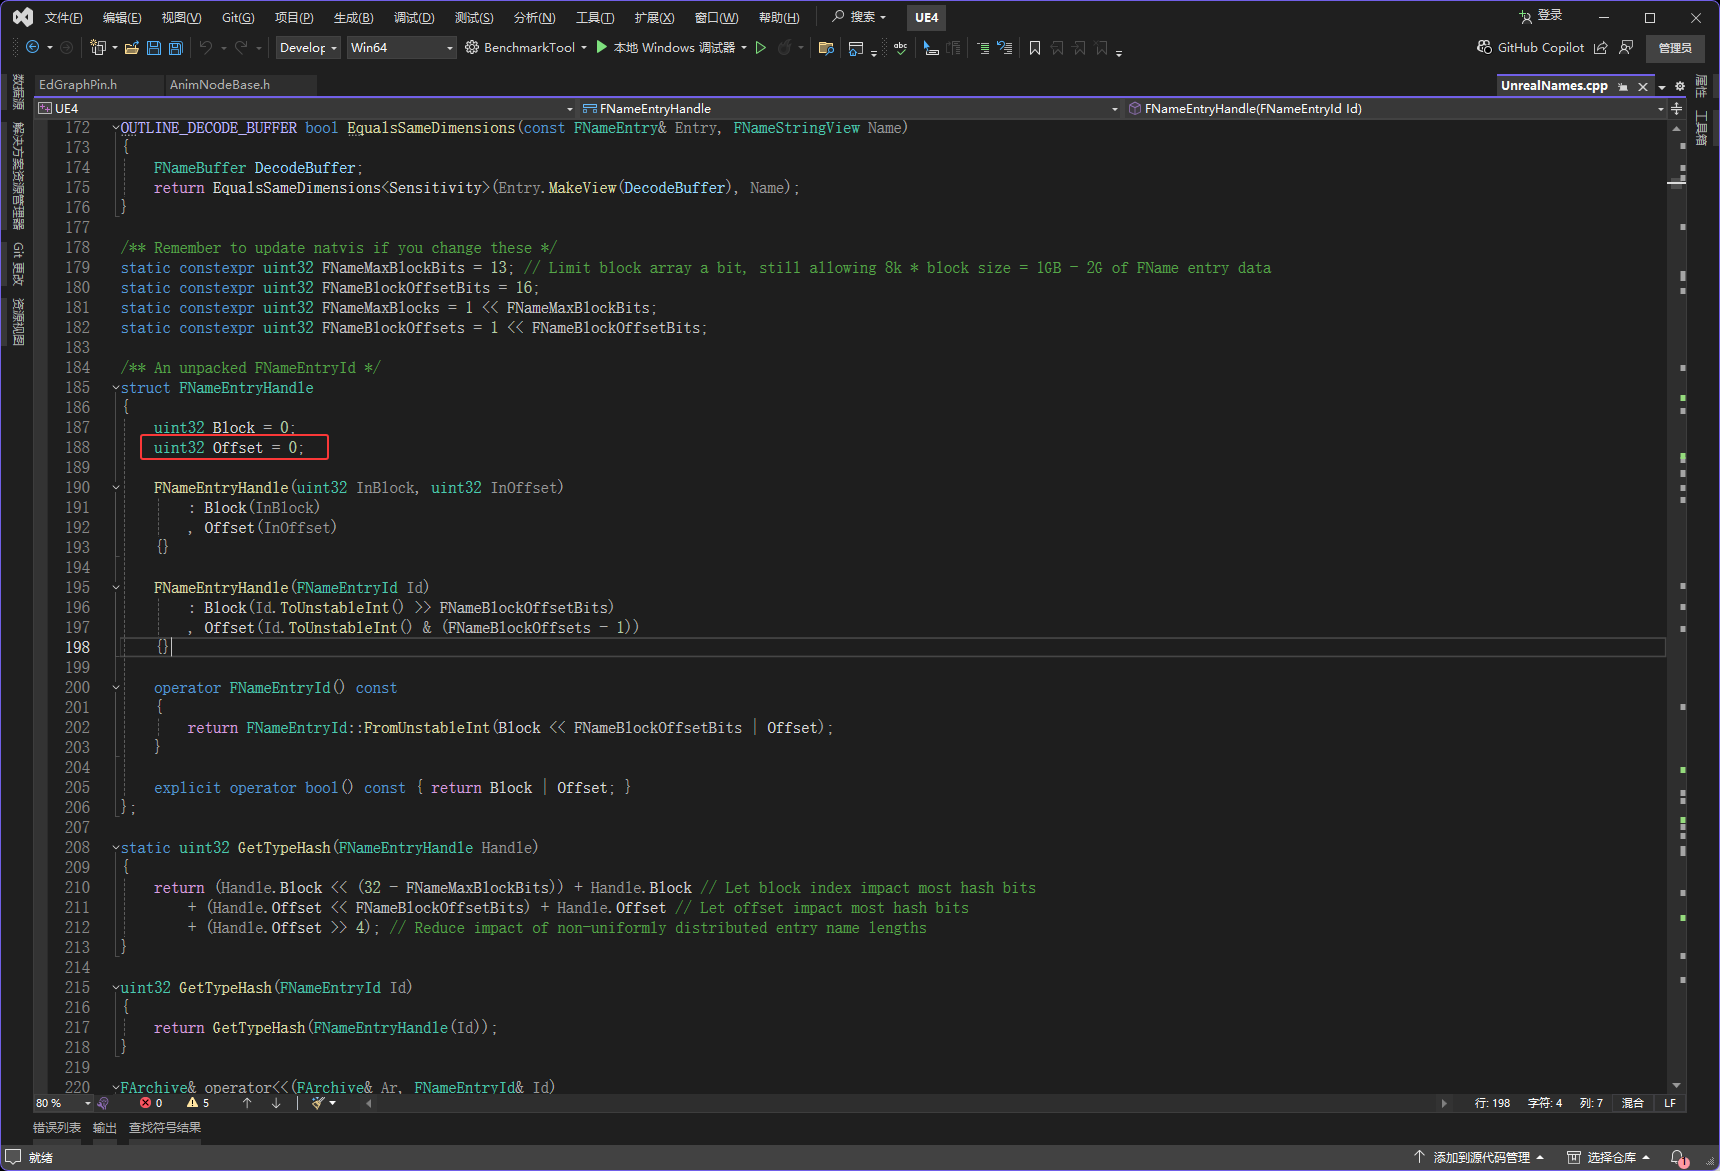
然后下图红框函数
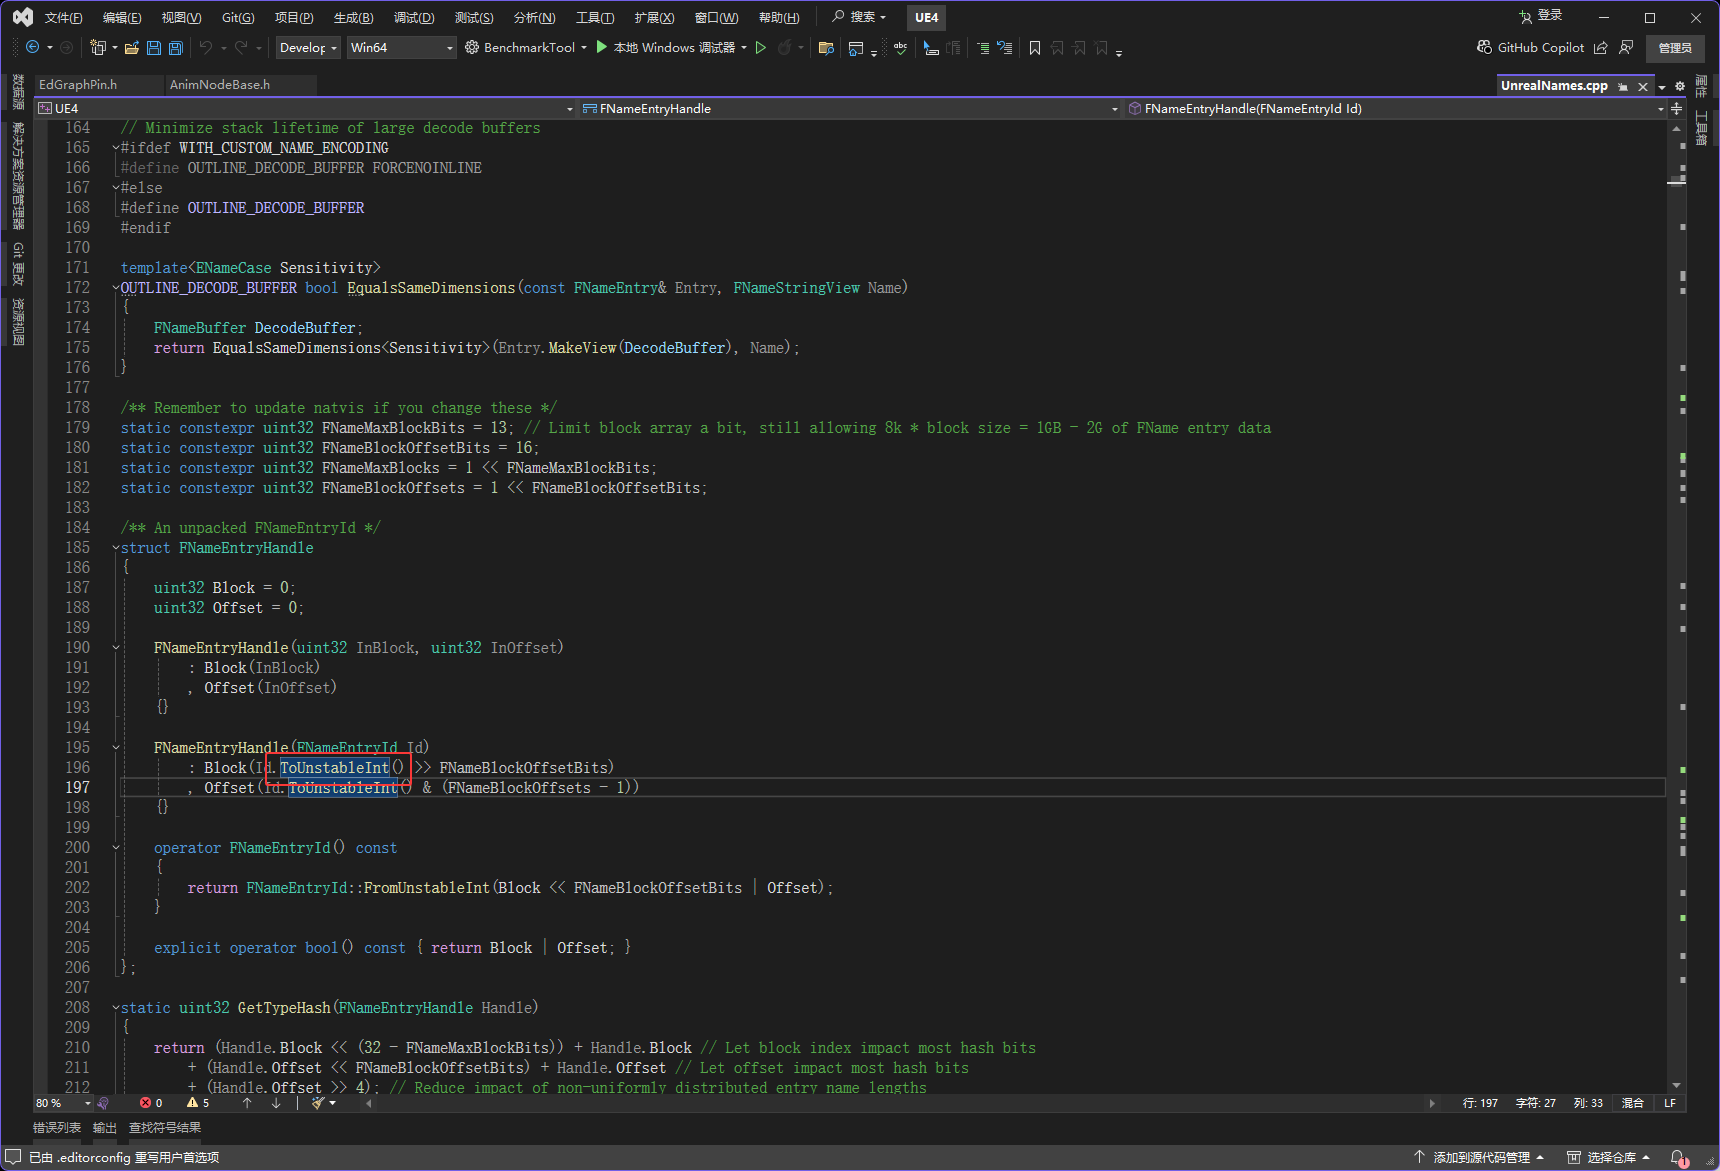
它直接返回了一个Value,也就是一个int
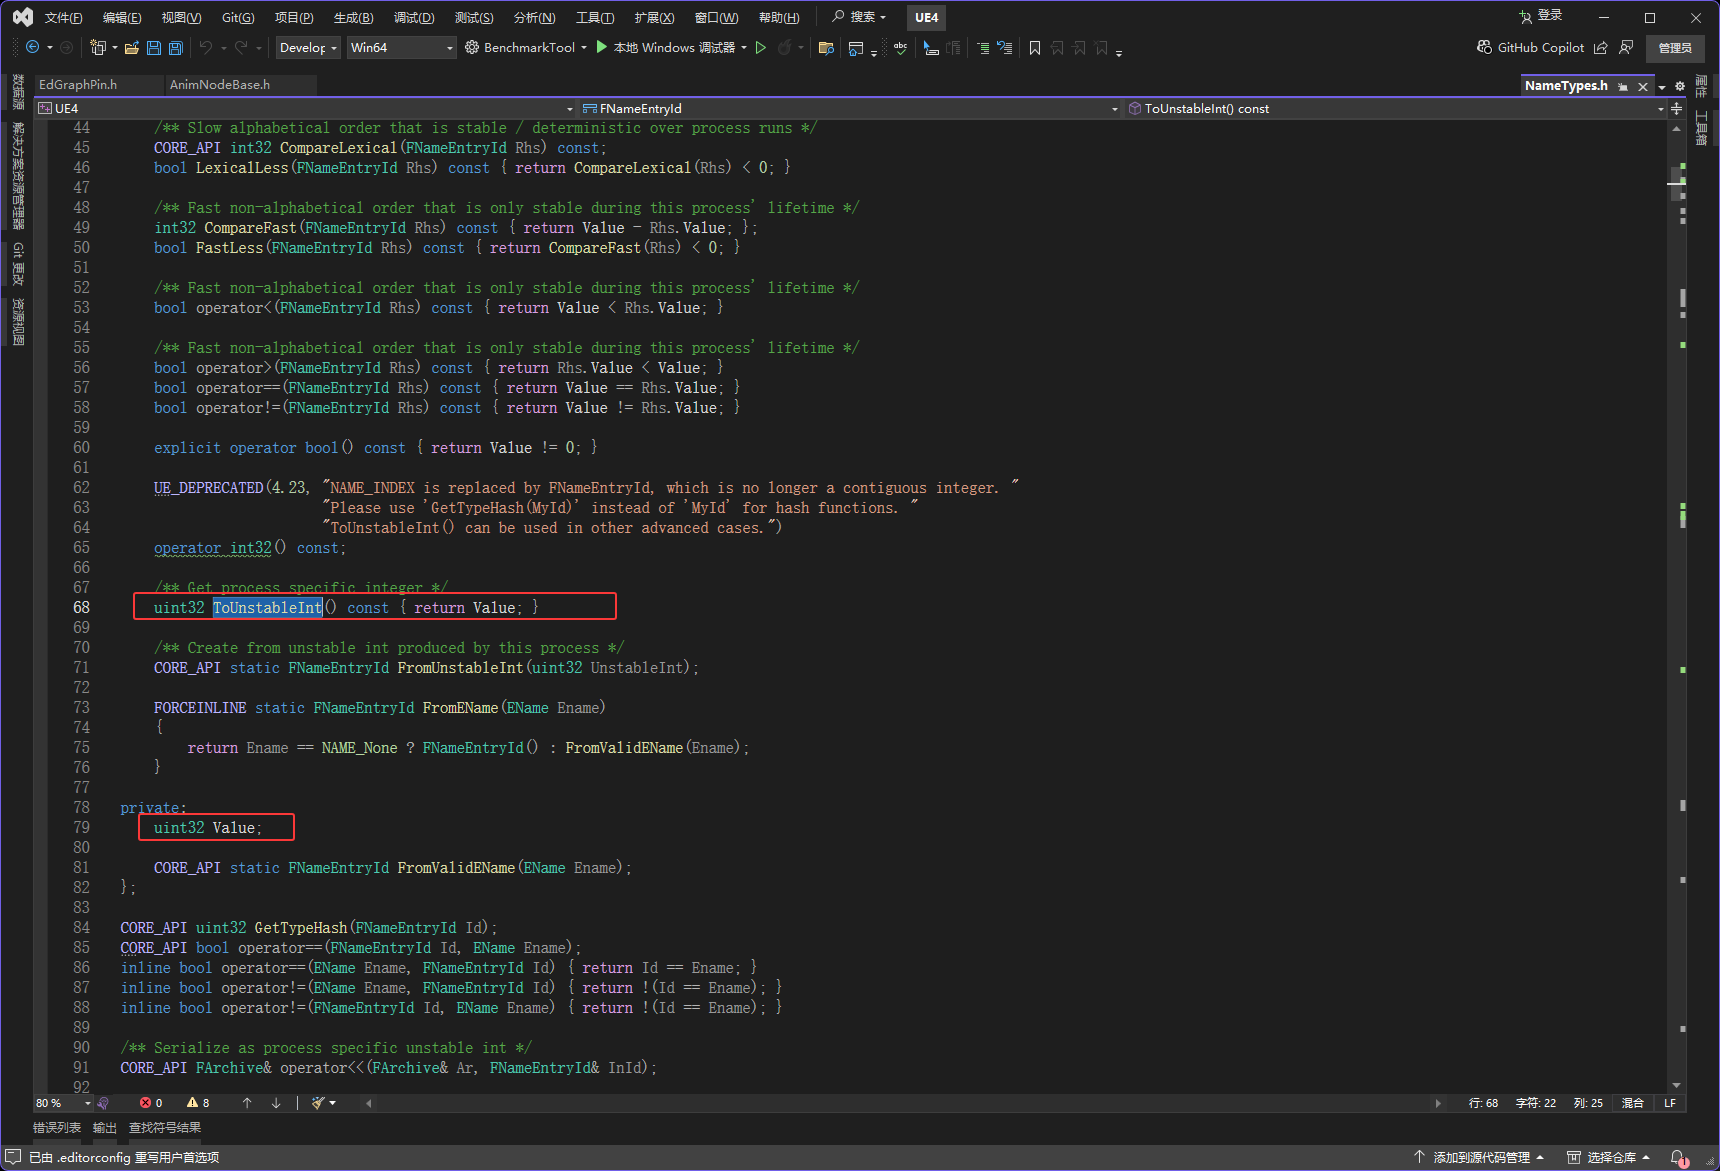
然后还有一个右移的操作,把Id.ToUnstableInt()的值右移16位,比如ToUnstableInt返回的数字的二进制是10000000000000000,它有17位也就是有17个数字,右移16位就变成了00000000000000001,也就是把1右边16个数字全部删除,然后左边补充16个0,从而让它保持17位,然后这是Block的值
然后是Offset的值是先左移(和右移一样只是它俩的操作是反着的,它是删除左边,右边补0),然后还进行一个&运算,&运算是,现在有两个二进制一个是100010,另一个是100000,经过&运算会变成100000,也就是都是1才是1
然后FNameEntryId转FNameEntryHandle就看完了,然后是Entries.Resolve(Handle)里的Resolve
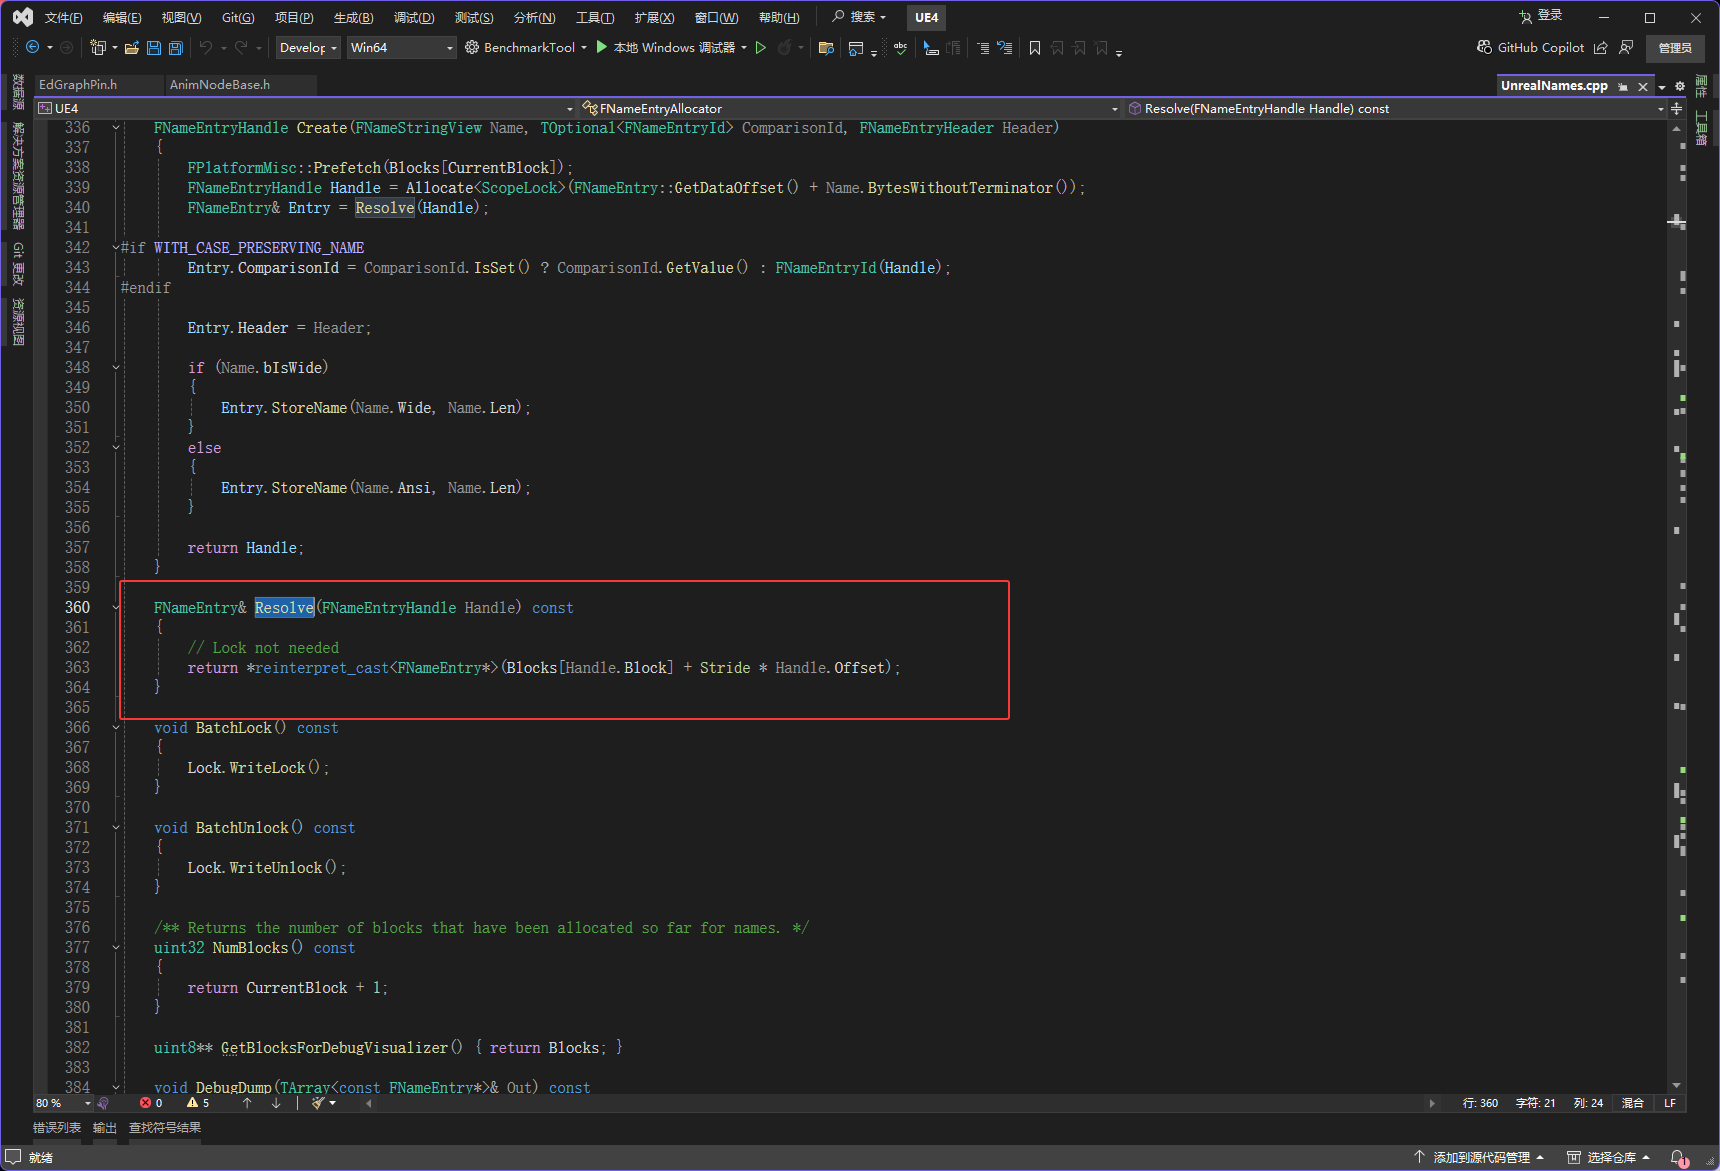
代码说明
// 通过 FNameEntryHandle(句柄)查找并返回对应的 FNameEntry(字符串条目)引用
// 作用:将“块索引+块内偏移”的定位信息转换为实际的字符串条目,是名字池中获取条目数据的核心函数
// 参数:Handle - 包含 Block(块索引)和 Offset(块内偏移)的定位句柄
FNameEntry& Resolve(FNameEntryHandle Handle) const
{
	// Lock not needed(无需加锁)
	// 原因:此函数通常在单线程上下文调用,或名字池已通过其他机制保证线程安全,
	// 省去加锁解锁的开销以提升性能(FName操作是高频场景,性能至关重要)

	// 计算 FNameEntry 在内存中的实际地址:
	// 1. Blocks[Handle.Block] → 获取第 Handle.Block 个“块”的起始内存地址(类似“第N个书架的第一个格子地址”)
	// 2. Stride * Handle.Offset → 计算块内偏移量:Stride 是每个 FNameEntry 占用的内存大小(类似“每个格子的宽度”),
	//    乘以 Offset(第几个格子)得到从块起始地址到目标条目的距离
	// 3. 两者相加 → 目标 FNameEntry 的内存地址(书架起始地址 + 格子距离 = 具体格子地址)
	// 4. reinterpret_cast<FNameEntry*> → 将计算出的地址转换为 FNameEntry 指针(告诉编译器这是一个字符串条目的地址)
	// 5. * → 解引用指针,得到 FNameEntry 的引用(直接操作条目数据)
	return *reinterpret_cast<FNameEntry*>(Blocks[Handle.Block] + Stride * Handle.Offset);
}
然后是下图红框的两个值的来源
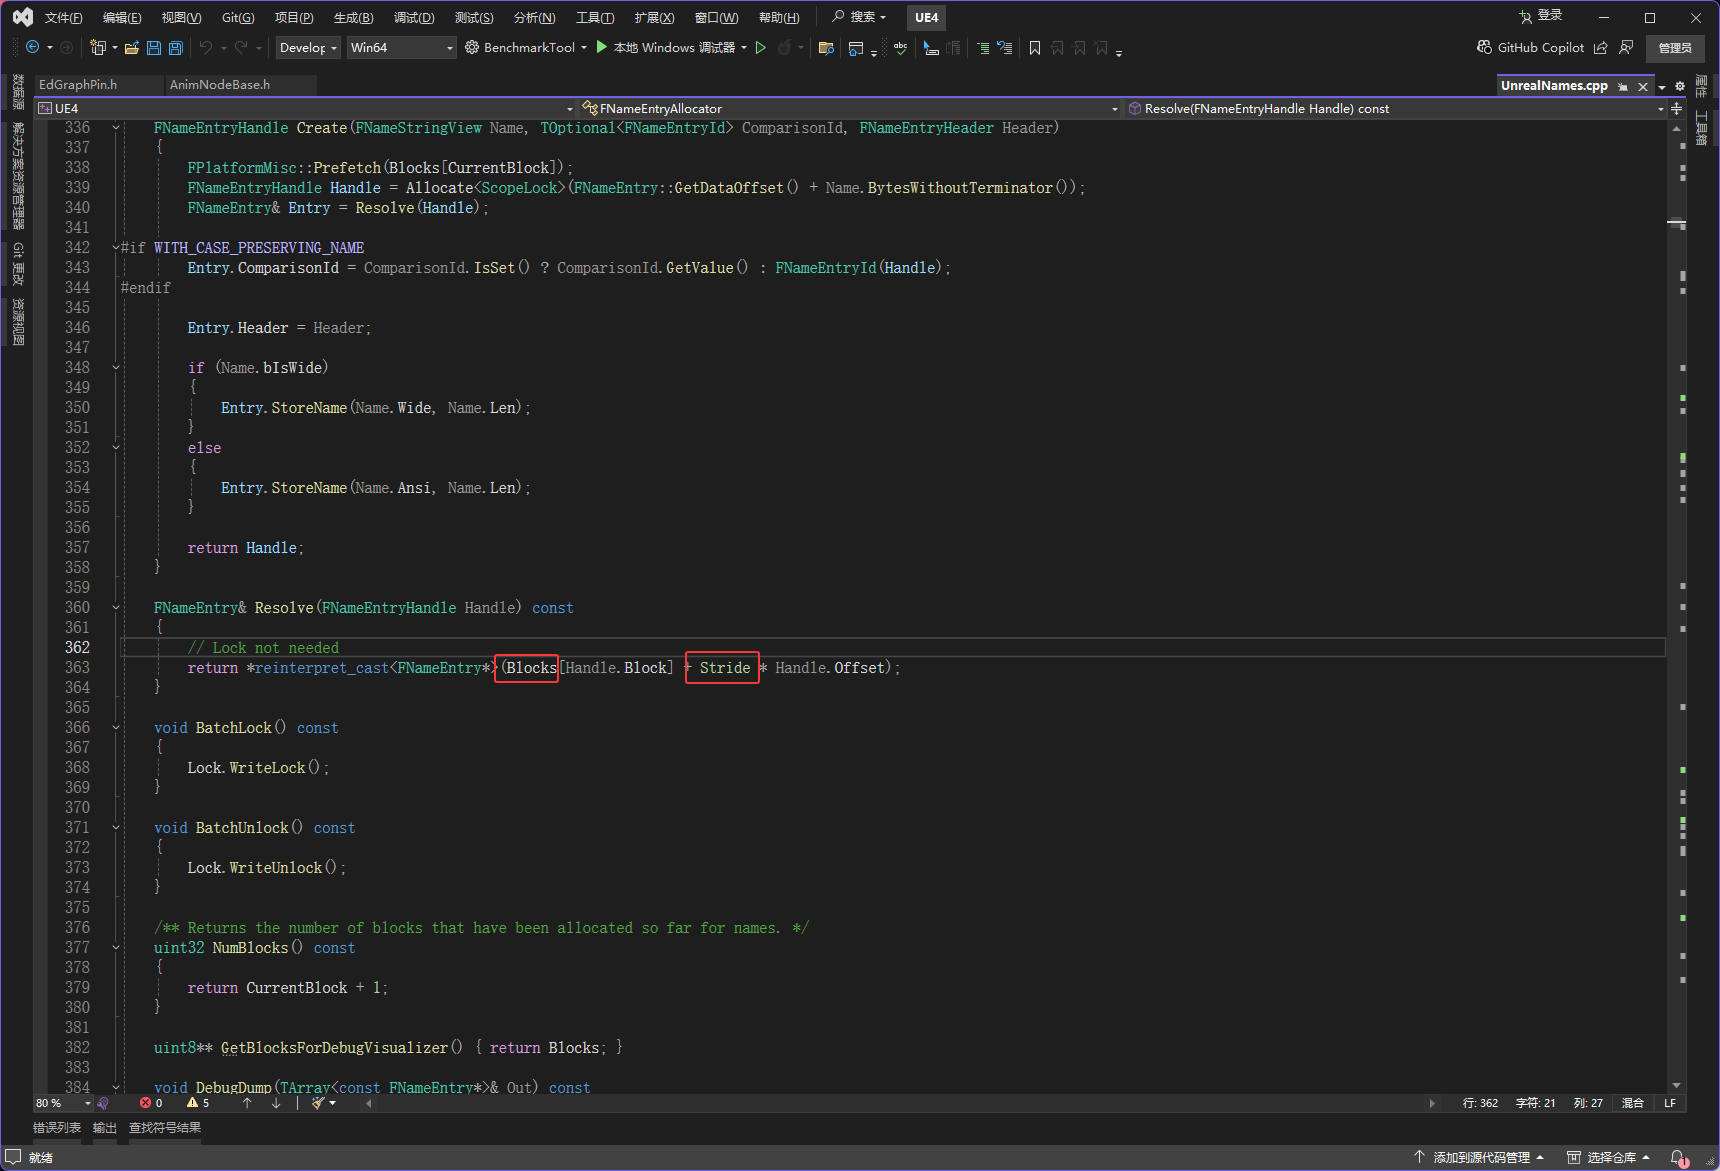
Stride的值取决于FNameEntry类型的大小
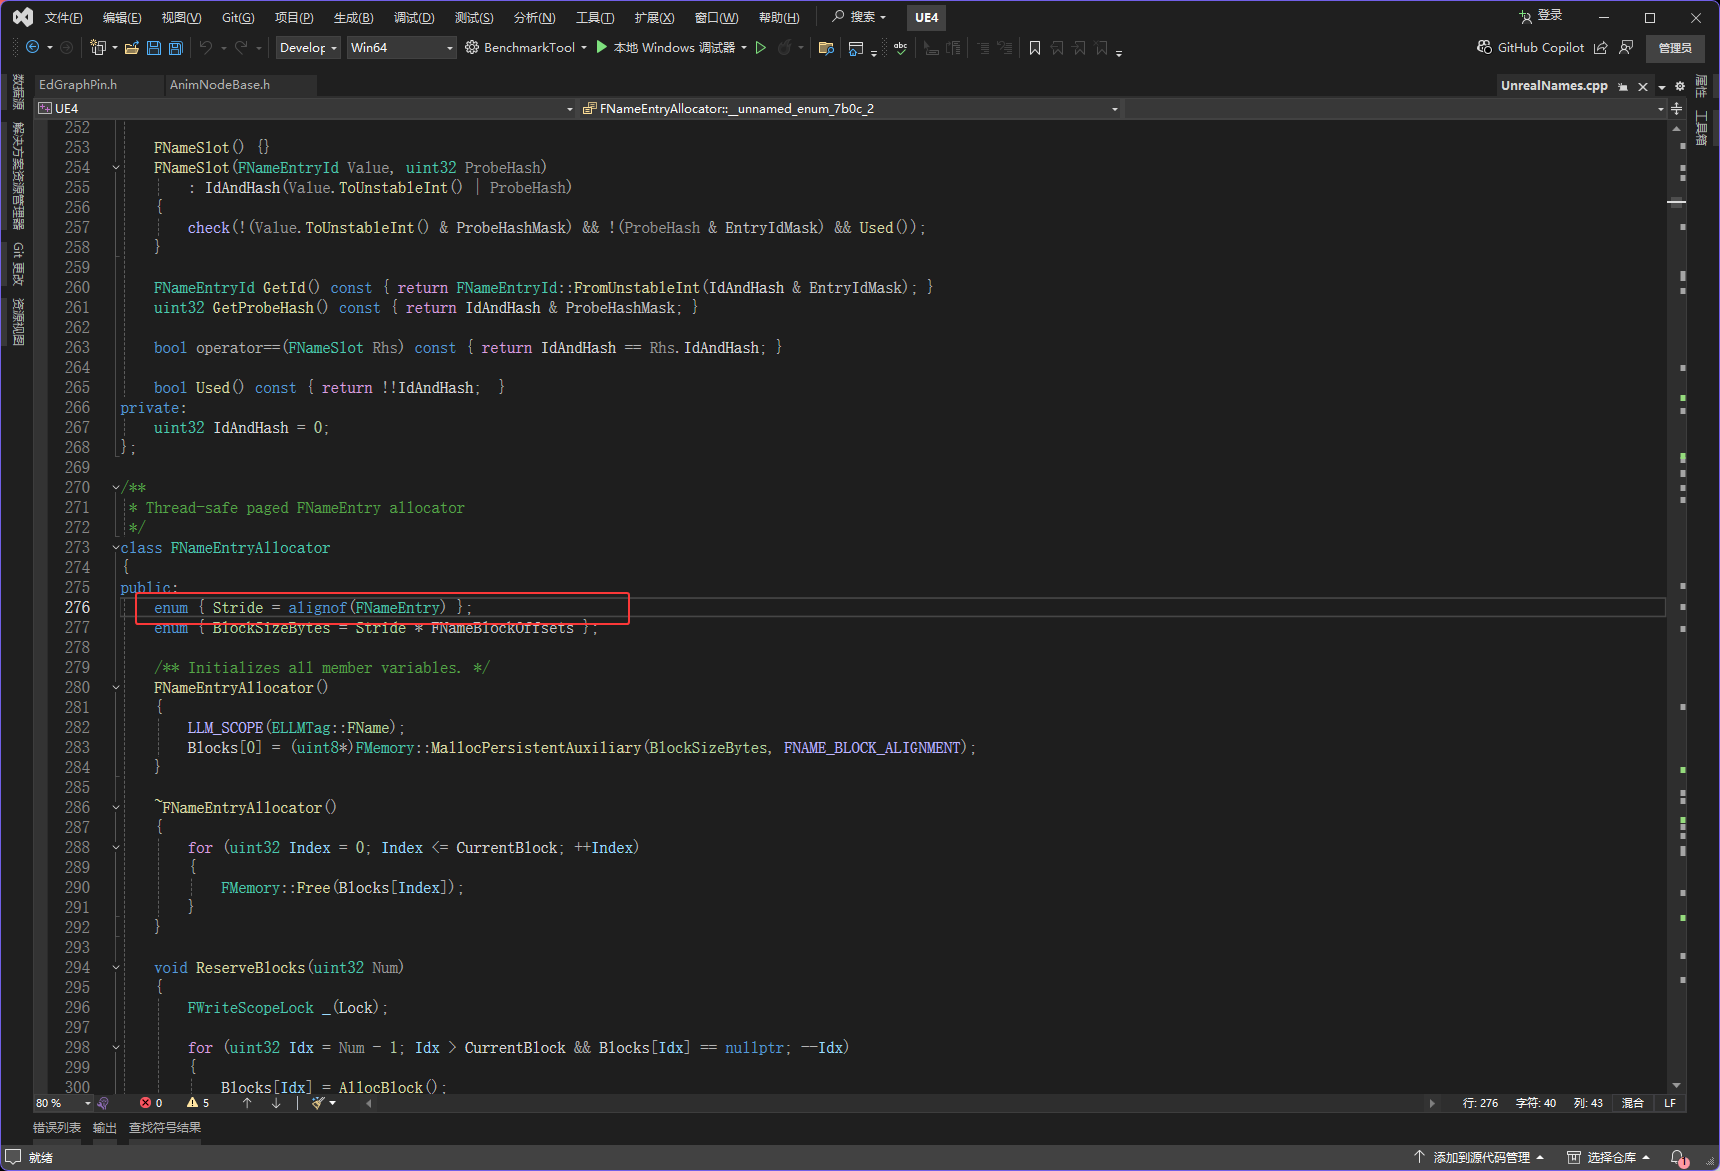
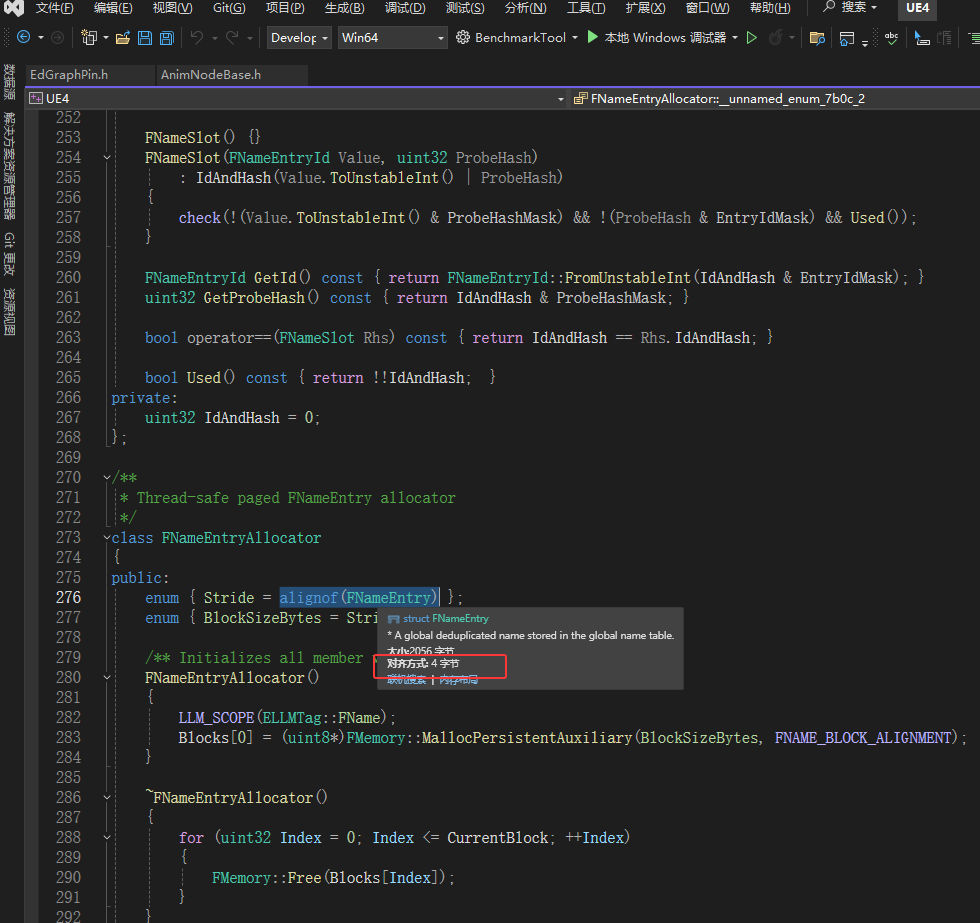
是4字节,Stride的值就是4
然后是Blocks的值,它存储了游戏中所有的字符串,也就是在游戏中看到的文字
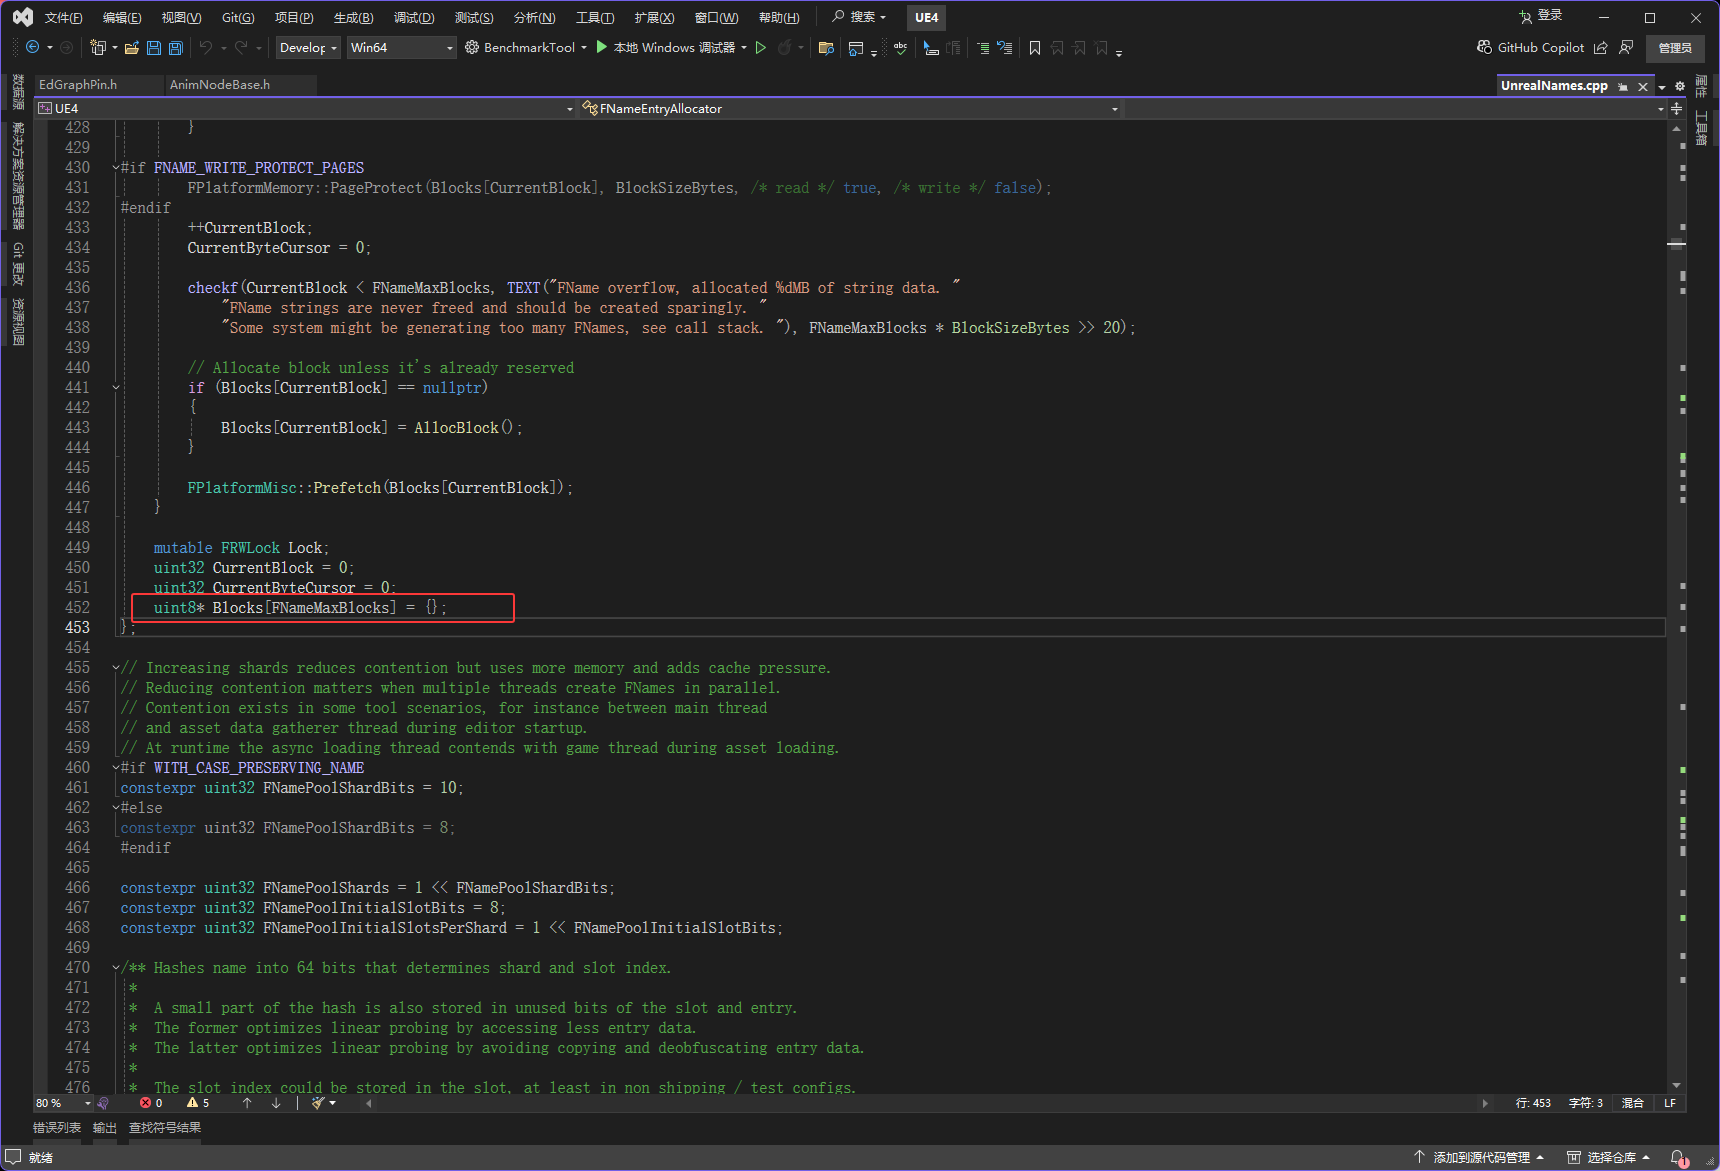
代码说明
// 这行代码定义了一个“块地址数组”,是名字池(FNamePool)管理分块存储的核心结构
// 作用:像“图书馆的书架地址目录”一样,记录所有存储字符串条目的“块”在内存中的起始位置
uint8* Blocks[FNameMaxBlocks] = {};


// 小白版逐句解释:
// 1. uint8* → “指向内存字节的指针”
//    - 可以理解为“内存地址”(比如0x123456),指向一块连续的内存空间的开头
//    - 这里每个指针都对应一个“块”(Block)的起始地址(类似“第3个书架从图书馆的哪个位置开始”)


// 2. Blocks → 数组的名字,意思是“所有块的集合”
//    - 你可以把它想象成一本“目录册”,每一页记录一个块的起始地址


// 3. [FNameMaxBlocks] → 数组的大小
//    - FNameMaxBlocks 是一个固定的数字(比如1024),表示这个目录册最多能记录多少个块的地址
//    - 相当于“图书馆最多能放1024个书架”,目录册就只有1024页


// 4. = {} → 初始化数组,把所有指针都设为“空”(nullptr)
//    - 刚创建名字池时,还没有任何块,所以目录册的所有页面都是空白的
//    - 防止指针指向随机的无效内存(避免程序崩溃)


// 为什么需要这个数组?
// 名字池里的字符串条目(FNameEntry)太多了,被分成了很多“块”(比如每个块存65536个条目)。
// 当需要找某个条目时:
// 1. 先通过 FNameEntryHandle 知道它在“第2个块”(Handle.Block = 2)
// 2. 查这个 Blocks 数组,Blocks[2] 就是第2个块的起始地址(比如0x789000)
// 3. 再用块内偏移(Handle.Offset)算出具体位置,就能快速找到条目

// 简单说:这个数组就是“块的地址目录”,让程序不用瞎找,直接按索引拿地址,速度飞快!
Blocks和Stride它们都在FNameEntryAllocator类中
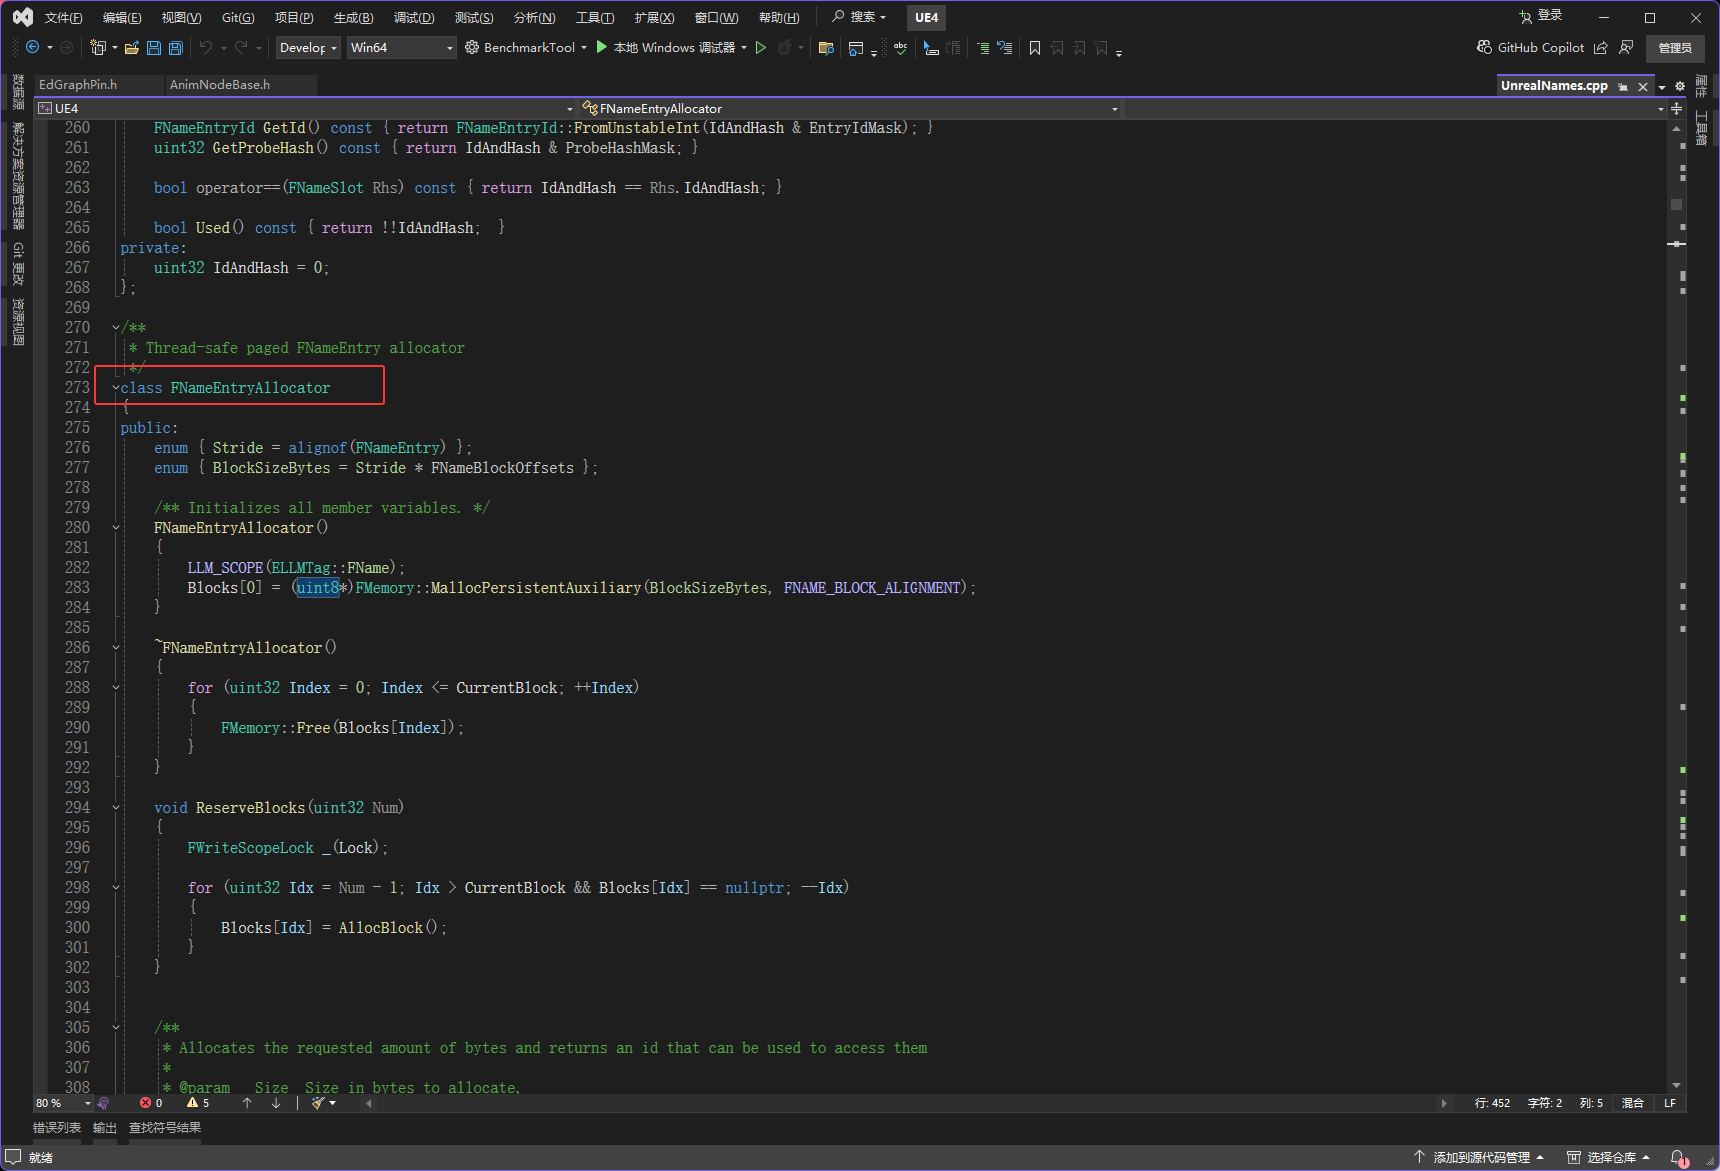
然后Blocks是比较重要的,然后它的偏移,在Blocks前面有下图红框的变量,它的大小是8
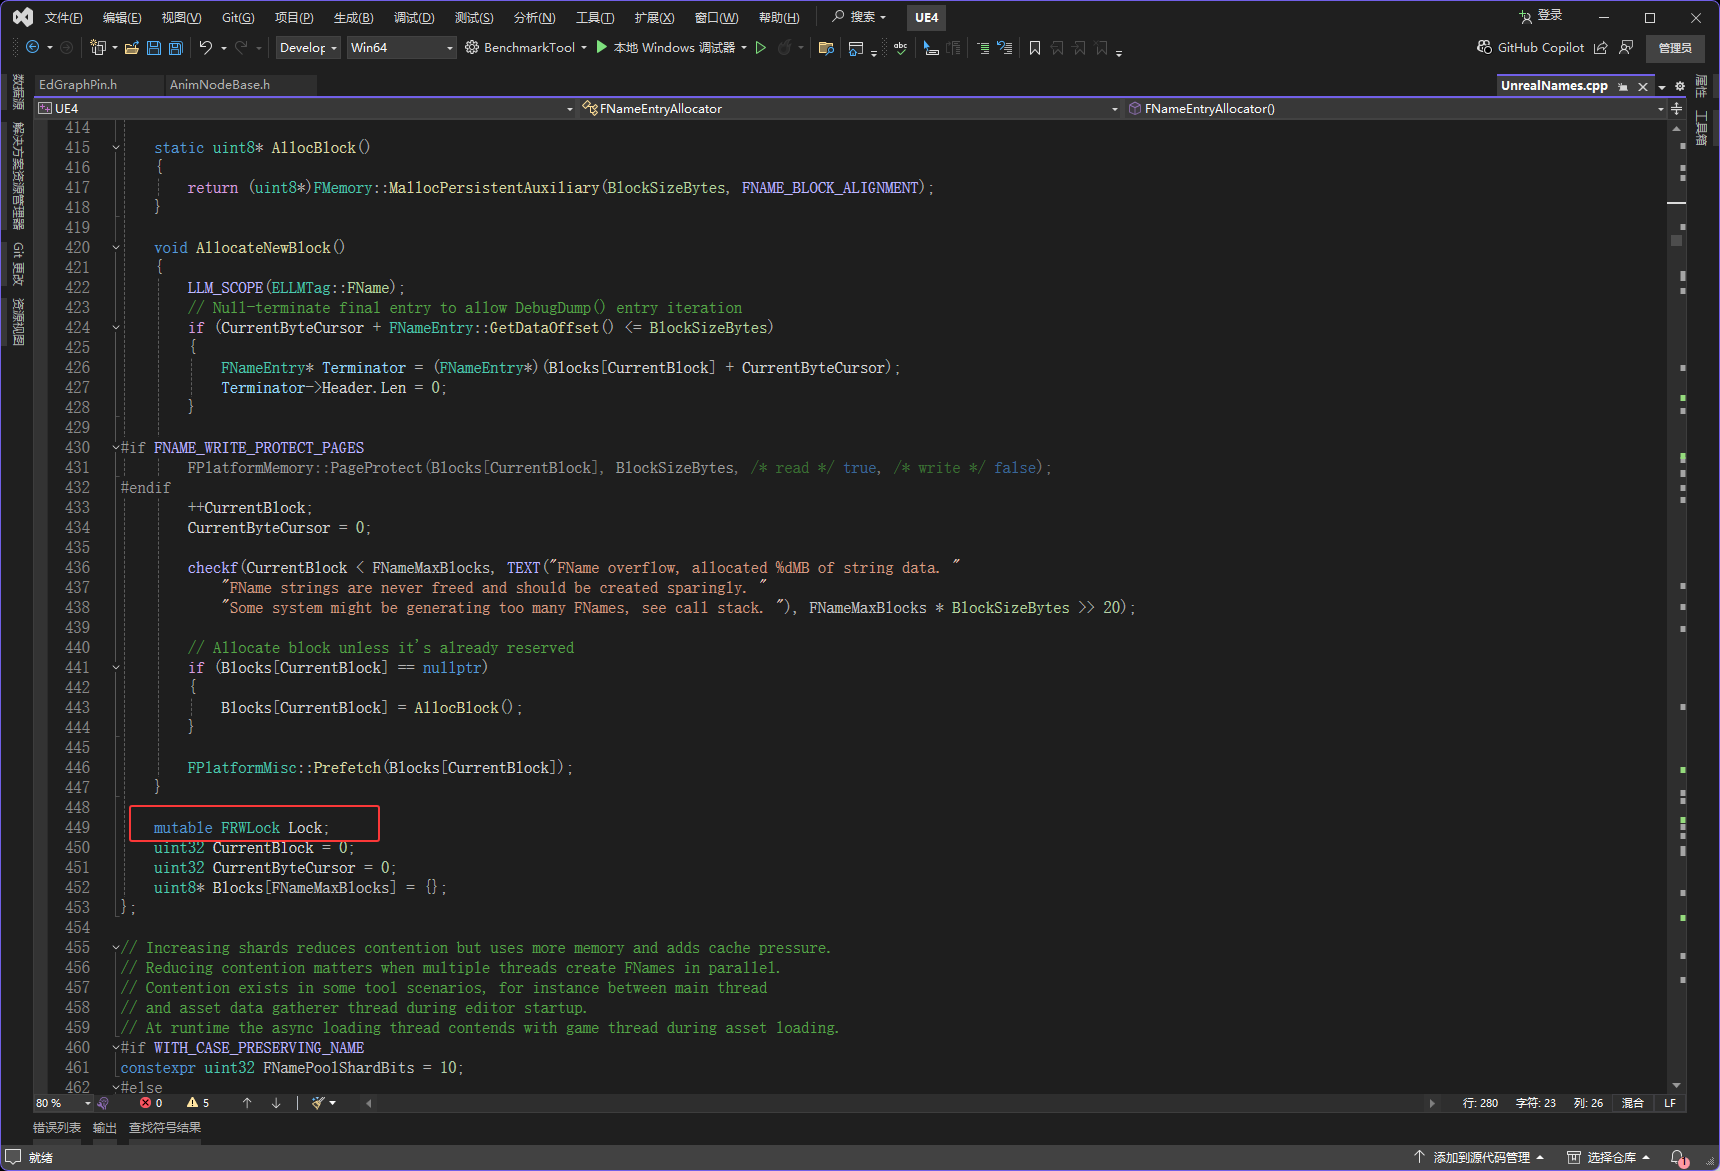
为什么说FRWLock是8,一步一步看,如下图进入FRWLock
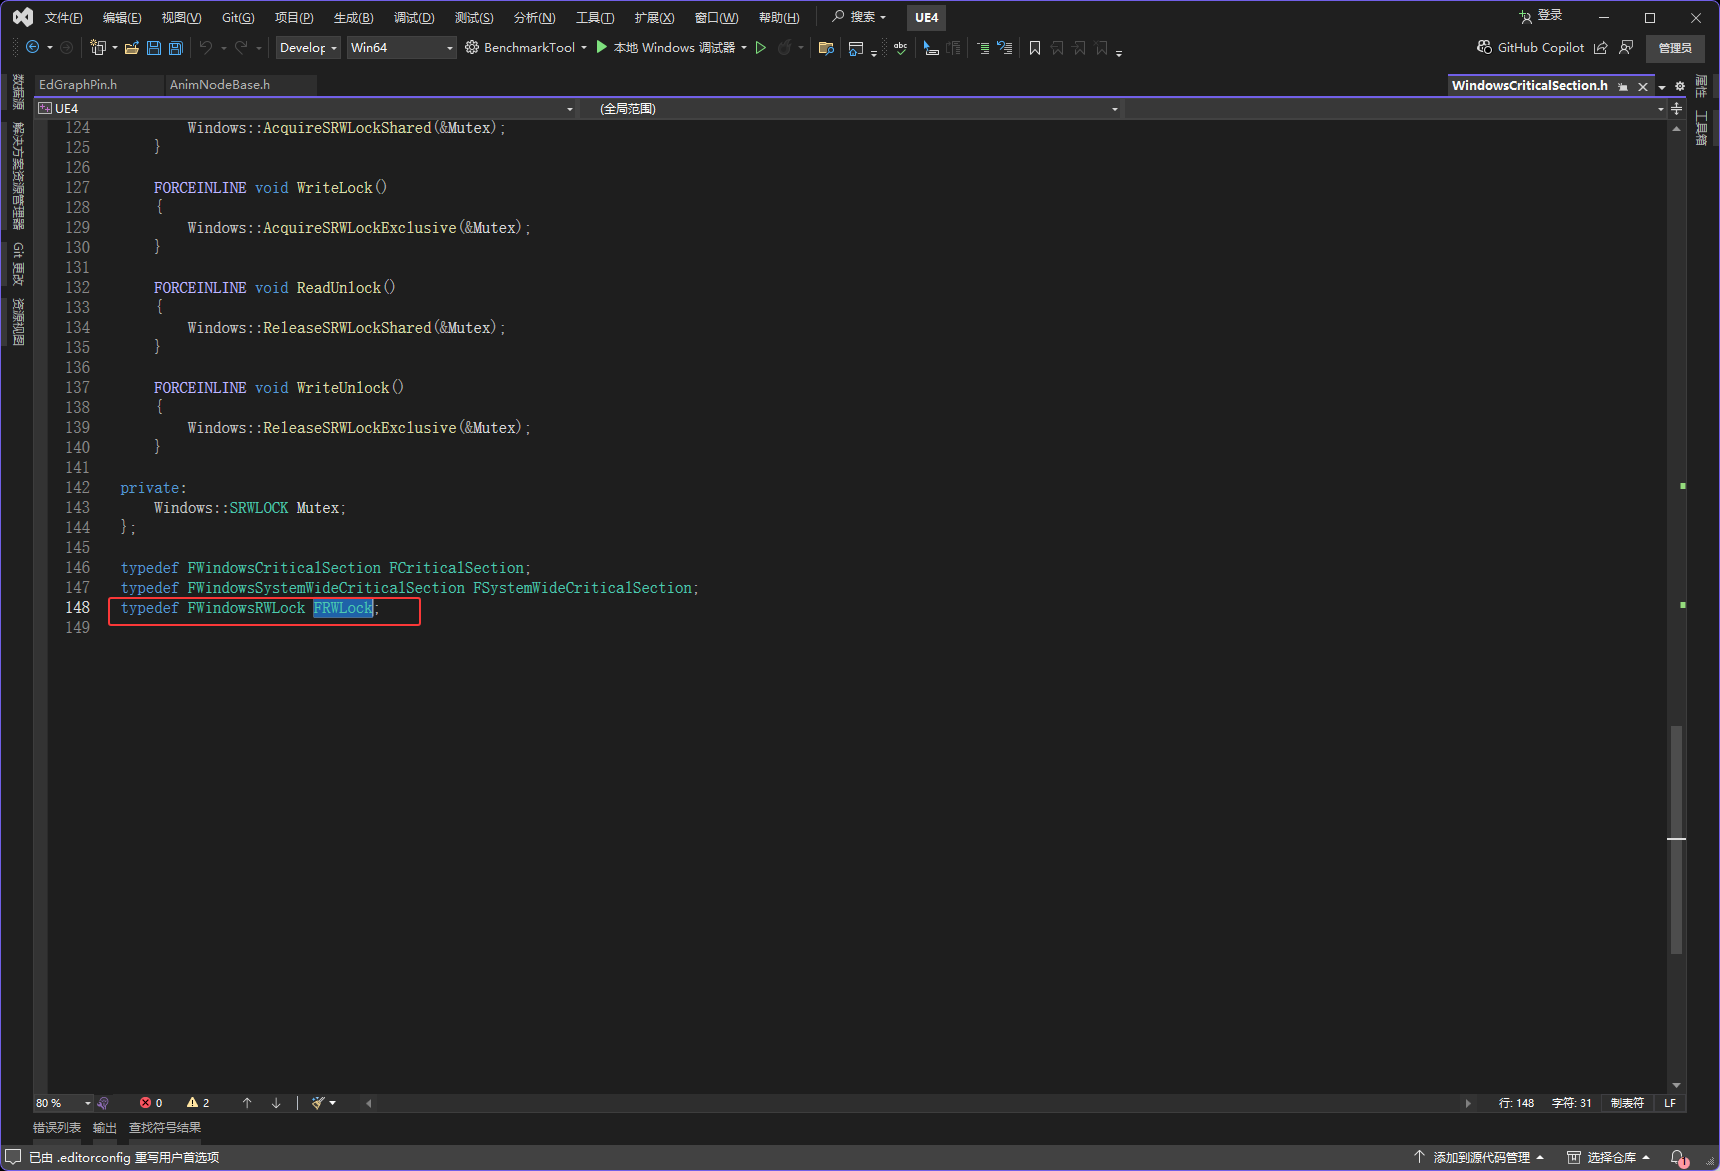
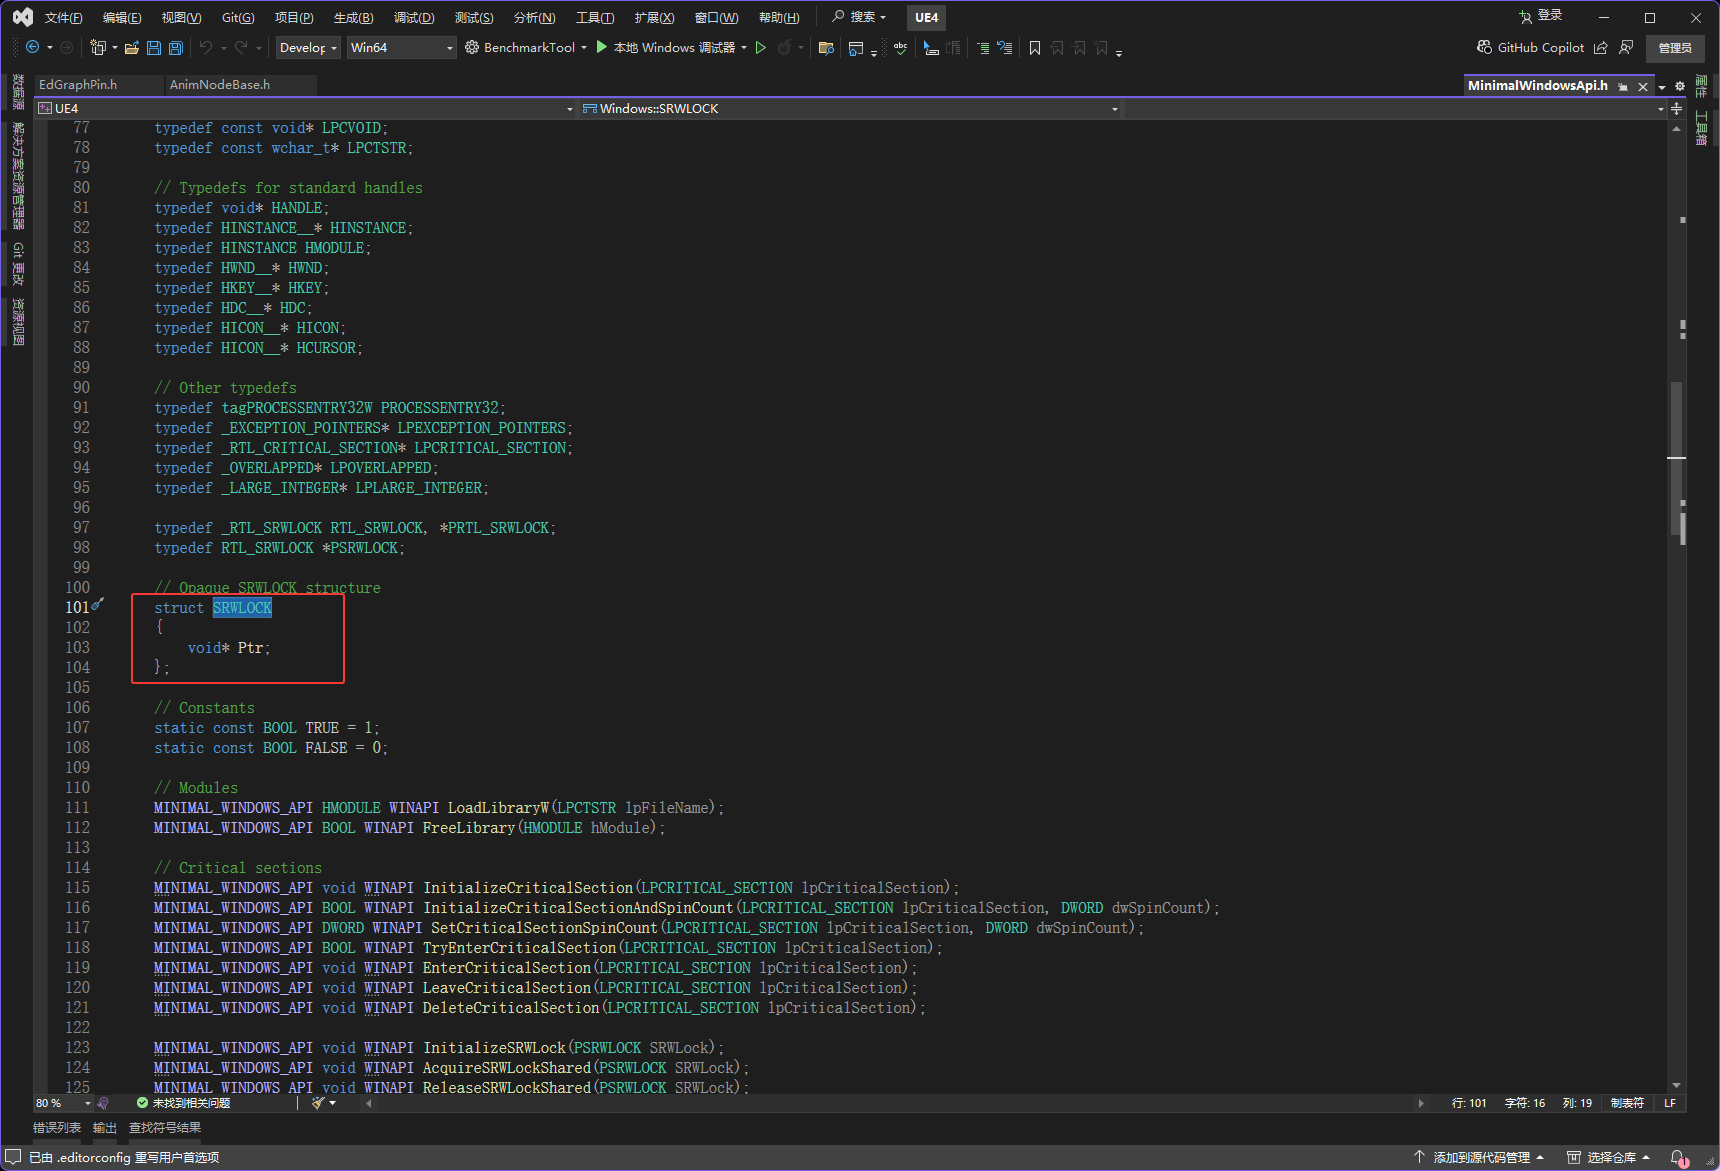
然后进入FWindowsRWLock,它里面就只有下图红框一个变量
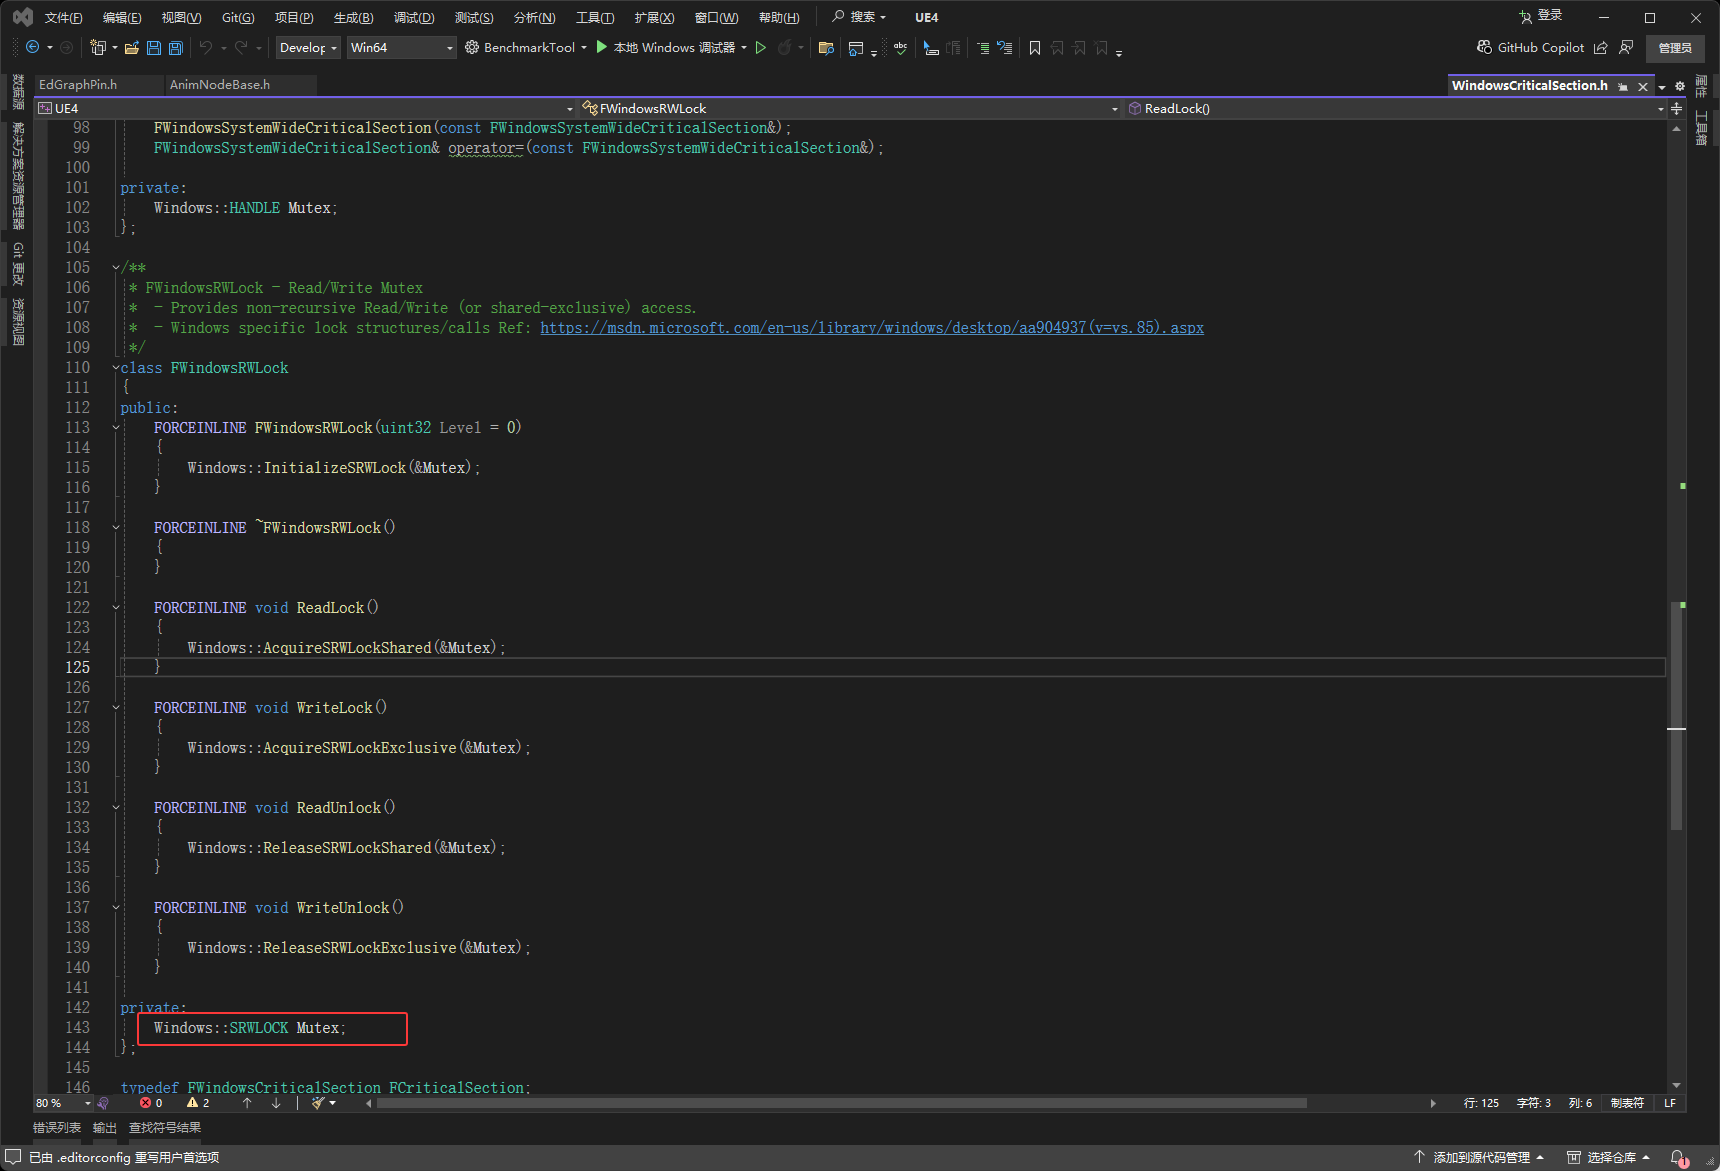
然后SRWLOCK里只有一个void*类型,这个类型在64位下是8字节,32位是4字节,所以说Lock是8字节
Blocks的位置是FNameEntryAllocator首地址+8+4+4,8+4+4的结果是16,16的十六机制是10,然后FNameEntryAllocator在FNamePool(GName)里
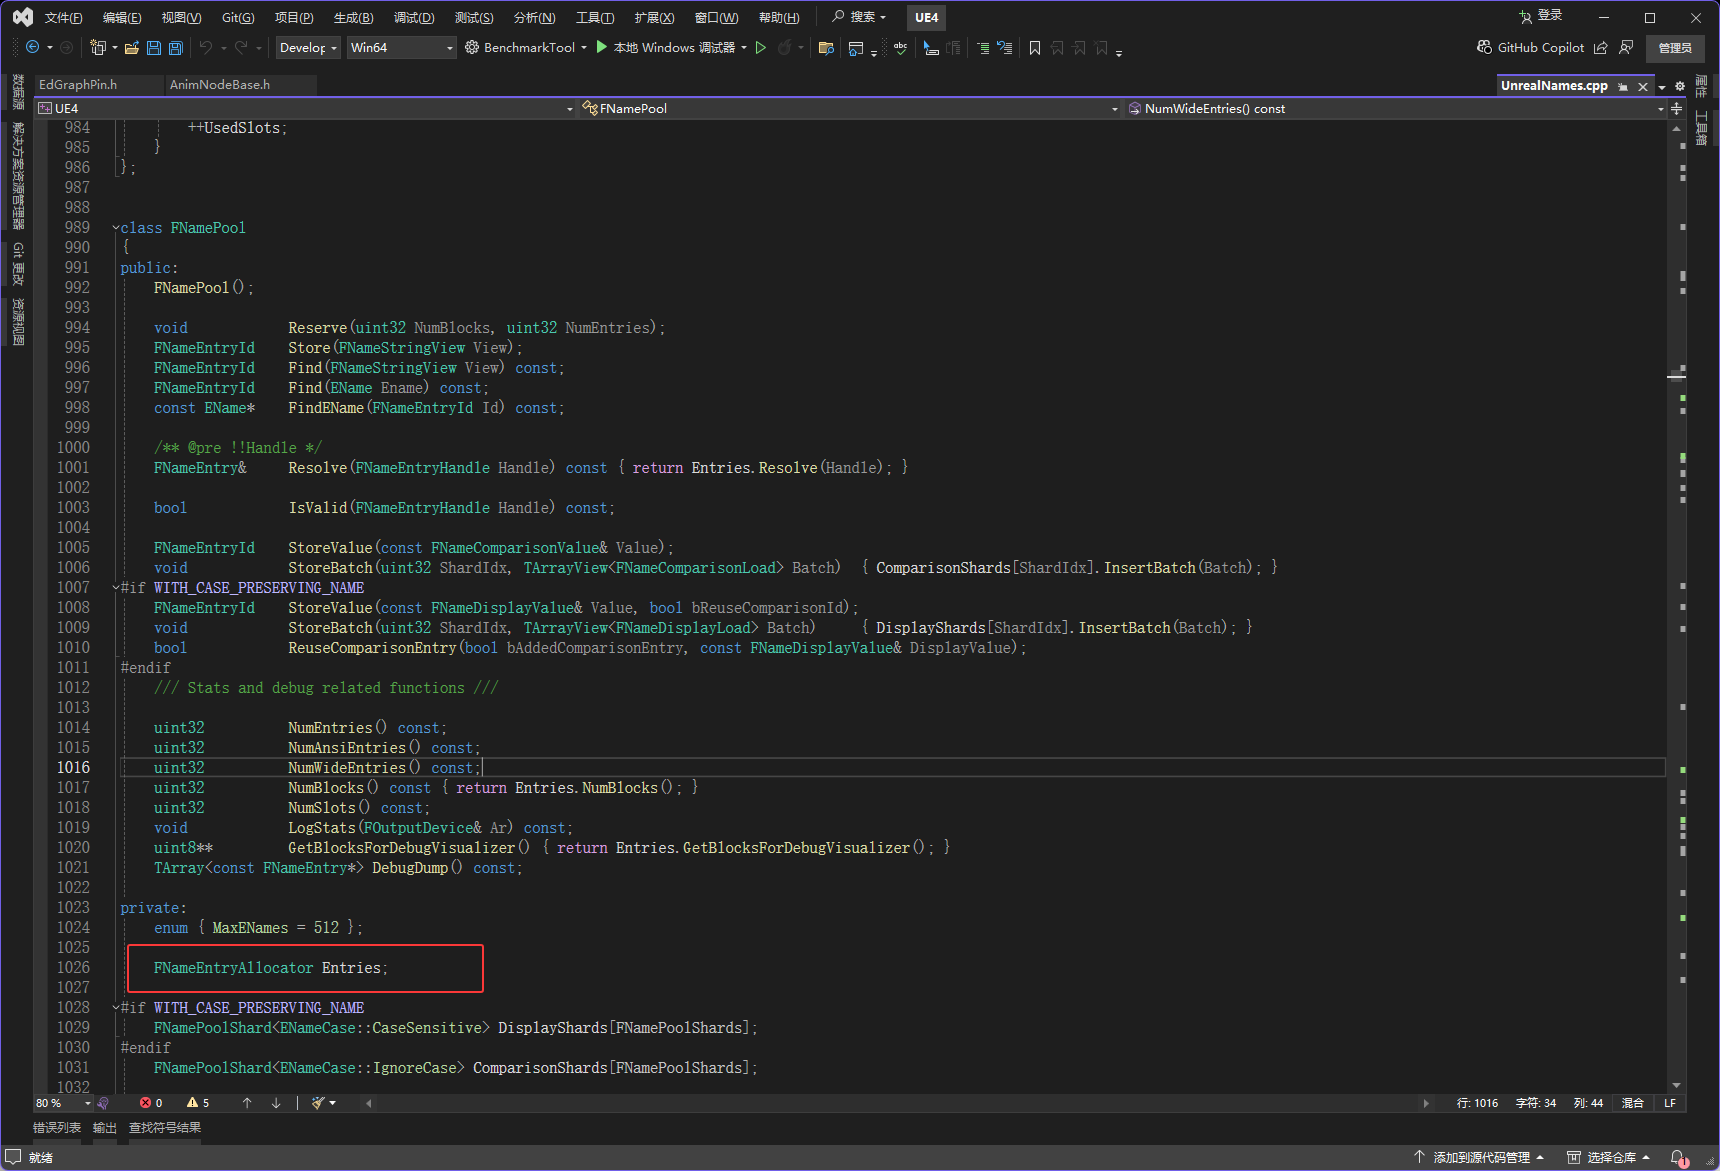
Entries在FNamePool中第一个,所以想得到Blocks的公式是首先取出FNamePool第0位的数据,这个数据是一个内存地址,内存地址里的数据是FNameEntryAllocator结构的首地址,也就是得到FNameEntryAllocator的数据,然后再进行8+4+4得到Blocks,得到Blocks后再通过 Blocks[Handle.Block] + Stride * Handle.Offset 这个算法得到一个地址(字符串的内存地址)。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 20
 0
- 0


 已为社区贡献20条内容

所有评论(0)