如何利用动态规划求子序列中的k种字母(hard难度)
(喜欢的觉得有用的家人们关注一下作者呗)
标题党了啊家人们,但是确实是遇到一道非常有意思的题目,拼尽全力依然只是过了几个测试点,发在这里看看评论区有没有大佬能够解答。以下是代码随想录第28例题:
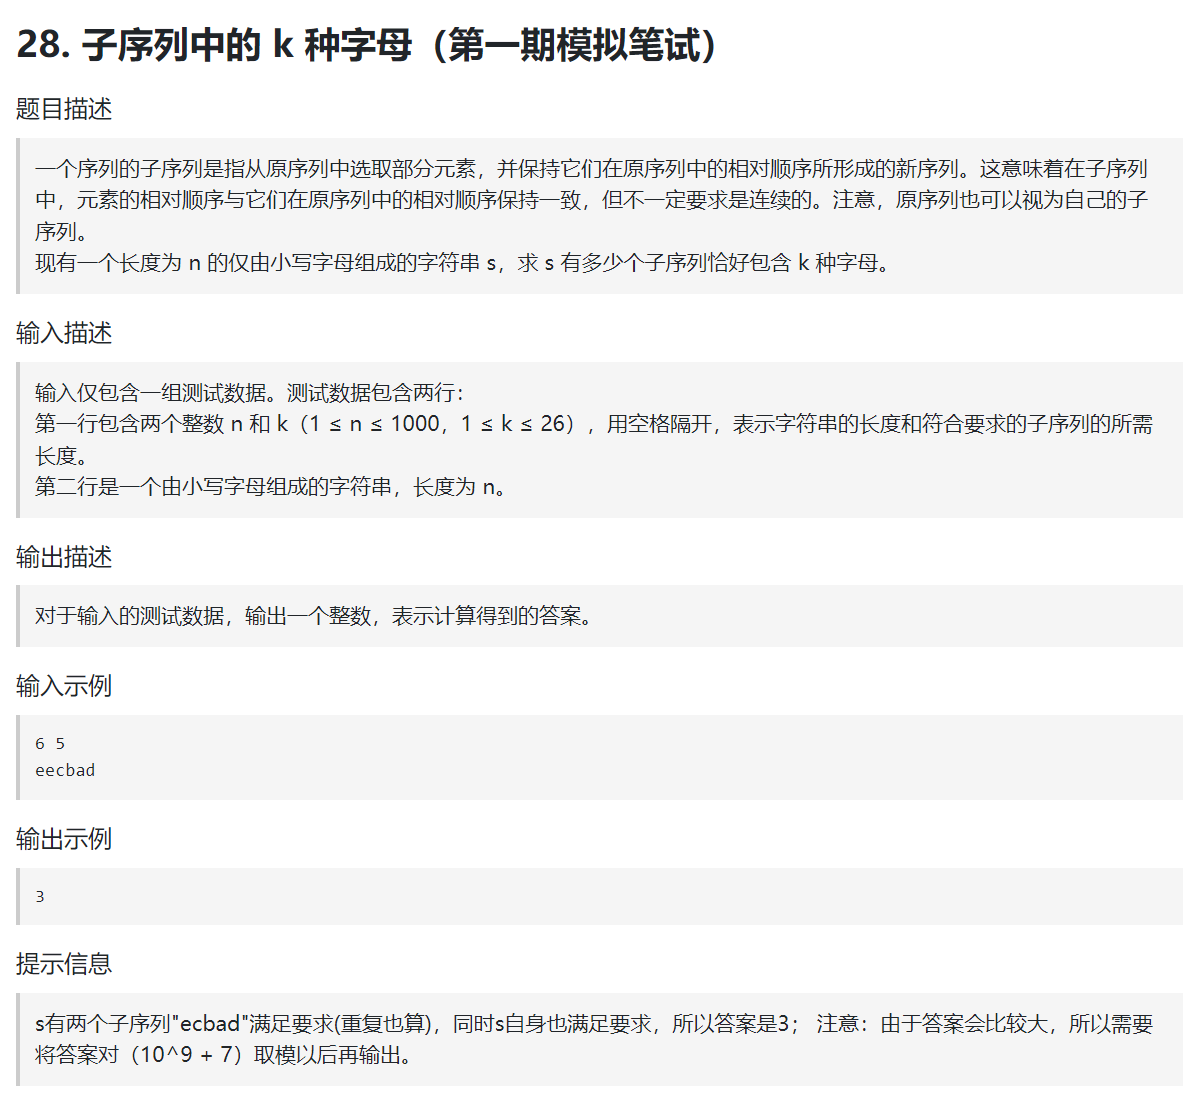
下面是本人过了几个测试点的代码:
import java.util.*;

public class Main {
    public static final int MOD = 1000000007;

    // 安全取模:确保结果在[0, MOD-1]
    private static long mod(long x) {
        x %= MOD;
        return x < 0 ? x + MOD : x;
    }

    public static void main(String[] args) {
        Scanner in = new Scanner(System.in);
        int n = 0, k = 0;
        String s = "";

        try {
            n = in.nextInt();
            k = in.nextInt();
            s = in.next();
        } catch (Exception e) {
            System.out.println(0);
            return;
        } finally {
            in.close();
        }

        if (k == 0) {
            System.out.println(0);
            return;
        }

        // 统计不同字符,不足k直接返回0
        Set<Character> distinct = new HashSet<>();
        for (char c : s.toCharArray()) distinct.add(c);
        if (distinct.size() < k) {
            System.out.println(0);
            return;
        }

        // dp[i][j]:前i个字符中,恰好包含j种不同字母的非空子序列数
        long[][] dp = new long[n + 1][k + 1];
        // sum[i][j]:前i个字符中,至多包含j种不同字母的非空子序列数(sum[i][j] = sum(dp[i][1..j]))
        long[][] sum = new long[n + 1][k + 1];
        // lastContribution[char][j]:字符上次出现时,对"至多j种"的贡献(用于去重组合)
        long[][] lastContribution = new long[26][k + 1];

        for (int i = 1; i <= n; i++) {
            char c = s.charAt(i - 1);
            int idx = c - 'a';

            // 1. 复制上一行状态(不选当前字符)
            for (int j = 1; j <= k; j++) {
                dp[i][j] = dp[i - 1][j];
                sum[i][j] = sum[i - 1][j];
            }

            // 2. 计算选择当前字符的新增子序列
            long[] newSubseq = new long[k + 1];
            newSubseq[1] = 1; // 单个字符子序列(允许重复,如两个'e'算2个)
            for (int j = 2; j <= k; j++) {
                // 新增组合 = 前i-1个中至多j-1种 + 当前字符
                newSubseq[j] = sum[i - 1][j - 1];
            }

            // 3. 核心修复:精准去重组合(针对j>1,减去上次出现时的j-1种贡献)
            // 重复组合的根源:上次出现的该字符已与j-1种形成过相同组合
            newSubseq[1] = mod(newSubseq[1] - lastContribution[idx][1]); // j=1去重单个字符重复计数
            for (int j = 2; j <= k; j++) {
                newSubseq[j] = mod(newSubseq[j] - lastContribution[idx][j - 1]); // j>1去重组合
            }

            // 4. 更新dp和sum
            for (int j = 1; j <= k; j++) {
                dp[i][j] = mod(dp[i][j] + newSubseq[j]);
                sum[i][j] = mod(sum[i][j] + newSubseq[j]);
            }

            // 5. 更新贡献记录:保存当前字符处理前的sum状态(用于下次去重)
            for (int j = 1; j <= k; j++) {
                lastContribution[idx][j] = sum[i - 1][j];
            }
        }

        System.out.println(dp[n][k]);
    }
}
这道题简直是 “细节魔鬼” 的典型代表,调试到崩溃都不冤 —— 它的坑根本不在 “算法思路”,而在一堆没说透的规则、反直觉的边界和藏在犄角旮旯的取模陷阱,完全是 “看似动态规划模板题,实则处处是坑的折磨题”!
首先最坑的就是 **“子序列去重” 的定义模糊 **。题目只说 “恰好包含 k 种不同字符的子序列”,但没明说 “内容相同但位置不同的子序列算不算同一个”—— 比如你遇到的 “eecbad” 里两个 “ecbad”,按常理觉得 “字符顺序一样就是同一个”,但通用 DP 逻辑会默认 “不同位置选出来的就算不同”,结果算出来 6,答案却要 3。这种 “规则不透明” 的坑,完全是靠反复试错才踩明白,前期方向错了再怎么调代码都是白费。
然后是DP 状态设计的 “隐形陷阱”。一开始想当然用 “恰好 j 种” 的状态,结果重复字符处理时要么多减(出 999999998)要么少减(出 6);换成 “至多 j 种” 又要处理空序列的抵消,稍微不注意就溢出变负。更离谱的是 “重复贡献” 的记录 —— 你以为记上次的 DP 值就行,结果要记 “上次出现前的状态”;你以为 j>1 时减 j 的贡献,结果要减 j-1 的贡献,每一步都要和 “反直觉的细节” 死磕。
还有取模和溢出的 “连环坑”。明明用了 long,却因为累加次数多(比如 n=100 的测试用例),中间值悄悄超过 long 上限溢出成负数;好不容易处理了显性负数,又冒出 “隐性溢出导致的负数值”,最后逼得每个步骤都要加安全取模。关键是错误结果还特别有迷惑性 ——999999998 看着像模运算的正常结果,实际上是 - 1 没处理好,查错时根本想不到是溢出导致的连锁反应。
最让人崩溃的是测试用例的 “针对性折磨”。那个 “eecbad” 的例子,刚好两个重复字符卡在 “影响最终结果” 的关键位置,少去一次重就多 3 个,多去一次重就少 1 个;而大规模测试用例又藏着溢出坑,你以为本地调通了小例子,提交上去要么 6 要么 999999998,反复横跳心态都崩了。
总结下来,这道题根本不是考 “会不会 DP”,而是考 “能不能忍受反复踩坑、能不能抠到每一个反直觉的细节”—— 明明思路没错,却要在 “规则理解”“状态细节”“取模溢出” 上死磕半天,调试到最后都怀疑自己是不是对 “子序列” 的定义有误解,属实是 “折磨人的破题” 了!

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)