【读点论文】Adversarial Reciprocal Points Learning for Open Set Recognition构建互反点,类似于n个二分类,对抗性边际约束损失优化特征空间
Adversarial Reciprocal Points Learning for Open Set Recognition
Abstract
- 开集识别(Open Set Recognition,OSR)是机器学习中的一个重要分支,它的目标是同时对已知的类进行分类,并将未知的类识别为“未知”类。OSR的关键问题是如何同时降低已知数据的经验分类风险和未知数据的开空间风险。为了解决这一问题,本文从多类集成的角度对开放空间风险问题进行了描述,并对未开发的类外空间引入了一个新的概念–互反点,在此基础上提出了一个新的学习框架–对抗互反点学习(ARPL),在不损失已知分类精度的前提下,最小化已知分布和未知分布的重叠,通过类外空间学习对应的已知类别的倒数点,并利用多个已知类别之间的对抗来降低经验分类风险。
- 然后,提出一种对抗性边界约束,通过限制由倒易点构成的潜在开放空间来降低开放空间风险,为进一步估计开放空间中的未知分布,设计了一种实例化的对抗性增强方法来生成多样且混乱的训练样本,基于互反点与已知类之间的对抗机制,有效地提高了模型对未知类的区分能力实验结果表明,所提出的方法获得了较好的性能,明显上级现有的方法。代码发布于 [GitHub - iCGY96/ARPL: TPAMI 2022] Adversarial Reciprocal Points Learning for Open Set Recognition。
- 论文地址:Adversarial Reciprocal Points Learning for Open Set Recognition | IEEE Journals & Magazine | IEEE Xplore。
- 为解决开放集识别(OSR) 中需同时降低已知数据经验分类风险与未知数据开放空间风险的核心挑战,本文提出互反点(Reciprocal Point) 概念以建模每类已知样本对应的类外空间,并构建对抗性互反点学习(ARPL) 框架:通过互反点与已知类的对抗提升已知类分类精度,引入对抗性边际约束(AMC) 限制开放空间以降低开放空间风险;为进一步估计未知分布,设计实例化对抗增强(Instantiated Adversarial Enhancement) 机制生成混淆样本,结合辅助批量归一化(ABN) 与聚焦训练(FT) 提升模型对未知类的区分能力。
- 开放集识别(OSR)的定义与意义:OSR 旨在解决传统闭集识别(假设测试类均在训练集中)的局限性,要求模型在测试时既能正确分类已知类,又能将未知类标记为 “unknown”,是可靠机器学习的关键(如自动驾驶中识别未知障碍物)。其核心矛盾是经验分类风险(已知数据的分类误差)与开放空间风险(将未知空间误判为已知类的概率)的同步降低。
- 现有方法的不足:判别模型:如 Softmax(仅优化类间分离)、Openmax(基于激活向量距离建模未知)、K-sigmoid(无有界开放空间风险),均未建模未知类分布,导致未知检测能力弱。生成模型:如 GOpenmax(用 GAN 生成未知样本)、C2AE(基于类条件自编码器)、VAE(条件高斯分布),未关注未知类在深度特征空间的低响应特性(多数未知样本的深度特征幅值低于已知样本),开放空间风险未有效控制。原型学习:如 GCPL(通过原型减小类内方差),原型易收敛到未知空间,导致已知与未知类特征重叠,无法降低开放空间风险。
INTRODUCTION
-
在过去的几年里,深度学习在许多图像识别和分类任务中的表现已经达到甚至超过了人类水平。这些方法遵循闭集设置,假设所有测试类都是已知的或在训练中看到的。然而,在现实应用中,类的知识是不完整的,并且未知的类可能在测试期间提交给算法。例如,诸如自动驾驶车辆的自主移动的代理可能在其生命周期期间的某个点遇到未知来源的对象。
-
因此,这些在闭集环境下的超人表现是虚幻的,因为开集识别(OSR)是人类操作的环境,在那里他们的表现远远超过所有当前的计算机视觉方法。因此,一个强大的识别系统应该识别测试样本为已知或未知,并同时正确地分类所有已知或已知类别的测试实例。
-
OSR的关键是同时降低已标记已知数据上的经验分类风险和潜在未知数据上的开放空间风险,其中开放空间风险是将开放空间标记为任何已知类别的“正”。典型的基于深度学习的基线在嵌入特征上采用线性分类层和softmax函数,以产生它通常假设来自未知类的样本应该在已知类上具有均匀的概率分布。
-
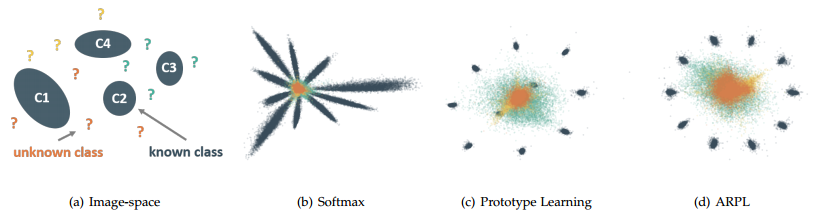
如图1(B)所示,softmax构造了几个超平面,将嵌入特征空间分隔成不同的子空间,每个子空间对应一个已知的类。对于OSR任务,学习的嵌入特征不仅应该是可分离的,而且应该是有区别的,并且可以在没有标签预测的情况下充分泛化,以识别新的不可见类。然而,softmax损失只会鼓励特征的可分离性,为了使特征更具区分性,几种方法利用原型来表示嵌入特征空间中的每个已知类,并鼓励训练样本的特征接近相应的原型。
-
-
图1:(a):图像空间具有无限的开放空间,但大多数未知量的深响应分布在深空间的有限低幅度区域[6]。(b)-(d):LENET++对已知和未知的深度回应。MNIST(蓝色)用于已知训练,KMNIST(绿色)、SVHN(黄色)和CIFAR-100(橙色)用于开集评估,它们与MNIST的相似性逐渐降低。(b)中的网络是由Softmax训练的,而(c)和(d)中的网路是用原型学习和我们的新颖对抗互反原型学习(ARPL)训练的。
-
本文探讨了如何通过减少已知样本的深度特征与不同未知样本的特征之间的重叠来提高识别率。在应用程序中,应选择一个分数阈值,以最佳地将各种未知样本与已知样本分开。不幸的是,很难为(b)或(c)找到这样的阈值。通过(d)可以实现更好的分离。
-
-
如图1(c)所示,学习的原型可以收敛在训练中的未知类的空间中,使得已知类和未知类无法区分。总体而言,这两类方法都只关注已知数据,忽略了未知数据的潜在特征,导致降低开放空间风险的效果较差。与图1(a)中无限未知图像空间相反,大多数未知样本从神经网络中获得较低的深度幅度特征,因为这些样本不能激活用有限已知样本训练的模型。这也可以从图1中观察到。因此,我们认为,不仅是已知的类,而且潜在的未知的深空应该在训练中建模。
-
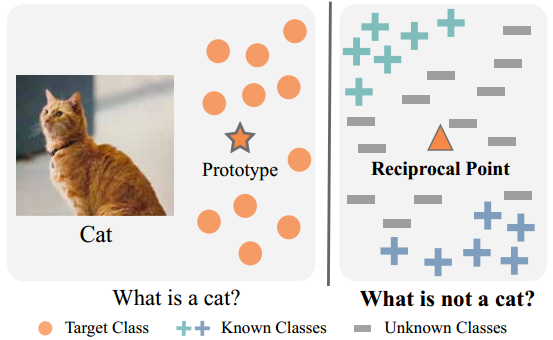
为了在没有对应样本的情况下对潜在未知空间进行建模,本文提出了一个新的概念–倒易点(Reciprocal Point)。考虑一个只有一个已知类(如图2中的猫)的简单情况。如何识别猫?大多数分类方法的目标是学习“什么是猫?",导致在整个问题空间中只能看到一个点。
-
-
图2:如何在OSR设置中识别猫?大多数方法侧重于学习猫作为原型的潜在代表性特征。相比之下,互反点作为非猫的潜在代表性特征,通过差异性来识别猫。在这里,这些互易点构成了额外类空间的实例化表示,这可能有助于在解决OSR问题时减少不确定性。
-
-
相反,互反点作为非猫的潜在代表性特征,通过差异性来识别猫。所有这些互反点构成了潜在的未开发的类外空间的实例化表示,当在OSR设置中解决“什么是猫?”问题时,这些互反点可以潜在地用于减少不确定性。
-
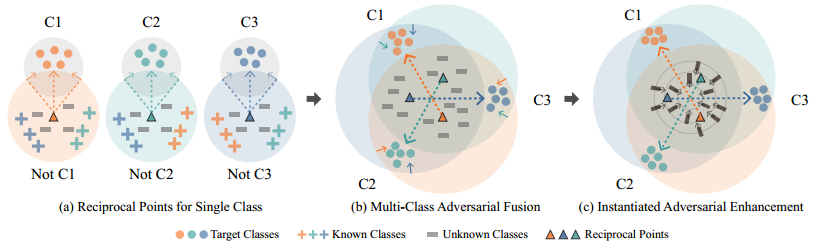
对于已知类别猫,大多数未知样本显然属于非猫空间,其特征应该更接近非猫的表示,这意味着对应的未知信息在每个非猫嵌入空间中更隐式,因此,提出了一种新的基于多个已知类与它们的互反点的对抗的分类框架,其目的是扩大距离在目标类的嵌入特征和对应的倒易点之间,如图3(a)所示。
-
-
图3:用于开放集识别的对抗互反点学习(ARPL)方法概述。(a)单一类别的互反积分会使每个已知类别远离其互反积分。(b)多类对抗融合导致由倒易点构建的多类有界空间之间的对抗。结果,已知类被推到特征空间的外围,未知类被限制在有界空间中。(c) 即时对抗增强生成更有效、更多样化的混淆样本,以提高分类器的可靠性。
-
-
从多类集成的角度,我们还提出了开集风险的概念。为了降低每个已知类的潜在未知数据的开空间风险,我们提出了一种新的对抗性边缘约束项,通过绑定目标类及其倒数点,将类外嵌入空间限制在有界范围内。此外,当多个类在训练阶段发生交互时,所有已知类不仅被相应的倒易点推到空间的外围进行分类,而且被其他具有对抗性边界约束的倒易点拉到一定的有界范围内。
-
最后,如图3(B)所示,所有已知类都分布在有界嵌入空间的外围,未知样本被限制在内部有界空间。有界约束防止神经网络对未知样本产生任意高的置信度。虽然在训练阶段只有已知样本可用,已知类和未知类之间的间隔由倒数点间接地分开。
-
为了从开放空间中估计未知分布,提出了一种新的实例化对抗增强机制来生成令人困惑的训练样本,以增强已知和未知类的模型可识别性。与常见的生成对抗网络(GAN)不同,所提出的方法涉及到一种额外的对抗策略,该策略在分类器和分类器之间:一方面,生成的样本应该欺骗分类器,使其判断它们是已知样本;另一方面,分类器对生成的样本的响应被鼓励接近每个倒数点,如图3(c)所示。
-
这意味着生成的样本要尽可能靠近分类器嵌入空间的开放空间,最后联合训练生成器、聚类器和分类器达到均衡,在此过程中生成更多多样性和迷惑性的样本,促使分类器过滤掉大部分与已知样本有显著差异的样本,此外,开发了辅助批量标准化模块和聚焦训练机制,以防止分类器由于不同的生成样本而做出混乱的预测。
-
我们的贡献总结如下:(1)从多类集成的角度出发,通过引入一个新的概念–倒易点,对特征空间中每个已知类的潜在开放空间进行建模,从而建立了开放空间风险模型。(2)基于多个已知类之间具有对抗性边界约束的倒易点,引入了一个分类框架来降低经验分类风险和开放空间风险,定理1从理论上保证了对抗边界约束的合理性。(3)为了从开放空间估计未知分布,特别是已知类别的不可区分部分,设计了一种新的实例化对抗增强,从已知数据和倒易点之间的对抗中生成更多样化的混淆训练样本。
-
这项研究在几个方面扩展了我们的ECCV spotlight 论文[Learning open set network with discriminative reciprocal points]。
- 1)我们开发了一种新的实例化对抗训练策略,通过生成令人困惑的训练样本来增强已知和未知类的模型可扩展性(第4节).在多个数据集上进行实验,证明了该方法的有效性。
- 2)改进了初始方法,引入了夹角余弦来度量已知类与其倒易点之间的距离,它与分类损失(第3.2节)具有内在一致性,并带来令人满意的性能改进。
- 3)提出对抗性边缘约束,为多类对抗性融合构建一个更具弹性的有界空间,学习更具鉴别力的特征空间来识别各种未知分布。本文从理论上分析了其合理性,(第3.3节)。
- 4)进行更多的定性和定量实验来评估该方法的有效性,包括以下内容:(a)一个更全面的指标,开放集分类率,是考虑到已知和未知类别的区别以及已知类别的准确性而制定的。它更符合开集识别的本质,并在5.2节中用于评估不同的算法。(B)我们在5.3节中增加了关于分布外检测任务的实验,和更多的国家的最先进的算法开集识别进行比较。(c)更多的可视化插图和相关性,以使更好地理解嵌入特征空间的近,第5.4节中的未知样本。
-
核心方法:对抗性互反点学习(ARPL),互反点(Reciprocal Point),为每类已知样本(如 “猫”)定义一个互反点,作为该类 “非样本”(其他已知类 + 所有未知类)的潜在表示,通过 “区分非样本” 间接实现已知类识别(如图 2 所示)。综合欧氏距离(空间位置差异)与点积(角度方向差异),公式如下: d e = 1 m ∥ C ( x ) − P k ∥ 2 2 , d d = C ( x ) ⋅ P k , d = d e + d d d_e = \frac{1}{m}\|\mathcal{C}(x)-\mathcal{P}^k\|_2^2, \quad d_d = \mathcal{C}(x)\cdot\mathcal{P}^k, \quad d = d_e + d_d de=m1∥C(x)−Pk∥22,dd=C(x)⋅Pk,d=de+dd。其中 C ( x ) \mathcal{C}(x) C(x) 是样本 x 的深度嵌入, P k \mathcal{P}^k Pk 是第 k 类的互反点,m 为嵌入维度。
-
ARPL 的损失函数设计,分类损失( L c \mathcal{L}_c Lc):基于互反点的 softmax 概率,最小化负对数概率以最大化已知类样本与对应互反点的距离,公式为: L c = − log ( e γ d ( C ( x ) , P k ) ∑ i = 1 N e γ d ( C ( x ) , P i ) ) \mathcal{L}_c = -\log\left(\frac{e^{\gamma d(\mathcal{C}(x),\mathcal{P}^k)}}{\sum_{i=1}^N e^{\gamma d(\mathcal{C}(x),\mathcal{P}^i)}}\right) Lc=−log(∑i=1Neγd(C(x),Pi)eγd(C(x),Pk))。其中 γ = 1.0 \gamma=1.0 γ=1.0(控制距离 - 概率转换硬度),N 为已知类数量。此损失对应降低经验分类风险。对抗性边际约束损失( L o \mathcal{L}_o Lo):为限制类外空间( O k = O k p o s + O k n e g O_k = O_k^{pos}+O_k^{neg} Ok=Okpos+Okneg)在有界范围,引入可学习边际 R,仅用欧氏距离计算,公式为: L o = max ( d e ( C ( x ) , P k ) − R , 0 ) \mathcal{L}_o = \max(d_e(\mathcal{C}(x),\mathcal{P}^k)-R,0) Lo=max(de(C(x),Pk)−R,0) 此损失确保类外样本与互反点的距离不超过 R,间接降低开放空间风险。
-
对于基于互反点的神经网络, L c 与 L o \mathcal{L}_c与\mathcal{L}_o Lc与Lo 同时最小化,当且仅当 “其他已知类样本与当前类互反点的最大距离≤R”。通过反证法证明:若存在其他类样本距离当前互反点 > R,会导致该样本被误分类为当前类,升高 L c \mathcal{L}_c Lc,与 “同时最小化” 矛盾。
-
实例化对抗增强:生成混淆样本(ARPL+CS),设计生成器(G)、判别器(D)、分类器(C)三方对抗框架:
- 判别器 D:区分真实已知样本与生成样本,优化目标为 max D 1 n [ log D ( x i ) + log ( 1 − D ( G ( z i ) ) ) ] \max_D \frac{1}{n}[\log D(x_i) + \log(1-D(G(z_i)))] maxDn1[logD(xi)+log(1−D(G(zi)))]。
- 生成器 G:需同时欺骗 D(使生成样本被视为已知)和接近开放空间(使生成样本与所有互反点距离相等),优化目标为: max G 1 n [ log D ( G ( z i ) ) + β ⋅ H ( z i , P ) ] \max_G \frac{1}{n}[\log D(G(z_i)) + \beta\cdot H(z_i,\mathcal{P})] maxGn1[logD(G(zi))+β⋅H(zi,P)] 其中 β \beta β为熵权重, H ( z i , P ) H(z_i,\mathcal{P}) H(zi,P) 是生成样本与互反点距离分布的信息熵(最大化熵确保样本接近所有互反点)。
- 分类器 C:用生成样本优化,目标为 min C 1 n [ L ( x i , y i ) − β ⋅ H ( z i , P ) ] \min_C \frac{1}{n}[\mathcal{L}(x_i,y_i) - \beta\cdot H(z_i,\mathcal{P})] minCn1[L(xi,yi)−β⋅H(zi,P)] ,以降低开放空间风险。
-
可靠性增强策略,辅助批量归一化(ABN):已知样本与混淆样本使用独立的 BN 层,避免混合分布导致的统计偏差(无 ABN 会导致已知类训练崩溃)。聚焦训练(FT):用已知样本重新训练分类器,纠正分类器对混淆样本的过度关注,进一步提升已知类分类精度与未知类检测能力。
RELATED WORK
Open Set Recognition
- Scheirer等人受具有拒绝选项的分类器的启发,首次定义了OSR问题,并提出了一个基本框架来执行训练和评估。近年来,OSR一直令人惊讶地被忽视,尽管它比常见的闭集设置更具实用价值。关于这个主题的少数工作大致可以分为两类:判别模型和生成模型。
- 判别方法。在深度学习时代之前,提出了几种利用传统机器学习方法的OSR作品。例如,Scheirer等人和Jain等人考虑了基于支持向量机(SVM)的极值模型的未知检测的决策分数分布。Rudd等人提出了极值机,其对类-基于极值理论(EVT)的密度函数的包含概率。Junior等人提出了一种开集最近邻方法,该方法识别与已知样本具有低相似性的任何测试样本。相似性得分使用最近邻居之间的距离比率计算。Zhang et al 提出了一种基于稀疏表示的OSR方法,该方法也使用EVT通过残差来识别未知样本。最近,Bendale等人也将深度神经网络(DNN)引入到OSR任务中。他们证明了软最大概率阈值不能产生稳健的OSR模型。然后,Openmax 提出通过对激活向量的距离建模来检测未知类。Shu等人提出了一种基于K-sigmoid激活的方法,该方法通过消除网络外部的离群值检测器来实现端到端训练。在这些工作中,S形函数不具有紧致衰减特性。该特性可以通过添加来自所有训练数据的无限远输入来激活,因此其开放空间风险是没有界的。
- 生成方法。与判别模型不同,生成器方法使用GAN ,自动编码器和基于流的模型生成未知或已知样本,以帮助分类器学习已知和未知样本之间的决策边界。Ge等人提出了G-Openmax,Openmax的直接扩展,使用生成模型来合成未知样本来训练网络。与[Sparse representation-based open set recognition]中的思想类似,Yoshihashi等人提出了CROSR模型,它结合了有监督的学习预测和无监督的重构潜在表示来重新分布概率分布。提出了OSR的C2AE模型,使用类条件自编码器通过EVT从重建误差中获得决策边界。Xin等人为变分自动编码器(VAE)提供了一种条件高斯分布学习通过迫使不同的潜在特征近似不同的高斯模型来检测未知和分类已知样本。Zhang等人提出了一种将分类器和基于流的密度估计器组合到联合嵌入空间中的方法,但这些方法没有考虑未知类在学习器中的深层分布,导致潜在的开放空间风险。
Out-of-Distribution Detection
- OSR自然与其他一些问题设置有关,如分布外(OOD)检测,离群值检测和新颖检测等。考虑到AI系统的安全性,面向对象实例的检测首先由Hendrycks等人在中介绍这里OOD检测是对不属于训练集但可能在测试期间出现的样本的检测。Hendrycks等人 Liang等人提出了ODIN,通过使用温度缩放和向输入添加小扰动来实现更有效的检测。Lee等人利用生成模型从OOD样本中生成最有效的样本,并从这个分支中导出一个新的OOD分数。Hendrycks等人提出了通过使用辅助数据集来教导网络更好地表示异常检测的outiler暴露。OOD检测类似于OSR中未知类的拒绝,因为它们都是研究分布内(已知)和分布外(未知)样本的分离,并且不需要已知类别的自适应能力。
Prototype Learning
-
原型是一个类别的平均或最佳样本,因此可以为整个类别的实例提供简洁的表示。最著名的原型学习方法是k-最近邻(KNN)。学习矢量量化(LVQ)被提出来节省存储空间并提高KNN的计算效率。在大多数以前的工作中,通过优化自定义目标函数来学习原型。最近,一些方法还将原型学习与概率模型和神经网络相结合,用于分类任务。
-
在神经网络的框架下,原型是每个类一个或多个潜在向量形式的可学习表示。作者将输入实例表示为K维向量,将每个分量建模为概率的混合,最后通过似然最大化将概率模型应用于参数化K-原型模式。Wen等提出了一种中心损失的方法来学习每个身份的深层特征的中心,并使用这些中心来减少类内方差。Yang等人提出了带原型损失的广义卷积原型学习(GCPL),作为一种正则化方法,用于提高特征表示的类内紧致性。对于OSR问题,原型有助于减少已知类的类内距离,但忽略了未知数据的潜在特征,导致降低开放空间风险的效果较低。
ADVERSARIAL RECIPROCAL POINT LEARNING
Problem Definition
-
给定具有N个已知类别的n个标记样本的集合 D L = { ( x 1 ; y 1 ) ; . . . ; ( x n ; y n ) } DL = \{(x_1; y_1);...;(x_n; y_n)\} DL={(x1;y1);...;(xn;yn)},其中 y i ∈ { 1 ; . . . ; N } y_i\in \{1;...; N\} yi∈{1;...;N} 是xi的标记,并且更大量的测试数据 D T = { t 1 ; . . . ; t u } D_T = \{t_1;...; t_u\} DT={t1;...;tu} ,其中ti的标记属于 { 1 ; . . . ; N } ∪ { N + 1 ; . . . ; N + U } \{1;...; N\} ∪ \{N + 1;...; N + U\} {1;...;N}∪{N+1;...;N+U} ,U是现实场景中未知类的数量,类别k的深嵌入空间表示为Sk,其对应的开放空间表示为Ok。为了有效地形式化和管理开放空间风险,Ok被分成两个子空间:来自其他已知类的正开放空间为 O k p o s O^{pos}_ k Okpos ,剩余的无限未知空间为负开放空间 O k n e g O^{neg}_k Okneg 。
-
在该方法中,将第k类的样本 D L k ∈ S k D^k_L\in S_k DLk∈Sk 、其他已知类的样本 D L ≠ k ∈ O k p o s D^{\neq k}_L\in O^{pos}_k DL=k∈Okpos 和非DL的样本 D U ∈ O k n e g D_U\in O^{neg}_k DU∈Okneg 分别定义为正训练数据、负训练数据和潜在未知数据,并构造了二元可测预测函数 Φ k : R d → { 0 ; 1 } \Phi_k:\R^d \rightarrow \{0; 1\} Φk:Rd→{0;1} 用于将嵌入x映射到标签k。对于1类OSR问题,总体目标是通过最小化预期误差Rk来优化判别二元函数k:
-
a r g min Φ k { R k ∣ R ϵ ( Φ k ; S k ∪ O k p o s ) + α ⋅ R o ( Φ k ; O k n e g ) } ; ( 1 ) arg \min_{\Phi_k} \{R^k|R_\epsilon( \Phi_k; S_k∪ O^{pos}_k ) + α · R_o( \Phi_k; O^{neg}_k )\}; (1) argΦkmin{Rk∣Rϵ(Φk;Sk∪Okpos)+α⋅Ro(Φk;Okneg)};(1)
-
其中,α 是正正则化参数,R 是已知数据的经验分类风险,Ro是用于测量将未知样本标记为已知或未知类别的不确定性的开放空间风险。这进一步表示为空间 O k n e g O^{neg}_k Okneg 上的非零积分函数:
-
R o ( Φ k ; O k n e g ) = ∫ O k n e g Φ k ( x ) d x ∫ S k ∪ O k Φ k ( x ) d x : ( 2 ) R_o(\Phi_k; O^{neg}_k ) =\frac{\int O^{neg}_k\Phi_k(x)dx}{\int_{S_k∪O_k}\Phi_k(x)dx}: (2) Ro(Φk;Okneg)=∫Sk∪OkΦk(x)dx∫OknegΦk(x)dx:(2)
-
开放空间 O k n e g O^{neg}_k Okneg 被标记为阳性的次数越多,开放空间风险就越大。在多类设置中,OSR问题通过集成多个二元分类任务(一个与一个)来识别。通过在所有已知类别中总结等式(1)中的预期风险,即 ∑ k = 1 N R k \sum^N _{k=1}R^k ∑k=1NRk ,我们得到
-
∑ k = 1 N R ϵ ( Φ k ; S k ∪ O k p o s ) + α ⋅ ∑ k = 1 N R o ( k , O k n e g ) : ( 3 ) \sum^N_{k=1} R_\epsilon( \Phi k; S_k∪ O^{pos}_k ) + α ·\sum^N_{k=1} R_o( k,O^{neg}_k ): (3) k=1∑NRϵ(Φk;Sk∪Okpos)+α⋅k=1∑NRo(k,Okneg):(3)
-
最小化等式(3)的左侧等同于训练多-二进制分类器,产生用于N类分类的多类预测函数 f = ⊙ ( 1 ; 2 ; . . . ; N ) f =\odot(1; 2;...; N) f=⊙(1;2;...;N),其中 ⊙ ( ⋅ ) \odot(·) ⊙(⋅) 是积分运算。
-
a r g min f ∈ H { R ϵ ( f ; D L ) + α ⋅ ∑ k = 1 X R o ( f ; D U ) } , ( 4 ) arg \min_{f\in H}\{R_\epsilon(f; D_L) + α · \sum^X_{k=1} R_o(f; DU )\},(4) argf∈Hmin{Rϵ(f;DL)+α⋅k=1∑XRo(f;DU)},(4)
-
其中 f : R d → N f:\R ^d \rightarrow N f:Rd→N 是可测量的多类识别函数,DL是训练阶段使用的标记数据集,DU是潜在未知数据。根据等式(4),解决OSR问题相当于同时最小化标记已知数据上的经验分类风险和潜在未知数据上的开放空间风险的组合,这使得嵌入函数在已知空间和未知空间之间更有区别。
-
Reciprocal Points for Classification
-
类别k的倒易点P k被认为是子数据集 D L ≠ k ∪ D U D^{\neq k}_L ∪ D_U DL=k∪DU 的潜在表示。因此, O k O_k Ok 的样本应该比 S k S_k Sk 的样本更接近倒易点 P k P^k Pk ,其被公式化为:
-
m a x ( ζ ( D L ≠ k ∪ D U ; P k ) ) ≤ d ; ∀ d ∈ ζ ( D L k ; P k ) ; ( 5 ) max(ζ(D^{\neq_k}_L∪ D_U ; P^ k )) ≤ d; \forall d\in ζ(D^k_L; P^k ); (5) max(ζ(DL=k∪DU;Pk))≤d;∀d∈ζ(DLk;Pk);(5)
-
其中, ζ ( ⋅ , ⋅ ) ζ(·,·) ζ(⋅,⋅) 计算两个集合之间的所有样本的距离的集合。基于等式(5),可以通过倒易点与对应的已知类之间的对立来对样本进行分类。
-
-
具体来说,类的倒易点由m维表示表示,并且可以通过具有可学习参数θ的深度嵌入函数C来优化。给定样本x和倒易点Pk,通过组合欧几里得距离de和点积dd来计算它们的距离 d ( C ( x ) ; P k ) d(C(x);P^k) d(C(x);Pk) :
-
d e ( C ( x ) ; P k ) = 1 m ⋅ ∣ ∣ C ( x ) − P k ∣ ∣ 2 2 ; d d ( C ( x ) ; P k ) = C ( x ) ⋅ P k ; d ( C ( x ) ; P k ) = d e ( C ( x ) ; p i k ) − d d ( C ( x ) ; P k ) : d_e(C(x);P^k ) = \frac1 m · ||C(x) − P^k||^2_2 ;\\ d_d(C(x);P^k ) = C(x) · P^k ;\\ d (C(x);P^k ) = d_e(C(x); p^k_i ) − d_d(C(x);P^k ): de(C(x);Pk)=m1⋅∣∣C(x)−Pk∣∣22;dd(C(x);Pk)=C(x)⋅Pk;d(C(x);Pk)=de(C(x);pik)−dd(C(x);Pk):
-
每个已知类与其倒易点在空间位置和角度方向上都是相反的,欧几里德相似度和点积的结合能够更好地评价已知类嵌入特征与其倒易点之间的相似度。
-
-
基于提出的距离度量,我们的框架估计嵌入特征C(x)与所有已知类的倒易点之间的差异性,以确定它属于哪个类别。根据倒易点的性质,样本x属于类别k的概率与C(x)与倒易点 P k P^k Pk 之间的差异性成正比,其中,C(x)和 P k P^k Pk 之间的距离越大,则样本 x 被分配给标签 k 的概率越大。根据求和为一的特性,最终的分类概率用softmax函数进行归一化:
-
p ( y = k ∣ x ; C ; P ) = e γ d ( C ( x ) ; P k ) ∑ i = 1 N e γ d ( C ( x ) ; P i ) ; ( 7 ) p(y = k|x; C;P) =\frac{e^{γd(C(x); P^k )}}{\sum^N_{i=1} e^{γd(C(x); P^i)}} ; (7) p(y=k∣x;C;P)=∑i=1Neγd(C(x);Pi)eγd(C(x);Pk);(7)
-
其中γ是控制距离-概率转换难度的超参数。θ的学习是通过基于真类k的负对数概率最小化倒易点分类损失来实现的:
-
L c ( x ; θ ; P ) = − l o g p ( y = k ∣ x ; C ; P ) : ( 8 ) L_c(x; θ;P) = − log p(y = k|x; C;P): (8) Lc(x;θ;P)=−logp(y=k∣x;C;P):(8)
-
通过最小化对应于等式(4)中的 R ϵ ( f ; D L ) R_\epsilon(f; D_L) Rϵ(f;DL) 的等式(8),倒数点分类损失通过倒数点降低了经验分类风险。
-
-
除了对已知类别进行分类之外,最小化等式(8)的优点是通过如下最大化类别的倒易点与其对应的训练样本之间的距离来分离已知和未知空间:
-
a r g max f ∈ H { ζ ( D L k ; P k ) } : ( 9 ) arg\max_{f\in H}\{ζ(D^k_L;P^k )\}: (9) argf∈Hmax{ζ(DLk;Pk)}:(9)
-
虽然等式(8)和等式(9)有助于使封闭空间Sk和开放空间Ok的中心之间的间隔最大化,但是Ok在等式(8)中不受约束。因此,Sk和Ok可能具有不可估计的重叠(如图7(B)所示),这意味着开放空间风险仍然存在。
-
Adversarial Margin Constraint
-
为了降低等式(4)中的开放空间风险 R o ( f ; D U ) R_o(f; D_U) Ro(f;DU) ,提出了一种新的对抗性边际约束(AMC)来约束开放空间,其中每个特定类别k包含正开放空间 O k p o s O^{pos}_k Okpos 和无限负开放空间 O k n e g O^{neg}_k Okneg 。对于多类OSR场景,多个类开放空间被联合成全局开放空间OG:
-
O G = ∩ k = 1 N ( O k p o s ∪ O k n e g ) ; ( 10 ) O_G = ∩^N_{k=1} (O^{pos}_k ∪ O^{neg}_k ); (10) OG=∩k=1N(Okpos∪Okneg);(10)
-
其中,可以通过限制每个已知类别的开放空间风险来限制总的开放空间风险。
-
-
为了尽可能地分离Sk和Ok,必须限制开空间Ok,以便可以估计开集空间。我们的目标是通过将开空间Ok限制在有界范围内来降低每个已知类的开空间风险。这具有促进负/未知数据与小于R的倒数点之间的距离的最大值增加的效果。因此,建立以下公式:
- m a x ( ζ ( D L ≠ k ∪ D U ; P k ) ) ≤ R : ( 11 ) max(ζ(D^{\neq_k}_L ∪ D_U ; P^k )) ≤ R: (11) max(ζ(DL=k∪DU;Pk))≤R:(11)
-
显然,通过限制开放空间来管理开放空间风险几乎是不可能的,因为开放空间包含大量未知样本DU。然而,考虑到空间Sk和Ok彼此互补,可以通过将来自Sk的样本与倒易点Pk之间的距离约束为小于R来间接限制开放空间风险,如下所示:
- L o ( x ; θ ; P k ; R k ) = m a x ( d e ( C ( x ) ; P k ) − R ; 0 ) ; ( 12 ) L_o(x; θ;P^k ; R^k ) = max(d_e(C(x);P^k ) − R; 0); (12) Lo(x;θ;Pk;Rk)=max(de(C(x);Pk)−R;0);(12)
-
其中R是可学习的裕度,并且仅使用欧几里德距离而不是方向度量来获得更大范围的非k个样本。具体地,通过分类损失Lc最小化等式(12)等效于使等式(5)中的 ζ ( D L ≠ k ∪ D U ; P k ) ζ(D^{\neq_k}_L ∪ D_U ; P^k) ζ(DL=k∪DU;Pk) 与R相比尽可能小。这里我们使用一个定理来更好地说明我们的方法的优点。
-
定理1.对于logit层基于倒易点的神经网络, x ∈ D L k x\in D^k_L x∈DLk ,Lc和Lo同时最小当且仅当 m a x ( ζ ( D L ≠ k ; P k ) ) ≤ R max(ζ(D^{\neq_k}_L ; P^k))≤ R max(ζ(DL=k;Pk))≤R.证明。我们用反证法来证明。
-
对于 x ∈ D L k x\in D^k_L x∈DLk ,我们假设有一个范畴t: s ∈ D t s\in D^t s∈Dt 的样本,其中 t ≠ k t\neq k t=k,且 ζ ( s ; P k ) > R ζ(s; P^k)> R ζ(s;Pk)>R.
-
对于这样的样本,我们可以做出如下推断:首先,最小化Lc使每个类别k与其Pk之间的距离最大化。第二,当等式(12)中的 ∀ k ∈ { 1 ; . . . ; N } ; m a x ( ζ ( D L k ; P k ) ) ≤ R \forall k\in \{1;...; N\}; max(ζ(D^k_L; P ^k))≤ R ∀k∈{1;...;N};max(ζ(DLk;Pk))≤R 时,损失Lo最小化。损失Lo最小化,因此, ζ ( s ; P t ) ≤ R ζ(s; P t)≤ R ζ(s;Pt)≤R 。然后,样本s被分类到等式(7)中的类别k中,增加了损失Lc。
-
这些结果与我们刚才假定样本s属于范畴t的情况相矛盾。
-
因此,对于 x ∈ D L k x\in D^k_L x∈DLk,Lc和Lo同时最小当且仅当 m a x ( ζ ( D L ≠ k ; P k )) ≤ R max(ζ(D ^{\neq_k}_ L ; P^k))≤ R max(ζ(DL=k;Pk))≤R.
-
-
定理1进一步指出,可以通过用分类损失Lc限制如等式(12)中的目标已知类来获得等式(11)。(包括其他已知的类和潜在的开放空间)也被约束到有界空间中。一方面,可以预期等式(9)中的先前分类损失增加类k与其倒数点Pk之间的距离。另一方面,类k由其他倒易点 P ≠ k P^{\neq_k} P=k 限定如下:
-
a r g min f ∈ H { m a x ( { ζ ( D L k ; P ≠ k ) − R } ∪ { 0 } ) } : ( 13 ) arg \min_{f\in H}\{max(\{ζ(D^k_L;P^{\neq_k} ) − R\}∪ \{0\})\}: (13) argf∈Hmin{max({ζ(DLk;P=k)−R}∪{0})}:(13)
-
通过等式(9)和等式(13)之间的这种对抗机制,每个已知类被最大程度地推到有限特征空间的边缘,使每个类远离其潜在的未知空间。
-
-
另外,考虑到以倒易点Pk为中心,R为相应区间的有界空间 B ( P k ; R ) B(P^k; R) B(Pk;R) ,为了分离已知和未知空间,我们利用这些有界空间尽可能逼近全局未知空间OG,因此,公式(12)中损失的计算可以看作是降低开放空间风险 R o ( f ; D U ) R_o(f; D_U) Ro(f;DU) 在等式(4)中。
Learning the Open Set Network
-
在对抗互反点学习中,整体损失函数结合等式(8)和等式(12)来同时处理经验分类风险和开放空间风险:
-
L ( x ; y ; θ ; P ; R ) = L c ( x ; θ ; P ) + λ L o ( x ; θ ; P ; R ) ; ( 14 ) L(x; y; θ;P; R) = L_c(x; θ;P) + λL_o(x; θ;P; R); (14) L(x;y;θ;P;R)=Lc(x;θ;P)+λLo(x;θ;P;R);(14)
-
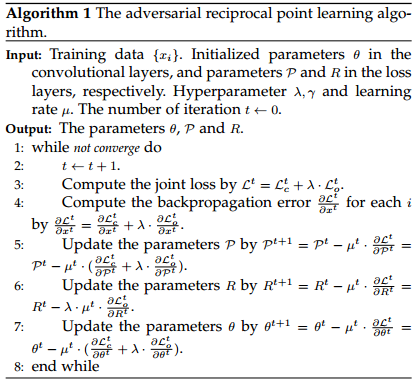
其中,λ是对抗性开放空间风险模块的权重,θ;P; R表示可学习的参数。Alg.1总结了联合监督开集网络的学习细节。这里还给出了一些额外的解释。
-
-
-
首先讨论了神经网络中的未知类问题,基于最大熵原理,对于一个未知样本xu,在没有任何先验信息的情况下,一个训练良好的闭集判别函数倾向于以均匀的概率将已知的标签分配给xu。DNN通常将未知样本的特征嵌入到具有较低幅度的空间中,而不是在整个空间中的随机位置。这种现象也与观察和可视化结果如图1所示。
-
对于真实的图像空间,“所有的正样本都是相似的;每个负样本都以自己的方式是负的”。然而,不提供各种负样本(未知)来训练神经网络,使得这些样本从神经网络获得比正样本(已知)更低的激活幅度。
-
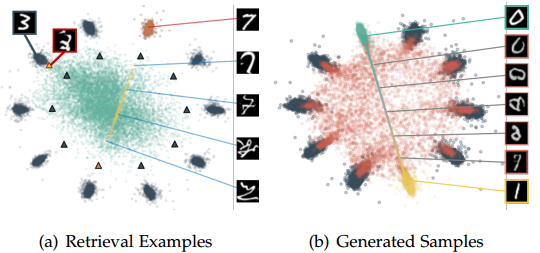
因此,大多数未知类分布在深层特征空间的低幅度区域,如图1和6(a)所示。此外,学习的倒易点也分布在低幅度区域,并将已知类推离低幅度区域,以区分已知和未知,如图7所示。如图6(a)所示,当我们从类中心移动到其倒数点时,检索到的图像逐渐变得不同。学习到的倒易点与未知类在深层特征空间中有更多的相似性,实际上并不能找到具体的现实样本。基本上,大量未知类之间的差异对于分类器来说仍然是未知的,大多数未知类对于一个分类器来说都有很大的共性,而这部分共性就是“未知”。
-
第二,我们讨论未知类和互反点。由于全局开空间OG更聚合,所以开集空间能够通过深嵌入空间中的倒易点来约束。如图3和图6(a)所示,用等式(14)学习将已知空间推到OG的外围,然后尽可能地分离两个空间。因此,通过对抗互反点学习(ARPL)形成了一个良好的嵌入空间结构,可以进一步划分已知类和大多数未知类。
INSTANTIATED ADVERSARIAL ENHANCEMENT
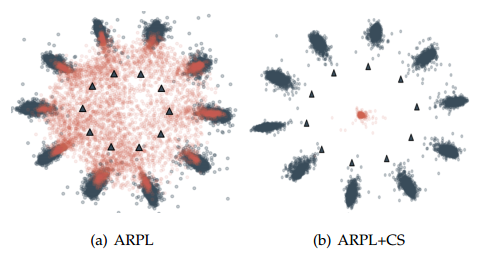
- 如图4(a)所示,ARPL分类器能够在没有未知数据的任何先验知识的情况下区分未知分布,但仍然容易受到简单生成器生成的混淆样本的影响,即使这些样本与已知类别完全不同。为了进一步降低由此类未知数据引起的开放空间风险,一个好的解决方案需要在合理的未知数据优化策略的支持下,最大限度地减少学习后的神经网络的开放空间。然而,在真实的场景中寻找有效的未知样本是一件大海捞针的事,因此,我们进一步生成混淆样本(CS)作为未知数据DU,以提高分类器对各种新型分布的区分能力。
-
-
图4:神经网络对来自混淆生成器的样本的特征响应的可视化。(a)仅由ARPL训练。(b)由ARPL+CS训练。红点表示通过实例化对抗增强生成的混淆样本的嵌入。
-
Learning the Confused Generator
-
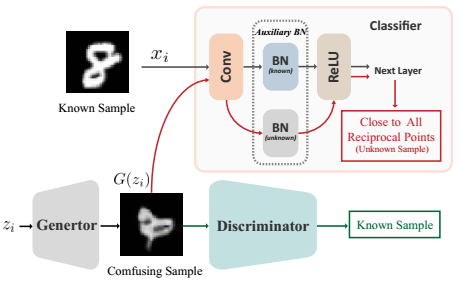
在这里,提出了一种新的训练策略来学习混淆的生成器。与常见的GAN 不同,我们希望使用生成器从OG中恢复一些混淆的样本,而不是从Sk中恢复已知样本。如图5所示,所提出的实例化对抗增强框架包含三个主要组件:判别器D,生成器G和具有深度嵌入函数C的分类器C。
-
-
图5:训练混淆生成器的基本框架。这里,生成器将潜在变量zi映射到生成的混淆样本G(zi),鉴别器专注于区分真实样本和生成样本。具有ABN的分类器由ARPL和FT训练。这里引入了一种已知类和互反点之间的对抗机制。一方面,生成的图像使鉴别器能够识别阳性样本(即接近已知样本的样本)。另一方面,生成的图像应该是分类器未知的样本,因此神经网络对这些样本的嵌入特征接近所有倒易点。
-
-
具有ARPL的分类器表示样本属于每个已知类别的概率。生成器将来自先验分布 P p r i ( z ) P_{pri}(z) Ppri(z) 的潜在变量z映射到生成的输出G(z),并且 D : X → [ 0 ; 1 ] D:X\rightarrow [0; 1] D:X→[0;1] 表示样本x来自真实的分布或伪分布的概率。然后,给定 { z 1 ; ⋅ ⋅ ⋅ ; z n } \{z_1; · · · ; z_n\} {z1;⋅⋅⋅;zn} 从先验 P p r i ( z ) P_{pri}(z) Ppri(z) 和已知样本 { x 1 ; ⋅ ⋅ ⋅ ; x n } \{x_1; · · · ; x_n\} {x1;⋅⋅⋅;xn} 中进行比较,则优化该阈值以区分真实的样本和生成的样本:
-
max D 1 n ∑ i = 1 n [ l o g D ( x i ) + l o g ( 1 − D ( G ( z i ) ) ) ] : ( 15 ) \max_D\frac1 n\sum^n_{i=1} [log D(x_i) + log(1 − D(G(z_i)))]: (15) Dmaxn1i=1∑n[logD(xi)+log(1−D(G(zi)))]:(15)
-
相比之下,生成器期望生成的样本更接近已知类,以便欺骗鉴别器:
-
max G 1 n ∑ i = 1 n [ l o g D ( G ( z i ) ) ] : ( 16 ) \max_G\frac1 n\sum^n_{i=1} [log D(G(z_i))]: (16) Gmaxn1i=1∑n[logD(G(zi))]:(16)
-
-
为了迷惑生成器,这里引入了已知类和倒易点之间的对抗机制,它鼓励生成器创建靠近开放空间Ok的每个中心P k的样本,类似于公式(10),相当于鼓励生成的图像靠近全局开放空间OG,形式上,通过分类器优化生成器:
-
max G 1 n ∑ i = 1 n [ − 1 N ∑ k = 1 N S ( z i ; P k ) ⋅ l o g ( S ( z i ; P k ) ) ] ; ( 17 ) \max_G\frac1 n\sum^n_{i=1} [−\frac1 N\sum^N_{k=1} S(z_i ;P^k ) · log(S(z_i ;P^k ))]; (17) Gmaxn1i=1∑n[−N1k=1∑NS(zi;Pk)⋅log(S(zi;Pk))];(17)
-
其中 S ( z i ; P k ) = s o f t m a x ( d e ( C ( G ( z i )) ; P k )) S(z_i ; P^k)= softmax(d_e(C(G(z_i)); P^k)) S(zi;Pk)=softmax(de(C(G(zi));Pk)) 。当这些样本的嵌入接近所有倒数点时,获得了用于混淆样本的等式(17)的最大值。引入定理以更好地说明这一点。
-
-
引理1。对于其logit层基于倒数点且x = G(z)的神经网络,等式( 17)。当深度特征向量C(x)和所有倒数点之间的距离相等时:被最大化: ∀ n ∈ N : S ( z i ; P k ) = 1 N \forall n\in N:S(z_i;P^k ) = \frac1 N ∀n∈N:S(zi;Pk)=N1,并且距离分布的熵被最大化。对于x = G(z),等式。(17)在形式上与每类softmax分数上的信息熵相同。因此,根据香农熵,很直观地,方程。当所有值相等时,( 17)最大化。通过结合这两种对抗机制,生成器通过以下方式得到优化:
-
max G 1 n ∑ i = 1 n [ l o g D ( G ( z i ) ) + β ⋅ H ( z i ; P ) ] ; ( 18 ) \max_G\frac1 n\sum^n_{i=1} [log D(G(z_i)) + β · H(z_i ;P)]; (18) Gmaxn1i=1∑n[logD(G(zi))+β⋅H(zi;P)];(18)
-
其中β是用于控制信息熵损失的权重的超参数, H ( z i ; p ) = − 1 N ∑ k = 1 N S ( z i ; P k ) H(z_i;p)=-\frac1N \sum^N_{k = 1}S(z_i;P^k) H(zi;p)=−N1∑k=1NS(zi;Pk) 日志 ( S ( z i ; P k ) ) (S(z_i;P^k)) (S(zi;Pk)) 是信息熵函数。如图5所示的框架,我们的目标是生成与已知样本更相似的样本;这也迫使生成器创建平衡所有倒易点的距离的样本,以便它们接近全局开放空间OG。如果生成的样本远离已知样本的边界,则等式(16)中的损耗应该大。
-
为了欺骗鉴别器,生成器生成与已知类相似的样本,这也使得生成的样本的特征接近已知类,而远离某些倒易点。因此,等式(17)中的损失应该大。因此,可以预期,所提出的损失将促使发生器产生位于全局开放空间边界上的样本,如图4(a)和图6(b)所示。
-
-
图6:(a)KMNIST的几个检索示例。橙色圆圈表示已知的类别编号7,橙色三角形表示与编号7对应的倒易点。左上角的红色样本表示故障情况,与已知的类别3非常相似。(b)在MNIST上使用ARPL分类器进行对抗训练,生成令人困惑的图像。最顶部和最底部对应于已知的训练图像。
-
Reliability Enhancement
-
把生成的样本看作未知数据DU,并考虑训练一个更好的特征空间的最终目标,其中开放空间最小化。因此,分类器C被生成的混淆样本优化为:
-
min C 1 n ∑ i = 1 n [ L ( x i ; y i ) − β ⋅ H ( z i ; P ) ] ; ( 19 ) \min_C\frac1 n\sum^n_{i=1} [L(x_i ; y_i) − β · H(z_i ;P)]; (19) Cminn1i=1∑n[L(xi;yi)−β⋅H(zi;P)];(19)
-
其中L是ARPL的总损失。这些生成的样本用于估计未知的OG分布,以通过减小OG的大小来降低开放空间风险(如图4(b)所示)。
-
-
注意,已知样本和生成的样本在等式(19)中独立处理。在这种情况下,生成的样本可能会使分类器混淆,因为它们与已知样本的分布不同,从而导致统计不准确。为了将这种混合分布分解为已知和混淆样本的两种基本分布,我们提出了辅助批量归一化(ABN ),以保证只为混淆样本获得归一化统计。
-
具体而言,批次归一化通过每个小批次内计算的平均值和方差对输入特征进行归一化,其中输入特征应来自单一或相似的分布。如图5所示,ABN通过为属于不同领域的特征保存单独的BN来帮助解开混合分布。与两分量混合分布(已知和混淆样本)相比,这种辅助BN能够有效阻断混淆样本对已知类别判别的负面影响。Sec5.3中的消融研究。证明对多个bn的这种不纠缠的学习可以提高性能。
-
最后,鉴别器和分类器可以通过混淆发生器相互改进。这自然暗示了一种联合训练方案,其中分类器改进生成器,反之亦然。同理,对于鉴别器来说也必然成立。如Alg中所示,交替算法2被设计来有效地优化上述目标。在用混淆样本训练每个分类器之后(Alg2中的步骤6),我们加入焦点训练(FT),利用已知类再次训练分类器。该方案的目的是鼓励分类器关注已知的分类,并纠正过分关注易混淆样本的偏差。
-
所提出的实例化对抗增强的主要区别如下:首先,该方法使用了由倒易点形成的封闭空间Sk和全局开放空间OG之间的对抗机制。其次,将生成的混淆样本和已知样本验证为两种不同的分布,以准确估计已知和未知类别的统计数据。此外,我们的方法生成的图像覆盖了未知特征空间的整个低响应(如图4所示),并包含一定数量的与已知类别相似的混淆图像(如图6(b)所示)。
Unknown Classes Detection
-
根据方程式(5),未知样本自然比已知类别的样本更接近所有倒易点。因此,测试实例x属于已知类别之一的概率与x与对应于类别k的最远倒数点之间的距离成正比:
- p ( k n o w n ∣ x ) ∝ max k ∈ { 1 ; . . . ; N } d ( f ( x ) ; P k ) : ( 20 ) p(known|x) \propto \max_{k\in\{1;...;N\}} d(f(x);P^k ): (20) p(known∣x)∝k∈{1;...;N}maxd(f(x);Pk):(20)
-
OSR模型中的一个关键问题是开放集识别的好分数是多少?(即将类标识为已知或未知)。由于在实际场景中不知道未知空间中的样本有多罕见或多常见,因此需要任意阈值或灵敏度进行比较的OSR方法是不合理的。因此,属于任何已知类别的已知和未知概率之间的差异用于衡量学习模型检测未知样本的能力,这提供了一种无需校准的检测性能度量。
EXPERIMENTS
Implementation Details
- 在所有训练阶段,γ设置为1.0,λ和β设置为0.1。它们都是通过交叉验证确定的。倒数点由随机正态分布初始化,每个边距初始化为1。对于开集识别,在编码器的最终卷积层之后添加全局平均池。在分布外样本的实验中,ResNet的全局平均池化(GAP)后的输出被用作特征。倒点的尺寸与GAP的输出一致。每个已知的类别都被分配了一个对等的训练点。除了MNIST,随机中心裁剪和随机水平翻转也被用作数据增强。在实验中,TinyImageNet中的图像被调整为64x64。在测试过程中,只有已知类的BN用于生成已知和未知类的深度特征。
Experiments for Open Set Recognition Datasets
-
数据集。与[C2ae: Class conditioned autoencoder for open-set recognition]类似,提供了每个数据集的这些协议的简单总结:
- MNIST,SVHN,CIFAR10。对于MNIST、SVHN和CIFAR10,随机抽样6个已知类和4个未知类。
- CIFAR+10、CIFAR+50。对于CIFAR+N实验,从CIFAR10中抽取4个类进行训练。N个不重叠的类被用作未知类,这些类是从CIFAR100数据集中采样的。
- TinyImageNet。对于TinyImageNet的实验,随机抽取20个已知类和180个未知类进行评估。
-
评估指标。由于在实际场景中未知空间的样本有多罕见或常见尚不清楚,因此需要任意阈值或灵敏度进行比较的OSR方法是不合理的。阈值无关指标,即受试者工作特征下面积(AUROC)曲线,被视为评估指标之一。AUROC曲线是阈值无关的度量,通过改变阈值来绘制真阳性率与假阳性率的关系。它可以被解释为正示例被分配比负示例更高的检测分数的概率。
-
然而,AUROC仅评估已知和未知类之间的区别,而不考虑开放集识别中已知类的准确性,然而,这一黄金标准“公平”指标隐藏了这一点。为了使其适应开放集识别的情况,我们引入了开放集分类率(OSCR)作为一种新的评估指标。设δ为分数阈值。正确分类率(CCR)是正确类别k具有最大概率并且概率大于δ的样本分数:
-
C C R ( δ ) = ∣ { x ∈ D T k ∧ a r g max k P ( k ∣ x ) = k ˉ ∧ P ( k ˉ ∣ x ) ≥ δ } ∣ D T k ∣ : ( 21 ) CCR(δ) = \frac{|\{x\in D^k_T \land arg\max_kP(k|x) = \bar k \land P(\bar k|x) ≥ δ\}} {|D^k_T|} : (21) CCR(δ)=∣DTk∣∣{x∈DTk∧argmaxkP(k∣x)=kˉ∧P(kˉ∣x)≥δ}:(21)
-
假阳性率(FPR)是来自未知数据DU的样本分数,这些样本被分类为任何已知的k类,其概率大于δ:
-
F P R ( δ ) = ∣ { x ∣ x ∈ D U ∧ max k P ( k ∣ x ) ≥ δ } ∣ ∣ D U ∣ : ( 22 ) FPR(δ) =\frac{|\{x|x\in D_U\land \max_kP(k|x) ≥ δ\}|}{|D_U|} : (22) FPR(δ)=∣DU∣∣{x∣x∈DU∧maxkP(k∣x)≥δ}∣:(22)
-
OSCR的值越大,表示检测性能越好。AUROC和OSCR在五项随机试验中取平均值。
-
-
网络架构。该实验的分类器与中使用的神经网络相同。除了TinyImageNet中使用的Adam优化器外,所有分类器都使用动量随机梯度下降(momentum SGD)优化器进行训练。分类器的学习率从0.1开始,在训练过程中每30个迭代周期降低0.1倍。混淆生成器和鉴别器与中的thos相同,并由Adam优化器以0.0002的学习率进行训练。更多细节见第5.1节。
-
结果比较。如表1所示,仅使用已知训练样本的ARPL明显优于大多数其他方法(包括基于传统判别方法的神经网络和一些复杂的OSR生成方法)。这些生成方法考虑使用解码器来优化深度特征空间,但它们没有注意到深度特征空间中未知分布的特征。
-
相反,ARPL通过倒易点将已知类与未知类推开,形成更好的判别特征空间。此外,具有混淆样本的ARPL(ARPL+CS)的性能明显优于其他最新最先进的生成方法 和ARPL,特别是在SVHN、CIFAR和TinyImageNet上。这进一步证明了所提出方法的优越性,这些令人困惑的样本可以有效地提高ARPL神经网络的可靠性。
-
此外,我们设计了一个新的OSR实验,以进行更合理的比较。首先,我们在[Open set learning with counterfactual images]中放弃了铰链损失的基线,这可能会导致一些优化困难。在这个实验中,更稳健的交叉熵损失被用作新的基线。其次,我们引入了一种新的评估指标OSCR,用于全面评估不同阈值下已知和未知类别检测的分类性能。最后,在相同的五个已知和未知分裂下,我们报告了五个试验的平均表现。
-
与表1中基于AUROC的实验相比,这个新的OSR实验中的大多数任务变得更加困难,因为这些方法应该平衡未知检测和已知类别的分类。我们比较了基于神经网络的四种判别方法,如表2所示。与交叉熵损失、GCPL和RPL相比,ARPL显示出优异的性能。此外,在混淆样本的帮助下,ARPL的OSCR得到了极大的提高。特别是,在TinyImageNet上,性能比ARPL提高了3.6%。这些结果表明,ARPL和ARPL+CS能够有效地提高未知样本的检测能力,同时保证已知类别分类的准确性。
-
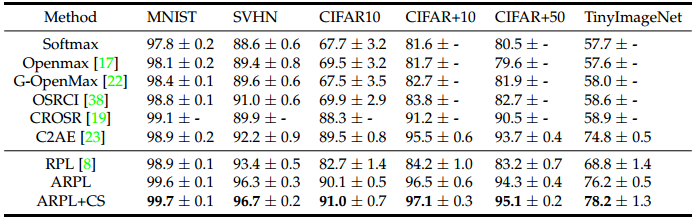
-
表1:检测已知和未知样本的AUROC结果。结果在五个随机试验中取平均值。
-
Experiments for Out-of-Distribution Detection
-
数据集。我们采用三个图像数据集进行评估,这些数据集代表了最具挑战性的常见OOD检测基准对、CIFAR10、CIFAR100、SVHN。CIFAR100和SVHN分别是CIFAR10的近OOD和远OOD数据集。请注意,CIFAR10和CIFAR100类是互斥的。
-
评估指标。采用AUROC、95%真阳性率(TPR)下的真阴性率(TNR)、精确召回曲线下面积(AUPR)和检测准确率进行评价:
- 95%真阳性率(TPR)时的真阴性率(TNR)。设TP、TN、FP和FN分别表示真阳性、真阴性、假阳性和假阴性。当TPR=T P/(FP+FN)为95%时,我们测量TNR=TN/(T P+T N)
- 精确召回曲线下面积(AUPR)。PR曲线是通过改变阈值绘制精度=TP/(TP+FP)与召回率=TP/(TP+FN)的图。AUIN(或AUOUT)是AUPR,其中内(或外)分布样本被指定为阳性。
- 检测精度(DTACC)。该度量对应于所有可能阈值δ上的最大分类概率。我们假设正样本和负样本出现在测试集中的概率相等,即 P ( x ∈ P i n ) = P ( x ∈ P o u t ) = 0.5 P(x\in P_{in})=P(x \in P_{out})=0.5 P(x∈Pin)=P(x∈Pout)=0.5.
-
网络架构。我们使用具有34层的ResNet在各种视觉数据集上证明了所提出方法的有效性。所有分类器都使用Adam优化器训练了100个迭代周期,批处理大小为128。分类器的学习率从0.1开始,在训练过程中每30个迭代周期降低0.1倍。混淆生成器和鉴别器与中的生成器和鉴别器相同,并由Adam优化器以0.0002的学习率进行训练。更多细节见第5.1节。
-
结果比较。如表3所示,ARPL仅在分布内数据方面优于三种方法的训练;这些方法是交叉熵损失(基线)、GCPL和RPL。对于包含接近和远离OOD的测试样本的CIFAR100,就AUROC而言,ARPL比RPL好3%以上。这证实了ARPL可以区分分布数据中接近或远离的OOD类。
-
此外,我们的方法与一个名为联合置信度损失(JCL)的生成式OOD模型进行了比较,该模型采用了与我们实例化的对抗增强类似的机制。由于考虑了深特征空间中未知样本和已知样本之间的差异,即使没有混淆样本的辅助训练,ARPL的性能也优于JCL。
-
在这里,我们分析了ABN和FT在实例化对抗增强中的作用。无ABN的ARPL+CS的性能远低于ARPL。这与我们的假设是一致的,即混淆的样本和已知的图像具有不同的潜在分布。尽管生成器旨在生成与已知类分布一致的图像,但在添加我们的对抗机制后,生成的图像和已知类的分布逐渐分离。混合分布的一个BN会影响检测OOD样本的性能。在添加ABN(ARPL+CS w/o FT)后,性能逐渐提高,特别是对于远OOD检测。
-
然而,与ARPL相比,近OOD的检测并没有得到改善。混淆样本可能会影响训练阶段已知类的判别特征。基于混淆样本的预先初始化,我们使用FT来鼓励分类器更加关注已知类的分类。如表3所示,近端和远端OOD的性能都得到了进一步的提高。
Ablation Study
ARPL vs. Softmax.
-
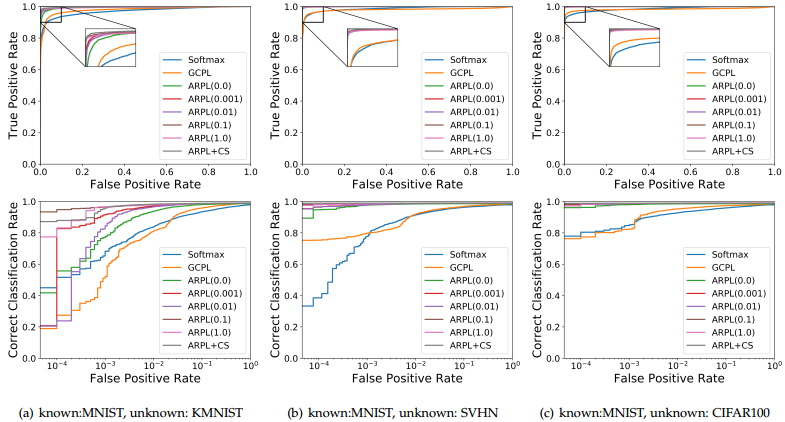
分类损失项(方程式(14)的第一部分)定义了倒易点的分类原则。与softmax类似,仅在这种分类损失的情况下,学习表示仍然是线性可分的。如图1(b)和7(b)所示,没有Lo的倒易点被学习到原点,在整个特征空间的低响应部分,已知和未知类之间存在显著重叠。此外,观察图9中的OSCR曲线,当softmax的FPR较低时,CCR较低。这就是为什么用softmax学习的神经网络以高置信度将未知样本检测为已知类别的原因。
-
相比之下,具有Lo约束开放空间的ARPL实现了更好的分布(如图7(c)所示),其中整个特征空间包含在有限的范围内(图7(b)中未知量的横坐标为1-13.5,已知量的横截面为14-17),以防止未知类的高置信度。即使在图9中的低FPR下,具有Lo的APRL也可以保证高精度,因为Lo对开放空间的有效限制,并将已知类别推离了全局开放空间。
-
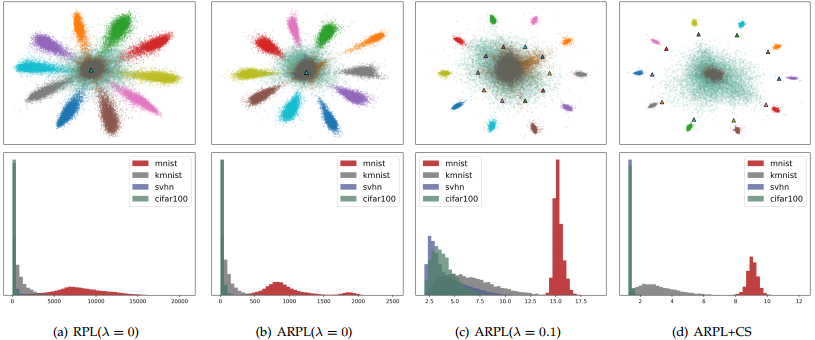
-
图7:(1)第一行是已知的MNIST和未知的KMNIST、SVHN、CIFAR100的学习特征空间中的可视化。中间的颜色形状是未知的数据,彩色圆圈是已知样本的数据。不同的颜色代表不同的阶级。彩色三角形表示从不同已知类别中学习到的互点。(2) 第二行是特征和倒易点之间的最大距离分布。
-
ARPL vs. GCPL.
- 如图1(c)所示,GCPL使用原型来减少类内方差。然而,在不考虑未知的情况下,GCPL将未知类扩展到整个特征空间,从而导致与已知类的显著重叠。在神经网络训练的初始阶段,GCPL的原型很容易分布在未知的特征空间中。这也导致一些已知的类别分布在特征空间的较低响应部分,这增加了开放空间的风险。
- 如图9所示,GCPL的AUROC和OSCR性能比softmax差。相比之下,ARPL不受初始化的影响,因为每个已知类都远离其相应的未知表示,这是一个倒易点。在分类损失和Lo的相互作用下,不同的已知类别扩展到空间的外围,而未知类别仅限于内部。如图7(c)所示,两种类型的样品(已知与未知)之间保持明显的间隙。ARPL通过有界约束防止对未知类别的误判,从而增强和稳定已知类别的分类,提高了神经网络的鲁棒性。
ARPL vs. RPL.
-
如表1、表2和表3所示,ARPL相较于RPL有了显著提升。与RPL相比,ARPL通过弹性有界空间提高了相似性估计,降低了开放空间风险。首先,对于方程(6)中特征点和倒易点之间的距离,添加角度度量。
-
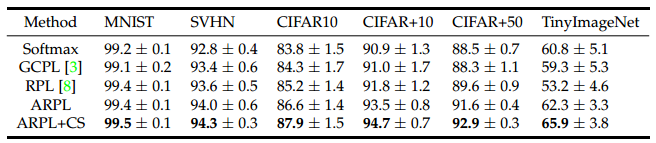
-
表2:开放集识别的开放集分类率(OSCR)曲线结果。结果在五个随机试验中取平均值。
-
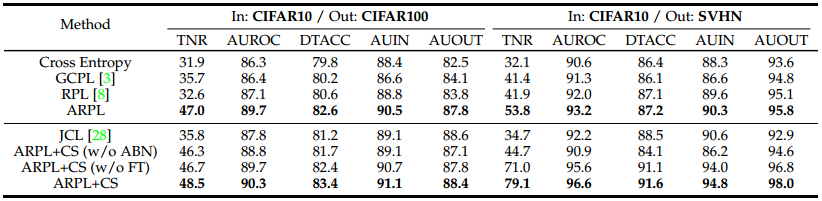
-
表3:在各种验证设置下区分图像分类的分布内和分布外测试集数据。所有值均为百分比,最佳结果以粗体显示。
-
-
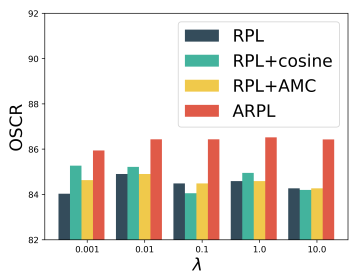
每个已知类在空间位置和角度方向上与其倒易点相反。比较图7(a)和图7(b),ARPL中每个类的特征之间有更大的空间(λ=0),每个类都更紧凑。如图8所示,添加角度度量有效地减少了类内距离,从而在不同的λ下实现了更好的性能。其次,我们不再将已知类和相应倒易点之间的距离限制在相同的范围内,我们在方程(12)中使用自适应正则化。中更强的限制将降低网络对所有已知类别的可区分性。
-
-
图8:以CIFAR10为已知数据,CIFAR100为未知数据的λ消融实验。
-
-
如果这个限制太大,分类和未知检测的性能将降低。它对中超参数λ的设置也很敏感。与图8中的ARPL和RPL+AMC相比,RPL和RPL+余弦的性能受λ的影响更大,性能更不稳定。对于AMC,可学习值R被用作锚点。通过不断调整倒易点和深度特征,将所有已知类提升到小于R,以便自适应地关注难以区分未知量的样本。通过等式(12)中的这种对抗性边缘约束,神经网络不再关注满足等式(11)中条件的样本,而是更加关注优化有界样本。
ARPL vs. ARPL + Confusing Samples.
- 从OOD检测的实验来看,CS在检测远OOD方面进一步提高了ARPL。此外,如图7(c)和图7(d)所示,混淆的样本使MNIST、SVHN和CIFAR100之间的差异更大。请注意,SVHN和MNIST具有相同的类,即数字0-9,但它们也被准确地检测为未知类。这种差异的主要原因是图像域、彩色图像与黑白图像的差异。这也证明了所提出的方法能够拒绝来自不同领域的数据。
- 对于KMNIST来说,ARPL+CS似乎并没有在图7(d)中的特征可视化方面带来太大改善。KMNIST的样本很难被分类器区分,并且在形状和结构上与MNIST的样本有更多的相似之处。然而,如表3和图9所示,ARPL+CS仍然提高了对这些令人困惑的样本的检测能力。一般来说,混淆样本有效地提高了ARPL检测各种未知类别的能力,同时确保了已知类别分类的准确性。
-
-
图9:(1)第一行是应用于已知MNIST数据和未知KMNIST、SVHN、CIFAR100数据的接收器工作特性下面积(AUROC)。(2)第二行是为相同算法提供的开集分类率曲线。与AUROC相比,通过开放集分类率曲线可以观察到更显著的差异。
-
ABN & FT
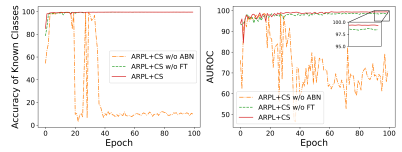
- 如果直接添加第4节中的两个相反的约束,训练过程将不稳定。因此,我们提出ABN和FT来提高可靠性。如图10所示,没有ABN的ARPL训练最终在MNIST上崩溃。已知和未知类独立使用自己的BN,因此当未知样本和已知样本的分布非常不同时,已知类的训练过程不会受到影响。通过ABN的稳定性训练程序,FT进一步提高了区分已知和未知类别的能力。通过ABN和FT,ARPL+CS可以同时提高神经网络区分已知类的能力和判断各种未知类的可辨别性。
-
-
图10:ABN和FT对训练过程中检测未知的已知和AUROC准确性的影响,其中MNIST是已知数据集,KMNIST是未知数据集。ABN可以确保限制样本不会对分类器产生负面影响,FT进一步增强了区分未知类别的能力。
-
Analysis of the Margin.
-
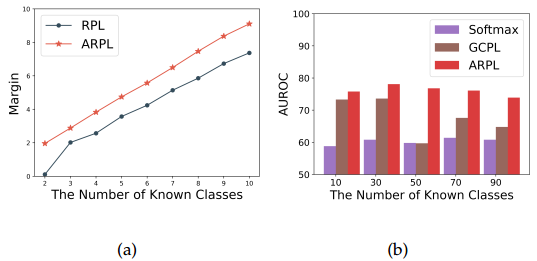
不同的数据集需要不同大小的深度特征空间,以确保已知和未知能够被正确分类。图11(a)证明,在λ固定的情况下,裕度随着已知类的数量而增加。此外,如图12所示,在不同数量的已知类下学习的特征分布对于已知类和未知类仍然是有区别的。如图11(b)所示,与具有不同已知类别数量的softmax和GCPL相比,ARPL在检测未知类别方面也可以保持更好的性能。
-
-
图11:(a):边际随已知类别数量的变化趋势。(b):AUROC性能基于CIFAR100上已知类的不同数量,其中剩余类为未知。
-
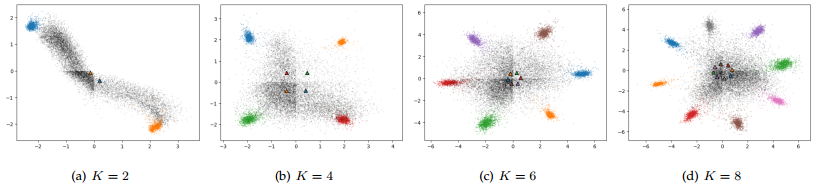
-
图12:ARPL在不同已知类别数量下的学习表示。数据来自MNIST,随机抽样K个已知类和10-K个未知类。彩色三角形代表不同已知类的学习倒易点。
-
-
Softmax和GCPL只增强了特征的可分离性,不能很好地区分已知和未知类别。ARPL可以通过将已知样本推离潜在的未知空间来区分已知和未知类别。这一现象证明了多个类别学习的空间分布的合理性。ARPL可以通过学习更合适的嵌入空间大小来有效地控制不同已知类之间的交互。因此,之前关于ARPL的结论仍然适用于不同数量的已知类别。
-
此外,对于开集识别,训练中提供了固定的已知类,而未知类是无限的。如上所述,对与所提供的已知类不同的大多数未知分布进行了倒易点建模。然而,有一些未知的类与已知的类非常相似,甚至很难通过人眼区分它们。在这种情况下,神经网络很容易受到有限的已知先验的影响,从而产生高的特征响应。这也是图6(a)左上部分受到KMNIST开放集数据影响的原因。我们将在未来的研究中探讨这些挑战。
Further Analysis
Analysis of Closed Set Recognition.
-
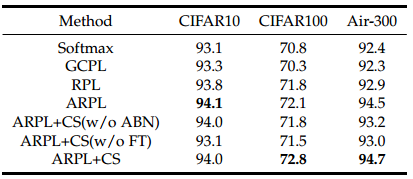
我们采用34层的ResNet 对CIFAR10、CIFAR100和Air-300飞机进行闭集识别。Air-300总共包含来自300个不同类别的320000张带注释的彩色图像。每个类别至少包含100张图像,最多包含10000张图像,这导致了长尾分布。所有类别分为两部分,分别有180个已知类别用于训练,120个新的未知类别用于测试。与现有的基准数据集相比,定制的Air-300数据集保持了长尾分布,以模拟真实的视觉世界。在这里,我们关注180个已知类别中模型的闭集精度。在这个实验中,Air-300的图像被中心裁剪并调整为64x64。
-
如表4所示,ARPL的性能与传统的softmax和原型学习方法GCPL相当。通过使用倒易点将已知类推离全局开放空间,增加了已知类之间的类间距离,这样神经网络就可以通过ARPL学习已知类的更多判别特征。这证明了ARPL对传统闭集识别任务的有效性。
-
-
表4:CIFAR10、CIFAR100和Air-300上不同方法的测试准确性。最佳结果以粗体显示。
-
-
此外,通过结合CS,ARPL+CS的闭集精度不会降低,甚至可以在CIFAR100和Air-300上执行更好的ARPL。ARPL+CS不受混淆样本的影响,混淆样本在很大程度上取决于所提出的ABN和FT。如果没有ABN或FT,由于与混淆样本的偏差,闭集精度可能会降低。这些结果表明,ARPL和ARPL+CS可以提高神经网络区分已知类的能力和判断各种未知类的可辨别性。
Semantic Shift versus Non-semantic Shift
-
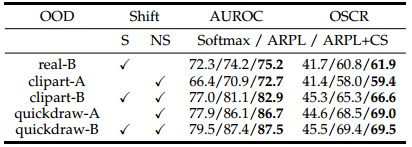
通过大规模数据集DomainNet探索更复杂的开放集场景。DomainNet有来自六个不同域的345个类的高分辨率图像。在进行实验时,数据集中有三个具有类标签的域。这些是真实的、剪贴画的和快速绘制的,它们会导致不同类型的分布变化。为了创建具有语义转换的子集,所有类都被分成两部分。拆分A的类索引为0到172,而拆分B的索引为173到334。我们的实验使用real-A表示分布内,使用其他子集表示分布外。根据中给出的定义,real-B与real-a有语义转换,而clipart-a有非语义转换。因此,Clipart-B具有两种类型的分布偏移。
-
我们用34层训练ResNet,训练100个迭代周期,批处理大小为128,SGD优化器的动量为0.9。学习率从0.01开始,在训练过程中每30个周期降低0.1倍。在这个实验中,图像被中心裁剪并调整为80x80。
-
表5中的结果显示了一些趋势。首先,具有这两种分布偏移的OOD数据集更容易检测,其次是非语义偏移。第二个观察结果是,与softmax相比,ARPL可以有效地检测所有分布偏移。特别是对于OSCR,ARPL实现了良好的性能改进。最后,混淆样本在不同领域中起着重要作用,可以提高ARPL的检测性能。近域可以从混淆的样本中获得更大的改进。
-
-
表5:使用DomainNet的三种方法的性能。已知的是实数A子集。分布移位的类型对OOD检测问题呈现出一种困难的趋势:语义移位(S)>非语义移位(NC)>语义+非语义移位。
-
Experiments on ImageNet.
-
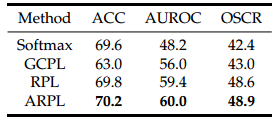
为了更好地将我们的方法与传统的softmax进行比较,我们在更大、更困难的ImageNet-1K数据集上进行了实验。ImageNet-1K包含1000个类,其中包含超过1200000个训练图像和50K个验证图像。此外,ImageNet-O被用作ImageNet-1K的分布外数据集。ImageNetO包括来自ImageNet-22K的2K个示例,不包括ImageNet-1K。ResNet 18 在ImageNet-1K上训练,并在ImageNet-1 K和ImageNet-O上进行测试。
-
如表6所示,即使在大型和困难的数据集上,ARPL在接近集精度(ACC)和未知检测(AUROC)方面的表现也优于传统的softmax、GCPL和RPL。特别是,对于未知检测,ARPL比softmax提高了约12%。由于倒易点对全局开放空间的约束,我们的方法可以确保更好地分离已知和未知类,同时确保对已知类的准确识别。这些结果表明,ARPL在大规模数据集中具有出色的可扩展性。
-
-
表6:不同方法在更大、更困难的数据集上的开放集识别性能,其中ImageNet-1K为已知数据集,ImageNet-O为未知数据集。
-
Extension for Class-Incremental Learning.
-
为了验证增量学习中互反点的潜力,我们用34层训练ResNet对CIFAR100进行分类。我们假设分类器在一定数量的基类上进行预训练,并逐步提供具有相应数据集的新类。在这种增量场景中,CIFAR100类的一半被设置为基类,其余的被设置为新类。该实验分五次进行,每次随机生成类别分割,然后报告平均结果。
-
由于基类的倒易点分布在可能包含新类的未知深度特征空间中,我们试图使用倒易点来表示新类。为了进行比较,我们考虑使用不同的基集来表示基类和新类,其中这些基是通过其他方法学习的。具体来说,对于softmax分类器,最后一个线性层的权重被用作一组基,因此logit是基于这些基的系数。同样,基类的原型和倒易点可以是不同的基集来表示不同的类,它们的logit分数用于分类。
-
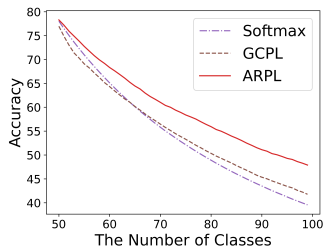
通过整体精度对实验进行评估,结果如图13所示。随着新类数量的增加,所提出的互易点明显优于其他方法。在初始精度相似的情况下,倒易点可以更好地抵抗灾难性遗忘。实验结果证明了我们的倒易点的优越性。未来将进一步探索增量学习中互反点的潜力。
-
-
图13:CIFAR100上课堂增量学习的实验结果。我们报告了添加最后一个新类后的总体准确性。
-
CONCLUSION
-
本文从多类集成的角度阐述了开放空间风险,引入了一个新概念——交互点,对每个已知类别对应的类外空间进行建模。我们引入了一种新的学习框架,对抗互反点学习,以促进可靠的开集神经网络。具体而言,引入了一个具有对抗性边际约束的分类框架,以降低经验分类风险和开放空间风险。
-
对抗边际约束的合理性在理论上由定理1保证。此外,为了从开放空间中估计未知分布,设计了一个实例化的对抗增强,从已知数据和对等点之间的对抗中生成更多样化的混淆训练样本。我们的方法打破了传统神经网络中的封闭世界假设,采用开放世界倒易点来区分已知和未知样本。在多个数据集上进行的大量实验表明,我们的方法在所有情况下都优于以前最先进的开集分类器。
-
本文还揭示了神经网络对未知类的识别主要基于已知先验,因此未知类的分布更多地集中在深度特征空间的低响应区域,而已知类分布在高响应空间。这与新皮质区域通过交错学习从海马体获得结构化知识的观察结果非常相似。未来,我们将深入探讨少镜头学习的神经机制,并利用其提高神经网络检测和学习未知类别的能力。
-
开放集识别(OSR)定义:同时分类已知类、识别未知类为“unknown”;同步降低经验分类风险(已知数据)与开放空间风险(未知数据)。现有方法不足:判别模型(如Softmax、Openmax),仅关注已知类分离,无法有效区分已知与未知;生成模型(如GAN、C2AE),未考虑未知类在深度特征空间的分布,开放空间风险高;原型学习(如GCPL):原型易收敛到未知空间,导致已知与未知重叠
-
核心概念与方法:互反点(Reciprocal Point),每类已知样本对应的类外空间(其他已知类+未知类)的潜在表示,距离计算:结合欧氏距离(空间位置)与点积(角度方向)。
-
ARPL框架:分类损失(Lc):基于互反点的负对数概率,最大化已知类与对应互反点距离;对抗性边际约束(AMC):通过损失Lo限制类外空间在有界范围,理论由定理1证明合理性;整体损失:L = Lc + λ·Lo(λ=0.1,交叉验证确定)。
-
实例化对抗增强:混淆样本(CS)生成:生成器、判别器、分类器三方对抗,使样本接近开放空间;可靠性增强:ABN:分离已知/混淆样本的归一化统计,避免混淆样本干扰;FT:用已知类重新训练,纠正分类器对混淆样本的过度关注。
-
ARPL 框架中,互反点与对抗性边际约束(AMC)如何协同作用以同时降低经验分类风险和开放空间风险?
- 互反点通过 “建模类外空间” 降低经验分类风险:每类已知样本的互反点代表其 “非样本”(其他已知类 + 未知类)的潜在特征,分类损失( L c \mathcal{L}_c Lc )通过最大化已知样本与对应互反点的距离(结合欧氏距离与角度点积),使已知类特征在深度空间中更紧凑且与类外空间分离,从而提升已知类分类精度(降低经验分类风险)。
- 对抗性边际约束(AMC)通过 “限制类外空间” 降低开放空间风险:AMC 对应的损失 L o \mathcal{L}_o Lo引入可学习边际 R,强制类外样本(其他已知类 + 未知类)与互反点的距离不超过 R,将开放空间约束在有界范围内;结合定理 1 的理论保障 L c 与 L o \mathcal{L}_c与\mathcal{L}_o Lc与Lo 同时最小化需满足 “其他已知类与当前互反点距离≤R”),避免未知样本被误判为已知类,从而降低开放空间风险。
- 两者协同: L c \mathcal{L}_c Lc 推动已知类远离互反点(扩大类内与类外的距离), L o \mathcal{L}_o Lo 限制类外空间的范围(避免开放空间无界),最终使已知类分布在特征空间边缘,未知类被限制在内部,实现两类风险的同步降低(图 3 (b))
-
ABN 与 FT 的必要性:
- ABN:已知样本与混淆样本的深度特征分布存在差异(即使生成样本外观接近已知类,其特征仍属于开放空间),共享 BN 层会导致统计偏差(如均值、方差混淆),使已知类分类精度下降;ABN 为两类样本设置独立 BN 层,分离其归一化统计,避免混淆样本对已知类分类的干扰。
- FT:生成器优化过程中,分类器可能过度关注混淆样本的特征,导致对已知类的分类能力偏移;FT 通过用已知样本重新训练分类器,纠正这种偏移,确保已知类分类精度不下降的同时,提升对未知类的检测能力(实验显示无 FT 时,近 OOD 检测性能无提升)。
ARPL 的模型设计围绕 “同步降低经验分类风险(已知数据)与开放空间风险(未知数据)” 展开,核心模块包括互反点、距离度量、损失函数、实例化对抗增强四大类
互反点
- 互反点(Reciprocal Point),互反点是 ARPL 最核心的创新概念,定义为 “每类已知样本对应的类外空间(即‘其他已知类 + 所有未知类’)的潜在代表性特征”。其核心作用是在无真实未知样本的情况下,实例化建模未知空间—— 通过互反点代理 “非当前已知类” 的特征分布,让模型通过 “区分‘非已知类’” 间接实现 “识别已知类”,解决 OSR 中 “未知空间不可见” 的根本问题。
- 突破传统原型学习(如 GCPL)“直接学习已知类原型” 的思路,采用 “反向定义” 逻辑:传统方法通过 “学习‘什么是猫’” 识别猫,而互反点通过 “学习‘什么不是猫’”(即非猫的特征用互反点表示)来定位猫的特征空间。这种思想使模型天然关注 “已知类与类外空间的边界”,而非仅关注已知类内部的紧凑性。
- 互反点 P k \mathcal{P}^k Pk 是 m 维可学习向量(m 与深度嵌入维度一致,即全局平均池化(GAP)输出维度),对应第 k 类已知样本的类外空间 O k = O k p o s ∪ O k n e g O_k = O_k^{pos} \cup O_k^{neg} Ok=Okpos∪Okneg,( O k p o s O_k^{pos} Okpos 为其他已知类, O k n e g O_k^{neg} Okneg 为未知类)的实例化表示。其数学意义是 “类外空间的中心代理”,满足 “类外样本与 P k \mathcal{P}^k Pk 的距离 ≤ 已知样本与 P k \mathcal{P}^k Pk 的距离”,确保互反点能有效区分已知与类外空间。
距离度量:欧氏距离 + 点积(多维度相似性评估)
- 为精准评估 “已知类特征与互反点的差异”,ARPL 设计了融合空间位置与角度方向的距离度量,避免传统单一距离(如仅欧氏距离)“只看位置不看方向” 导致的误判(例如:两个点空间距离近但角度方向完全相反,可能属于不同空间)。其作用是更全面地约束已知类特征与互反点的 “对立性”,确保已知类特征远离类外空间。
- 通过 “空间位置差异(欧氏距离)+ 角度方向差异(点积)” 双维度评估相似性:欧氏距离衡量特征在嵌入空间中的绝对位置距离,点积衡量特征向量的角度方向一致性(点积越小,角度差异越大),两者结合确保已知类特征与互反点在 “位置上远离、方向上对立”。
- 距离计算包含三个部分:欧氏距离 d e d_e de:衡量空间位置差异,采用 L2 范数平方的均值(避免梯度爆炸,同时保留距离单调性): d e ( C ( x ) , P k ) = 1 m ⋅ ∥ C ( x ) − P k ∥ 2 2 d_e(\mathcal{C}(x), \mathcal{P}^k) = \frac{1}{m} \cdot \|\mathcal{C}(x) - \mathcal{P}^k\|_2^2 de(C(x),Pk)=m1⋅∥C(x)−Pk∥22,其中 C ( x ) \mathcal{C}(x) C(x) 是样本 x 的深度嵌入,m 为嵌入维度。点积 d d d_d dd:衡量角度方向差异,利用点积与向量夹角的关系( C ( x ) ⋅ P k = ∥ C ( x ) ∥ ⋅ ∥ P k ∥ ⋅ cos θ \mathcal{C}(x) \cdot \mathcal{P}^k = \|\mathcal{C}(x)\| \cdot \|\mathcal{P}^k\| \cdot \cos\theta C(x)⋅Pk=∥C(x)∥⋅∥Pk∥⋅cosθ,θ 为两向量夹角),点积越小,角度差异越大: d d ( C ( x ) , P k ) = C ( x ) ⋅ P k d_d(\mathcal{C}(x), \mathcal{P}^k) = \mathcal{C}(x) \cdot \mathcal{P}^k dd(C(x),Pk)=C(x)⋅Pk。
损失函数:双损失协同优化(分类损失 + 对抗性边际约束损失)
- ARPL 的损失函数是 “同步降低两类风险” 的核心,由分类损失( L c \mathcal{L}_c Lc) 和对抗性边际约束损失( L o \mathcal{L}_o Lo) 加权组成,整体损失为 L = L c + λ ⋅ L o \mathcal{L} = \mathcal{L}_c + \lambda \cdot \mathcal{L}_o L=Lc+λ⋅Lo(λ=0.1,通过交叉验证确定)
分类损失 L c \mathcal{L}_c Lc:降低经验分类风险
- 通过 “最大化已知样本与对应互反点的距离”,使已知类特征在嵌入空间中更紧凑、与类外空间更分离,从而提升已知类的分类精度,对应降低 “经验分类风险”( R ϵ \mathcal{R}_\epsilon Rϵ).
- 借鉴 softmax 分类逻辑,但将 “类中心” 替换为 “互反点”:传统 softmax 通过样本与类中心的距离计算概率,ARPL 通过样本与互反点的距离计算概率 ——样本与某类互反点的距离越大,属于该类的概率越高(因为距离大说明样本越远离 “非该类” 空间)。
- 基于 “距离 - 概率” 转换的负对数似然损失,分类概率:通过 softmax 将距离转换为概率,γ 为超参数(控制距离 - 概率转换的 “硬度”,实验中设为 1.0): p ( y = k ∣ x , C , P ) = e γ ⋅ d ( C ( x ) , P k ) ∑ i = 1 N e γ ⋅ d ( C ( x ) , P i ) p(y=k|x,\mathcal{C},\mathcal{P}) = \frac{e^{\gamma \cdot d(\mathcal{C}(x), \mathcal{P}^k)}}{\sum_{i=1}^N e^{\gamma \cdot d(\mathcal{C}(x), \mathcal{P}^i)}} p(y=k∣x,C,P)=∑i=1Neγ⋅d(C(x),Pi)eγ⋅d(C(x),Pk),其中 N 为已知类数量。分类损失:最小化真实类 k 的负对数概率,迫使模型最大化已知样本与 P k \mathcal{P}^k Pk 的距离: L c ( x ; θ , P ) = − log p ( y = k ∣ x , C , P ) \mathcal{L}_c(x;\theta,\mathcal{P}) = -\log p(y=k|x,\mathcal{C},\mathcal{P}) Lc(x;θ,P)=−logp(y=k∣x,C,P),θ 为深度网络参数。
对抗性边际约束损失 L o \mathcal{L}_o Lo:降低开放空间风险
- 通过 “限制类外空间在有界范围”,避免未知样本因 “开放空间无界” 被误判为已知类,从而降低 “开放空间风险” R o \mathcal{R}_o Ro。引入可学习边际 R,将类外空间(其他已知类 + 未知类)约束在以互反点 P k \mathcal{P}^k Pk 为中心、R 为半径的有界球内 B ( P k , R ) B(\mathcal{P}^k, R) B(Pk,R) 。这种 “有界约束” 确保模型不会对未知样本产生过高置信度 —— 若未知样本超出该球,则会被判定为 “未知”。
- 基于 “距离 - 边际” 的 max 损失,损失计算:仅当类外样本与 P k \mathcal{P}^k Pk 的欧氏距离超过 R 时,产生损失(迫使模型调整参数,将类外样本拉回球内): L o ( x ; θ , P k , R ) = max ( d e ( C ( x ) , P k ) − R , 0 ) \mathcal{L}_o(x;\theta,\mathcal{P}^k,R) = \max(d_e(\mathcal{C}(x), \mathcal{P}^k) - R, 0) Lo(x;θ,Pk,R)=max(de(C(x),Pk)−R,0)。反证法证明: L c 与 L o \mathcal{L}_c 与 \mathcal{L}_o Lc与Lo 同时最小化,当且仅当 “所有其他已知类样本与 P k \mathcal{P}^k Pk 的最大距离 ≤ R”。这意味着 “类外空间被约束在球内”,从理论上确保开放空间风险可控。
实例化对抗增强:混淆样本 + 可靠性增强(提升未知类区分能力)
-
仅靠互反点仍无法完全覆盖 “未知分布的多样性”,ARPL 设计实例化对抗增强模块,通过生成 “混淆样本(CS)” 模拟未知分布,并结合辅助批量归一化(ABN) 和聚焦训练(FT) 解决 “混淆样本干扰已知类分类” 的问题。
-
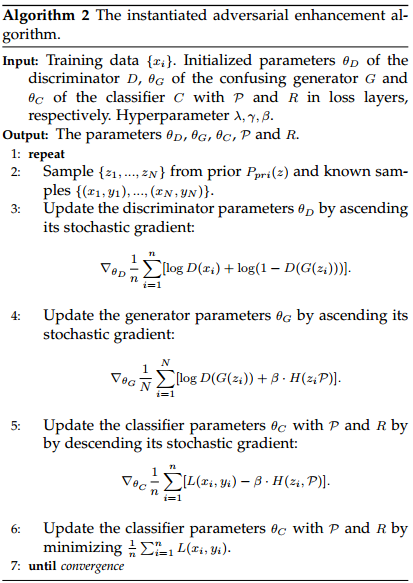
生成 “既接近已知类外观(欺骗判别器),又属于开放空间(接近所有互反点)” 的混淆样本,作为 “未知样本代理”,帮助模型学习 “已知 - 未知” 的边界,进一步降低开放空间风险。基于生成器(G)、判别器(D)、分类器(C)三方对抗(区别于传统 GAN 的 “G-D 双方对抗”):
- 判别器 D:区分 “真实已知样本” 与 “生成样本”,确保生成样本外观接近已知类;判别器 D 优化(最大化区分能力): max D 1 n ∑ i = 1 n [ log D ( x i ) + log ( 1 − D ( G ( z i ) ) ) ] \max_D \frac{1}{n} \sum_{i=1}^n [\log D(x_i) + \log(1-D(G(z_i)))] maxDn1∑i=1n[logD(xi)+log(1−D(G(zi)))],其中 x i x_i xi 为真实已知样本, G ( z i ) G(z_i) G(zi) 为生成样本( z i 来自先验分布 P p r i ( z ) z_i 来自先验分布 P_{pri}(z) zi来自先验分布Ppri(z))。
- 生成器 G:需同时满足 “欺骗 D” 和 “接近开放空间”(通过分类器 C 的熵约束); max G 1 n ∑ i = 1 n [ log D ( G ( z i ) ) + β ⋅ H ( z i , P ) ] ,其中 H ( z i , P ) \max_G \frac{1}{n} \sum_{i=1}^n [\log D(G(z_i)) + \beta \cdot H(z_i, \mathcal{P})],其中 H(z_i, \mathcal{P}) maxGn1∑i=1n[logD(G(zi))+β⋅H(zi,P)],其中H(zi,P) 为 “生成样本与所有互反点距离分布” 的信息熵(最大化熵确保生成样本与所有互反点距离相等,即接近全局开放空间 (O_G)(引理 1)),β 为熵权重。
- 分类器 C:利用生成样本优化,提升对 “类外样本” 的区分能力。分类器 C 优化(利用生成样本提升区分能力): min C 1 n ∑ i = 1 n [ L ( x i , y i ) − β ⋅ H ( z i , P ) ] \min_C \frac{1}{n} \sum_{i=1}^n [\mathcal{L}(x_i,y_i) - \beta \cdot H(z_i, \mathcal{P})] minCn1∑i=1n[L(xi,yi)−β⋅H(zi,P)],通过生成样本调整参数,降低对类外样本的误判概率。
-
辅助批量归一化(ABN):分离 “已知样本” 与 “混淆样本” 的归一化统计(均值、方差),避免两者分布差异导致的统计偏差(例如:混淆样本的特征分布偏开放空间,共享 BN 会拉偏已知样本的归一化结果)。为已知样本和混淆样本分别设置独立的 BN 层,在训练时仅用对应样本的统计量更新 BN 参数,推理时仅用已知样本的 BN 参数。基于批量归一化(BN)的 “域适应性”——BN 对输入分布敏感,不同域(已知 / 混淆)的样本需独立归一化才能保证模型稳定性。
-
聚焦训练(FT):纠正分类器对 “混淆样本” 的过度关注,确保已知类分类精度不下降;在利用混淆样本优化分类器后,用 “纯已知样本” 重新训练分类器一次,迫使模型将注意力拉回已知类分类任务。通过 “二次最小化已知样本的 L c \mathcal{L}_c Lc”,调整分类器参数回到 “已知类分类最优” 方向,避免因混淆样本导致的参数偏移。
-
ARPL 的全流程围绕 “已知样本 + 互反点 + 混淆样本” 展开,无真实未知样本参与训练,推理时通过 “距离分布” 区分已知与未知。训练流程:两阶段联合优化(ARPL 基础训练 + 对抗增强训练)
-
阶段 1:ARPL 基础训练(学习互反点与有界约束):初始化:卷积层参数 θ(随机初始化)、互反点 P \mathcal{P} P(随机正态分布)、边际 R(初始化为 1.0);对每个已知样本 x,计算 L c \mathcal{L}_c Lc(分类损失)和 L o \mathcal{L}_o Lo(边际约束损失),得到联合损失 L = L c + λ ⋅ L o \mathcal{L} = \mathcal{L}_c + \lambda \cdot \mathcal{L}_o L=Lc+λ⋅Lo;
-
阶段 2:实例化对抗增强训练(生成混淆样本 + 优化分类器):初始化:判别器 D 参数 θ D \theta_D θD、生成器 G 参数 θ G \theta_G θG、分类器 C 参数 θ C \theta_C θC(继承阶段 1 的 θ);迭代优化(多轮交替更新):
- 采样:从先验分布 P p r i ( z ) P_{pri}(z) Ppri(z) 采样 latent 向量 z i z_i zi,从训练集采样已知样本 x i , y i x_i,y_i xi,yi;
- 更新 D:通过梯度上升最大化 D 的区分损失;
- 更新 G:通过梯度上升最大化 G 的 “欺骗 + 熵约束” 损失;
- 更新 C:通过梯度下降最小化 “已知样本损失 - 生成样本熵”;
- 聚焦训练(FT):用已知样本重新更新 C,最小化 L c \mathcal{L}_c Lc(纠正参数偏移);
-
-
ARPL 的推理无需手动设置阈值,通过 “样本与互反点的距离分布” 自动区分已知与未知:
- 特征提取:将测试样本 x 输入深度网络,得到深度嵌入 C ( x ) \mathcal{C}(x) C(x)(仅用已知样本的 BN 参数归一化);
- 距离计算:计算 C ( x ) \mathcal{C}(x) C(x) 与所有已知类互反点 P k \mathcal{P}^k Pk 的距离 d ( C ( x ) , P k ) d(\mathcal{C}(x), \mathcal{P}^k) d(C(x),Pk);
- 已知 / 未知判断:已知类概率: p ( k n o w n ∣ x ) ∝ max k d ( C ( x ) , P k ) p(known|x) \propto \max_{k} d(\mathcal{C}(x), \mathcal{P}^k) p(known∣x)∝maxkd(C(x),Pk)(样本与最远互反点的距离越大,属于已知类的概率越高);分类决策:若 max k d ( C ( x ) , P k ) \max_{k} d(\mathcal{C}(x), \mathcal{P}^k) maxkd(C(x),Pk) 大于 “已知类距离分布的置信区间”,则判定为已知类并输出对应类别;否则判定为未知类;
- 性能评估:用 AUROC(阈值无关)、OSCR(兼顾已知分类精度与未知检测)等指标评估推理结果。
-
ARPL 与传统原型学习(如 GCPL、KNN)的核心区别在于不存储已知类原型,仅存储互反点,具体如下:训练结束后,ARPL 仅存储 “每个已知类对应的互反点 P k \mathcal{P}^k Pk”(m 维向量,m 为 GAP 输出维度),无需存储已知类的原型、样本特征或其他参数 。存储成本极低(例如:CIFAR10 有 10 个已知类,m=512,则存储量仅 10×512=5120 个浮点数)。
-
维度 ARPL(互反点) 传统原型学习(如 GCPL) 存储对象 类外空间代理(互反点) 已知类中心(原型) 核心逻辑 通过 “非已知类” 定位 “已知类” 通过 “已知类原型” 定位 “已知类” 开放空间建模 有(互反点 + 边际约束) 无(仅关注已知类紧凑性) 存储成本 低(仅存储互反点) 高(需存储原型 + 样本特征)
-
-
互反点的唯一利用场景是推理阶段的 “已知 / 未知区分”:通过计算测试样本与互反点的距离,判断样本是否属于已知类 。例如:已知类样本与互反点的距离普遍较大(因训练时 L c \mathcal{L}_c Lc 最大化该距离),未知类样本与互反点的距离普遍较小(因训练时 L o \mathcal{L}_o Lo 约束类外空间在互反点周围),通过距离分布的差异实现区分。
仓库结构与核心模块解读
-
osr.py:对应论文的 “开放集识别” 任务。实现了论文中 OSR 的训练与评估流程,支持指定数据集(如 mnist、cifar10)、损失函数(ARPLoss/RPLoss 等),并通过--cs参数启用 “混淆样本增强(ARPL+CS)”。核心逻辑:加载数据集→构建模型→通过 ARPLoss 优化已知类分类与互反点对抗→评估 OSR 关键指标(OSCR、AUROC 等)。 -
ood.py:对应论文的 “分布外检测” 任务。用于评估模型对 “分布外数据(与训练集分布不同的未知数据)” 的识别能力,支持指定 “已知数据集” 和 “分布外数据集”(如已知为 mnist,分布外为 kmnist),验证论文中 ARPL 框架在 OOD 场景的泛化性。 -
ARPLoss.py:实现论文提出的 “对抗互反点损失”,是整个框架的核心。包含两部分:已知类分类损失:保证已知类的分类精度;对抗互反点约束:通过互反点与已知类特征的对抗,拉开已知类与类外空间的距离(降低开放空间风险)。 -
resnet.py/resnetABN.py:基础分类网络。resnetABN.py:带有自适应批归一化(ABN)的 ResNet,在 “ARPL+CS” 模式下使用,增强对混淆样本的鲁棒性。 -
gan.py:实现论文中的 “混淆样本生成器”。包含生成器(Generator32)和判别器(Discriminator32),用于生成接近已知类但属于未知空间的样本(对应论文 “instantiated adversarial enhancement”),通过对抗训练优化生成质量,增强模型对未知类的区分能力。 -
train.py:基础训练逻辑,优化分类损失和互反点约束。train_cs.py:启用 GAN 时的训练逻辑,同时优化分类网络、互反点、GAN 生成器和判别器(对应 ARPL+CS 模式)。 -
开放集识别(OSR)的核心挑战是同时实现已知类准确分类和未知类(未见过的类别)有效识别。ARPL 框架,通过互反点建模类外空间、对抗学习减少分布重叠、混淆样本增强未知类区分性三大核心模块解决该问题。
-
数据集划分:已知类与未知类的分离(OSR 任务基础),
osr.py中数据集加载部分(MNIST_OSR/CIFAR10_OSR等)-
# osr.py 中数据集划分逻辑
from split import splits_2020 as splits  # 导入预定义的已知/未知类划分
for i in range(len(splits[options['dataset']])):
    known = splits[options['dataset']][len(splits[options['dataset']])-i-1]  # 已知类
    if options['dataset'] == 'cifar100':
        unknown = splits[options['dataset']+'-'+str(options['out_num'])][...]  # 未知类
    else:
        unknown = list(set(list(range(0, 10))) - set(known))  # 未知类 = 总类别 - 已知类
-
-
互反点(Reciprocal Points)的建模与优化,loss/ARPLoss.py
-
# osr.py 中损失函数加载
Loss = importlib.import_module('loss.'+options['loss'])
criterion = getattr(Loss, options['loss'])(**options)  # 初始化ARPLoss
-
-
混淆样本增强(ARPL+CS):GAN 生成未知类近似样本,
osr.py中模型构建与core/train.py的train_cs函数-
# osr.py 中CS模式下的GAN初始化 if options['cs']: print("Creating GAN") netG = gan.Generator32(1, nz, 64, 3) # 生成器:生成32x32混淆样本 netD = gan.Discriminator32(1, 3, 64) # 判别器:区分真实样本与生成样本 criterionD = nn.BCELoss() # GAN的二分类损失 # core/train.py 中GAN与分类器联合训练(train_cs函数核心逻辑) # (1)训练判别器D:区分真实样本(已知类)和生成样本(混淆样本) output_real = netD(data) # 真实样本输入D errD_real = criterionD(output_real, real_label) # 真实样本应被判别为1 output_fake = netD(fake.detach()) # 生成样本输入D(detach避免G梯度传播) errD_fake = criterionD(output_fake, fake_label) # 生成样本应被判别为0 errD = errD_real + errD_fake optimizerD.step() # (2)训练生成器G:生成“混淆样本”(接近已知类但被模型识别为未知) output = netD(fake) # 生成样本输入D,目标是让D判别为1(欺骗D) errG = criterionD(output, real_label) # 额外约束:生成样本的特征应远离所有已知类中心(接近互反点区域) x, y = net(fake, True, 1*torch.ones(...).cuda()) # 生成样本输入分类器 errG_F = criterion.fake_loss(x).mean() # 混淆样本的特征应被判定为未知 generator_loss = errG + options['beta'] * errG_F # 联合优化 optimizerG.step() # (3)训练分类器:利用混淆样本增强对未知类的敏感度 x, y = net(fake, True, 1*torch.ones(...).cuda()) F_loss_fake = criterion.fake_loss(x).mean() # 分类器应将混淆样本识别为未知 total_loss = loss + options['beta'] * F_loss_fake # 结合已知类分类损失 -
GAN 生成的 “混淆样本” 是已知类与未知类边界上的样本(既接近已知类特征,又属于未知空间),用于增强模型对未知类的区分能力。
-
-
自适应批归一化(ABN):增强模型对分布偏移的适应性,models/models.py
中的classifier32ABN与models/ABN.py的MultiBatchNorm-
# models/models.py 中classifier32ABN的BatchNorm层 self.bn1 = MultiBatchNorm(64, num_ABN) # 多BN层:分别适配真实样本和混淆样本 self.bn2 = MultiBatchNorm(64, num_ABN) # ... 其他层类似 # 前向传播时指定BN标签(0:真实样本,1:混淆样本) x, _ = self.bn1(x, bn_label) # bn_label=0用真实样本的BN统计,=1用混淆样本的BN统计 -
真实样本与 GAN 生成的混淆样本可能存在分布差异,ABN 通过多个独立的 BatchNorm 层分别学习两者的统计特性(均值 / 方差),避免分布偏移导致的模型性能下降。批归一化对数据分布敏感,ABN 通过动态选择 BN 层(基于
bn_label),确保模型在真实样本和混淆样本上均能稳定训练,提升对未知类的泛化能力。
-
-
开放集评估指标:OSCR 与 AUROC,core/evaluation.py
中的compute_oscr和metric_ood-
# core/evaluation.py 中OSCR计算(开放集分类率) def compute_oscr(pred_k, pred_u, labels): x1, x2 = np.max(pred_k, axis=1), np.max(pred_u, axis=1) # 已知类/未知类的最大置信度 # ... 计算不同阈值下的正确分类率(CCR)和假阳性率(FPR) # 积分计算OSCR:综合评估已知类分类准确率和未知类识别率 OSCR = 0 for j in range(n+1): h = ROC[j][0] - ROC[j+1][0] w = (ROC[j][1] + ROC[j+1][1]) / 2.0 OSCR = OSCR + h*w # AUROC(ROC曲线下面积):衡量已知/未知类区分能力 def metric_ood(x1, x2): # x1:已知类得分,x2:未知类得分 # 计算TPR(已知类被正确识别)和FPR(未知类被误判) # 积分得到AUROC(越大越好,理想值100%) -
OSCR(Open Set Classification Rate):通过积分计算已知类正确分类率与未知类识别率的综合指标,更全面反映开放集性能(优于单一准确率)。AUROC(Area Under ROC Curve):衡量模型区分已知类与未知类的能力,ROC 曲线的横轴为假阳性率(未知类被误判为已知类),纵轴为真阳性率(已知类被正确分类)。
-
-
基础特征提取网络(classifier32与classifier32ABN)提取输入图像的高维特征,为后续分类和开放集识别提供基础表示。
-
# 基础分类器(无ABN,适用于普通训练)
class classifier32(nn.Module):
    def __init__(self, num_classes=10):
        super().__init__()
        # 3层卷积块(每层含3个卷积层+BN+LeakyReLU+Dropout)
        self.conv1 = nn.Conv2d(3, 64, 3, 1, 1, bias=False)
        self.bn1 = nn.BatchNorm2d(64)
        # ... 中间卷积层省略(共9个卷积层,逐步提升通道数至128)
        self.avgpool = nn.AdaptiveAvgPool2d((1, 1))  # 全局平均池化
        self.fc = nn.Linear(128, num_classes)  # 分类头

    def forward(self, x, return_feature=False):
        # 卷积块1:输入3→64通道,步长1,保留空间尺寸
        x = self.dr1(x)  # Dropout2d(0.2)防止过拟合
        x = self.conv1(x)
        x = self.bn1(x)
        x = nn.LeakyReLU(0.2)(x)
        # ... 重复卷积块2和3(通道数提升至128,通过stride=2下采样)
        x = self.avgpool(x)  # 输出128×1×1
        x = torch.flatten(x, 1)  # 特征向量:128维
        y = self.fc(x)  # 分类输出
        return (x, y) if return_feature else y
# 带ABN的分类器(适用于混淆样本训练)
class classifier32ABN(nn.Module):
    def __init__(self, num_classes=10, num_ABN=2):
        super().__init__()
        # 与classifier32结构一致,但BN层替换为MultiBatchNorm
        self.bn1 = MultiBatchNorm(64, num_ABN)  # 支持num_ABN个独立BN统计
        # ... 其他BN层同理
    def forward(self, x, return_feature=False, bn_label=None):
        # bn_label:0表示真实样本,1表示混淆样本,选择对应BN层
        x = self.conv1(x)
        x, _ = self.bn1(x, bn_label)  # 动态选择BN层
        # ... 后续流程与classifier32一致
-
-
互反点损失机制(ARPLoss),通过互反点建模未知类空间,约束已知类特征远离互反点,降低开放空间风险。
-
def forward(self, x, y, labels=None): # 计算特征x与已知类中心(points)的点积距离和L2距离 dist_dot_p = self.Dist(x, center=self.points, metric='dot') # 点积距离(相似度) dist_l2_p = self.Dist(x, center=self.points) # L2距离(欧氏距离) logits = dist_l2_p - dist_dot_p # 综合距离作为分类logits if labels is None: return logits, 0 # 测试阶段仅返回logits # 1. 分类损失:确保已知类准确分类 loss_cls = F.cross_entropy(logits / self.temp, labels) # 带温度系数的交叉熵 # 2. 半径损失:约束已知类特征在中心附近(远离互反点) center_batch = self.points[labels, :] # 已知类中心 dis_known = (x - center_batch).pow(2).mean(1) # 特征与中心的距离 target = torch.ones_like(dis_known).cuda() # 目标:距离应小于半径 loss_r = self.margin_loss(self.radius, dis_known, target) # 半径约束损失 total_loss = loss_cls + self.weight_pl * loss_r # 总损失 return logits, total_loss -
互反点(
self.points)作为可学习参数,代表未知类可能存在的区域,通过dist_l2_p - dist_dot_p拉大已知类与互反点的距离。半径损失(loss_r)确保已知类特征紧凑分布在中心周围,减少与未知类的重叠。
-
-
混淆样本生成与对抗训练(GAN+train_cs),通过 GAN 生成接近已知类的混淆样本,增强模型对未知类的敏感度。
models/gan.py(生成器 / 判别器)+core/train.py(train_cs函数)-
# GAN判别器(区分真实样本与混淆样本)- models/gan.py
class _netD32(nn.Module):
    def __init__(self, ngpu, nc, ndf):
        super().__init__()
        self.main = nn.Sequential(
            nn.Conv2d(nc, ndf*2, 4, 2, 1),  # 输入3通道(图像),输出128通道
            nn.LeakyReLU(0.2),
            # ... 逐步提升通道数至1024(ndf*16),下采样至1×1
        )
        self.classifier = nn.Sequential(nn.Linear(1024, 1), nn.Sigmoid())  # 二分类输出

    def forward(self, input):
        x = self.main(input)
        x = torch.flatten(x, 1)
        return self.classifier(x).flatten()  # 输出0(假)或1(真)
# 对抗训练逻辑 - core/train.py
def train_cs(net, netD, netG, criterion, criterionD, optimizer, optimizerD, optimizerG, trainloader, **options):
    for batch_idx, (data, labels) in enumerate(trainloader):
        # (1)训练判别器D:区分真实样本(1)和生成样本(0)
        output_real = netD(data)
        errD_real = criterionD(output_real, torch.ones_like(output_real))  # 真实样本标为1
        fake = netG(torch.randn(data.size(0), options['nz'], 1, 1).cuda())  # G生成混淆样本
        output_fake = netD(fake.detach())  # 切断G的梯度
        errD_fake = criterionD(output_fake, torch.zeros_like(output_fake))  # 生成样本标为0
        (errD_real + errD_fake).backward()
        optimizerD.step()

        # (2)训练生成器G:生成能欺骗D的样本,且远离已知类中心
        output = netD(fake)
        errG_gan = criterionD(output, torch.ones_like(output))  # 让D认为生成样本是真实的
        x, y = net(fake, return_feature=True, bn_label=1)  # 生成样本输入分类器(用ABN的1号BN层)
        errG_osr = criterion.fake_loss(x).mean()  # 生成样本应被识别为未知(远离所有已知类中心)
        (errG_gan + options['beta'] * errG_osr).backward()
        optimizerG.step()

        # (3)训练分类器:利用混淆样本增强未知类识别
        x_real, y_real = net(data, return_feature=True, bn_label=0)  # 真实样本用0号BN层
        loss_cls, _ = criterion(x_real, y_real, labels)  # 已知类分类损失
        x_fake, y_fake = net(fake.detach(), return_feature=True, bn_label=1)
        loss_fake = criterion.fake_loss(x_fake).mean()  # 混淆样本应被判定为未知
        (loss_cls + options['beta'] * loss_fake).backward()
        optimizer.step()
-
-
自适应批归一化(ABN),为真实样本和混淆样本维护独立的批统计(均值 / 方差),避免分布偏移影响训练。
-
# models/ABN.py def forward(self, x, domain_label): self._check_input_dim(x) bn = self.bns[domain_label[0]] # 根据domain_label选择BN层(0:真实样本,1:混淆样本) return bn(x), domain_label # models/models.py中classifier32ABN的forward x, _ = self.bn1(x, bn_label) # bn_label动态选择BN层 -
将普通
BatchNorm2d替换为MultiBatchNorm,初始化时指定num_ABN=2(支持 2 类样本)。训练时通过bn_label区分真实样本(0)和生成样本(1),测试时默认用 0 号 BN 层。
-
-
ARPL 中,互反点(reciprocal points)本质上是模型学习到的类别中心参数,并非独立存储为单独文件,而是作为损失函数的可学习参数存在于模型状态字典(
state_dict)中,随模型和损失函数的参数一起保存和加载。互反点在代码中对应 “类别中心”(centers),定义于loss/Dist.py的Dist类中,是模型的核心可学习参数。-
# loss/Dist.py 中隐含的 centers 定义(结合 ARPLoss 逻辑) class Dist(nn.Module): def __init__(self, num_classes, feat_dim): super(Dist, self).__init__() self.num_classes = num_classes self.feat_dim = feat_dim # 互反点(类别中心):shape为 [num_classes, feat_dim] 的可学习参数 self.centers = nn.Parameter(torch.randn(num_classes, feat_dim)) # 随机初始化 -
在
ARPLoss中,互反点通过self.points = self.Dist.centers被引用(loss/ARPLoss.py),是损失函数的一部分,随损失函数的参数一起被优化和存储。互反点作为损失函数(criterion)的参数,通过utils.py中的save_networks函数与模型参数一起保存到文件中。 -
# utils.py 中保存模型和损失函数参数的逻辑
def save_networks(networks, result_dir, name='', loss='', criterion=None):
    mkdir_if_missing(osp.join(result_dir, 'checkpoints'))
    # 保存模型参数
    weights = networks.state_dict()
    filename = '{}/checkpoints/{}_{}.pth'.format(result_dir, name, loss)
    torch.save(weights, filename)
    # 保存损失函数参数(含互反点 centers)
    if criterion:
        weights = criterion.state_dict()  # 包含 Dist.centers(互反点)
        filename = '{}/checkpoints/{}_{}_criterion.pth'.format(result_dir, name, loss)
        torch.save(weights, filename)  # 互反点随 criterion 一起保存
-
-
在训练流程中(如
osr.py、ood.py),每次调用save_networks时会传入criterion,因此互反点会被写入_criterion.pth文件:-
# osr.py 训练循环中保存参数
save_networks(net, model_path, file_name, criterion=criterion)  # 保存模型 + 损失函数(含互反点)
-
-
测试或重新训练时,通过
utils.py的load_networks函数加载损失函数参数,从而恢复互反点:-
# utils.py 中加载模型和损失函数参数的逻辑
def load_networks(networks, result_dir, name='', loss='', criterion=None):
    # 加载模型参数
    weights = networks.state_dict()
    filename = '{}/checkpoints/{}_{}.pth'.format(result_dir, name, loss)
    networks.load_state_dict(torch.load(filename))
    # 加载损失函数参数(恢复互反点 centers)
    if criterion:
        weights = criterion.state_dict()
        filename = '{}/checkpoints/{}_{}_criterion.pth'.format(result_dir, name, loss)
        criterion.load_state_dict(torch.load(filename))  # 恢复互反点
    return networks, criterion
# osr.py 评估时加载参数
if options['eval']:
    net, criterion = load_networks(net, model_path, file_name, criterion=criterion)  # 恢复互反点
    results = test(net, criterion, testloader, outloader, epoch=0, **options)  # 测试中使用互反点
-
-
互反点(类别中心
centers)作为损失函数的可学习参数,并未单独存储为文件,而是随criterion的state_dict通过save_networks和load_networks与模型参数一起保存(_criterion.pth)和加载。这种设计确保了互反点与模型的一致性,在训练和测试中自动被复用。在 ARPL 中,互反点(reciprocal points)本质上是模型学习到的类别中心参数,并非独立存储为单独文件,而是作为损失函数的可学习参数存在于模型状态字典(state_dict)中,随模型和损失函数的参数一起保存和加载。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 28
 0
- 0


 已为社区贡献16条内容

所有评论(0)