S23 二叉树的先序遍历
目录
温馨提示:再看本片文章时应先对树的基础知识有一定了解,可以看博主之前发布的关于树的概念
二叉树的先序遍历是二叉树三大基础遍历算法(先序、中序、后序)之一,其核心特点是 根节点优先,即遍历顺序严格遵循 “访问根节点 → 递归遍历左子树 → 递归遍历右子树”(Root → Left → Right,简称 RLR)的规则。
一、核心定义与遍历顺序
1. 遍历顺序规则
对任意一棵二叉树(或子树),先序遍历的执行步骤固定为:
访问当前根节点:读取或处理根节点的值(如打印、存储)。
遍历左子树:递归地对当前根节点的左子树执行先序遍历。
遍历右子树:递归地对当前根节点的右子树执行先序遍历。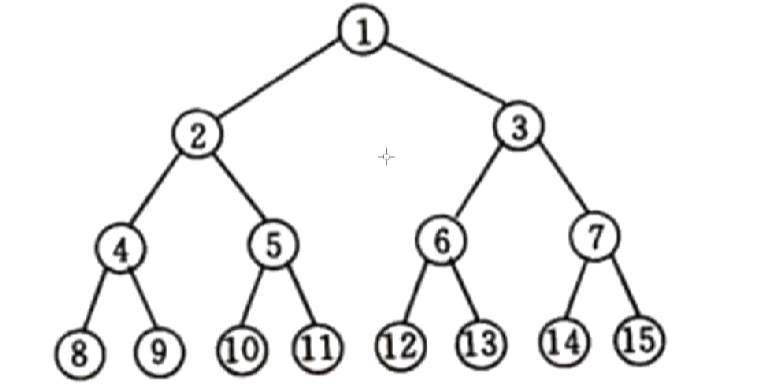
先序遍历的规则是 “根 - 左 - 右”,即先访问根节点,再递归遍历左子树,最后递归遍历右子树。按照这个规则,对图中二叉树进行先序遍历:
首先访问根节点 1。
然后遍历 1 的左子树,左子树的根是 2,访问 2;接着遍历 2 的左子树,根是 4,访问 4;再遍历 4 的左子树,根是 8,访问 8;4 的右子树是 9,访问 9。
回到 2,遍历 2 的右子树,根是 5,访问 5;遍历 5 的左子树,根是 10,访问 10;5 的右子树是 11,访问 11。
回到根节点 1,遍历 1 的右子树,根是 3,访问 3;遍历 3 的左子树,根是 6,访问 6;遍历 6 的左子树,根是 12,访问 12;6 的右子树是 13,访问 13。
回到 3,遍历 3 的右子树,根是 7,访问 7;遍历 7 的左子树,根是 14,访问 14;7 的右子树是 15,访问 15。
所以先序遍历结果为:1、2、4、8、9、5、10、11、3、6、12、13、7、14、15。
2. 先序遍历递归代码
递归实现原理:递归的本质是利用系统栈来保存每次递归调用的上下文信息。对于先序遍历,每次操作都是先处理当前节点(访问根节点),然后递归处理左子树,再递归处理右子树。
void PreOrder(struct Bid_Node*root){
    if(root==NULL)return;
    printf("%d ",root->val);
    PreOrder(root->left);
    PreOrder(root->right);
}
3. 先序遍历非递归代码
原理:非递归实现需要手动模拟递归时系统栈的行为。使用一个栈来存储待处理的节点。首先将根节点入栈,然后循环:出栈一个节点并访问它,然后将右子节点和左子节点依次入栈(这样出栈时会先处理左子节点,保证先序遍历的顺序,因为栈是后进先出的,先入右子节点,后入左子节点,出栈时左子节点先出)。
#include <vector>
class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
        // write code here
        vector<int>res;
        if(root==NULL)return res;
        stack<TreeNode*>s1;
        s1.push(root);
        while(!s1.empty()){
            TreeNode* node=s1.top();
            s1.pop();
            res.push_back(node->val);
            if(node->right){
                s1.push(node->right);
            }
            if(node->left){
                s1.push(node->left);
            }
            free(node);
            node=NULL;
        }
        return res;
    }
};
1. 递归实现
原理:利用系统栈自动保存递归调用的上下文,本质是隐式使用栈结构。
优点:代码简洁直观,符合遍历逻辑的自然表达。
缺点:递归深度过大会导致栈溢出,时间和空间复杂度均为 O (n)(n 为节点数)。
2. 非递归实现(手动栈)
原理:用手动定义的栈模拟递归过程,显式管理节点的访问顺序。
步骤:
1.根节点入栈。
2.栈非空时,弹出栈顶节点并访问。
3.先将右子节点入栈,再将左子节点入栈(利用栈 “后进先出” 特性,保证左子树先被访问)。
重复步骤 2-3,直至栈空。
优点:避免递归栈溢出风险,空间复杂度 O (n)(栈的最大深度),时间复杂度 O (n)。
总结
先序遍历的核心是 “根节点优先访问”,递归实现适合简单场景,非递归实现(栈)更适合深度较大的二叉树,两者本质都是通过栈结构保证遍历顺序。理解先序遍历的逻辑,有助于掌握二叉树的其他遍历方式(中序、后序)及相关算法。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)