十大经典排序算法全解析
常见排序算法
插入排序:直接插入排序,希尔排序
选择排序:选择排序,堆排序
交换排序:快速排序,冒泡排序
归并排序:归并排序
非比较排序:计数排序、基数排序
其中前三种为内排序,即直接在内存中进行排序,归并排序既可以是内排序,也可以是外排序,即在外部存储中进行排序(文件中排序)
稳定性
- 选择排序、快速排序、希尔排序、堆排序不是稳定的排序算法
- 冒泡排序、插入排序、归并排序、基数排序是稳定的排序算法
稳定性的定义
- 稳定:如果a原本在b前面,而a=b,排序之后a仍然在b前面
- 不稳定:如果a原本在b前面,而a=b,排序之后a可能在b的后面
冒泡排序
算法步骤
- 比较相邻元素:从列表的第一个元素开始,比较相邻的两个元素。
- 交换位置:如果前一个元素比后一个元素大,则交换它们的位置。
- 重复遍历:对列表中的每一对相邻元素重复上述步骤,直到列表的末尾。这样,最大的元素会被"冒泡"到列表的最后。
- 缩小范围:忽略已经排序好的最后一个元素,重复上述步骤,直到整个列表排序完成。
动图演示
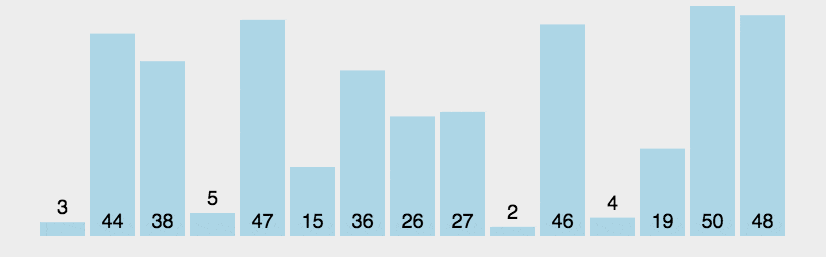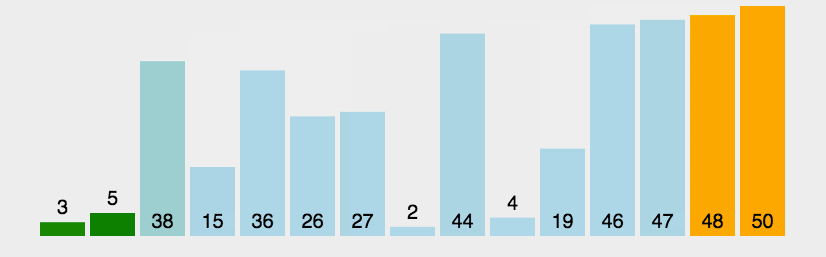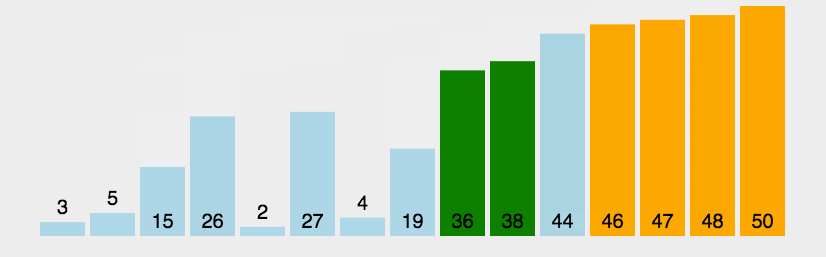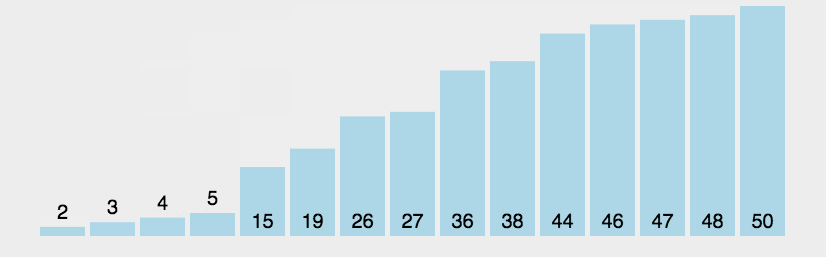
代码
void bubblesort(vector<int>& arr)
{
    for(int i=0;i<arr.size()-1;i++)
    {
        for(int j=0;j<arr.size()-1-i;j++)
            //每进行一次排序,就会确定最后一个位置的数字,
            //因此每进行一次循环,就去除掉最后一个位置
        {
            if(arr[j]>arr[j+1])
            {
                swap(arr[j],arr[j+1]);
            }
        }
    }
}
时间复杂度
- 最坏情况:O(n²),当列表是逆序时
- 最好情况:O(n),当列表已经有序时
- 平均情况:O(n²)
空间复杂度
- O(1),因为冒泡排序是原地排序算法,不需要额外的存储空间
优缺点
- 优点:
-
- 实现简单,代码易于理解
- 原地排序,不需要额外的存储空间
- 缺点:
-
- 效率较低,尤其是对于大规模数据集
- 不适合处理几乎已经有序的列表,因为仍然需要进行多次遍历
什么时候最快
当输入的数据已经是正序时(都已经是正序了,我还要你冒泡排序有何用啊)
什么时候最慢
当输入的数据是反序时(写一个 for 循环反序输出数据不就行了,干嘛要用你冒泡排序呢,我是闲的吗)
选择排序
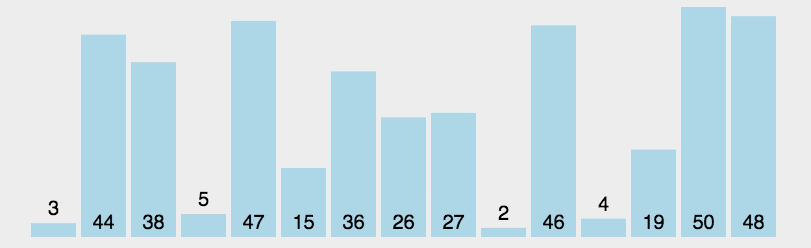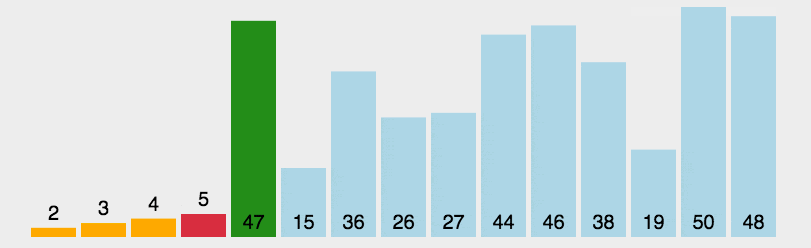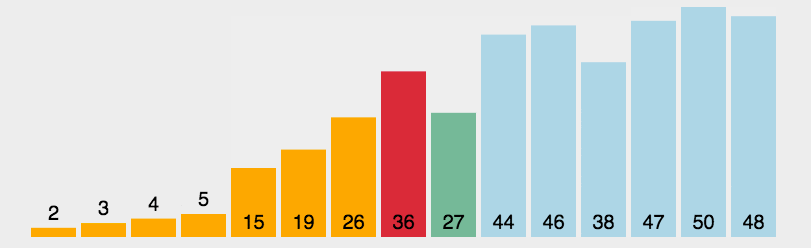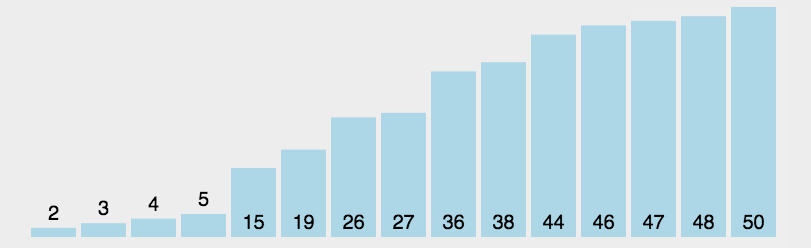
算法步骤
- 初始化:将列表分为已排序部分和未排序部分。初始时,已排序部分为空,未排序部分为整个列表
- 查找最小值:在未排序部分中查找最小的元素。
- 交换位置:将找到的最小元素与未排序部分的第一个元素交换位置。
- 更新范围:将未排序部分的起始位置向后移动一位,扩大已排序部分的范围。
- 重复步骤:重复上述步骤,直到未排序部分为空,列表完全有序。
动图演示
代码
void selectsort(vector<int>& arr)
{
    for (int i = 0; i < arr.size()-1; i++) {
        int minnum = i;
        for (int j = i + 1; j < arr.size(); j++) {
            if (arr[j] < arr[minnum]){
                minnum = j;
            }
        }
        if (minnum != i)
        {
            swap(arr[minnum], arr[i]);
        }
    }
}
时间复杂度
- 最坏情况:O(n²),无论输入数据是否有序,都需要进行 n(n-1)/2 次比较
- 最好情况:O(n²),即使列表已经有序,仍需进行相同数量的比较
- 平均情况:O(n²)
空间复杂度
- O(1),选择排序是原地排序算法,不需要额外的存储空间
优缺点
- 优点:
-
- 实现简单,代码易于理解
- 原地排序,不需要额外的存储空间
- 对于小规模数据集,性能尚可接受
- 缺点:
-
- 时间复杂度较高,不适合大规模数据集
- 不稳定排序算法(如果存在相同元素,可能会改变它们的相对顺序)
适用场景
- 数据量较小且对性能要求不高的场景
- 需要简单实现的场景
插入排序
算法步骤
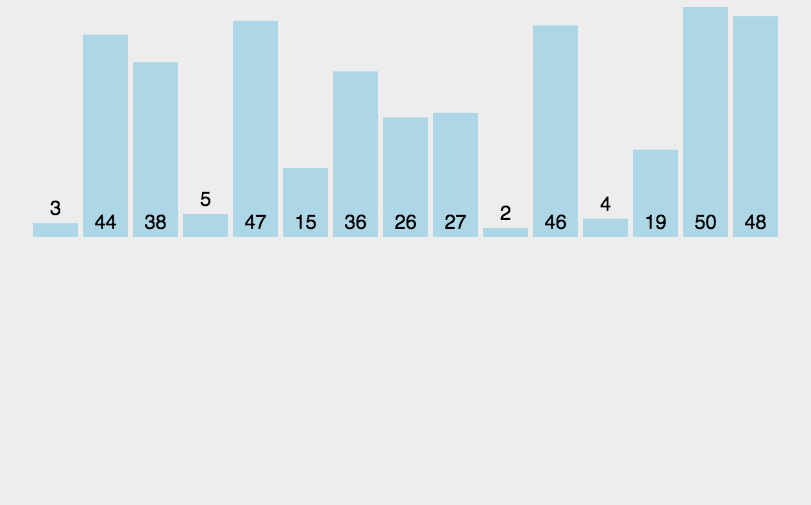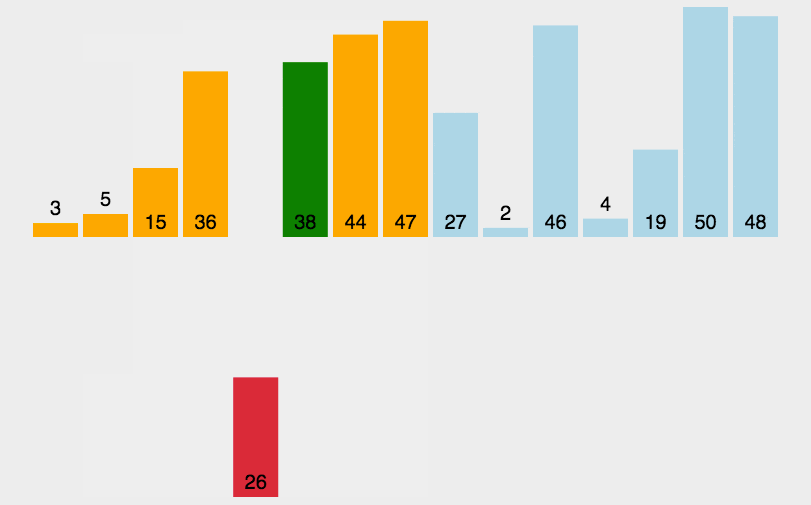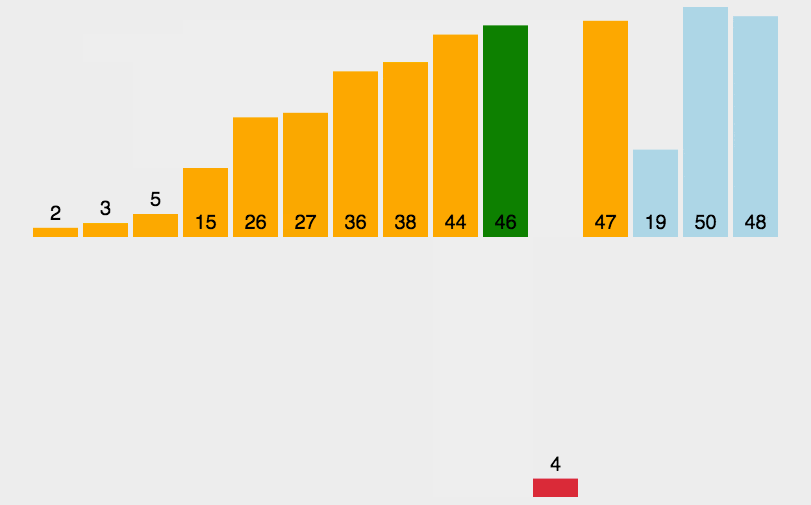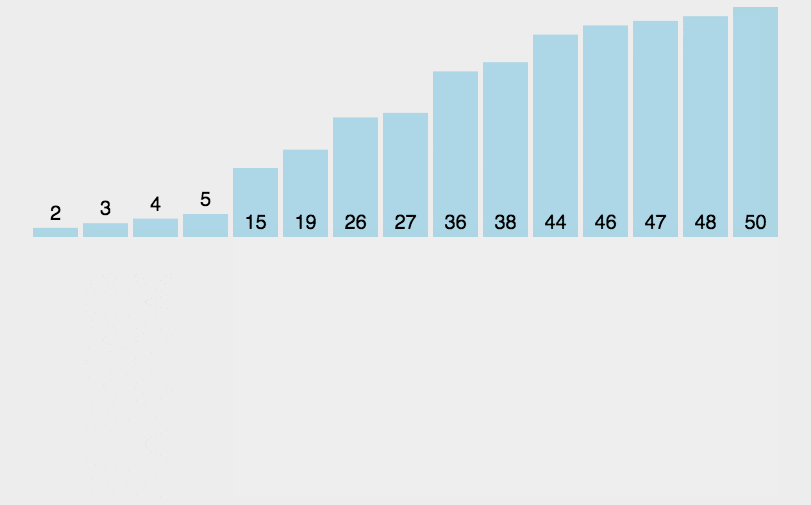
把待排序的记录按其关键码值的大小逐个插入到一个已经排好序的有序序列中,直到所有的记录插入完为止,得到一个新的有序序列
元素集合越接近有序,直接插入排序算法的时间效率越高
- 初始化:将列表分为已排序部分和未排序部分。初始时,已排序部分只包含第一个元素,未排序部分包含剩余元素。
- 选择元素:从未排序部分中取出第一个元素。
- 插入到已排序部分:将该元素与已排序部分的元素从后向前依次比较,找到合适的位置插入。
- 重复步骤:重复上述步骤,直到未排序部分为空,列表完全有序。
动画演示
代码
void insertsort(vector<int>& arr)
{
    for(int i=0;i<arr.size()-1;i++)//相当于从头开始遍历一遍手牌
        {//因为i位置前面的已经排好序了,因此需要和i位置后面一个的数字进行比较
            int key=arr[i+1];//保存已排序位置的后一个[0,1],2;0到1已排序,1到2为未排序部分
            int j=i;//不能直接修改i,需要先用一个变量保存一下
            while((j>=0)&&key<arr[j])//依次向前遍历,比key大就继续向前,直到找到适合的位置
                {
                    arr[j+1]=arr[j];
                    j--;
                }
            arr[j+1]=key;//因为原本key的位置被填上了,因此key可以填入这个坑里面
        }
}
时间复杂度
- 最坏情况:O(n²),当列表是逆序时,每次插入都需要移动所有已排序元素
- 最好情况:O(n),当列表已经有序时,只需遍历一次列表
- 平均情况:O(n²)
空间复杂度
- O(1),插入排序是原地排序算法,不需要额外的存储空间
优缺点
- 优点:
-
- 实现简单,代码易于理解
- 对小规模数据或基本有序的数据效率较高
- 原地排序,不需要额外的存储空间
- 稳定排序算法(相同元素的相对顺序不会改变)
- 缺点:
-
- 时间复杂度较高,不适合大规模数据集
适用场景
- 数据量较小或基本有序的场景
- 需要稳定排序算法的场景
- 作为更复杂排序算法(如快速排序、归并排序)的辅助算法
希尔排序
算法步骤
希尔排序法又称缩小增量法。希尔排序法的基本思想是:先选定一个整数,把待排序文件中所有记录分成 n 个组,所有距离为 n 的记录分在同一组内,并对每一组内的记录进行排序。然后,取,重复上述分组和排序的工作。当到达=1时,所有记录在统一组内排好序
- 选择增量序列:选择一个增量序列(gap sequence),用于将列表分成若干子列表。常见的增量序列有希尔增量(
n/2, n/4, ..., 1)等 - 分组插入排序:按照增量序列将列表分成若干子列表,对每个子列表进行插入排序,增量是多少,就会分成多少个组
- 缩小增量:逐步缩小增量,重复上述分组和排序过程,直到增量为 1,随着增量越来越小,虽然组内元素越来越多,但是也越来越有序,效率也越来越高
- 最终排序:当增量为 1 时,对整个列表进行一次插入排序,完成排序
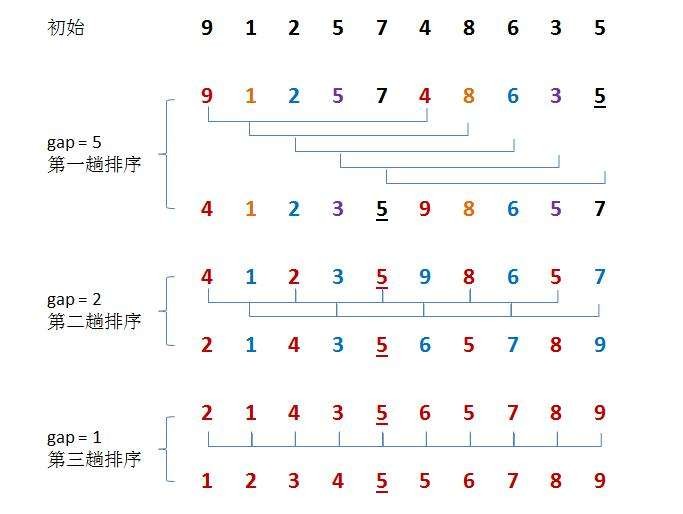
gap 越大,大的值更快调到后面,小的值更快调到前面,但是越不接近有序
gap 越小,调的越慢,但是越接近有序,gap==1 就是直接插入排序
动图演示
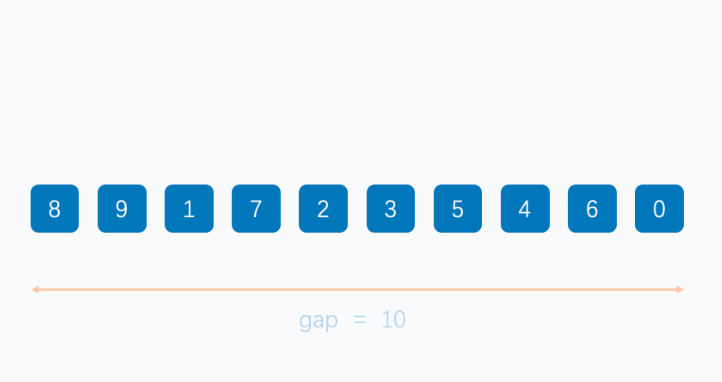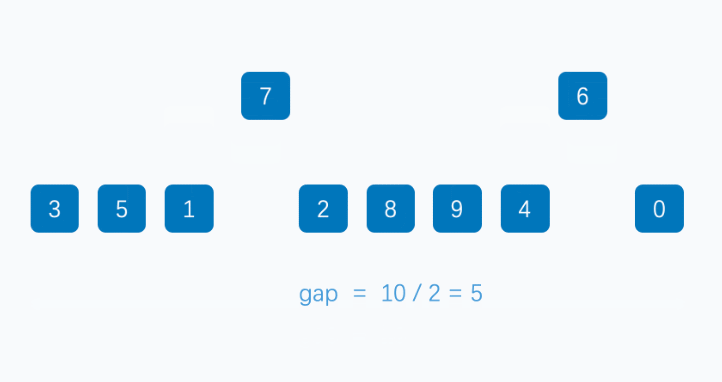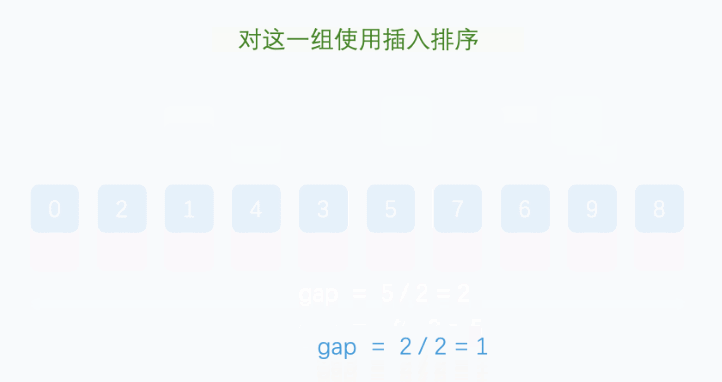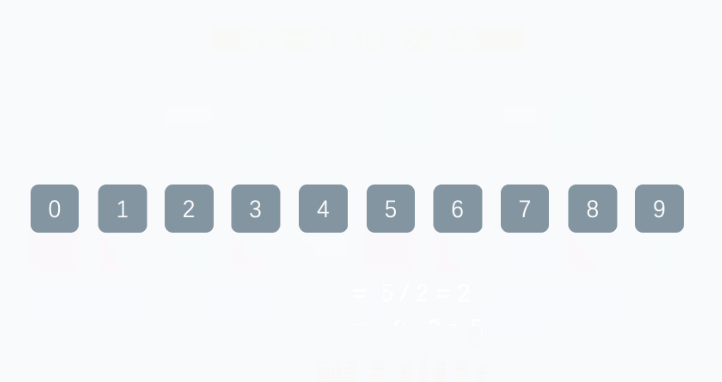
代码
void shell_sort_v1(vector<int> &arr)
{
    int gap = 3;
    for (int j = 0; j < gap; j++)                       // 前j个表示已经排好序的
    {                                                   // 这种方法是一组一组排
        for (int i = j; i < arr.size() - gap; i += gap) // 进行一次间隔为gap的插入排序
        {
            int end = i;
            int key = arr[end + gap];
            while (end >= 0 && key < arr[end])
            {
                arr[end + gap] = arr[end];
                end -= gap;
            }
            arr[end + gap] = key;
        }
    }
    //最终并不是有序,还需要进行一次gap为1的插入排序才能完全有序
}
void shell_sort_v2(vector<int> &arr)
{
    int gap = 3;
    // 这种方法是多组并排
    for (int i = 0; i < arr.size() - gap; ++i) // 进行一次间隔为gap的插入排序
    {
        int end = i;
        int key = arr[end + gap];
        while (end >= 0 && key < arr[end])
        {
            arr[end + gap] = arr[end];
            end -= gap;
        }
        arr[end + gap] = key;
    }
    //最终并不是有序,还需要进行一次gap为1的插入排序才能完全有序
}

void shell_sort_v3(vector<int> &arr)
{
    int gap = arr.size();
    while (gap > 1)
    {
        gap /= 2;// 动态调整gap,先接近有序,最后一次gap=1令其有序
        //gap/=3+1     gap/3时gap有可能等于0,因此需要加上1
        for (int i = 0; i < arr.size() - gap; ++i) // 进行一次间隔为gap的插入排序
        {
            int end = i;
            int key = arr[end + gap];
            while (end >= 0 && key < arr[end])
            {
                arr[end + gap] = arr[end];
                end -= gap;
            }
            arr[end + gap] = key;
        }
    }
    //最终gap会等于1,因此不需要额外进行插入排序
}
时间复杂度
希尔排序时间复杂度是 O(n^(1.3-2)),空间复杂度为 O(1)。希尔排序没有时间复杂度为 O(n(logn)) 的快速排序算法快 ,因此对中等大小规模表现良好,但对规模非常大的数据排序不是最优选择,总之比一般 O(n^2 ) 复杂度的算法快得多
归并排序
算法步骤
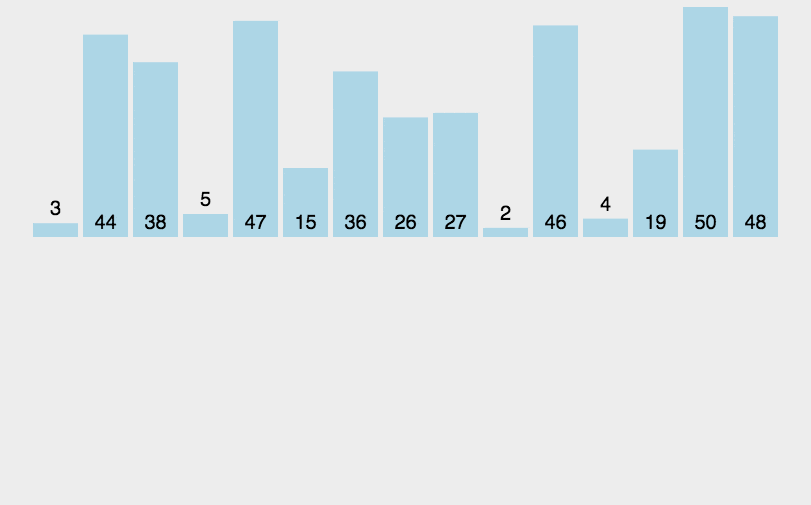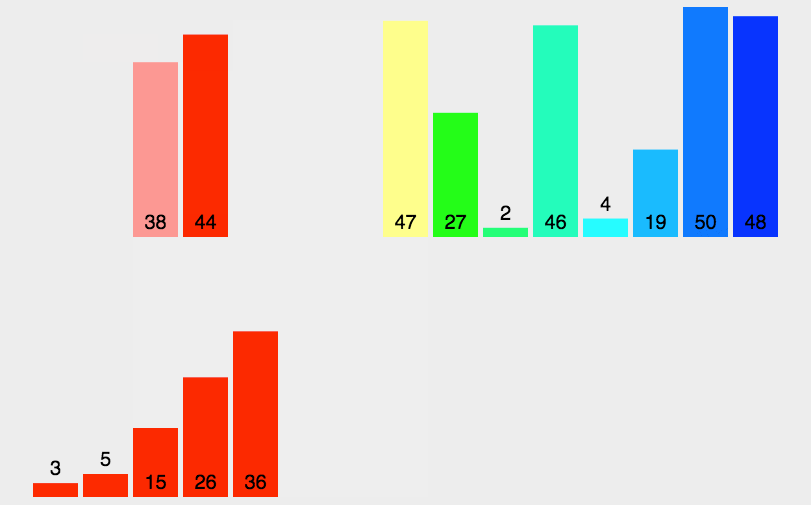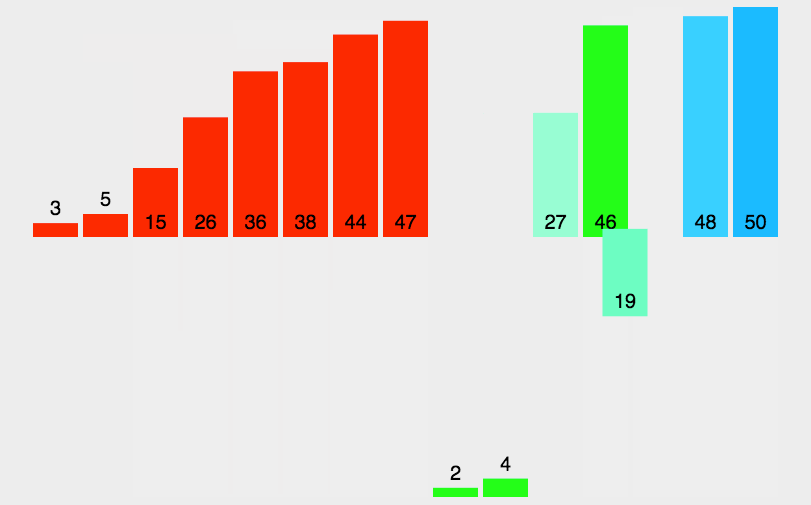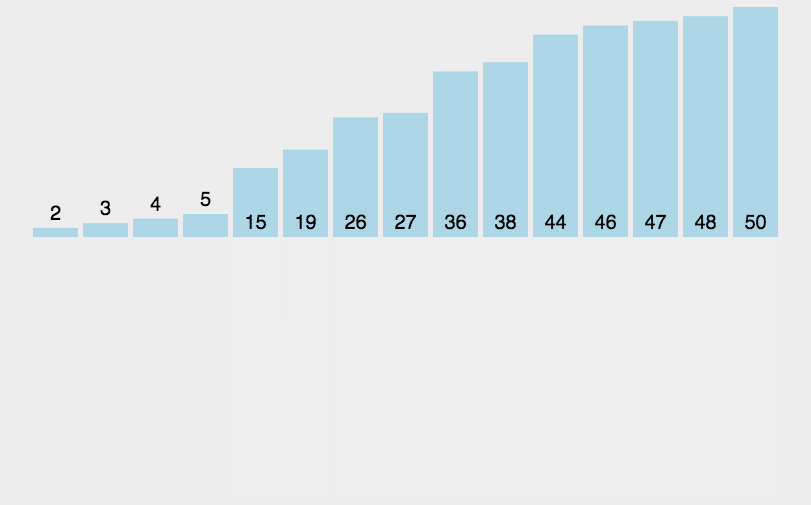
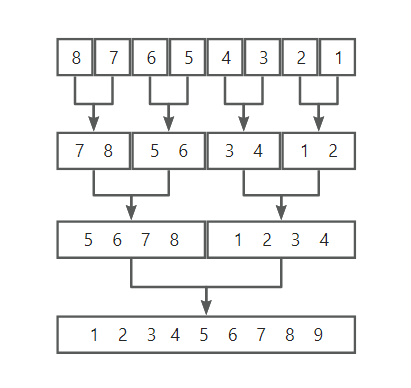
- 将待排序的线性表不断地切分成若干个子表,直到每个子表只包含一个元素,这时可以任务只包含一个元素的子表是有序表(归)
- 将子表两两合并,每合并一次,就会产生一个新的且更长的有序表,重复这一步骤,直到最后只剩下一个子表,这个就是子表排好序的线性表(并)
动图
代码
void _mergesort(vector<int>& arr,int begin,int end,vector<int>& tmp)
{
    if(begin>=end)
        return;
    int mid=(begin+end)/2;
    _mergesort(arr,begin,mid,tmp);
    _mergesort(arr,mid+1,end,tmp);
    int begin1=begin,end1=mid;
    int begin2=mid+1,end2=end;
    int i=begin;
    while(begin1<=end1&&begin2<=end2)
    {
        if(arr[begin1]<arr[begin2])
            tmp[i++]=arr[begin1++];
        else
            tmp[i++]=arr[begin2++];
    }
    while(begin1<=end1)
    {
        tmp[i++]=arr[begin1++];
    }
    while(begin2<=end2)
        tmp[i++]=arr[begin2++];
    arr=tmp;
}
void mergesort(vector<int>& arr)
{
    vector<int> tmp(arr.size());
    _mergesort(arr,0,arr.size()-1,tmp);
}
时间复杂度
- 分解:每次将列表分成两半,需要 O(log n) 层递归。
- 合并:每层递归需要 O(n) 的时间来合并子列表。
- 总时间复杂度:O(n log n)。
空间复杂度
- O(n),归并排序需要额外的空间来存储临时列表。
优缺点
- 优点:
-
- 时间复杂度稳定为 O(n log n),适合大规模数据。
- 稳定排序算法(相同元素的相对顺序不会改变)。
- 适合外部排序(如对磁盘文件进行排序)。
- 缺点:
-
- 需要额外的存储空间,空间复杂度为 O(n)。
- 对于小规模数据,性能可能不如插入排序等简单算法。
选择排序
算法步骤
每一次从待排序的数据元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的数据元素排完,也可以同时选择最小和最大的,分别放在序列的起始位置和结束位置
- 初始化:将列表分为已排序部分和未排序部分。初始时,已排序部分为空,未排序部分为整个列表。
- 查找最小值:在未排序部分中查找最小的元素。
- 交换位置:将找到的最小元素与未排序部分的第一个元素交换位置。
- 更新范围:将未排序部分的起始位置向后移动一位,扩大已排序部分的范围。
- 重复步骤:重复上述步骤,直到未排序部分为空,列表完全有序。
动图演示
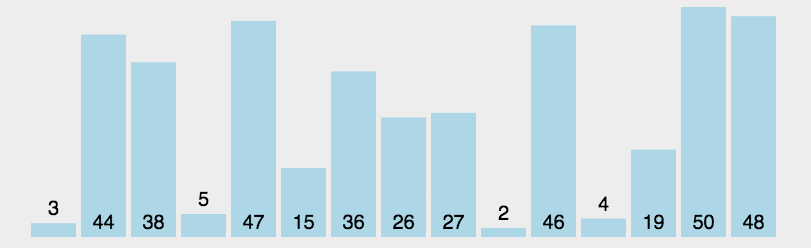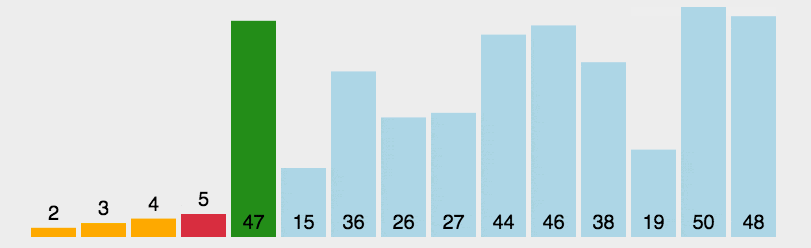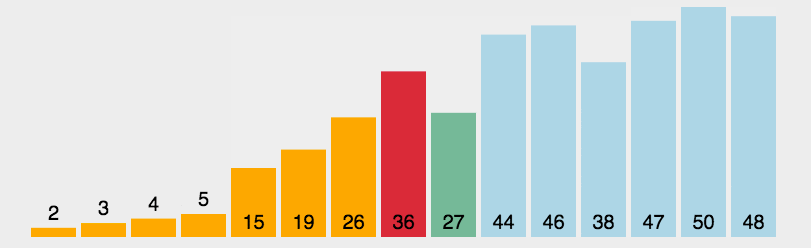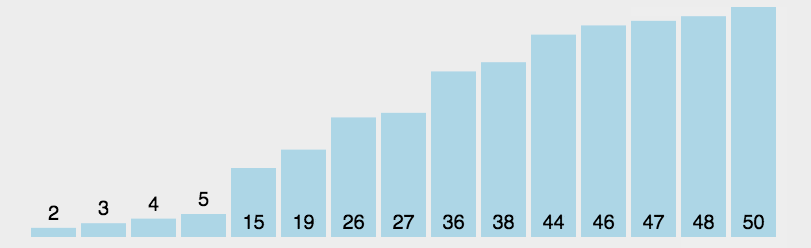
代码
void select_sort(vector<int> &arr)
{
    int begin = 0, end = arr.size() - 1;
    while (begin < end)
    {
        int mini = begin, maxi = begin; // 双指针一次选两个
        for (int i = begin + 1; i <= end; i++)
        {
            if (arr[i] < arr[mini])
            {
                mini = i;
            }
            if (arr[i] > arr[maxi])
            {
                maxi = i;
            }
        }
        swap(arr[begin], arr[mini]);
        if (maxi == begin) // 当maxi位于起始位置时,会被最小值换走,此时最大值位于原来最小值的位置,因此将maxi改为mini
        {
            maxi = mini;
        }
        swap(arr[end], arr[maxi]);
        begin++;
        end--; // 双指针移动
    }
}
时间复杂度
- 最坏情况:O(n²),无论输入数据是否有序,都需要进行 n(n-1)/2 次比较。
- 最好情况:O(n²),即使列表已经有序,仍需进行相同数量的比较。
- 平均情况:O(n²)。
空间复杂度
- O(1),选择排序是原地排序算法,不需要额外的存储空间
优缺点
- 优点:
-
- 实现简单,代码易于理解。
- 原地排序,不需要额外的存储空间。
- 对于小规模数据集,性能尚可接受。
- 缺点:
-
- 时间复杂度较高,不适合大规模数据集。
- 不稳定排序算法(如果存在相同元素,可能会改变它们的相对顺序)。
适用场景
- 数据量较小且对性能要求不高的场景。
- 需要简单实现的场景
快速排序
霍尔版本
算法步骤
任取待排序元素序列中的某元素作为基准值,按照该排序码将待排序集合分割成两子序列,左子序列中所有元素均小于基准值,右子序列中所有元素均大于基准值,然后最左右子序列重复该过程,直到所有元素都排列在相应位置上为止
- 选择基准元素:从列表中选择一个元素作为基准(pivot)。选择方式可以是第一个元素、最后一个元素、中间元素或随机元素。
- 分区:将列表重新排列,使得所有小于基准元素的元素都在基准的左侧,所有大于基准元素的元素都在基准的右侧。基准元素的位置在分区完成后确定。
- 递归排序:对基准元素左侧和右侧的子列表分别递归地进行快速排序。
- 合并:由于分区操作是原地进行的,递归结束后整个列表已经有序
为了让相遇位置一定小于 key,让右边先走:R 没有找到比 key 小的位置
动图演示
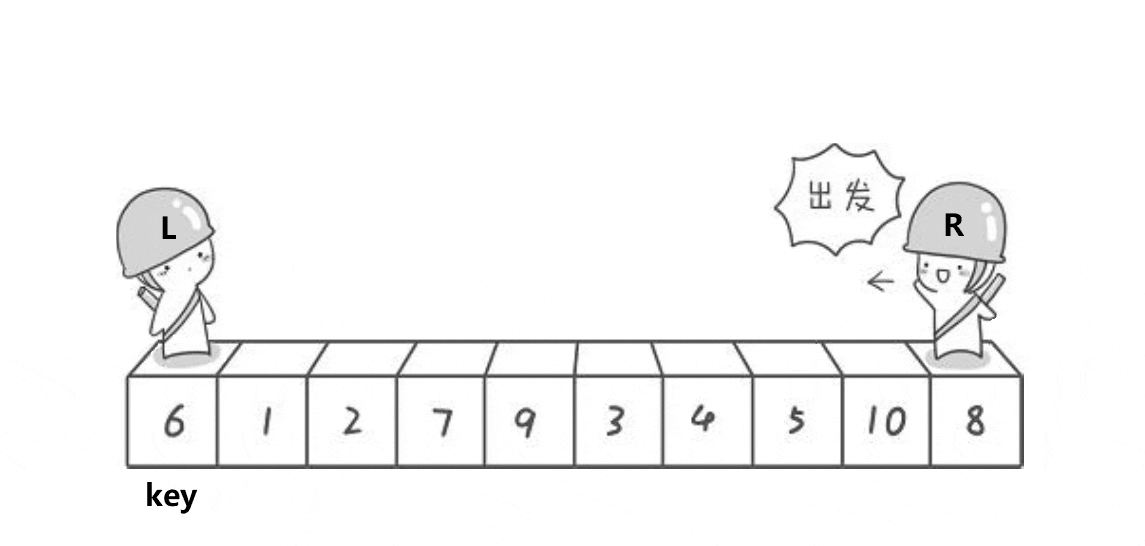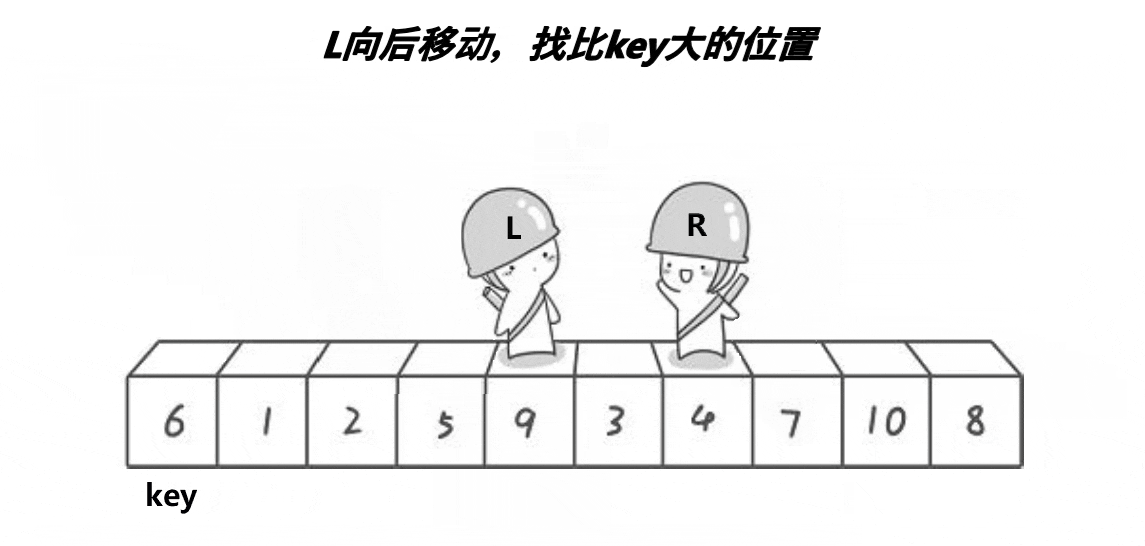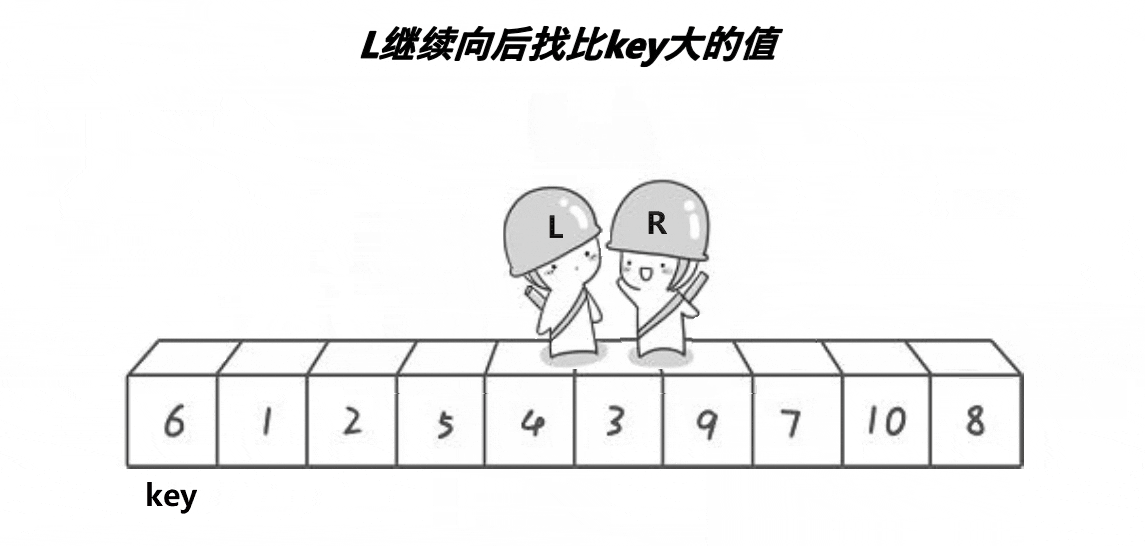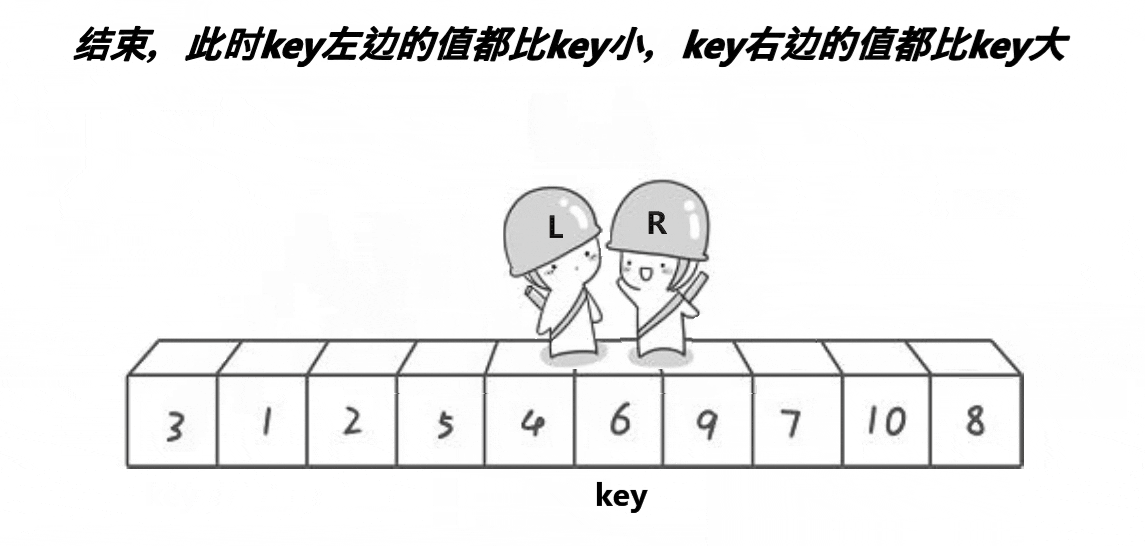
代码
int GetMid(vector<int>& arr,int begin,int end)
{
    int mid=(begin+end)/2;
    if(arr[begin]<arr[end])
    {
        if(arr[mid]>arr[begin])
            return mid;
        else if(arr[mid]<arr[begin])
            return begin;
        else
            return end;
    }
    else//end >= begin
    {
        if(arr[mid]<arr[begin])
            return begin;
        else if(arr[mid]>arr[begin])
            return mid;
        else return end;
    }
}

void quick_sort(vector<int>& arr,int begin,int end)
{
    if(begin>=end)
    {
        return;
    }
    // int left=begin,right=end;
    // int keyi=begin;
    // while(left<right)
    // {
    //     while (left<right&&arr[left]<=arr[keyi])
    //     {
    //         left++;
    //     }
    //     while(left<right&&arr[right]>=arr[keyi])
    //     {
    //         right--;
    //     }
    //     swap(arr[left],arr[right]);
    // }
    // swap(arr[keyi],arr[left]);
    // keyi=left;
    // quick_sort(arr,begin,keyi-1);
    // quick_sort(arr,keyi+1,end);
    int midi=GetMid(arr,begin,end);//通过找到begin,mid,end三个数的中值来进行优化
    swap(arr[begin],arr[midi]);
    int left = begin, right = end;
	int keyi = begin;

	while (left < right)
	{
        //一定要是先找小再找大,为了让相遇位置一定是小于基准值的
		// 右边找小
		while (left < right && arr[right] >= arr[keyi])
		{
			--right;
		}

		// 左边找大
		while (left < right && arr[left] <= arr[keyi])
		{
			++left;
		}

		swap(arr[left], arr[right]);
	}

	swap(arr[left], arr[keyi]);
	keyi = left;

	// [begin, keyi-1] keyi [keyi+1, end]
	quick_sort(arr, begin, keyi - 1);
	quick_sort(arr, keyi+1, end);
}
挖坑法
算法步骤
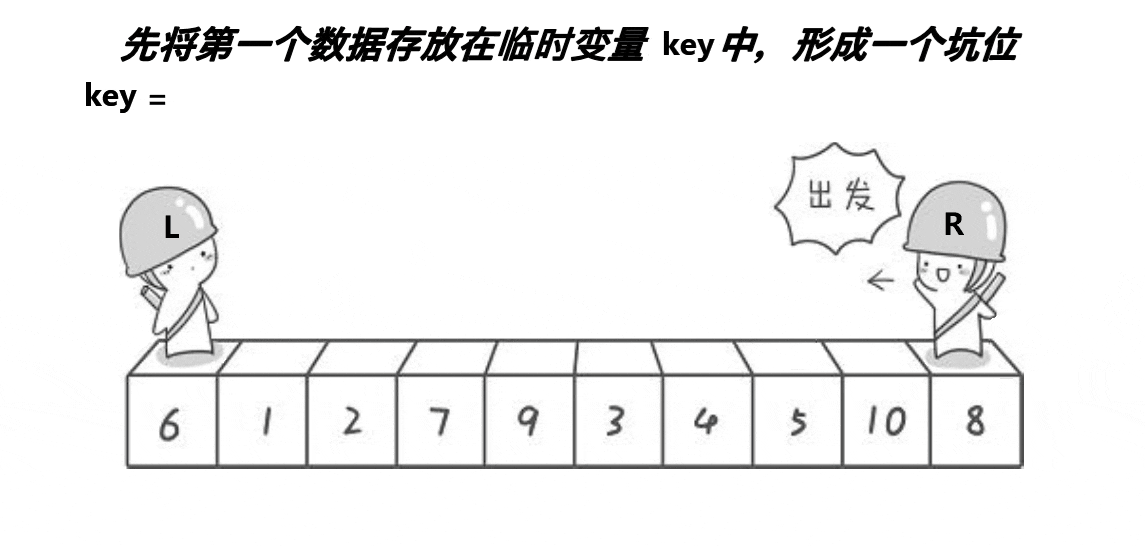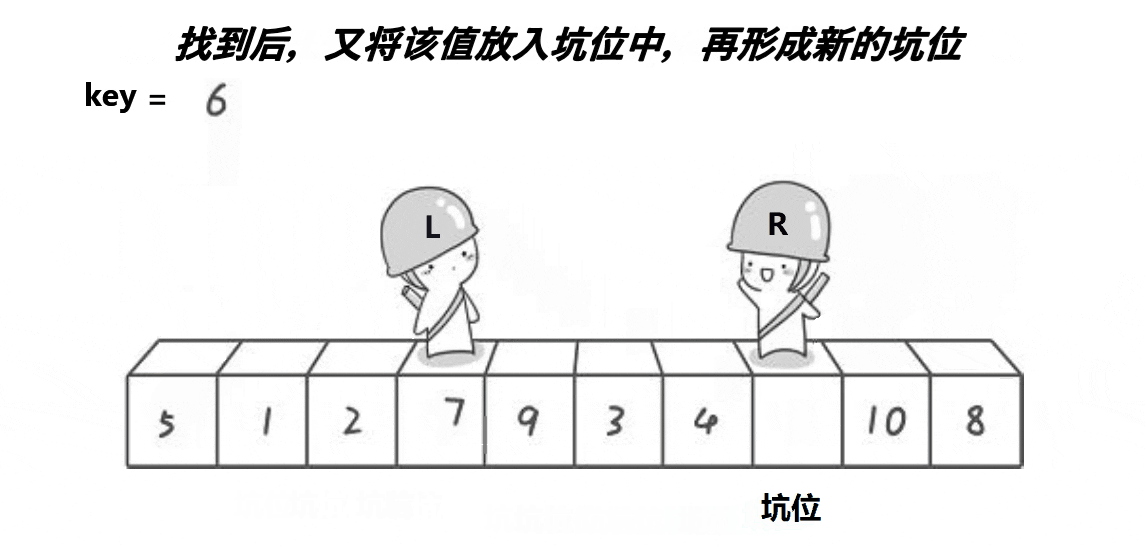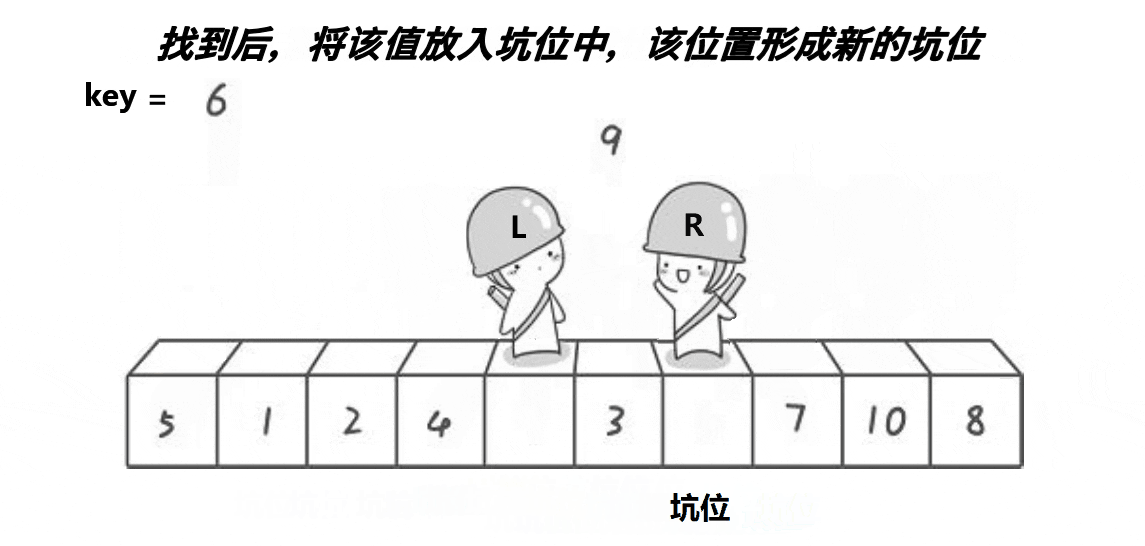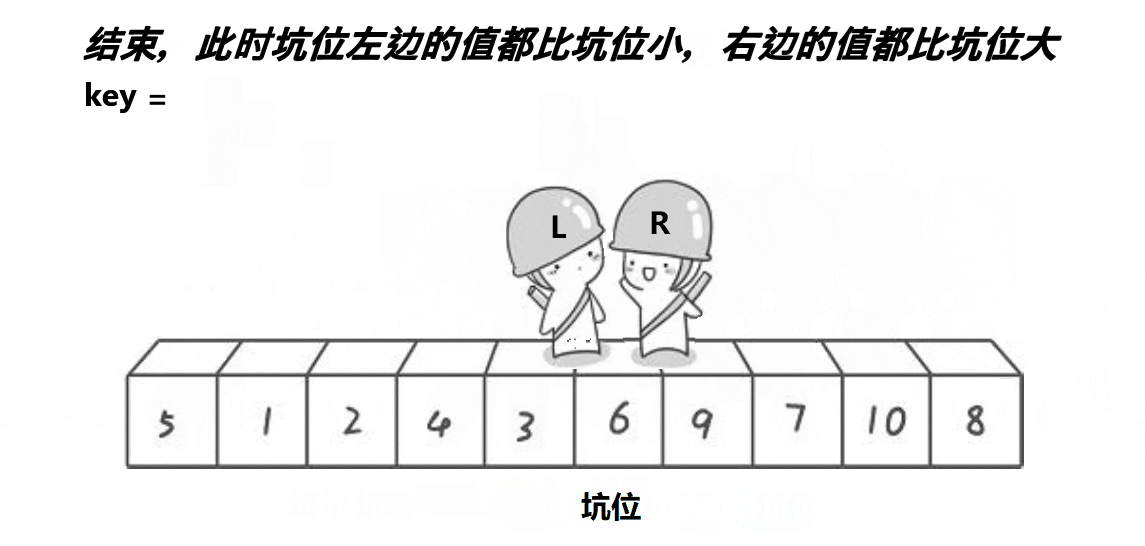
先将第一个数据存入一个变量中,此时这个数据的位置就可以看作一个坑,接下来先从右边找到小于 key 的值,找到后将这个值放入原来的坑位,现在的位置形成了新的坑,接下来再从左边找大于 key 的值,找到后将其放入坑中,现在的位置形成了新的坑,依次循环上述步骤,直到左右两个指针相遇
动图
代码
void quicksort(vector<int> &arr, int begin, int end)
{
    if(begin>=end)
        return;
    int key = arr[begin];
    int hole = begin;
    int left = begin, right = end;
    while (left < right)
    {
        while (left < right && arr[right] >= key)
        {
            right--;
        }
        if (arr[right] < key)
        {
            arr[hole] = arr[right];
            hole = right;
        }
        while (left < right && arr[left] <= key)
        {
            left++;
        }
        if (arr[left] > key)
        {
            arr[hole] = arr[left];
            hole = left;
        }
    }
    arr[hole] = key;
    quicksort(arr, begin, hole - 1);
    quicksort(arr, hole + 1, end);
}
前后指针法
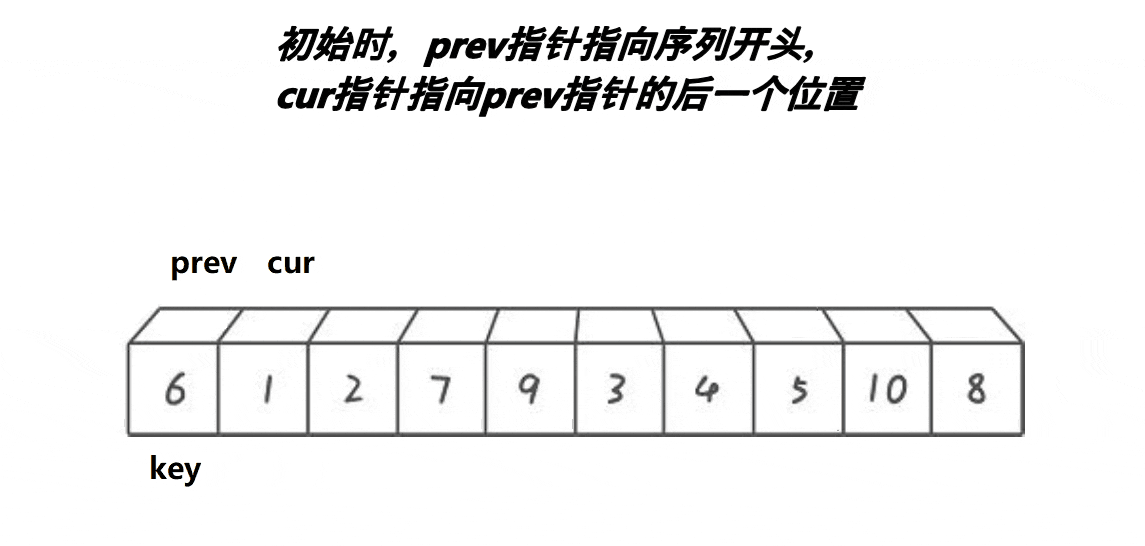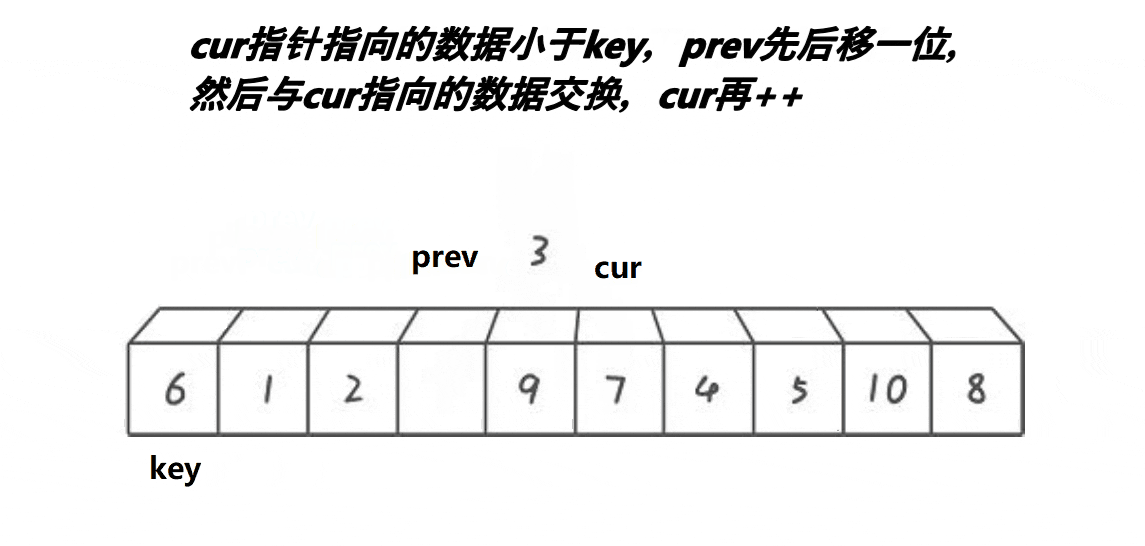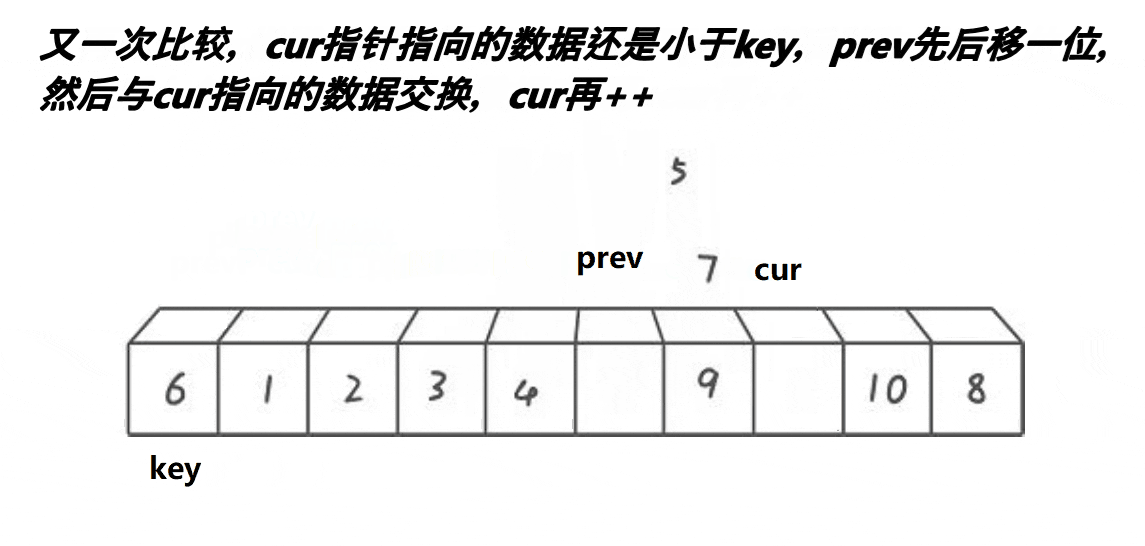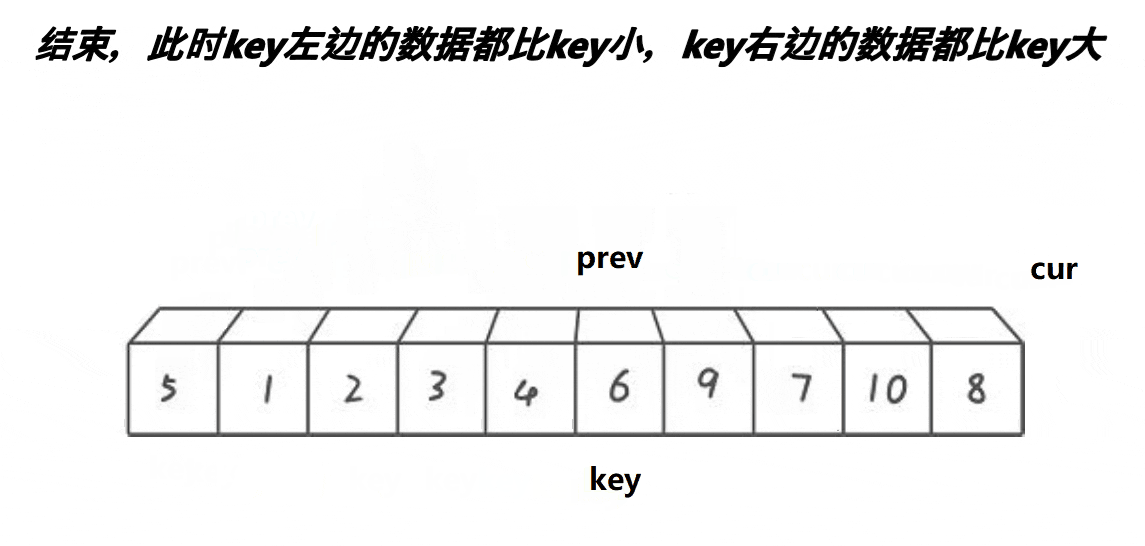
算法原理
- cur 的值大于 key,cur++
- cur 的值小于 key,prev++,交换 prev 和 cur 位置的值,cur++
动图
代码
void quicksort(vector<int> &arr, int begin, int end)
{
    if (begin >= end)
        return;
    int key = arr[begin];
    int keyi = begin;
    int prev = begin, cur = begin + 1;
    while (cur <= end)
    {
        if (arr[cur] < key)
        {
            prev++;
            swap(arr[prev], arr[cur]);
        }
        cur++;//无论是cur>key还是cur<key都需要++,因此放到外面
    }
    swap(arr[prev], arr[keyi]);
    keyi = prev;
    quicksort(arr, begin, keyi - 1);
    quicksort(arr, keyi + 1, end);
}
上述方法的非递归形式
int partition(vector<int> &arr, int begin, int end)
{
    int key = arr[begin];
    int keyi = begin;
    int prev = begin, cur = begin + 1;
    while (cur <= end)
    {
        if (arr[cur] < key)
        {
            prev++;
            swap(arr[prev], arr[cur]);
        }
        cur++;
    }
    swap(arr[prev], arr[keyi]);
    keyi = prev;
    return keyi;
    //quicksort(arr, begin, keyi - 1);
    //quicksort(arr, keyi + 1, end);
}
void quicksort_NonRecursive(vector<int>& arr,int begin,int end)
{
    stack<int> st;
    st.push(end);
    st.push(begin);
    while(!st.empty())
    {
        int left=st.top();
        st.pop();
        int right=st.top();
        st.pop();
        int keyi=partition(arr,left,right);
        //[left,keyi-1],keyi,[keyi+1,right]
        if(left<keyi-1)
        {
            st.push(keyi-1);
            st.push(left);
        }
        if(right>keyi+1)
        {
            st.push(right);
            st.push(keyi+1);
        }
    }
}
时间复杂度
- 分解:每次将列表分成两半,需要 O(log n) 层递归。
- 合并:每层递归需要 O(n) 的时间来合并子列表。
- 总时间复杂度:O(n log n)。
空间复杂度
- O(n),归并排序需要额外的空间来存储临时列表。
优缺点
- 优点:
-
- 时间复杂度稳定为 O(n log n),适合大规模数据。
- 稳定排序算法(相同元素的相对顺序不会改变)。
- 适合外部排序(如对磁盘文件进行排序)。
- 缺点:
-
- 需要额外的存储空间,空间复杂度为 O(n)。
- 对于小规模数据,性能可能不如插入排序等简单算法。
堆排序
递归形式
算法步骤
升序建小堆,降序建大堆,建小堆需要从根节点开始向下调整,找到子节点中较大的一个进行交换,直到到达最后一个位置;建大堆需要从最后一个结点开始,如果比自身小,就向上调整,直到到达根节点
代码
void _mergesort(vector<int>& arr,int begin,int end,vector<int>& tmp)
{
    if(begin>=end)
        return;
    int mid=(begin+end)/2;
    _mergesort(arr,begin,mid,tmp);
    _mergesort(arr,mid+1,end,tmp);
    int begin1=begin,end1=mid;
    int begin2=mid+1,end2=end;
    int i=begin;
    while(begin1<=end1&&begin2<=end2)
    {
        if(arr[begin1]<arr[begin2])
            tmp[i++]=arr[begin1++];
        else
            tmp[i++]=arr[begin2++];
    }
    while(begin1<=end1)
        tmp[i++]=arr[begin1++];
    while(begin2<=end2)
        tmp[i++]=arr[begin2++];
    arr=tmp;
}
void mergesort(vector<int>& arr)
{
    vector<int> tmp(arr);
    _mergesort(arr,0,arr.size()-1,tmp);
}
非递归形式
非递归形式不适合使用栈进行模拟,因为栈只能模拟向下层递归的过程,不能模拟向上层返回的过程,强行模拟会导致时间复杂度变高
因为数组本身就可以当成以一个为一组的形式,因此就可以省略掉递归的过程,直接开始原本回调的过程
代码
void _mergesortN(vector<int>& arr,int begin,int end,vector<int>& tmp)
{
    int gap=1;
    while(gap<end)
    {
        //数组可以直接按照一个一个的进行分组,省略掉不断向下递归的过程
        for(int i=begin;i<end;i+=gap*2)
        {
            //[i,i+gap-1],[i+gap,2*gap-1]
            //[begin1,end1],[begin2,end2]
            int begin1=i,end1=i+gap-1;
            int begin2=i+gap,end2=i+2*gap-1;
            if(end1>=end||begin2>=end)//防止在循环过程中发生越界,一旦end1或者begin2发生了越界,说明当前不足或只有一组
            //因此直接退出当前循环即可
                break;
            if(end2>=end)//end2越界直接将end2设置为数组的最后位置即可
                end2=end-1;
            int j=begin1;
            while(begin1<=end1&&begin2<=end2)
            {
                if(arr[begin1]<arr[begin2])
                    tmp[j++]=arr[begin1++];
                else
                    tmp[j++]=arr[begin2++];
            }
            while(begin1<=end1)
                tmp[j++]=arr[begin1++];
            while(begin2<=end2)
                tmp[j++]=arr[begin2++];
            arr=tmp;
        }
        gap*=2;
    }
}
void mergesort(vector<int>& arr)
{
    vector<int> tmp(arr);
    _mergesortN(arr,0,arr.size(),tmp);
}
计数排序
计数排序通过统计每个元素的出现次数,然后根据统计结果将元素放回正确的位置。计数排序的时间复杂度为 O(n + k),其中 n 是待排序元素的数量,k 是数据的范围大小
算法步骤
- 统计频率:遍历待排序的列表,统计每个元素出现的次数,存储在一个计数数组中。
- 累加频率:将计数数组中的值累加,得到每个元素在排序后列表中的最后一个位置。
- 构建有序列表:遍历待排序的列表,根据计数数组中的位置信息,将元素放到正确的位置。
- 输出结果:将排序后的列表输出。
动图
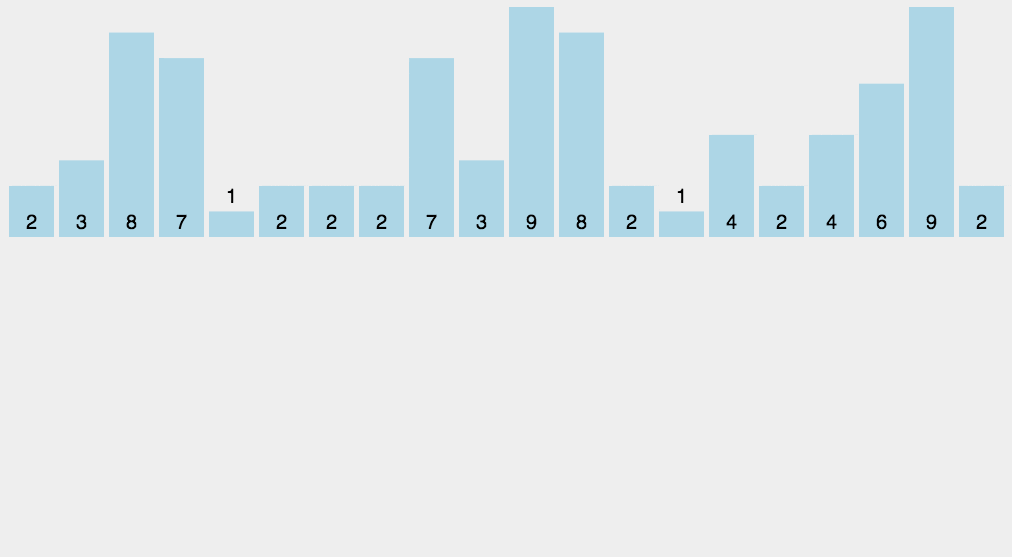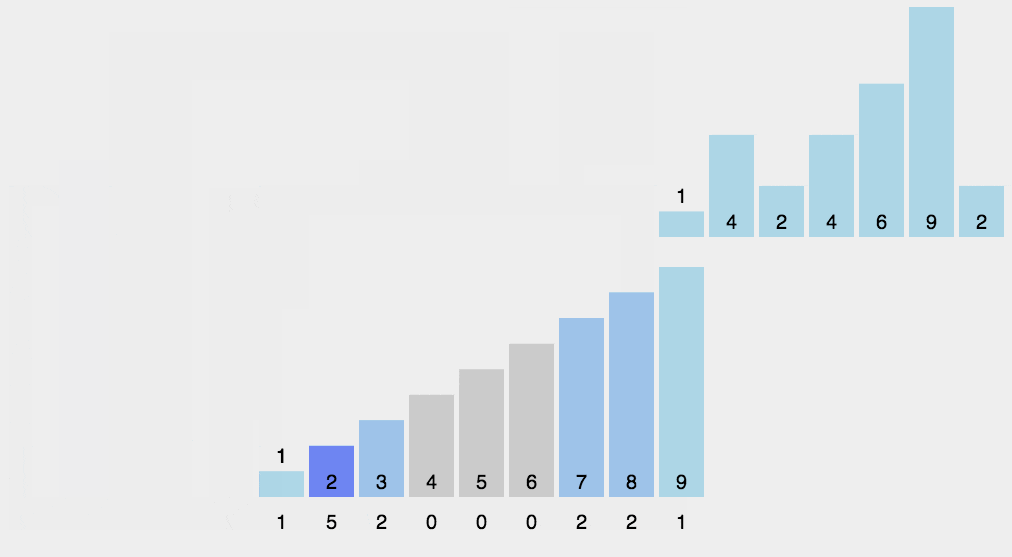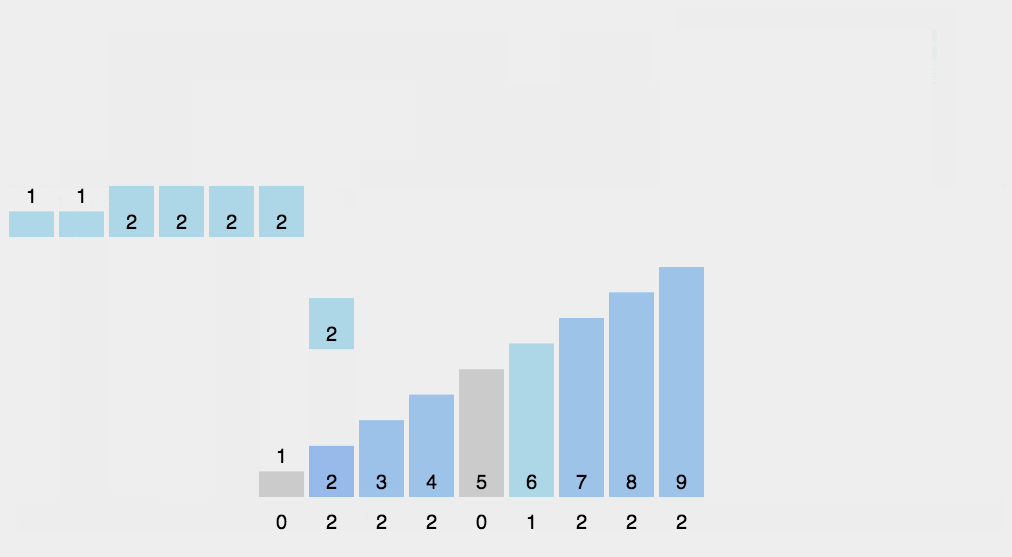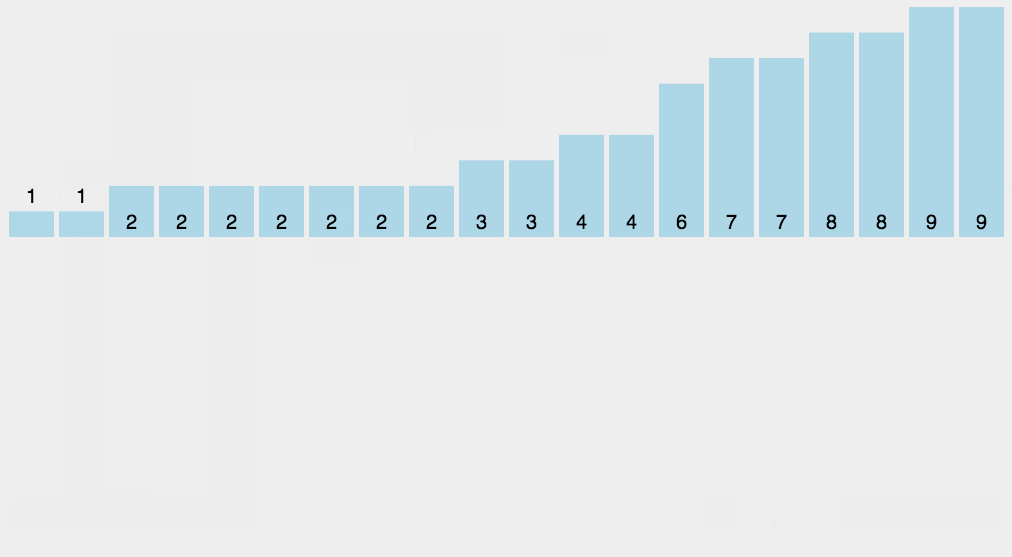
代码
void countsort(vector<int> &arr)
{
    int n = arr.size();
    int max = arr[0], min = arr[0];
    for (int i = 1; i < n; i++)
    {
        if (arr[i] < min)
            min = arr[i];
        if (arr[i] > max)
            max = arr[i];
    }
    int range = max - min+1;//获取到数组中最大和最小之间的间隔
    vector<int> count(range);//开辟一个类似于哈希表的数组,用于存放对应位置的值的数量
    int j = 0;
    for (int i = 0; i < n; i++)
        count[arr[i] - min]++;//计算每个位置的值的数量分别为多少,同时减去min是为了减少空间占用
    for(int i=0;i<count.size();i++)
    {
        while(count[i]--)
        {
            arr[j++]=i+min;//从头取出数据将其放回到原数组即可得到排好序的数组
        }
    }
}
算法特点
- 计数排序在数据范围集中时,效率很高,但是适用范围及场景有限
- 时间复杂度:
O(MAX(N,范围)) - 空间复杂度:
O(范围)

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 15
 0
- 0


 已为社区贡献1条内容

所有评论(0)