数据结构与算法:伪C代码实现详解

简介:数据结构是计算机科学的核心内容,涉及如何在内存中高效组织和操作数据。本压缩包包含涵盖线性表、栈、队列、串、数组、广义表、树、图以及动态存储管理等多种基础与高级数据结构的伪C代码实现。通过这些代码,学习者可以深入理解数据结构的原理及其在实际编程中的应用,提升算法设计与问题解决能力。
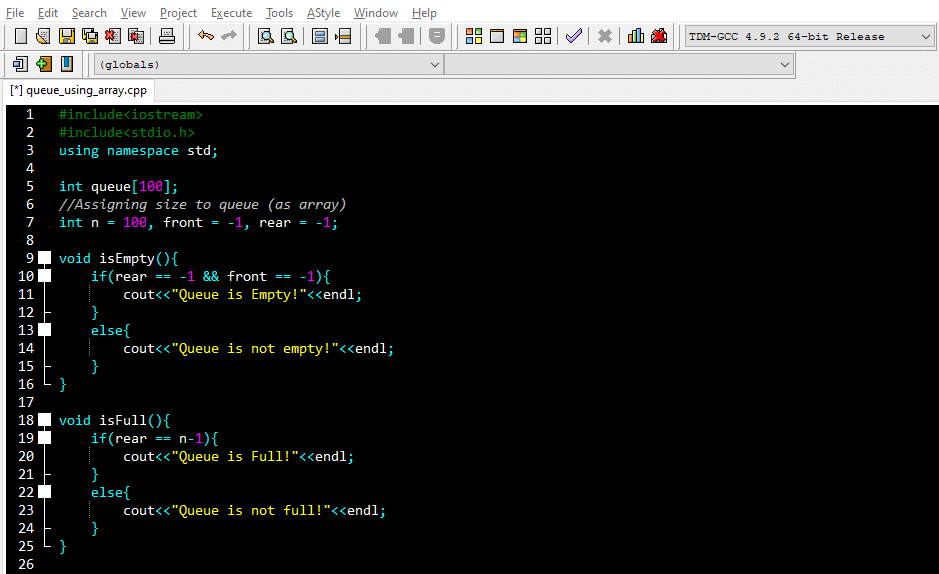
1. 数据结构概述
数据结构是计算机科学中的基石,它研究如何在计算机中组织、管理和高效操作数据。理解数据结构有助于提升程序的效率与可维护性,是设计高质量算法和软件系统的核心基础。
在本章中,我们将从基本概念入手,逐步深入解析数据、数据元素、数据项等术语,并明确逻辑结构与物理结构的本质区别。同时,我们也将引入抽象数据类型(ADT)的概念,帮助你建立从接口定义到具体实现的思维模型。这些内容将为后续章节中具体数据结构的学习打下坚实基础。
2. 线性表的数组与链表实现
线性表(Linear List)是数据结构中最基础、最常见的一类结构,广泛应用于各种算法和系统设计中。它由一组具有相同特性的数据元素组成,这些元素之间存在一个线性关系:每个元素(除了第一个和最后一个)都有一个前驱和一个后继。本章将深入探讨线性表的两种主要实现方式——顺序存储(数组实现)与链式存储(链表实现),并从结构定义、操作实现、性能对比等多个维度进行详细分析。
2.1 线性表的基本概念
线性表是一种线性结构,其逻辑结构为一个有序序列,通常表示为:L = (a₁, a₂, …, aₙ),其中 n ≥ 0。每个元素 aᵢ 属于同一数据类型,且满足以下关系:
- 若 n > 0,则 a₁ 是唯一没有前驱的元素,称为“首元素”;
- 若 n > 0,则 aₙ 是唯一没有后继的元素,称为“尾元素”;
- 对于 1 < i < n,aᵢ 有唯一前驱 aᵢ₋₁ 和唯一后继 aᵢ₊₁。
线性表的抽象数据类型(ADT)定义如下:
2.1.1 线性表的定义与基本操作
线性表支持的基本操作包括:
| 操作名称 | 描述 |
|---|---|
| InitList | 初始化一个空线性表 |
| DestroyList | 销毁线性表,释放内存 |
| ClearList | 清空线性表中的所有元素 |
| ListEmpty | 判断线性表是否为空 |
| ListLength | 返回线性表中元素的个数 |
| GetElem | 获取第 i 个位置的元素 |
| LocateElem | 查找某个元素在表中的位置 |
| PriorElem | 获取某个元素的前驱元素 |
| NextElem | 获取某个元素的后继元素 |
| ListInsert | 在第 i 个位置插入一个新元素 |
| ListDelete | 删除第 i 个位置的元素 |
| ListTraverse | 遍历线性表,对每个元素执行某一操作 |
这些操作构成了线性表的抽象接口,后续章节将基于这些接口分别实现数组和链表版本。
2.1.2 线性表的抽象数据类型描述
使用伪代码定义线性表的抽象数据类型(ADT),如下所示:
ADT List {
    InitList(&L)              // 初始化线性表
    DestroyList(&L)           // 销毁线性表
    ClearList(&L)             // 清空线性表
    ListEmpty(L)              // 判断是否为空
    ListLength(L)             // 获取长度
    GetElem(L, i, &e)         // 获取第i个元素
    LocateElem(L, e)          // 查找元素位置
    PriorElem(L, e, &pre_e)   // 获取前驱
    NextElem(L, e, &next_e)   // 获取后继
    ListInsert(&L, i, e)      // 插入元素
    ListDelete(&L, i, &e)     // 删除元素
    ListTraverse(L, visit)    // 遍历线性表
}
上述 ADT 定义为线性表提供了统一的操作接口,具体实现将取决于存储结构的选择。
2.2 线性表的顺序存储实现(数组)
顺序存储结构是将线性表中的元素依次存放在一组地址连续的存储单元中,利用数组来实现。这种方式具有逻辑结构与物理结构一致、访问效率高等特点。
2.2.1 数组实现线性表的结构定义
顺序表的结构定义如下(以 C 语言为例):
#define MAX_SIZE 100  // 线性表最大容量

typedef struct {
    int data[MAX_SIZE];  // 存储元素的数组
    int length;          // 当前线性表长度
} SeqList;
参数说明:
-
data[]:用于存储线性表元素的数组; -
length:记录当前线性表中实际元素的个数。
这种结构的优点是内存连续,便于通过下标访问元素;但缺点是插入和删除操作需要移动大量元素,效率较低。
2.2.2 插入与删除操作的实现
插入操作 ListInsert
在顺序表中插入一个元素,需将插入位置后的所有元素后移一位。
int ListInsert(SeqList *L, int i, int e) {
    if (i < 1 || i > L->length + 1) return 0;  // 插入位置不合法
    if (L->length >= MAX_SIZE) return 0;       // 表已满

    for (int j = L->length; j >= i; j--) {
        L->data[j] = L->data[j - 1];  // 后移元素
    }

    L->data[i - 1] = e;  // 插入新元素
    L->length++;         // 表长增加
    return 1;
}
逻辑分析:
-
i < 1 || i > L->length + 1:判断插入位置是否合法; -
L->length >= MAX_SIZE:判断是否溢出; -
for循环从后向前移动元素,为插入腾出空间; - 最后将新元素放入正确位置,并更新长度。
删除操作 ListDelete
删除操作需将删除位置后的所有元素前移一位。
int ListDelete(SeqList *L, int i, int *e) {
    if (i < 1 || i > L->length) return 0;  // 删除位置不合法

    *e = L->data[i - 1];  // 保存被删除元素

    for (int j = i; j < L->length; j++) {
        L->data[j - 1] = L->data[j];  // 前移元素
    }

    L->length--;  // 表长减少
    return 1;
}
逻辑分析:
-
i < 1 || i > L->length:判断删除位置是否合法; - 保存被删除元素,供调用者使用;
-
for循环将后续元素前移; - 更新长度。
2.2.3 顺序存储的优缺点分析
| 优点 | 缺点 |
|---|---|
| 支持随机访问,查找效率高 O(1) | 插入/删除效率低 O(n) |
| 存储结构简单,易于实现 | 扩展性差,容量固定 |
| 内存连续,缓存命中率高 | 删除操作需移动大量数据 |
适用场景:
- 元素数量固定或变化不大;
- 查找操作频繁,插入/删除较少;
- 对访问速度要求较高。
2.3 线性表的链式存储实现(链表)
链式存储结构使用链表来实现线性表,其特点是物理存储位置可以不连续,通过指针链接各个节点。
2.3.1 单链表的结构定义与初始化
单链表由多个节点组成,每个节点包含数据域和指针域。
typedef struct Node {
    int data;          // 数据域
    struct Node *next; // 指针域
} LinkNode;

typedef struct {
    LinkNode *head;   // 头指针
    int length;       // 链表长度
} LinkedList;
初始化函数:
void InitList(LinkedList *L) {
    L->head = (LinkNode *)malloc(sizeof(LinkNode));
    L->head->next = NULL;
    L->length = 0;
}
逻辑分析:
- 创建头节点,
next设置为NULL; - 初始化链表长度为 0。
2.3.2 链表的插入、删除与遍历操作
插入操作 ListInsert
int ListInsert(LinkedList *L, int i, int e) {
    if (i < 1 || i > L->length + 1) return 0;

    LinkNode *p = L->head;
    for (int j = 1; j < i; j++) {
        p = p->next;  // 移动到插入位置的前一个节点
    }

    LinkNode *s = (LinkNode *)malloc(sizeof(LinkNode));
    s->data = e;
    s->next = p->next;
    p->next = s;

    L->length++;
    return 1;
}
逻辑分析:
- 使用循环定位到插入位置的前一个节点;
- 创建新节点
s; - 修改指针完成插入;
- 更新链表长度。
删除操作 ListDelete
int ListDelete(LinkedList *L, int i, int *e) {
    if (i < 1 || i > L->length) return 0;

    LinkNode *p = L->head;
    for (int j = 1; j < i; j++) {
        p = p->next;  // 移动到删除位置的前一个节点
    }

    LinkNode *q = p->next;
    *e = q->data;
    p->next = q->next;
    free(q);

    L->length--;
    return 1;
}
逻辑分析:
- 定位到前一个节点;
- 保存被删除节点的数据;
- 修改指针跳过被删除节点;
- 释放内存并更新长度。
遍历操作 ListTraverse
void ListTraverse(LinkedList L) {
    LinkNode *p = L.head->next;
    while (p != NULL) {
        printf("%d ", p->data);
        p = p->next;
    }
    printf("\n");
}
逻辑分析:
- 从头节点的下一个节点开始遍历;
- 打印每个节点的数据;
- 直到指针为
NULL。
2.3.3 双向链表与循环链表简介
双向链表(Doubly Linked List)
每个节点有两个指针,分别指向前驱和后继节点:
typedef struct DNode {
    int data;
    struct DNode *prev;
    struct DNode *next;
} DLinkNode;
双向链表支持双向遍历,提高了插入和删除的灵活性。
循环链表(Circular Linked List)
循环链表的尾节点指向头节点,形成环形结构,适用于某些特定应用场景,如约瑟夫问题。
graph LR
A[Head] --> B[Node1]
B --> C[Node2]
C --> D[Node3]
D --> A
2.3.4 链表的优缺点及适用场景分析
| 优点 | 缺点 |
|---|---|
| 插入/删除效率高 O(1)(已知位置) | 不支持随机访问,查找效率低 O(n) |
| 动态内存分配,扩展性强 | 实现复杂度略高 |
| 不需要连续内存空间 | 存储空间利用率略低 |
适用场景:
- 数据频繁增删;
- 数据量不确定或较大;
- 对插入删除效率要求高;
- 不需要频繁访问中间元素。
总结与过渡
本章从线性表的基本概念出发,深入剖析了其两种主流实现方式:顺序存储(数组)和链式存储(链表)。通过结构定义、操作实现、性能对比等方式,我们明确了数组在查找上的优势和链表在插入删除上的灵活性。
在下一章中,我们将聚焦于栈这一重要的线性结构,探讨其后进先出(LIFO)特性在算法设计与系统调用中的核心作用,并分别实现其数组和链表版本,为后续章节中更复杂的数据结构打下坚实基础。
3. 栈的LIFO结构设计与实现
栈(Stack)是计算机科学中最基础、最常用的数据结构之一,它遵循“后进先出”(Last In First Out, LIFO)的原则,即最后被压入栈的元素最先被弹出。栈结构在程序运行、算法实现、系统调用等多个方面发挥着关键作用。从基本的括号匹配到复杂的函数调用栈机制,栈的广泛应用体现了其在数据结构体系中的重要地位。
本章将围绕栈的基本概念、数组与链表的实现方式、栈的操作实现以及其在递归与函数调用中的应用展开详细讲解。通过代码实现与性能对比,帮助读者深入理解栈的内部机制,并掌握其在实际开发中的使用方法。
3.1 栈的基本概念与应用场景
栈是一种线性结构,只能在一端进行插入和删除操作,这一端被称为“栈顶”(Top),另一端称为“栈底”(Bottom)。栈的插入操作称为“入栈”(Push),删除操作称为“出栈”(Pop),栈顶始终指向最后一个被压入的元素。
3.1.1 栈的定义与LIFO特性
栈的定义如下:
栈(Stack)是一个有序线性表,其中插入和删除操作只允许在表的一端进行,该端称为栈顶(Top),另一端称为栈底(Bottom)。栈遵循后进先出(LIFO, Last In First Out)的原则。
栈的基本操作包括:
- Push(x) :将元素 x 压入栈顶。
- Pop() :移除栈顶元素并返回该元素。
- Top() :返回栈顶元素但不删除。
- IsEmpty() :判断栈是否为空。
- Size() :返回栈中元素的数量。
栈的LIFO特性决定了它的操作只能在栈顶进行,这使得其逻辑结构非常清晰,但也限制了访问自由度。这种特性在某些特定场景中反而成为优势,例如函数调用、表达式求值等。
3.1.2 常见应用:括号匹配、表达式求值
栈的典型应用场景包括:
括号匹配(Parentheses Matching)
在编译器设计和表达式解析中,括号匹配是常见任务。例如判断表达式 (a + (b - c)) 是否合法。实现方式如下:
def is_parentheses_matched(expression):
    stack = []
    for char in expression:
        if char in '({[':
            stack.append(char)
        elif char in ')}]':
            if not stack:
                return False
            top = stack.pop()
            if not ((top == '(' and char == ')') or
                    (top == '{' and char == '}') or
                    (top == '[' and char == ']')):
                return False
    return len(stack) == 0

# 示例
expr = "{a + [b - (c * d)]}"
print(is_parentheses_matched(expr))  # 输出:True
代码逻辑分析:
- 遍历表达式中的每个字符。
- 若是左括号,压入栈中。
- 若是右括号,判断栈是否为空,若为空则不匹配。
- 弹出栈顶元素,判断是否为对应的左括号。
- 最后栈是否为空决定了括号是否完全匹配。
中缀表达式转后缀表达式并求值
栈可以用于将中缀表达式转换为后缀表达式(逆波兰表达式),然后利用栈进行求值。以下为简化版实现:
def precedence(op):
    if op == '+' or op == '-':
        return 1
    if op == '*' or op == '/':
        return 2
    return 0

def infix_to_postfix(expression):
    output = []
    stack = []
    for char in expression:
        if char.isdigit():
            output.append(char)
        elif char in '+-*/':
            while stack and precedence(stack[-1]) >= precedence(char):
                output.append(stack.pop())
            stack.append(char)
        elif char == '(':
            stack.append(char)
        elif char == ')':
            while stack and stack[-1] != '(':
                output.append(stack.pop())
            stack.pop()  # 弹出 '('
    while stack:
        output.append(stack.pop())
    return ''.join(output)

# 示例
expr = "3+4*2/(1-5)"
print(infix_to_postfix(expr))  # 输出:342*15-/+
代码逻辑分析:
- 数字直接加入输出列表。
- 运算符则根据优先级决定是否弹出栈顶运算符。
- 遇到左括号压入栈中,遇到右括号则弹出直到左括号。
- 最后将栈中剩余运算符弹出。
- 输出列表即为后缀表达式。
3.2 栈的数组实现
栈可以通过数组实现,称为顺序栈(Sequential Stack)。数组实现的栈结构简单、访问效率高,但在栈满时需要扩容或报错。
3.2.1 顺序栈的结构定义
顺序栈通常由一个数组和一个表示栈顶位置的整型变量构成。
class ArrayStack:
    def __init__(self, capacity=10):
        self.capacity = capacity
        self.stack = [None] * self.capacity
        self.top = -1  # 栈顶指针,初始为空栈

    def is_empty(self):
        return self.top == -1

    def is_full(self):
        return self.top == self.capacity - 1
参数说明:
-
capacity:栈的容量,默认为10。 -
stack:用于存储栈元素的数组。 -
top:栈顶指针,初始为 -1,表示栈为空。
3.2.2 栈的基本操作实现(push、pop、top)
    def push(self, item):
        if self.is_full():
            raise Exception("Stack is full")
        self.top += 1
        self.stack[self.top] = item

    def pop(self):
        if self.is_empty():
            raise Exception("Stack is empty")
        item = self.stack[self.top]
        self.top -= 1
        return item

    def peek(self):
        if self.is_empty():
            raise Exception("Stack is empty")
        return self.stack[self.top]

    def size(self):
        return self.top + 1
逻辑分析:
-
push:先判断栈是否已满,若是则抛出异常;否则栈顶指针加一并插入元素。 -
pop:判断栈是否为空,若是则抛出异常;否则取出栈顶元素并移动指针。 -
peek:返回栈顶元素但不弹出。 -
size:栈顶指针加一即为元素个数。
优缺点:
- 优点:访问效率高,内存连续,缓存友好。
- 缺点:容量固定,扩容复杂,插入删除需移动元素(在栈顶除外)。
3.3 栈的链表实现
链表实现的栈称为链栈(Linked Stack),它由一系列节点组成,每个节点包含数据和指向下一个节点的指针。
3.3.1 链栈的结构定义
class Node:
    def __init__(self, data):
        self.data = data
        self.next = None

class LinkedStack:
    def __init__(self):
        self.top = None
        self.size = 0

    def is_empty(self):
        return self.top is None

    def get_size(self):
        return self.size
参数说明:
-
top:指向栈顶节点的指针。 -
size:栈中元素数量。
3.3.2 链栈操作的实现与性能对比
    def push(self, item):
        new_node = Node(item)
        new_node.next = self.top
        self.top = new_node
        self.size += 1

    def pop(self):
        if self.is_empty():
            raise Exception("Stack is empty")
        item = self.top.data
        self.top = self.top.next
        self.size -= 1
        return item

    def peek(self):
        if self.is_empty():
            raise Exception("Stack is empty")
        return self.top.data
逻辑分析:
-
push:创建新节点,将其next指向当前栈顶,再更新栈顶指针。 -
pop:取出栈顶节点的数据,更新栈顶指针。 -
peek:返回栈顶节点的数据。
性能对比:
| 操作 | 顺序栈(数组) | 链栈(链表) |
|---|---|---|
| Push | O(1) | O(1) |
| Pop | O(1) | O(1) |
| 空间利用率 | 固定容量 | 动态分配 |
| 插入扩容 | 需要手动扩容 | 无需扩容 |
| 内存访问 | 连续存储 | 离散存储 |
链栈适合频繁扩容或栈大小不确定的场景,而顺序栈适合栈大小可预测、访问速度要求高的场景。
3.4 栈在递归与函数调用中的作用
栈不仅是数据结构,更是操作系统和编程语言运行机制的核心组成部分。特别是在函数调用和递归中,栈用于维护程序调用的上下文信息。
3.4.1 函数调用栈的运行机制
每次函数调用时,系统都会在运行时栈(Call Stack)中压入一个 栈帧 (Stack Frame),包含:
- 函数的局部变量
- 函数参数
- 返回地址
- 调用者的上下文信息
函数执行完毕后,该栈帧被弹出。
例如,以下C语言代码:
void func2() {
    int b = 20;
}

void func1() {
    int a = 10;
    func2();
}

int main() {
    func1();
    return 0;
}
调用过程:
graph TD
    main --> func1
    func1 --> func2
    func2 -->|pop| func1
    func1 -->|pop| main
3.4.2 栈在递归中的实现与优化
递归本质上是函数调用自身的机制,每次递归调用都会在栈中压入一个新的栈帧。例如:
def factorial(n):
    if n == 0:
        return 1
    return n * factorial(n - 1)
对于 factorial(3) ,其调用栈如下:
factorial(3) -> n=3, call factorial(2)
factorial(2) -> n=2, call factorial(1)
factorial(1) -> n=1, call factorial(0)
factorial(0) -> base case, return 1
递归的栈结构变化:
sequenceDiagram
    participant Stack
    Stack->>Stack: push factorial(3)
    Stack->>Stack: push factorial(2)
    Stack->>Stack: push factorial(1)
    Stack->>Stack: push factorial(0)
    Stack->>Stack: pop factorial(0) -> 1
    Stack->>Stack: pop factorial(1) -> 1*1=1
    Stack->>Stack: pop factorial(2) -> 2*1=2
    Stack->>Stack: pop factorial(3) -> 3*2=6
递归优化建议:
- 使用 尾递归 (Tail Recursion)优化栈空间,但Python不支持尾递归优化。
- 使用 栈模拟递归 ,避免栈溢出。
- 设置递归深度上限(Python默认1000层)。
本章通过对栈的定义、应用场景、数组与链表实现方式以及在递归与函数调用中的作用进行了深入讲解,并结合代码实现和流程图说明,帮助读者建立对栈结构的全面理解。下一章我们将探讨队列结构的FIFO特性及其在任务调度中的应用。
4. 队列的FIFO结构设计与实现
队列(Queue)是一种重要的线性结构,其操作遵循“先进先出”(First In First Out, FIFO)的原则。在日常编程与系统设计中,队列广泛应用于任务调度、缓冲机制、广度优先搜索(BFS)等场景。本章将系统地介绍队列的基本概念、实现方式及其典型应用场景,重点分析其数组与链表实现的原理、操作实现细节以及性能比较,帮助读者深入理解队列的结构设计与实现技巧。
4.1 队列的基本概念与特性
4.1.1 队列的定义与FIFO规则
队列是限定只能在一端进行插入操作,另一端进行删除操作的线性表。插入操作的一端称为 队尾(rear) ,删除操作的一端称为 队头(front) 。队列的操作遵循 FIFO 原则,即最早进入队列的元素最先被移除。
这种结构与现实生活中的排队系统类似,如银行窗口、打印机任务队列等。队列的核心操作包括:
- 入队(enqueue) :将元素添加到队尾;
- 出队(dequeue) :从队头移除元素;
- 判空(is_empty) :判断队列是否为空;
- 获取队头元素(front) :查看队头元素但不删除。
4.1.2 队列的基本操作(入队、出队、判空)
为了更直观地展示队列的基本操作,下面以一个简单的顺序队列结构为例,演示其基本功能实现:
#include <stdio.h>
#include <stdlib.h>

#define MAX_SIZE 10

typedef struct {
    int data[MAX_SIZE];
    int front;  // 队头指针
    int rear;   // 队尾指针
} Queue;

// 初始化队列
void init_queue(Queue* q) {
    q->front = 0;
    q->rear = 0;
}

// 判断队列是否为空
int is_empty(Queue* q) {
    return q->front == q->rear;
}

// 判断队列是否已满
int is_full(Queue* q) {
    return (q->rear + 1) % MAX_SIZE == q->front;
}

// 入队操作
void enqueue(Queue* q, int value) {
    if (is_full(q)) {
        printf("Queue is full\n");
        return;
    }
    q->data[q->rear] = value;
    q->rear = (q->rear + 1) % MAX_SIZE;  // 循环处理
}

// 出队操作
int dequeue(Queue* q) {
    if (is_empty(q)) {
        printf("Queue is empty\n");
        return -1;
    }
    int value = q->data[q->front];
    q->front = (q->front + 1) % MAX_SIZE;
    return value;
}

// 获取队头元素
int get_front(Queue* q) {
    if (is_empty(q)) {
        printf("Queue is empty\n");
        return -1;
    }
    return q->data[q->front];
}
代码分析与参数说明:
-
front和rear是两个指针变量,分别指示队头和队尾的位置; -
enqueue函数用于将元素插入队列尾部; -
dequeue函数用于从队列头部移除元素; -
% MAX_SIZE的使用是为了实现循环队列,避免“假溢出”问题; -
is_full和is_empty是判断队列状态的辅助函数。
注意 :该实现为循环队列的简化版本,适用于基本教学与演示。实际应用中需要考虑更多边界条件和错误处理。
4.2 队列的数组实现
4.2.1 循环队列的结构设计
顺序队列在使用数组实现时,容易出现“假溢出”问题,即队列未满但无法继续入队。为了解决这一问题,引入了 循环队列 的概念。
在循环队列中,数组被看作是一个首尾相连的环形结构,通过取模运算来实现指针的循环移动。其结构设计如下:
| 字段名 | 类型 | 描述 |
|---|---|---|
| data[] | int[] | 存储队列元素的数组 |
| front | int | 队头指针 |
| rear | int | 队尾指针 |
| size | int | 当前队列元素个数(可选) |
mermaid流程图:循环队列入队出队操作
graph TD
    A[初始化队列] --> B[入队]
    B --> C{队列是否已满?}
    C -->|是| D[提示队列已满]
    C -->|否| E[将元素插入rear位置]
    E --> F[rear = (rear + 1) % MAX_SIZE]
    F --> G[出队]
    G --> H{队列是否为空?}
    H -->|是| I[提示队列为空]
    H -->|否| J[取出front元素]
    J --> K[front = (front + 1) % MAX_SIZE]
4.2.2 操作实现与边界处理
在实际编程中,需要特别注意循环队列的边界处理。例如,当 rear == front 时,队列可能为空也可能为满。为了解决这个问题,通常有以下两种方式:
- 牺牲一个存储单元 :即当
(rear + 1) % MAX_SIZE == front时,视为队列已满。 - 引入一个计数器
size:记录当前队列中的元素个数,用于判断队列状态。
修改后的结构体定义(带 size):
typedef struct {
    int data[MAX_SIZE];
    int front;
    int rear;
    int size;  // 当前队列元素个数
} Queue;
对应的判断函数:
int is_empty(Queue* q) {
    return q->size == 0;
}

int is_full(Queue* q) {
    return q->size == MAX_SIZE;
}
入队与出队函数修改如下:
void enqueue(Queue* q, int value) {
    if (is_full(q)) {
        printf("Queue is full\n");
        return;
    }
    q->data[q->rear] = value;
    q->rear = (q->rear + 1) % MAX_SIZE;
    q->size++;
}

int dequeue(Queue* q) {
    if (is_empty(q)) {
        printf("Queue is empty\n");
        return -1;
    }
    int value = q->data[q->front];
    q->front = (q->front + 1) % MAX_SIZE;
    q->size--;
    return value;
}
逻辑分析:
- 使用
size变量可以更直观地判断队列状态,避免歧义; - 每次入队或出队后,
size的值都会相应增减; - 该方式虽然增加了内存开销,但在逻辑清晰性和边界处理上更具优势。
4.3 队列的链表实现
4.3.1 链式队列的结构定义
链式队列使用链表实现,避免了数组实现中的空间限制问题。链式队列的结构由两个指针组成: 队头指针(front) 和 队尾指针(rear) 。
typedef struct Node {
    int data;
    struct Node* next;
} Node;

typedef struct {
    Node* front;
    Node* rear;
    int size;
} LinkedQueue;
结构说明:
-
front:指向链表的第一个节点(队头); -
rear:指向链表的最后一个节点(队尾); -
size:记录队列中的元素个数; - 链表节点
Node包含数据域data和指针域next。
4.3.2 队列操作的实现与性能分析
初始化链式队列:
void init_linked_queue(LinkedQueue* q) {
    q->front = NULL;
    q->rear = NULL;
    q->size = 0;
}
入队操作:
void enqueue_linked(LinkedQueue* q, int value) {
    Node* new_node = (Node*)malloc(sizeof(Node));
    if (!new_node) {
        printf("Memory allocation failed\n");
        return;
    }
    new_node->data = value;
    new_node->next = NULL;

    if (q->rear == NULL) {  // 队列为空
        q->front = new_node;
        q->rear = new_node;
    } else {
        q->rear->next = new_node;
        q->rear = new_node;
    }
    q->size++;
}
出队操作:
int dequeue_linked(LinkedQueue* q) {
    if (q->front == NULL) {
        printf("Queue is empty\n");
        return -1;
    }
    Node* temp = q->front;
    int value = temp->data;
    q->front = q->front->next;
    free(temp);
    q->size--;
    if (q->front == NULL) {  // 出队后队列为空
        q->rear = NULL;
    }
    return value;
}
性能对比:
| 实现方式 | 空间效率 | 时间效率 | 扩展性 | 适用场景 |
|---|---|---|---|---|
| 数组实现 | 固定 | O(1) | 差 | 数据量固定 |
| 链表实现 | 动态 | O(1) | 好 | 数据量不固定 |
逻辑分析:
- 链式队列无需预分配空间,适合元素数量不固定的场景;
- 每次入队需要动态申请内存,存在一定的性能开销;
- 出队操作需要释放内存,避免内存泄漏;
- 链式结构在插入和删除操作上效率较高,尤其适用于频繁修改的队列。
4.4 队列的应用场景
4.4.1 任务调度与缓冲队列
队列在操作系统和并发编程中被广泛用于任务调度。例如,操作系统中的进程调度器使用队列来管理等待执行的进程。任务队列常用于生产者-消费者模型中,实现异步处理与负载均衡。
典型应用场景:
- 消息队列系统 :如 RabbitMQ、Kafka 等中间件,使用队列实现消息的顺序处理;
- 线程池管理 :工作线程从任务队列中取出任务执行,实现任务的并行处理;
- 网络请求缓冲 :服务器将请求放入队列中,按顺序处理以避免并发问题。
4.4.2 广度优先搜索(BFS)中的队列使用
广度优先搜索(BFS)是图论中的一种遍历算法,其核心思想是按层遍历节点,使用队列来管理待访问节点。
BFS算法伪代码:
def bfs(graph, start):
    visited = set()
    queue = deque([start])
    while queue:
        node = queue.popleft()
        if node not in visited:
            visited.add(node)
            for neighbor in graph[node]:
                if neighbor not in visited:
                    queue.append(neighbor)
逻辑分析:
-
queue用于保存当前层的所有节点; - 每次从队列中取出一个节点,访问其邻居并加入队列;
- 使用
visited集合避免重复访问; - BFS 能保证最短路径搜索(在无权图中);
- 队列的 FIFO 特性确保了节点按层访问。
总结 :队列作为FIFO结构的典型代表,在系统调度、算法设计、并发处理等领域具有广泛的应用。本章从队列的基本概念出发,详细讲解了其数组与链表实现的结构设计与操作实现,并通过代码示例和流程图帮助读者深入理解其原理与应用场景。下一章将进入字符串处理部分,继续探索数据结构的更多可能性。
5. 串的存储与基本操作实现
字符串(串)是计算机科学中最基础、最常用的数据结构之一,广泛应用于文本处理、编程语言、编译器设计、数据库查询等领域。字符串操作的性能和实现方式直接影响系统的效率与可维护性。本章将系统地讲解串的基本概念、存储结构以及基本操作的实现方法,并深入探讨串在实际开发中的重要性。
5.1 串的基本概念与术语
字符串(String)是由零个或多个字符组成的有限序列。它通常用来表示文本信息,是程序中最常见的数据类型之一。
5.1.1 串的定义与常用操作
串的基本定义如下:
- 空串 :长度为0的串,记作
""。 - 子串 :串中任意连续字符组成的子序列。
- 主串 :包含子串的原串。
- 串的长度 :串中字符的个数。
- 位置 :字符在串中的起始索引(通常从0开始)。
常见的串操作包括:
| 操作名 | 功能描述 |
|---|---|
StrAssign | 将字符串赋值给变量 |
StrCopy | 复制一个字符串 |
StrCompare | 比较两个字符串的大小 |
StrLength | 获取字符串长度 |
StrConcat | 连接两个字符串 |
SubString | 获取指定位置和长度的子串 |
Index | 查找子串在主串中的位置 |
Replace | 替换主串中所有匹配的子串 |
这些操作构成了串的基本抽象数据类型(ADT)的核心接口。
5.1.2 串与字符数组的区别
虽然字符串在很多编程语言中以字符数组的形式表示,但二者在逻辑结构和操作方式上存在本质区别:
| 特性 | 字符数组 | 串(String) |
|---|---|---|
| 可变性 | 可直接修改单个字符 | 通常不可变,操作生成新串 |
| 存储方式 | 连续内存,静态分配 | 动态分配,可扩展 |
| 操作复杂度 | 简单访问,复杂操作需手动实现 | 提供丰富的内置方法 |
| 应用场景 | 底层实现,性能敏感 | 高层开发,注重易用性和安全性 |
例如,在C语言中,字符串以字符数组结尾 \0 作为结束标志;而在Java或Python中,字符串是封装好的类,提供统一接口。
5.2 串的顺序存储实现
顺序串是使用数组来存储字符串内容的实现方式,具有访问速度快、结构简单等优点。
5.2.1 定长顺序串的结构定义
顺序串的结构可以定义为一个字符数组加上长度信息。例如:
#define MAX_STR_LEN 255  // 最大长度限制

typedef struct {
    char ch[MAX_STR_LEN];  // 存储字符
    int length;            // 串长度
} StringType;
这种方式适用于长度固定的字符串处理,但在动态扩展时存在局限。
5.2.2 串的基本操作实现(连接、比较、查找)
连接操作 StrConcat
连接两个字符串并返回新串:
int StrConcat(StringType *result, StringType s1, StringType s2) {
    if (s1.length + s2.length > MAX_STR_LEN) return 0;  // 超出最大长度
    for (int i = 0; i < s1.length; i++) {
        result->ch[i] = s1.ch[i];
    }
    for (int j = 0; j < s2.length; j++) {
        result->ch[s1.length + j] = s2.ch[j];
    }
    result->length = s1.length + s2.length;
    return 1;
}
逐行分析 :
- 第1行判断连接后的总长度是否超过限制。
- 第3~4行将第一个串复制到结果串中。
- 第5~7行将第二个串拼接到结果串后。
- 第8行设置结果串长度。
比较操作 StrCompare
比较两个字符串的大小(按字典序):
int StrCompare(StringType s1, StringType s2) {
    int i = 0;
    while (i < s1.length && i < s2.length) {
        if (s1.ch[i] != s2.ch[i]) {
            return s1.ch[i] - s2.ch[i];  // 不同字符比较
        }
        i++;
    }
    return s1.length - s2.length;  // 前缀相同,比较长度
}
逐行分析 :
- 第1行初始化索引。
- 第2~6行逐字符比较,遇到不同字符立即返回差值。
- 第7行处理前缀相同的情况,返回长度差。
查找子串 Index
查找子串在主串中的位置:
int Index(StringType S, StringType T) {
    int i = 0;
    while (i <= S.length - T.length) {
        int j = 0;
        while (j < T.length && S.ch[i + j] == T.ch[j]) {
            j++;
        }
        if (j == T.length) return i;  // 找到匹配
        i++;
    }
    return -1;  // 未找到
}
逐行分析 :
- 第1行初始化主串搜索位置。
- 第2~8行遍历主串,尝试匹配子串。
- 第9行返回未找到。
5.3 串的链式存储实现
链式串使用链表结构来存储字符串,适用于动态长度变化的场景。
5.3.1 链式串的结构设计
链式串的节点结构如下:
typedef struct StringNode {
    char data;              // 当前字符
    struct StringNode *next; // 下一节点
} StringNode, *StringList;
整个字符串由链表节点串联而成,头节点指向第一个字符。
5.3.2 操作实现与性能比较
创建链式串
StringList CreateString(char *chars) {
    StringList head = NULL, tail = NULL;
    while (*chars != '\0') {
        StringNode *newNode = (StringNode*)malloc(sizeof(StringNode));
        newNode->data = *chars;
        newNode->next = NULL;
        if (!head) {
            head = newNode;
            tail = newNode;
        } else {
            tail->next = newNode;
            tail = newNode;
        }
        chars++;
    }
    return head;
}
逐行分析 :
- 第3行初始化头尾指针。
- 第4~12行循环创建节点并连接。
- 第13行返回链表头指针。
性能比较(顺序串 vs 链式串)
| 操作 | 顺序串 | 链式串 |
|---|---|---|
| 插入 | O(n) | O(1)(尾插) |
| 删除 | O(n) | O(1)(已知节点) |
| 查找 | O(n) | O(n) |
| 空间利用率 | 高 | 略低(含指针) |
| 可扩展性 | 固定大小限制 | 动态增长 |
链式串更适合频繁插入/删除操作的场景,而顺序串适合静态或频繁访问的场景。
5.4 模式匹配算法(BF与KMP算法)
模式匹配是字符串处理的核心问题之一,广泛应用于文本编辑、搜索引擎、编译器等领域。
5.4.1 BF算法原理与实现
Brute Force(BF)算法是最朴素的模式匹配方法,其思想是逐字符比对,一旦不匹配则回溯主串。
int BF(StringType S, StringType T) {
    int i = 0, j = 0;
    while (i < S.length && j < T.length) {
        if (S.ch[i] == T.ch[j]) {
            i++; j++;  // 匹配成功,继续下一对
        } else {
            i = i - j + 1;  // 回溯主串
            j = 0;          // 重新开始匹配
        }
    }
    if (j == T.length) return i - j;  // 返回匹配位置
    else return -1;  // 未找到
}
逐行分析 :
- 第2行初始化索引。
- 第3~9行进行字符比对与回溯。
- 第10~11行判断是否匹配成功。
时间复杂度 :最坏情况下为 O(n * m),其中 n 为主串长度,m 为模式串长度。
5.4.2 KMP算法思想与优化实现
Knuth-Morris-Pratt(KMP)算法通过预处理模式串,构建 next 数组,避免主串回溯,显著提升效率。
void getNext(StringType T, int next[]) {
    next[0] = -1;
    int i = 0, j = -1;
    while (i < T.length - 1) {
        if (j == -1 || T.ch[i] == T.ch[j]) {
            i++; j++;
            next[i] = j;
        } else {
            j = next[j];
        }
    }
}

int KMP(StringType S, StringType T, int next[]) {
    int i = 0, j = 0;
    while (i < S.length && j < T.length) {
        if (j == -1 || S.ch[i] == T.ch[j]) {
            i++; j++;
        } else {
            j = next[j];
        }
    }
    if (j == T.length) return i - j;
    else return -1;
}
逐行分析 :
- getNext 函数构建 next 数组,用于回溯。
- KMP 函数使用 next 数组避免主串回溯,提高效率。
时间复杂度 :预处理 O(m),匹配 O(n),总体为 O(n + m)。
流程图表示 :
graph TD
    A[开始] --> B[构建next数组]
    B --> C[初始化i=0,j=0]
    C --> D{S[i] == T[j] ?}
    D -- 是 --> E[i++,j++]
    D -- 否 --> F[j = next[j]]
    E --> G{j == T.length?}
    F --> G
    G -- 是 --> H[返回i-j]
    G -- 否 --> I{i < S.length?}
    I -- 是 --> C
    I -- 否 --> J[返回-1]
通过本章的深入分析,我们不仅了解了串的基本概念和存储结构,还掌握了串操作的实现方式以及模式匹配算法的核心思想。下一章将进入更复杂的数据结构——数组与广义表的讨论。
6. 数组与广义表的概念与实现
6.1 数组的基本概念与存储方式
数组(Array)是一种线性数据结构,用于存储 固定大小 的同类型数据。数组在计算机科学中具有基础地位,广泛应用于各种算法和程序设计中。数组可以是一维、二维或多维的,其本质是通过顺序存储的方式将多个数据元素组织起来,并通过索引进行快速访问。
6.1.1 多维数组的定义与访问
在C语言中,定义一个二维数组如下:
int matrix[3][4]; // 3行4列的二维数组
该数组可以表示为一个3行4列的矩阵,其中每个元素可以通过 matrix[i][j] 进行访问,其中 i 表示行索引, j 表示列索引。
多维数组的访问逻辑是通过 索引映射 实现的。例如,一个二维数组 A[m][n] 在内存中是按 行优先 顺序存储的。假设每个元素占用 k 个字节,则元素 A[i][j] 的存储地址为:
Address(A[i][j]) = BaseAddress + (i * n + j) * k
6.1.2 数组的顺序存储结构与索引计算
数组的存储结构是 顺序存储 ,即所有元素在内存中是连续存放的。对于多维数组,其实质是通过一维内存空间模拟多维结构。
以三维数组 A[x][y][z] 为例,其每个元素的地址计算公式为:
Address(A[i][j][k]) = BaseAddress + ((i * y * z) + (j * z) + k) * size_of_element
这种计算方式保证了数组元素在内存中的连续性,也便于CPU缓存优化。
下面是一个数组索引计算的C语言示例:
#include <stdio.h>

int main() {
    int arr[3][4] = {
        {1, 2, 3, 4},
        {5, 6, 7, 8},
        {9, 10, 11, 12}
    };

    int i = 1, j = 2;
    int *base = &arr[0][0];
    int element = *(base + i * 4 + j); // 计算偏移量访问元素
    printf("Element at [%d][%d] = %d\n", i, j, element); // 输出 7

    return 0;
}
代码解释:
- base 指向数组的起始地址;
- i * 4 + j 计算二维数组中元素的线性偏移量;
- *(base + offset) 实现指针访问。
6.2 特殊矩阵的压缩存储
矩阵是数组的一种典型应用。对于 特殊矩阵 ,如对称矩阵、三角矩阵、稀疏矩阵等,可以采用 压缩存储 的方式节省空间。
6.2.1 对称矩阵与三角矩阵的压缩方法
对称矩阵 是指矩阵中的元素满足 A[i][j] == A[j][i] 。由于其对称性,只需存储下三角或上三角部分即可。
例如,一个 n×n 的对称矩阵,只需存储 n(n+1)/2 个元素。
压缩方式示例:
A[0][0]
A[1][0], A[1][1]
A[2][0], A[2][1], A[2][2]
对应一维数组 sa[k] ,索引映射公式为:
k = i*(i+1)/2 + j
6.2.2 稀疏矩阵的三元组表示与压缩存储
稀疏矩阵 是指大多数元素为零的矩阵。使用三元组(行号、列号、值)表示非零元素,可以显著节省空间。
三元组表结构定义(C语言):
typedef struct {
    int row;        // 行号
    int col;        // 列号
    int value;      // 非零值
} Triple;
稀疏矩阵三元组表示示例:
| row | col | value |
|---|---|---|
| 0 | 1 | 5 |
| 1 | 2 | 3 |
| 2 | 0 | 7 |
稀疏矩阵的三元组存储结构适用于 矩阵转置、加法、乘法 等运算,尤其在图的邻接矩阵表示中具有重要应用。
6.3 广义表的基本概念与结构
广义表 (Generalized List)是一种非线性的递归结构,它可以包含 原子元素 或 子表 ,因此比普通线性表更灵活。
6.3.1 广义表的定义与递归结构
广义表的定义形式如下:
L = (a1, a2, ..., an)
其中, ai 可以是一个原子(如整数、字符)或另一个广义表。
例如:
-
A = ( ):空表 -
B = (a, b, c):原子表 -
C = (a, (b, c), d):含子表的广义表
广义表具有 递归结构 ,非常适合表示嵌套结构。
6.3.2 广义表的头尾链表存储方式
为了实现广义表,常采用 头尾链表 结构。每个节点包含:
-
tag:标记是原子(0)还是子表(1) -
data:如果为原子,存储值;如果为子表,指向子表的指针 -
next:指向下一个节点
C语言结构定义如下:
typedef enum { ATOM, LIST } ElementType;

typedef struct GLNode {
    ElementType tag;            // 节点类型
    union {
        int atom;               // 原子值
        struct GLNode *list;    // 子表指针
    } data;
    struct GLNode *next;        // 下一个节点
} *GList;
该结构可以递归构建和解析广义表,适用于编译器中语法树的表示、Lisp语言的实现等领域。
6.4 广义表的操作实现
6.4.1 广义表的创建与遍历
创建广义表可以采用递归方式。以下是一个简化版的创建函数(以字符串输入为例):
GList CreateGList(char *s) {
    if (*s == '(') {
        GList head = (GList)malloc(sizeof(struct GLNode));
        head->tag = LIST;
        s++; // 跳过 '('
        if (*s == ')') {
            head->data.list = NULL; // 空表
        } else {
            head->data.list = CreateGList(s); // 创建子表
        }
        s++; // 跳过 ')'
        return head;
    } else {
        GList atomNode = (GList)malloc(sizeof(struct GLNode));
        atomNode->tag = ATOM;
        atomNode->data.atom = *s - '0'; // 假设为数字字符
        atomNode->next = NULL;
        return atomNode;
    }
}
遍历广义表同样使用递归方式:
void PrintGList(GList L) {
    if (L == NULL) return;
    if (L->tag == ATOM) {
        printf("%d", L->data.atom);
    } else {
        printf("(");
        PrintGList(L->data.list);
        printf(")");
    }
    if (L->next) {
        printf(",");
        PrintGList(L->next);
    }
}
6.4.2 广义表的深度与长度计算
广义表的长度 是指第一层元素的个数; 深度 是指嵌套的最大层数。
例如:
-
A = (a, b, c):长度 = 3,深度 = 1 -
B = (a, (b, c), d):长度 = 3,深度 = 2
深度计算的递归函数如下:
int GListDepth(GList L) {
    if (L == NULL) return 1;
    int maxDepth = 0;
    while (L) {
        if (L->tag == LIST) {
            int depth = GListDepth(L->data.list);
            if (depth > maxDepth) maxDepth = depth;
        }
        L = L->next;
    }
    return maxDepth + 1;
}
该函数递归遍历每个子表,返回最大嵌套深度。
下一章节将继续深入探讨树与二叉树的结构与实现,敬请期待。
简介:数据结构是计算机科学的核心内容,涉及如何在内存中高效组织和操作数据。本压缩包包含涵盖线性表、栈、队列、串、数组、广义表、树、图以及动态存储管理等多种基础与高级数据结构的伪C代码实现。通过这些代码,学习者可以深入理解数据结构的原理及其在实际编程中的应用,提升算法设计与问题解决能力。

北京人形旗下天工造物具身智能开源社区,聚焦具身天工与慧思开物两大平台
更多推荐
 30
 0
- 0


 已为社区贡献25条内容

所有评论(0)